Karpenter
支持的版本:Karpenter 1.14 LTS(示例:1.14.1);请根据兼容性和 provider 支持表选择 Kubernetes/EKS 版本。 最后更新:October 16, 2026
目录
简介
Karpenter 是一款开源节点自动扩缩器。本章使用其 AWS provider,为兼容的 Kubernetes 工作负载预置 EC2 容量。可用性和效率取决于约束、云容量、节点初始化和应用设计。
Karpenter 的主要优势
- 快速响应扩缩:在工作负载因无法调度而产生需求时开始预置;节点和应用就绪时间没有固定的延迟保证。
- 成本优化:为工作负载选择最合适的实例类型
- 配置简单:通过声明式 API 轻松配置
- 以工作负载为中心的设计:根据 Pod 要求预置节点
- 云集成:利用云 provider 的功能
- 高效装箱:优化资源利用率
- 灵活的节点管理:管理节点生命周期并集成中断处理
与现有自动扩缩器的比较
| 功能 | Karpenter | Cluster Autoscaler | 云 provider 托管节点组 |
|---|---|---|---|
| 扩缩速度 | 取决于调度、EC2 容量和初始化 | 取决于节点组扩缩和初始化 | 取决于扩缩策略、容量和初始化 |
| 实例类型选择 | 动态 | 基于节点组 | 基于节点组 |
| 装箱效率 | 取决于工作负载/约束 | 取决于工作负载/节点组 | 取决于调度器和扩缩控制器 |
| 配置复杂度 | 低 | 中 | 低 |
| 云集成 | provider 专属实现 | 多种云 provider 集成 | 云平台原生 |
| 节点组管理 | 不需要 | 需要 | 需要 |
| 中断处理 | 已配置的事件处理和节点生命周期 | 取决于平台/集成 | 平台专属处理 |
注意:EKS 于 2026 年 4 月 8 日增加了 Managed Node Group warm-pool 支持。预初始化的实例可以减少重复初始化工作;Stopped 和 Running 模式的转换时间和成本不同,缩容时是否复用实例则为可选项。根据 AWS 的说法,Cluster Autoscaler 集成无需额外配置。恢复、节点就绪和应用启动仍需要时间。这是 EKS Managed Node Group/Auto Scaling 功能,并非由 Karpenter 管理的节点池。
架构
Karpenter 以 Kubernetes 控制器的形式运行,检测无法调度的 Pod 并预置适当的节点。
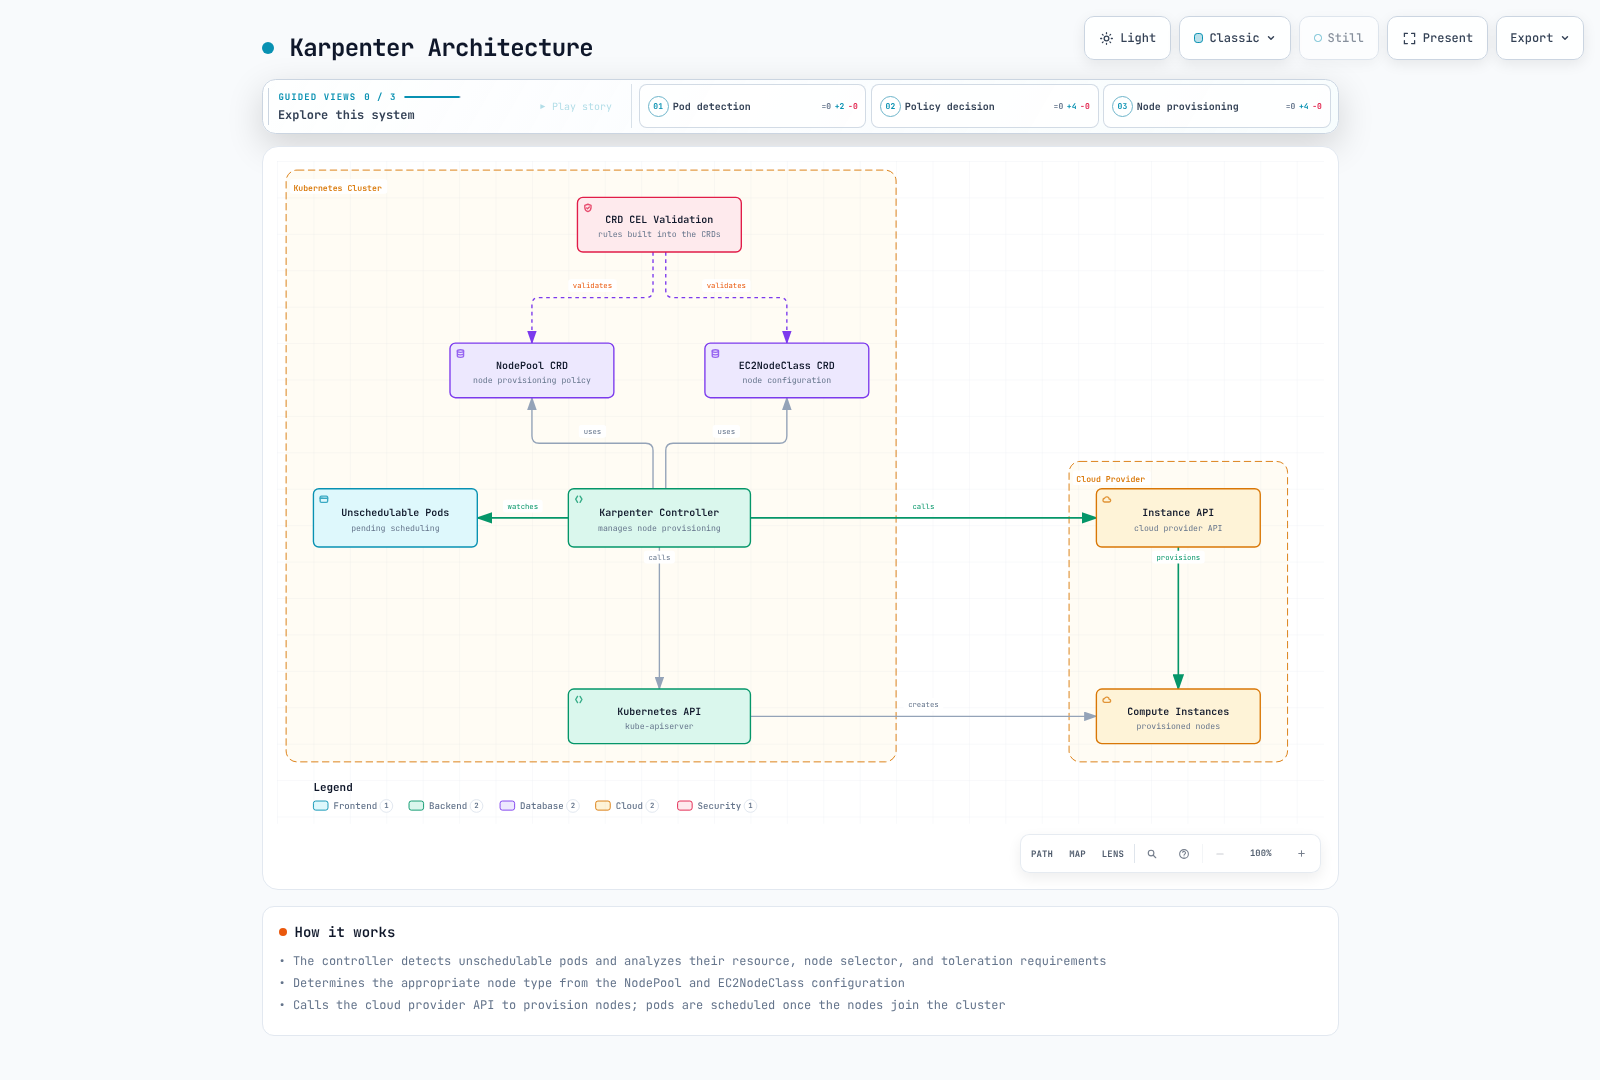
Karpenter 工作流程
下图展示了 Karpenter 在 EKS 集群中的工作方式:
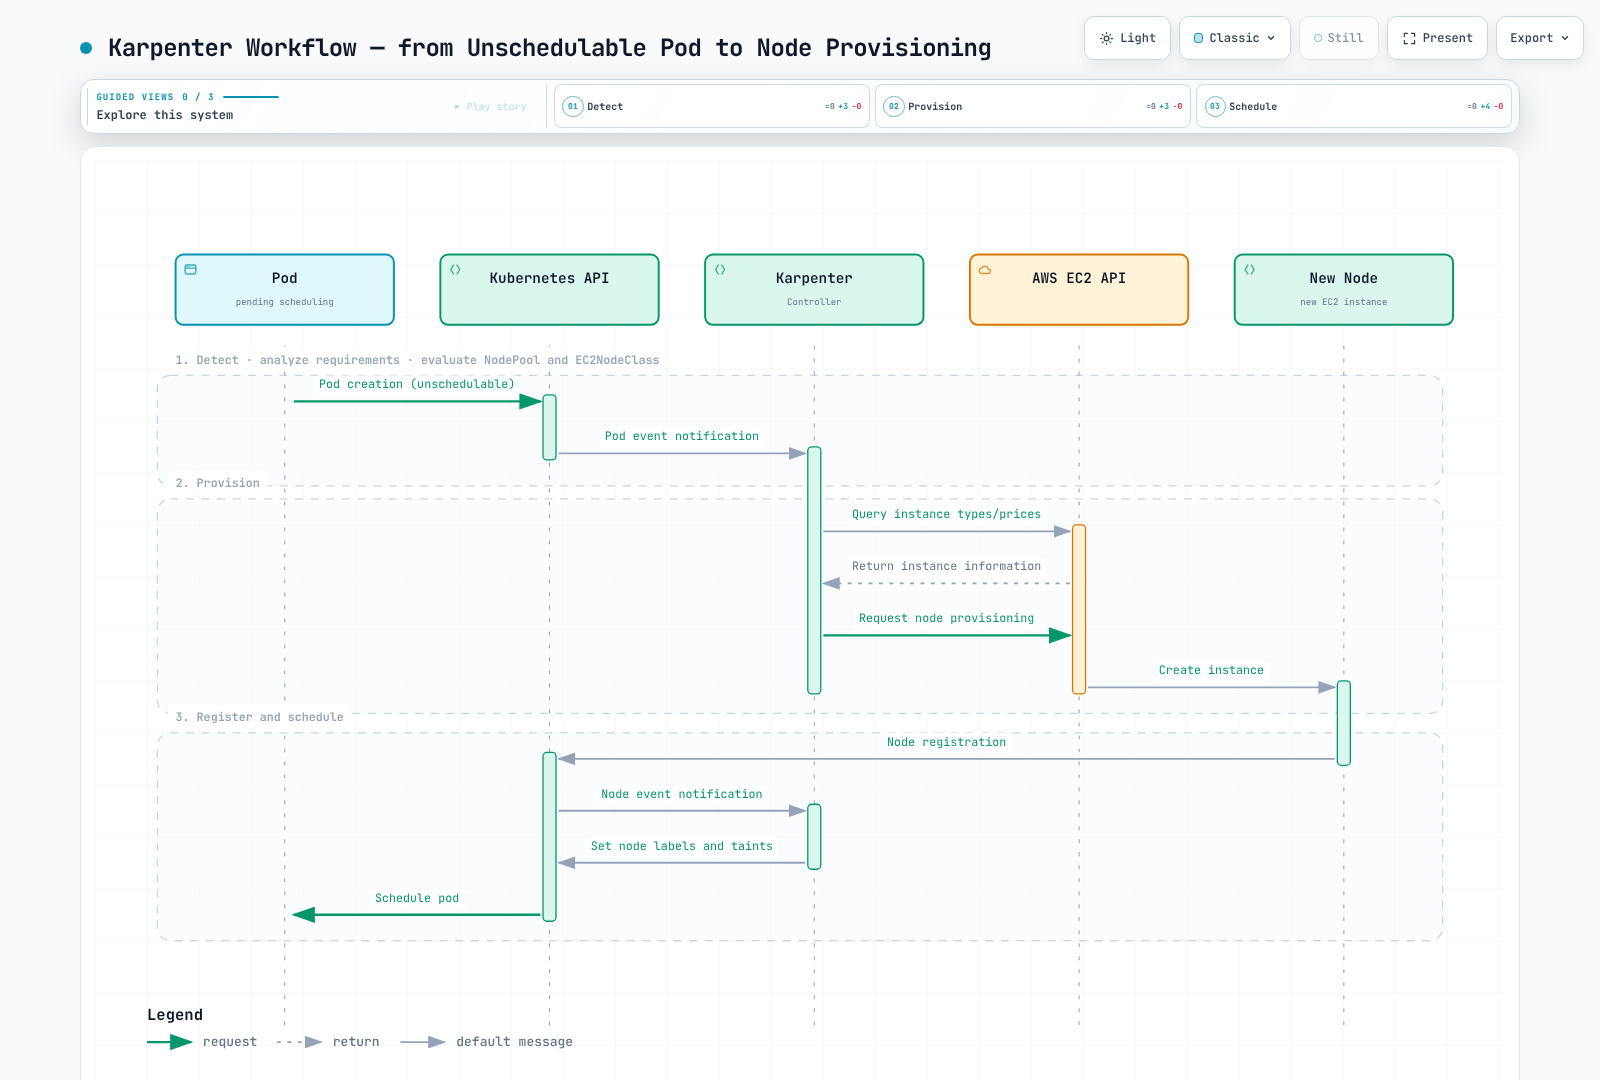
主要组件
- Karpenter 控制器:模拟调度需求、创建 NodeClaims 并管理节点生命周期;实际的 Pod 绑定由 Kubernetes 的调度器执行。
- CRD CEL 验证:NodePool 和 EC2NodeClass 由 CRD 中的 CEL 规则进行验证(Karpenter 1.1 中移除了 admission/conversion webhook)
- NodePool 和 NodeClaim CRD:NodePool 定义策略;NodeClaim 记录单个预置节点的要求和生命周期。
- EC2NodeClass CRD:定义要预置节点的配置
- 云 provider 集成:与云 provider API 集成以管理计算资源
工作原理
- Karpenter 控制器检测无法调度的 Pod
- 分析 Pod 要求(资源、节点选择器、容忍等)
- 根据 NodePool 和 EC2NodeClass 配置确定合适的节点类型
- 调用云 provider API 来预置节点
- 节点注册并就绪;之后 Kubernetes 调度器可以绑定符合条件的 Pod。Karpenter 不会取代 kube-scheduler。
- Consolidation、漂移、过期、手动删除和云中断各有不同的触发条件和防护措施;它们并非全部属于 SQS 中断事件。
安装和配置
不含 apiVersion/kind 的 YAML 代码块是针对所讨论的 NodePool 或 EC2NodeClass spec 的配置片段;它们并非可独立通过 kubectl apply 应用的文档。
这些是针对现有集群的独立学习示例,并非可用于生产环境的部署套件。重复的对象名称表示不同的替代方案。安装前,请准备并验证 IAM/OIDC、节点访问、已批准的子网/安全组、引导容量和中断队列。所有 YAML 使用 my-cluster 之类的字面示例名称;kubectl 不会在保存的 YAML 文件中展开 ${CLUSTER_NAME}。本次审查未预置 AWS 资源、安装 Karpenter 或测量扩缩表现。如果该版本已经安装,全新安装命令会失败;现有安装必须遵循对应版本的升级/CRD 迁移指南。
先决条件
- 使用平台和 Karpenter 兼容性矩阵均支持的 Kubernetes 版本。已发布的矩阵列出了 Kubernetes1.34 所需的最低 Karpenter 版本为 1.6,1.35 为 1.9,1.36 为 1.13;这些最低版本并不表示所有旧版 Karpenter 次要版本仍受维护。v1.14 矩阵不包含1.37,v1.15 矩阵则要求 Kubernetes1.37 使用 Karpenter1.15.x。EKS 版本的可用性/支持情况需要另行检查。
- 已配置的 kubectl
- 云 provider 凭证和权限
- Helm(可选)
在 AWS EKS 上安装
1. IAM 角色和策略设置
这些命令假设已有控制器角色、节点角色,并且 EKS 使用基于 API 的身份验证(API 或 API_AND_CONFIG_MAP)。对于仅使用 CONFIG_MAP 的集群,应检查现有的 aws-auth 节点映射,而不是运行 list-access-entries;不要将更改身份验证模式作为顺带的设置步骤。节点角色信任 EC2,并需要 worker-node/ECR 拉取权限(例如 AmazonEKSWorkerNodePolicy 和 AmazonEC2ContainerRegistryPullOnly)。在支持的情况下,为 VPC CNI 配置独立身份;SSM 权限为可选项,且需要已配置的 agent。AmazonEKSClusterPolicy 不能替代 Karpenter 控制器策略。
# Set the existing cluster and Region; these commands only inspect AWS/Kubernetes.
export CLUSTER_NAME="my-cluster"
export AWS_REGION="us-west-2"
export KARPENTER_VERSION="1.14.1"
ACCOUNT_ID=$(aws sts get-caller-identity --query Account --output text)
CLUSTER_ENDPOINT=$(aws eks describe-cluster --region "$AWS_REGION" --name "$CLUSTER_NAME" --query cluster.endpoint --output text)
export ACCOUNT_ID CLUSTER_ENDPOINT
kubectl config current-context
aws iam get-role --role-name "KarpenterControllerRole-${CLUSTER_NAME}" --query Role.AssumeRolePolicyDocument
aws iam get-role --role-name "KarpenterNodeRole-${CLUSTER_NAME}" --query Role.AssumeRolePolicyDocument
aws eks list-access-entries --region "$AWS_REGION" --cluster-name "$CLUSTER_NAME"
2. 使用 Helm 安装
准备好所引用的队列和引导容量后,只运行一次全新安装示例。如需升级,请查阅对应版本的迁移指南并更新匹配的 CRD(例如,通过单独管理的 karpenter-crd chart);单独升级控制器 chart 通常不会升级 CRD。迁移现有 CRD 安装前,请验证其所有权。
# Run only after the prerequisites and the current kubectl context are verified.
: "${CLUSTER_NAME:?Set the existing cluster name}"
: "${ACCOUNT_ID:?Set the AWS account ID}"
: "${CLUSTER_ENDPOINT:?Set the matching EKS endpoint}"
KARPENTER_VERSION="1.14.1"
helm install karpenter oci://public.ecr.aws/karpenter/karpenter \
  --version "$KARPENTER_VERSION" \
  --namespace karpenter --create-namespace \
  --set-string 'serviceAccount.annotations.eks\.amazonaws\.com/role-arn'="arn:aws:iam::${ACCOUNT_ID}:role/KarpenterControllerRole-${CLUSTER_NAME}" \
  --set-string settings.clusterName="$CLUSTER_NAME" \
  --set-string settings.clusterEndpoint="$CLUSTER_ENDPOINT" \
  --set-string settings.interruptionQueue="$CLUSTER_NAME" \
  --wait --timeout 5m
3. 验证安装
kubectl get deployments,pods -n karpenter
kubectl rollout status deployment/karpenter -n karpenter --timeout=180s
kubectl get nodepools,ec2nodeclasses,nodeclaims
默认两个控制器副本的示例输出(并非本次审查中实际执行所得):
NAME                         READY   STATUS    RESTARTS   AGE
karpenter-<hash>-<id-1>      1/1     Running   0          1m
karpenter-<hash>-<id-2>      1/1     Running   0          1m
基本 NodePool 和 EC2NodeClass 配置
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: default
spec:
  disruption:
    consolidationPolicy: WhenEmpty
    consolidateAfter: 30s
  limits:
    cpu: '1000'
    memory: 1000Gi
  template:
    spec:
      requirements:
      - key: karpenter.sh/capacity-type
        operator: In
        values:
        - on-demand
      - key: kubernetes.io/arch
        operator: In
        values:
        - amd64
      - key: node.kubernetes.io/instance-type
        operator: In
        values:
        - m5.large
        - m5.xlarge
        - m5.2xlarge
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: default
---
apiVersion: karpenter.k8s.aws/v1
kind: EC2NodeClass
metadata:
  name: default
spec:
  role: KarpenterNodeRole-my-cluster
  amiSelectorTerms:
  - alias: al2023@latest
  subnetSelectorTerms:
  - tags:
      karpenter.sh/discovery: my-cluster
  securityGroupSelectorTerms:
  - tags:
      karpenter.sh/discovery: my-cluster
  tags:
    karpenter.sh/discovery: my-cluster
  blockDeviceMappings:
  - deviceName: /dev/xvda
    ebs:
      volumeSize: 100Gi
      volumeType: gp3
      deleteOnTermination: true
      encrypted: true
NodePool
NodePool 是一种 Kubernetes 自定义资源,用于定义 Karpenter 如何预置节点。它取代了之前的 Provisioner。
基本 NodePool 配置
下面的特殊污点有意要求工作负载配置匹配的容忍项。在你验证有初始化程序会移除所配置的污点之前,startupTaints 应保持为空;如果设置启动污点却没有对应的管理者,节点可能会一直无法使用。限制、初始化和中断示例是不同的替代方案,并非对运行中的生产 NodePool 进行叠加修改的指引。
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: default
spec:
  template:
    metadata:
      labels:
        environment: training
        app: web
    spec:
      requirements:
      - key: karpenter.sh/capacity-type
        operator: In
        values:
        - on-demand
      - key: kubernetes.io/arch
        operator: In
        values:
        - amd64
      - key: node.kubernetes.io/instance-type
        operator: In
        values:
        - m5.large
        - m5.xlarge
        - m5.2xlarge
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: default
      expireAfter: 720h
      taints:
      - key: example.com/special-taint
        value: 'true'
        effect: NoSchedule
      startupTaints: []
  limits:
    cpu: '1000'
    memory: 1000Gi
  disruption:
    consolidationPolicy: WhenEmpty
    consolidateAfter: 30s
Requirements 配置
Requirements 会彼此取交集,并与 EC2NodeClass 以及 Pod 约束取交集。允许 amd64 和 arm64 只有在符合条件的实例类型、AMI 和容器镜像均支持两种架构时才有帮助。列出符合条件的可用区/容量类型并不能保证容量平均分布;如需实现这一点,请使用工作负载拓扑约束。
Requirements 定义 Karpenter 将预置的节点特征:
template:
  spec:
    requirements:
    - key: karpenter.sh/capacity-type
      operator: In
      values:
      - on-demand
      - spot
    - key: kubernetes.io/arch
      operator: In
      values:
      - amd64
      - arm64
    - key: node.kubernetes.io/instance-type
      operator: In
      values:
      - m5.large
      - m5.xlarge
      - c5.large
      - m6g.large
      - c6g.large
    - key: topology.kubernetes.io/zone
      operator: In
      values:
      - us-west-2a
      - us-west-2b
      - us-west-2c
    - key: kubernetes.io/os
      operator: In
      values:
      - linux
Limits 配置
spec.limits 限制预置资源的总量,但并行预置使用最终一致性检查,因此可能会暂时超过限制。它不是严格的账单上限。使用字符串数量可避免 API/GitOps 类型差异。
limits:
  cpu: '1000'
  memory: 1000Gi
  nvidia.com/gpu: '10'
实验性的 DRA 分配跟踪(v1.13)
Karpenter 核心 v1.13 新增了 DRA 设备分配跟踪。这并不意味着生产环境中的 DRA 预置已得到全面保证:AWS1.14.1 chart 默认将 settings.ignoreDRARequests: true,而上游仍将正式 DRA 支持标记为尚未 GA。Kubernetes1.29 的最低版本要求不足以证明兼容性。请验证确切的 Kubernetes 资源 API、DRA 驱动程序、ResourceClaims/ResourceSlices 和 Karpenter 配置;不要将 DRA 声明视为与下方的 device-plugin 扩展资源示例可互换。
节点过期配置
expireAfter 定义因过期而开始排空的时间,并不保证在特定时间内完成替换。下面的可选 terminationGracePeriod 会限制排空时间,但可能强制删除剩余的 Pod,包括受 PDB 阻止的 Pod。只有验证应用关闭和恢复要求后,才应选择该期限。
spec:
  template:
    spec:
      expireAfter: 720h
      terminationGracePeriod: 30m
  disruption:
    consolidationPolicy: WhenEmpty
    consolidateAfter: 30s
识别 NodeReadinessController 污点(v1.13)
Karpenter 核心 v1.13 在模拟未初始化的受管节点的调度时,会将独立的 NodeReadinessController 所设的 readiness.k8s.io/ 污点识别为临时污点。它仍会等待这些污点消失后才标记初始化完成;它不会删除这些污点,也不会让 Kubernetes 调度器绕过它们。对于其他初始化程序设置的污点,仍需准确配置 startupTaints,并确保有控制器将其移除。
2026 年 7 月更新:v1.14 已发布
Karpenter v1.14 于 2026 年 7 月 11 日发布,带来以下更新:
- 支持 CapacityBuffers API:增加 alpha 阶段的容量缓冲区集成;默认禁用
CapacityBuffer,并且需要匹配的 CRD/控制器配置。预留的容量余量不是免费容量,也不代表延迟保证。 - 支持预览版实例类型:识别符合条件的预览版实例;实际预置仍需要账户/区域访问权限和容量可用性。
- 支持 Nitro Enclaves:当 NodeClaim 资源请求包含
eks.amazonaws.com/nip-slots时,provider 会将生成的启动模板EnclaveOptions.Enabled设为 true。兼容的实例、AMI 和 device-plugin 设置仍是先决条件;1.14.1 中没有EC2NodeClass.spec.enclaveOptions字段。 - Bug 修复:在次级 ENI 上计入主 IP、确保 Zonal Shift 缓存已填充、将 AWS SDK 客户端超时接入 operator 配置等
详情请参阅 v1.14.0 发行说明。
2026 年 7 月 17 日,较旧分支收到了包括1.3.8 和1.11.3 在内的补丁。这次历史性的向后移植并不代表所有中间次要版本会继续受支持。当前支持策略列出 LTS1.9 支持至 2027 年 2 月,LTS1.14 支持至 2027 年 7 月;常规次要版本仅支持到下一个次要版本发布。请选择受支持的版本线并遵循其迁移指南,不要假设旧版本线仍在维护。
AWS 于 2026 年 7 月 22 日发布公告,为 Karpenter/EKS Auto Mode 增加了 EFA 网络接口和置放群组配置。在 AWS Karpenter1.14.1 中,具体字段是 EC2NodeClass.spec.networkInterfaces 和 spec.placementGroupSelector(不是 NodePool 字段)。仅使用 EFA 的接口不占用 VPC IP 地址,但仍需要在设备/卡索引0处配置主 interface。按名称或 ID 选择现有置放群组;其集群/Spread/Partition 策略和支持的实例会限制置放条件。此处的示例不会配置或验证 HPC 工作负载。
2026 年 8 月更新:v1.14.1 补丁版本发布
v1.14.1 是 v1.14 版本线上的第一个补丁版本,于 2026 年 8 月 21 日发布。这是一个维护版本,更新了上游 sigs.k8s.io/karpenter 版本,并回合移植了 v1.14.0 之后的修复。
2026 年 10 月更新:v1.15.0 常规版本发布
v1.15.0 是一个常规(非 LTS)次要版本,于 2026 年 10 月 10 日发布。主要变更:
- 节点修复成为自愿中断:节点修复纳入中断处理机制;当容量受限的 NodePool 无法先暂存替换节点时,会优先终止再修复。新增通过
ec2:RebootInstances执行重启修复的操作(由RebootForRepairAWS feature gate 控制),此前的修复控制器仍可通过--legacy-node-repairflag 使用。 - KubeletConfiguration 支持 CEL:
maxPodsExpression、kubeReserved和systemReserved接受 CEL 表达式,且扩展了 EC2NodeClass 的 KubeletConfiguration 字段。 - 更广泛的 DRA 支持:支持优先级替代方案,以及 NVIDIA 和 EFA 驱动程序的 DRA 支持。
- 其他更新:新增
--aws-feature-gatesflag、默认感知 Pod 拓扑分布、预置时计入实例类型卷限制、新增karpenter_pods_disrupted_total等中断指标,以及受 feature gate 控制的 Pod 删除成本管理控制器。
根据支持策略,常规次要版本仅支持到下一个次要版本发布,因此 v1.15.0 发布后,v1.14 仅作为 LTS 版本线继续支持(至 2027 年 7 月);因此,本章示例仍使用 1.14 LTS (1.14.1)。Kubernetes 1.37 要求使用 Karpenter 1.15.x,因此如果需要 Kubernetes 1.37 或要升级到 1.15,请先查看 v1.15 兼容性矩阵 和升级指南。详情请参阅 v1.15.0 发行说明。
Node Classes
Node Classes 定义 Karpenter 预置节点的配置。在 AWS 上,它使用 EC2NodeClass CRD。
AWS EC2NodeClass 配置
apiVersion: karpenter.k8s.aws/v1
kind: EC2NodeClass
metadata:
  name: default
spec:
  subnetSelectorTerms:
  - tags:
      karpenter.sh/discovery: my-cluster
  securityGroupSelectorTerms:
  - tags:
      karpenter.sh/discovery: my-cluster
  tags:
    karpenter.sh/discovery: my-cluster
    environment: training
  blockDeviceMappings:
  - deviceName: /dev/xvda
    ebs:
      volumeSize: 100Gi
      volumeType: gp3
      deleteOnTermination: true
      encrypted: true
  role: KarpenterNodeRole-my-cluster
  amiSelectorTerms:
  - alias: al2023@latest
  userData: '#!/bin/bash

    echo "Hello from Karpenter node!"

    '
  metadataOptions:
    httpEndpoint: enabled
    httpProtocolIPv6: disabled
    httpPutResponseHopLimit: 1
    httpTokens: required
子网和安全组选择
使用 selector terms 选择子网和安全组(多个 term 之间为 OR 关系;一个 term 内的标签之间为 AND 关系):
subnetSelectorTerms:
- tags:
    karpenter.sh/discovery: my-cluster
    Name: private-*
securityGroupSelectorTerms:
- tags:
    karpenter.sh/discovery: my-cluster
AMI 配置
Karpenter 通过 amiSelectorTerms 选择 AMI。别名用于选择系列/版本;@latest 不是固定版本,可能会更改解析出的 AMI 并触发漂移。@latest 示例用于学习。生产环境中,请在发布前解析并测试明确且受支持的 AMI 版本(使用带有真实发布日期的 al2023@vYYYYMMDD)或已批准的 AMI ID。Kubernetes1.33 及更高版本不再发布 AL2 EKS AMI。以下变体是替代方案;Custom AMI 需要正确配置引导、注册污点、kubelet、CNI/运行时和身份。
# Amazon Linux 2023
amiSelectorTerms:
  - alias: al2023@latest
---
# Bottlerocket
amiSelectorTerms:
  - alias: bottlerocket@latest
---
# Custom AMI (by ID): amiFamily is required when no alias term is used
amiFamily: Custom
amiSelectorTerms:
  - id: "ami-0123456789abcdef0"
# Ubuntu: no v1 alias; use amiFamily: Custom with an id/tags/name term
块设备配置
设备映射因 AMI 系列而异。这些 AL2023 示例使用 /dev/xvda 作为根设备;对于其他 AMI,请检查实际的设备布局。额外卷需要明确的文件系统/挂载或应用存储方案。客户管理的 KMS 密钥也需要相应的密钥/IAM 权限。
你可以定义节点的存储配置:
blockDeviceMappings:
- deviceName: /dev/xvda
  ebs:
    volumeSize: 100Gi
    volumeType: gp3
    iops: 3000
    throughput: 125
    deleteOnTermination: true
    encrypted: true
    kmsKeyID: arn:aws:kms:us-west-2:111122223333:key/1234abcd-12ab-34cd-56ef-1234567890ab
- deviceName: /dev/xvdb
  ebs:
    volumeSize: 500Gi
    volumeType: gp3
    deleteOnTermination: true
    encrypted: true
User Data 配置
这些 shell user-data 片段假设使用 AL2023,Karpenter 会将自定义数据合并到 AL2023 生成的 bootstrap/nodeadm 配置中。它们并非适用于 Bottlerocket/Windows 的通用引导配置。应将软件包烘焙到 AMI 并进行测试,而不是在每次启动时都不受限制地更新软件包。在没有相应配置、IAM 和网络通路的情况下安装/启动 CloudWatch Agent,并不能确保遥测数据会被收集。
userData: |
  #!/bin/bash
  set -euo pipefail
  # Only for a workload that requires this setting; keep node packages in a tested AMI.
  cat > /etc/sysctl.d/99-workload-map-count.conf <<'EOF'
  vm.max_map_count=262144
  EOF
  sysctl -p /etc/sysctl.d/99-workload-map-count.conf
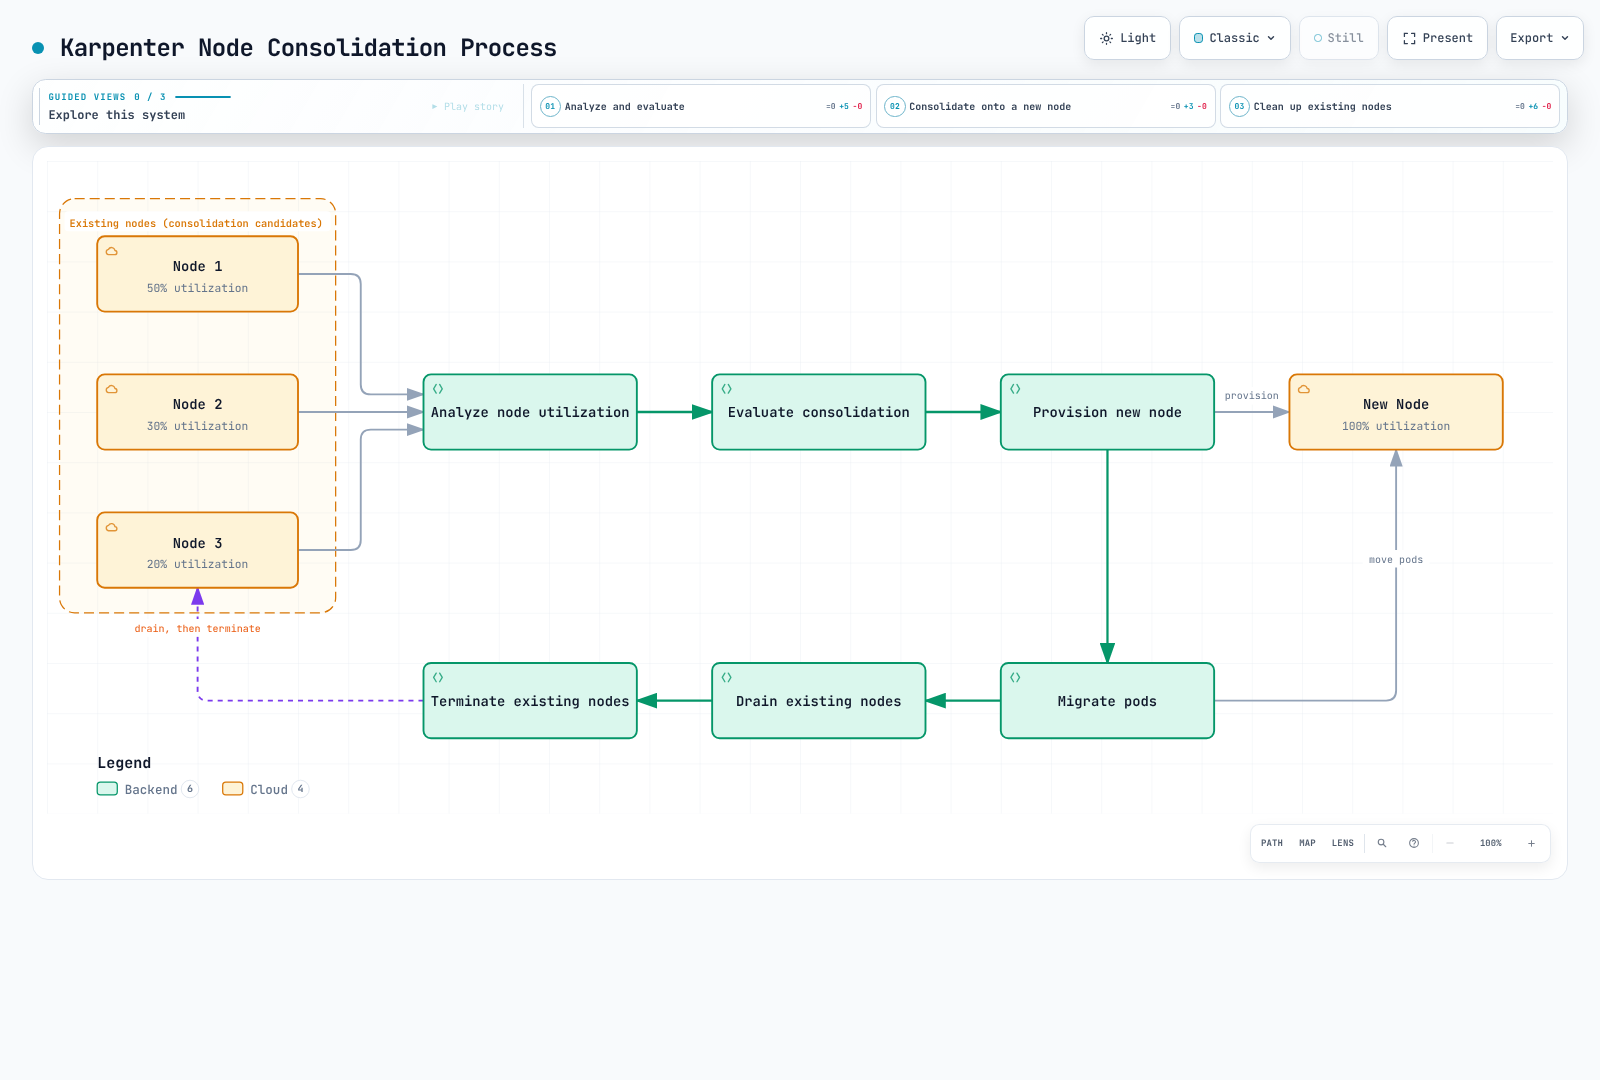
节点 Consolidation 流程
下图展示了 Karpenter 的节点 Consolidation 流程。此功能对于提高集群效率和降低成本非常重要:
中断处理
已配置的中断处理会尝试在容量丢失之前作出响应。结果取决于通知、替换容量、关机期限和应用恢复情况;无法保证服务不中断。
集成的中断处理
云中断处理与 Consolidation/过期处理相互独立。它会处理以下信号:
- Spot 中断警告:在可能的情况下开始排空并请求替换容量;通知时限不代表恢复 SLA 保证。
- 计划内的运行状况/维护事件:对受影响的实例作出响应。
- 实例停止/终止事件:协调即将退出服务的容量。
- EC2 实例状态故障:使用所需的 EC2 API 权限检查运行状况。Rebalance 建议仅作为事件发布,不会自动触发污点标记/排空/终止操作。
中断处理配置
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: default
spec:
  template:
    spec:
      requirements:
        - key: karpenter.sh/capacity-type
          operator: In
          values: ["on-demand"]
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: default

      # Node expiration settings
      expireAfter: 720h  # 30 days
  disruption:
    consolidationPolicy: WhenEmpty
    consolidateAfter: 30s
排空配置
Karpenter 通常会在优雅排空时使用 eviction。Helm 设置用于配置控制器;NodePool 中断预算限制的是自愿 Consolidation/漂移的启动,而不是所有同时发生的节点丢失。30% 的预算会向上取整,然后扣除正在删除/未就绪的节点;它不是严格的30%上限。过期、中断和修复可能会有不同的强制处理行为。在启用 interruptionQueue 之前,请配置相应的 SQS 队列、EventBridge 规则/目标、队列策略和控制器权限;仅设置 Helm 字段并不会创建这些资源。
settings:
  clusterName: my-cluster
  interruptionQueue: my-cluster
  batchMaxDuration: 10s
  batchIdleDuration: 1s
  featureGates:
    spotToSpotConsolidation: false
controller:
  resources:
    requests:
      cpu: 1
      memory: 1Gi
    limits:
      cpu: '1'
      memory: 1Gi
logLevel: infoapiVersion: karpenter.sh/v1
kind: NodePool
metadata:
name: default
spec:
template:
spec:
requirements:
- key: karpenter.sh/capacity-type
operator: In
values: ["on-demand"]
nodeClassRef:
group: karpenter.k8s.aws
kind: EC2NodeClass
name: default
expireAfter: 720h
disruption:
consolidationPolicy: WhenEmpty
consolidateAfter: 30s
budgets:
- nodes: "30%" # Voluntary budget: round up, then subtract deleting/not-ready nodesPDB(PodDisruptionBudget)集成
PDB 根据健康副本数量限制自愿 eviction;它不会创建副本,也不保证应用可用性。下面的 minAvailable: 2 要求在允许 eviction 之前,存在足够数量的匹配健康 Pod。实例丢失和强制终止期限仍可能导致这些 Pod 中断。
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: app-pdb
  namespace: default
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: my-app
集成
Karpenter 可与多种 Kubernetes 和云服务集成。
Kubernetes 集成
1. Pod 拓扑分布约束
Karpenter 在预置节点时会考虑 Pod 拓扑分布约束:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web-server
  namespace: default
spec:
  replicas: 10
  template:
    spec:
      topologySpreadConstraints:
      - maxSkew: 1
        topologyKey: topology.kubernetes.io/zone
        whenUnsatisfiable: DoNotSchedule
        labelSelector:
          matchLabels:
            app: web-server
      containers:
      - name: web-server
        image: nginx:1.30.6
        ports:
        - containerPort: 80
        resources:
          requests:
            cpu: 100m
            memory: 128Mi
          limits:
            memory: 256Mi
    metadata:
      labels:
        app: web-server
  selector:
    matchLabels:
      app: web-server
2. Pod 亲和性/反亲和性
Karpenter 会考虑 Pod 亲和性和反亲和性规则:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web-server
  namespace: default
spec:
  replicas: 10
  template:
    spec:
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchExpressions:
              - key: app
                operator: In
                values:
                - web-server
            topologyKey: kubernetes.io/hostname
      containers:
      - name: web-server
        image: nginx:1.30.6
        ports:
        - containerPort: 80
        resources:
          requests:
            cpu: 100m
            memory: 128Mi
          limits:
            memory: 256Mi
    metadata:
      labels:
        app: web-server
  selector:
    matchLabels:
      app: web-server
3. 污点和容忍
GPU 示例需要兼容的加速 AMI、NVIDIA 驱动程序,以及一个能够容忍 GPU 污点并声明 nvidia.com/gpu 的 device-plugin DaemonSet。BusyBox Pod 仅用于演示预留 GPU;它不会运行或基准测试 CUDA。请单独使用实际的 GPU 应用镜像进行验证。
Karpenter 在预置节点时会考虑污点和容忍:
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: gpu
spec:
  template:
    spec:
      requirements:
      - key: node.kubernetes.io/instance-type
        operator: In
        values:
        - g4dn.xlarge
        - g4dn.2xlarge
      taints:
      - key: nvidia.com/gpu
        value: 'true'
        effect: NoSchedule
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: default
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: gpu-app
  namespace: default
spec:
  replicas: 3
  template:
    spec:
      tolerations:
      - key: nvidia.com/gpu
        operator: Exists
        effect: NoSchedule
      nodeSelector:
        karpenter.sh/nodepool: gpu
      containers:
      - name: gpu-allocation-demo
        image: busybox:1.38.0
        command:
        - sh
        - -c
        - sleep 3600
        resources:
          requests:
            cpu: 100m
            memory: 64Mi
          limits:
            memory: 128Mi
            nvidia.com/gpu: 1
    metadata:
      labels:
        app: gpu-app
  selector:
    matchLabels:
      app: gpu-app
AWS 集成
1. EC2 Spot 实例
Karpenter 支持使用 EC2 Spot 实例来优化成本:
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: spot
spec:
  template:
    spec:
      requirements:
      - key: karpenter.sh/capacity-type
        operator: In
        values:
        - spot
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: spot
---
apiVersion: karpenter.k8s.aws/v1
kind: EC2NodeClass
metadata:
  name: spot
spec:
  role: KarpenterNodeRole-my-cluster
  amiSelectorTerms:
  - alias: al2023@latest
  subnetSelectorTerms:
  - tags:
      karpenter.sh/discovery: my-cluster
  securityGroupSelectorTerms:
  - tags:
      karpenter.sh/discovery: my-cluster
2. EC2 Instance Profile
role 和 instanceProfile 不能同时使用。使用 role 时,Karpenter 会管理 instance profile,并需要相应的 IAM API 权限/连接。如果集群无法访问 IAM endpoint,请使用预先配置的 instanceProfile;IAM 没有 PrivateLink endpoint。控制器仍需要对其节点角色拥有 PassRole 权限;EKS 节点访问与持有 EC2 凭证是两回事。
Karpenter 使用 EC2 instance profile 向节点授予 IAM 权限:
apiVersion: karpenter.k8s.aws/v1
kind: EC2NodeClass
metadata:
  name: default
spec:
  instanceProfile: KarpenterNodeInstanceProfile-my-cluster
  amiSelectorTerms:
  - alias: al2023@latest
  subnetSelectorTerms:
  - tags:
      karpenter.sh/discovery: my-cluster
  securityGroupSelectorTerms:
  - tags:
      karpenter.sh/discovery: my-cluster
3. 替代启动模板(EC2NodeClass)
Karpenter v1 不接受用户提供的 EC2 启动模板(已移除旧版 launchTemplate 字段)。Karpenter 会根据 EC2NodeClass 自行生成并管理启动模板,因此原本会放在启动模板中的设置需要直接在 EC2NodeClass 中配置:
apiVersion: karpenter.k8s.aws/v1
kind: EC2NodeClass
metadata:
  name: node-config
spec:
  role: KarpenterNodeRole-my-cluster
  subnetSelectorTerms:
  - tags:
      karpenter.sh/discovery: my-cluster
  securityGroupSelectorTerms:
  - tags:
      karpenter.sh/discovery: my-cluster
  amiSelectorTerms:
  - alias: al2023@latest
  userData: '#!/bin/bash

    echo "Hello from Karpenter node!"

    '
  blockDeviceMappings:
  - deviceName: /dev/xvda
    ebs:
      volumeSize: 100Gi
      volumeType: gp3
      deleteOnTermination: true
      encrypted: true
  metadataOptions:
    httpEndpoint: enabled
    httpProtocolIPv6: disabled
    httpPutResponseHopLimit: 1
    httpTokens: required
与 Amazon EKS 集成
在配置好身份、网络、节点访问和引导后,Karpenter 的 AWS provider 可以与 EKS 管理的计算资源共同预置 EC2 容量。
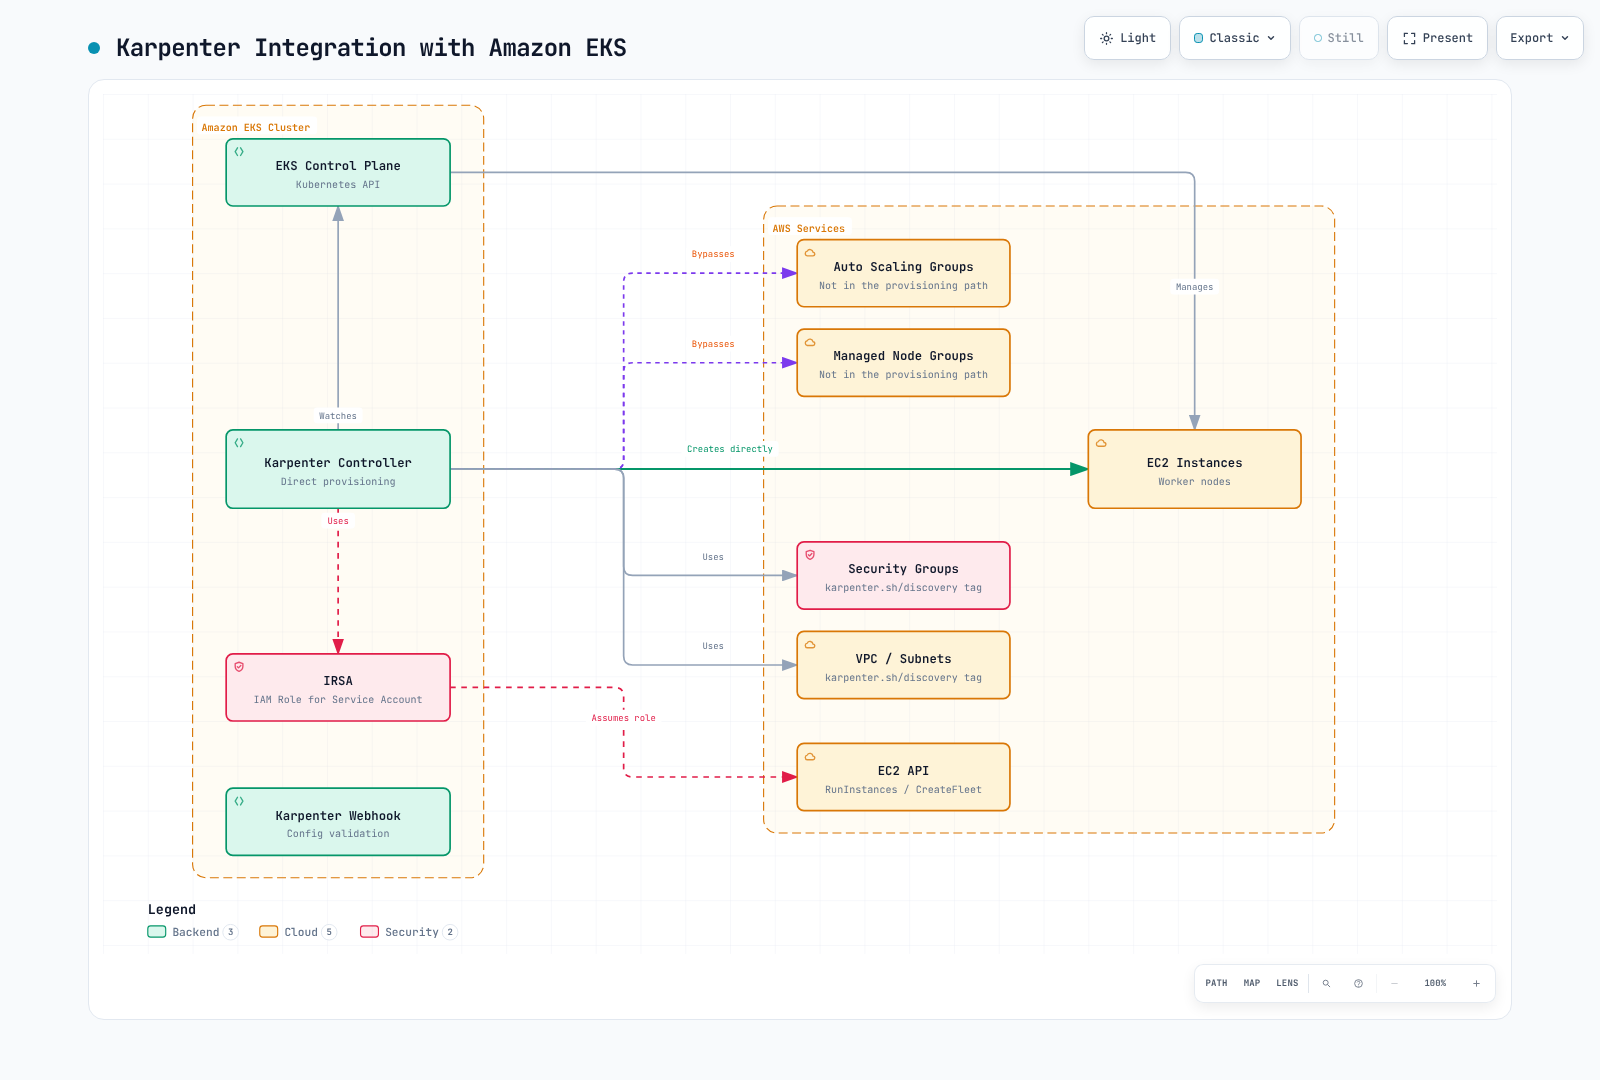
EKS 集群准备
请一致地替换所有示例名称。只选择适合工作节点的子网/安全组;为所有控制平面子网添加标签并不是安全的资源发现策略。允许节点启动之前,请验证子网路由、安全规则、CNI IP 容量以及所需的私有 endpoint。
1. 集群标签设置
请在基础设施配置中仅为已批准的工作节点子网和安全组添加标签。VPC 标签不会决定这些资源的选择方式。发现标签值必须与示例匹配(此处为 my-cluster);仅有标签并不能证明路由是私有的、安全规则适用或有足够的可用地址。在应用 NodePool 前,请检查实际资源和路由。
# Inspect resources that your infrastructure configuration has tagged for this cluster.
: "${CLUSTER_NAME:?Set the existing cluster name}"
: "${AWS_REGION:?Set the cluster Region}"
aws ec2 describe-subnets --region "$AWS_REGION" \
  --filters "Name=tag:karpenter.sh/discovery,Values=${CLUSTER_NAME}" \
  --query 'Subnets[].{ID:SubnetId,AZ:AvailabilityZone,FreeIPs:AvailableIpAddressCount,PublicIPOnLaunch:MapPublicIpOnLaunch,VPC:VpcId}'
aws ec2 describe-security-groups --region "$AWS_REGION" \
  --filters "Name=tag:karpenter.sh/discovery,Values=${CLUSTER_NAME}" \
  --query 'SecurityGroups[].{ID:GroupId,VPC:VpcId,Name:GroupName}'
# Inspect explicit and main route-table associations for the intended subnets.
aws ec2 describe-route-tables --region "$AWS_REGION" \
  --filters "Name=vpc-id,Values=$(aws eks describe-cluster --region "$AWS_REGION" --name "$CLUSTER_NAME" --query cluster.resourcesVpcConfig.vpcId --output text)"
2. IAM 角色设置
请使用下方针对特定版本的控制器策略和基础设施参考,而不要使用前文不完整的手写 allow-all 策略。控制器凭证(此处为 IRSA)与节点凭证、VPC CNI/工作负载身份相互独立。控制器信任策略必须与集群 OIDC provider、system:serviceaccount:karpenter:karpenter 和 aud: sts.amazonaws.com 匹配;只授予此版本和所选功能所需的操作/资源/条件。节点角色必须获准加入 EKS;启用了基于 API 的身份验证时,通常通过 EC2_LINUX access entry 授予权限。这些检查命令不会创建 IAM 角色或 access entry。
# Download a versioned reference for review; this does not create a CloudFormation stack.
KARPENTER_VERSION="1.14.1"
curl --fail --show-error --location \
  "https://raw.githubusercontent.com/aws/karpenter-provider-aws/v${KARPENTER_VERSION}/website/content/en/preview/getting-started/getting-started-with-karpenter/cloudformation.yaml" \
  --output karpenter-cloudformation-reference.yaml
# Inspect the existing role's attached and inline policies.
: "${CLUSTER_NAME:?Set the existing cluster name}"
aws iam list-attached-role-policies --role-name "KarpenterControllerRole-${CLUSTER_NAME}"
aws iam list-role-policies --role-name "KarpenterControllerRole-${CLUSTER_NAME}"
在 EKS 集群上安装 Karpenter
# Run only after the prerequisites and the current kubectl context are verified.
: "${CLUSTER_NAME:?Set the existing cluster name}"
: "${ACCOUNT_ID:?Set the AWS account ID}"
: "${CLUSTER_ENDPOINT:?Set the matching EKS endpoint}"
KARPENTER_VERSION="1.14.1"
helm install karpenter oci://public.ecr.aws/karpenter/karpenter \
  --version "$KARPENTER_VERSION" \
  --namespace karpenter --create-namespace \
  --set-string 'serviceAccount.annotations.eks\.amazonaws\.com/role-arn'="arn:aws:iam::${ACCOUNT_ID}:role/KarpenterControllerRole-${CLUSTER_NAME}" \
  --set-string settings.clusterName="$CLUSTER_NAME" \
  --set-string settings.clusterEndpoint="$CLUSTER_ENDPOINT" \
  --set-string settings.interruptionQueue="$CLUSTER_NAME" \
  --wait --timeout 5m
与 EKS Managed Node Groups 配合使用
Karpenter 可以与 EKS Managed Node Groups 共存。以下 NodePool 会预置独立的 EC2 节点;它不会管理 Managed Node Group。请让控制器运行在可靠的引导容量上(默认 chart 会排除 Karpenter 节点,并请求两个分布在不同主机上的副本)。
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: managed-ng
spec:
  template:
    metadata:
      labels:
        managed-by: karpenter
    spec:
      requirements:
      - key: karpenter.sh/capacity-type
        operator: In
        values:
        - on-demand
      - key: node.kubernetes.io/instance-type
        operator: In
        values:
        - m5.large
        - m5.xlarge
      taints:
      - key: managed-by
        value: karpenter
        effect: NoSchedule
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: managed-ng
  disruption:
    consolidationPolicy: WhenEmpty
    consolidateAfter: 30s
---
apiVersion: karpenter.k8s.aws/v1
kind: EC2NodeClass
metadata:
  name: managed-ng
spec:
  role: KarpenterNodeRole-my-cluster
  amiSelectorTerms:
  - alias: al2023@latest
  subnetSelectorTerms:
  - tags:
      karpenter.sh/discovery: my-cluster
  securityGroupSelectorTerms:
  - tags:
      karpenter.sh/discovery: my-cluster
  tags:
    karpenter.sh/discovery: my-cluster
与 EKS Fargate 配合使用
Fargate 不实现 Kubernetes topologySpreadConstraints,Kubernetes 亲和性/反亲和性规则也不适用于 Fargate。不要假设默认 chart 的 EC2 置放约束能够保证 Fargate 在多个可用区之间分散;应单独设计和验证 profile/子网置放。
可以使用范围严格限定的 Fargate profile 承载控制器 Pod,同时由 Karpenter 预置 EC2 worker。Karpenter 不会创建 Fargate 容量或管理其 profile。应准备一个选择 karpenter 命名空间和控制器标签的 profile,而不是涵盖整个 default/kube-system;JSON 选择器结构为 [{"namespace":"karpenter","labels":{"app.kubernetes.io/name":"karpenter"}}]。该 profile 需要自己的 Pod execution role/私有子网,控制器 AWS 权限仍需通过 IRSA 提供(EKS Pod Identity 不支持在 Fargate 上使用)。以下命令只会检查现有 profile。
# Inspect an existing, narrowly selected controller Fargate profile.
: "${CLUSTER_NAME:?Set the existing cluster name}"
: "${AWS_REGION:?Set the cluster Region}"
aws eks describe-fargate-profile --region "$AWS_REGION" \
--cluster-name "$CLUSTER_NAME" --fargate-profile-name karpenter-controllerapiVersion: karpenter.sh/v1
kind: NodePool
metadata:
name: ec2
spec:
template:
spec:
requirements:
- key: karpenter.sh/capacity-type
operator: In
values:
- on-demand
nodeClassRef:
group: karpenter.k8s.aws
kind: EC2NodeClass
name: ec2
disruption:
consolidationPolicy: WhenEmpty
consolidateAfter: 30s
---
apiVersion: karpenter.k8s.aws/v1
kind: EC2NodeClass
metadata:
name: ec2
spec:
role: KarpenterNodeRole-my-cluster
amiSelectorTerms:
- alias: al2023@latest
subnetSelectorTerms:
- tags:
karpenter.sh/discovery: my-cluster
securityGroupSelectorTerms:
- tags:
karpenter.sh/discovery: my-cluster可用区故障响应:Amazon ARC Zonal Shift 集成(2026 年 5 月)
Karpenter 可以与已启用的 EKS ARC zonal-shift 资源集成。手动 zonal shift 或配置的 autoshift 生效后,Karpenter 会避免在受影响的可用区中创建新容量。这并不意味着它能够独立检测每一种可用区故障,也不会覆盖将工作负载固定在该可用区的 Pod/PV 要求。
在 shift 生效期间,受影响可用区中的自愿中断会暂停;依赖于将 Pod 移入该可用区的健康可用区中断操作也会被阻止。这并不表示所有健康可用区中的所有自愿中断都会无条件暂停。请配置 EKS/ARC 先决条件、eks:DescribeCluster/ARC 权限以及 settings.enableZonalShift: true(环境变量选项 ENABLE_ZONAL_SHIFT);autoshift 还需要单独选择启用并配置演练。无需自定义 ARC CRD,shift 结束后操作会恢复。
EKS 成本优化
你可以使用 Karpenter 优化 EKS 集群的成本:
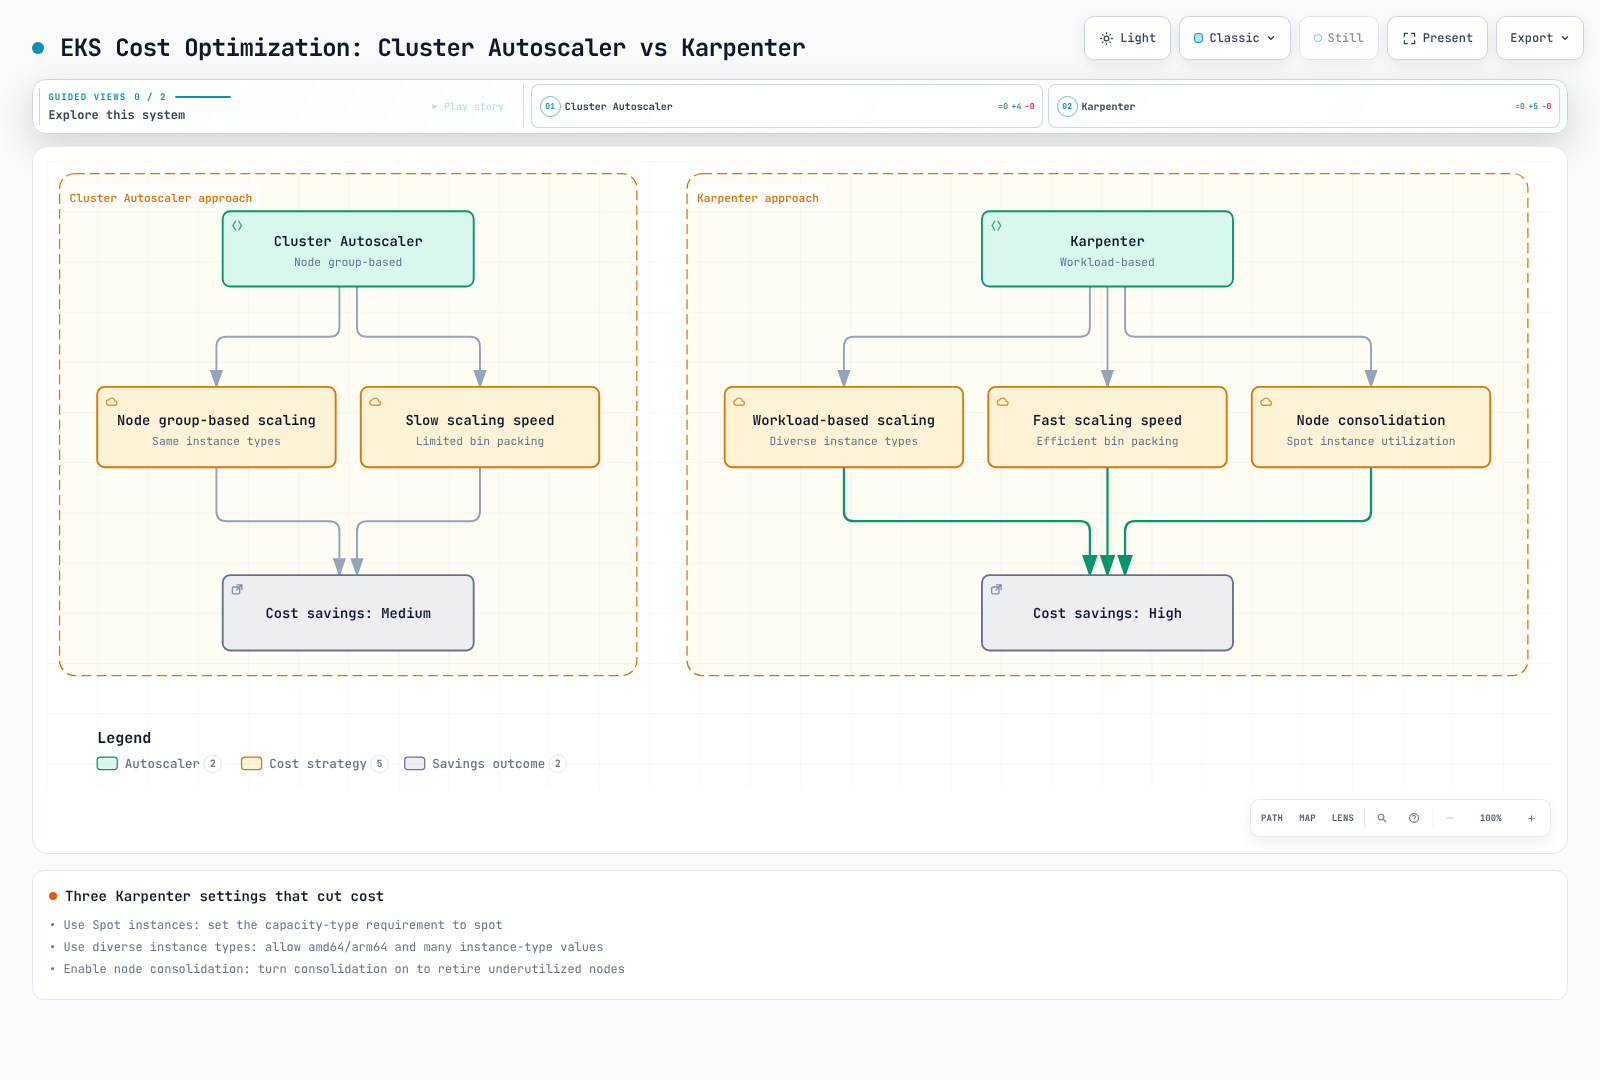
1. 使用 Spot 实例
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: spot
spec:
  template:
    spec:
      requirements:
      - key: karpenter.sh/capacity-type
        operator: In
        values:
        - spot
      - key: kubernetes.io/arch
        operator: In
        values:
        - amd64
        - arm64
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: spot
  disruption:
    consolidationPolicy: WhenEmpty
    consolidateAfter: 30s
---
apiVersion: karpenter.k8s.aws/v1
kind: EC2NodeClass
metadata:
  name: spot
spec:
  role: KarpenterNodeRole-my-cluster
  amiSelectorTerms:
  - alias: al2023@latest
  subnetSelectorTerms:
  - tags:
      karpenter.sh/discovery: my-cluster
  securityGroupSelectorTerms:
  - tags:
      karpenter.sh/discovery: my-cluster
2. 使用多种实例类型
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: flexible
spec:
  template:
    spec:
      requirements:
      - key: karpenter.sh/capacity-type
        operator: In
        values:
        - on-demand
        - spot
      - key: kubernetes.io/arch
        operator: In
        values:
        - amd64
        - arm64
      - key: node.kubernetes.io/instance-type
        operator: In
        values:
        - m5.large
        - m5.xlarge
        - m5.2xlarge
        - m6g.large
        - m6g.xlarge
        - m6g.2xlarge
        - c5.large
        - c5.xlarge
        - c5.2xlarge
        - c6g.large
        - c6g.xlarge
        - c6g.2xlarge
        - r5.large
        - r5.xlarge
        - r5.2xlarge
        - r6g.large
        - r6g.xlarge
        - r6g.2xlarge
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: default
  disruption:
    consolidationPolicy: WhenEmpty
    consolidateAfter: 30s
3. 启用节点 Consolidation
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: default
spec:
  template:
    spec:
      requirements:
        - key: karpenter.sh/capacity-type
          operator: In
          values: ["on-demand"]
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: default
  disruption:
    consolidationPolicy: WhenEmptyOrUnderutilized
    consolidateAfter: 1m
最佳实践
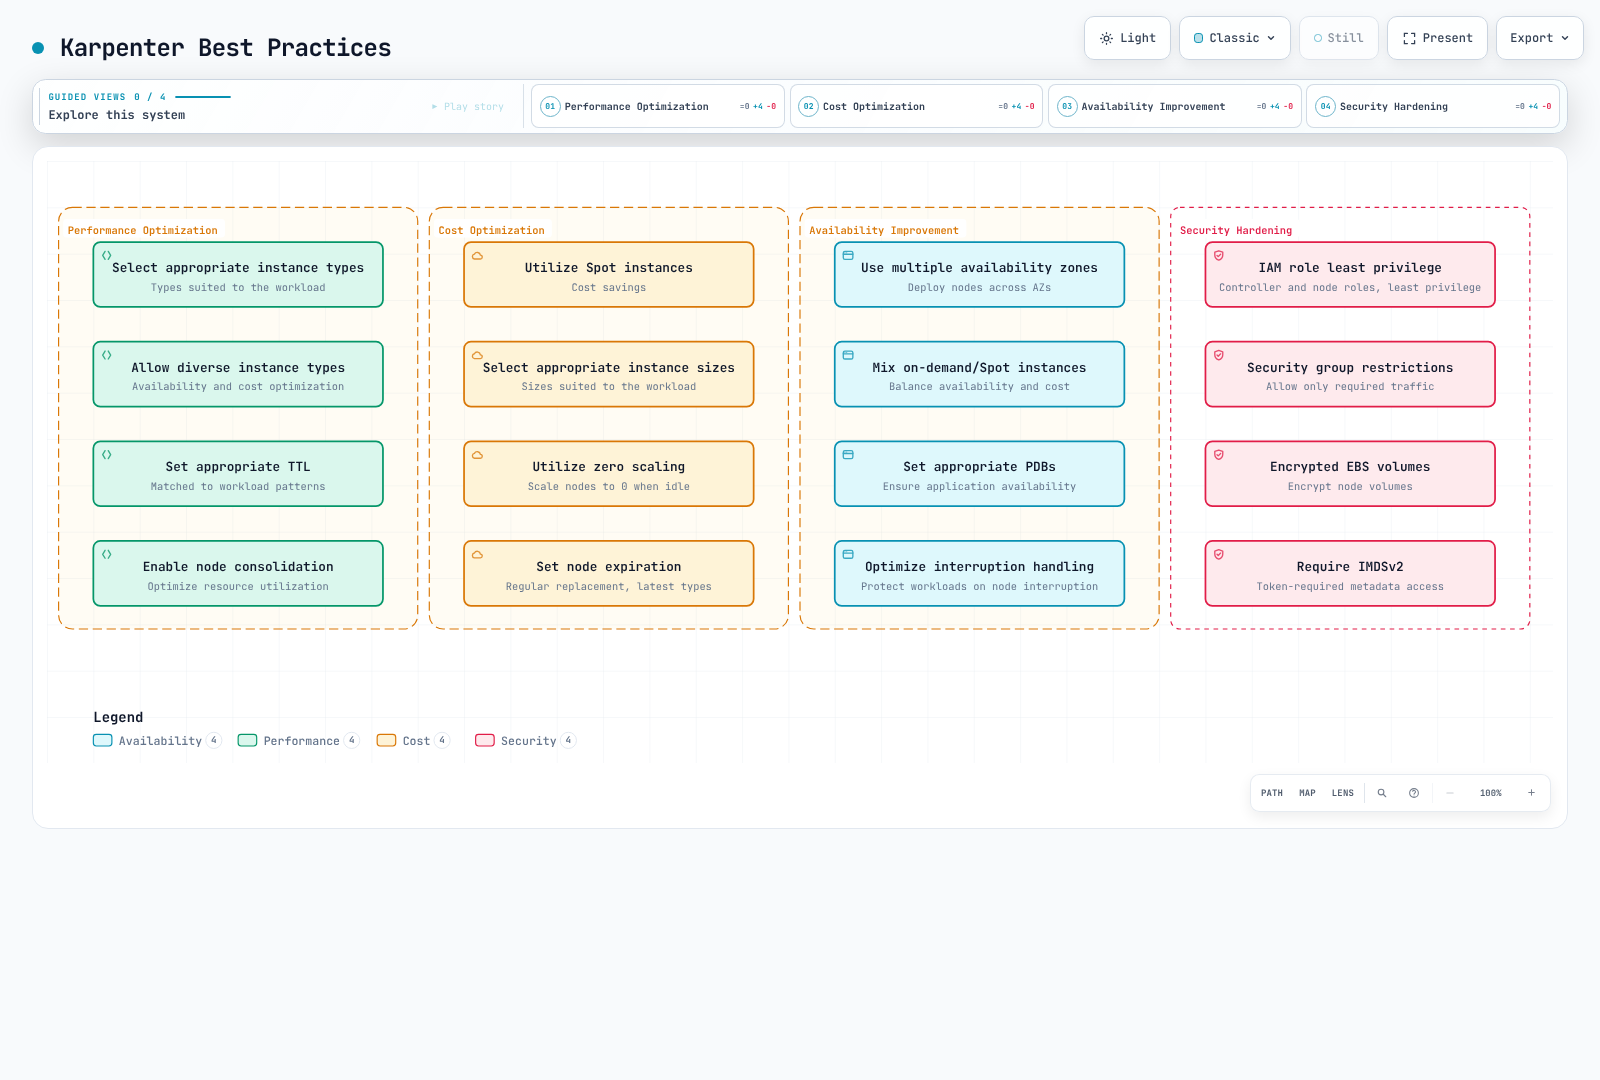
性能优化
- 选择合适的实例类型:选择适合工作负载的实例类型
- 允许多种实例类型:允许使用多种实例类型以提高可用性并优化成本
- 设置合适的 TTL:设置符合工作负载模式的 TTL
- 启用节点 Consolidation:启用节点 Consolidation 以优化资源利用率
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: optimized
spec:
  template:
    spec:
      requirements:
      - key: node.kubernetes.io/instance-type
        operator: In
        values:
        - m5.large
        - m5.xlarge
        - m5.2xlarge
        - c5.large
        - c5.xlarge
        - c5.2xlarge
        - r5.large
        - r5.xlarge
        - r5.2xlarge
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: default
      expireAfter: 720h
  disruption:
    consolidationPolicy: WhenEmpty
    consolidateAfter: 30s
成本优化
- 利用 Spot 实例:使用 Spot 实例以节省成本
- 选择合适的实例规格:选择适合工作负载的实例规格
- 评估空节点移除:符合条件的 worker NodePool 可以缩减至零;控制器/引导计算资源和其他无关的集群成本仍然存在。
- 规划节点刷新:过期会根据当前约束轮换符合条件的容量;它不会自动选择更新的实例类型,也不会修补固定版本的 AMI。
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: cost-optimized
spec:
  template:
    spec:
      requirements:
      - key: karpenter.sh/capacity-type
        operator: In
        values:
        - spot
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: default
      expireAfter: 168h
  disruption:
    consolidationPolicy: WhenEmpty
    consolidateAfter: 30s
提高可用性
- 使用多个可用区:在多个可用区中部署节点
- 混用 On-demand 和 Spot 实例:平衡可用性和成本
- 设置合适的 PDB:在实际健康副本数量允许的范围内保护 Pod 免受自愿 eviction,同时配合冗余和恢复设计。
- 配置并测试中断处理:验证通知路径、关机期限和替换容量,不要假设服务一定不会中断。
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: high-availability
spec:
  template:
    spec:
      requirements:
      - key: topology.kubernetes.io/zone
        operator: In
        values:
        - us-west-2a
        - us-west-2b
        - us-west-2c
      - key: karpenter.sh/capacity-type
        operator: In
        values:
        - on-demand
        - spot
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: default
      expireAfter: 720h
  disruption:
    consolidationPolicy: WhenEmptyOrUnderutilized
    consolidateAfter: 60s
故障排查
常见问题
1. 节点预置失败
症状:Pod 一直处于 Pending 状态,且未预置节点
解决方案:
- 检查 Karpenter 日志
- 验证 IAM 权限
- 检查 NodePool 配置
# Check Karpenter logs
kubectl logs -n karpenter -l app.kubernetes.io/name=karpenter -c controller

# Check NodePool status
kubectl describe nodepool <name>

# Check pod events
kubectl describe pod <name>
2. 节点移除问题
症状:节点未按预期移除
解决方案:
- 检查 TTL 设置
- 验证节点 Consolidation 设置
- 检查 Pod 排空状态
# Check node status
kubectl describe node <name>

# Check node labels
kubectl get node <name> --show-labels

# Check Karpenter logs
kubectl logs -n karpenter -l app.kubernetes.io/name=karpenter -c controller --since=30m
3. 实例类型选择问题
症状:预置了意外的实例类型
解决方案:
- 检查 NodePool requirements
- 验证 Pod 资源请求
- 检查可用区约束
# Check NodePool requirements
kubectl get nodepool <name> -o yaml

# Check pod resource requests
kubectl describe pod <name>

# Check node information
kubectl describe node <name>
调试工具
# Check Karpenter version
kubectl get deployment -n karpenter karpenter -o jsonpath="{.spec.template.spec.containers[0].image}"

# Check Karpenter logs
kubectl logs -n karpenter -l app.kubernetes.io/name=karpenter -c controller

# Check NodePool list
kubectl get nodepools

# Check EC2NodeClass list
kubectl get ec2nodeclasses

# Check events
kubectl get events --sort-by='.lastTimestamp'

# Inspect the installed chart version and values before any optional log-level change.
helm list --namespace karpenter --filter '^karpenter$'
helm get values karpenter --namespace karpenter
kubectl get nodeclaims -o wide
结论
Karpenter 会根据工作负载和基础设施约束自动处理节点预置和生命周期管理。它可以改善容量管理,但可用性、性能和成本方面的效果仍需针对具体工作负载进行验证。
本文介绍了 Karpenter 的基本概念、安装方法、NodePool 和 EC2NodeClass 配置、中断处理、各种集成、与 Amazon EKS 的集成、最佳实践和故障排查。
借助 Karpenter,你可以简化集群管理、优化资源利用率并降低成本。尤其是在 Amazon EKS 这类云托管 Kubernetes 环境中,你可以充分发挥 Karpenter 的优势。
后续步骤
- 使用 Karpenter 实施成本优化策略
- 为各种工作负载类型配置 NodePool
- 设计混合集群架构
- 将 Karpenter 与其他 Kubernetes 工具集成
- 制定高级节点生命周期管理策略
参考资料
- Karpenter 官方文档
- Karpenter AWS Provider 仓库
- Amazon EKS Workshop - Karpenter
- AWS 博客 - Karpenter
- Karpenter 最佳实践
- Karpenter GitHub 发行版本
- AWS 最新动态 - Karpenter ARC Zonal Shift 支持
- AWS 最新动态 - Amazon EKS Managed Node Group Warm Pool 支持
测验
如需测试你在本章学到的内容,请尝试主题测验。
本次修订已核实的主要参考资料:兼容性、NodePool、EC2NodeClass、Disruption、支持策略、固定版本的 Helm values、Readiness 污点、固定版本的 DRA 选项、EKS 节点 IAM、Fargate profiles。