第 2 部分:Spark Operator
审查基线:Kubeflow operator/chart 2.5.2;Apache operator 1.0.0 / chart 1.8.0
示例运行时:Kubeflow 实验使用 Spark 4.0.4,与其控制器镜像的提交运行时匹配;Apache 示例使用 Spark 4.2.0
最后审查:2026 年 9 月 12 日
两个项目,使用不同 API
这是分别维护的两个项目,并不是同一份清单的可互换实现。应根据所需 API/生命周期、已有资源、受支持的运行时组合和运维测试结果进行选择。项目历史长短或未经测量的流行度都不能保证兼容性。
| 项目 | Kubeflow Spark Operator | Apache Spark Kubernetes Operator |
|---|---|---|
| 已审查的发行版 | 2.5.2 | 1.0.0 |
| Helm chart | 2.5.2 | 1.8.0;chart 和应用版本不同 |
| 此处使用的应用 API | sparkoperator.k8s.io/v1beta2 | spark.apache.org/v1 |
| 主要工作负载类型 | SparkApplication、ScheduledSparkApplication;另有独立的 SparkConnect API | SparkApplication 和 SparkCluster |
| 配置模型 | type/mode/driver/executor/restartPolicy | runtimeVersions/driverSpec/executorSpec/applicationTolerations/sparkConf |
| 这些 chart 使用的准入方式 | 可变更与验证 Webhook | 此 chart 不会安装等效的 Pod 变更 Webhook |
Apache 的 SparkCluster 可以管理常驻 Spark 集群,其执行模型不同于原生 Kubernetes SparkApplication 流程。其 Comet/Gluten 示例仍需要合适的插件二进制文件/镜像、类路径、配置以及运行时/架构兼容性。仅安装 Operator 并不会自动启用加速,也不能因此断言某个 Operator 总是更优。
两个 API 组可以共存,但需要有意配置监听范围、名称、Webhook 选择器和 RBAC。下方实验只选择一种安装路径。应使用资源的完整限定名称,避免 sparkapp 等快捷写法带来的歧义。
协调流程会增加什么
普通的 spark-submit 可以等待作业完成,并展示 Pod/日志/UI/事件日志状态;脚本、属性和 Pod 模板也可以在 Git 中进行版本管理。它并非天然就是“发后不管”。它本身不会创建由 Operator 管理的 SparkApplication CR、定时资源控制器或自动应用重试。
Kubeflow 会有意使用 spark.kubernetes.submission.waitAppCompletion=false 提交作业,然后协调 Pod/应用状态。它也会观察执行器 Pod 并执行生命周期清理;“Operator 只接触 Driver”这一说法并不正确。Spark Driver 仍然会申请执行器容量并分配 Spark 任务。
准备实验命名空间和身份
使用与集群兼容的 kubectl/Helm。chart 示例针对 Kubernetes 1.36 渲染;Apache Spark 4.2 工作负载要求 Kubernetes 1.34 或更高版本。不要根据旧 README 表格推断当前推荐的 Kubernetes 最低版本。
Kubeflow 控制器固定使用 Spark 4.0.4 作为提交运行时。本章让该实验工作负载与 4.0.4 对齐;第 1 部分的直接提交方式单独使用 4.2。SparkApplication 的 sparkVersion 字段不会升级控制器内部安装的 Spark。在采用其他提交器/工作负载组合前,应显式进行测试。
安装任一 chart 前,先保存/应用 job-rbac.yaml。它与第 1 部分的命名空间级作业权限相符,并将 Driver 和执行器身份分开。如果已使用这些名称,应先检查现有资源。
apiVersion: v1
kind: Namespace
metadata:
  name: spark-jobs
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: spark-driver
  namespace: spark-jobs
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: spark-executor
  namespace: spark-jobs
automountServiceAccountToken: false
---
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  name: spark-driver
  namespace: spark-jobs
rules:
- apiGroups:
  - ''
  resources:
  - pods
  - services
  - configmaps
  verbs:
  - create
  - get
  - list
  - watch
  - delete
  - patch
---
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: spark-driver
  namespace: spark-jobs
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: Role
  name: spark-driver
subjects:
- kind: ServiceAccount
  name: spark-driver
namespace: spark-jobskubectl apply -f job-rbac.yamlSparkPi 不需要 AWS 数据访问。Operator API 权限、Driver API 权限和 AWS 数据权限是不同的问题。
选项 A:安装 Kubeflow
将以下内容保存为 kubeflow-values.yaml。默认 chart 监听的是 default 命名空间,而不是它自身的安装命名空间;监听的命名空间必须与作业命名空间一致。此处作业运行在 spark-jobs 中,chart 会复用前面准备的作业 RBAC。资源大小和提交并发数只是需要测量的实验起始值。
spark:
  jobNamespaces:
  - spark-jobs
  jobNamespaceSelector: ''
  serviceAccount:
    create: false
  rbac:
    create: false
webhook:
  enable: true
  resources:
    requests:
      cpu: 100m
      memory: 128Mi
    limits:
      cpu: '1'
      memory: 512Mi
controller:
  workers: 2
  resources:
    requests:
      cpu: 500m
      memory: 1Gi
    limits:
      cpu: '2'
      memory: 2Gi
在 2.5.2 中,webhook.enable 默认已经是 true。这里显式设置它是为了记录选择,而不是因为省略该标志会禁用 Webhook。有些自定义配置会使用准入机制,另一些则会转换为原生 Spark 配置。禁用 Webhook 并不意味着所有配置都会被忽略。
下面的校验和与下载的 GitHub 发行版资源文件一致。本次审查发现,仓库索引中这一版本的摘要与资源文件元数据/下载结果不同,因此示例使用直接核实过的发行包。
# Fresh installation after reviewing/applying job-rbac.yaml.
curl --fail --location --silent --show-error 'https://github.com/kubeflow/spark-operator/releases/download/v2.5.2/spark-operator-2.5.2.tgz' -o spark-operator-2.5.2.tgz
printf '%s\n' '762be5b8632ecfe12eb20fff54450ddae0427f09506422107c508a0d1d38655b  spark-operator-2.5.2.tgz' | sha256sum --check -
helm install spark-operator ./spark-operator-2.5.2.tgz \
  --namespace spark-operator --create-namespace \
  --values kubeflow-values.yaml --wait --timeout 5m
kubectl -n spark-operator get deployments,pods
这是全新安装示例。升级时应审查 CRD 迁移流程:普通 Helm 升级不会自动替换 crds/ 中的 CRD,而此 chart 的 hook.upgradeCrd 则是一个显式启用选项。不要在常规升级中删除共享 CRD,因为这会影响对应的自定义资源。
在 EKS 中,应验证控制平面能访问 Webhook Service/端点、提供的证书/CA bundle 以及选择器。此 chart 中服务端监听 9443。使用 failurePolicy=Fail 时,Webhook 不可用可能阻止匹配的准入请求。Deployment 就绪并不能证明 Spark 工作负载一定可以通过准入。
Kubeflow SparkApplication
将以下内容保存为 spark-pi.yaml。它使用固定镜像中真实存在的示例,避免依赖未指定的 S3 对象或缺失的自定义 ETL 类。
apiVersion: sparkoperator.k8s.io/v1beta2
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: spark-jobs
spec:
  type: Scala
  mode: cluster
  image: apache/spark:4.0.4@sha256:94ad730f7510002d8a1615de269f27cdeca4d4eef51657384db3fa9246b5a4d8
  imagePullPolicy: IfNotPresent
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: local:///opt/spark/examples/jars/spark-examples_2.13-4.0.4.jar
  arguments:
  - '10'
  sparkVersion: 4.0.4
  restartPolicy:
    type: OnFailure
    onFailureRetries: 3
    onFailureRetryInterval: 30
    onSubmissionFailureRetries: 3
    onSubmissionFailureRetryInterval: 30
  driver:
    cores: 1
    coreLimit: '1'
    memory: 1g
    serviceAccount: spark-driver
    podSecurityContext: &id001
      runAsNonRoot: true
      runAsUser: 185
      seccompProfile:
        type: RuntimeDefault
    securityContext: &id002
      allowPrivilegeEscalation: false
      capabilities:
        drop:
        - ALL
  executor:
    cores: 1
    coreLimit: '1'
    instances: 2
    memory: 1g
    serviceAccount: spark-executor
    terminationGracePeriodSeconds: 60
    podSecurityContext: *id001
securityContext: *id002在此版本中,driver.serviceAccount 和 executor.serviceAccount 都是有效字段。重试设置适用于提交/应用尝试,不只是原地重启容器。重新运行可能会重复产生输出副作用;实际作业应采用幂等或事务型输出设计。
执行器宽限期字段由 Kubeflow Pod mutator 应用。它与第 1 部分讨论的原生 Spark 4.2 模板覆盖不同。如果启用 Spark decommissioning 或自定义生命周期钩子,应检查所选 Operator、Spark 运行时和 Webhook 如何组合这些机制。
kubectl apply -f spark-pi.yaml
kubectl -n spark-jobs get sparkapplications.sparkoperator.k8s.io spark-pi \
  -o jsonpath='{.status.applicationState.state}{"\n"}'
kubectl -n spark-jobs describe sparkapplications.sparkoperator.k8s.io spark-pi
DRIVER_POD="$(kubectl -n spark-jobs get sparkapplications.sparkoperator.k8s.io spark-pi \
  -o jsonpath='{.status.driverInfo.podName}')"
: "${DRIVER_POD:?Driver pod name is not available yet; inspect submission events}"
kubectl -n spark-jobs logs "$DRIVER_POD"
读取当前状态和事件(包括提交失败),再获取实际 Driver Pod 名称。kubectl get -w 会开启一个需要手动中断的持续观察;它不是有限时的“等待成功”步骤。COMPLETED 表示进程完成,不代表外部数据集正确。
明确使用 UTC 的定时调度
将以下内容保存为 scheduled-spark-pi.yaml。这里有意调度同一个无害的 Pi 示例;处理真实数据前,应替换为已打包并测试过的 ETL 程序。
apiVersion: sparkoperator.k8s.io/v1beta2
kind: ScheduledSparkApplication
metadata:
  name: daily-spark-pi
  namespace: spark-jobs
spec:
  schedule: 0 2 * * *
  timeZone: UTC
  concurrencyPolicy: Forbid
  successfulRunHistoryLimit: 2
  failedRunHistoryLimit: 2
  template:
    type: Scala
    mode: cluster
    image: apache/spark:4.0.4@sha256:94ad730f7510002d8a1615de269f27cdeca4d4eef51657384db3fa9246b5a4d8
    imagePullPolicy: IfNotPresent
    mainClass: org.apache.spark.examples.SparkPi
    mainApplicationFile: local:///opt/spark/examples/jars/spark-examples_2.13-4.0.4.jar
    arguments:
    - '10'
    sparkVersion: 4.0.4
    restartPolicy:
      type: OnFailure
      onFailureRetries: 3
      onFailureRetryInterval: 30
      onSubmissionFailureRetries: 3
      onSubmissionFailureRetryInterval: 30
    driver:
      cores: 1
      coreLimit: '1'
      memory: 1g
      serviceAccount: spark-driver
      podSecurityContext: &id001
        runAsNonRoot: true
        runAsUser: 185
        seccompProfile:
          type: RuntimeDefault
      securityContext: &id002
        allowPrivilegeEscalation: false
        capabilities:
          drop:
          - ALL
    executor:
      cores: 1
      coreLimit: '1'
      instances: 2
      memory: 1g
      serviceAccount: spark-executor
      terminationGracePeriodSeconds: 60
      podSecurityContext: *id001
      securityContext: *id002
2.5.2 支持 timeZone;否则默认使用控制器的本地时区。这里的调度时间表示 UTC 02:00。Forbid 仅检查此 ScheduledSparkApplication 的上一次运行,不会阻止重试、手动运行或其他调度器造成重复副作用。历史数量限制的是保留的子运行记录,不是数据备份。
kubectl apply -f scheduled-spark-pi.yaml
kubectl -n spark-jobs get scheduledsparkapplications.sparkoperator.k8s.io daily-spark-pi -o yaml
# Stop future schedule triggers; this does not itself terminate an active child run.
kubectl -n spark-jobs patch scheduledsparkapplications.sparkoperator.k8s.io daily-spark-pi \
  --type=merge -p '{"spec":{"suspend":true}}'
选项 B:Apache Operator,采用不同路径
在此实验中,应使用 apache-values.yaml 替代选项 A。它会监听 spark-jobs,使用命名空间级角色,并复用已有的作业身份。chart 注释可能使用旧属性写法;渲染后的配置会设置 spark.kubernetes.operator.watchedNamespaces=spark-jobs。
workloadResources:
  namespaces:
    create: false
    overrideWatchedNamespaces: true
    data:
    - spark-jobs
  serviceAccount:
    create: false
  role:
    create: false
  clusterRole:
    create: false
  roleBinding:
    create: false
operatorRbac:
  clusterRole:
    create: false
  clusterRoleBinding:
    create: false
  role:
    create: true
  roleBinding:
create: true# Fresh installation after reviewing/applying job-rbac.yaml.
curl --fail --location --silent --show-error 'https://github.com/apache/spark-kubernetes-operator/releases/download/1.0.0/spark-kubernetes-operator-1.8.0.tgz' -o spark-kubernetes-operator-1.8.0.tgz
printf '%s\n' '7536a8849b8a7c242283d0e393b5e0ec56365f34ec93717b158c76dfa1036a06 spark-kubernetes-operator-1.8.0.tgz' | sha256sum --check -
helm install asf-spark-operator ./spark-kubernetes-operator-1.8.0.tgz \
--namespace spark-operator-asf --create-namespace \
--values apache-values.yaml --wait --timeout 5m
kubectl -n spark-operator-asf get deployments,podsApache 发行版与 Kubeflow 具有不同的生命周期模型和运行时镜像。应使用 Apache 发布的镜像;工作负载的 Java 版本要求不能用来推断 Operator 镜像所需的 Java 版本。
此 v1 示例使用 Spark 4.2.0,并短暂保留资源以供检查:
apiVersion: spark.apache.org/v1
kind: SparkApplication
metadata:
  name: spark-pi-asf
  namespace: spark-jobs
spec:
  runtimeVersions:
    sparkVersion: 4.2.0
  mainClass: org.apache.spark.examples.SparkPi
  jars: local:///opt/spark/examples/jars/spark-examples.jar
  driverArgs:
  - '10'
  sparkConf:
    spark.kubernetes.namespace: spark-jobs
    spark.kubernetes.container.image: spark:4.2.0-scala2.13-java21-ubuntu
    spark.kubernetes.authenticate.driver.serviceAccountName: spark-driver
    spark.kubernetes.authenticate.executor.serviceAccountName: spark-executor
    spark.executor.instances: '2'
  applicationTolerations:
    resourceRetainPolicy: Always
    ttlAfterStopMillis: 600000
ttlAfterStopMillis: 600000 允许控制器在应用最终停止后删除应用及相关资源。resourceRetainPolicy: Always 会保留 Operator 创建的资源,直到执行清理;它不会覆盖 Driver 自身的执行器/Service 删除设置,也不会跨重试保留资源。
kubectl apply -f apache-spark-pi.yaml
kubectl -n spark-jobs get sparkapplications.spark.apache.org spark-pi-asf -o yaml
该发行版也提供旧版 v1beta1 schema,但本文的新示例使用 v1。只修改 Kubeflow 资源的 apiVersion 并不能迁移其字段、状态或重试/保留行为。不要将 Kubeflow 的 ScheduledSparkApplication 或 restartPolicy schema 用于 Apache API。
Pod 创建前后会发生什么
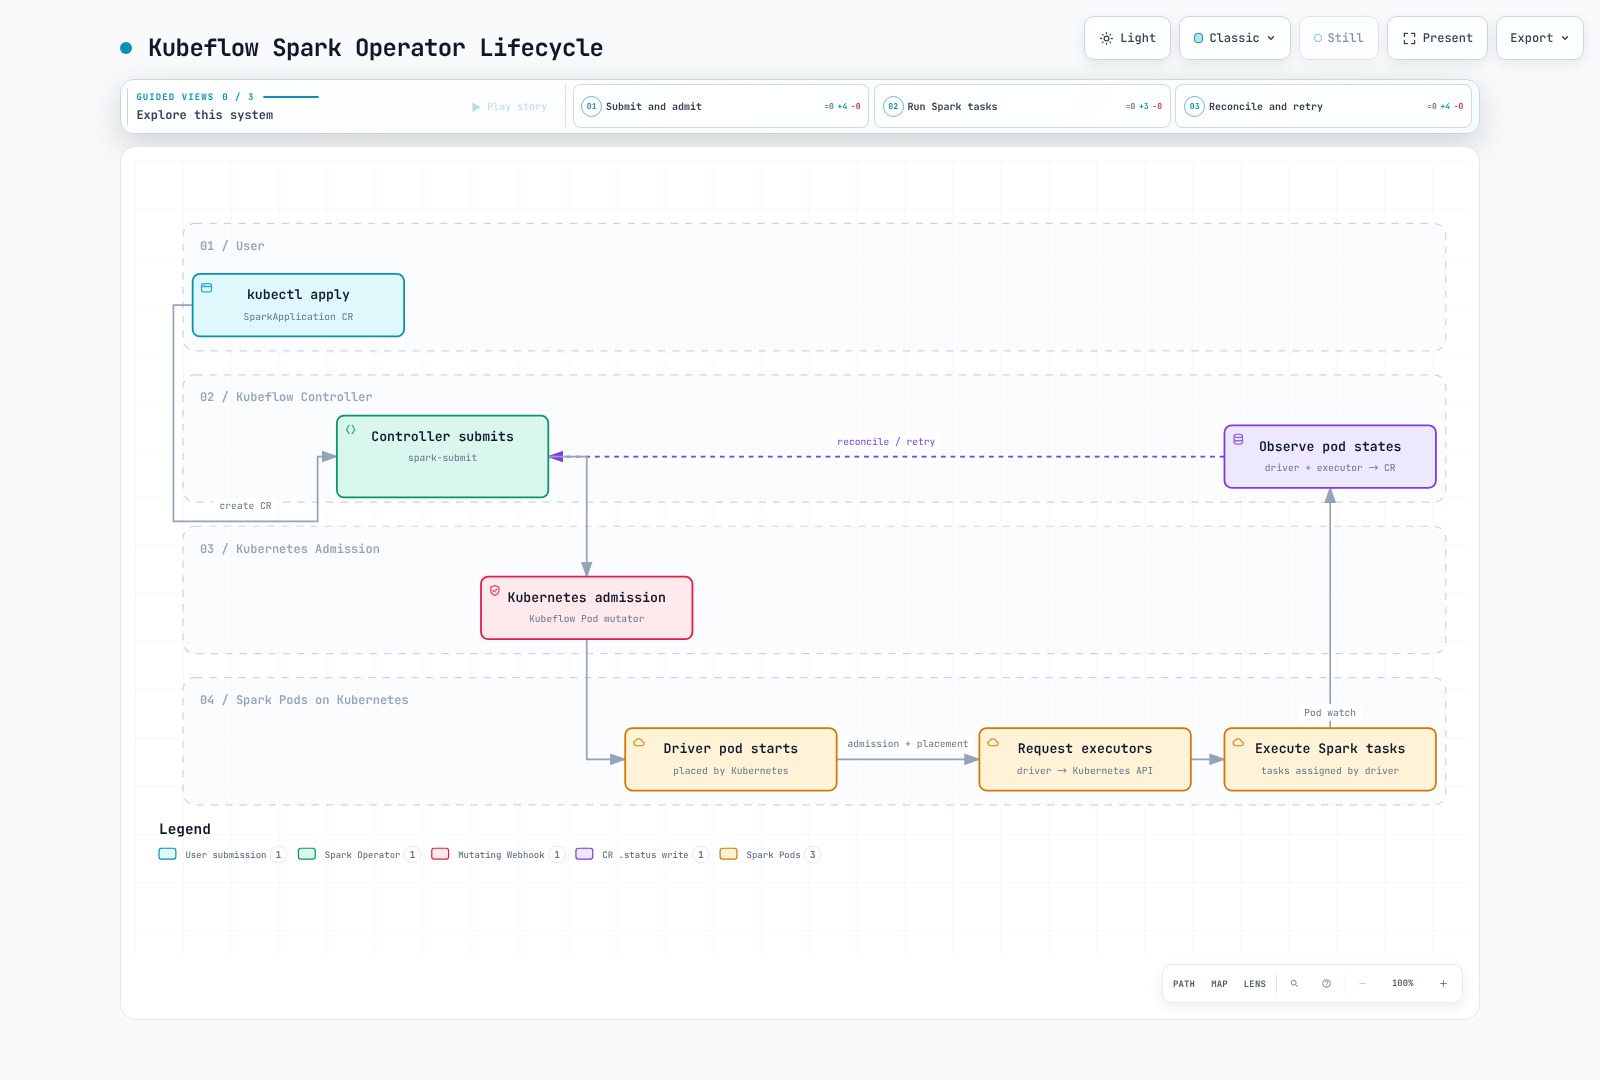
Webhook 属于 Kubernetes 准入流程,它不能替代节点调度或 Spark 任务调度。两个 Operator 都需要单独评估架构/API;此流程展示的是 Kubeflow。
存储、身份和指标
正确放置临时卷
在 Kubeflow API 中,卷属于 spec.volumes,挂载点则位于 driver/executor 下。spec.driver.volumes 和 spec.executor.volumes 并不是此 CRD 中的字段。以下是针对完整 Kubeflow 示例的 JSON merge patch:
spec:
  volumes:
  - name: spark-local-dir-scratch
    emptyDir:
      sizeLimit: 8Gi
  driver:
    volumeMounts:
    - name: spark-local-dir-scratch
      mountPath: /var/data/spark-local
  executor:
    volumeMounts:
    - name: spark-local-dir-scratch
mountPath: /var/data/spark-localkubectl -n spark-jobs patch sparkapplications.sparkoperator.k8s.io spark-pi \
--type=merge --patch-file scratch.patch.yaml运行真实工作负载前应先应用存储自定义配置;更新应用可能触发重新提交。JSON merge patch 会替换数组,因此改造其他应用时,应将已有卷/挂载列表合并到这个 patch 中。
spark-local-dir- 前缀具有特殊处理:Operator 会将这些本地卷/挂载转换为原生 Spark 卷配置,而通用 Pod 卷 mutator 会跳过它们。其他自定义卷可以使用 Webhook 路径。不要认为所有字段都由同一种机制实现。
额外添加 emptyDir 不会创建独立的物理磁盘,也不会选择 NVMe。除非由内存支持,否则它会使用节点配置的文件系统。kubelet/容器文件系统可能位于 EBS、实例存储或其他已配置的存储布局上。应配置/验证节点存储或合适的持久卷,并规划 ephemeral-storage 请求、限制和磁盘压力行为。
IRSA 与 Pod Identity 不同
对于 S3 作业,应为 Driver/执行器身份配置实际数据权限及信任关系/关联配置,同时准备兼容的 Hadoop S3A/AWS 库和凭证提供程序。只有标准镜像、ARN 注解或 s3a:// 文本都不够。获取工件/模板的进程也需要相应访问权限。
- IRSA 使用 ServiceAccount 角色注解、OIDC 信任关系和 Web 身份凭证交换。
- EKS Pod Identity 使用身份关联和 Pod Identity Agent/容器凭证路径;它不会通过 IRSA 角色注解建立身份关联。
- Kubernetes RBAC 不会授予 S3 权限。应使用临时凭证,并在实际 Pod 中测试生效的身份和数据访问。
第 5 部分提供完整的数据访问与安全示例。不要将静态 AWS 密钥放入应用 spec 或镜像。
控制器指标不等于工作负载 JMX 指标
chart 默认的 Prometheus 端点在 8080 上公开 Operator 指标。它不会自动向每个 Spark JVM 添加 JMX Java agent。工作负载监控需要显式配置应用,并在镜像中提供适当的 exporter JAR/配置,同时设置抓取/发现机制。原生 Spark 指标端点和事件/历史日志是其他可用机制。详细设置参见第 5 部分。
清理和验证范围
删除演示运行前,应暂停定时任务,并检查删除父资源是否会级联删除子资源。应使用预期的 API 组:
# Kubeflow demo resources, if installed:
kubectl -n spark-jobs delete scheduledsparkapplications.sparkoperator.k8s.io daily-spark-pi
kubectl -n spark-jobs delete sparkapplications.sparkoperator.k8s.io spark-pi
# Apache demo resource, if installed:
kubectl -n spark-jobs delete sparkapplications.spark.apache.org spark-pi-asf
chart 渲染和已发布 CRD 检查可以验证资源形状、命名空间和配置路径,但不能证明实际 Webhook、控制器/运行时组合、S3 访问、数据正确性或重试恢复有效。将真实工作负载投入使用前,应检查生成的 Pod、状态和输出。
- Kubeflow Spark Operator 2.5.2
- Kubeflow 2.5.2 应用 API
- Kubeflow 2.5.2 定时调度 API
- Kubeflow 提交/配置转换
- Kubeflow Pod mutator
- Apache Operator 1.0.0
- Apache Operator 配置
- Apache Comet 示例和前提条件
- Apache Gluten 示例和前提条件
- Spark Kubernetes 配置