第 2 部分:Kubeflow Pipelines
支持的版本:Kubeflow Pipelines 2.16.1、Kubeflow Community Distribution 26.03.1 已检查的最新独立版本:KFP 2.17.2(2026 年 9 月 4 日;PyPI 上最新的
kfpSDK:2.17.0),检查日期为 2026 年 10 月 12 日;示例使用 2.16.1 最后更新:2026 年 10 月 12 日
实验环境设置
本地编译需要 Python 和 kfp==2.16.1;本章使用 Python 3.12 进行检查。上游 KFP 2.17.2 已发布(PyPI 上最新的 kfp SDK 包为 2.17.0),但此版本固定设置与 Community Distribution 26.03.1 相匹配。它并未验证新的 SDK/后端组合。
编译不会连接集群。远程执行需要兼容的 KFP 后端、经过身份验证的客户端以及命名空间权限。S3 还要求执行 ServiceAccount 使用工作负载身份,并要求访问制品的组件具备相应权限。
Kubeflow Pipelines 是什么
KFP 使用带类型的参数/制品连接各个组件,并跟踪运行记录。这里使用的开源 KFP 2.16.1 后端会将 IR 转换为 Argo Workflows。Argo 管理工作流顺序和 Pod 创建;Kubernetes 调度器负责将 Pod 放置到节点上。由于缓存任务、导入器和嵌套 DAG 的存在,并非每个逻辑任务都对应一次独立的用户容器执行。
KFP v2 架构:IR YAML 和后端执行
Community Distribution 26.03.1 捆绑了 KFP 2.16.1。旧版 v1 默认编译路径会生成 Argo Workflow YAML;v2 的 Compiler().compile(...) 会生成基于 PipelineSpec 的 IR YAML。上传/存储 Pipeline 与创建 Run 是两项独立操作。仅上传不会执行 Pipeline。
IR 避免了直接编写 Argo 对象,但并不保证可以不受限制地移植到所有后端。IR/SDK 版本、支持的功能、Kubernetes 平台扩展、身份验证和存储都必须与目标环境相匹配。kfp 包还提供客户端 API 和 Python 组件执行支持;它的作用并不止于编译。
核心概念
| 概念 | 作用和范围 |
|---|---|
| Pipeline | 使用 @dsl.pipeline 编写的图;已上传的定义/版本与执行是分开的 |
| Component / Task | 可复用的组件定义和图中的一次调用;轻量级 Python 只是其中一种形式,此外还有容器、导入器和图 |
| Run / Experiment | Run 是一次执行;Experiment 是一组相关 Run;两者均不同于 Katib 的 Experiment CRD |
| Parameter | 字符串、数字和较小的结构化输入/输出值 |
| Artifact | 类似 Dataset/Model/Metrics 的对象,带有 URI、类型和元数据;不一定是单个文件 |
| MLMD | 已注册的执行、制品及其关系;不会自动记录每个外部副作用或文件完整性 |
元数据记录与制品字节是分开的。当可复现性和内容验证很重要时,请记录代码/镜像/数据的修订版本和哈希值。
Pipeline Run 如何在系统中流转
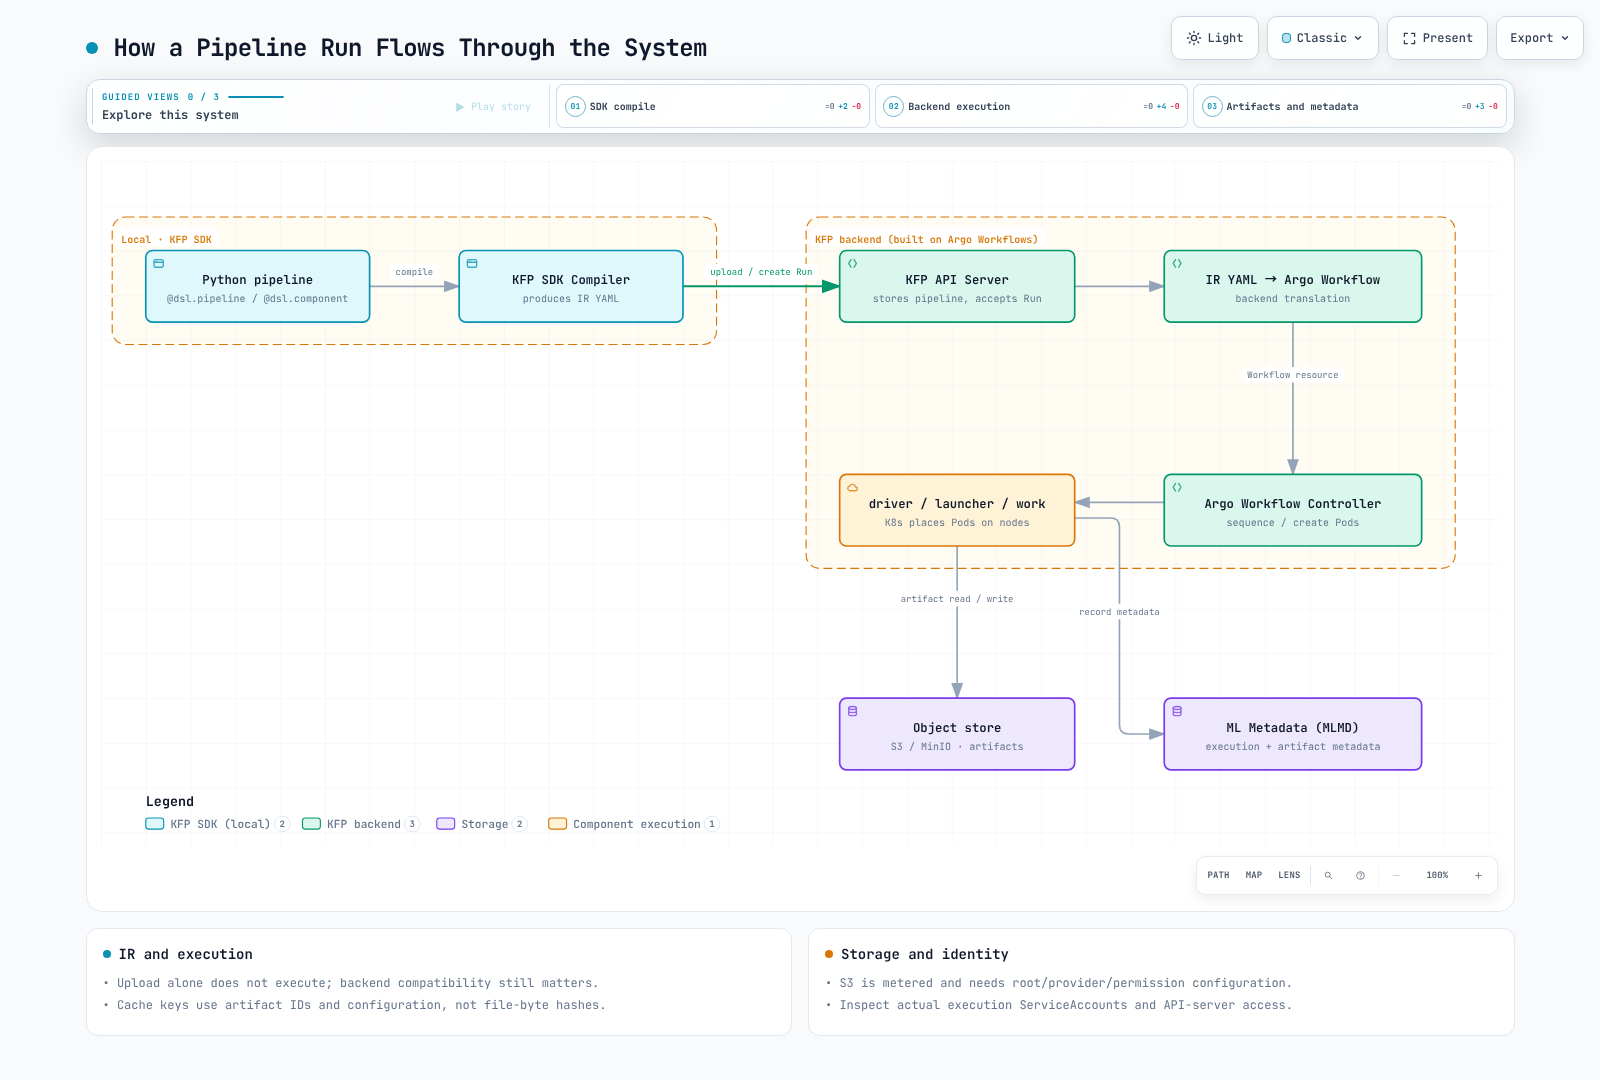
编译在本地进行。创建 Run 后,API server、Argo、KFP driver/launcher 和用户容器会协同工作。launcher/runtime 负责处理制品路径、传输和元数据。Kubernetes 对节点的放置仍与 Argo 的工作流排序相互独立。
EKS 专用制品存储
经审查的发行版默认安装中包含 MinIO,但并非每个 KFP 安装或制品 URI 都会使用它。请检查 Pipeline 根路径、导入的 URI 和提供程序配置。Metrics 等面向元数据的制品不一定是指标文件。
对于 S3,请根据当前对象存储指南配置 pipeline_root、提供程序和凭证链。S3 会产生存储、请求和传输费用;它不是默认免费的制品服务。
不要假设所有环境中的执行 ServiceAccount 都是 pipeline-runner。请检查 Run 选用的账户和实际 Pod,以及 API server/launcher 所需的访问权限。当前指南中记录了 IRSA。使用 Pod Identity 时,必须验证 SDK、agent、关联关系和运行时支持;本章未执行 AWS 集成。第 1 部分解释了这些边界以及旧版 AWS 发行版在安装方面的限制。
一个简单的两步 Pipeline
下面展示了一个最简的 data-prep -> train Pipeline,使用 KFP v2 SDK 的装饰器,并将带类型的 Dataset 制品从第一个组件传递给第二个组件:
from kfp import dsl, compiler
from kfp.dsl import Dataset, Model, Output, Input

@dsl.component(base_image="python:3.12-slim", packages_to_install=["pandas==2.3.3"])
def prepare_data(output_dataset: Output[Dataset]):
    import pandas as pd

    # In a real pipeline this would read from S3 or another source
    df = pd.DataFrame({"feature": [1, 2, 3, 4], "label": [0, 1, 0, 1]})
    df.to_csv(output_dataset.path, index=False)

@dsl.component(base_image="python:3.12-slim", packages_to_install=["scikit-learn==1.7.2", "pandas==2.3.3"])
def train_model(input_dataset: Input[Dataset], output_model: Output[Model]):
    import pandas as pd
    from sklearn.linear_model import LogisticRegression
    import pickle

    df = pd.read_csv(input_dataset.path)
    clf = LogisticRegression().fit(df[["feature"]], df["label"])
    with open(output_model.path, "wb") as f:
        pickle.dump(clf, f)

@dsl.pipeline(name="data-prep-train-pipeline")
def data_prep_train_pipeline():
    prep_task = prepare_data()
    train_task = train_model(input_dataset=prep_task.outputs["output_dataset"])

compiler.Compiler().compile(
    pipeline_func=data_prep_train_pipeline,
    package_path="data_prep_train_pipeline.yaml",
)
Output[Dataset] 到 Input[Dataset] 的连接会记录图依赖关系和制品类型。实际的 .path 准备和传输在运行时进行。编译不会验证存储或训练。
这些是轻量级 Python 组件。@dsl.component 会提取函数代码;它不会自动构建镜像。packages_to_install 会在执行时于基础镜像中安装依赖。之前的示例在 prepare_data 中遗漏了 pandas;现在两个组件都声明了各自的依赖,且已在本地检查其函数体。对于生产环境,请预先将依赖构建到容器中、固定其摘要,并单独测试该容器。此处的 Python 镜像标签和传递依赖并未构成完全锁定的构建。
只加载本练习生成的可信 pickle。加载外部 pickle 可能会执行任意代码。这个小型模型用于演示 API,并非模型质量验证结果。
缓存行为
在 2.16.1 中,缓存键包含输入参数值、输入制品名称/ID、输出规格、容器镜像字符串、命令/参数以及 PVC 名称。缓存查找按 Pipeline 名称和命名空间限定范围。每次查找时,它不会读取并哈希输入制品文件的字节。
因此,在同一制品 ID 背后修改文件、变更镜像标签,或更改外部数据库/API 状态,都可能导致缓存键保持不变。已有的缓存元数据也不能确保已删除的输出对象仍可供下游读取。请将数据版本/哈希值作为显式参数传入;对于可变的外部状态或副作用,可考虑禁用缓存。
# Inside the pipeline function, disable caching for this task.
prep_task.set_caching_options(enable_caching=False)
经过身份验证的客户端调用 create_run_from_pipeline_package(..., enable_caching=False) 时,会覆盖该 Run 的任务缓存设置;None 则保留编译后的任务设置。CLI 默认值和 KFP_DISABLE_EXECUTION_CACHING_BY_DEFAULT 也可以更改编译默认值;请在导入 KFP 之前设置该环境变量。
验证与来源
IR 使用 Python 3.12 / KFP 2.16.1 编译,并对依赖、类型和缓存设置进行了检查。函数体在本地 CPU 上使用 pandas 2.3.3 / scikit-learn 1.7.2 执行过。未测试 Docker、Argo、集群缓存复用、S3 和 Pod Identity 执行。
后续步骤
Pipeline 编写、编译并运行后,接下来通常会想了解:这些 Pipeline 组件背后的交互式开发工作最初是在什么地方进行的。第 3 部分:Kubeflow Notebooks介绍了团队用来编写和迭代代码的用户级 Notebook 环境,这些代码最终会打包成 Pipeline 组件。本系列后续的第 6 部分:KServe(Kubernetes 上的模型服务)将介绍如何为这些 Pipeline 最终生成的模型提供服务。
测验
要检验你在本章中的学习成果,请尝试主题测验。