Parte 2: Pipelines de Kubeflow
Versiones compatibles: Kubeflow Pipelines 2.16.1, Kubeflow Community Distribution 26.03.1 Última versión independiente comprobada: KFP 2.17.2 (4 de septiembre de 2026; último SDK de
kfpen PyPI: 2.17.0), comprobada el 12 de octubre de 2026; los ejemplos usan 2.16.1 Última actualización: October 12, 2026
Configuración del entorno de laboratorio
La compilación local requiere Python y kfp==2.16.1; este capítulo se comprobó con Python 3.12. KFP 2.17.2 upstream está disponible (el último paquete SDK de kfp en PyPI es 2.17.0), pero esta versión fijada coincide con Community Distribution 26.03.1. No valida una combinación nueva de SDK/backend.
La compilación no se comunica con un clúster. La ejecución remota necesita un backend de KFP compatible, un cliente autenticado y permisos de namespace. S3 también requiere identidad de carga de trabajo para la ServiceAccount de ejecución y los componentes que acceden a los artifacts.
Qué es Kubeflow Pipelines
KFP conecta componentes con parámetros/artifacts tipados y realiza el seguimiento de Runs. El backend open source de KFP 2.16.1 utilizado aquí traduce IR en Argo Workflows. Argo administra el orden del workflow y la creación de Pods; el scheduler de Kubernetes coloca los Pods en los nodos. Las tareas en caché, los importadores y los DAG anidados implican que no todas las tareas lógicas corresponden a una ejecución independiente de contenedor de usuario.
Arquitectura de KFP v2: IR YAML y ejecución de backend
Community Distribution 26.03.1 incluye KFP 2.16.1. La ruta de compilación predeterminada del legado v1 producía Argo Workflow YAML; Compiler().compile(...) de v2 produce IR YAML basado en PipelineSpec. Cargar/almacenar un pipeline y crear un Run son operaciones independientes. La carga por sí sola no lo ejecuta.
IR evita escribir objetos de Argo directamente, pero no garantiza portabilidad sin restricciones a todos los backends. Las versiones de IR/SDK, las características compatibles, las extensiones de plataforma de Kubernetes, la autenticación y el almacenamiento deben coincidir con el destino. El paquete kfp también proporciona API de cliente y compatibilidad para la ejecución de componentes de Python; su función no termina con la compilación.
Conceptos principales
| Concepto | Función y alcance |
|---|---|
| Pipeline | Grafo creado con @dsl.pipeline; las definiciones/versiones cargadas y las ejecuciones son independientes |
| Component / Task | Definición de componente reutilizable y una invocación de grafo; Python ligero es una forma junto con contenedores/importadores/grafos |
| Run / Experiment | Ejecución con entradas y un grupo de Runs relacionados; distinto del Experiment CRD de Katib |
| Parameter | Cadenas, números y valores de entrada/salida estructurados pequeños |
| Artifact | Objeto de estilo Dataset/Model/Metrics con URI, tipo y metadatos; no necesariamente un solo archivo |
| MLMD | Ejecuciones, artifacts y relaciones registrados; no es un registro automático de cada efecto secundario externo o de la integridad de archivos |
Los registros de metadatos y los bytes de artifacts son independientes. Registre las revisiones y hashes de código/imagen/datos cuando la reproducibilidad y la verificación de contenido sean importantes.
Cómo fluye un Run de pipeline por el sistema
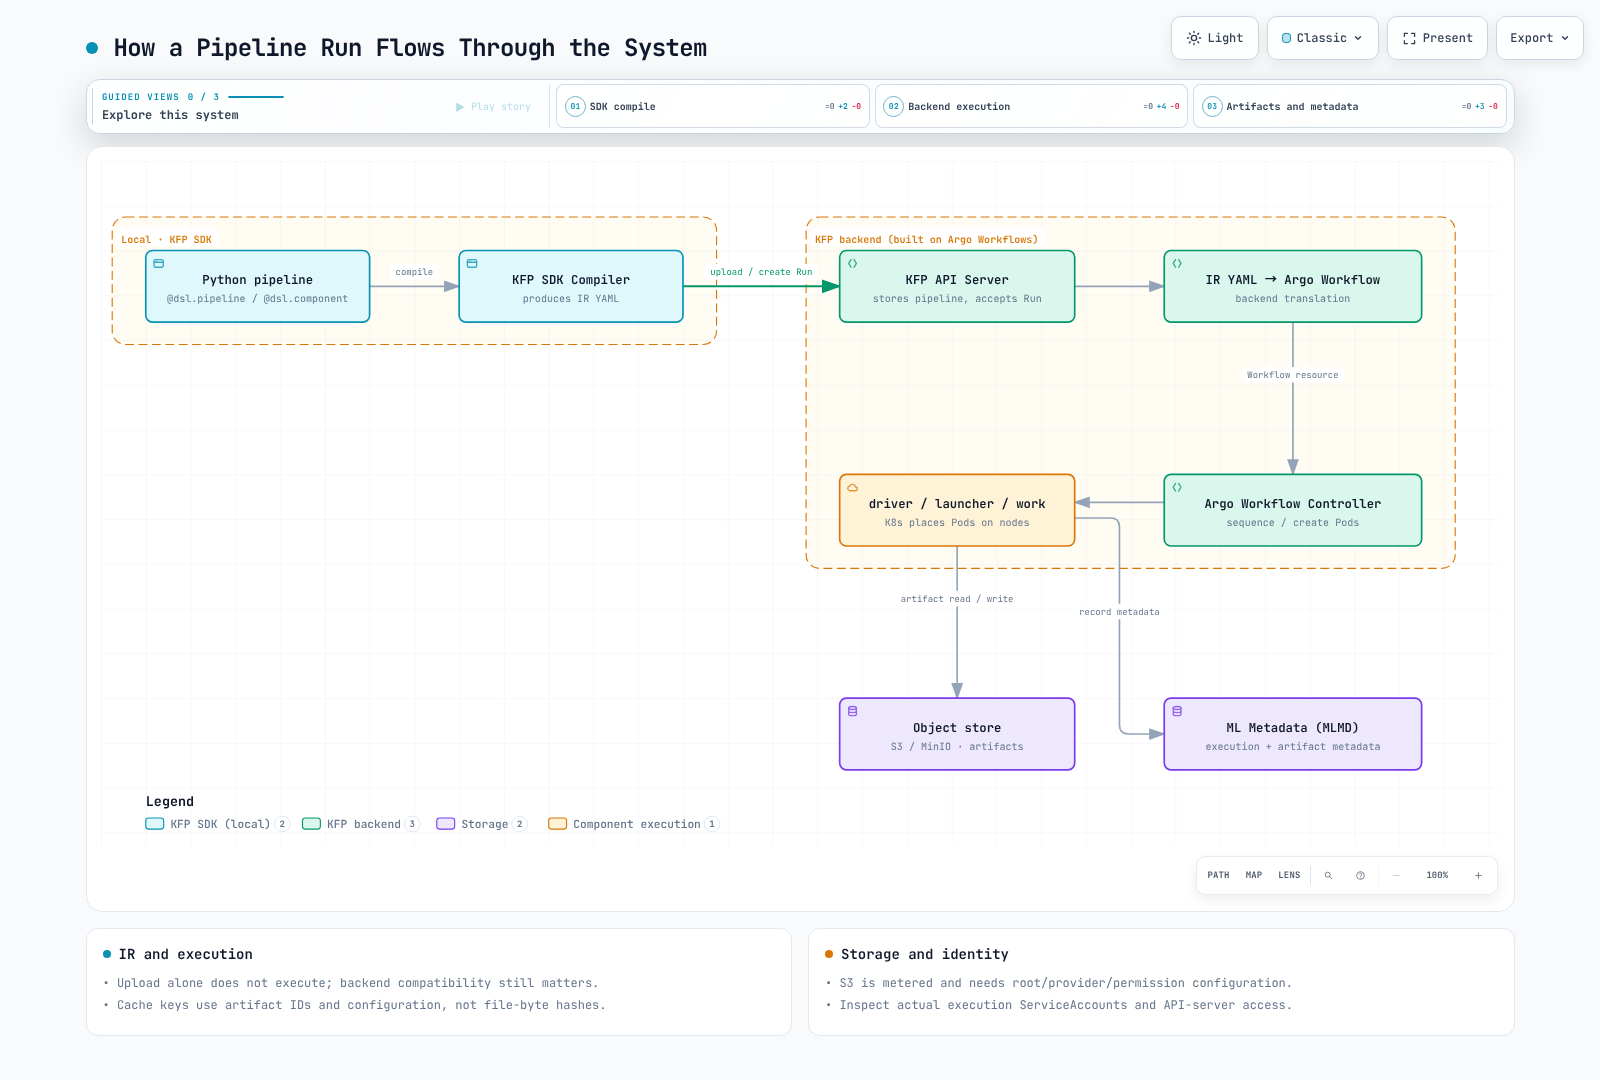
La compilación es local. Después de crear el Run, el servidor de API, Argo, el driver/launcher de KFP y los contenedores de usuario colaboran. El launcher/runtime gestiona las rutas, la transferencia y los metadatos de artifacts. La colocación de nodos de Kubernetes permanece separada de la secuenciación de workflows de Argo.
Almacenamiento de artifacts específico de EKS
La instalación predeterminada de la distribución revisada incluye MinIO, pero no todas las instalaciones de KFP ni las URI de artifacts lo utilizan. Inspeccione la raíz del pipeline, las URI importadas y la configuración del proveedor. Los artifacts orientados a metadatos, como Metrics, no son necesariamente archivos de métricas.
Para S3, configure pipeline_root, el proveedor y la cadena de credenciales mediante la guía actual de almacenamiento de objetos. S3 genera cargos de almacenamiento, solicitudes y transferencia; no es un servicio de artifacts gratuito predeterminado.
No asuma que pipeline-runner es la ServiceAccount de ejecución en todos los entornos. Inspeccione la cuenta seleccionada del Run y los Pods reales, además del acceso necesario para el servidor de API/launcher. IRSA está documentado en la guía actual. Pod Identity requiere verificar la compatibilidad del SDK, el agente, la asociación y el runtime; este capítulo no ejecutó la integración de AWS. La Parte 1 explica estos límites y la limitación de instalación de la distribución de AWS heredada.
Un pipeline simple de dos pasos
Lo siguiente ilustra un pipeline mínimo data-prep -> train que usa los decoradores del SDK de KFP v2, con un artifact Dataset tipado que se pasa del primer componente al segundo:
from kfp import dsl, compiler
from kfp.dsl import Dataset, Model, Output, Input

@dsl.component(base_image="python:3.12-slim", packages_to_install=["pandas==2.3.3"])
def prepare_data(output_dataset: Output[Dataset]):
    import pandas as pd

    # In a real pipeline this would read from S3 or another source
    df = pd.DataFrame({"feature": [1, 2, 3, 4], "label": [0, 1, 0, 1]})
    df.to_csv(output_dataset.path, index=False)

@dsl.component(base_image="python:3.12-slim", packages_to_install=["scikit-learn==1.7.2", "pandas==2.3.3"])
def train_model(input_dataset: Input[Dataset], output_model: Output[Model]):
    import pandas as pd
    from sklearn.linear_model import LogisticRegression
    import pickle

    df = pd.read_csv(input_dataset.path)
    clf = LogisticRegression().fit(df[["feature"]], df["label"])
    with open(output_model.path, "wb") as f:
        pickle.dump(clf, f)

@dsl.pipeline(name="data-prep-train-pipeline")
def data_prep_train_pipeline():
    prep_task = prepare_data()
    train_task = train_model(input_dataset=prep_task.outputs["output_dataset"])

compiler.Compiler().compile(
    pipeline_func=data_prep_train_pipeline,
    package_path="data_prep_train_pipeline.yaml",
)
La conexión de Output[Dataset] a Input[Dataset] registra una dependencia de grafo y un tipo de artifact. La preparación y transferencia reales de .path suceden en tiempo de ejecución. La compilación no valida el almacenamiento ni el entrenamiento.
Estos son componentes ligeros de Python. @dsl.component extrae el código de la función; no crea imágenes automáticamente. packages_to_install instala dependencias en tiempo de ejecución en la imagen base. El ejemplo anterior omitía pandas de prepare_data; ahora ambos componentes declaran sus dependencias y sus cuerpos de función se comprobaron localmente. Para producción, compile previamente las dependencias en un contenedor, fije su digest y pruebe ese contenedor por separado. La etiqueta de imagen de Python y las dependencias transitivas aquí no constituyen una compilación completamente bloqueada.
Cargue únicamente el pickle confiable producido por este ejercicio. Cargar un pickle externo puede ejecutar código arbitrario. Este modelo diminuto demuestra la API y no es un resultado de validación de la calidad del modelo.
Comportamiento de caché
En 2.16.1 la clave incluye valores de parámetros de entrada, nombres/ID de artifacts de entrada, especificaciones de salida, la cadena de imagen de contenedor, comando/argumentos y nombres de PVC. La búsqueda en caché tiene alcance por nombre de pipeline y namespace. No lee ni calcula hashes de los bytes de archivos de artifacts de entrada en cada búsqueda.
Por lo tanto, mutar un archivo detrás del mismo ID de artifact, una etiqueta de imagen o un estado de base de datos/API externo puede dejar la clave sin cambios. Los metadatos existentes en caché tampoco garantizan que los objetos de salida eliminados sigan siendo legibles downstream. Pase versiones/hashes de datos como parámetros explícitos y considere deshabilitar la caché para estados externos mutables o efectos secundarios.
# Inside the pipeline function, disable caching for this task.
prep_task.set_caching_options(enable_caching=False)
create_run_from_pipeline_package(..., enable_caching=False) de un cliente autenticado anula la caché de tareas para el Run; None conserva la configuración de tareas compilada. Los valores predeterminados de CLI y KFP_DISABLE_EXECUTION_CACHING_BY_DEFAULT también pueden cambiar los valores predeterminados de compilación; establezca la variable de entorno antes de importar KFP.
Validación y fuentes
IR se compiló con Python 3.12 / KFP 2.16.1 y se comprobó para dependencias, tipos y configuraciones de caché. Los cuerpos de función se ejecutaron localmente en CPU con pandas 2.3.3 / scikit-learn 1.7.2. No se probaron Docker, Argo, la reutilización de caché de clúster, S3 ni la ejecución de Pod Identity.
- Implementación de clave de caché 2.16.1
- Búsqueda y reutilización de caché 2.16.1
- Guía oficial de caché
- Componentes ligeros de Python
Próximos pasos
Con los pipelines creados, compilados y en ejecución, la siguiente pregunta suele ser dónde sucede en primer lugar el trabajo de desarrollo interactivo detrás de esos componentes de pipeline. La Parte 3: Kubeflow Notebooks cubre los entornos de notebooks por usuario que los equipos utilizan para crear e iterar sobre el código que termina empaquetado en componentes de pipeline y, más adelante en esta serie, la Parte 6: KServe — Servicio de modelos en Kubernetes cubre el servicio de los modelos que esos pipelines finalmente producen.
Cuestionario
Para comprobar lo que ha aprendido en este capítulo, pruebe el Cuestionario del tema.