Grafana Dashboards
Versiones compatibles: Grafana 13.2.1 · Chart de Helm comunitario 13.2.2
Última actualización: September 13, 2026
Introducción
Grafana consulta Prometheus, Loki, Tempo, CloudWatch y otras fuentes de datos, y ofrece dashboards (paneles de control) y alertas. Su base de datos de metadatos es independiente de los backends que retienen métricas, logs y trazas. Los ejemplos ejecutables se conectan a backends existentes en un clúster. Consulta el laboratorio de la pila de observabilidad para el despliegue de los backends.
Arquitectura
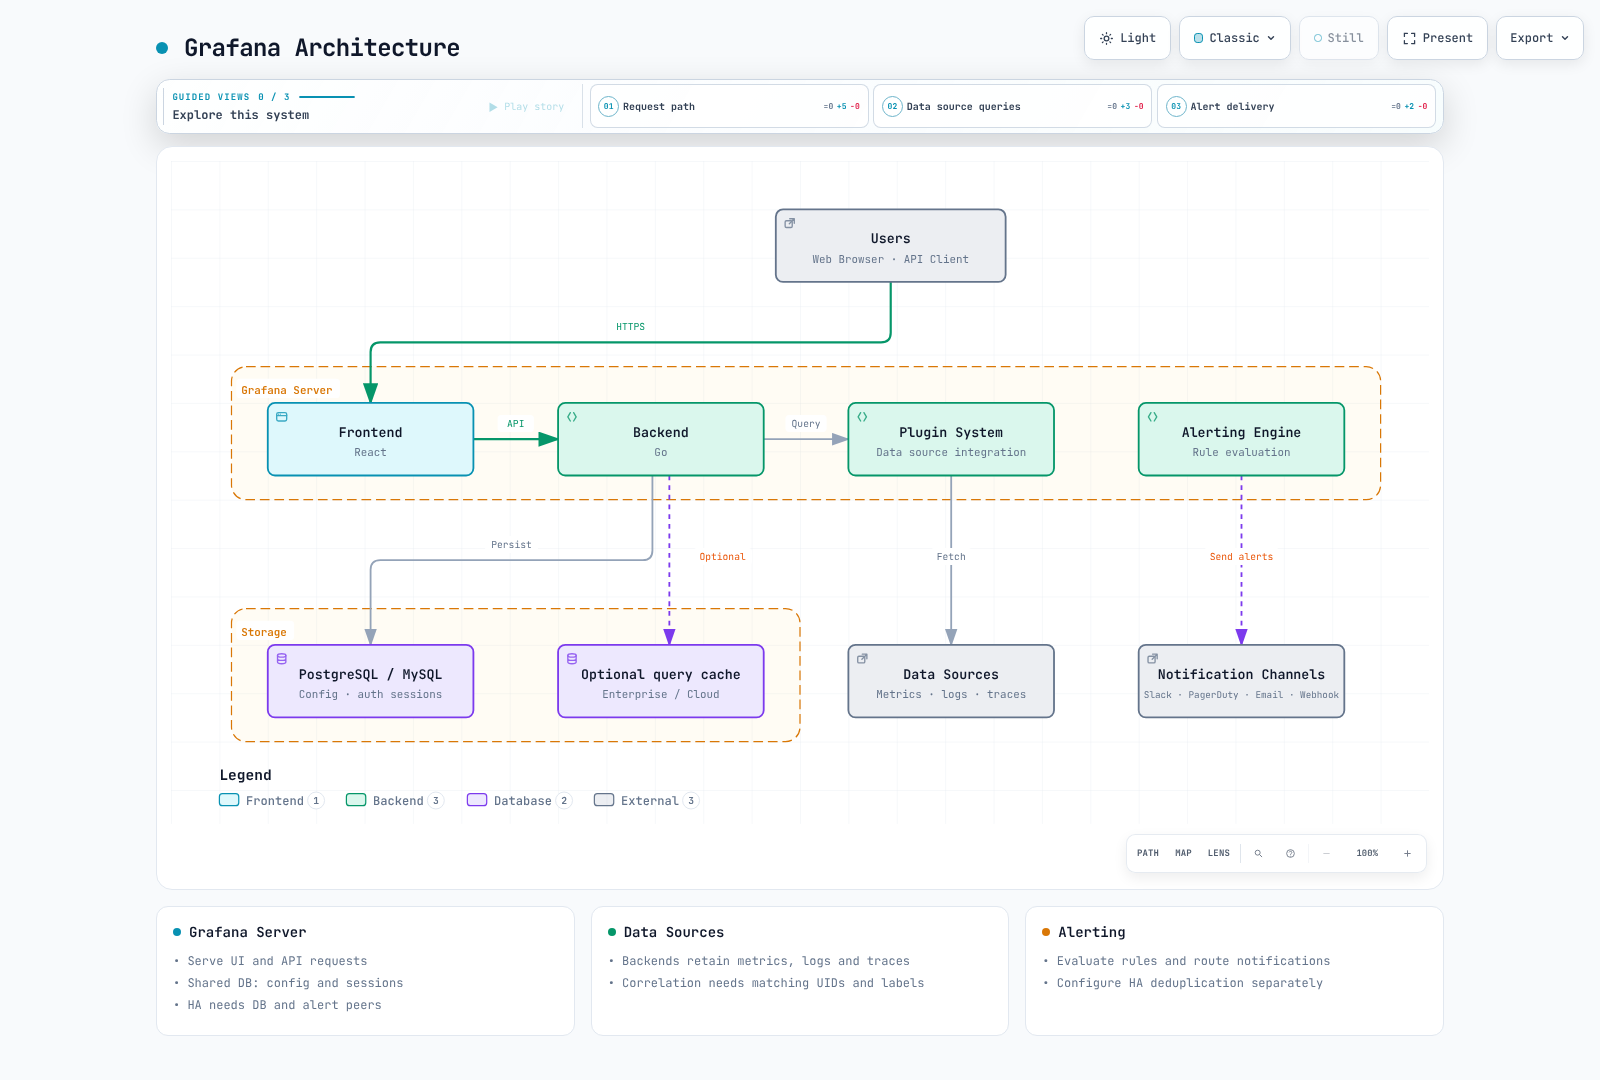
| Componente | Responsabilidad |
|---|---|
| Base de datos de Grafana | Usuarios, dashboards, configuración y sesiones de autenticación; PostgreSQL/MySQL compartido para HA |
| Fuentes de datos | Consultas y retención reales de métricas, logs y trazas |
| Grafana Alerting | Evaluación y enrutamiento de notificaciones; la deduplicación de notificaciones necesita una configuración de HA aparte |
| Caché de consultas opcional | Capacidad admitida en Enterprise/Cloud; Redis no es un almacén de sesiones obligatorio |
Despliegue con Helm
Instalación básica
El perfil predeterminado usa una réplica, SQLite, un PVC RWO y actualizaciones Recreate. Requiere la StorageClass gp3 y el driver CSI, y puede quedar no disponible durante las actualizaciones. La HA es un perfil aparte. El chart proviene del repositorio comunitario; su versión y el digest de la imagen están fijados.
Clona este repositorio y edita las tres URLs de endpoints.yaml para que coincidan con los Services y puertos reales. El ejemplo de Tempo 3.x usa el puerto 3200 de la API HTTP, que difiere de los puertos de ingesta OTLP. Los nombres de servicio de ejemplo no crean backends. Si los backends del laboratorio requieren mTLS, añade su configuración de certificado de CA/cliente a las fuentes de datos; el HTTP simple no puede eludirlo.
Estos comandos son para una instalación nueva. Rota las credenciales existentes mediante tu proceso establecido en lugar de sobrescribir Secrets. Lee localmente el archivo de contraseña privada generado al iniciar sesión; mantén su contenido fuera de Git, de los archivos de values y de los logs del terminal.
helm repo add grafana-community https://grafana-community.github.io/helm-charts
helm repo update grafana-community
kubectl create namespace monitoring --dry-run=client -o yaml | kubectl apply -f -
cd examples/observability/grafana

umask 077
GRAFANA_STATE=$(mktemp -d "$PWD/.grafana-private.XXXXXX")
printf '%s' admin > "$GRAFANA_STATE/admin-user"
python3 -c 'import secrets; print(secrets.token_hex(24), end="")' > "$GRAFANA_STATE/admin-password"
python3 -c 'import secrets; print(secrets.token_hex(32), end="")' > "$GRAFANA_STATE/secret-key"
python3 -c 'import secrets; print(secrets.token_hex(24), end="")' > "$GRAFANA_STATE/metrics-password"
kubectl -n monitoring create secret generic grafana-admin-credentials \
  --from-file=admin-user="$GRAFANA_STATE/admin-user" \
  --from-file=admin-password="$GRAFANA_STATE/admin-password"
kubectl -n monitoring create secret generic grafana-runtime \
  --from-file=secret-key="$GRAFANA_STATE/secret-key" \
  --from-file=metrics-password="$GRAFANA_STATE/metrics-password"

kubectl apply -f endpoints.yaml
kubectl -n monitoring create configmap grafana-datasources --from-file=datasources.yaml
kubectl -n monitoring create configmap grafana-alerts --from-file=alerts.yaml
kubectl -n monitoring create configmap grafana-docs-dashboards --from-file=dashboard.json
helm upgrade --install grafana grafana-community/grafana --version 13.2.2 \
  --namespace monitoring --values values.yaml --wait
kubectl -n monitoring port-forward service/grafana 3000:80 --address 127.0.0.1
Abre http://localhost:3000. El Service es de tipo ClusterIP y el port forwarding se enlaza únicamente a loopback. Antes de exponer Grafana, configura la autenticación, TLS y las políticas de red/acceso aprobadas.
Configuración de values.yaml
replicas: 1
deploymentStrategy:
  type: Recreate
persistence:
  enabled: true
  type: pvc
  storageClassName: gp3
  size: 10Gi
  accessModes:
  - ReadWriteOnce
admin:
  existingSecret: grafana-admin-credentials
  userKey: admin-user
  passwordKey: admin-password
serviceAccount:
  create: true
  name: grafana
  automountServiceAccountToken: false
El archivo completo conecta los montajes de Secrets, los UIDs fijos de las fuentes de datos, los archivos de dashboards y una alerta en pausa. Para el aprovisionamiento mediante ConfigMap montado, reinicia los Pods en secuencia después de actualizar los archivos para que el aprovisionamiento se ejecute de nuevo. Proporciona explícitamente cada archivo de values previsto en lugar de conservar ajustes históricos desconocidos con --reuse-values.
Alta disponibilidad
values-ha.yaml añade dos réplicas, deshabilita el PVC compartido y configura PostgreSQL externo con verify-full, un Service headless y el gossip de Alerting. Prepara por separado la HA de la base de datos, las copias de seguridad y la recuperación. No compartas un único archivo SQLite entre réplicas de Grafana.
La base de datos y el usuario de ejemplo son grafana. Prepara un Secret grafana-database que contenga host (DNS:5432 que coincida con el certificado), password y ca.crt; monta el mismo grafana-runtime/secret-key en ambos Pods. Sustituye root_url por la dirección HTTPS externa real y configura la terminación TLS. Mover datos SQLite existentes requiere una migración y una comprobación de recuperación aparte; cambiar el tipo de base de datos no los migra.
helm upgrade --install grafana grafana-community/grafana --version 13.2.2 \
  -n monitoring -f values.yaml -f values-ha.yaml --wait
El DNS de los peers asume el release grafana y el namespace monitoring; actualízalo si cambia alguno de los dos. Permite TCP/UDP 9094 entre los Pods de Grafana y solo la conectividad necesaria de DNS, base de datos y backends. Las sesiones de autenticación se almacenan en la base de datos compartida de Grafana, por lo que no se requieren sesiones en Redis ni afinidad en el balanceador de carga para la continuidad del inicio de sesión.
La HA de Alerting requiere conectividad entre peers y configuración de deduplicación. Ten en cuenta la evaluación en cada nodo con la configuración predeterminada. La versión 13.2.1 también tiene ha_single_node_evaluation, pero este ejemplo mantiene su valor predeterminado. La deduplicación no garantiza la entrega de notificaciones exactamente una vez ante particiones de red. La validación nativa usó una sola instancia de Grafana y no ejecutó una conmutación por error de la base de datos para este perfil de HA.
Integración de fuentes de datos
Aprovisionamiento por archivos y UIDs
datasources.yaml fija Prometheus=prometheus, Loki=loki y Tempo=tempo. Los dashboards, las alertas y los enlaces de correlación deben usar UIDs coincidentes. Las variables de entorno suministran valores dentro de los archivos de aprovisionamiento; definir variables por sí solo no crea objetos de fuente de datos.
apiVersion: 1
datasources:
- name: Prometheus
  type: prometheus
  uid: prometheus
  url: $PROMETHEUS_URL
  access: proxy
  isDefault: true
  editable: false
  jsonData:
    httpMethod: POST
    exemplarTraceIdDestinations:
    - name: trace_id
      datasourceUid: tempo
- name: Loki
  type: loki
  uid: loki
  url: $LOKI_URL
  access: proxy
  editable: false
  jsonData:
    derivedFields:
    - name: TraceID
      matcherRegex: '"trace_id"\s*:\s*"([a-f0-9]{32})"'
      url: $${__value.raw}
      datasourceUid: tempo
- name: Tempo
  type: tempo
  uid: tempo
  url: $TEMPO_URL
  access: proxy
  editable: false
  jsonData:
    tracesToLogsV2:
      datasourceUid: loki
      tags:
      - key: service.name
        value: service_name
      spanStartTimeShift: -5m
      spanEndTimeShift: 5m
      customQuery: true
      query: '{$${__tags}} | json | trace_id="$${__span.traceId}"'
    tracesToMetrics:
      datasourceUid: prometheus
      tags:
      - key: service.name
        value: service
      queries:
      - name: Request rate
        query: sum(rate(lab_http_requests_total{$${__tags}}[5m]))
    serviceMap:
      datasourceUid: prometheus
    nodeGraph:
      enabled: true
Estos enlaces usan el service.name de la aplicación del laboratorio, el service_name de Loki, la etiqueta de métrica service y el campo de log JSON trace_id. Adáptalos a las etiquetas reales para otros pipelines. $${...} preserva las macros de enlace ${...} de Grafana a través del aprovisionamiento por archivos. ${__tags} se expande a matchers como service="..."; envolverlo de nuevo dentro de service="${__tags}" crea un selector no válido.
Los exemplars conectan observaciones de métricas seleccionadas con trazas; no contienen la traza de cada solicitud. La compatibilidad del exporter, la ingesta de exemplars en Prometheus y la retención de trazas deben estar alineadas. serviceMap requiere métricas de grafo de servicios del metrics-generator de Tempo en Prometheus. Configurar únicamente un UID no genera grafos de servicios.
IRSA para CloudWatch
Asocia un rol IRSA aprobado al ServiceAccount de Grafana y restringe su confianza OIDC al namespace/ServiceAccount exactos y a aud. Verifica la proyección del token y la obtención de credenciales del SDK en el Pod. La fuente de datos con authType: default usa esa cadena de credenciales. No establezcas de forma redundante assumeRoleArn con el mismo rol; úsalo para una asunción de rol adicional deliberada, con la confianza y los permisos sts:AssumeRole necesarios.
Comienza con cloudwatch:ListMetrics y cloudwatch:GetMetricData para las consultas de métricas. Añade permisos de Logs, EC2, etiquetas o X-Ray solo para las funciones que uses. Para acciones sin permisos a nivel de recurso, restringe Resource: "*" con las condiciones de Región aplicables; limita el acceso a Logs a los grupos de logs reales. No combines todas las acciones de lectura de AWS en una única declaración con comodín sin condiciones. El ejemplo predeterminado no crea credenciales ni recursos de AWS.
Patrones de diseño de dashboards
dashboard.json es JSON completo con ocho paneles. Los paneles de la aplicación usan lab_http_* del laboratorio de MSA. Los paneles de nodos requieren node-exporter; el panel de CrashLoop requiere kube-state-metrics.
| Método | Señales | Interpretación |
|---|---|---|
| RED: Rate, Errors, Duration | Tasa de solicitudes, porcentaje de 5xx, p99 del histograma | No conviertas la ausencia de tráfico de solicitudes o el tráfico cero en un 100 % de éxito |
| USE: Utilization, Saturation, Errors | Uso de CPU/memoria, presión de la cola de disco, errores de red | El tiempo de E/S ponderado no es un contador de errores de disco |
| Cuatro señales doradas | Latencia, Tráfico, Errores, Saturación | La disponibilidad es un SLI aparte importante, no uno de estos cuatro nombres |
Rellena con cero una serie de errores ausente solo cuando exista la serie de solicitudes correspondiente:
((sum by (service) (rate(lab_http_requests_total{status=~"5.."}[5m])) or 0 * sum by (service) (rate(lab_http_requests_total[5m]))) / (sum by (service) (rate(lab_http_requests_total[5m])) > 0)) * 100El denominador excluye el tráfico cero. Muestra por separado la falta de recolección y la ausencia de tráfico. rate(node_disk_io_time_weighted_seconds_total[5m]) estima la presión media de la cola de E/S; increase(...) no cuenta errores de disco. node_load1 incluye tareas ejecutables y esperas de E/S, y no es una medida pura de la saturación de CPU.
El dashboard asume un único clúster. Al combinar clústeres en un backend central, adjunta etiquetas cluster de forma coherente e inclúyelas en los selectores, agrupaciones y joins. Los joins de métricas de Pods necesitan al menos namespace y pod. Añade variables de clúster/namespace solo cuando existan esas etiquetas. Las selecciones múltiples o de tipo "all" necesitan matchers de regex y el escapado ${variable:regex}. Las variables y las carpetas no son controles de acceso a las fuentes de datos.
Aprovisionamiento de dashboards
Sidecar
El perfil predeterminado de archivos montados no requiere token ni RBAC de la API de Kubernetes. Añade values-sidecar.yaml cuando necesites observación dinámica de ConfigMaps. Este perfil opcional usa un Role con ámbito de namespace, lee solo ConfigMaps de monitoring y selecciona grafana_dashboard: "true". La etiqueta y su valor son configurables, no requisitos universales de Grafana. Cualquiera que pueda escribir ConfigMaps coincidentes puede cambiar el contenido aprovisionado.
El Role de namespace predeterminado del chart también lee Secrets. Crea primero el Role limitado a ConfigMaps de sidecar-role.yaml y referéncialo con useExistingRole.
kubectl apply -f sidecar-role.yaml
helm upgrade grafana grafana-community/grafana --version 13.2.2 \
  -n monitoring -f values.yaml -f values-sidecar.yaml
Este provider usa una carpeta Sidecar aparte; los sidecars de fuentes de datos y de alertas permanecen deshabilitados. No copies searchNamespace: ALL ni un acceso amplio a Secrets como valores predeterminados habituales. Para conservar los cambios en un dashboard aprovisionado de solo lectura, actualiza su archivo de origen.
Grafana Operator
Un despliegue con Operator necesita primero el controlador/CRDs correspondientes y una instancia Grafana seleccionada por sus recursos GrafanaDashboard/GrafanaDatasource. No dejes que un despliegue de Helm independiente y el Operator compitan por la propiedad. Este capítulo valida el aprovisionamiento por archivos con Helm, no una instalación con Operator. Las elipsis como panels: [...] no son JSON válido y desplegable; usa el dashboard.json completo como contenido del dashboard.
Reglas de alerta (Grafana Alerting)
Usa [unified_alerting] en 13.2.1; no habilites la configuración heredada [alerting], que se ha eliminado. El ejemplo conserva las etiquetas a través de A=consulta de rango de CPU, B=reducción por último valor y C=umbral >80. classic_conditions no es adecuado cuando necesitas etiquetas de alerta multidimensionales.
apiVersion: 1
groups:
- orgId: 1
  name: grafana-docs
  folder: Observability
  interval: 1m
  rules:
  - uid: docs-high-cpu
    title: Sustained CPU usage
    condition: C
    data:
    - refId: A
      relativeTimeRange:
        from: 300
        to: 0
      datasourceUid: prometheus
      model:
        refId: A
        expr: 100 * (1 - avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m])))
        instant: false
        range: true
        intervalMs: 15000
        maxDataPoints: 43200
    - refId: B
      relativeTimeRange:
        from: 0
        to: 0
      datasourceUid: __expr__
      model:
        refId: B
        type: reduce
        expression: A
        reducer: last
    - refId: C
      relativeTimeRange:
        from: 0
        to: 0
      datasourceUid: __expr__
      model:
        refId: C
        type: threshold
        expression: B
        conditions:
        - type: query
          evaluator:
            type: gt
            params:
            - 80
          operator:
            type: and
          query:
            params:
            - C
          reducer:
            type: last
            params: []
    noDataState: NoData
    execErrState: Error
    for: 5m
    isPaused: true
    annotations:
      summary: High CPU on {{ $labels.instance }}
    labels:
      severity: warning
La regla se instala en pausa. Valida los datos reales, los resultados de la evaluación, la política de notificación y los contactos antes de reactivarla. for: 5m es la duración pendiente; interval: 1m es la frecuencia de evaluación. No ocultes NoData/Error como si fueran normales. Los reinicios frecuentes no prueban que un contenedor esté actualmente en CrashLoopBackOff; usa la métrica de motivo de espera para ese estado.
Aprovisiona los contactos de Slack/PagerDuty con el esquema documentado y valores procedentes de Secrets. Usa una plantilla de notificación integrada o define explícitamente una plantilla personalizada antes de referenciarla; los nombres no definidos como slack.title fallan. Un punto de contacto por sí solo no establece el enrutamiento: adjunta el receiver a una política de notificación. Envía pruebas reales solo a un destino aprobado. Esta auditoría no envió notificaciones externas.
Métricas propias de Grafana
/metrics usa una autenticación básica independiente. Instala Prometheus Operator y haz coincidir la etiqueta release del ServiceMonitor con su selector. La contraseña debe coincidir con la contraseña montada de Grafana:
printf '%s' metrics > "$GRAFANA_STATE/metrics-user"
kubectl -n monitoring create secret generic grafana-metrics-auth \
  --from-file=username="$GRAFANA_STATE/metrics-user" \
  --from-file=password="$GRAFANA_STATE/metrics-password"
helm upgrade grafana grafana-community/grafana --version 13.2.2 \
  -n monitoring -f values.yaml -f values-metrics.yaml
Autenticación y acceso
Después de confirmar el HTTPS externo, el callback del IdP (/login/generic_oauth), los endpoints/JWKS reales y los claims de grupo, asigna este fragmento INI a grafana.ini.auth.generic_oauth del chart. Añade por separado el montaje del archivo del Secret de OAuth. Estos endpoints de IdP de ejemplo no constituyen una instalación de SSO lista para usar.
[auth.generic_oauth]
enabled = true
name = Organization SSO
client_id = $__file{/run/grafana-oauth/client-id}
client_secret = $__file{/run/grafana-oauth/client-secret}
scopes = openid profile email groups
auth_url = https://sso.example.com/authorize
token_url = https://sso.example.com/token
api_url = https://sso.example.com/userinfo
use_pkce = true
validate_id_token = true
jwk_set_url = https://sso.example.com/actual-jwks-endpoint
role_attribute_strict = true
allow_assign_grafana_admin = false
role_attribute_path = contains(groups[*], 'grafana-admins') && 'Admin' || contains(groups[*], 'grafana-viewers') && 'Viewer'
allow_sign_up = true
Admin es un rol de organización, distinto de GrafanaAdmin a nivel de servidor. La asignación estricta rechaza a los usuarios ajenos a los grupos asignados; PKCE y la validación de la firma del ID token están habilitados. Verifica el inicio de sesión real, los cambios de grupo y la revocación en el entorno de destino. Los usuarios con rol Viewer pueden consultar las fuentes de datos de su organización más allá de las consultas de los dashboards visibles, por lo que los permisos de carpeta por sí solos no restringen el acceso a los datos subyacentes.
Comparación entre Grafana Cloud y autoalojado
| Área | OSS autoalojado | Grafana Cloud |
|---|---|---|
| Operación | Base de datos propia, actualizaciones, copias de seguridad y capacidad | Servicio gestionado; revisa el contrato y los límites |
| Disponibilidad | Diséñala y verifícala tú mismo | El SLA depende del plan/acuerdo de servicio real |
| Permisos de fuentes de datos/caché de consultas | No asumas que son funciones de OSS | Revisa las capacidades admitidas y el plan |
| Ubicación de los datos | Infraestructura/backends elegidos | Región real del stack, retención y condiciones de procesamiento |
| Plugins | Verifica compatibilidad, firmas y empaquetado | Catálogo admitido y política del stack |
Obtén las URLs y los nombres de usuario de Prometheus/Loki de Cloud en la página Connections del stack. No asumas identificadores idénticos ni copies URLs regionales inventadas. Usa tokens de Cloud Access Policy con el ámbito de acceso metrics:read/logs:read necesario y suministra secureJsonData.basicAuthPassword mediante un Secret. Los tokens de cuenta de servicio de Grafana y los tokens de acceso a datos de Cloud tienen finalidades distintas.
Buenas prácticas
Organiza Overview, Infrastructure, Kubernetes, Applications y Alerts por propósito. Incluye unidades y estados de datos ausentes. Reduce el rango, la frecuencia y la cardinalidad de las consultas antes de aumentar los recursos; usa recording rules para los cálculos repetidos. Sustituye los plugins Angular retirados piechart/worldmap por los paneles integrados Pie chart/Geomap. Fija versiones compatibles de los plugins adicionales y suministra las mismas versiones a todos los nodos de HA.
[dashboards] min_refresh_interval = 10s limita la frecuencia de refresco del navegador, no la evaluación de alertas. Dimensiona los pools de base de datos frente a los límites de conexiones de la BD y el número de réplicas. Un fragmento [caching] enabled/ttl en OSS no proporciona el almacenamiento en caché de consultas de Enterprise/Cloud.
Alcance de la validación y referencias
Se renderizaron los perfiles del chart de instancia única, HA, métricas y sidecar. Una instancia real de Grafana 13.2.1 comprobó las fuentes de datos, los dashboards, el aprovisionamiento de la alerta en pausa, la evaluación de expresiones y la autenticación de métricas. Las expresiones usaron respuestas sintéticas de Prometheus. Estas comprobaciones no desplegaron EKS, no validaron el TLS real de los backends, no realizaron conmutación por error de una base de datos en HA, no completaron SSO/IRSA ni entregaron notificaciones externas.
- Grafana HA
- Grafana 13.2.1 configuration defaults
- Community Helm chart
- Alerting file provisioning
- Generic OAuth
- Data source permissions and caching
- Tempo provisioning
- Loki configuration
Quiz
Pon a prueba las distinciones de configuración y operación con el quiz de Grafana.