Parte 1: Fundamentos de Kafka
Última actualización: 12 de septiembre de 2026. Apache Kafka 4.3.1, compatible con Strimzi 1.2.0. Validación: Diecinueve comprobaciones utilizaron las clases de configuración reales de Kafka 4.3.1 para verificar validez, valores predeterminados y conflictos. No se inició ningún broker ni clúster EKS.
1. Brokers, temas y particiones
Kafka almacena eventos en registros de partición, lo que permite que productores y consumidores avancen de forma independiente. Un broker puede almacenar réplicas de particiones de varios temas; no necesita contener un tema completo.
| Término | Significado |
|---|---|
| Broker | Rol de servidor que almacena réplicas de datos y atiende solicitudes |
| Tema | Categoría lógica de eventos |
| Partición | Registro ordenado al que se añaden entradas; la retención y la compactación pueden eliminar registros |
| Offset | Posición dentro de una partición, no un ID global; las eliminaciones y transacciones pueden dejar huecos visibles |
| Factor de replicación | Número de réplicas de una partición, gestionado mediante metadatos de creación/reasignación |
| Líder / seguidor | Los líderes gestionan escrituras y los seguidores replican; la lectura desde seguidores configurada puede atender a consumidores |
| ISR | Réplicas suficientemente sincronizadas con el líder, incluido el propio líder |
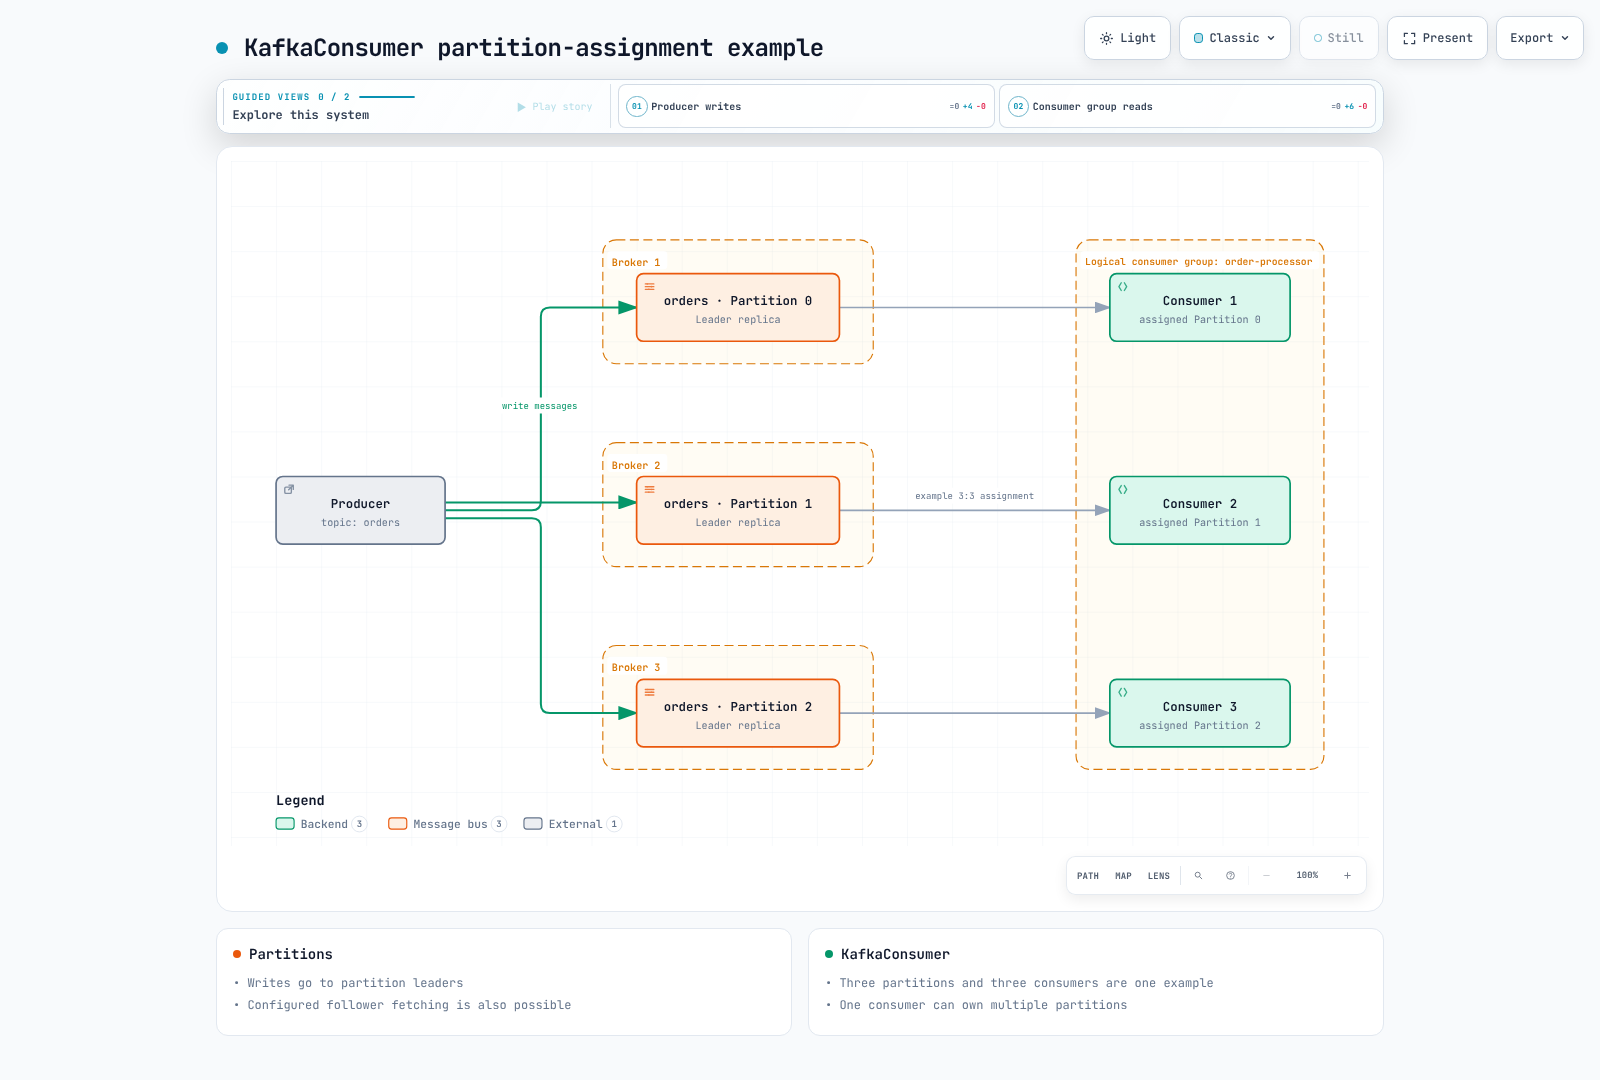
El diagrama 3:3 es un ejemplo. Con la asignación automática de grupos de KafkaConsumer mediante subscribe(), cada partición se asigna a un miembro del grupo a la vez; un miembro puede tener varias particiones. El uso manual de assign() se gestiona por separado. Varios grupos pueden consumir el mismo tema de forma independiente. Los Share Groups/KafkaShareConsumer de Kafka 4.x utilizan otro modelo de distribución y confirmación.
2. Orden y claves de partición
Kafka define el orden del registro dentro de una partición. No establece automáticamente un orden global del tema ni un orden según las marcas de tiempo de los eventos de negocio.
El enrutamiento coherente de una misma clave requiere serialización, particionado y número de particiones coherentes. Aumentar el número de particiones puede cambiar la asignación basada en hash. Los particionadores personalizados y las particiones elegidas explícitamente también afectan al enrutamiento. Varios productores, reintentos y procesamiento paralelo de la aplicación requieren su propio contrato de orden.
El enrutamiento de claves nulas depende del cliente/particionador. Una cardinalidad alta de claves por sí sola no garantiza una carga equilibrada; unas pocas claves desproporcionadamente frecuentes pueden crear particiones calientes.
Este comando crea un tema en un clúster ya accesible con al menos tres brokers. Añada --command-config client.properties para listeners autenticados. No lo aplique sin cambios a la configuración didáctica de un solo nodo que aparece más adelante.
: "${DOCS_BOOTSTRAP:?Set the existing Kafka bootstrap host:port}"
kafka-topics.sh --create --bootstrap-server "$DOCS_BOOTSTRAP" \
  --topic orders --partitions 6 --replication-factor 3 \
  --config min.insync.replicas=2
3. Grupos de consumidores y offsets
Los grupos basados en particiones pueden tener miembros inactivos cuando hay más consumidores que particiones. El rendimiento de los productores, los discos, la red y el procesamiento de la aplicación también afectan a la concurrencia; el número de particiones por sí solo no predice el rendimiento.
Distinguir los protocolos de grupo
El consumidor Java de Kafka 4.3 establece group.protocol en classic de forma predeterminada.
| Opción | Asignación y tiempos de espera |
|---|---|
classic | Asignadores del cliente y session.timeout.ms / heartbeat.interval.ms |
consumer | Asignadores del servidor y group.consumer.session.timeout.ms / group.consumer.heartbeat.interval.ms del broker |
El rebalanceo eager de Classic revoca un conjunto amplio de asignaciones. CooperativeStickyAssignor mueve incrementalmente las particiones que necesitan reasignación. El protocolo consumer más reciente también realiza reconciliación incremental en el servidor. No todos los rebalanceos pausan necesariamente el grupo completo. No traslade al protocolo nuevo las suposiciones de Classic sobre asignadores y tiempos de espera del cliente.
max.poll.interval.ms tiene un valor predeterminado de 300000 ms. Con membresía estática (group.instance.id), superarlo no reasigna inmediatamente las particiones: el consumidor deja de enviar latidos y el tiempo de espera de sesión aplicable también afecta a la reasignación.
Offsets y finalización del trabajo de negocio
Un offset confirmado generalmente identifica la siguiente posición que se leerá. La posición de lectura del cliente y el trabajo externo completado son hechos diferentes. Con procesamiento asíncrono/paralelo, no confirme más allá de registros cuyo trabajo siga pendiente.
| Método | Significado y consideraciones |
|---|---|
| Confirmación automática | enable.auto.commit=true, intervalo predeterminado de 5000 ms; no determina la finalización del negocio |
commitSync() | Espera a que termine la llamada; el impacto en la latencia depende de los lotes y la frecuencia |
commitAsync() | Siga los fallos y el progreso mediante callbacks; no reintente ciegamente offsets obsoletos que hagan retroceder el progreso confirmado |
Confirmar antes de procesar puede perder trabajo tras un fallo; confirmar después puede repetir efectos durante la recuperación. Pruebe fallos, reinicios y rebalanceos junto con la salida de la aplicación.
4. Alcance del procesamiento exactamente una vez
enable.idempotence evita escrituras duplicadas en el registro de una misma transmisión del productor durante los reintentos. No es una clave general de deduplicación para una aplicación que envía el mismo evento de negocio como un envío nuevo.
Para procesamiento de Kafka a Kafka, confirme los registros de salida y los siguientes offsets de entrada en la misma transacción, y haga que los consumidores lean con read_committed. Establecer una cadena transactional.id no implementa esa lógica de procesamiento. Las bases de datos y API externas requieren contratos independientes de transacción del destino, idempotencia y recuperación.
producer.properties
bootstrap.servers=127.0.0.1:19092
key.serializer=org.apache.kafka.common.serialization.StringSerializer
value.serializer=org.apache.kafka.common.serialization.StringSerializer
acks=all
enable.idempotence=true
transactional.id=orders-writer-1
max.in.flight.requests.per.connection=5
delivery.timeout.ms=120000
consumer.properties
bootstrap.servers=127.0.0.1:19092
key.deserializer=org.apache.kafka.common.serialization.StringDeserializer
value.deserializer=org.apache.kafka.common.serialization.StringDeserializer
group.id=order-processor
group.protocol=consumer
enable.auto.commit=false
isolation.level=read_committed
max.poll.interval.ms=300000
El procesamiento transaccional incluye initTransactions(), beginTransaction(), los envíos de salida, sendOffsetsToTransaction(...), commitTransaction() y la gestión de abortos/recuperación. Los productores concurrentes necesitan IDs transaccionales distintos; diseñe un comportamiento estable de reinicio y exclusión del escritor lógico.
La idempotencia explícita requiere acks=all, retries>0 y max.in.flight.requests.per.connection<=5. Los conflictos generan ConfigException. La idempotencia predeterminada implícita puede desactivarse con ajustes incompatibles. Un valor alto de retries no anula plazos como delivery.timeout.ms.
5. Metadatos KRaft
KRaft llegó como acceso anticipado en Kafka 2.8, pasó a estar listo para producción en 3.3 y es el único modo desde la eliminación de ZooKeeper en Kafka 4.0. Los procesos de controlador dedicados no necesitan atender tráfico de datos de brokers, por lo que los controladores no son necesariamente un subconjunto de los brokers de datos.
Los votantes del controlador replican el registro Raft de metadatos, con un controlador activo. Las implementaciones de producción suelen utilizar tres o cinco votantes. Los grupos de tamaño par también tienen una mayoría calculable; los tamaños impares usan los recursos eficientemente para la misma tolerancia a fallos.
__cluster_metadata nombra el registro interno de metadatos, no un tema de aplicación ordinario gestionado mediante KafkaProducer/KafkaConsumer. Eliminar ZooKeeper no elimina la responsabilidad sobre el quórum de controladores, almacenamiento, actualizaciones y monitorización.
Quórums dinámicos y estáticos
Los quórums dinámicos usan controller.quorum.bootstrap.servers como puntos iniciales de descubrimiento, no como membresía de votantes. El formateo inicial del almacenamiento y el arranque del quórum deben coincidir en el ID del clúster, los IDs de directorio y los votantes iniciales. Para cambios, utilice los procedimientos admitidos de incorporación/eliminación de controladores.
El ajuste estático controller.quorum.voters sigue siendo compatible con Kafka 4.3.1. No lo establezca para un quórum dinámico. Cambiar las direcciones iniciales por sí solo no migra automáticamente un quórum estático.
Este archivo sirve para aprendizaje local con un solo nodo, no para HA. Usa listeners PLAINTEXT de loopback. Antes del arranque, un directorio de datos nuevo necesita el procedimiento adecuado de formato/inicialización del almacenamiento. Nunca formatee arbitrariamente datos existentes de Kafka.
combined-lab.properties
# Local, single-node configuration for learning; not an HA deployment.
process.roles=broker,controller
node.id=1
controller.quorum.bootstrap.servers=127.0.0.1:19093
listeners=BROKER://127.0.0.1:19092,CONTROLLER://127.0.0.1:19093
advertised.listeners=BROKER://127.0.0.1:19092,CONTROLLER://127.0.0.1:19093
listener.security.protocol.map=BROKER:PLAINTEXT,CONTROLLER:PLAINTEXT
controller.listener.names=CONTROLLER
inter.broker.listener.name=BROKER
log.dirs=./kafka-lab-data
# Single-node internal-topic settings are for this lab only.
offsets.topic.replication.factor=1
transaction.state.log.replication.factor=1
transaction.state.log.min.isr=1
share.coordinator.state.topic.replication.factor=1
share.coordinator.state.topic.min.isr=1
Un listener personalizado BROKER necesita una asignación explícita de protocolo. Kafka 4.3.1 puede proporcionar una asignación PLAINTEXT para el listener predeterminado exclusivo del controlador CONTROLLER en las configuraciones pertinentes; la ausencia de una línea de asignación no invalida todas las configuraciones de controlador.
En EKS, use los ajustes, certificados y almacenamiento generados por Strimzi en la Parte 2. No edite directamente server.properties de Pods gestionados por el Operator. Configure el TLS, la autenticación y la autorización necesarios para los listeners de producción.
6. Replicación, disponibilidad de escritura y durabilidad
RF=3 por sí solo no garantiza que todos los datos sobrevivan a cualesquiera dos fallos de brokers. Considere el progreso real de replicación, el ISR al confirmar, la elección de líderes elegibles, los fallos de almacenamiento/red y el quórum de controladores.
Si inicialmente las tres réplicas pertenecen a un ISR saludable, una partición con min.insync.replicas=2 y acks=all puede continuar con dos miembros ISR tras el fallo de un broker mientras se mantengan las demás condiciones. La transición de líder todavía puede causar errores/reintentos. Por debajo del ISR mínimo, las escrituras fallan o se rechazan, con detalles de error que dependen del momento.
| acks | Confirmación | Interpretación |
|---|---|---|
0 | No espera respuesta del broker | Almacenamiento sin confirmar; el offset devuelto es -1 |
1 | El líder responde después de registrar | Riesgo de perder el líder antes de la replicación a seguidores |
all / -1 | Espera al ISR completo actual | Evalúelo junto con el ISR mínimo, la replicación y la política de elección de líder |
acks=all no significa que cada disco haya completado fsync para cada registro. Tampoco acks por sí solo garantiza una clasificación de rendimiento o p99. Mida el coste de confirmación con cargas, lotes y redes comparables.
Puede cambiar el ISR mínimo como sigue. Cambiar el factor de replicación requiere reasignar réplicas, no añadir replication.factor como configuración ordinaria del tema.
kafka-configs.sh --bootstrap-server "$DOCS_BOOTSTRAP" \
  --alter --entity-type topics --entity-name orders \
  --add-config min.insync.replicas=2