Parte 1: MLflow Tracking
Referencia revisada: MLflow 3.16.0; último parche 3.16.1 comprobado · 2026-10-12
Configuración del entorno de laboratorio
Instale mlflow==3.16.0 con Python 3.10 o una versión posterior. El ejemplo siguiente se comprobó con Python 3.12, SQLite y un almacén de artefactos local. No requiere GPU, un modelo entrenado ni un servidor remoto.
El parche 3.16.1 está disponible, pero este ejemplo no se ha vuelto a ejecutar con él. La Parte 3 aborda un servidor HTTP de equipo y la operación de EKS.
¿Qué es MLflow Tracking?
Tracking proporciona API y una UI para experimentos, ejecuciones, parámetros, métricas, artefactos, modelos registrados y trazas. El SDK puede conectarse a un servidor HTTP de tracking o directamente a un backend local de archivos/SQL. No se requiere un proceso de servidor independiente para cada uso.
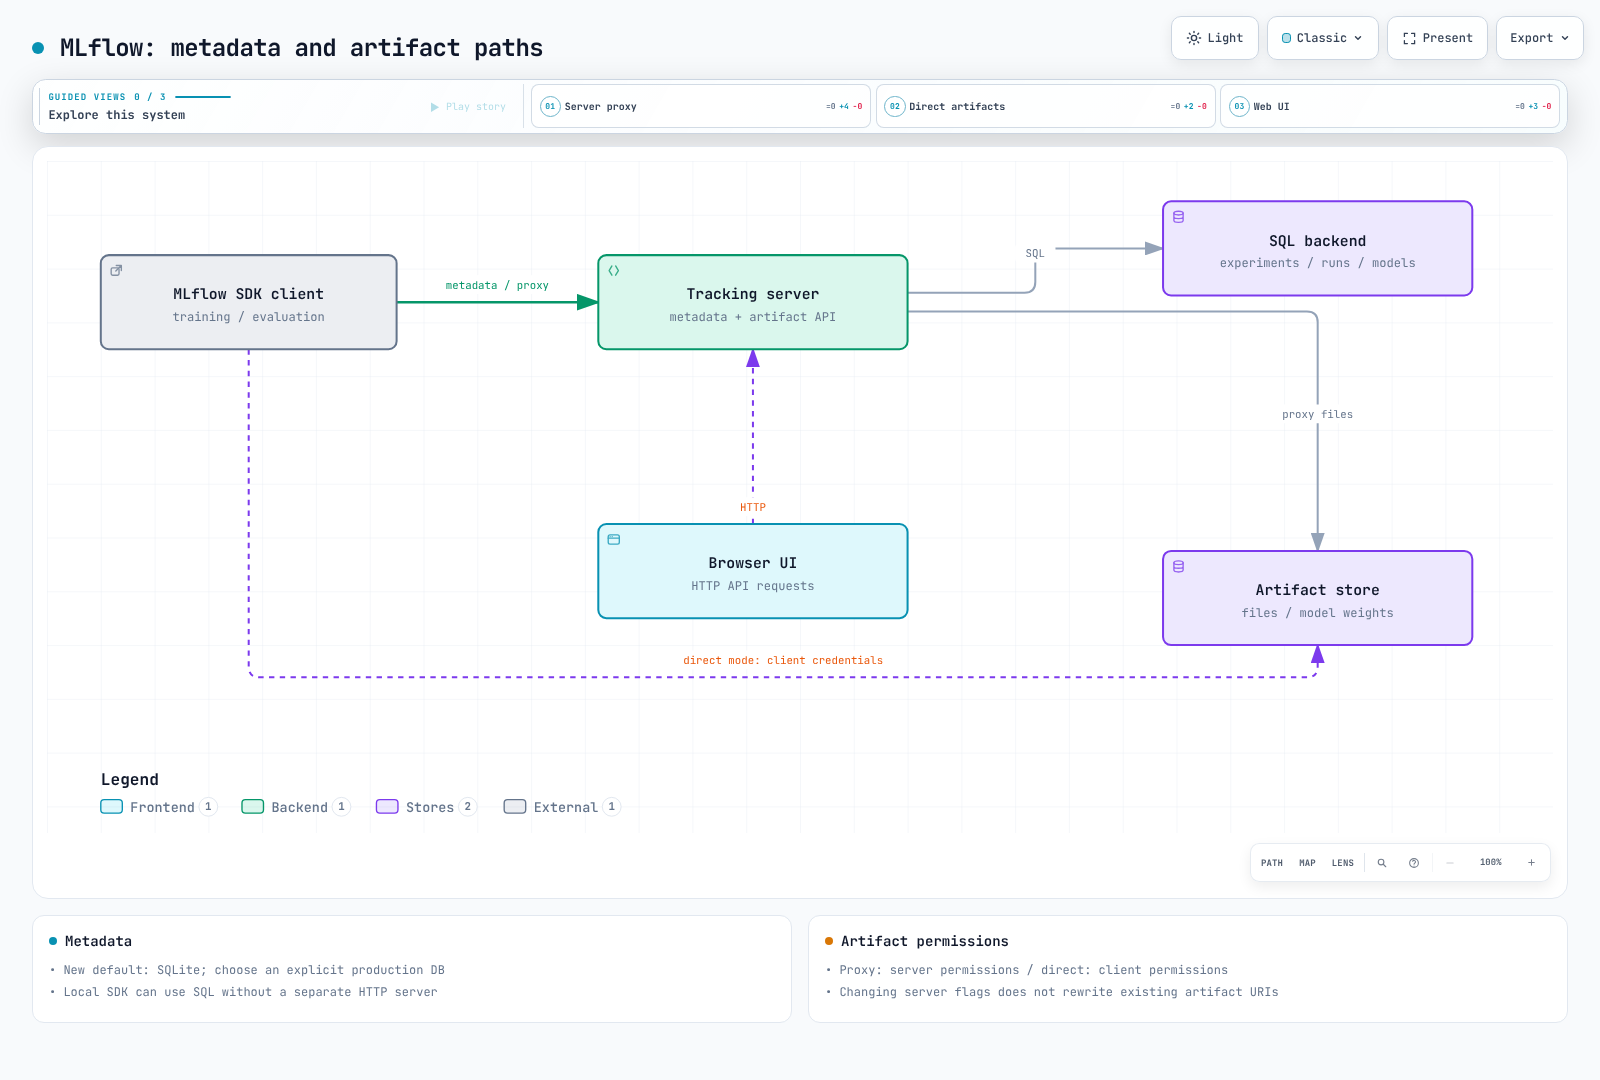
Incluso con un servidor remoto, las transferencias de metadatos y artefactos pueden seguir rutas distintas. Los metadatos pasan por la API de tracking; los artefactos pueden ser proxy a través del servidor o transferirse directamente entre el cliente y un almacén como S3. Estas configuraciones se distinguen a continuación.
Conceptos fundamentales: experimentos y ejecuciones
Un Experiment agrupa ejecuciones y resultados relacionados. Una Run puede representar evaluación, preprocesamiento o una comparación, además de entrenamiento. Una clave de parámetro no se puede cambiar a un valor diferente dentro de una ejecución. Las métricas pueden tener varias observaciones con marca de tiempo y pasos; distinga el resumen actual del historial completo.
Los valores siguientes son fixtures de la Tracking API, no precisión de modelo medida. El ejemplo crea su artefacto JSON en lugar de depender de un archivo de imagen no definido.
from pathlib import Path
import mlflow
from mlflow import MlflowClient

root = Path(".mlflow-demo").resolve()
root.mkdir(exist_ok=True)
mlflow.set_tracking_uri(f"sqlite:///{root / 'mlflow.db'}")
client = MlflowClient()
experiment = client.get_experiment_by_name("tracking-demo")
experiment_id = (
    experiment.experiment_id if experiment else
    client.create_experiment(
        "tracking-demo", artifact_location=(root / "artifacts").as_uri()
    )
)
mlflow.set_experiment(experiment_id=experiment_id)

with mlflow.start_run(run_name="demo") as run:
    mlflow.log_param("learning_rate", 0.01)
    mlflow.log_metric("demo_score", 0.92, step=0)
    mlflow.log_metric("demo_score", 0.95, step=1)
    mlflow.log_dict({"synthetic_example": True}, "summary.json")
    run_id = run.info.run_id

assert client.get_run(run_id).info.status == "FINISHED"
assert len(client.get_metric_history(run_id, "demo_score")) == 2
La salida normal del contexto finaliza la ejecución como FINISHED; una excepción en el bloque la finaliza como FAILED. La terminación de la ejecución no realiza una copia de seguridad de los artefactos ni verifica el éxito de un proceso de entrenamiento completo. Repetir el ejemplo añade una ejecución al mismo experimento. La condición no cambia la ubicación de artefactos de un experimento existente.
Registro automático
mlflow.autolog() configura integraciones compatibles. Los valores capturados, las versiones de framework compatibles, el registro de modelos y la recopilación de ejemplos de entrada varían según la integración. No asuma que un bucle ordinario de PyTorch y un flujo de trabajo de Lightning reciben instrumentación automática idéntica. Consulte la API y la compatibilidad de versiones específicas del framework; registre métricas adicionales manualmente.
Revise dónde se almacenarán las entradas, salidas, modelos y muestras de datos antes de activar el registro automático. Activar esta funcionalidad no elimina PII ni instrumenta todas las rutas de código personalizadas.
El cambio de MLflow 3: los modelos como entidades de primera clase
Un LoggedModel tiene su propio model_id, estado, ubicación de artefactos y metadatos. Puede referirse a una ejecución de entrenamiento mediante source_run_id y tener relaciones con otras ejecuciones de evaluación, métricas y trazas. Es distinto de los Registered Models y Model Versions.
Llamar a log_model() sin un bloque start_run() explícito no es en sí algo nuevo en 3.x. Model.log() en 2.22.0 ya usaba _get_or_start_run() cuando era necesario; la ruta de registro de modelos de 3.16.0 mantiene este comportamiento. El cambio importante es la identidad independiente del modelo y el seguimiento de relaciones.
Después de la configuración de tracking anterior, esto crea metadatos de modelo sin una ejecución activa:
model = mlflow.initialize_logged_model(
    name="metadata-only", model_type="demo"
)
assert mlflow.active_run() is None
assert model.source_run_id is None
print(model.model_id, model.status)  # PENDING
Aún no contiene pesos de modelo utilizables ni un flavor de modelo. Complete el registro del modelo real, la retención de artefactos y la finalización antes de usarlo. READY no es evidencia de aprobación de Deployment, calidad ni revisión de seguridad.
Observabilidad de GenAI y LLM: trazado
MLflow Tracing se introdujo en 2.14.0 el 2024-06-17. La versión 3.x amplió la integración de modelos, evaluación y UI de GenAI; 3.16.0 añadió enlaces de span y una UI de trazas rediseñada. El trazado no fue posible por primera vez en la versión 3.
Una traza representa pasos de solicitud como recuperación, ejecución de herramientas y llamadas de LLM con spans. Distinga la estructura padre/hijo de los enlaces de span. La recopilación de tokens depende de la integración y de la respuesta del proveedor; los spans de recuperación o de herramientas no tienen necesariamente campos de tokens o costo de LLM. La estimación de costos requiere la identidad del modelo, información de uso y precio, y no es el total de facturación conciliado.
Combine la instrumentación automática con spans manuales cuando corresponda. Las entradas, salidas, excepciones, argumentos de herramientas y el razonamiento pueden contener información sensible; defina el alcance de recopilación, el acceso, el enmascaramiento y la retención. Instalar una integración no garantiza una cobertura completa de rutas ni la contabilización de costos.
Backend Store frente a Artifact Store
| Almacén o valor predeterminado | Significado |
|---|---|
| Backend | metadatos de experimento/ejecución/parámetro/métrica/modelo; SQLite, PostgreSQL, MySQL y otros almacenes SQL compatibles |
| Artifact | archivos de modelo, gráficos, JSON y otros archivos; rutas locales, S3 y otros almacenes |
| Predeterminado | un nuevo entorno 3.16.0 usa sqlite:///mlflow.db; compruebe el comportamiento de compatibilidad si ya existe ./mlruns |
| Backend de archivos heredado | modo de mantenimiento; elija un backend SQL explícito y un plan de migración para una nueva operación |
SQLite también es una base de datos relacional. Es adecuado para ejercicios locales pequeños; los escritores simultáneos, múltiples réplicas de servidor, copias de seguridad y alta disponibilidad requieren una evaluación independiente. Una copia de seguridad de la base de datos de metadatos no incluye automáticamente los archivos de artefactos.
Dos rutas de artefactos con un servidor remoto
- Modo proxy: el cliente usa una ubicación
mlflow-artifacts:y envía archivos a través del servidor, que posee permisos de almacén de artefactos. Es posible que los clientes no necesiten su propio acceso a S3, lo que hace importantes la autenticación y la autorización del servidor de tracking. - Modo directo: con
--no-serve-artifactsy una raíz de artefactos directas3://..., los clientes acceden al almacenamiento por sí mismos. Necesitan los permisos de AWS pertinentes, acceso de red y bibliotecas.
Cambiar las opciones del servidor no reescribe retroactivamente los URI de artefactos de experimentos existentes. Inspeccione el URI real de experimento/ejecución. La UI del navegador consulta las API HTTP del servidor; no se conecta directamente a PostgreSQL.
Siguientes pasos
La Parte 2 aborda el registro, las versiones y los alias. La Parte 3 aborda el almacenamiento de EKS y el control de acceso. Cambiar solo un alias no vuelve a realizar automáticamente el Deployment de cada proceso de servicio.