Pods y cargas de trabajo de Kubernetes
Versiones compatibles: Kubernetes 1.35, 1.36, 1.37 Última actualización: October 12, 2026
Este documento proporciona una explicación detallada de los Pods, la unidad básica de ejecución en Kubernetes, y los diversos recursos de carga de trabajo que los gestionan. Partiendo del concepto de Pods, abordaremos las características y los casos de uso de diversos recursos de carga de trabajo, incluidos Deployments, StatefulSets, DaemonSets y más.
Configuración del entorno de laboratorio
Para seguir los ejemplos de este documento, necesitarás las siguientes herramientas y entorno:
Herramientas necesarias
- kubectl con una diferencia máxima de una versión menor respecto al servidor de la API
- Un clúster de Kubernetes funcional (EKS, minikube, kind, etc.)
Desplegar la aplicación de ejemplo
# Create namespace
kubectl create namespace workloads-demo

# Create a simple deployment
kubectl -n workloads-demo apply -f - <<EOF
apiVersion: apps/v1
kind: Deployment
metadata:
  name: nginx-deployment
  labels:
    app: nginx
spec:
  replicas: 3
  selector:
    matchLabels:
      app: nginx
  template:
    metadata:
      labels:
        app: nginx
    spec:
      containers:
      - name: nginx
        image: nginx:1.30.4
        ports:
        - containerPort: 80
        resources:
          requests:
            memory: "64Mi"
            cpu: "100m"
          limits:
            memory: "128Mi"
            cpu: "200m"
EOF

# Check deployment status
kubectl -n workloads-demo get deployments,pods
Tabla de contenido
- Conceptos de Pod
- Ciclo de vida de Pod
- Patrones de diseño de Pod
- Resumen de recursos de carga de trabajo
- ReplicaSet
- Deployment
- StatefulSet
- DaemonSet
- Jobs y CronJobs
Conceptos de Pod
Concepto clave: Un Pod es la unidad de computación desplegable más pequeña de Kubernetes y consta de uno o más grupos de contenedores que comparten almacenamiento y red.
Un Pod es la unidad de computación desplegable más pequeña de Kubernetes. Un Pod es un grupo de uno o más contenedores que comparten almacenamiento y red y se programan juntos.
Características de Pod
- Contexto compartido: Los contenedores comparten la red del Pod y normalmente IPC; compartir el espacio de nombres de procesos requiere
shareProcessNamespace: true. Los sistemas de archivos raíz de los contenedores siguen siendo independientes. - Mismo nodo: Todos los contenedores de un Pod siempre se ejecutan en el mismo nodo.
- Dirección IP única: Cada Pod tiene una dirección IP única dentro del clúster.
- Efímero: Los Pods son intrínsecamente efímeros y se pueden reemplazar por Pods nuevos en caso de error.
- Unidad atómica: Los Pods son la unidad atómica de despliegue, programación y replicación.
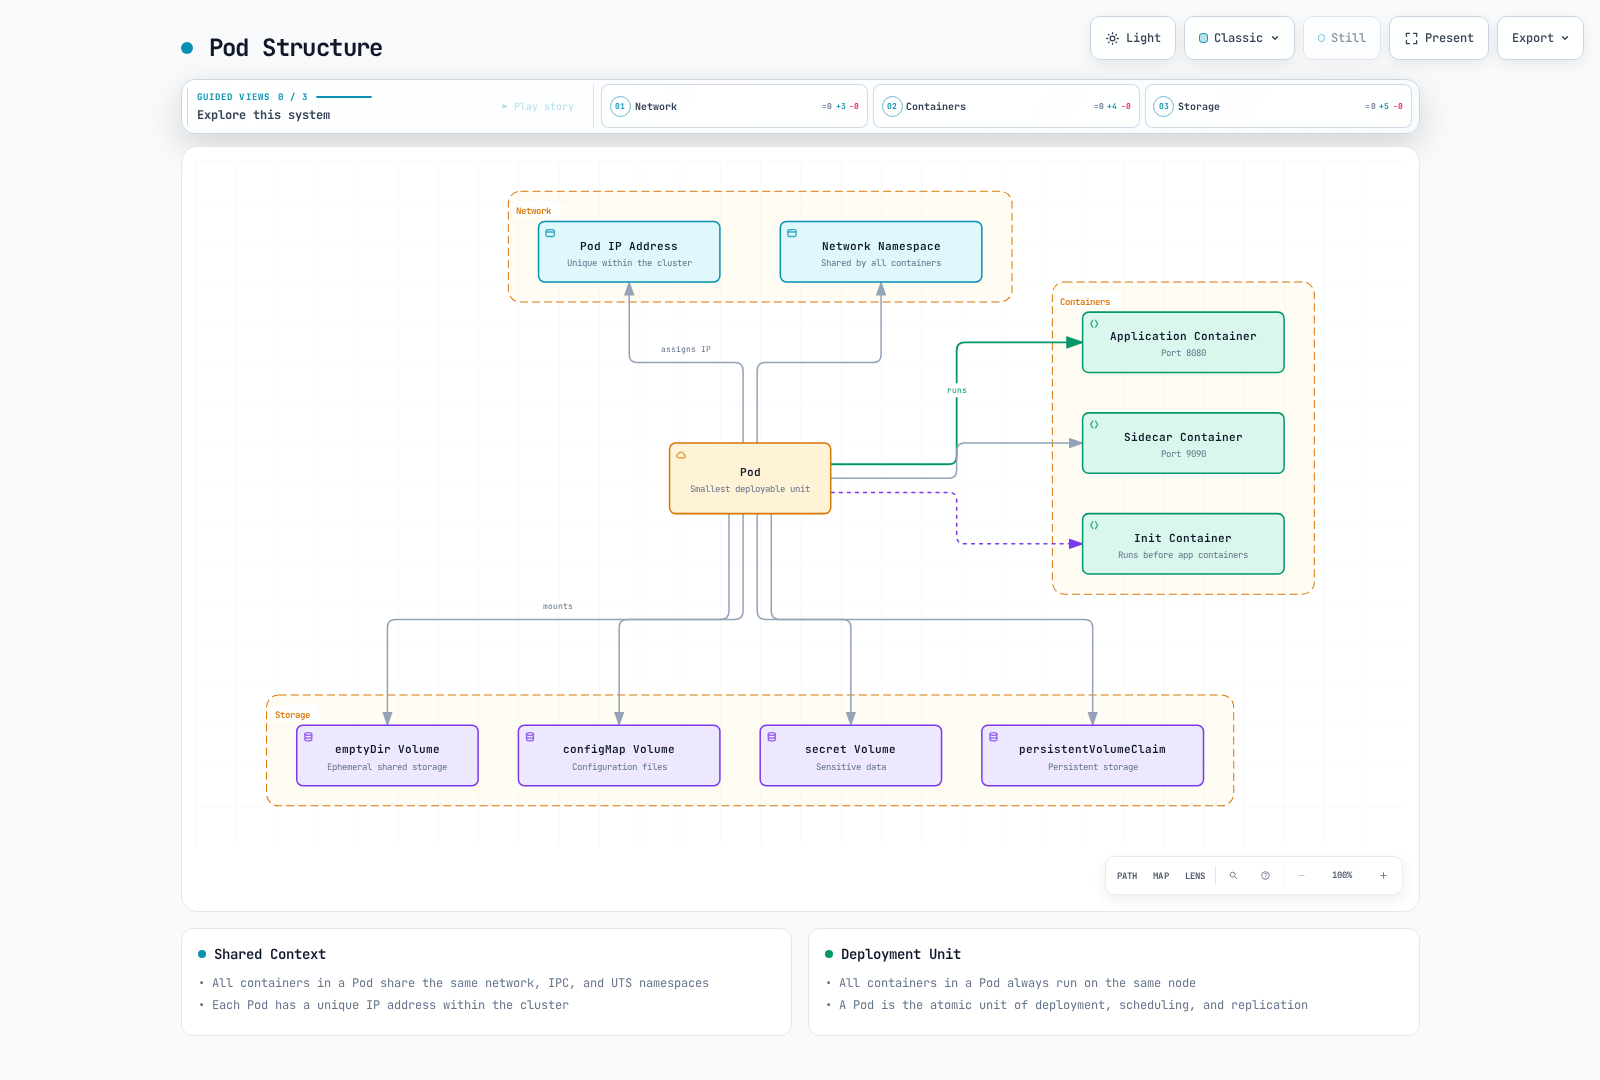
Estructura de Pod
Un Pod consta de los siguientes componentes:
- Contenedores: Uno o más contenedores que se ejecutan dentro del Pod
- Volúmenes: Almacenamiento compartido por los contenedores dentro del Pod
- Red: Dirección IP y puertos asignados al Pod
- Especificación del contenedor: Imagen de contenedor, variables de entorno, requisitos de recursos, etc.
Ejemplo de Pod
apiVersion: v1
kind: Pod
metadata:
  name: multi-container-pod
  labels:
    app: web
spec:
  containers:
  - name: web
    image: nginx:1.30.4
    ports:
    - containerPort: 80
    volumeMounts:
    - name: shared-data
      mountPath: /usr/share/nginx/html
  - name: content-updater
    image: alpine
    command: ["/bin/sh", "-c"]
    args:
    - |
      while true; do
        echo "Current time: $(date)" > /content/index.html;
        sleep 10;
      done
    volumeMounts:
    - name: shared-data
      mountPath: /content
  volumes:
  - name: shared-data
    emptyDir: {}
Ejemplo práctico: Pod de aplicación web
El siguiente es un ejemplo de un Pod que contiene una aplicación web y un contenedor sidecar:
apiVersion: v1
kind: Pod
metadata:
  name: web-app
  labels:
    app: web
    environment: production
spec:
  containers:
  - name: web-application
    image: nginx:1.30.4
    volumeMounts:
    - name: log-volume
      mountPath: /var/log/nginx
    ports:
    - containerPort: 80
    resources:
      requests:
        memory: "128Mi"
        cpu: "100m"
      limits:
        memory: "256Mi"
        cpu: "500m"
  - name: log-collector
    image: fluentd:v1.19-debian-1
    volumeMounts:
    - name: log-volume
      mountPath: /var/log/nginx
    resources:
      requests:
        memory: "64Mi"
        cpu: "50m"
      limits:
        memory: "128Mi"
        cpu: "100m"
  volumes:
  - name: log-volume
    emptyDir: {}
Este ejemplo demuestra el siguiente escenario real:
- Ejecutar el servidor web Nginx como contenedor principal
- Ejecutar el recolector de logs Fluentd como contenedor sidecar
- Compartir el volumen de logs entre dos contenedores
- Establecer solicitudes y límites de recursos para cada contenedor
Esta configuración es adecuada para ejecutar contenedores estrechamente conectados mientras se separan funcionalidades como el registro, la monitorización y la creación de proxies en arquitecturas de microservicios.
Estos manifiestos de registro ilustran la conexión de volúmenes. Fluentd también necesita una configuración explícita de origen y salida tail; montar un directorio por sí solo no recopila sus logs. Las imágenes y la configuración de la aplicación son ilustrativas, no recomendaciones de versiones de producción. Los sidecars nativos utilizan initContainers con restartPolicy: Always (estable desde la v1.33); los Pods multi-contenedor ordinarios no garantizan el orden de inicio o apagado.
Definición de Pod
Los Pods se definen mediante archivos de manifiesto en formato YAML o JSON. Este es un ejemplo básico de definición de Pod:
apiVersion: v1
kind: Pod
metadata:
  name: nginx-pod
  labels:
    app: nginx
spec:
  containers:
  - name: nginx
    image: nginx:1.30.4
    ports:
    - containerPort: 80
    resources:
      requests:
        memory: "64Mi"
        cpu: "250m"
      limits:
        memory: "128Mi"
        cpu: "500m"
Pods de un solo contenedor frente a Pods multi-contenedor
Pods de un solo contenedor:
- Caso de uso más común
- Contiene solo un contenedor de aplicación
- Estructura simple e intuitiva
Pods multi-contenedor:
- Contiene varios contenedores estrechamente acoplados
- Posibilidad de comunicación local entre contenedores (localhost)
- Uso compartido de datos mediante volúmenes compartidos
- Se escalan y colocan juntos
Patrones de Pod multi-contenedor
- Patrón Sidecar: Contenedor auxiliar que amplía la funcionalidad del contenedor principal
- Ejemplos: recolector de logs, sincronización de archivos, proxy
apiVersion: v1
kind: Pod
metadata:
  name: web-with-sidecar
spec:
  containers:
  - name: web
    image: nginx:1.30.4
    volumeMounts:
    - name: logs
      mountPath: /var/log/nginx
  - name: log-collector
    image: fluentd:v1.19-debian-1
    volumeMounts:
    - name: logs
      mountPath: /var/log/nginx
  volumes:
  - name: logs
emptyDir: {}- Patrón Ambassador: Contenedor que actúa como proxy para servicios externos
- Ejemplos: proxy de base de datos, sidecar de service mesh
apiVersion: v1
kind: Pod
metadata:
  name: app-with-ambassador
spec:
  containers:
  - name: app
    image: myapp:1.0
  - name: ambassador
    image: envoyproxy/envoy:v1.20.0
    ports:
- containerPort: 9901- Patrón Adapter: Contenedor que estandariza la salida del contenedor principal
- Ejemplos: conversión de formato de logs, conversión de métricas
apiVersion: v1
kind: Pod
metadata:
  name: app-with-adapter
spec:
  containers:
  - name: app
    image: myapp:1.0
    volumeMounts:
    - name: app-logs
      mountPath: /var/log/app
  - name: adapter
    image: adapter:1.0
    volumeMounts:
    - name: app-logs
      mountPath: /var/log/app
  volumes:
  - name: app-logs
emptyDir: {}- Patrón de contenedor init: Contenedor que se ejecuta antes de que se inicie el contenedor principal
- Ejemplos: creación de archivos de configuración, migración de base de datos, configuración de permisos
apiVersion: v1
kind: Pod
metadata:
  name: app-with-init
spec:
  initContainers:
  - name: init-db
    image: busybox:1.34
    command: ['sh', '-c', 'until nslookup db; do echo waiting for db; sleep 2; done;']
  containers:
  - name: app
    image: myapp:1.0
Redes de Pod
Los contenedores dentro de un Pod tienen las siguientes características de red:
- Misma dirección IP: Todos los contenedores dentro de un Pod comparten la misma dirección IP.
- Uso compartido de puertos: Los contenedores dentro de un Pod comparten el espacio de puertos, por lo que normalmente no pueden asociar la misma combinación de IP/protocolo/puerto.
- Comunicación mediante localhost: Los contenedores dentro de un Pod pueden comunicarse entre sí a través de localhost.
- Comunicación entre Pods: Cada Pod tiene una dirección IP única y puede comunicarse directamente con otros Pods.
Almacenamiento de Pod
Los Pods pueden utilizar diversos tipos de volúmenes para almacenar y compartir datos:
- emptyDir: Volumen temporal creado cuando se crea el Pod y eliminado cuando se elimina el Pod
- hostPath: Volumen montado desde el sistema de archivos del nodo host al Pod
- persistentVolumeClaim: Volumen que solicita almacenamiento persistente
- configMap: ConfigMap montado como volumen
- secret: Secret montado como volumen
- projected: Varias fuentes de volumen asignadas al mismo directorio
apiVersion: v1
kind: Pod
metadata:
  name: pod-with-volumes
spec:
  containers:
  - name: app
    image: myapp:1.0
    volumeMounts:
    - name: data
      mountPath: /data
    - name: config
      mountPath: /etc/config
  volumes:
  - name: data
    emptyDir: {}
  - name: config
    configMap:
      name: app-config
Ciclo de vida de Pod
Los Pods pasan por diversas etapas del ciclo de vida desde su creación hasta su terminación. Comprender este ciclo de vida es importante para garantizar la estabilidad y disponibilidad de la aplicación.
Fases de Pod
Los Pods pasan por las siguientes fases:
- Pending: El Pod ha sido aceptado por el clúster, pero todavía no se han configurado uno o más contenedores
- Running: El Pod se ha asociado a un nodo, se han creado todos los contenedores y al menos uno se está ejecutando o iniciando/reiniciando
- Succeeded: Todos los contenedores del Pod han finalizado correctamente y no se reiniciarán
- Failed: Todos los contenedores del Pod han finalizado y al menos uno ha terminado con error
- Unknown: No se pudo obtener el estado del Pod por algún motivo
Estados de contenedor
Cada contenedor dentro de un Pod puede tener los siguientes estados:
- Waiting: Estado previo a la ejecución del contenedor (descargando la imagen, esperando dependencias, etc.)
- Running: El proceso se está ejecutando; esto por sí solo no establece el estado de salud ni la preparación de la aplicación
- Terminated: El contenedor ha completado la ejecución o ha fallado por algún motivo
Condiciones de Pod
Los Pods indican su estado de forma más específica mediante las siguientes condiciones:
- PodScheduled: Si el Pod se ha programado en un nodo
- ContainersReady: Si todos los contenedores del Pod están preparados
- Initialized: Los contenedores init regulares se han completado y los contenedores init reiniciables (sidecars nativos) se han iniciado
- Ready: Si el Pod puede gestionar solicitudes y puede añadirse al grupo de balanceo de carga de los servicios
Probes de contenedor
Kubernetes proporciona las siguientes probes para comprobar el estado de los contenedores:
- livenessProbe: Comprueba si el contenedor está activo; reinicia el contenedor en caso de error
- readinessProbe: Comprueba si el contenedor está preparado para gestionar solicitudes; se excluye del tráfico del servicio en caso de error
- startupProbe: Comprueba si se ha iniciado la aplicación dentro del contenedor; deshabilita otras probes hasta que se complete correctamente
apiVersion: v1
kind: Pod
metadata:
  name: pod-with-probes
spec:
  containers:
  - name: app
    image: myapp:1.0
    ports:
    - containerPort: 8080
    livenessProbe:
      httpGet:
        path: /healthz
        port: 8080
      initialDelaySeconds: 30
      periodSeconds: 10
      timeoutSeconds: 5
      failureThreshold: 3
    readinessProbe:
      httpGet:
        path: /ready
        port: 8080
      initialDelaySeconds: 5
      periodSeconds: 5
    startupProbe:
      httpGet:
        path: /startup
        port: 8080
      failureThreshold: 30
      periodSeconds: 10
Proceso de terminación de Pod
Cuando se termina un Pod, ocurre el siguiente proceso:
- Solicitud de eliminación al servidor de la API: El usuario o controlador solicita la eliminación del Pod
- Inicio del período de terminación: Se establece el período de terminación predeterminado (30 segundos)
- Actualización de la API: El servidor de la API actualiza la marca de tiempo de eliminación del Pod
- Actualización de endpoint: Los EndpointSlices marcan el endpoint como terminándose y no preparado; la propagación ocurre simultáneamente con el apagado del nodo
- Señal de detención: kubelet ejecuta cualquier hook preStop dentro del período de gracia y, después, solicita al runtime que envíe la señal de detención (normalmente SIGTERM, salvo que la imagen o el contenedor la anulen)
- Espera de apagado ordenado: Se proporciona tiempo para que las aplicaciones se apaguen ordenadamente
- Señal SIGKILL: Si los contenedores no terminan tras el período de terminación, se envía la señal SIGKILL
- Limpieza de recursos: kubelet limpia los recursos del Pod
Contenedores init
Los contenedores init son contenedores especiales que se ejecutan antes de que se inicien los contenedores de aplicación de un Pod:
- Ejecución secuencial: Los contenedores init se ejecutan uno a la vez en el orden en que se definen
- Requisito previo: Cada contenedor init comienza solo después de que el contenedor anterior haya finalizado correctamente
- Reinicio en caso de error: Si un contenedor init falla, se reinicia según la política de reinicio del Pod
- Propósito: Configuración antes de que se inicie el contenedor de aplicación, verificación de dependencias, configuración de permisos, etc.
apiVersion: v1
kind: Pod
metadata:
  name: init-pod
spec:
  initContainers:
  - name: init-myservice
    image: busybox:1.34
    command: ['sh', '-c', 'until nslookup myservice; do echo waiting for myservice; sleep 2; done;']
  - name: init-mydb
    image: busybox:1.34
    command: ['sh', '-c', 'until nslookup mydb; do echo waiting for mydb; sleep 2; done;']
  containers:
  - name: app
    image: myapp:1.0
Interrupción de Pod
Las interrupciones de Pod se pueden dividir en voluntarias o involuntarias:
Interrupciones voluntarias: Interrupciones realizadas por administradores del clúster o herramientas de automatización
- Drenaje de nodos
- Actualizaciones de Deployment
- Eliminación de Pod
Interrupciones involuntarias: Interrupciones debidas a fallos de hardware, kernel panics, particiones de red, etc.
PodDisruptionBudget limita las expulsiones voluntarias mediante la API Eviction (por ejemplo, drain). La eliminación directa de Pods y las actualizaciones continuas de Deployment la omiten; configura por separado la disponibilidad del rollout. No puede evitar fallos involuntarios.
Patrones de diseño de Pod
Hay varios patrones y prácticas recomendadas que se deben considerar al diseñar Pods. Comprender y aplicar estos patrones puede mejorar la estabilidad, escalabilidad y facilidad de mantenimiento de la aplicación.
Principio de responsabilidad única
Los Pods deben seguir el principio de responsabilidad única:
- Una función principal: Cada Pod debe ser responsable de una función o proceso principal
- Escalado independiente: Diseña de modo que cada función pueda escalar de forma independiente
- Ciclo de vida independiente: Diseña de modo que cada función pueda tener su propio ciclo de vida
Plantillas de Pod
Las plantillas de Pod son especificaciones utilizadas para crear Pods en recursos de carga de trabajo (Deployments, StatefulSets, etc.):
apiVersion: apps/v1
kind: Deployment
metadata:
  name: nginx-deployment
spec:
  replicas: 3
  selector:
    matchLabels:
      app: nginx
  template:  # Pod template starts
    metadata:
      labels:
        app: nginx
    spec:
      containers:
      - name: nginx
        image: nginx:1.30.4
        ports:
        - containerPort: 80
  # Pod template ends
Afinidad y antiafinidad de Pod
La afinidad y antiafinidad de Pod son reglas que controlan en qué nodos se programan los Pods:
- Afinidad de Pod: Programa en el mismo nodo o dominio de topología que Pods específicos
- Antiafinidad de Pod: Programa en un nodo o dominio de topología distinto de Pods específicos
apiVersion: v1
kind: Pod
metadata:
  name: web-pod
spec:
  affinity:
    podAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
      - labelSelector:
          matchExpressions:
          - key: app
            operator: In
            values:
            - cache
        topologyKey: "kubernetes.io/hostname"
    podAntiAffinity:
      preferredDuringSchedulingIgnoredDuringExecution:
      - weight: 100
        podAffinityTerm:
          labelSelector:
            matchExpressions:
            - key: app
              operator: In
              values:
              - web
          topologyKey: "kubernetes.io/hostname"
  containers:
  - name: web
    image: nginx:1.30.4
Afinidad de nodo
La afinidad de nodo es una regla que restringe que los Pods se programen en nodos específicos:
apiVersion: v1
kind: Pod
metadata:
  name: gpu-pod
spec:
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
        - matchExpressions:
          - key: gpu
            operator: In
            values:
            - "true"
  containers:
  - name: gpu-container
    image: gpu-app:1.0
Taints y tolerations
Los taints se aplican a los nodos para evitar que se programen determinados Pods, y las tolerations se aplican a los Pods para permitir la programación en nodos con taints:
# Apply taint to node
kubectl taint nodes node1 key=value:NoSchedule# Apply toleration to Pod
apiVersion: v1
kind: Pod
metadata:
name: tolerant-pod
spec:
tolerations:
- key: "key"
operator: "Equal"
value: "value"
effect: "NoSchedule"
containers:
- name: app
image: myapp:1.0Solicitudes y límites de recursos
Establecer solicitudes y límites de recursos para los contenedores en Pods es importante para el uso eficiente de los recursos del clúster y para garantizar la estabilidad:
apiVersion: v1
kind: Pod
metadata:
  name: resource-pod
spec:
  containers:
  - name: app
    image: myapp:1.0
    resources:
      requests:
        memory: "64Mi"
        cpu: "250m"
      limits:
        memory: "128Mi"
        cpu: "500m"
Contexto de seguridad de Pod
El contexto de seguridad define configuraciones de seguridad en el nivel de Pod o de contenedor:
apiVersion: v1
kind: Pod
metadata:
  name: security-pod
spec:
  securityContext:
    runAsUser: 1000
    runAsGroup: 3000
    fsGroup: 2000
  containers:
  - name: app
    image: myapp:1.0
    securityContext:
      allowPrivilegeEscalation: false
      capabilities:
        drop:
        - ALL
Prioridad y preemption de Pod
La prioridad y preemption de Pod determinan qué Pods se programan y cuáles se expropian cuando los recursos del clúster son insuficientes:
# Priority class definition
apiVersion: scheduling.k8s.io/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 1000000
globalDefault: false
description: "This priority class should be used for critical pods only."
---
# Pod using priority class
apiVersion: v1
kind: Pod
metadata:
  name: high-priority-pod
spec:
  priorityClassName: high-priority
  containers:
  - name: app
    image: myapp:1.0
Resumen de recursos de carga de trabajo
Kubernetes proporciona diversos recursos de carga de trabajo para gestionar Pods. Cada recurso de carga de trabajo está diseñado para casos de uso y requisitos específicos.
Tipos de recursos de carga de trabajo
Los principales recursos de carga de trabajo de Kubernetes son:
- ReplicaSet: Mantiene un número especificado de réplicas de Pod
- Deployment: Gestiona ReplicaSets para proporcionar actualizaciones declarativas
- StatefulSet: Recurso para aplicaciones que requieren persistencia de estado
- DaemonSet: Ejecuta una copia de un Pod en todos los nodos
- Job: Tareas de una sola vez que terminan después de completarse
- CronJob: Ejecuta Jobs periódicamente según una programación
Criterios de selección de recursos de carga de trabajo
Criterios para seleccionar el recurso de carga de trabajo adecuado:
- Persistencia de estado: Si la aplicación necesita mantener el estado
- Patrón de ejecución: Si se ejecuta continuamente, una sola vez o periódicamente
- Requisitos de despliegue: Requisitos para actualizaciones continuas, despliegues blue/green, etc.
- Cobertura de nodos: Si necesita ejecutarse en todos los nodos
- Requisitos de escalabilidad: Si se necesita escalado horizontal
ReplicaSet
Un ReplicaSet garantiza que siempre se esté ejecutando un número especificado de réplicas de Pod. Si los Pods fallan o se eliminan, el ReplicaSet crea automáticamente Pods de reemplazo.
Características principales de ReplicaSet
- Mantener réplicas de Pod: Mantiene el número especificado de réplicas de Pod
- Selección de Pod: Identifica los Pods que se deben gestionar mediante selectores de etiquetas
- Creación de Pod: Crea nuevos Pods cuando es necesario
- Eliminación de Pod: Elimina los Pods sobrantes
Definición de ReplicaSet
apiVersion: apps/v1
kind: ReplicaSet
metadata:
  name: frontend
  labels:
    app: guestbook
    tier: frontend
spec:
  replicas: 3
  selector:
    matchLabels:
      tier: frontend
  template:
    metadata:
      labels:
        tier: frontend
    spec:
      containers:
      - name: php-redis
        image: gcr.io/google_samples/gb-frontend:v3
        resources:
          requests:
            cpu: 100m
            memory: 100Mi
        ports:
        - containerPort: 80
Funcionamiento de ReplicaSet
- Coincidencia de selector de etiquetas: ReplicaSet identifica los Pods que coinciden con el selector de etiquetas
- Comprobar el estado actual: Verifica el número de Pods que se están ejecutando actualmente
- Comparar con el estado deseado: Compara el recuento actual de Pods con el número de réplicas deseado
- Acciones de ajuste: Crea o elimina Pods según sea necesario
ReplicaSet frente a Replication Controller
ReplicaSet es el sucesor de Replication Controller y proporciona selectores de etiquetas más potentes:
- Replication Controller: Admite solo selectores basados en igualdad (p. ej., app=nginx)
- ReplicaSet: Admite selectores basados en conjuntos (p. ej., app in (nginx, apache))
Casos de uso de ReplicaSet
Los ReplicaSets generalmente se utilizan de forma indirecta a través de Deployments, en lugar de directamente. Sin embargo, se pueden utilizar directamente en los siguientes casos:
- Replicación simple: Cuando simplemente se mantienen réplicas de Pod
- Actualizaciones personalizadas: Cuando se necesitan mecanismos de actualización personalizados
- Compatibilidad con sistemas heredados: Compatibilidad con aplicaciones heredadas
Deployment
Un Deployment gestiona ReplicaSets para proporcionar actualizaciones declarativas de los Pods. Los Deployments gestionan actualizaciones continuas, reversiones, escalado y más para las aplicaciones.
Características principales de Deployment
- Actualizaciones declarativas: Declara el estado deseado y Deployment cambia el estado actual al estado deseado
- Actualizaciones continuas: Actualiza aplicaciones sin tiempo de inactividad
- Reversión: Reversión sencilla a versiones anteriores
- Escalado: Ajusta el número de réplicas de la aplicación
- Historial de despliegue: Mantiene registros de versiones de despliegues anteriores
Definición de Deployment
apiVersion: apps/v1
kind: Deployment
metadata:
  name: nginx-deployment
  labels:
    app: nginx
spec:
  replicas: 3
  selector:
    matchLabels:
      app: nginx
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxSurge: 1
      maxUnavailable: 0
  template:
    metadata:
      labels:
        app: nginx
    spec:
      containers:
      - name: nginx
        image: nginx:1.30.4
        ports:
        - containerPort: 80
        resources:
          requests:
            cpu: 100m
            memory: 100Mi
          limits:
            cpu: 200m
            memory: 200Mi
        livenessProbe:
          httpGet:
            path: /
            port: 80
          initialDelaySeconds: 30
          periodSeconds: 10
        readinessProbe:
          httpGet:
            path: /
            port: 80
          initialDelaySeconds: 5
          periodSeconds: 5
Estrategias de actualización de Deployment
Los Deployments proporcionan dos estrategias de actualización:
RollingUpdate: Actualiza gradualmente los Pods para el despliegue sin tiempo de inactividad (predeterminado)
- maxSurge: Número máximo de Pods que se pueden crear por encima del recuento de Pods deseado
- maxUnavailable: Número máximo de Pods no disponibles durante la actualización
Recreate: Elimina todos los Pods existentes antes de crear Pods nuevos (provoca tiempo de inactividad temporal)
Reversión de Deployment
Los Deployments admiten la reversión a versiones anteriores:
# Check deployment history
kubectl -n workloads-demo rollout history deployment/nginx-deployment

# Check details of specific version
kubectl -n workloads-demo rollout history deployment/nginx-deployment --revision=2

# Rollback to previous version
kubectl -n workloads-demo rollout undo deployment/nginx-deployment

# Rollback to specific version
kubectl -n workloads-demo rollout undo deployment/nginx-deployment --to-revision=2
Escalado de Deployment
Los Deployments se pueden escalar fácilmente:
# Imperative scaling
kubectl -n workloads-demo scale deployment/nginx-deployment --replicas=5

# Declarative scaling (after modifying YAML file)
kubectl apply -f deployment.yaml
Pausar y reanudar Deployment
Los rollouts de Deployment se pueden pausar y reanudar:
# Pause rollout
kubectl -n workloads-demo rollout pause deployment/nginx-deployment

# Apply multiple changes
kubectl -n workloads-demo set image deployment/nginx-deployment nginx=nginx:1.30.4-alpine
kubectl -n workloads-demo set resources deployment/nginx-deployment -c=nginx --limits=cpu=200m,memory=256Mi

# Resume rollout
kubectl -n workloads-demo rollout resume deployment/nginx-deployment
Estado de Deployment
Las condiciones de Deployment incluyen Progressing, Available y ReplicaFailure. Un rollout bloqueado puede informar Progressing=False con la razón ProgressDeadlineExceeded; Kubernetes no lo revierte automáticamente. “Completo” describe la finalización del rollout en lugar de un tipo de condición.
StatefulSet
StatefulSet es un recurso de carga de trabajo para aplicaciones que requieren persistencia de estado. Asigna identificadores únicos a cada Pod y proporciona identificadores de red estables y almacenamiento persistente.
Características principales de StatefulSet
- Identificadores de red estables y únicos: Los nombres y hostnames de Pod se mantienen incluso después de reinicios
- Almacenamiento estable y persistente: Acceso al mismo almacenamiento incluso cuando los Pods se reprograman
- Despliegue y escalado secuenciales: Los Pods se crean, actualizan y eliminan en orden
- Actualizaciones continuas automáticas secuenciales: Los Pods se actualizan en orden
Definición de StatefulSet
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: web
spec:
  selector:
    matchLabels:
      app: nginx
  serviceName: "nginx"
  replicas: 3
  updateStrategy:
    type: RollingUpdate
  podManagementPolicy: OrderedReady
  template:
    metadata:
      labels:
        app: nginx
    spec:
      containers:
      - name: nginx
        image: nginx:1.30.4
        ports:
        - containerPort: 80
          name: web
        volumeMounts:
        - name: www
          mountPath: /usr/share/nginx/html
  volumeClaimTemplates:
  - metadata:
      name: www
    spec:
      accessModes: [ "ReadWriteOnce" ]
      storageClassName: "standard"
      resources:
        requests:
          storage: 1Gi
Identificadores de Pod de StatefulSet
StatefulSet asigna identificadores únicos a los Pods en el siguiente formato:
<StatefulSet name>-<ordinal index>Por ejemplo, un StatefulSet web crea Pods como web-0, web-1, web-2.
Service sin cabecera de StatefulSet
Los StatefulSets se utilizan normalmente con un service sin cabecera (clusterIP: None). Esto crea registros DNS para cada Pod:
apiVersion: v1
kind: Service
metadata:
  name: nginx
  labels:
    app: nginx
spec:
  ports:
  - port: 80
    name: web
  clusterIP: None
  selector:
    app: nginx
Con esto, cada Pod tiene un nombre DNS en el siguiente formato:
<Pod name>.<service name>.<namespace>.svc.cluster.localEjemplo: web-0.nginx.default.svc.cluster.local
Almacenamiento de StatefulSet
Los StatefulSets utilizan volumeClaimTemplates para crear automáticamente Persistent Volume Claims (PVCs) para cada Pod. Estos PVCs se mantienen incluso cuando los Pods se reprograman.
Estrategias de actualización de StatefulSet
Los StatefulSets proporcionan dos estrategias de actualización:
- RollingUpdate: Actualiza los Pods en orden (predeterminado)
- OnDelete: Actualiza solo cuando se eliminan los Pods
Política de gestión de Pod
Los StatefulSets proporcionan dos políticas de gestión de Pod:
- OrderedReady: Crea y termina los Pods en orden (predeterminado)
- Parallel: Crea y termina los Pods en paralelo
Casos de uso de StatefulSet
Los StatefulSets son adecuados para las siguientes aplicaciones:
- Bases de datos: MySQL, PostgreSQL, MongoDB, etc.
- Sistemas distribuidos: Kafka, ZooKeeper, Elasticsearch, etc.
- Colas de mensajes: RabbitMQ, etc.
- Otras aplicaciones con estado: Servidores de archivos, almacenes de sesiones, etc.
Ejemplo de StatefulSet: instancia MySQL persistente
Este ejemplo demuestra una identidad estable y un PVC para una instancia de MySQL. No configura replicación ni failover automático de la base de datos. Aumentar replicas crearía bases de datos independientes. Crea mysql-secret con una clave password en el mismo namespace y proporciona una StorageClass predeterminada (o establece explícitamente una clase adecuada). Utiliza un patch/digest probado de MySQL 8.4; los cambios de credenciales requieren rotación a nivel de base de datos, no simplemente actualizar el Secret.
apiVersion: v1
kind: Service
metadata:
  name: mysql
spec:
  clusterIP: None
  selector:
    app: mysql
  ports:
  - name: mysql
    port: 3306
---
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: mysql
spec:
  serviceName: mysql
  replicas: 1
  selector:
    matchLabels:
      app: mysql
  podManagementPolicy: OrderedReady
  template:
    metadata:
      labels:
        app: mysql
    spec:
      containers:
      - name: mysql
        image: mysql:8.4
        env:
        - name: MYSQL_ROOT_PASSWORD
          valueFrom:
            secretKeyRef:
              name: mysql-secret
              key: password
        ports:
        - name: mysql
          containerPort: 3306
        startupProbe:
          tcpSocket:
            port: mysql
          periodSeconds: 10
          failureThreshold: 60
        readinessProbe:
          exec:
            command:
            - sh
            - -c
            - 'MYSQL_PWD="$MYSQL_ROOT_PASSWORD" mysql -h 127.0.0.1 -u root -e "SELECT 1"'
          periodSeconds: 10
          timeoutSeconds: 5
        resources:
          requests:
            cpu: 500m
            memory: 1Gi
          limits:
            memory: 2Gi
        volumeMounts:
        - name: data
          mountPath: /var/lib/mysql
  volumeClaimTemplates:
  - metadata:
      name: data
    spec:
      accessModes: [ReadWriteOnce]
      resources:
        requests:
          storage: 10Gi
Para la replicación y promoción de líder, utiliza un operador de base de datos o un runbook de replicación probado por separado. StatefulSet por sí solo no proporciona ninguno de los dos. El tutorial de replicación upstream utiliza explícitamente valores predeterminados de enseñanza inseguros y no es una configuración de producción.
DaemonSet
Un DaemonSet garantiza que una copia de un Pod se ejecute en todos los nodos (o nodos específicos). Cuando se añade un nodo al clúster, los Pods se añaden automáticamente y, cuando se elimina un nodo, los Pods también se eliminan.
Características principales de DaemonSet
- Ejecutar en todos los nodos: Ejecuta Pods en todos los nodos del clúster
- Selección de nodos: Puede ejecutarse solo en nodos específicos mediante selectores de nodos
- Despliegue automático: Despliega automáticamente Pods cuando se añaden nodos nuevos
- Limpieza automática: Limpia automáticamente los Pods cuando se eliminan nodos
Definición de DaemonSet
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: fluentd-elasticsearch
  namespace: kube-system
  labels:
    k8s-app: fluentd-logging
spec:
  selector:
    matchLabels:
      name: fluentd-elasticsearch
  updateStrategy:
    type: RollingUpdate
    rollingUpdate:
      maxUnavailable: 1
  template:
    metadata:
      labels:
        name: fluentd-elasticsearch
    spec:
      tolerations:
      - key: node-role.kubernetes.io/control-plane
        effect: NoSchedule
      containers:
      - name: fluentd-elasticsearch
        image: quay.io/fluentd_elasticsearch/fluentd:v2.5.2
        resources:
          limits:
            memory: 200Mi
          requests:
            cpu: 100m
            memory: 200Mi
        volumeMounts:
        - name: varlog
          mountPath: /var/log
          readOnly: true
      terminationGracePeriodSeconds: 30
      volumes:
      - name: varlog
        hostPath:
          path: /var/log
Para los runtimes CRI, configura el recolector para analizar los logs de CRI en /var/log/pods (normalmente enlazados desde /var/log/containers), no los logs JSON de Docker. El recolector necesita su propia configuración de origen/salida y RBAC.
Estrategias de actualización de DaemonSet
Los DaemonSets proporcionan dos estrategias de actualización:
RollingUpdate: Actualiza los Pods secuencialmente (predeterminado)
- maxUnavailable: Número máximo de Pods no disponibles durante la actualización
OnDelete: Actualiza solo cuando se eliminan los Pods
Selección de nodos de DaemonSet
Los DaemonSets se pueden configurar para ejecutarse solo en nodos específicos:
spec:
  template:
    spec:
      nodeSelector:
        disk: ssd
Tolerations de DaemonSet para taints
Los DaemonSets pueden establecer tolerations para ejecutarse en nodos con taints:
spec:
  template:
    spec:
      tolerations:
      - key: node-role.kubernetes.io/control-plane
        effect: NoSchedule
Casos de uso de DaemonSet
Los DaemonSets se utilizan para los siguientes fines:
- Recolectores de logs: Fluentd, Logstash, etc.
- Agentes de monitorización: Prometheus Node Exporter, Datadog Agent, etc.
- Plugins de red: Calico, Cilium, etc.
- Daemons de almacenamiento: Ceph, GlusterFS, etc.
- Agentes de seguridad: Falco, Sysdig, etc.
Ejemplo de DaemonSet: Prometheus Node Exporter
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: node-exporter
  namespace: monitoring
  labels:
    app: node-exporter
spec:
  selector:
    matchLabels:
      app: node-exporter
  template:
    metadata:
      labels:
        app: node-exporter
    spec:
      hostNetwork: true
      hostPID: true
      containers:
      - name: node-exporter
        image: prom/node-exporter:v1.3.1
        args:
        - --path.procfs=/host/proc
        - --path.sysfs=/host/sys
        - --path.rootfs=/host/root
        - --web.listen-address=:9100
        ports:
        - containerPort: 9100
          protocol: TCP
          name: http
        resources:
          limits:
            cpu: 250m
            memory: 180Mi
          requests:
            cpu: 102m
            memory: 180Mi
        volumeMounts:
        - name: proc
          mountPath: /host/proc
          readOnly: true
        - name: sys
          mountPath: /host/sys
          readOnly: true
        - name: root
          mountPath: /host/root
          readOnly: true
      tolerations:
      - operator: "Exists"
      volumes:
      - name: proc
        hostPath:
          path: /proc
      - name: sys
        hostPath:
          path: /sys
      - name: root
        hostPath:
          path: /
Jobs y CronJobs
Los Jobs y CronJobs son recursos de carga de trabajo para ejecutar tareas únicas o periódicas.
Job
Un Job crea uno o más Pods y continúa la ejecución hasta que finalice correctamente un número especificado de Pods.
Características principales de Job
- Seguimiento de finalización: Realiza seguimiento de Pods correctos; los límites de reintentos o plazos pueden hacer que un Job falle
- Ejecución paralela: Puede ejecutar varios Pods en paralelo
- Reintento: Reintento automático de Pods que fallan
- Limpieza después de la finalización: Limpieza opcional de Pods después de que se complete el job
Definición de Job
apiVersion: batch/v1
kind: Job
metadata:
  name: pi
spec:
  completions: 5      # Number of Pods that must successfully complete
  parallelism: 2      # Number of Pods to run in parallel
  backoffLimit: 4     # Number of retries on failure
  activeDeadlineSeconds: 100  # Job time limit (seconds)
  ttlSecondsAfterFinished: 100  # Deletion time after completion (seconds)
  template:
    spec:
      containers:
      - name: pi
        image: perl:5.34
        command: ["perl", "-Mbignum=bpi", "-wle", "print bpi(2000)"]
        resources:
          requests:
            cpu: 100m
            memory: 50Mi
          limits:
            cpu: 100m
            memory: 100Mi
      restartPolicy: Never  # or OnFailure
Modos de finalización de Job
Los Jobs proporcionan dos modos de finalización:
- NonIndexed: Modo de job estándar en el que el job se completa cuando el número especificado de Pods finaliza correctamente
- Indexed: A cada Pod se le asigna un índice a partir de 0, realizando tareas para intervalos de índices específicos
apiVersion: batch/v1
kind: Job
metadata:
  name: indexed-job
spec:
  completions: 5
  parallelism: 3
  completionMode: Indexed  # Enable Indexed mode
  template:
    spec:
      containers:
      - name: worker
        image: busybox:1.34
        command: ["sh", "-c", "echo Processing item ${JOB_COMPLETION_INDEX}"]
      restartPolicy: Never
Casos de uso de Job
Los Jobs se utilizan para los siguientes fines:
- Procesamiento por lotes: Procesamiento de datos, tareas ETL
- Tareas de cálculo: Cálculos científicos, renderizado
- Migraciones de base de datos: Actualizaciones de esquema
- Tareas administrativas de una sola vez: Copias de seguridad, tareas de limpieza
CronJob
Los CronJobs ejecutan Jobs periódicamente según una programación especificada. Funcionan de forma similar a los trabajos cron de Linux.
Características principales de CronJob
- Ejecución programada: Especifica la programación de ejecución mediante expresiones cron
- Gestión de Job: Crea Jobs según la programación
- Política de concurrencia: Define el comportamiento cuando el job anterior aún está en ejecución
- Límite de historial: Limita el historial de jobs completados
Definición de CronJob
apiVersion: batch/v1
kind: CronJob
metadata:
  name: hello
spec:
  schedule: "*/1 * * * *"  # Run every minute
  timeZone: "America/New_York"  # Timezone (stable since Kubernetes 1.27)
  concurrencyPolicy: Forbid  # Allow, Forbid, Replace
  successfulJobsHistoryLimit: 3
  failedJobsHistoryLimit: 1
  startingDeadlineSeconds: 60
  jobTemplate:
    spec:
      template:
        spec:
          containers:
          - name: hello
            image: busybox:1.34
            command:
            - /bin/sh
            - -c
            - date; echo Hello from the Kubernetes cluster
          restartPolicy: OnFailure
Expresión cron
Las expresiones cron tienen el siguiente formato:
+------------------- minute (0 - 59)
| +----------------- hour (0 - 23)
| | +--------------- day of month (1 - 31)
| | | +------------- month (1 - 12)
| | | | +----------- day of week (0 - 6) (Sunday to Saturday; use 0 for Sunday)
| | | | |
| | | | |
* * * * *
Ejemplos comunes de expresiones cron:
*/5 * * * *: Cada 5 minutos0 * * * *: Cada hora en punto0 0 * * *: Todos los días a medianoche0 0 * * 0: Todos los domingos a medianoche0 0 1 * *: El primer día de cada mes a medianoche0 0 1 1 *: El 1 de enero a medianoche cada año
Política de concurrencia
Los CronJobs proporcionan tres políticas de concurrencia:
- Allow: Se pueden ejecutar varios Jobs simultáneamente (predeterminado)
- Forbid: Omite el Job nuevo si el Job anterior aún está en ejecución
- Replace: Reemplaza el Job anterior por uno nuevo si todavía está en ejecución
Casos de uso de CronJob
Los CronJobs se utilizan para los siguientes fines:
- Copias de seguridad regulares: Copias de seguridad de bases de datos, creación de snapshots
- Sincronización de datos: Sincronización periódica de datos
- Generación de informes: Generación de informes diarios/semanales/mensuales
- Tareas de limpieza: Limpieza de archivos temporales, rotación de logs
- Notificaciones y monitorización: Comprobaciones de estado, envío de alertas
Ejemplo de CronJob: copia de seguridad de base de datos
apiVersion: batch/v1
kind: CronJob
metadata:
  name: database-backup
spec:
  schedule: "0 2 * * *"
  timeZone: "Etc/UTC"
  concurrencyPolicy: Forbid
  successfulJobsHistoryLimit: 3
  failedJobsHistoryLimit: 1
  jobTemplate:
    spec:
      template:
        spec:
          containers:
          - name: backup
            image: postgres:14
            env:
            - name: PGHOST
              value: postgres-service
            - name: PGUSER
              valueFrom:
                secretKeyRef:
                  name: postgres-secret
                  key: username
            - name: PGPASSWORD
              valueFrom:
                secretKeyRef:
                  name: postgres-secret
                  key: password
            command:
            - /bin/sh
            - -c
            - |
              set -eu
              backup_file="/backup/db-$(date +%Y%m%d-%H%M%S).dump"
              trap 'rm -f "$backup_file.partial"' EXIT
              pg_dump -Fc > "$backup_file.partial"
              pg_restore --list "$backup_file.partial" > /dev/null
              mv "$backup_file.partial" "$backup_file"
              find /backup -maxdepth 1 -type f -name 'db-*.dump' -mtime +7 -delete
            volumeMounts:
            - name: backup-volume
              mountPath: /backup
          restartPolicy: OnFailure
          volumes:
          - name: backup-volume
            persistentVolumeClaim:
              claimName: backup-pvc
La programación de CronJob es aproximada: los jobs deben tolerar la ejecución duplicada. Forbid se aplica solo a los Jobs del mismo CronJob. Los límites de historial eliminan objetos Job/Pod, no archivos de copia de seguridad. El ejemplo de copia de seguridad se ejecuta a las 02:00 UTC y requiere backup-pvc, postgres-secret y una base de datos accesible; pg_dump debe ser como mínimo tan reciente como la versión principal del servidor. Especifica PGDATABASE cuando sea diferente de PGUSER. Prueba las restauraciones reales por separado.
Conclusión
Este documento abordó los Pods, el bloque de construcción básico de Kubernetes, y diversos recursos de carga de trabajo. Partiendo del concepto de Pods, exploramos las características y los casos de uso de diversos recursos de carga de trabajo, incluidos Deployments, StatefulSets, DaemonSets, Jobs y CronJobs. Cada uno de estos recursos tiene propósitos y características únicos, y utilizarlos adecuadamente permite un despliegue y una gestión eficientes de las aplicaciones.
Cuestionario
Para evaluar lo que aprendiste en este capítulo, prueba el Cuestionario de Pods y cargas de trabajo.