Alarmas de CloudWatch
Última actualización: September 13, 2026
Los ejemplos de CLI y Terraform cubren las alarmas de métricas clásicas de CloudWatch y las alarmas compuestas. CloudWatch también admite alarmas de PromQL sobre métricas ingeridas mediante su endpoint de OTLP y alarmas de registros sobre resultados de consultas de Logs Insights. Las alarmas de PromQL usan PendingPeriod/RecoveryPeriod; las configuraciones de M-de-N y de datos faltantes siguientes no se aplican sin cambios. Los valores de cuenta, Region y recurso son ejemplos. Antes de usar comandos de creación o actualización, verifique los destinos reales, los permisos de IAM, el costo y los destinatarios. PutMetricAlarm/PutCompositeAlarm reemplazan una configuración de alarma existente, por lo que debe conservar su configuración actual antes de actualizarla.
Tabla de contenidos
- Descripción general de las alarmas de CloudWatch
- Arquitectura
- Alarmas de métricas
- Alarmas compuestas
- Detección de anomalías
- Integración con SNS
- Integración con EventBridge
- Alertas de Container Insights
- Acciones de alarmas de CloudWatch
- Optimización de costos
- Integración de métricas de Prometheus
- Ejemplos de Terraform
Descripción general de las alarmas de CloudWatch
Amazon CloudWatch Alarms es la función de alertas del servicio de monitoreo nativo de AWS. Crea alertas basadas en métricas de CloudWatch y permite respuestas automatizadas mediante la integración con SNS, Lambda, EC2 Auto Scaling y más.
Características principales
- Alarmas de métricas: evalúan una métrica, cálculos de métricas o una consulta de Metrics Insights
- Alarmas compuestas: combinan varias condiciones de alarma
- Detección de anomalías: detección de anomalías basada en machine learning
- Acciones de alarma: ejecutan acciones automáticas cuando se activan alertas
- Integración con servicios de AWS: integración nativa con EC2, ECS, EKS, Lambda, etc.
Alarmas de CloudWatch frente a Prometheus Alertmanager
| Característica | Alarmas de CloudWatch | Prometheus Alertmanager |
|---|---|---|
| Tipo | Servicio administrado de AWS | Código abierto |
| Fuente de datos | Métricas de CloudWatch, métricas de OTLP o registros según el tipo de alarma | Alertas evaluadas por Prometheus u otros clientes |
| Evaluación | Cálculos de métricas, PromQL o Logs Insights según el tipo de alarma | Prometheus evalúa PromQL; Alertmanager agrupa, inhibe y enruta alertas |
| Costo | Depende del tipo de alarma, las métricas evaluadas, las consultas y los contribuyentes | Sin tarifa de licencia de software; la infraestructura y las operaciones siguen teniendo costo |
| Enrutamiento complejo | Limitado | Compatibilidad avanzada de enrutamiento |
| Integración con AWS | Nativa | Requiere configuración adicional |
Arquitectura
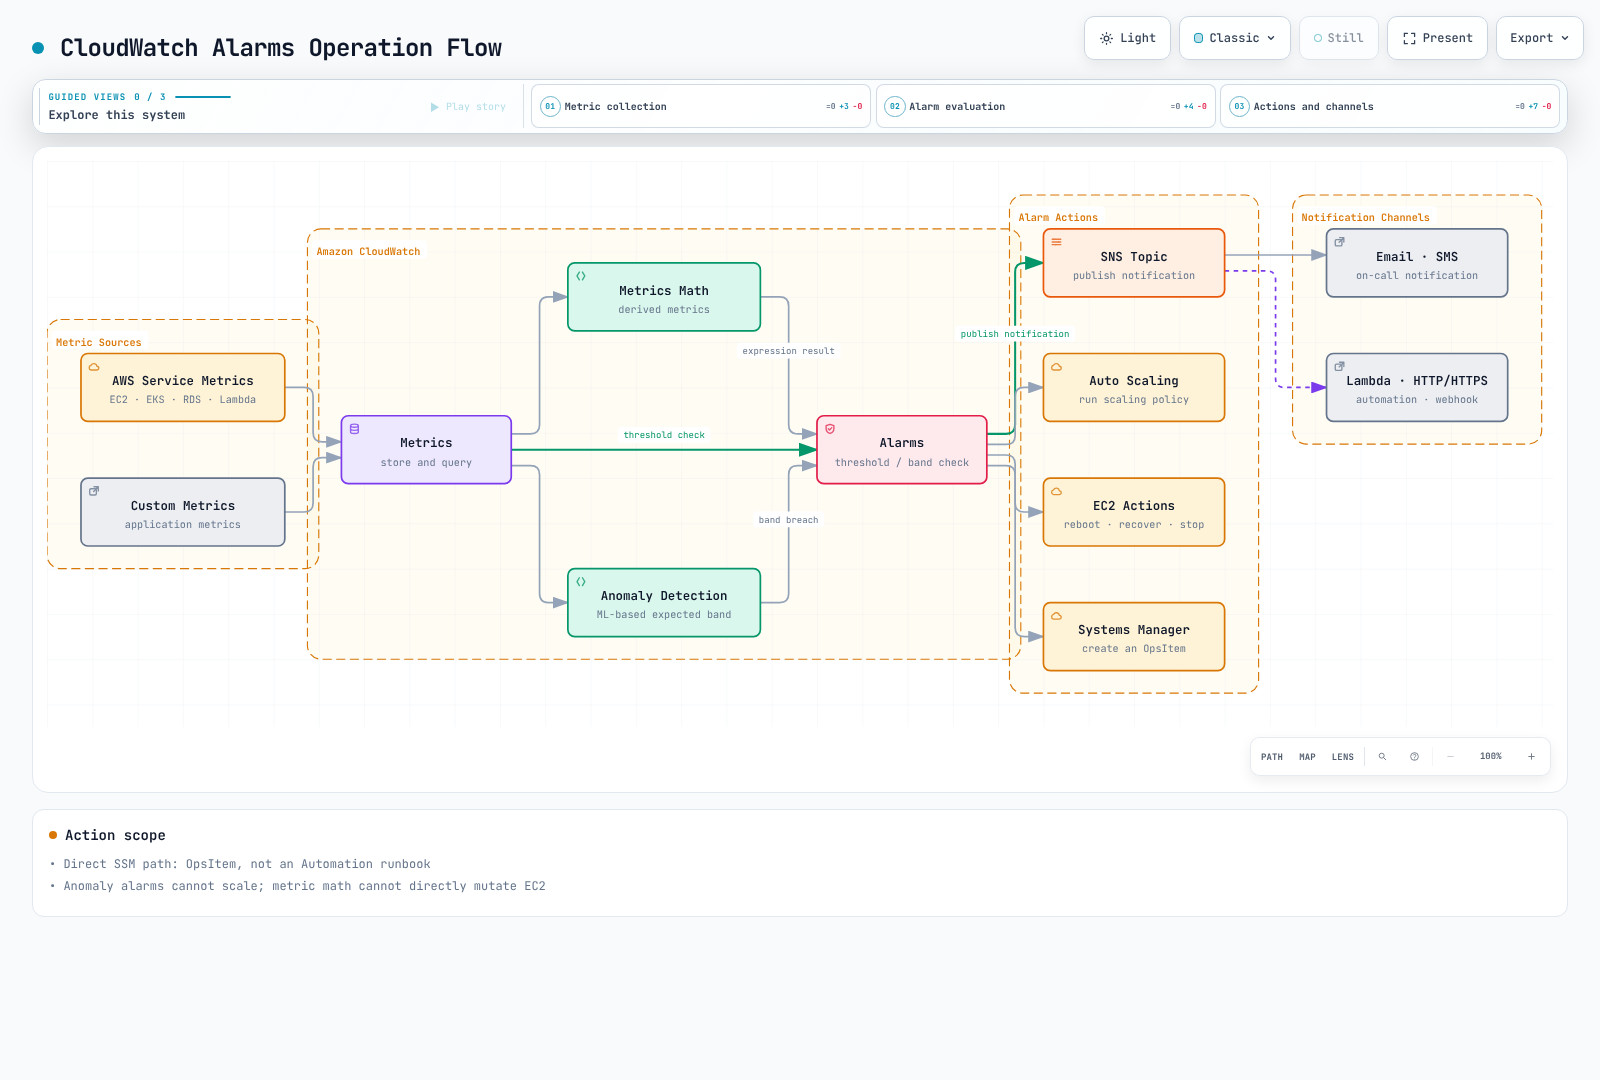
Flujo de operación de las alarmas de CloudWatch
Estados de alarma
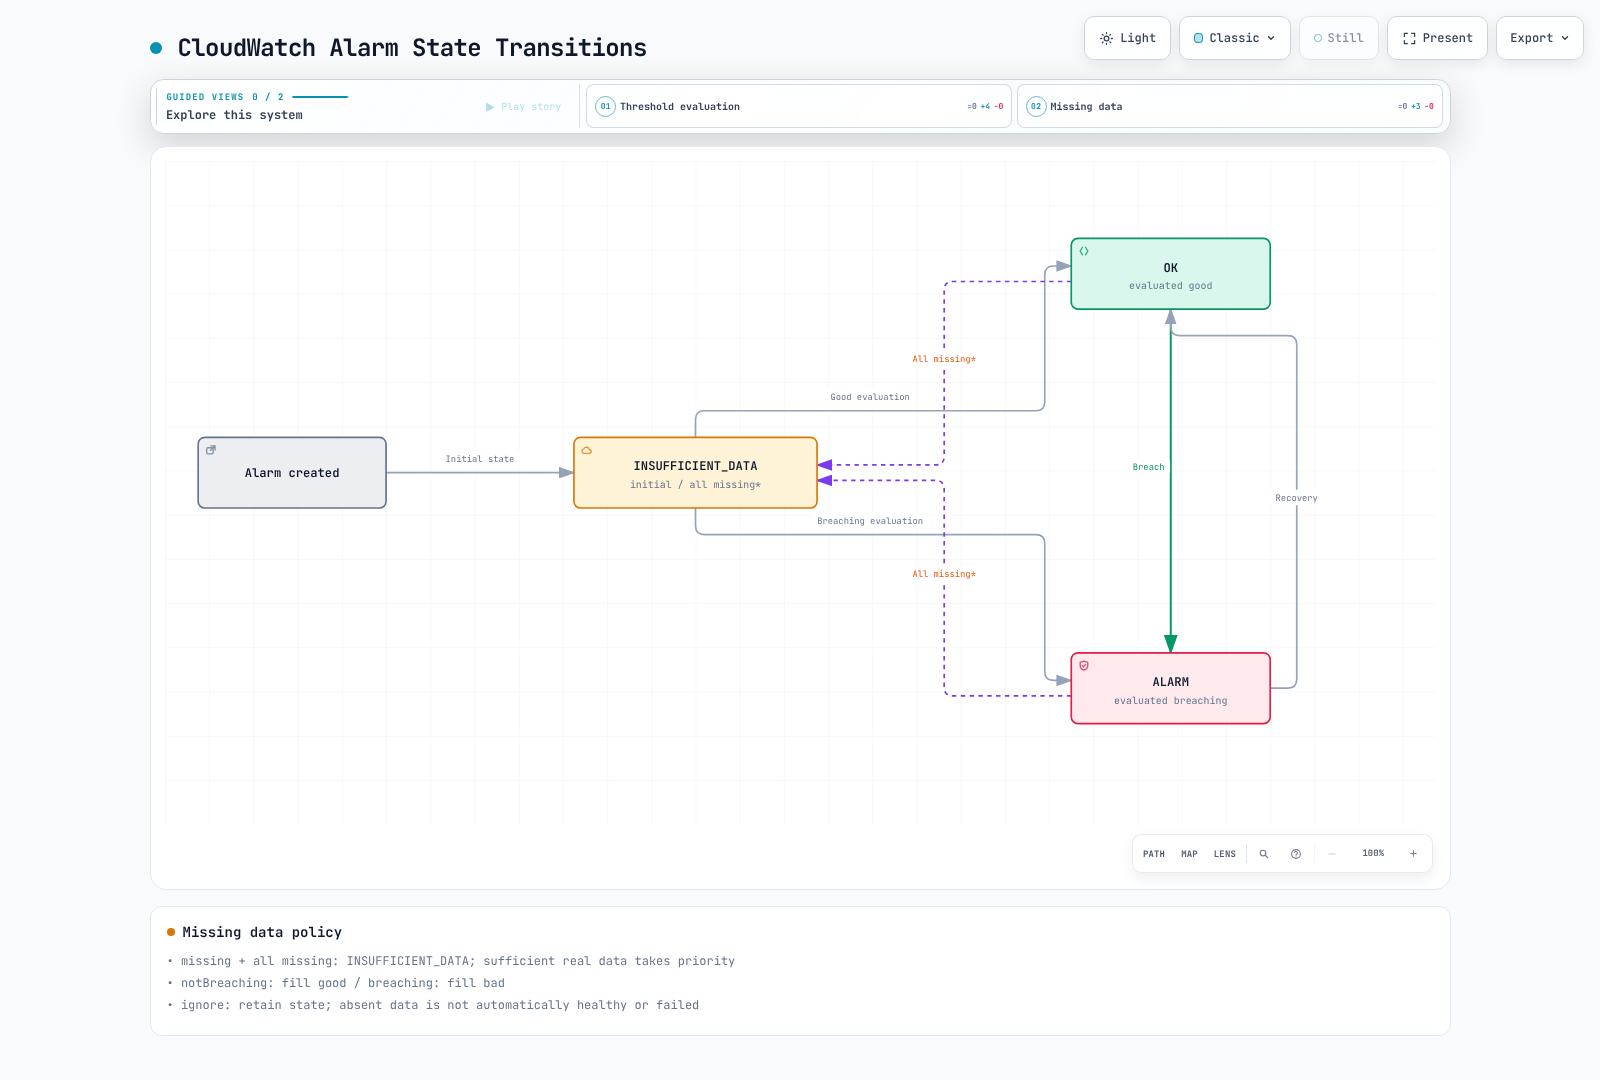
Una alarma de métrica clásica comienza en INSUFFICIENT_DATA y luego se evalúa como OK o ALARM. Los datos faltantes no siempre implican INSUFFICIENT_DATA: missing produce datos insuficientes cuando faltan todos los datos de evaluación, notBreaching completa los puntos faltantes como buenos, breaching los completa como malos e ignore conserva el estado. Cuando los puntos reales adicionales son suficientes para la evaluación, CloudWatch no usa la configuración para completar datos faltantes. Por lo tanto, una política general de notBreaching puede ocultar un heartbeat o recopilador detenido. Una alarma compuesta puede estar en INSUFFICIENT_DATA únicamente justo después de su creación.
Alarmas de métricas
Creación básica de alarmas (consola/CLI)
AWS CLI
# Create CPU utilization alarm
aws cloudwatch put-metric-alarm \
  --alarm-name "HighCPUUtilization" \
  --alarm-description "CPU usage exceeds 80%" \
  --metric-name CPUUtilization \
  --namespace AWS/EC2 \
  --statistic Average \
  --period 300 \
  --threshold 80 \
  --comparison-operator GreaterThanThreshold \
  --evaluation-periods 2 \
  --dimensions Name=InstanceId,Value=i-1234567890abcdef0 \
  --alarm-actions arn:aws:sns:ap-northeast-2:123456789012:alerts \
  --ok-actions arn:aws:sns:ap-northeast-2:123456789012:alerts \
  --treat-missing-data missing
Componentes de configuración de alarmas
| Parámetro | Descripción | Ejemplo |
|---|---|---|
metric-name | Nombre de la métrica que se debe monitorear | CPUUtilization |
namespace | Espacio de nombres de la métrica | AWS/EC2, AWS/EKS |
statistic | Función estadística | Average, Sum, Maximum, Minimum, SampleCount |
period | Período de evaluación (segundos) | 60, 300, 3600 |
threshold | Valor de umbral | 80 |
comparison-operator | Operador de comparación | GreaterThanThreshold |
evaluation-periods | Número de períodos de evaluación N | 3 (M es datapoints-to-alarm) |
datapoints-to-alarm | Puntos de datos necesarios para la alarma | 2 de 3 |
treat-missing-data | Manejo de datos faltantes | notBreaching, breaching, ignore, missing |
Use --extended-statistic p99, no --statistic p99. Los M puntos que superan el umbral dentro de N no tienen que ser consecutivos; omitir M hace que sea igual a N. Period es la duración de agregación, no un intervalo de notificación. Los períodos de alarma de métrica clásica de 10, 20 o 30 segundos son de alta resolución y requieren datos de alta resolución coincidentes. 60 segundos es resolución estándar. Period×N está limitado a siete días, o a un día cuando Period es inferior a una hora. Normalmente, las acciones se ejecutan en las transiciones de estado, excepto las acciones de Auto Scaling.
Operadores de comparación
# Available comparison operators
comparison-operators:
  - GreaterThanThreshold           # Greater than
  - GreaterThanOrEqualToThreshold  # Greater than or equal
  - LessThanThreshold              # Less than
  - LessThanOrEqualToThreshold     # Less than or equal
  - LessThanLowerOrGreaterThanUpperThreshold  # Outside range
  - LessThanLowerThreshold         # Below lower bound
  - GreaterThanUpperThreshold      # Above upper bound
Alarmas que usan Metrics Math
# Error rate calculation alarm (error count / total requests)
aws cloudwatch put-metric-alarm \
  --alarm-name "HighErrorRate" \
  --alarm-description "Error rate exceeds 5%" \
  --metrics '[
    {
      "Id": "errors",
      "MetricStat": {
        "Metric": {
          "Namespace": "AWS/ApplicationELB",
          "MetricName": "HTTPCode_Target_5XX_Count",
          "Dimensions": [
            {"Name": "LoadBalancer", "Value": "app/my-alb/1234567890"}
          ]
        },
        "Period": 300,
        "Stat": "Sum"
      },
      "ReturnData": false
    },
    {
      "Id": "requests",
      "MetricStat": {
        "Metric": {
          "Namespace": "AWS/ApplicationELB",
          "MetricName": "RequestCount",
          "Dimensions": [
            {"Name": "LoadBalancer", "Value": "app/my-alb/1234567890"}
          ]
        },
        "Period": 300,
        "Stat": "Sum"
      },
      "ReturnData": false
    },
    {
      "Id": "error_rate",
      "Expression": "IF(requests > 0, 100 * FILL(errors, 0) / requests, 0)",
      "ReturnData": true
    }
  ]' \
  --threshold 5 \
  --comparison-operator GreaterThanThreshold \
  --evaluation-periods 2 \
  --alarm-actions arn:aws:sns:ap-northeast-2:123456789012:alerts
Esta expresión mide las respuestas 5xx del destino entre las solicitudes reenviadas por el ALB. No incluye todos los fallos visibles para el usuario, como los errores generados por el ALB o los fallos antes de seleccionar un destino. Los puntos 5xx faltantes se completan con cero cuando existen solicitudes; aquí, cero solicitudes se define como 0 %. Monitoree por separado los datos faltantes de solicitudes/recopilación. Una alarma de cálculo de métricas clásica debe devolver una serie temporal final. SEARCH es para gráficos y no se puede usar como expresión de alarma. RATE puede comportarse de manera diferente con métricas dispersas porque el rango de evaluación cambia.
Funciones de Metrics Math
# Commonly used functions
math-functions:
  # Arithmetic operations
  - "m1 + m2"           # Sum
  - "m1 - m2"           # Difference
  - "m1 * m2"           # Product
  - "m1 / m2"           # Division
  - "(m1 / m2) * 100"   # Percentage

  # Statistical functions
  - "AVG(METRICS())"    # Average
  - "SUM(METRICS())"    # Sum
  - "MIN(METRICS())"    # Minimum
  - "MAX(METRICS())"    # Maximum

  # Conditional functions
  - "IF(m1 > 100, m1, 0)"  # Conditional

  # Time-related
  - "RATE(m1)"          # Rate of change
  - "DIFF(m1)"          # Difference
  - "PERIOD(m1)"        # Period

  # Search
  - "SEARCH('{AWS/EC2,InstanceId} MetricName=\"CPUUtilization\"', 'Average', 300)"
Alarmas compuestas
Concepto de alarma compuesta
Las alarmas compuestas pueden combinar varias alarmas de métricas para definir condiciones complejas.
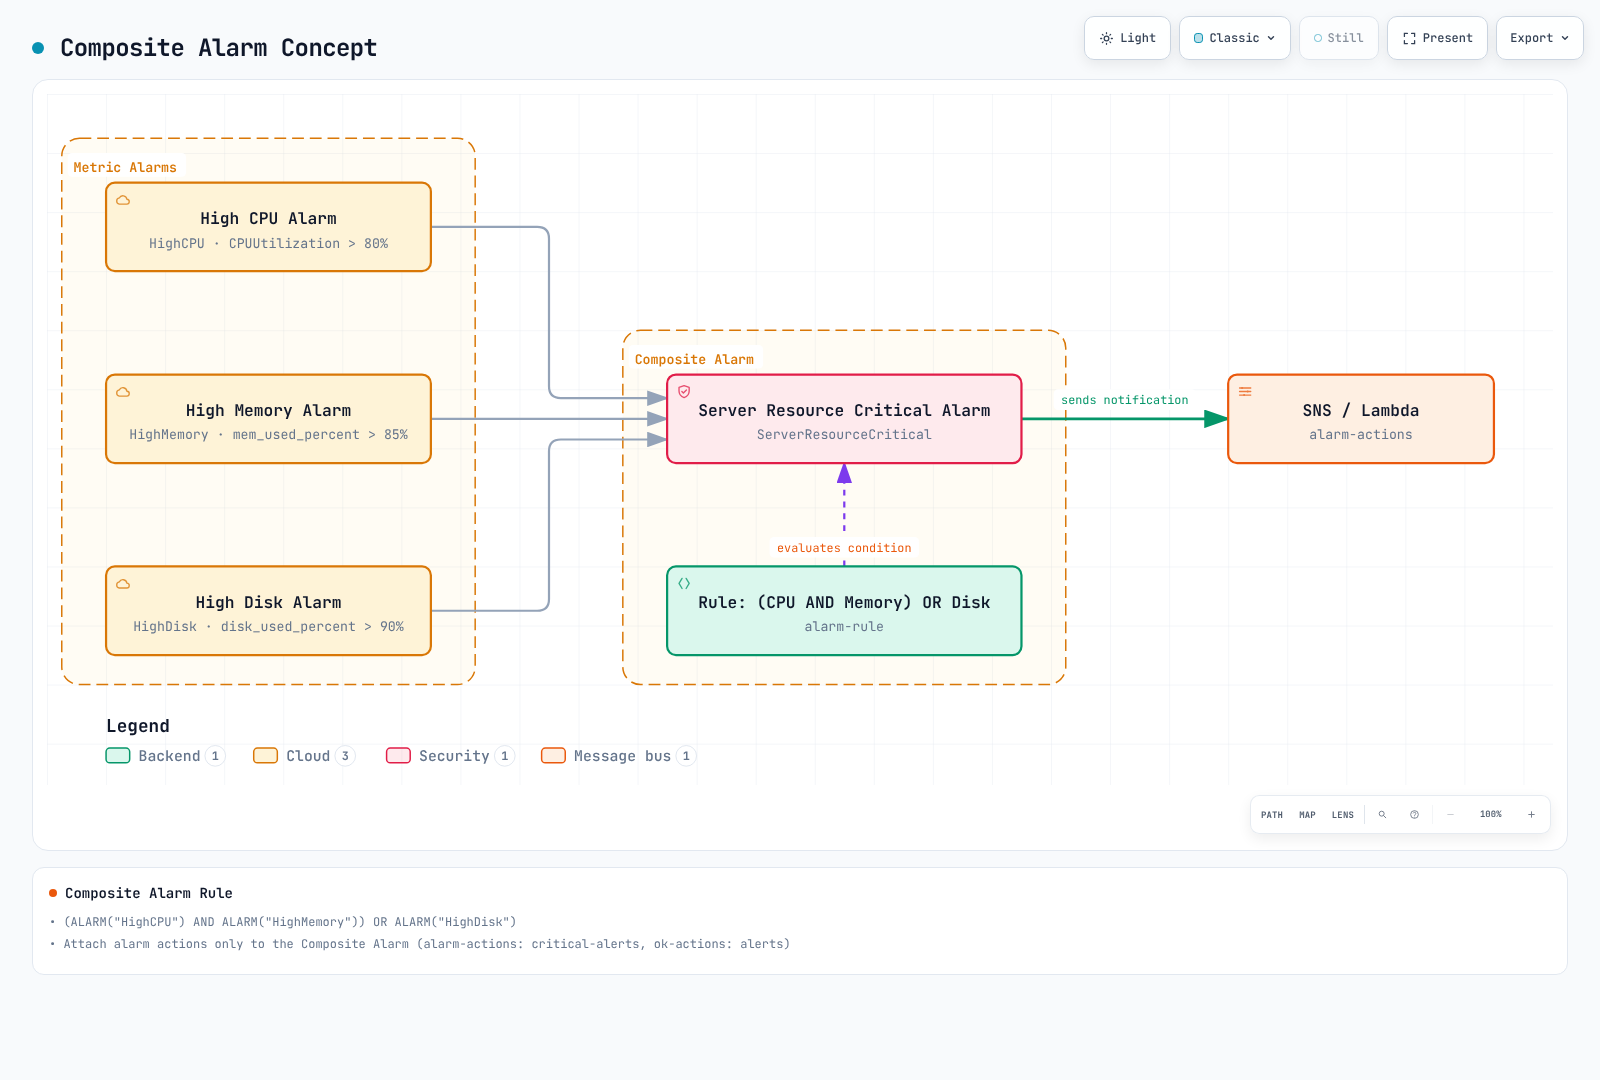
Las métricas de memoria y disco de CWAgent requieren un agente instalado y un conjunto de dimensiones publicadas coincidente. Los ejemplos con solo InstanceId funcionan únicamente si el agente publica esa agregación. disk_used_percent suele incluir también path, device y fstype; use el conjunto completo de dimensiones que devuelve list-metrics. Las alarmas secundarias de ejemplo no tienen acciones; solo la compuesta envía notificaciones.
Creación de alarmas compuestas
# Create individual alarms
aws cloudwatch put-metric-alarm \
  --alarm-name "HighCPU" \
  --metric-name CPUUtilization \
  --namespace AWS/EC2 \
  --statistic Average \
  --period 300 \
  --threshold 80 \
  --comparison-operator GreaterThanThreshold \
  --evaluation-periods 2 \
  --dimensions Name=InstanceId,Value=i-1234567890abcdef0

aws cloudwatch put-metric-alarm \
  --alarm-name "HighMemory" \
  --metric-name mem_used_percent \
  --namespace CWAgent \
  --statistic Average \
  --period 300 \
  --threshold 85 \
  --comparison-operator GreaterThanThreshold \
  --evaluation-periods 2 \
  --dimensions Name=InstanceId,Value=i-1234567890abcdef0

aws cloudwatch put-metric-alarm \
  --alarm-name "HighDisk" \
  --metric-name disk_used_percent \
  --namespace CWAgent \
  --statistic Average \
  --period 300 \
  --threshold 90 \
  --comparison-operator GreaterThanThreshold \
  --evaluation-periods 2 \
  --dimensions Name=InstanceId,Value=i-1234567890abcdef0

# Create Composite Alarm
aws cloudwatch put-composite-alarm \
  --alarm-name "ServerResourceCritical" \
  --alarm-description "Server resources are critical" \
  --alarm-rule '(ALARM("HighCPU") AND ALARM("HighMemory")) OR ALARM("HighDisk")' \
  --alarm-actions arn:aws:sns:ap-northeast-2:123456789012:critical-alerts \
  --ok-actions arn:aws:sns:ap-northeast-2:123456789012:alerts
Sintaxis de reglas de alarma
# Composite Alarm rule syntax
rule-syntax:
  # Basic operators
  - "ALARM(alarm-name)"      # Check ALARM state
  - "OK(alarm-name)"         # Check OK state
  - "INSUFFICIENT_DATA(alarm-name)"  # Check INSUFFICIENT_DATA state

  # Logical operators
  - "AND"                    # All conditions met
  - "OR"                     # One or more conditions met
  - "NOT"                    # Negation
  - "()"                     # Grouping

examples:
  # All conditions met
  - "ALARM(A1) AND ALARM(A2) AND ALARM(A3)"

  # One or more met
  - "ALARM(A1) OR ALARM(A2)"

  # Complex condition
  - "(ALARM(A1) AND ALARM(A2)) OR ALARM(A3)"

  # Negation
  - "ALARM(A1) AND NOT ALARM(A2)"

  # M of N pattern (2 or more of 3)
  - "(ALARM(A1) AND ALARM(A2)) OR (ALARM(A1) AND ALARM(A3)) OR (ALARM(A2) AND ALARM(A3))"
Patrón de supresión de alertas
set-alarm-state es una anulación temporal para pruebas; una alarma de métrica vuelve rápidamente a su estado evaluado y no establece una ventana de mantenimiento. El siguiente ejemplo supone que un controlador externo publica continuamente el estado de una alarma MaintenanceMode. ActionsSuppressor suprime las acciones compuestas sin cambiar su estado evaluado. Incluya los períodos de espera/extensión al probar la ventana de mantenimiento.
aws cloudwatch put-composite-alarm  \
  --alarm-name ProductionAlerts  \
  --alarm-rule 'ALARM("HighCPU")'  \
  --actions-suppressor MaintenanceMode  \
  --actions-suppressor-wait-period 60  \
  --actions-suppressor-extension-period 60  \
  --alarm-actions arn:aws:sns:ap-northeast-2:123456789012:alerts
Detección de anomalías
Descripción general de la detección de anomalías
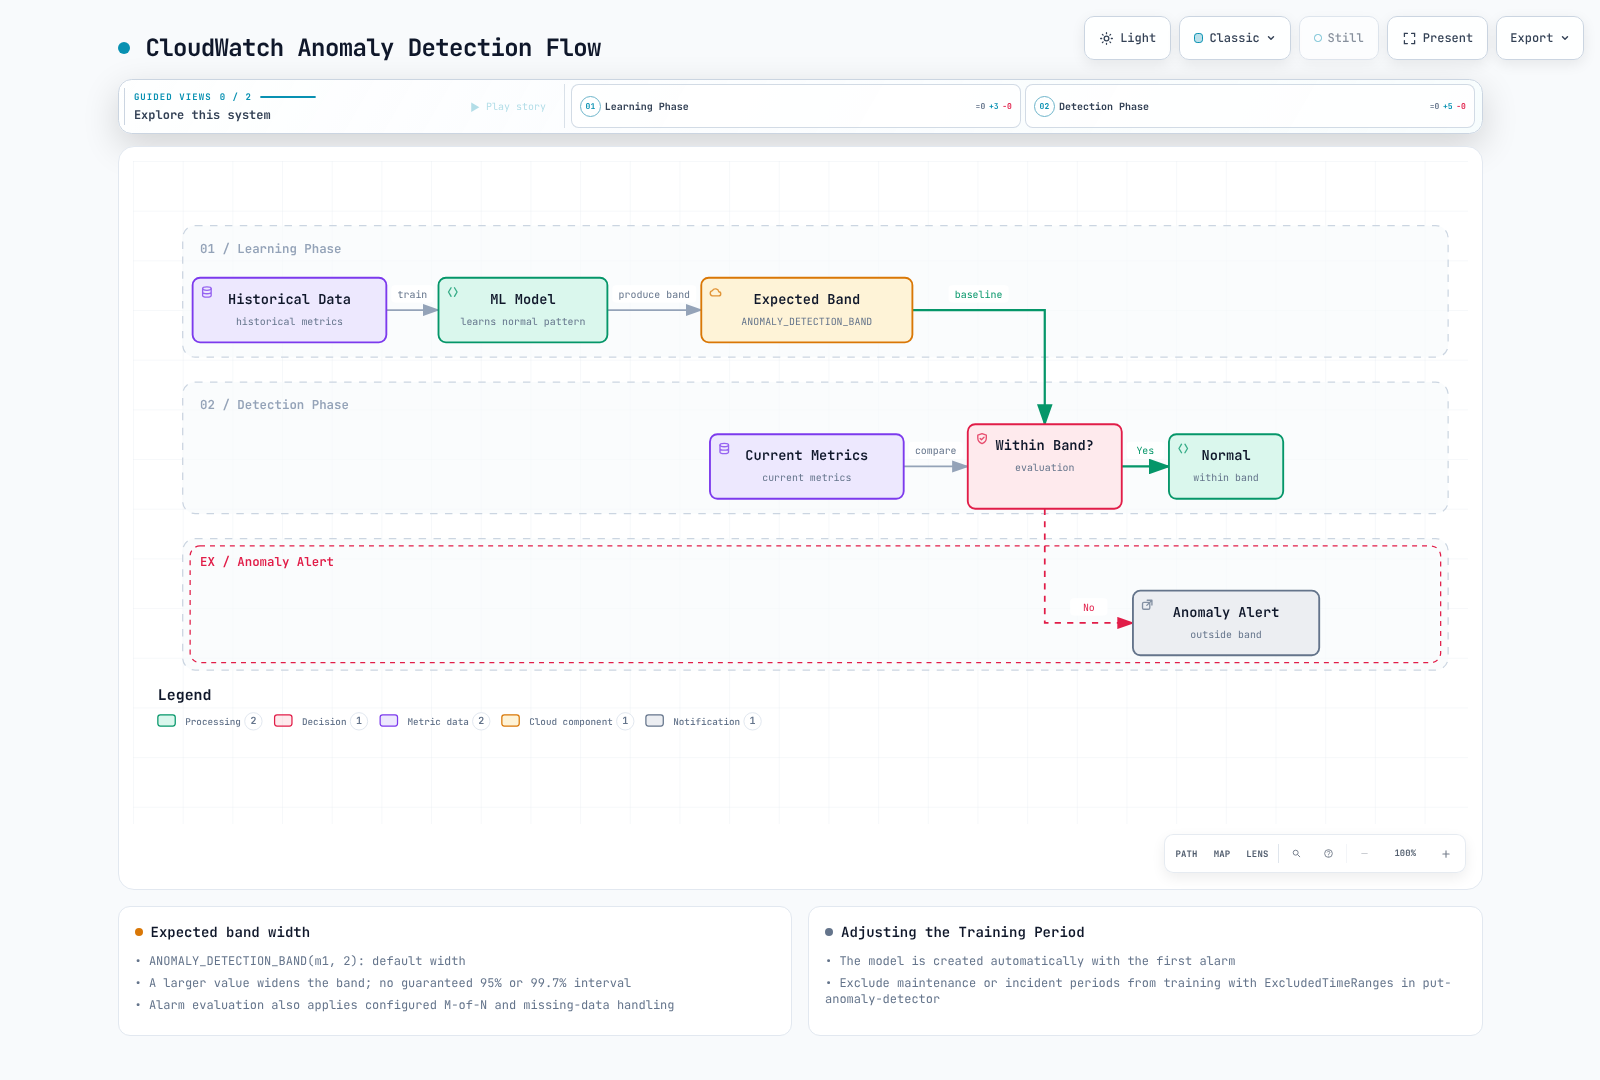
CloudWatch Anomaly Detection usa machine learning para aprender patrones normales de las métricas y detectar valores atípicos.
Creación de alarmas de detección de anomalías
# Anomaly Detection model creation (automatic)
# Model is automatically created when first alarm is created

aws cloudwatch put-metric-alarm \
  --alarm-name "CPUAnomalyDetection" \
  --alarm-description "CPU usage is anomalous" \
  --metrics '[
    {
      "Id": "m1",
      "MetricStat": {
        "Metric": {
          "Namespace": "AWS/EC2",
          "MetricName": "CPUUtilization",
          "Dimensions": [
            {"Name": "InstanceId", "Value": "i-1234567890abcdef0"}
          ]
        },
        "Period": 300,
        "Stat": "Average"
      },
      "ReturnData": true
    },
    {
      "Id": "ad1",
      "Expression": "ANOMALY_DETECTION_BAND(m1, 2)",
      "ReturnData": true
    }
  ]' \
  --threshold-metric-id ad1 \
  --comparison-operator LessThanLowerOrGreaterThanUpperThreshold \
  --evaluation-periods 2 \
  --alarm-actions arn:aws:sns:ap-northeast-2:123456789012:alerts
Configuración de detección de anomalías
# ANOMALY_DETECTION_BAND function
# ANOMALY_DETECTION_BAND(metric, stddev)
# - metric: Metric to analyze
# - stddev: Standard deviation multiplier (default 2)

examples:
  # Width parameter 2: not a guaranteed 95% confidence interval
  - "ANOMALY_DETECTION_BAND(m1, 2)"

  # Width parameter 3: a wider expected band
  - "ANOMALY_DETECTION_BAND(m1, 3)"

  # More sensitive detection (1 standard deviation)
  - "ANOMALY_DETECTION_BAND(m1, 1)"
El parámetro controla el ancho de la banda esperada del modelo; no es un intervalo gaussiano garantizado del 95 % ni del 99,7 %. El modelo usa hasta dos semanas de historial y puede comenzar con menos. Las fechas excluidas a continuación ilustran el formato; reemplácelas por intervalos relevantes dentro del historial de entrenamiento del modelo.
Ajuste del período de entrenamiento del modelo
# Add exclusion periods to existing model (maintenance, incident periods, etc.)
aws cloudwatch put-anomaly-detector \
  --namespace AWS/EC2 \
  --metric-name CPUUtilization \
  --stat Average \
  --dimensions Name=InstanceId,Value=i-1234567890abcdef0 \
  --configuration '{
    "ExcludedTimeRanges": [
      {
        "StartTime": "2025-02-15T00:00:00Z",
        "EndTime": "2025-02-15T06:00:00Z"
      }
    ]
  }'
Integración con SNS
Creación de un tema de SNS
# Create SNS Topic
aws sns create-topic --name eks-alerts

# Add Email subscription
aws sns subscribe \
  --topic-arn arn:aws:sns:ap-northeast-2:123456789012:eks-alerts \
  --protocol email \
  --notification-endpoint team@example.com

# Add SMS subscription
aws sns subscribe \
  --topic-arn arn:aws:sns:ap-northeast-2:123456789012:eks-alerts \
  --protocol sms \
  --notification-endpoint "$VERIFIED_SMS_NUMBER"

# Add Lambda subscription
aws sns subscribe \
  --topic-arn arn:aws:sns:ap-northeast-2:123456789012:eks-alerts \
  --protocol lambda \
  --notification-endpoint arn:aws:lambda:ap-northeast-2:123456789012:function:alert-handler
Filtrado de mensajes de SNS
Las notificaciones predeterminadas de CloudWatch SNS no incluyen automáticamente los atributos de mensaje severity o environment de ejemplo. Para filtrar el NewStateValue del cuerpo, establezca FilterPolicyScope=MessageBody. Este filtro excluye los mensajes de recuperación OK. El correo electrónico requiere confirmación de suscripción; SMS requiere comprobar los números verificados, los requisitos de sandbox/Region y el costo. Una suscripción de Lambda también necesita una política de recursos de Lambda que permita a sns.amazonaws.com desde el ARN del tema específico.
aws sns set-subscription-attributes  \
  --subscription-arn "$SUBSCRIPTION_ARN"  \
  --attribute-name FilterPolicyScope  \
  --attribute-value MessageBody
aws sns set-subscription-attributes  \
  --subscription-arn "$SUBSCRIPTION_ARN"  \
  --attribute-name FilterPolicy  \
  --attribute-value '{"NewStateValue": ["ALARM"]}'
Integración de SNS con Slack (Lambda)
Para las notificaciones estándar de CloudWatch, conecte el tema de SNS y un canal de Slack aprobado mediante Amazon Q Developer in chat applications (anteriormente AWS Chatbot). Limite el rol de IAM y la política de barreras de protección del canal a su propósito de notificación.
Si se requiere una Lambda personalizada, obtenga el webhook de un almacén de secretos, valide su destino, establezca tiempos de espera de conexión/lectura y compruebe el estado de la respuesta. No informe HTTP 429/5xx como éxito; configure reintentos, una ruta de dead-letter y el manejo de duplicados. SNS usa Records[].Sns.Message, no el sobre de EventBridge siguiente. La validación de este capítulo no envía mensajes reales de Slack.
Integración con EventBridge
Creación de una regla de EventBridge
# Route CloudWatch Alarm state changes to EventBridge
aws events put-rule \
  --name "CloudWatchAlarmStateChange" \
  --event-pattern '{
    "source": ["aws.cloudwatch"],
    "detail-type": ["CloudWatch Alarm State Change"],
    "detail": {
      "state": {
        "value": ["ALARM"]
      }
    }
  }'

# Add Lambda target
aws events put-targets \
  --rule "CloudWatchAlarmStateChange" \
  --targets '[
    {
      "Id": "AlertHandler",
      "Arn": "arn:aws:lambda:ap-northeast-2:123456789012:function:alert-handler"
    }
  ]'
Configuración de respuesta automática
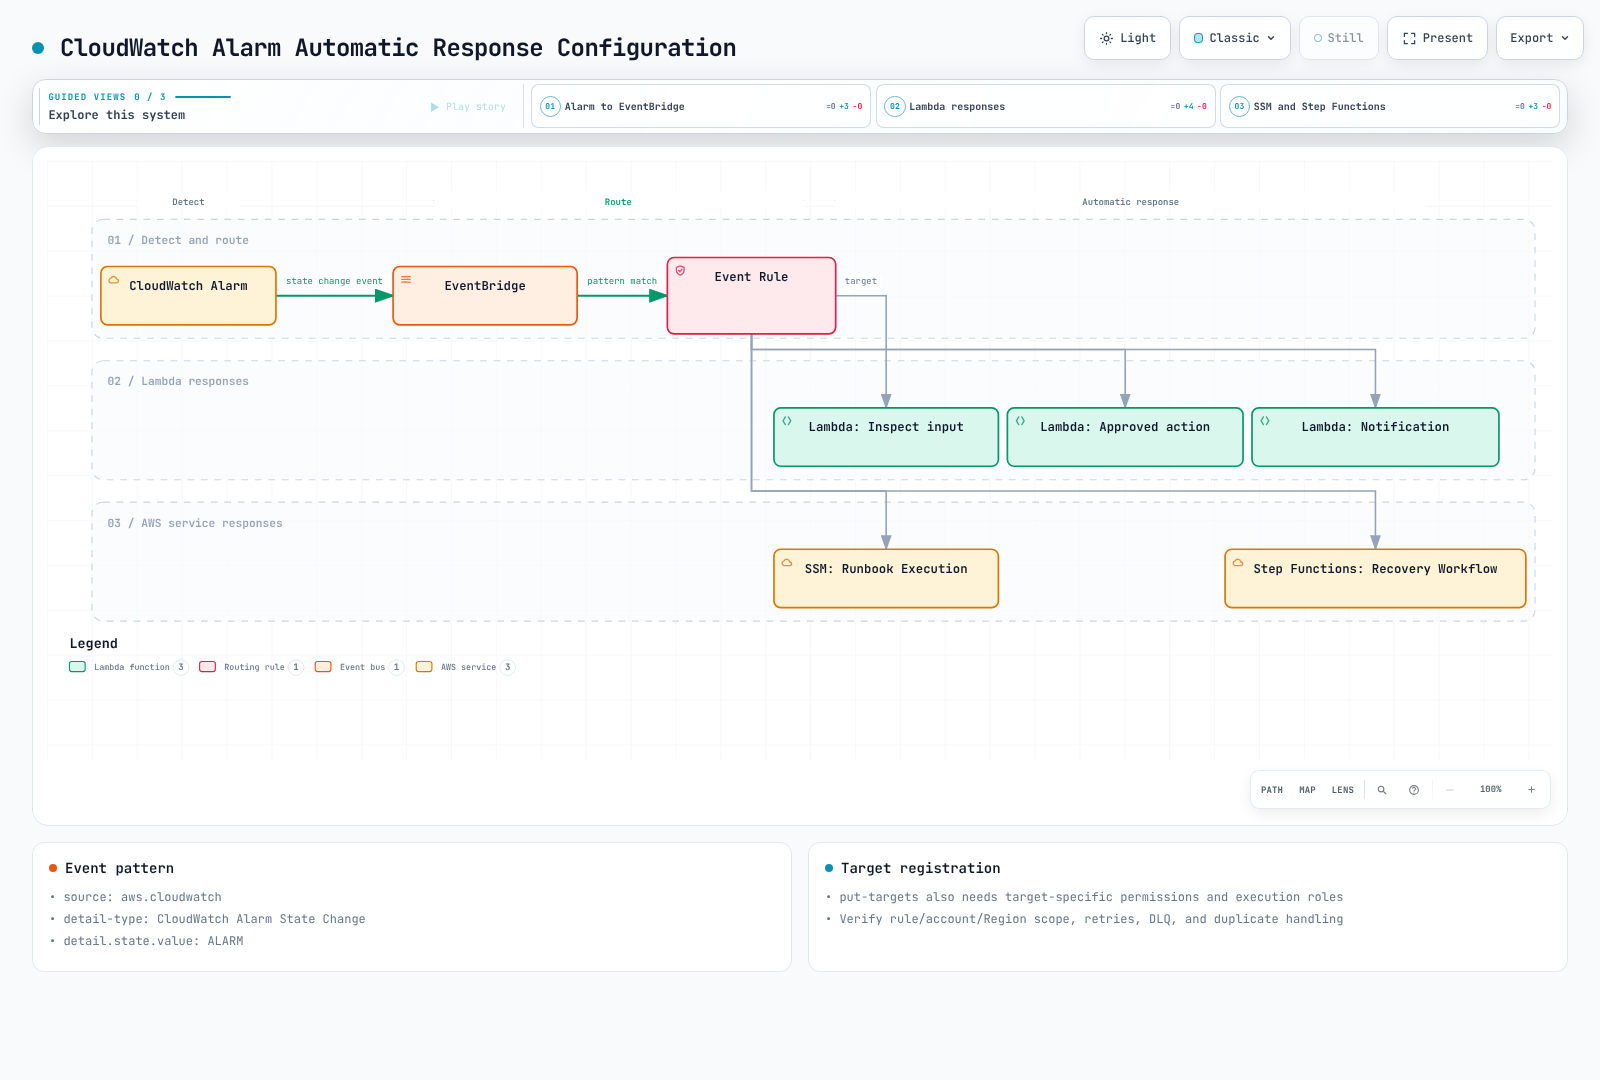
Patrón de eventos de EventBridge
{
  "source": ["aws.cloudwatch"],
  "detail-type": ["CloudWatch Alarm State Change"],
  "account": ["123456789012"],
  "region": ["ap-northeast-2"],
  "resources": ["arn:aws:cloudwatch:ap-northeast-2:123456789012:alarm:EKS-Node-HighCPU"],
  "detail": {
    "alarmName": ["EKS-Node-HighCPU"],
    "state": {"value": ["ALARM"]}
  }
}
Restringir previousState a OK omite INSUFFICIENT_DATA → ALARM. Hacer coincidir un ARN de alarma exacto evita suposiciones sobre las formas de configuración de cálculos de métricas o compuestas. put-targets no concede permiso de invocación de Lambda: agregue una política de recursos de Lambda para events.amazonaws.com, limitada al SourceArn de la regla, y configure el comportamiento de reintento/dead-letter.
Ejemplo de Lambda de recuperación automática
Una CPU alta por sí sola no demuestra que reiniciar sea apropiado. Este ejemplo implementa la etapa de inspección de entrada de la recuperación: comprueba el estado, la cuenta, la Region y el ARN de alarma, y luego devuelve información de la métrica. Las dimensions de EventBridge son un objeto, a diferencia de la lista de dimensiones en un mensaje de alarma de SNS. También maneja una consulta que comienza con una expresión y una alarma compuesta sin métricas.
Empaquete el normalizador de eventos probado y las pruebas con el controlador de Lambda:
from event_normalizer import normalize_alarm_event

def lambda_handler(event, context):
    return normalize_alarm_event(
        event,
        expected_account="123456789012",
        expected_region="ap-northeast-2",
    )
La función no realiza mutaciones de AWS. Las comprobaciones de payload no autentican al remitente. Toda remediación agregada necesita una lista de permitidos explícita de destinos, comprobaciones actuales del estado de la alarma/recurso, idempotencia, período de enfriamiento, mínimo privilegio y reversión.
Alertas de Container Insights
Métricas de EKS Container Insights
Estos ejemplos usan la ruta de métricas clásicas de CloudWatch ContainerInsights. No mezcle sus nombres, dimensiones y facturación con rutas de métricas de observabilidad mejorada u OTel. Siga la guía actual de complementos de EKS, que instala CloudWatch Agent y Fluent Bit, y seleccione una versión de complemento compatible con la versión de Kubernetes y la Region del clúster. Configure primero IAM y la asociación del agente al usar EKS Pod Identity.
update-addon actualiza una instalación existente; una primera instalación usa create-addon. Conserve la configuración existente y las asociaciones de Pod Identity. Consulte las versiones disponibles y seleccione una en el plan de implementación en lugar de fijar la antigua v1.2.0 o aplicar un manifiesto latest de Fluentd sin revisar.
aws eks describe-addon-versions  \
  --addon-name amazon-cloudwatch-observability  \
  --kubernetes-version "$KUBERNETES_VERSION"  \
  --region "$AWS_REGION"
aws cloudwatch list-metrics  \
  --namespace ContainerInsights  \
  --metric-name pod_number_of_container_restarts  \
  --dimensions Name=ClusterName,Value=my-cluster  \
  --region "$AWS_REGION"
Ejemplos de alertas de Container Insights
# Cluster aggregate CPU utilization alarm
aws cloudwatch put-metric-alarm \
  --alarm-name "EKS-Node-HighCPU" \
  --metric-name node_cpu_utilization \
  --namespace ContainerInsights \
  --dimensions Name=ClusterName,Value=my-cluster \
  --statistic Average \
  --period 300 \
  --threshold 80 \
  --comparison-operator GreaterThanThreshold \
  --evaluation-periods 2 \
  --alarm-actions arn:aws:sns:ap-northeast-2:123456789012:eks-alerts

# Pod memory utilization alarm
aws cloudwatch put-metric-alarm \
  --alarm-name "EKS-Pod-HighMemory" \
  --metric-name pod_memory_utilization_over_pod_limit \
  --namespace ContainerInsights \
  --dimensions Name=ClusterName,Value=my-cluster Name=Namespace,Value=production \
  --statistic Average \
  --period 300 \
  --threshold 85 \
  --comparison-operator GreaterThanThreshold \
  --evaluation-periods 2 \
  --alarm-actions arn:aws:sns:ap-northeast-2:123456789012:eks-alerts

# One Pod's cumulative restart count (not a five-minute increase)
aws cloudwatch put-metric-alarm \
  --alarm-name "EKS-Pod-Restarts" \
  --metric-name pod_number_of_container_restarts \
  --namespace ContainerInsights \
  --dimensions Name=ClusterName,Value=my-cluster Name=Namespace,Value=production Name=PodName,Value=my-pod \
  --statistic Maximum \
  --period 300 \
  --threshold 3 \
  --comparison-operator GreaterThanThreshold \
  --evaluation-periods 1 \
  --alarm-actions arn:aws:sns:ap-northeast-2:123456789012:eks-alerts
El ejemplo de CPU es una agregación de clúster. Un nodo individual usa el conjunto completo ClusterName, NodeName e InstanceId. pod_memory_utilization divide por la memoria del nodo, mientras que pod_memory_utilization_over_pod_limit divide por el límite del Pod. Este último puede estar ausente si cualquier contenedor carece de un límite de memoria. pod_number_of_container_restarts es acumulativo y usa ClusterName, Namespace y PodName. Maximum > 3 significa que el recuento observado durante la vida útil superó tres; sumar muestras no cuenta los reinicios recientes. Tenga en cuenta el reemplazo de Pod, los restablecimientos y la reutilización de nombres. Use increase() de PromQL con reconocimiento de restablecimientos o una métrica delta definida por separado para incrementos recientes.
Métricas clave de Container Insights
| Métrica | Descripción | Dimensiones |
|---|---|---|
cluster_node_count | Recuento de nodos del clúster | ClusterName |
cluster_failed_node_count | Recuento de nodos con errores | ClusterName |
node_cpu_utilization | Utilización de CPU del nodo | ClusterName, NodeName, InstanceId; o ClusterName |
node_memory_utilization | Utilización de memoria del nodo | ClusterName, NodeName, InstanceId; o ClusterName |
node_filesystem_utilization | Utilización de disco del nodo | ClusterName, NodeName, InstanceId; o ClusterName |
pod_cpu_utilization | Utilización de CPU del Pod | ClusterName, Namespace, PodName |
pod_memory_utilization | Utilización de memoria del Pod | ClusterName, Namespace, PodName |
pod_number_of_container_restarts | Recuento de reinicios de contenedores | ClusterName, Namespace, PodName |
service_number_of_running_pods | Pods en ejecución por Service | ClusterName, Namespace, Service |
Acciones de alarmas de CloudWatch
Acciones de EC2
Las acciones directas de EC2 son detener, terminar, reiniciar y recuperar; iniciar no es compatible. Estos ejemplos modifican instancias: use solo un destino aprobado explícitamente después de comprobar las instancias compatibles, los permisos y el impacto de detención/recuperación. Use missing para datos faltantes y adjunte acciones de mutación solo a ALARM. Las alarmas de cálculo de métricas y las compuestas no pueden realizar directamente acciones de EC2.
# EC2 instance recovery (on system status check failure)
aws cloudwatch put-metric-alarm \
  --alarm-name "EC2-SystemCheckFailed" \
  --metric-name StatusCheckFailed_System \
  --namespace AWS/EC2 \
  --dimensions Name=InstanceId,Value=i-1234567890abcdef0 \
  --statistic Maximum \
  --period 60 \
  --threshold 1 \
  --comparison-operator GreaterThanOrEqualToThreshold \
  --evaluation-periods 2 \
  --treat-missing-data missing \
  --alarm-actions arn:aws:automate:ap-northeast-2:ec2:recover

# EC2 instance stop
aws cloudwatch put-metric-alarm \
  --alarm-name "EC2-LowUtilization-Stop" \
  --metric-name CPUUtilization \
  --namespace AWS/EC2 \
  --dimensions Name=InstanceId,Value=i-1234567890abcdef0 \
  --statistic Average \
  --period 3600 \
  --threshold 5 \
  --comparison-operator LessThanThreshold \
  --evaluation-periods 24 \
  --treat-missing-data missing \
  --alarm-actions arn:aws:automate:ap-northeast-2:ec2:stop
Acciones de Auto Scaling
# Link Auto Scaling policy
aws cloudwatch put-metric-alarm \
  --alarm-name "ASG-ScaleOut" \
  --metric-name CPUUtilization \
  --namespace AWS/EC2 \
  --dimensions Name=AutoScalingGroupName,Value=my-asg \
  --statistic Average \
  --period 300 \
  --threshold 70 \
  --comparison-operator GreaterThanThreshold \
  --evaluation-periods 2 \
  --alarm-actions arn:aws:autoscaling:ap-northeast-2:123456789012:scalingPolicy:xxx:autoScalingGroupName/my-asg:policyName/scale-out

aws cloudwatch put-metric-alarm \
  --alarm-name "ASG-ScaleIn" \
  --metric-name CPUUtilization \
  --namespace AWS/EC2 \
  --dimensions Name=AutoScalingGroupName,Value=my-asg \
  --statistic Average \
  --period 300 \
  --threshold 30 \
  --comparison-operator LessThanThreshold \
  --evaluation-periods 3 \
  --alarm-actions arn:aws:autoscaling:ap-northeast-2:123456789012:scalingPolicy:xxx:autoScalingGroupName/my-asg:policyName/scale-in
Acciones de Systems Manager
Un ARN automation-definition/... no es un destino directo de AlarmActions compatible para ejecutar un runbook arbitrario de SSM Automation. La integración directa con SSM usa las acciones enumeradas por la API, como OpsItems. Enrute Automation mediante un destino de SSM Automation de EventBridge o un flujo de trabajo explícito de Lambda/Step Functions. Limite por separado el rol de ejecución del destino, ssm:StartAutomationExecution, los parámetros del runbook y el rol de Automation. Un umbral de disco por sí solo no debe autorizar la eliminación arbitraria de archivos.
Optimización de costos
Factores de costo
Las cifras siguientes son ejemplos de US East de la página de precios oficial consultada el 2026-09-13, no una cotización para Seúl. Consulte los precios actuales de la Region de destino. Las alarmas de métricas se cobran por métricas evaluadas, mientras que las compuestas se cobran por alarma. La detección de anomalías incluye la métrica real y dos métricas de banda. Agregar una compuesta conserva los cargos de las alarmas secundarias: reduce el ruido de las notificaciones, no el costo automáticamente.
| Elemento | Costo |
|---|---|
| Alarma de resolución estándar (60 s) | $0.10/alarma/mes |
| Alarma de alta resolución (10 s) | $0.30/alarma/mes |
| Alarma de anomalía estándar: una métrica real más dos bandas | Ejemplo de $0.30/alarma/mes |
| Alarma compuesta | $0.50/alarma/mes |
Estrategias de optimización de costos
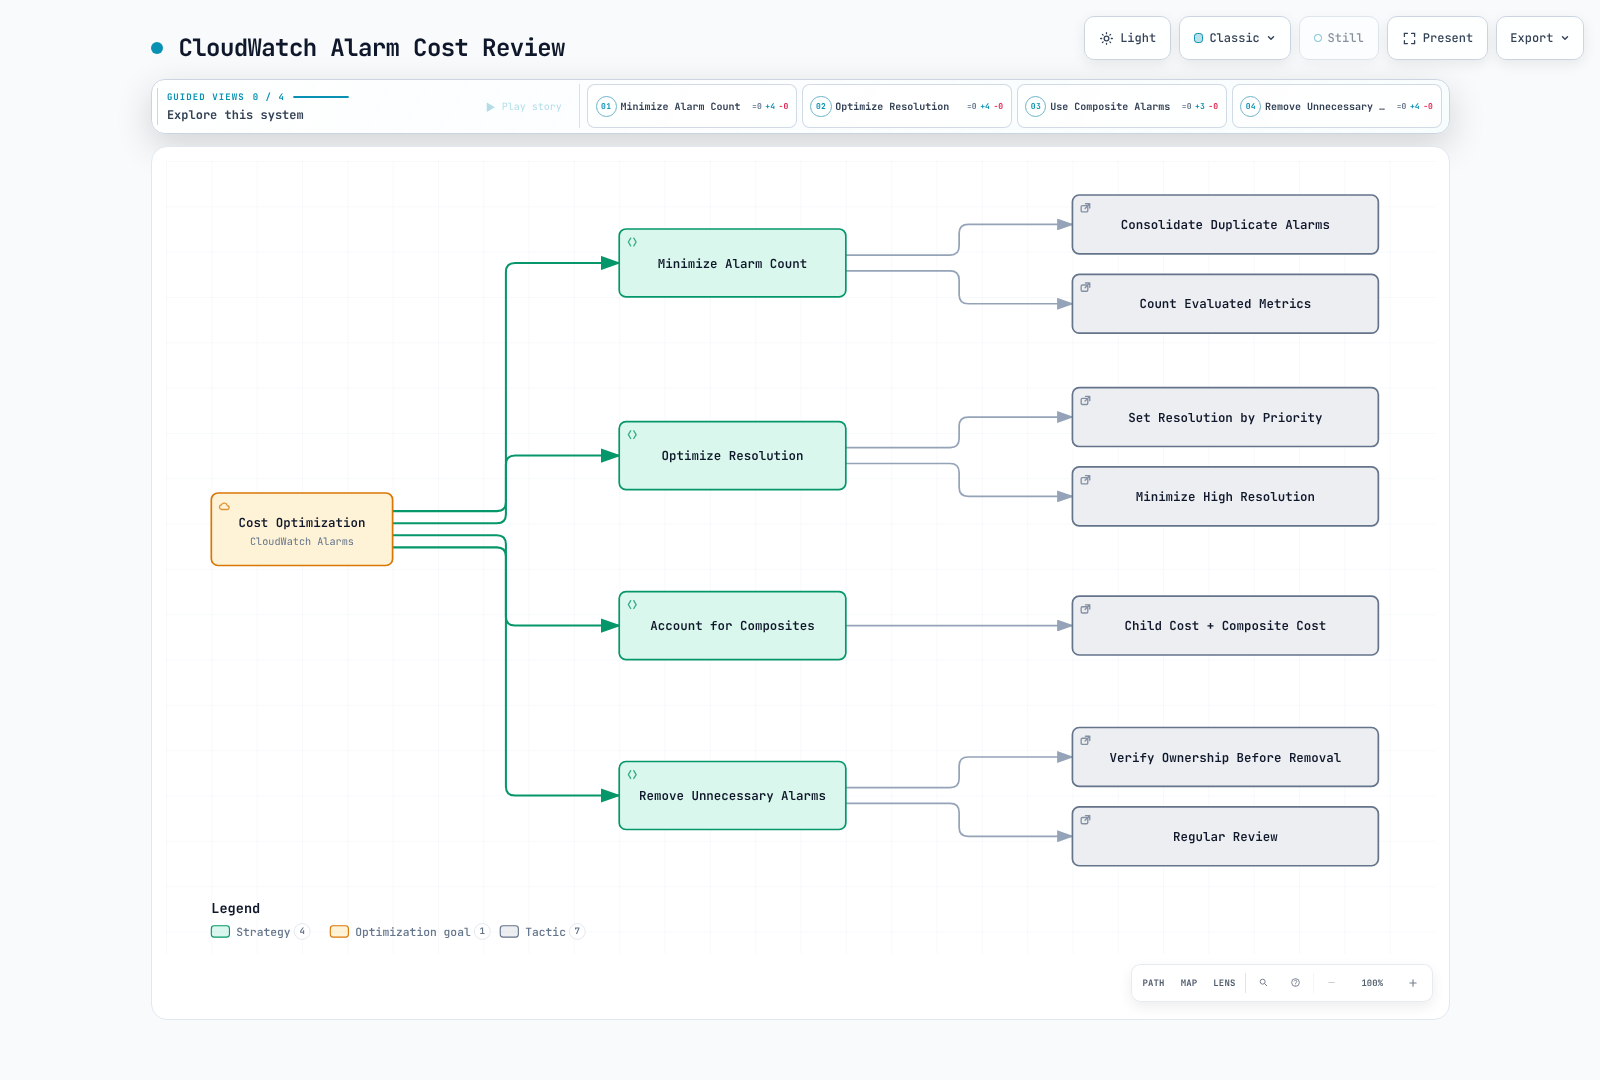
Configuración recomendada
# Cost-effective alarm settings

# Critical: Standard Resolution (60s; only 10/20/30s is high resolution)
critical-alerts:
  period: 60  # 1 minute
  evaluation-periods: 2

# Warning: Standard Resolution
warning-alerts:
  period: 300  # 5 minutes
  evaluation-periods: 2

# Info: Standard Resolution (relaxed detection)
info-alerts:
  period: 900  # 15 minutes
  evaluation-periods: 3
Script de limpieza de alarmas
Este comando solo enumera candidatos para inspección. INSUFFICIENT_DATA no prueba que una alarma no se use, y una fecha histórica fija no puede significar «hace 90 días». Revise el tiempo transcurrido desde StateTransitionedTimestamp, la recopilación real, la propiedad y las dependencias compuestas antes de una eliminación autorizada por separado. StateUpdatedTimestamp también puede cambiar cuando cambia el motivo del estado; no es lo mismo que el tiempo en el estado actual.
aws cloudwatch describe-alarms  \
  --alarm-types MetricAlarm  \
  --state-value INSUFFICIENT_DATA  \
  --query 'MetricAlarms[].{Name:AlarmName,StateSince:StateTransitionedTimestamp,Updated:StateUpdatedTimestamp}'  \
  --output json
Integración de métricas de Prometheus
Integración con Amazon Managed Prometheus (AMP)
Las métricas almacenadas en AMP no se copian automáticamente a las métricas clásicas de CloudWatch. Elija la ruta que corresponda al requisito.
- Alertas dentro de AMP: configure reglas de alerta de Prometheus del espacio de trabajo → Alertmanager administrado → un receptor compatible (SNS o PagerDuty).
- Alarmas de PromQL de CloudWatch: evalúan métricas ingeridas mediante el endpoint de OTLP de CloudWatch. No es una consulta directa de un espacio de trabajo de AMP.
- Republicación de métricas clásicas de CloudWatch: defina solo los agregados requeridos en un exportador independiente. Firme con un conjunto único y consistente de credenciales temporales congeladas, y valide los tiempos de espera, el estado HTTP, el tipo de resultado, los valores finitos, las marcas de tiempo y las dimensiones. No convierta resultados vacíos, NaN o fallos en cero o éxito. Esto agrega costos de consulta, métricas personalizadas, tiempo de ejecución y retraso.
El anterior promedio de modo de CPU no era la utilización total de CPU; una proporción de promedios de memoria entre Pods no relacionados o sin límite no era la utilización del límite de cada Pod. Seleccione PromQL que conserve las etiquetas requeridas y la semántica de restablecimiento, luego pruebe la regla y valide los datos recopilados reales.
Ejemplos de Terraform
Los bloques siguientes forman un módulo de ejemplo. Configure valores reales de recursos y la política del tema de SNS, y luego revise terraform plan antes de la implementación. La validación de ejemplo cubre el esquema/sintaxis del proveedor, no la implementación de AWS ni la entrega real de notificaciones.
Alarma básica
# SNS Topic
resource "aws_sns_topic" "alerts" {
  name = "eks-alerts"
}

resource "aws_sns_topic_subscription" "email" {
  topic_arn = aws_sns_topic.alerts.arn
  protocol  = "email"
  endpoint  = "team@example.com"
}

# EC2 CPU alarm
resource "aws_cloudwatch_metric_alarm" "ec2_cpu" {
  alarm_name          = "ec2-high-cpu"
  comparison_operator = "GreaterThanThreshold"
  evaluation_periods  = 2
  metric_name         = "CPUUtilization"
  namespace           = "AWS/EC2"
  period              = 300
  statistic           = "Average"
  threshold           = 80
  alarm_description   = "EC2 CPU usage exceeds 80%"

  dimensions = {
    InstanceId = "i-1234567890abcdef0"
  }

  alarm_actions = [aws_sns_topic.alerts.arn]
  ok_actions    = [aws_sns_topic.alerts.arn]

  treat_missing_data = "missing"
}
Alarma de Metrics Math
resource "aws_cloudwatch_metric_alarm" "alb_error_rate" {
  alarm_name          = "alb-high-error-rate"
  comparison_operator = "GreaterThanThreshold"
  evaluation_periods  = 2
  threshold           = 5
  alarm_description   = "ALB error rate exceeds 5%"

  metric_query {
    id          = "errors"
    return_data = false

    metric {
      metric_name = "HTTPCode_Target_5XX_Count"
      namespace   = "AWS/ApplicationELB"
      period      = 300
      stat        = "Sum"

      dimensions = {
        LoadBalancer = "app/my-alb/1234567890"
      }
    }
  }

  metric_query {
    id          = "requests"
    return_data = false

    metric {
      metric_name = "RequestCount"
      namespace   = "AWS/ApplicationELB"
      period      = 300
      stat        = "Sum"

      dimensions = {
        LoadBalancer = "app/my-alb/1234567890"
      }
    }
  }

  metric_query {
    id          = "error_rate"
    expression  = "IF(requests > 0, 100 * FILL(errors, 0) / requests, 0)"
    label       = "Error Rate"
    return_data = true
  }

  alarm_actions = [aws_sns_topic.alerts.arn]
}
Alarma compuesta
# Individual alarms
resource "aws_cloudwatch_metric_alarm" "cpu_alarm" {
  alarm_name          = "high-cpu"
  comparison_operator = "GreaterThanThreshold"
  evaluation_periods  = 2
  metric_name         = "CPUUtilization"
  namespace           = "AWS/EC2"
  period              = 300
  statistic           = "Average"
  threshold           = 80

  dimensions = {
    InstanceId = "i-1234567890abcdef0"
  }
}

resource "aws_cloudwatch_metric_alarm" "memory_alarm" {
  alarm_name          = "high-memory"
  comparison_operator = "GreaterThanThreshold"
  evaluation_periods  = 2
  metric_name         = "mem_used_percent"
  namespace           = "CWAgent"
  period              = 300
  statistic           = "Average"
  threshold           = 85

  dimensions = {
    InstanceId = "i-1234567890abcdef0"
  }
}

# Composite Alarm
resource "aws_cloudwatch_composite_alarm" "server_critical" {
  alarm_name        = "server-critical"
  alarm_description = "Server CPU and Memory are both high"

  alarm_rule = "ALARM(${aws_cloudwatch_metric_alarm.cpu_alarm.alarm_name}) AND ALARM(${aws_cloudwatch_metric_alarm.memory_alarm.alarm_name})"

  alarm_actions = [aws_sns_topic.alerts.arn]
  ok_actions    = [aws_sns_topic.alerts.arn]
}
Alarma de EKS Container Insights
resource "aws_cloudwatch_metric_alarm" "eks_node_cpu" {
  alarm_name          = "eks-node-high-cpu"
  comparison_operator = "GreaterThanThreshold"
  evaluation_periods  = 2
  metric_name         = "node_cpu_utilization"
  namespace           = "ContainerInsights"
  period              = 300
  statistic           = "Average"
  threshold           = 80
  alarm_description   = "EKS Node CPU usage exceeds 80%"

  dimensions = {
    ClusterName = "my-eks-cluster"
  }

  alarm_actions = [aws_sns_topic.alerts.arn]
}

resource "aws_cloudwatch_metric_alarm" "eks_pod_restarts" {
  alarm_name          = "eks-pod-restarts"
  comparison_operator = "GreaterThanThreshold"
  evaluation_periods  = 1
  metric_name         = "pod_number_of_container_restarts"
  namespace           = "ContainerInsights"
  period              = 300
  statistic           = "Maximum"
  threshold           = 3
  alarm_description   = "Observed cumulative restart count exceeds 3; not a 5-minute increase"

  dimensions = {
    ClusterName = "my-eks-cluster"
    Namespace   = "production"
    PodName     = "my-pod"
  }

  alarm_actions = [aws_sns_topic.alerts.arn]
}
Alarma de detección de anomalías
resource "aws_cloudwatch_metric_alarm" "cpu_anomaly" {
  alarm_name          = "cpu-anomaly-detection"
  comparison_operator = "LessThanLowerOrGreaterThanUpperThreshold"
  evaluation_periods  = 2
  threshold_metric_id = "ad1"
  alarm_description   = "CPU usage is anomalous"

  metric_query {
    id          = "m1"
    return_data = true

    metric {
      metric_name = "CPUUtilization"
      namespace   = "AWS/EC2"
      period      = 300
      stat        = "Average"

      dimensions = {
        InstanceId = "i-1234567890abcdef0"
      }
    }
  }

  metric_query {
    id          = "ad1"
    expression  = "ANOMALY_DETECTION_BAND(m1, 2)"
    label       = "CPUUtilization (Expected)"
    return_data = true
  }

  alarm_actions = [aws_sns_topic.alerts.arn]
}
Referencias
- Tipos de alarmas de CloudWatch
- API PutMetricAlarm
- Evaluación de datos faltantes
- Alarmas compuestas y supresión de acciones
- Cálculos de métricas
- Detección de anomalías
- Esquemas de mensajes de alarma de SNS
- Ámbito de la política de filtro de SNS
- Eventos de alarma de EventBridge
- Permisos de destino de EventBridge
- Dimensiones de métricas de Container Insights
- Complemento CloudWatch Observability de EKS
- Precios de CloudWatch
- Alarmas de PromQL
- Alarmas de registros
- Receptores de alertas de AMP
Cuestionario
Pruebe sus conocimientos con el Cuestionario de alarmas de CloudWatch.