Parte 5: Kubeflow Trainer y entrenamiento distribuido
Línea base de la revisión: Trainer 2.2.0 / Community Distribution 26.03.1; comparación de actualización independiente a 2.3.0 Última actualización: September 12, 2026
Configuración del entorno de laboratorio
Use Kubernetes, el controlador/CRD de Trainer, runtimes y sus dependencias, como JobSet, que sean compatibles. Las GPU dependen de la carga de trabajo; el entrenamiento con CPU es posible. Las cargas de trabajo con GPU requieren adicionalmente drivers, device plugins, capacidad de nodos y redes. La validación aquí consiste en el renderizado de Helm y la inspección de esquemas, no en la ejecución de entrenamiento.
De Operators específicos de frameworks a una API unificada
El entrenamiento distribuido en Kubernetes ha experimentado un verdadero cambio arquitectónico dentro del proyecto Kubeflow, y esto es lo más importante que debe entender antes de modificar cualquier YAML.
El Training Operator original (v1)
El Training Operator que Kubeflow consolidó en 2021 adoptó un enfoque de CRD específico de framework. Cada framework de ML compatible tenía su propia Custom Resource Definition, cada una con su propio controlador que implementaba la semántica particular de entrenamiento distribuido de ese framework:
PyTorchJob— el controlador entendía las convenciones de lanzamiento distribuido de PyTorch e inyectaba variables de entorno comoMASTER_ADDR,RANKyWORLD_SIZEen cada Pod de worker para quetorch.distributedpudiera formar un grupo de procesos.TFJob— en su lugar, el controlador construía una variable de entornoTF_CONFIG(un blob JSON que describe los roles de tareas del clúster — chief, worker, parameter server) que esperan las estrategias de distribución de TensorFlow.MPIJob— el controlador gestionaba el lanzamiento de un trabajo MPI entre Pods y coordinaba un launcher estilompiruncon un conjunto de Pods de worker.
Además de estos tres, el Training Operator v1 también incluía CRD para algunos otros frameworks. Cada CRD codificaba la idea de un framework distinto sobre «cómo los workers se encuentran entre sí y acuerdan sus roles» directamente en un controlador independiente, por lo que agregar un framework requería integración, aunque la infraestructura compartida de controladores de Job aún podía reutilizarse.
El cambio a Kubeflow Trainer v2
Kubeflow Trainer v2 sustituye esto por una API única y unificada basada en dos conceptos en lugar de un CRD por framework:
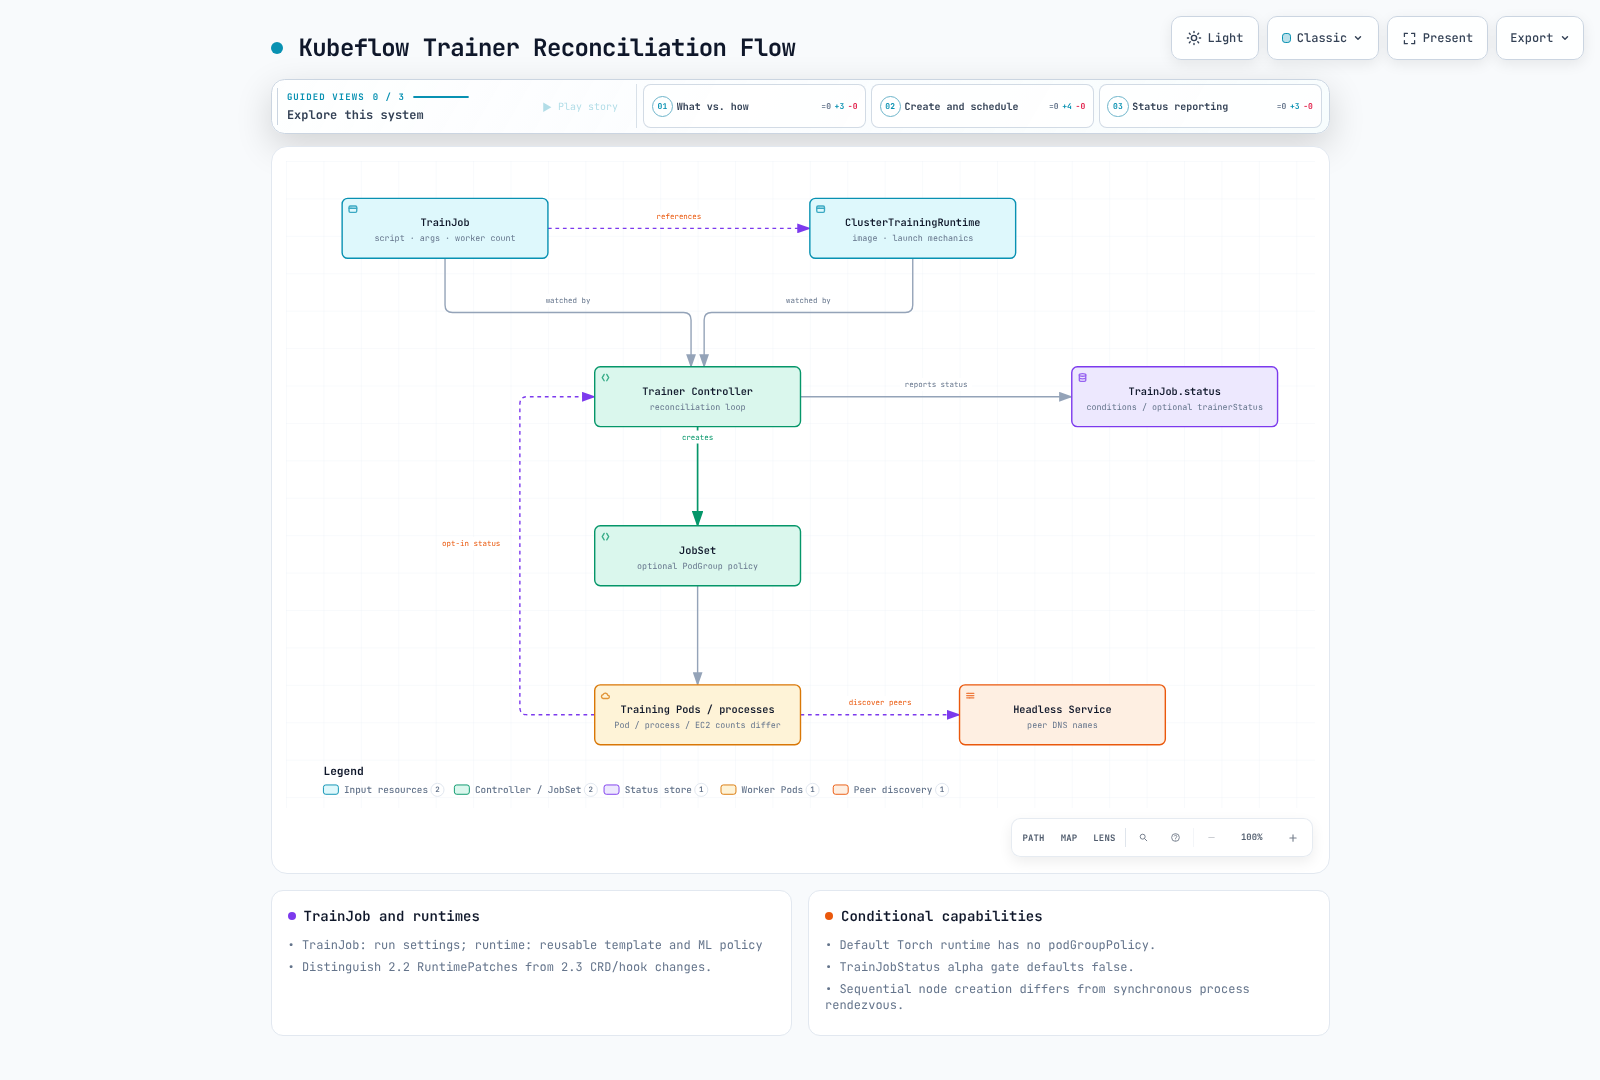
TrainJob— describe qué ejecutar: el script/entrypoint de entrenamiento, argumentos, recuentos de recursos (por ejemplo, número de workers) y una referencia al runtime que debe ejecutarlo. Es el objeto que un profesional de ML crea para una ejecución de entrenamiento individual.TrainingRuntime/ClusterTrainingRuntime— describe cómo ejecutarlo: una plantilla de ejecución reutilizable y específica de framework que abarca la imagen de contenedor, la mecánica de lanzamiento distribuido (cómo los workers se descubren entre sí, qué variables de entorno o proceso launcher se usan) y la forma de recursos predeterminada. Un equipo de plataforma define una pequeña cantidad de estos una vez — por ejemplo, un runtime PyTorch DDP y un runtime MPI — y muchosTrainJobdiferentes hacen referencia al mismo runtime en muchas ejecuciones de entrenamiento.
Esto refleja un patrón observado en otras partes de Kubernetes: separar un recurso de «plantilla» reutilizable de la «instancia» que lo consume, similar en espíritu a cómo un StorageClass es una plantilla reutilizable a la que hacen referencia muchos PersistentVolumeClaim. El beneficio práctico es que un equipo de plataforma puede poseer y versionar en un solo lugar la compleja mecánica de lanzamiento distribuido (el runtime), mientras que los profesionales de ML que envían trabajos solo necesitan proporcionar su script y solicitar un runtime por nombre — el runtime reduce la configuración repetida, mientras que el código de entrenamiento aún debe manejar la inicialización distribuida compatible, la fragmentación de datos, los checkpoints y la recuperación.
Diferencias entre 2.2.0 y 2.3.0
Trainer 2.2.0 se publicó el 20 de marzo de 2026 y está incluido en 26.03.1. Agrega runtimes de JAX/XGBoost y políticas/integración de Flux; la inclusión de características no demuestra compatibilidad con todas las configuraciones de imagen, red o acelerador.
2.2.0 también reemplaza PodTemplateOverrides por RuntimePatches, elimina numProcPerNode de la política Torch y elimina ElasticPolicy. No confunda una política Torch de runtime con trainer.numProcPerNode por ejecución. Los manifiestos 2.x anteriores también pueden requerir migración.
El progreso y las métricas del runtime en status.trainerStatus requieren el feature gate alpha TrainJobStatus, deshabilitado de forma predeterminada. El código de entrenamiento debe informar al servidor de estado con acceso funcional a TLS/token de ServiceAccount proyectado. Los valores de entorno de token/CA inyectados son rutas de archivo, no contenidos de secretos. La mera impresión de logs no completa automáticamente las métricas de estado.
2.3.0, publicado el 7 de agosto de 2026, cambia los finalizers/snapshots de runtime y la ubicación de los Helm CRD. Sus notas de versión requieren que las instalaciones 2.0/2.1/2.2 pasen por 2.3 antes de versiones posteriores. Revise la propiedad de Helm de los CRD y la migración específica de la versión antes de actualizar; eliminar CRD existentes no es una solución de actualización rutinaria.
Los charts OCI publicados también difieren: 2.2 renderiza directamente ocho runtimes predeterminados, mientras que 2.3 los empaqueta en un ConfigMap runtimes.yaml aplicado por un Job instalador post-install/post-upgrade. El hook de 2.3 instala kubectl en tiempo de ejecución, aplica recursos de forma forzada del lado del servidor y elimina mediante su etiqueta de administración; también existe un hook pre-delete. Revise el manejo de hooks de GitOps, el acceso de red y la propiedad de los runtimes. Esta revisión renderizó los hooks sin ejecutarlos.
Migración de APIs heredadas
26.03.1 incluye Trainer 2.2.0 y el Training Operator heredado 1.9.2. Su coexistencia no revela el avance de migración de ningún equipo. PyTorchJob/TFJob/MPIJob y TrainJob son APIs diferentes y no se convierten automáticamente.
El documento oficial de migración fijado proporciona un ejemplo de PyTorchJob al runtime Torch predeterminado y orientación para SDK, no un mapeo exhaustivo para cada framework/campo. Compare roles de réplica, comandos de lanzamiento, entorno, reintentos, almacenamiento, scheduling/redes y recuperación de checkpoints para cada carga de trabajo.
Responsabilidades de TrainJob y Runtime
TrainingRuntime tiene ámbito de namespace; ClusterTrainingRuntime tiene ámbito de clúster. Ambos contienen plantillas de ejecución y políticas de ML. TrainJob.runtimeRef selecciona tipo/nombre, mientras que los campos de trainer pueden configurar comando/argumentos, cantidad de Pods de entrenamiento y recursos por Pod. Los permisos y las anulaciones permitidas requieren una gestión independiente.
El runtime predeterminado torch-distributed tiene mlPolicy.numNodes: 1, torch: {} y una plantilla JobSet. En 2.2.0 hace referencia a pytorch/pytorch:2.10.0-cuda12.8-cudnn9-runtime. Registre las revisiones de imagen/runtime y verifique la arquitectura, los drivers y las bibliotecas de comunicación; esta revisión no ejecutó la imagen ni entrenó un modelo.
Aquí numNodes representa la cantidad de Pods de entrenamiento, no un recuento uno a uno de instancias EC2. Calcule por separado los procesos, las GPU por Pod y la colocación de múltiples Pods.
Mecánica del entrenamiento distribuido en Kubernetes
JobSet y los runtimes componen Jobs/Pods y usan Service/DNS junto con la configuración de rango/rendezvous para el descubrimiento de procesos. Un Service headless por sí solo no conserva el estado ni las IP de los procesos; el nombrado estable de Pod, hostname/subdomain y las condiciones de red siguen siendo importantes.
Instalar Trainer no habilita automáticamente el gang scheduling. El runtime Torch predeterminado de 2.2.0 no tiene podGroupPolicy. Las políticas de coscheduling/Volcano, los CRD y la integración de scheduler deben instalarse/configurarse para esas rutas de PodGroup. La admisión de Kueue también es distinta del scheduling real de Pods.
El entrenamiento síncrono de tamaño fijo necesita que todos los procesos requeridos estén listos para la comunicación, pero los nodos no necesitan crearse en el mismo instante. El aprovisionamiento secuencial puede tener éxito dentro de los timeouts de rendezvous; las cargas de trabajo elásticas compatibles tienen reglas diferentes. La admisión gang reduce la asignación parcial, pero no puede resolver toda escasez de EC2 ni los deadlocks de aplicación. Coordine la capacidad de Karpenter con JobSet, scheduler y los timeouts/reintentos del framework.
Referencia cruzada: Katib y TrainJob
Katib 0.19.0 puede usar TrainJob en una plantilla Trial configurada. Haga coincidir el registro de trialResources, el runtime, las condiciones de éxito/error, los Pods/contenedores principales y la recopilación de métricas. Los informes de métricas de Katib son independientes del servidor de estado con opt-in de Trainer. Un TrainJob exitoso no despliega automáticamente un modelo en KServe.
Validación y fuentes
Los charts oficiales OCI de Helm de Trainer 2.2.0 y 2.3.0 se descargaron y renderizaron con runtimes predeterminados habilitados; se inspeccionaron los esquemas de CRD/runtime. No se ejecutaron la admisión de API/CEL, las actualizaciones reales, la creación de JobSet, el entrenamiento distribuido/con GPU ni los informes del servidor de estado.
- API de TrainJob 2.2.0
- Feature gate predeterminado de TrainJobStatus
- Creación condicional de PodGroup de Coscheduling
- Runtime Torch predeterminado
Próximos pasos
Con el cambio de CRD específicos de framework al modelo unificado de TrainJob/runtime ya establecido, Parte 6: KServe — Model Serving en Kubernetes abarca qué sucede con un modelo una vez que se completa el entrenamiento mediante un TrainJob: servirlo para inferencia.
Cuestionario
Para poner a prueba lo aprendido en este capítulo, pruebe el Cuestionario del tema.