Parte 2: El operador de KubeRay
Referencia de revisión: KubeRay 1.7.0 · Ray 2.58.0 · 2026-09-12
Configuración del entorno de laboratorio
Prepare Kubernetes compatible, kubectl compatible y Helm 3. El hardware GPU y Karpenter no son requisitos previos para revisar una configuración de CPU. La capacidad real de EKS puede provenir de grupos de nodos administrados existentes, Karpenter, Cluster Autoscaler o la configuración de aprovisionamiento elegida para el clúster.
La validación aquí cubre la descarga oficial del chart y el renderizado nativo de Helm, las comprobaciones del esquema de CRD y el generador de configuración del autoscaler de Ray 2.58.0. No establece la admisión/CEL del servidor API, la reconciliación del controlador, el autoscaling en vivo ni la ejecución en GPU.
Qué hace KubeRay
KubeRay reconcilia los CR de Ray en Pods, Services y recursos relacionados. No suponga que un grupo de workers ordinario de RayCluster es necesariamente un Deployment o StatefulSet. Un nodo de Ray suele corresponder a un Pod de Ray, distinto del nodo de Kubernetes/EC2 que aloja ese Pod.
Instalar el operador no inicia una carga de trabajo de Ray. Cree recursos como RayCluster, RayJob o RayService por separado. Tampoco todos los cambios en spec se aplican automáticamente en el lugar a un Pod existente; inspeccione la ruta de actualización.
CRD y Feature Gates
El chart 1.7.0 incluye CRD de RayCluster, RayJob, RayService y RayCronJob. Todos proporcionan ray.io/v1. Los tres primeros también conservan el v1alpha1 obsoleto; los ejemplos nuevos usan v1.
| Recurso | Función y límite |
|---|---|
| RayCluster | administra un Pod head y grupos de workers; son posibles las configuraciones solo con head |
| RayJob | envío por lotes y ciclo de vida opcional de RayCluster; distinga los clústeres existentes y las políticas de limpieza |
| RayService | administra RayCluster y las aplicaciones de Serve; inspeccione las condiciones de actualización y transición de tráfico |
| RayCronJob | crea RayJobs según una programación; su Feature Gate de controlador está deshabilitado de forma predeterminada a pesar del CRD instalado |
Los valores predeterminados del chart habilitan el gate beta RayServiceIncrementalUpgrade. Los gates alpha para mTLS, NetworkPolicy de RayCluster y la inyección automática del recopilador de History están deshabilitados. El estado beta de History Server difiere de la inyección automática alpha del recopilador. Que haya un Feature Gate disponible no significa que el recurso tenga configurada esa función.
Limpieza de RayJob
shutdownAfterJobFinishes tiene como valor predeterminado false. El valor predeterminado ttlSecondsAfterFinished: 0 no lo habilita. Configure explícitamente la limpieza, los reintentos y los plazos previos a la ejecución/de ejecución. La versión 1.7 también tiene deletionStrategy, con restricciones como no mezclar las políticas heredadas onSuccess/onFailure y deletionRules.
Distinga la selección de clúster compartido de la limpieza de un clúster creado por el controlador, y conserve primero los resultados, checkpoints y logs. Eliminar un RayCluster no limpia automáticamente los artefactos/PVC externos ni todos los cargos de EC2.
Actualizaciones de RayService
NewCluster y NewClusterWithIncrementalUpgrade crean un clúster nuevo. El segundo usa la API Gateway de Kubernetes y una implementación GatewayClass adecuada para desplazar el tráfico progresivamente. Esto es diferente de simplemente realizar un rolling de algunos Pods en el lugar.
Aunque el gate incremental está habilitado de forma predeterminada en 1.7, la estrategia, la configuración de Gateway, la capacidad disponible, la preparación y los requisitos de drenaje siguen siendo importantes. Cero tiempo de inactividad es un objetivo, no una garantía para todas las aplicaciones. La Parte 4 cubre con más detalle el comportamiento de Serve.
Capas de autoscaling
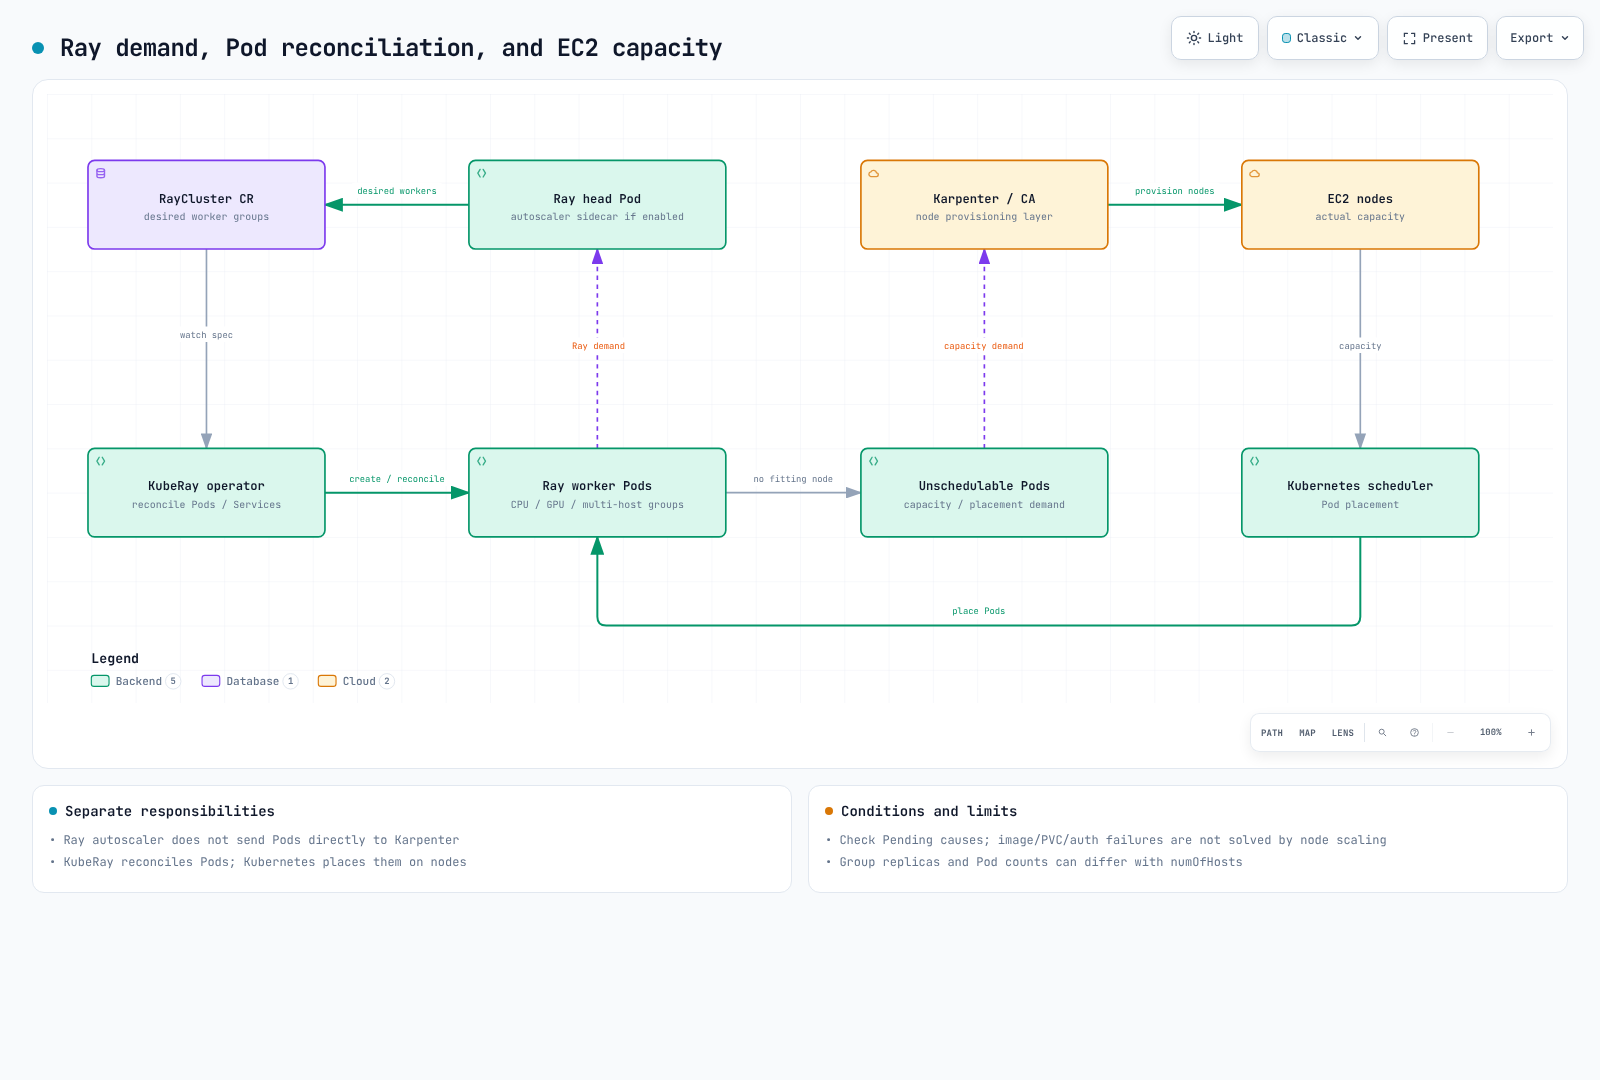
Habilite el autoscaling de Ray con enableInTreeAutoscaling: true. KubeRay configura un sidecar de autoscaler en el Pod head y los permisos necesarios. El ejemplo establece explícitamente autoscalerOptions.version: v2 en lugar de depender de valores predeterminados sensibles a la versión.
El autoscaler de Ray examina tareas, actores, solicitudes de placement/recursos y el tamaño deseado del grupo de workers; KubeRay ajusta los Pods. Con numOfHosts, una réplica de grupo puede corresponder a varios Pods de Ray, por lo que replicas == Pod count no es universal.
Kubernetes coloca Pods, mientras que un aprovisionador como Karpenter proporciona capacidad de EC2 para requisitos no programables. Un Pod Pending causado por descargas de imágenes, PVC, permisos o cuotas no se soluciona necesariamente agregando un nodo. La consolidación y el manejo de drift de Karpenter también son comportamientos de control independientes.
El generador de configuración de Ray 2.58.0 establece de forma predeterminada el tiempo de inactividad global en 60 segundos; los tiempos de inactividad a nivel de grupo pueden anular el comportamiento. Las réplicas mínimas/máximas, la actividad, el sondeo y las condiciones de drenaje significan que no es una promesa de eliminar un Pod exactamente 60 segundos después.
Declaraciones de recursos de CPU/GPU
Un límite de GPU de Pod no siempre es la única fuente de configuración. El código revisado aplica precedencia entre los resources estructurados del grupo, rayStartParams y los límites/solicitudes del primer contenedor de Ray. Un num-gpus explícito no se sobrescribe incondicionalmente con el límite de GPU del contenedor.
Las comprobaciones de configuración nativa de Ray 2.58.0 produjeron GPU 1 a partir del límite 1, GPU 2 con rayStartParams.num-gpus=2 y GPU 3 con los resources.GPU=3 estructurados del grupo. Esto no crea más GPU físicas. Alinee los límites de Kubernetes, los plugins de dispositivo, los drivers, los recursos lógicos de Ray y el hardware visible.
Las réplicas mínimas y los requisitos de CPU/placement también pueden afectar el tamaño del grupo GPU; los Pods GPU no aparecen necesariamente solo cuando las tareas GPU están pendientes. Distinga también la configuración lógica de CPU de Ray de la aplicación de límites del contenedor.
Instalación y actualización del operador
helm repo add kuberay https://ray-project.github.io/kuberay-helm/
helm repo update kuberay
helm pull kuberay/kuberay-operator --version 1.7.0 --untar --untardir ./vendor
helm template kuberay-operator ./vendor/kuberay-operator \
  --namespace kuberay-system --include-crds > operator.rendered.yaml
Inspeccione los CRD, RBAC, el ámbito de observación del namespace y los Feature Gates. Los valores predeterminados del chart habilitan la elección de líder y la observación en todo el clúster. Para restringir el ámbito, revise conjuntamente singleNamespaceInstall, watchNamespace y la configuración relacionada de RBAC.
Realice la instalación real después de verificar el contexto y los permisos administrativos:
helm upgrade --install kuberay-operator kuberay/kuberay-operator \
  --version 1.7.0 --namespace kuberay-system --create-namespace
kubectl rollout status deployment/kuberay-operator -n kuberay-system
El mecanismo crds/ de Helm no actualiza ni elimina automáticamente los CRD existentes. No suponga que una actualización del chart actualizó el esquema. Compruebe los CR almacenados y la compatibilidad de la versión de API; luego realice por separado la actualización de CRD apropiada para la versión. Eliminar un CRD puede eliminar sus recursos personalizados.
Configuración mínima de CPU
Este ejemplo supone que existe el namespace ray-demo. Se validó el esquema de CRD; no se ejercitaron la ejecución del controlador, el inicio de la imagen ni el autoscaling.
apiVersion: ray.io/v1
kind: RayCluster
metadata:
  name: ray-cpu-demo
  namespace: ray-demo
spec:
  rayVersion: '2.58.0'
  enableInTreeAutoscaling: true
  autoscalerOptions:
    version: v2
    idleTimeoutSeconds: 60
  headGroupSpec:
    serviceType: ClusterIP
    rayStartParams:
      num-cpus: '0'
    template:
      spec:
        containers:
          - name: ray-head
            image: rayproject/ray:2.58.0-py312
            resources:
              requests:
                cpu: '1'
                memory: 2Gi
              limits:
                cpu: '1'
                memory: 2Gi
  workerGroupSpecs:
    - groupName: cpu
      replicas: 0
      minReplicas: 0
      maxReplicas: 2
      rayStartParams: {}
      template:
        spec:
          containers:
            - name: ray-worker
              image: rayproject/ray:2.58.0-py312
              resources:
                requests:
                  cpu: '1'
                  memory: 2Gi
                limits:
                  cpu: '1'
                  memory: 2Gi
El fixture completo del esquema usa rayproject/ray:2.58.0-py312 y solicitudes y límites de CPU 1/memoria 2 GiB para head y workers. Establecer rayVersion no actualiza por sí mismo las imágenes de contenedor. Verifique también la compatibilidad de runtime, Python e imagen.
Restrinja los puntos de entrada del dashboard, Ray Client y envío de jobs a actores de confianza. La autenticación mediante token es una configuración independiente, no TLS ni control de acceso para cada endpoint de aplicación. Compruebe la entrega de secretos conforme a la política organizacional y mantenga los tokens sensibles fuera de los manifests y logs públicos.