Datadog
Última actualización: October 12, 2026 Helm chart 3.244.0; Agent/Cluster Agent coincidentes 7.83.1. A continuación se indican los límites de configuración, SDK y validación local; no se modificó ningún tenant de Datadog.
Introducción
Datadog proporciona un backend de observabilidad SaaS. Los equipos siguen siendo responsables de los recopiladores, la identidad, el acceso de red, la instrumentación, la divulgación de datos, la retención, los monitores y el costo. Infrastructure Monitoring, APM, profiling, logs y otros productos tienen derechos y dimensiones de facturación distintos; instalar un Agent no incluye todos los productos.
| Tema | Datadog | CloudWatch | Prometheus / Grafana autogestionados |
|---|---|---|---|
| Backend | Datadog SaaS, con disponibilidad específica del sitio | Servicios administrados por AWS | Almacenamiento, consulta y visualización operados |
| Recopilación | Agent/Cluster Agent, bibliotecas y rutas OTel compatibles | Métricas de servicios AWS, agents/SDKs/OTLP | Exporters, scraping, agents y remote write |
| APM/logs | Seleccione y configure los productos requeridos | Integraciones de Application Signals, tracing y Logs | Configure los backends y recopiladores pertinentes |
| Operaciones | Se mantienen las responsabilidades del recopilador/configuración y de la aplicación | Se mantienen las responsabilidades de recopilación/configuración y respuesta | Se mantienen las responsabilidades del backend y la recopilación |
| Costo | Unidades de uso/retención específicas de host y otros productos | Unidades de métrica/observación/OTLP/log/consulta/alarma | Infraestructura y esfuerzo operativo |
Elija el sitio de Datadog correcto para la organización y sus credenciales; los endpoints de API, la residencia de datos, los productos disponibles y los términos de precios no son intercambiables entre sitios. Use el catálogo de integraciones en lugar de afirmar un número fijo de integraciones o una clasificación universal de “fácil/avanzado/barato”.
Arquitectura de integración de EKS
| Componente | Responsabilidad / límite |
|---|---|
| Node Agent | Comprobaciones de host/contenedor; normalmente un DaemonSet en nodos EC2 compatibles |
| Cluster Agent | Metadatos/comprobaciones compartidos de Kubernetes, coordinación de eventos y funciones opcionales de admission/external-metric |
| Trace Agent | Recibe cargas útiles de traces de aplicaciones y las reenvía |
| Recopilación de procesos / system-probe | Funciones opcionales de proceso/red/seguridad con sus propios requisitos de sistema operativo, privilegios y producto |
| Admission Controller | Inserta la configuración de conexión y, cuando se configura, bibliotecas de cliente compatibles en pods nuevos |
La instrumentación de aplicaciones produce traces/profiles; un listener de Agent o una etiqueta de Pod por sí sola no demuestra la instrumentación. El Cluster Agent no es la ruta habitual de reenvío de logs o traces de aplicaciones.
La instalación de este capítulo se dirige a nodos EKS basados en Linux EC2. EKS Fargate usa el modelo documentado de recopilación por Pod/sidecar, no este DaemonSet de host. UDS es local al host y no es compatible con Windows. Windows, Bottlerocket, Auto Mode y computación mixta requieren sus configuraciones específicas de distribución/función y acceso al host compatible. No desactive la verificación TLS ni afirme que todas las funciones de eBPF/proceso funcionan en todas partes.
Datadog documenta Agent y Cluster Agent 7.67+ para compatibilidad con Kubernetes 1.33+ con AllocatedResources, y recomienda que sus versiones coincidan. Dichos requisitos mínimos de funciones no son la matriz actual de soporte de EKS.
La descripción general muestra posibles rutas de recopilación. Los traces/profiles requieren instrumentación de aplicaciones y productos seleccionados; se debe configurar el enrutamiento de notificaciones de Watchdog.
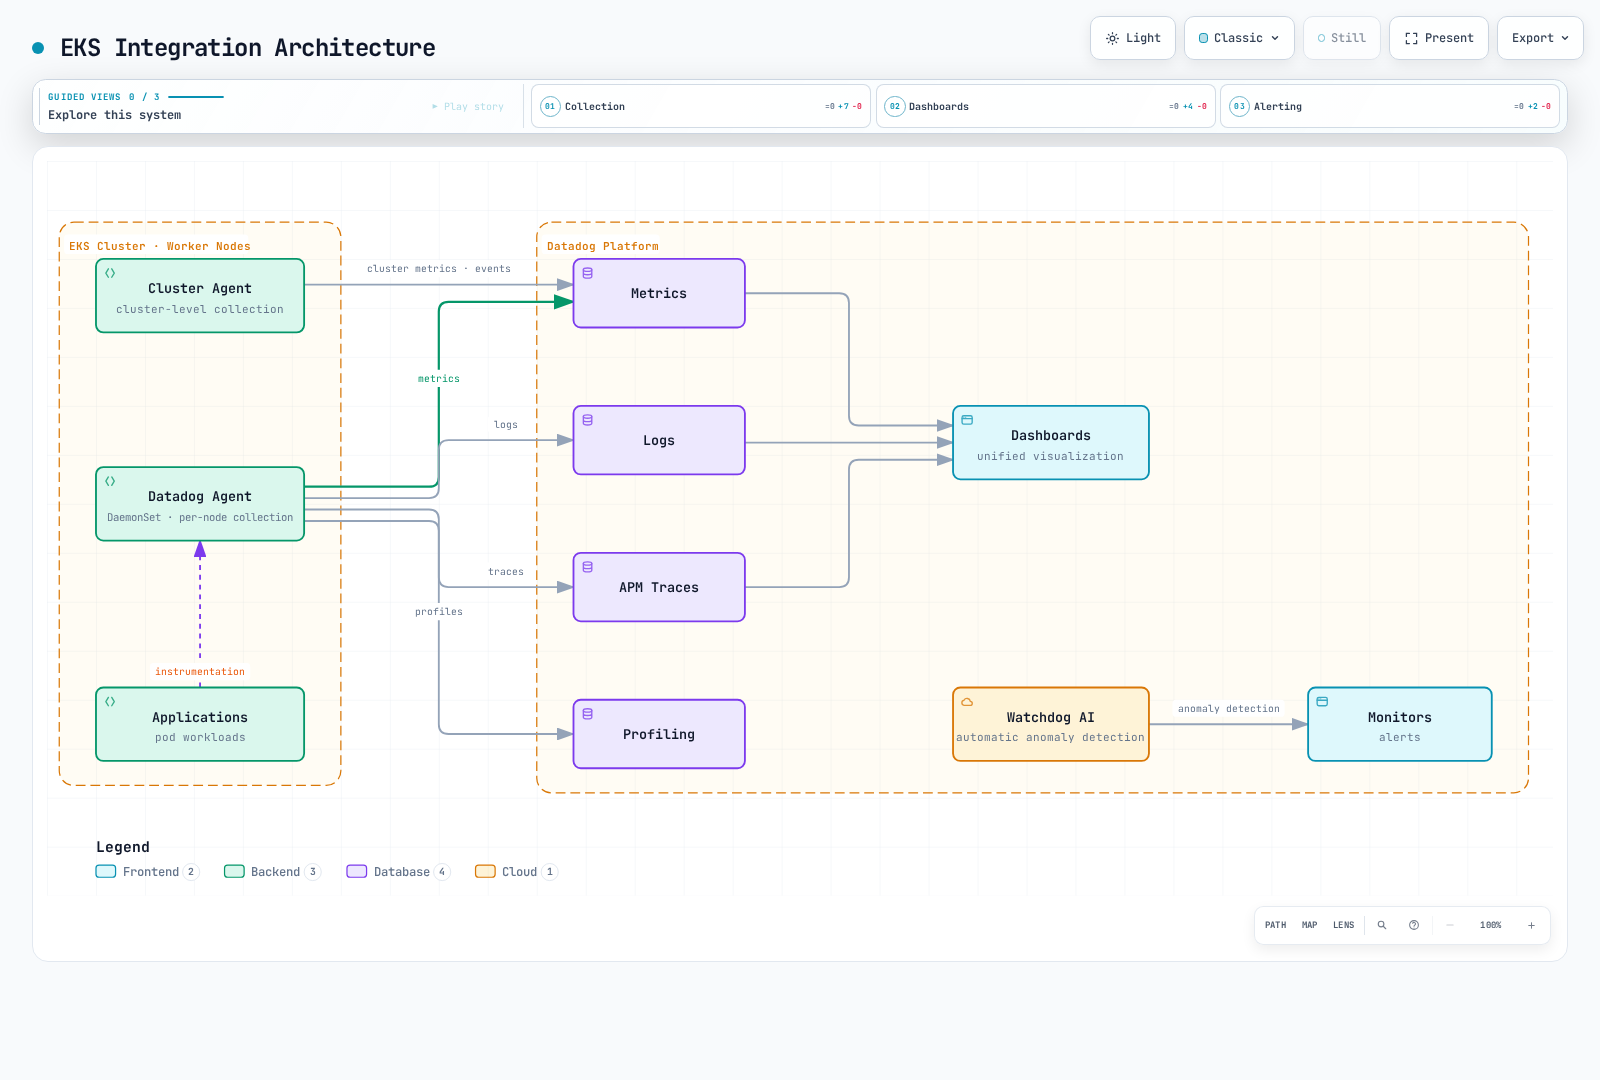
Instalación de Datadog Agent
Datadog recomienda su Operator para configuración del ciclo de vida de nivel superior y también admite la instalación con Helm. Este ejemplo controla los Agents de nodo/Cluster mediante el Helm chart de Datadog Agent. El chart 3.244.0 incluye una dependencia opcional de Operator; datadog.operator.enabled: false mantiene ese controlador adicional fuera de este ejemplo. No significa que el Operator sea obsoleto.
El chart tiene como valor predeterminado Agent/Cluster Agent 7.82.3. Este ejemplo fija explícitamente ambos a 7.83.1 y los digests verificados del índice de imágenes. La versión incluye correcciones para la facturación de network-test, limpieza de snapshots de containerd y apagado del bloqueo de líder de Cluster Agent. Los índices de imágenes de Agent/Cluster Agent incluyen Linux amd64/arm64. Un renderizado de template correcto no es una prueba de despliegue de Kubernetes ni de compatibilidad en tiempo de ejecución.
Credenciales y propiedad de la instalación
Este perfil obtiene la clave de API de Datadog y el token compartido de Cluster Agent desde AWS Secrets Manager mediante el backend nativo aws.secrets. No se necesita una clave de aplicación para la ingesta básica; las métricas externas permanecen deshabilitadas.
Prepare observability/datadog en ap-northeast-2 con claves de cadena JSON api-key y cluster-token; el token debe ser criptográficamente aleatorio y tener al menos 32 caracteres. La clave de API debe coincidir con el sitio de Datadog. Ambos ServiceAccounts, datadog y datadog-cluster-agent en el namespace datadog, requieren roles IRSA con alcance limitado, conectividad regional con STS/Secrets Manager y permiso KMS si corresponde. Reemplace los dos ARN de roles de ejemplo. La reserva de credenciales de metadatos EC2 está deshabilitada. Consulte los requisitos previos completos y perfiles reutilizables.
Use Python 3/PyYAML 6.0.3 y el postrenderer ejecutable del chart fijado desde ese directorio del repositorio. Reemplaza exactamente siete entradas codificadas de forma fija de SecretKeyRef con controladores literales ENC[...], preservando los consumidores de nodo, trace, init y Cluster Agent. La resolución nativa actualiza la configuración en memoria, no el entorno. El script init requiere DD_API_KEY no vacío, por lo que eliminarlo sin un reemplazo válido interrumpe el inicio. El Secret must-use-secret-postrenderer está deliberadamente ausente; no lo cree para omitir un renderer faltante. Mantenga el renderer en cada instalación/actualización y revise los cambios en el chart, las imágenes o el contrato de perfil fijados.
Estos comandos cambian el clúster únicamente durante la instalación; no se ejecutó ningún despliegue en la auditoría. Ejecute desde la raíz del repositorio, en un namespace datadog existente, con una versión que le pertenezca después de preparar los requisitos previos de IAM/secrets.
PROFILE=examples/observability/secret-profiles
helm repo add datadog https://helm.datadoghq.com
helm repo update datadog
helm template datadog datadog/datadog --version 3.244.0 \
  --namespace datadog --include-crds -f "$PROFILE/datadog-values.yaml" \
  --post-renderer "$PROFILE/datadog_postrender.py" > datadog-reviewed-render.yaml
# Review resources and ownership first; retain the renderer on EVERY upgrade.
helm upgrade --install datadog datadog/datadog --version 3.244.0 \
  --namespace datadog -f "$PROFILE/datadog-values.yaml" \
  --post-renderer "$PROFILE/datadog_postrender.py"
Valores revisados
Lo siguiente coincide con el datadog-values.yaml reutilizable. Los logs se habilitan de forma opcional mediante la configuración del contenedor, APM/DogStatsD usan UDS y la inyección automática de bibliotecas en todo el clúster, las métricas HPA externas, las estadísticas de red de discovery y la recopilación opcional de procesos/red no están habilitadas aquí. El namespace de aplicación debe estar separado del namespace de Agent; SSI no instrumenta Pods en el namespace propio de Agent.
# datadog 3.244.0: postrenderer required; replace example IRSA role ARNs.
targetSystem: linux
registry: gcr.io/datadoghq
datadog:
  apiKeyExistingSecret: must-use-secret-postrenderer
  clusterName: my-eks-cluster
  site: datadoghq.com
  tags:
  - env:demo
  - team:platform
  logs:
    enabled: true
    containerCollectAll: false
    containerCollectUsingFiles: true
  apm:
    socketEnabled: true
    portEnabled: false
    instrumentation:
      enabled: false
  dogstatsd:
    useSocketVolume: true
    useHostPort: false
    nonLocalTraffic: false
  processAgent:
    processCollection: false
    processDiscovery: false
    containerCollection: true
  networkMonitoring:
    enabled: false
  discovery:
    enabled: false
    networkStats:
      enabled: false
  autoscaling:
    workload:
      enabled: false
  profiling:
    enabled: null
  collectEvents: true
  prometheusScrape:
    enabled: false
  kubeStateMetricsCore:
    enabled: true
    collectSecretMetrics: false
    collectConfigMaps: false
  operator:
    enabled: false
  secretBackend:
    type: aws.secrets
    config:
      aws_session:
        aws_region: ap-northeast-2
    enableGlobalPermissions: false
  env: &id001
  - name: AWS_EC2_METADATA_DISABLED
    value: 'true'
  - name: DD_SECRET_REFRESH_INTERVAL
    value: '0'
  - name: DD_SECRET_REFRESH_ON_API_KEY_FAILURE_INTERVAL
    value: '0'
clusterAgent:
  enabled: true
  replicas: 2
  image:
    tag: 7.83.1
    digest: sha256:8e420c81e68abec34ab792c72a6513b739dcba8f7682c52e1e7e276363827b1a
  metricsProvider:
    enabled: false
    useDatadogMetrics: false
  admissionController:
    enabled: true
    mutateUnlabelled: false
  tokenExistingSecret: must-use-secret-postrenderer
  rbac:
    create: true
    serviceAccountAnnotations:
      eks.amazonaws.com/role-arn: arn:aws:iam::111122223333:role/datadog-cluster-agent-secrets
  env: *id001
agents:
  image:
    tag: 7.83.1
    digest: sha256:ed0bd588e955d82f661d1b8dd1cdf179c1023e74a2817e7a812c99d52f05c319
  rbac:
    create: true
    serviceAccountAnnotations:
      eks.amazonaws.com/role-arn: arn:aws:iam::111122223333:role/datadog-agent-secrets
Los únicos valores de entorno relacionados con credenciales después del postrenderizado son ENC[observability/datadog;api-key] y ENC[observability/datadog;cluster-token]. DD_SECRET_BACKEND_TYPE/CONFIG solo contienen el tipo de backend y la región. Ningún shell exporta un valor resuelto, no se coloca ninguna clave real en los valores de Helm y el perfil no necesita un Secret de credenciales de Kubernetes. Los dos contenedores init-volume solo copian la configuración de la imagen; init-config usa el controlador de clave de API para su comprobación de arranque. La autorización real del backend nativo y la ingesta de Datadog aún requieren verificación en tiempo de ejecución.
La actualización programada y por error de API de secrets está explícitamente deshabilitada. Rote mediante un reinicio coordinado aprobado de los Pods de nodo/trace y Cluster Agent; mantenga una clave de API antigua válida hasta que la flota use la nueva clave. Un cambio de cluster-token puede interrumpir la autenticación de node/Cluster Agent durante el despliegue de versión mixta, así que planifique una ventana de mantenimiento o una transición validada por separado. No se afirma una rotación sin tiempo de inactividad. Consulte backends de secrets de Datadog.
processAgent.enabled está obsoleto; use las opciones de recopilación individuales. El chart ya monta /etc/passwd cuando corresponde, así que no agregue volúmenes/montajes manuales passwd duplicados. Las anulaciones de recursos son por componente, como agents.containers.agent.resources; dimensione los contenedores realmente renderizados bajo carga. Dos réplicas de Cluster Agent no sustituyen las pruebas de colocación, interrupción y fallos.
Las entradas originales de nivel superior kubeStateMetricsEnabled y prometheus.enabled no configuran las integraciones indicadas. La opción KSM heredada está anidada en datadog; el ejemplo usa datadog.kubeStateMetricsCore.enabled y evita la recopilación heredada duplicada. Las comprobaciones explícitas de Datadog Autodiscovery son independientes de habilitar el discovery prometheusScrape para todas las anotaciones.
datadog.profiling.enabled es válido. Inserta DD_PROFILING_ENABLED en Pods aptos y requiere bibliotecas de cliente instaladas y Cluster Agent 7.57+. No instala un profiler en una aplicación arbitraria sin instrumentar. Elija deliberadamente su comportamiento null/false/auto/true. De forma similar, habilitar métricas HPA externas requiere su clave de aplicación, permisos de API, service/CRDs y disponibilidad real de métricas; la monitorización de red requiere acceso compatible a system-probe.
La integración de la cuenta AWS es una ruta independiente
La integración SaaS de cuenta AWS usa un rol autorizado entre cuentas y un ID externo proporcionado por Datadog, con los permisos necesarios para las integraciones seleccionadas. Un rol IRSA arbitrario asociado a un Agent SA de nodo no configura esa integración SaaS. La recopilación ordinaria de Kubernetes Agent no requiere la amplia política de CloudWatch/EC2/tags mostrada anteriormente aquí.
Use Pod Identity o IRSA solo para un Agent/check que realmente llame a AWS, con su rol, confianza y permisos específicos. Resuelva el nombre de ServiceAccount renderizado; crear una asociación IAM para un SA datadog-agent supuesto no vincula un SA diferente usado por la versión de Helm. Nunca trate una comprobación local del llamador STS como prueba de la identidad de la carga de trabajo.
Infrastructure Monitoring
Compruebe el recopilador, la unidad y los tags de la métrica
| Métrica / fuente | Significado |
|---|---|
system.cpu.idle / comprobación System | Porcentaje de CPU inactiva; adecuado para un umbral de nodo basado en porcentaje |
system.mem.total, system.mem.used, system.mem.free | Mediciones de memoria; libre no es intercambiable con memoria utilizable/reclamable |
kubernetes.cpu.usage.total / Kubelet | Nanocores, no porcentaje; un core equivale a 1,000,000,000 nanocores |
kubernetes.memory.usage, kubernetes.memory.limits | Bytes; el uso frente al límite requiere coincidir con la misma entidad/conjunto de tags |
kubernetes.pods.running, kubernetes.containers.restarts | Gauges válidos de Kubelet: Pods en ejecución y reinicios acumulados de contenedores |
kubernetes_state.deployment.replicas_available, kubernetes_state.deployment.replicas_desired | Estado de Deployment de Kubernetes State Metrics Core |
kubernetes_state.pod.status_phase, kubernetes_state.service.count | Inventario de fase de Pod/service; inspeccione sus tags de agrupación documentados |
kubernetes_state.container.restarts | Gauge de reinicio de State Core, con tags namespace/pod/container |
La integración heredada de Kubernetes, la comprobación de Kubelet y State Core tienen catálogos diferentes. Una métrica ausente de un catálogo no necesariamente se eliminó del Agent. No cambie el nombre de métricas válidas de Kubelet a ciegas. La disponibilidad de filesystem/network y las unidades de rate dependen del recopilador/tiempo de ejecución; lea la definición real de esa métrica.
Use el tag estándar kube_cluster_name para esta instalación de Kubernetes e inspeccione los tags reales de métricas antes de agrupar. Las métricas State Core centradas en el clúster no siempre incluyen un tag host. cluster_name y kube_cluster_name no son intercambiables. Un valor nanocore sin procesar comparado con 80 no significa 80% de CPU.
OpenMetrics Autodiscovery
Combine el siguiente fragmento de metadata en una carga de trabajo cuyo contenedor se denomine app y sirva el gauge queue_depth en el puerto 9464. No crea esa aplicación ni endpoint. El identificador de contenedor de la anotación debe coincidir. Proteja el endpoint y configure TLS/autenticación si es necesario.
metadata:
  annotations:
    ad.datadoghq.com/app.checks: "{\n  \"openmetrics\": {\n    \"init_config\": {},\n\
      \    \"instances\": [\n      {\n        \"openmetrics_endpoint\": \"http://%%host%%:9464/metrics\"\
      ,\n        \"namespace\": \"my_app\",\n        \"metrics\": [\n          {\n\
      \            \"queue_depth\": \"queue_depth\"\n          }\n        ]\n    \
      \  }\n    ]\n  }\n}"
La comprobación actual openmetrics usa openmetrics_endpoint. Estas anotaciones de Datadog Autodiscovery no requieren un servidor Prometheus independiente ni el discovery amplio prometheusScrape del chart. Restrinja las métricas/labels seleccionadas. Para counters e histograms, verifique la normalización de nombres, las series .count/bucket emitidas y el comportamiento de versión de la comprobación en vez de asumir que el nombre de Prometheus también es el nombre final de Datadog.
DogStatsD: use un endpoint alcanzable desde la aplicación
El localhost de un Pod de aplicación no es el Agent de nodo. El ejemplo de Linux usa el directorio UDS local del host. El modo socket de Admission Controller puede insertar DD_DOGSTATSD_URL, DD_TRACE_AGENT_URL y el volumen; de lo contrario, configure los montajes y permisos coincidentes explícitamente. Un admission.datadoghq.com/config.mode específico de Pod es una label, no una anotación. Monte el directorio principal para que el reemplazo del socket después de un reinicio de Agent siga siendo visible.
El helper de Python se comprobó con datadog==0.53.0. Pase la ruta real del filesystem, como /var/run/datadog/dsd.socket, a socket_path; la URL unix:// usada por otros SDKs/configuraciones de entorno no tiene el mismo formato de argumento. Llame a emit_batch con conteos reales de intervalo, incluidos valores cero de good/error.
from datadog import DogStatsd


def emit_batch(client, total, errors):
    """Report one real interval; send zeros instead of omitting counters."""
    if any(isinstance(x, bool) or not isinstance(x, int) for x in (total, errors)):
        raise ValueError("counts must be integers")
    if not 0 <= errors <= total:
        raise ValueError("require 0 <= errors <= total")
    client.increment("requests.total", total)
    client.increment("requests.error", errors)
    client.increment("requests.good", total - errors)


# Create once in an application with the Agent's UDS directory mounted.
# This construction does not mean that the socket or receiving Agent is ready.
def make_metrics_client(socket_path):
    return DogStatsd(
        socket_path=socket_path,
        namespace="my_app",
        constant_tags=["env:demo", "service:orders"],
        disable_telemetry=True,
        disable_buffering=True,
    )
El helper de Go usa datadog-go/v5. Cree el cliente con WithNamespace("my_app.") y los mismos tags env:demo,service:orders. Compruebe los errores de constructor, envío y cierre; no descarte el error de statsd.New. El helper no cierra un cliente compartido proporcionado por quien llama.
package metrics

import (
    "fmt"

    "github.com/DataDog/datadog-go/v5/statsd"
)

// The caller creates/reuses the client, checks New's error, and closes it at shutdown.
// For the Linux UDS example, use unix:///var/run/datadog/dsd.socket.
func EmitBatch(client *statsd.Client, total, errors int64) error {
    if errors < 0 || total < errors {
        return fmt.Errorf("require 0 <= errors <= total")
    }
    for _, item := range []struct {
        name string
        value int64
    }{
        {"requests.total", total},
        {"requests.error", errors},
        {"requests.good", total - errors},
    } {
        if err := client.Count(item.name, item.value, nil, 1); err != nil {
            return err
        }
    }
    return nil
}| Tipo DogStatsD | Interpretación |
|---|---|
| Counter | Conteo de intervalo; Datadog puede almacenarlo como rate. .as_count() reconstruye conteos para una ventana de consulta |
| Gauge | Instantánea como profundidad de cola; sumar instantáneas no es un conteo de solicitudes procesadas |
| Histogram | Agregado por el Agent receptor; promediar percentiles por host no crea un percentil global |
| Distribution | Admite agregación de distribución de backend; revise percentiles habilitados, tags y facturación |
| Service check | Estado de una comprobación de salud real: 0 OK, 1 advertencia, 2 crítico, 3 desconocido |
La entrega local de datagramas no confirma la ingesta SaaS. UDP puede perder paquetes; UDS/buffering del cliente y las colas de Agent también necesitan monitorización. El helper de muestra no habilita la telemetría del cliente DogStatsD, así que elija una señal independiente de estado de recopilación para el despliegue. Los reintentos de counter/envíos duplicados no constituyen un libro de negocio de exactamente una vez.
Configuración de Autodiscovery basada en archivos
Para configuración gestionada por Helm, datadog.confd crea y monta los archivos de comprobación. Un ConfigMap independiente llamado datadog-checks no se descubre automáticamente solo porque exista. El siguiente fragmento NGINX requiere una identidad de imagen coincidente y un endpoint stub_status configurado y autorizado.
datadog:
  confd:
    nginx.yaml: "ad_identifiers:\n  - nginx\ninit_config: {}\ninstances:\n  - nginx_status_url:\
      \ http://%%host%%:80/nginx_status\n"
Una comprobación Redis autenticada necesita además el puerto/TLS y la entrega de credenciales correctos. %%env_REDIS_PASSWORD%% lee el entorno del Agent, no el entorno del Pod de aplicación Redis. Prefiera un backend de secrets Datadog configurado o la entrega de archivos protegidos con los permisos específicos que necesita; no exponga contraseñas en ejemplos públicos de comprobación ni conceda lecturas de Secret en todo el clúster solo para discovery.
APM y Distributed Tracing
La inyección local de SDK y SSI son decisiones explícitas
La label de opt-in de admission permite la mutación/inyección de configuración de conexión. Para instalar una biblioteca de tracing, configure objetivos SSI o una anotación de lenguaje/versión compatible. La label por sí sola no demuestra que se instaló un SDK ni que los traces llegaron a Datadog. La inyección local de Java/Python/Node.js requiere Cluster Agent 7.40+; .NET/Ruby requiere 7.44+. Cluster Agent 7.83.1 (la versión fijada en esta guía) también excluye kube-system y su propio namespace de la inyección.
Para un ejemplo Java controlado, combine el siguiente fragmento de pod-template en un Deployment existente de un namespace de aplicación, conservando su selector, contenedores y configuración de seguridad. No es un Deployment completo para aplicar por sí solo. La imagen init de Java gcr.io/datadoghq/dd-lib-java-init:v1.66.0 se verificó para Linux amd64/arm64. Verifique la compatibilidad real de JVM/framework/imagen de la aplicación.
spec:
  template:
    metadata:
      labels:
        admission.datadoghq.com/enabled: 'true'
        admission.datadoghq.com/config.mode: socket
        tags.datadoghq.com/env: demo
        tags.datadoghq.com/service: orders
        tags.datadoghq.com/version: 1.0.0
      annotations:
        admission.datadoghq.com/java-lib.version: v1.66.0
Las labels tags.datadoghq.com/* proporcionan etiquetado unificado de service/environment/version. No coloque la label solo en los metadata de Deployment y espere que sus Pods la hereden. La inyección ocurre cuando se admiten nuevos Pods. Confirme los contenedores init insertados, los archivos de biblioteca, montajes/permisos UDS y los ajustes de conectividad no secretos, y después verifique el tráfico/traces reales. Las exclusiones de namespace, los fallos de webhook, las políticas de seguridad y las imágenes no compatibles pueden impedir la instrumentación.
SSI en todo el clúster es una alternativa configurada mediante datadog.apm.instrumentation, con objetivos de namespace/pod y versiones de bibliotecas revisados. Evite combinar tracers manuales e inyectados involuntariamente: una biblioteca inyectada puede tener prioridad sobre una instalada manualmente. La habilitación de profiler sigue requiriendo una biblioteca de cliente compatible y sus propias condiciones de producto/tiempo de ejecución.
Instrumentación Java manual
Use un dd-java-agent.jar por etapas y versionado al iniciar la JVM de la aplicación, o la ruta de inyección validada anterior. Agregar solamente dd-trace-api da acceso a la anotación/API; no inicia instrumentación de bytecode en tiempo de ejecución. La dependencia Maven siguiente y el código fuente Java son archivos independientes.
<dependency>
  <groupId>com.datadoghq</groupId>
  <artifactId>dd-trace-api</artifactId>
  <version>1.66.0</version>
</dependency>import java.util.function.Supplier;
import datadog.trace.api.Trace;
public final class TraceMethods {
private TraceMethods() {}
@Trace(operationName = "order.process", resourceName = "process_order")
public static <T> T process(Supplier<T> handler) {
return handler.get();
}
}El handler representa código de aplicación proporcionado por quien llama. Use nombres acotados de operación/recurso. Los tags de identificador por pedido/cliente del ejemplo antiguo son innecesarios para esta demostración y pueden crear riesgos de divulgación/cardinalidad. Las APIs de span manuales requieren su bridge/biblioteca compatible correspondiente; no agregue importaciones OpenTracing a un proyecto que solo tiene la API de anotación.
Instrumentación Python manual
Use la importación actual ddtrace.trace para este ejemplo comprobado 4.14.0. Mantenga la declaración de dependencia en requirements.txt, no dentro de un bloque de código Python. Para la auto-instrumentación de framework, siga la configuración seleccionada de ddtrace-run/SSI antes de las importaciones de aplicación; no suponga que este helper aplica patches a un framework completo.
ddtrace==4.14.0from ddtrace.trace import tracer
def process_order(handler):
with tracer.trace("order.process", service="orders", resource="process_order") as span:
span.set_tag("operation.kind", "order")
return handler()El decorador equivalente tracer.wrap está disponible para tracing de métodos. Las excepciones del handler deben propagarse; registrar un span no es un reintento de aplicación ni una garantía de éxito. Use tags de service/env/version correctos y propagación de contexto a través de integraciones HTTP/message compatibles. Los mapas de servicios provienen de relaciones instrumentadas observadas, no solo de DD_TAGS arbitrarios.
No etiquete identificadores sin procesar de cliente/pedido, tokens ni cuerpos de solicitud de forma predeterminada. Revise la captura de instrumentación, los mensajes de error y las reglas de muestreo/enmascaramiento para la aplicación real. La auto-instrumentación no garantiza la eliminación completa de PII.
Log Management
Seleccione deliberadamente la recopilación y el parsing
La instalación habilita la recopilación de logs, pero deja containerCollectAll: false. Combine estos metadata en el template de Pod para el contenedor llamado app. La regla multiline se aplica a registros Java de texto sin formato que comienzan con una fecha. No es un parser general de logs JSON. El framing de runtime de contenedor y el parsing de mensajes de aplicación son etapas independientes; verifique los registros recopilados reales.
metadata:
  annotations:
    ad.datadoghq.com/app.logs: "[\n  {\n    \"source\": \"java\",\n    \"service\"\
      : \"orders\",\n    \"log_processing_rules\": [\n      {\n        \"type\": \"\
      multi_line\",\n        \"name\": \"java_timestamp_start\",\n        \"pattern\"\
      : \"^\\\\d{4}-\\\\d{2}-\\\\d{2}\"\n      }\n    ]\n  }\n]"
Para aplicaciones de un evento JSON por línea, use la ruta JSON compatible en lugar de unir eventos JSON no relacionados con esta regla. El acceso a archivos, las rutas de runtime, la coincidencia de anotaciones, la configuración de exclusión y los filtros de pipeline de backend afectan la recopilación. Compruebe la recopilación selectiva tanto con una aplicación coincidente como con una excluida.
Estructura de solicitud de pipeline
Esta solicitud usa los campos reales de API match_rules y support_rules. Los antiguos campos camelCase no eran el modelo de Logs API. El mensaje de muestra define el formato de línea esperado; use el formato/zona horaria reales de la aplicación y pruebe casos sin coincidencia/multiline/error. Un modelo de solicitud válido no demuestra parsing Grok ni ingesta/indexación en un tenant de Datadog.
{
  "name": "Java application logs",
  "is_enabled": true,
  "filter": {
    "query": "source:java service:orders"
  },
  "processors": [
    {
      "type": "grok-parser",
      "name": "Parse the documented Java line format",
      "is_enabled": true,
      "source": "message",
      "samples": [
        "2026-09-13 12:00:00,123 INFO [main] example.Service - completed"
      ],
      "grok": {
        "support_rules": "",
        "match_rules": "java_log %{date(\"yyyy-MM-dd HH:mm:ss,SSS\"):timestamp} %{word:level} \\[%{notSpace:thread}\\] %{notSpace:logger} - %{data:message}"
      }
    },
    {
      "type": "status-remapper",
      "name": "Use level as status",
      "is_enabled": true,
      "sources": [
        "level"
      ]
    },
    {
      "type": "date-remapper",
      "name": "Use parsed timestamp",
      "is_enabled": true,
      "sources": [
        "timestamp"
      ]
    }
  ]
}
La creación/reordenación de pipelines cambia el procesamiento para logs coincidentes. Configúrelo bajo el sitio correcto, permisos de API con alcance limitado y propiedad de pipeline existente. No se envió ninguna solicitud de pipeline durante esta auditoría.
Correlación trace-log y propiedad de MDC
Use la inyección automática de logs compatible cuando sea posible y preserve los ID de trace/span como cadenas en logs estructurados. También son necesarios service/env/version correctos, timestamps, parsing y datos de trace disponibles; dos campos de ID por sí solos no garantizan la correlación. No hay un ID de trace activo útil cuando un proceso no se ha instrumentado.
Para aplicaciones que administran explícitamente SLF4J MDC, este helper restaura el contexto anterior completo de quien llama tanto en éxito como en fallo. El anterior MDC.clear() incondicional perdía campos no relacionados de quien llama. Es un helper síncrono, no un mecanismo de propagación de contexto async ni un filtro servlet completo.
import java.util.Map;
import java.util.function.Supplier;
import datadog.trace.api.CorrelationIdentifier;
import org.slf4j.MDC;

public final class TraceLogContext {
    private TraceLogContext() {}

    public static <T> T withTraceContext(Supplier<T> handler) {
        Map<String, String> previous = MDC.getCopyOfContextMap();
        try {
            MDC.put("dd.trace_id", CorrelationIdentifier.getTraceId());
            MDC.put("dd.span_id", CorrelationIdentifier.getSpanId());
            return handler.get();
        } finally {
            if (previous == null) {
                MDC.clear();
            } else {
                MDC.setContextMap(previous);
            }
        }
    }
}
Requiere dd-trace-api y la API/proveedor SLF4J compatible de la aplicación. El patrón de logging o el encoder JSON debe incluir los valores MDC. No copie un ejemplo servlet sin la API servlet, las importaciones y el contrato de excepciones comprobado.
Dashboards y alertas
Construcción de solicitudes de dashboard
Este helper usa datadog-api-client==2.60.0 para construir un cuerpo de solicitud. Las variables de template de clúster y namespace se referencian realmente mediante sus consultas. El widget de host usa una métrica de porcentaje; el widget de Pod usa bytes de memoria y su filtro de namespace. Compruebe que los datos seleccionados realmente tengan los tags de agrupación.
from datadog_api_client.v1.model.dashboard import Dashboard
from datadog_api_client.v1.model.dashboard_layout_type import DashboardLayoutType


def build_dashboard(cluster_name):
    return Dashboard(
        title="EKS observability example",
        layout_type=DashboardLayoutType.ORDERED,
        widgets=[
            {"definition": {
                "type": "timeseries",
                "title": "CPU idle by host (%)",
                "requests": [{"q": "avg:system.cpu.idle{$cluster} by {host}", "display_type": "line"}],
            }},
            {"definition": {
                "type": "toplist",
                "title": "Top 10 pod memory series by mean (bytes)",
                "requests": [{"q": "top(sum:kubernetes.memory.usage{$cluster,$namespace} by {pod_name,kube_namespace}, 10, 'mean', 'desc')"}],
            }},
        ],
        template_variables=[
            {"name": "cluster", "prefix": "kube_cluster_name", "default": cluster_name},
            {"name": "namespace", "prefix": "kube_namespace", "default": "*"},
        ],
    )
Quien llama proporciona un ApiClient configurado correctamente y usa DashboardsApi para crear o actualizar el dashboard previsto. Registre/reconcilie su ID devuelto; la creación repetida por título puede crear duplicados. El sitio y las credenciales de automatización con alcance limitado son independientes de la clave de API del node Agent. No se llamó a ninguna API de dashboard en esta auditoría.
Consultas y unidades de monitor
Use un proveedor Datadog Terraform configurado y restricciones de versión/archivo de bloqueo del proyecto. Estos son fragmentos de recursos, no una configuración completa de proveedor/credenciales. Los umbrales son ejemplos; inspeccione las unidades de métricas, tags, ventanas y objetivos de aplicación reales. El primer monitor evalúa directamente el porcentaje idle en vez de comparar nanocores con 80 y llamar al resultado “porcentaje de CPU”.
# Fragments for a configured, version-pinned Datadog Terraform provider.
# Replace notification destinations with approved, tested destinations.
resource "datadog_monitor" "low_cpu_idle" {
  name    = "Low CPU idle on EKS nodes"
  type    = "metric alert"
  message = "CPU idle on {{host.name}} is {{value}}%. Inspect the host and collection health."
  query   = "avg(last_5m):avg:system.cpu.idle{kube_cluster_name:my-eks-cluster} by {host} < 20"
  monitor_thresholds {
    warning  = 30
    critical = 20
  }
  require_full_window = false
  notify_no_data      = false
  tags               = ["env:demo", "team:platform"]
}

resource "datadog_monitor" "restart_total" {
  name    = "Container restart total exceeds example threshold"
  type    = "metric alert"
  message = "Inspect {{pod_name.name}} / {{kube_container_name.name}}. This is a restart total, not a count of new restarts in five minutes."
  query   = "max(last_5m):max:kubernetes_state.container.restarts{kube_cluster_name:my-eks-cluster} by {pod_name,kube_namespace,kube_container_name} > 3"
  monitor_thresholds {
    warning  = 2
    critical = 3
  }
  require_full_window = false
  notify_no_data      = false
  tags               = ["env:demo", "team:platform"]
}

resource "datadog_monitor" "request_error_rate" {
  name    = "High request error ratio"
  type    = "metric alert"
  message = "Error ratio for {{service.name}} is {{value}}%. Check traffic volume and the reporting path."
  query   = "sum(last_5m):sum:my_app.requests.error{env:demo} by {service}.as_count() / sum:my_app.requests.total{env:demo} by {service}.as_count() * 100 > 5"
  monitor_thresholds {
    warning  = 2
    critical = 5
  }
  require_full_window = false
  notify_no_data      = false
  tags               = ["env:demo", "type:application"]
}
El gauge de reinicio es un total. Comparar sumas de muestras repetidas de gauge en dos ventanas no cuenta nuevos reinicios de forma fiable, especialmente con resets, Pods de reemplazo o muestreo desigual. Un monitor de reinicio reciente necesita un diseño validado de delta/reset. Este ejemplo alerta explícitamente sobre un total en su lugar.
El monitor de errores usa los tres counters emitidos por emit_batch, incluidos valores cero explícitos para solicitudes error/good. Para la evaluación .as_count(), la agregación temporal ocurre antes de la división: sum(errors)/sum(total), en lugar de una suma de la proporción de cada bucket de tiempo. Use un agregador sum con esta ruta.
Tráfico cero, telemetría ausente y tráfico realmente libre de errores son diferentes. Defina condiciones mínimas de tráfico/estado de recopilación y valide el comportamiento de ausencia de datos del monitor. notify_no_data: false no establece el estado; simplemente no notifica sobre datos faltantes en estos fragmentos.
Para métricas APM integradas, use los nombres y tags reales trace.<operation>.hits/errors generados por la integración elegida. Las integraciones Java, Python y otras no emiten todas trace.http.request.*. Trace analytics, métricas de trace generadas y métricas DogStatsD personalizadas son fuentes distintas.
Watchdog y entrega de notificaciones
Watchdog puede revelar anomalías/insights detectados sin elegir manualmente cada umbral. Un insight no prueba que se entregó una notificación. Use el flujo de trabajo compatible de Watchdog/monitor y verifique la fuente de evento, la disponibilidad de producto y el enrutamiento de notificaciones en el sitio previsto.
El siguiente fragmento de event-monitor supone que existen eventos reales que coinciden con source:watchdog en esa organización. No inventa un tag de grupo story_category ni garantiza que cada resultado Watchdog aparezca en este stream. Valide el filtro con eventos reales antes de habilitar notificaciones.
resource "datadog_monitor" "watchdog_events" {
  name    = "Review matching Watchdog events"
  type    = "event-v2 alert"
  message = "Review the matching Watchdog event and affected services. Add an approved notification destination."
  query   = "events(\"source:watchdog\").rollup(\"count\").last(\"5m\") > 0"
  tags    = ["env:demo", "type:watchdog"]
}
Construcción de solicitudes de SLO
Los SLO basados en métricas necesitan conteos good/total bien definidos. El helper siguiente usa los counters explícitos anteriores. “Good” debe coincidir con la política SLI de la aplicación; contar solo HTTP 2xx no es una definición universal de disponibilidad. Valide el comportamiento de tráfico cero y datos faltantes en lugar de tratar la ausencia como 100 % de éxito.
from datadog_api_client.v1.model.service_level_objective_request import ServiceLevelObjectiveRequest


def build_success_slo():
    return ServiceLevelObjectiveRequest(
        name="Orders successful-request SLO",
        type="metric",
        description="Successful requests divided by all reported requests",
        query={
            "numerator": "sum:my_app.requests.good{env:demo,service:orders}.as_count()",
            "denominator": "sum:my_app.requests.total{env:demo,service:orders}.as_count()",
        },
        thresholds=[{"timeframe": "30d", "target": 99.9, "warning": 99.95}],
        tags=["env:demo", "service:orders"],
    )
Esto construye una solicitud, no un SLO activo. Quien llama configurado puede pasarlo a ServiceLevelObjectivesApi.create_slo después de verificar propiedad, datos y permisos. Datadog también admite SLO basados en monitor y time-slice; elija el modelo que coincida con el SLI en vez de forzar un total de gauge/reinicio a un conteo de eventos good.
Estructura de costos
Use las unidades reales de producto y contrato
| Componente | Entradas para estimar |
|---|---|
| Infrastructure | Hosts/contenedores facturables o el modelo de plataforma aplicable, plan y términos de compromiso |
| APM | Hosts APM facturables y plan/modelo seleccionado, asignaciones incluidas, spans ingeridos e indexados |
| Logs | Volumen ingerido más opciones de indexación/retención/búsqueda/archive |
| Métricas personalizadas / distributions | Combinaciones distintas de métrica/tag, agregaciones habilitadas y volúmenes incluidos aplicables |
| Productos adicionales | Cargos por profiling, red/seguridad, serverless y otros productos habilitados |
No combine cada producto en una tabla universal Free/Pro/Enterprise. La página de precios distingue productos, términos anuales/bajo demanda y ofertas adjuntas frente a independientes. La retención de métricas de infraestructura, traces consultables e logs indexados no es una configuración común de “15 meses”.
Para el antiguo ejemplo de 100 nodos, 50 services no implican 50 hosts APM. En un acuerdo con precio por host, determine primero los conteos reales de hosts facturables de Infrastructure y APM. Para 100 GB/día durante 30 días, la ingesta de logs es 3,000 GB, pero la ingesta por sí sola no es la factura total de logs.
Estimated cost =
  billable infrastructure units × applicable rate
  + billable APM units × applicable rate
  + ingested/indexed span overages under the contract
  + 3,000 GB × applicable log-ingestion rate
  + indexed events/retention/search/archive charges
  + custom-metric and other enabled-product charges
El total anterior de ~$3,350 usaba unidades APM no coincidentes y omitía dimensiones facturables. No era una factura de producción medida. Use la cotización actual de sitio/producto y el uso medido en vez de tratar esa estimación como una garantía de presupuesto.
Los controles de métricas, logs y trace hacen cosas distintas
dogstatsd.nonLocalTrafficcontrola la accesibilidad del receptor; no es una cuota de métricas personalizadas. Cerrar un receptor puede simplemente perder telemetría.ignoreAutoConfigdeshabilita comprobaciones automáticas seleccionadas. Los filtros de exclusión de contenedor seleccionan contenedores; ninguno es un limitador general de cardinalidad de tags.Revise las métricas y valores de tags permitidos en su propietario de recopilación. Cambiar la cardinalidad de tags de origen puede cambiar los tags de agrupación disponibles, así que vuelva a comprobar monitores/SLOs.
La exclusión de logs en origen evita el envío de registros seleccionados. La exclusión de índice ocurre después y no elimina los costos de ingesta. Conserve la evidencia de incidentes y los fallos; no descarte cada línea de health-check sin importar el resultado.
El muestreo y la indexación/retención son independientes.
DD_TRACE_SAMPLE_RATEo las reglas de muestreo dependen de la biblioteca/versión y del alcance coincidente. El documentadoDD_TRACE_RATE_LIMITde Python es por proceso y se aplica con las reglas/rate de muestreo configuradas, no como un límite de todo el clúster ni de dólares. Una tasa de trace del 10 % no implica una reducción del 90 % en toda la factura de Datadog.
Prácticas recomendadas
Use labels consistentes de service/env/version y tags acotados, con permisos separados de ingesta de clave de API y automatización de clave de aplicación. Revise las rutas de captura de aplicación y enmascaramiento de secrets antes de recopilar todos los logs, argumentos de proceso o profiles. Monitorice las colas/pérdidas del recopilador y verifique las salidas reales después de cambiar filtros.
Acuerde gravedad de alerta, propiedad y objetivos de respuesta con el equipo de operaciones. Las etiquetas P1/P2 en un runbook son una política operativa, no definiciones independientes de recursos Datadog. Pruebe los destinos reales, los datos faltantes y las notificaciones de recuperación. Use un SLI/SLO documentado y el contexto de tráfico en vez de elegir umbrales solo porque aparecen en una muestra.
Solución de problemas
Comience con el propietario de la instalación, los nombres reales de pod/contenedor y el sitio previsto. Compruebe los controladores literales de backend nativo, IRSA de Secrets Manager y el postrenderer requerido, la salud de Agent/Cluster Agent, el acceso Kubelet/RBAC, la configuración de scrape y la telemetría en cola/perdida. El Pod de Agent de nodo renderizado por esta versión tiene contenedores agent y trace-agent; el selector antiguo app=datadog no es un sustituto fiable de inspeccionar las labels actuales.
kubectl get pods -n datadog \
  -l app.kubernetes.io/instance=datadog,app.kubernetes.io/component=agent -o wide

# Select the actual node Agent pod after inspecting the list.
: "${DD_AGENT_POD:?Set the node Agent pod name}"
kubectl exec -n datadog "$DD_AGENT_POD" -c agent -- agent status
kubectl logs -n datadog "$DD_AGENT_POD" -c agent --tail=100
kubectl logs -n datadog "$DD_AGENT_POD" -c trace-agent --tail=100

# Check new application pods without dumping credentials/environment values.
: "${APP_NAMESPACE:?Set the application namespace}"
: "${APP_POD:?Set the application pod name}"
kubectl get pod -n "$APP_NAMESPACE" "$APP_POD" \
  -o jsonpath='{.spec.initContainers[*].image}'
kubectl get pod -n "$APP_NAMESPACE" "$APP_POD" \
  -o jsonpath='{range .spec.containers[*]}{.name}{": "}{.env[*].name}{"\n"}{end}'

# Create a local diagnostic archive only; review it before any authorized sharing.
kubectl exec -n datadog "$DD_AGENT_POD" -c agent -- agent flare --local
Para traces, verifique la inyección/inicio real de biblioteca, el socket o endpoint de host, los permisos y tags consistentes. Una comprobación TCP exitosa no valida una ruta UDS ni prueba cargas útiles de trace aceptadas. No use env | grep DD_: puede divulgar claves de API/aplicación o credenciales de proxy.
Para logs, inspeccione el identificador real de anotación/contenedor y el acceso a archivos, luego las exclusiones de recopilación, el parsing y los filtros de índice. agent configcheck, status, logs y archives pueden exponer datos de configuración o aplicación; inspeccione/enmascare las salidas antes de compartirlas.
agent flare --local crea un bundle local para inspección. La carga o recopilación remota de flare es una acción de soporte autorizada independiente. El enmascaramiento incorporado es útil, pero no sustituye revisar el archive para los datos recopilados por su aplicación.
Alcance de validación
La auditoría usó renderizado de chart e inspección de schema/source oficiales, datagramas Unix DogStatsD locales, spans manuales ddtrace 4.14.0 en Python 3.12 con export/telemetry deshabilitados, compilación de dd-trace-api 1.66.0 para Java 17 y pruebas MDC síncronas, y modelos/serialización de solicitudes de cliente API 2.60.0. Estas comprobaciones no llamaron a un tenant de Datadog, instalaron en EKS, ejecutaron un webhook de admission, enviaron traces/logs a SaaS, crearon dashboards/monitors/ SLOs ni midieron costos.
El significado de las consultas de monitor se comprobó con las unidades de métricas documentadas y las reglas de agregación; no se invocó ningún motor de consulta de Datadog ni plan de proveedor Terraform. El schema de solicitud Grok es distinto del parsing activo. Las aplicaciones, credenciales, tráfico, soporte de runtime y propiedad de destino siguen siendo requisitos previos de despliegue.
Referencias
- Instalación de Kubernetes y requisitos previos de versión
- Helm chart 3.244.0
- Versión Agent 7.83.1
- Distribuciones Kubernetes
- Métricas Kubelet
- Kubernetes State Metrics Core
- Métricas System
- Integración de cuenta AWS
- Admission Controller
- Inyección SDK local
- OpenMetrics en Kubernetes
- DogStatsD UDS
- Configuración de tracing Python
- Instrumentación personalizada
- Parsing de logs
- Evaluación de monitor as_count
- SLO basados en métricas
- Preguntas frecuentes sobre precios y facturación de Datadog
- Gestión de Agent flare