Parte 6: Análisis de trazabilidad distribuida
Dificultad: Avanzada · Tiempo estimado: 45 minutos Última actualización: September 13, 2026
Sigue una solicitud real desde las métricas, pasando por un exemplar, hasta su traza y logs, separando las observaciones de las hipótesis causales. Esto requiere la ruta de ingesta de la Parte 2 y la propagación de contexto de la Parte 3. El TraceQL a continuación se verificó con el analizador real de Tempo 3.0.3 y utiliza atributos OTel actuales.
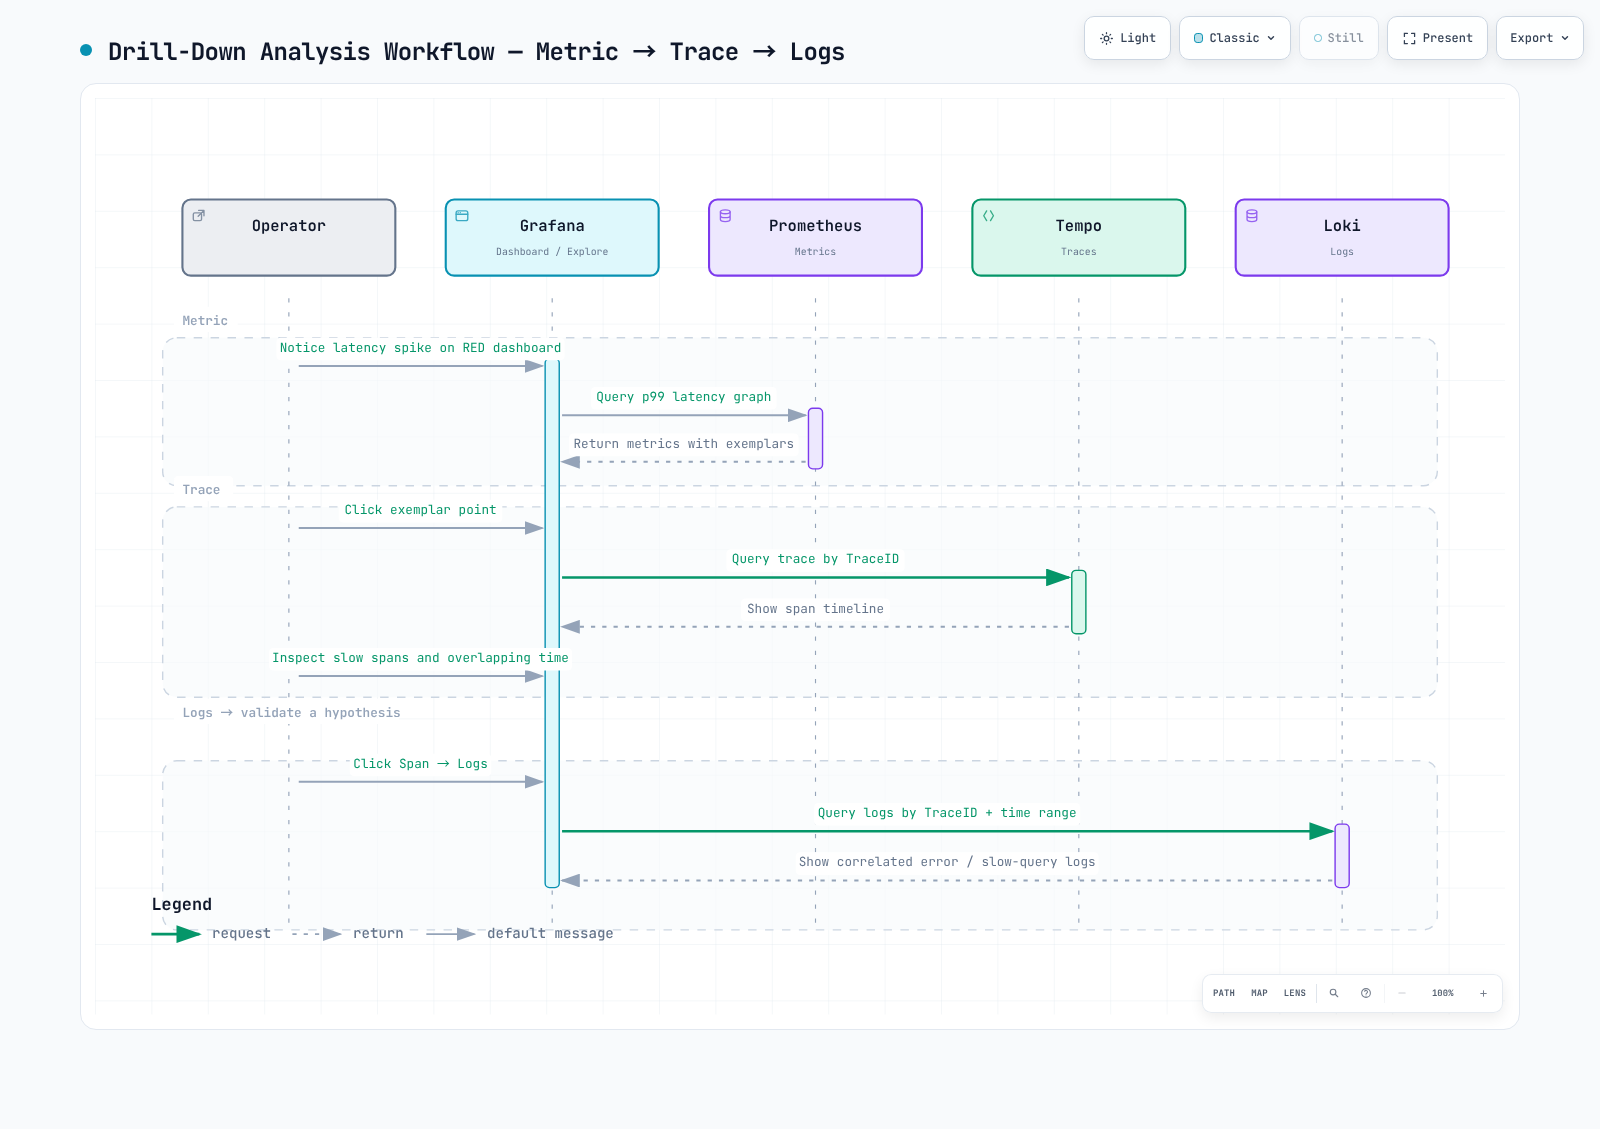
1. Búsqueda en TraceQL
{ resource.service.name = "order-service" && span:duration > 1s }

{ trace:duration > 2s && resource.service.name = "order-service" }

{ span:kind = server && span.http.response.status_code >= 500 }

{ span.db.system.name = "postgresql" && span:duration > 100ms }

{ span.messaging.system = "aws_sqs" && span.messaging.operation.type = "send" }

{ resource.service.name = "api-gateway" } >> { resource.service.name = "order-service" }

{ resource.service.name = "order-service" } >> { span.db.system.name = "postgresql" }

{ span:status = error } | select(resource.service.name, span.http.response.status_code, span:duration)
span:duration mide un span individual; trace:duration mide toda la traza. Usa span: para intrínsecos explícitos y span./resource. para atributos. >> encuentra spans del lado derecho que descienden de spans del lado izquierdo. Buscar descendientes de un span de DB es diferente de encontrar trabajo de DB bajo un servicio.
sort(duration), SQL order by, | limit 20 y { duration > p99 } no pertenecen a esta sintaxis de búsqueda. Configura el orden de los resultados, el límite de búsqueda y el intervalo de tiempo en Grafana, y sustituye un p99 medido por un literal de duración como 800ms. select() solicita los atributos que se muestran; no puede recrear spans que nunca se almacenaron.
Los SDK más antiguos pueden emitir http.status_code, http.method, db.system, db.statement o messaging.operation. Inspecciona los spans reales y las versiones de SDK antes de usar los actuales http.response.status_code, http.request.method, db.system.name, db.query.text o messaging.operation.type. Renombrar un atributo de consulta no transforma los datos recopilados. Captura texto de consultas solo bajo una política explícita de sanitización; excluye contraseñas, literales SQL y datos de clientes.
2. Requisitos previos del grafo de servicios
Recibir trazas solo en Tempo no completa el grafo de servicios de Grafana. Habilita el procesador service-graphs de metrics-generator, entrega sus métricas a un backend de métricas real y vincula el UID serviceMap de la fuente de datos Tempo de Grafana a ese backend. Los spans de cliente/servidor o productor/consumidor deben compartir contexto. El muestreo, los spans faltantes y los tipos de span incorrectos afectan las aristas resultantes.
sum by (client, server) (rate(traces_service_graph_request_total[5m]))

(
  sum by (client, server) (rate(traces_service_graph_request_failed_total[5m]))
  or on (client, server)
  (0 * sum by (client, server) (rate(traces_service_graph_request_total[5m])))
)
/ on (client, server)
(sum by (client, server) (rate(traces_service_graph_request_total[5m])) > 0)

sum by (client, server) (rate(traces_service_graph_request_server_seconds_sum[5m]))
/
sum by (client, server) (rate(traces_service_graph_request_server_seconds_count[5m]))
El contador de fallos puede no tener ninguna serie hasta el primer fallo. Completa su numerador faltante con cero a partir de la serie request-total correspondiente y luego exige un denominador positivo para distinguir un 0 % saludable de la ausencia de tráfico o de ingesta faltante.
La última consulta mide la duración media del lado del servidor. La duración del lado del cliente usa traces_service_graph_request_client_seconds_*; no consultes la familia inexistente traces_service_graph_request_duration_seconds_*. Trata los intervalos sin tráfico como evidencia faltante. Los colores y los anchos de las aristas dependen de la configuración de Grafana/dashboard; inspecciona los valores de solicitud/error/duración en lugar de asumir reglas fijas de color de 1 %/5 %.
3. Formula hipótesis de cuellos de botella a partir de la cascada
| Observación | Seguimiento |
|---|---|
| Span de DB lento | Comprueba el plan de consulta, bloqueos, el pool de conexiones y las métricas de DB |
| Span de cliente largo | Compara los intervalos de espera/reintento de DNS/TLS/red/servidor |
| Brecha entre padre e hijo | Comprueba trabajo sin instrumentar, colas, GC y planificación |
| Spans hijos paralelos | Analiza la superposición y la ruta crítica en lugar de sumar las duraciones |
| Retraso de mensajería | Separa la duración de envío/recepción/procesamiento de la espera en cola y la reentrega |
La duración del padre incluye la duración de los hijos; sumar todos los spans cuenta el tiempo dos veces. Un span de DB de 1,8 segundos por sí solo no demuestra que falte un índice. Compara logs y métricas en la misma versión, tráfico e intervalo de tiempo antes de aceptar una hipótesis.
4. Vincula logs y trazas
{service_name="order-service"} | json | level="ERROR"

{service_name="order-service"} | json | trace_id="0123456789abcdef0123456789abcdef"
Estas consultas suponen una etiqueta de flujo service_name real y un campo JSON trace_id. Sustituye el ID de traza de ejemplo de 32 caracteres por un ID de solicitud real. traceID, traceId y trace_id son campos diferentes. Mantén los ID de traza en campos de log/metadatos estructurados, no en etiquetas de flujo únicas. Establece los límites de tiempo en los parámetros de Grafana/HTTP; no añadas timestamp >= 2025-... a LogQL.
Un campo derivado de Loki extrae el ID de traza y lo vincula al UID de la fuente de datos Tempo. En el YAML de aprovisionamiento de Grafana, escapa la expresión del enlace interno como $${__value.raw}. Las expresiones regulares entre comillas dobles y un envsubst de shell amplio pueden cambiar las barras invertidas o las variables de Grafana; usa comillas simples adecuadas y sustituciones de alcance limitado.
Configura Tempo tracesToLogsV2 con el UID de Loki, el mapeo real de etiquetas de recurso a log, relleno de tiempo y filtrado por ID de traza. Inspecciona el LogQL generado después de hacer clic en “Logs for this span.” La existencia de un enlace y la recuperación exitosa de la misma solicitud son verificaciones independientes.
5. Significado y verificación de exemplar
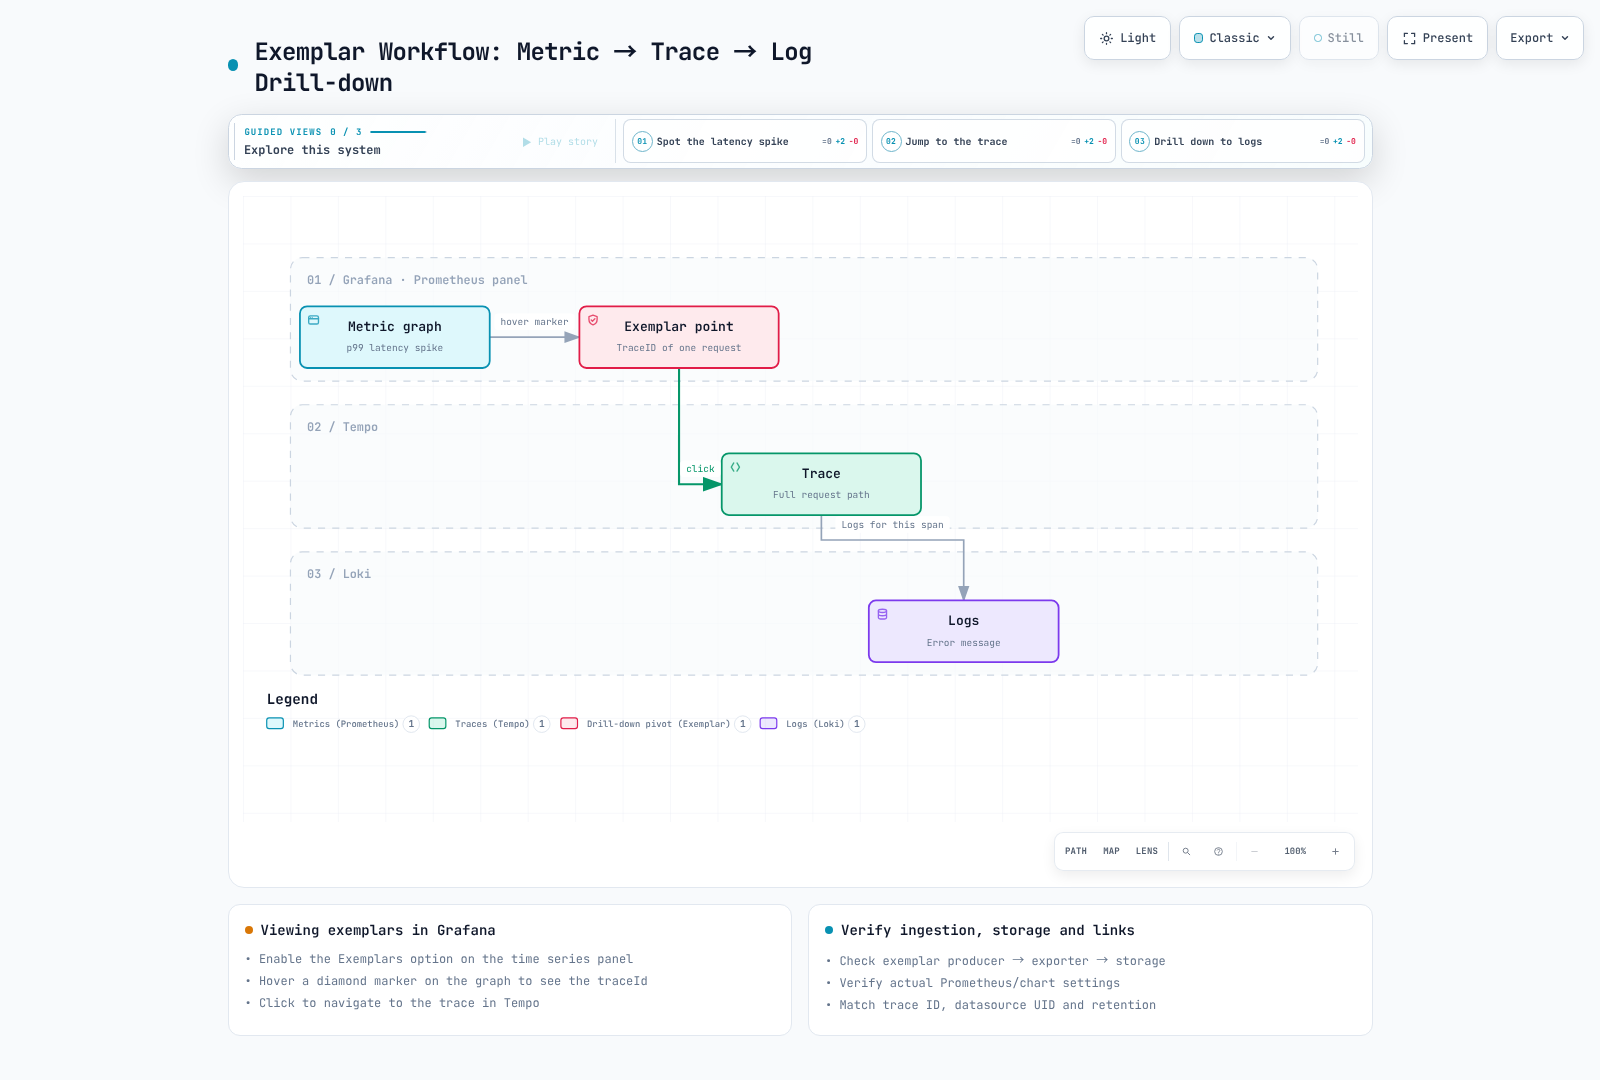
Un exemplar es una observación representativa adjunta a un agregado. Hacer clic en un punto de un gráfico p99 no demuestra que esa solicitud determinara el límite exacto del percentil. La producción de exemplars, la conservación por exporter/remote-write, el almacenamiento de Prometheus y la vinculación de la fuente de datos de Grafana deben funcionar. El muestreo o la retención pueden dejar un ID de exemplar cuya traza no está disponible.
Inspecciona los resultados reales de la API de exemplar de Prometheus y consulta Tempo con el trace_id devuelto. Habilitar una opción de visualización de Grafana o buscar un ConfigMap de Prometheus inexistente no es una validación de ingesta. Confirma la configuración de almacenamiento de exemplars con respecto a la versión instalada de Prometheus/chart y los argumentos del recurso/runtime de Prometheus renderizados.
6. Dashboards RED y SLI/SLO
Crea paneles RED a partir de nombres de métricas, etiquetas y unidades de histogramas reales. Compara la tasa de solicitudes, la proporción de fallos y la distribución de duración en el mismo ámbito de servicio/ruta. Define las solicitudes elegibles y el éxito antes de calcular la disponibilidad; indica cómo se tratan las respuestas 4xx, las comprobaciones de estado y los reintentos.
Un SLO de 30 días requiere retención y observaciones reales durante ese período. Una consulta [30d] en un laboratorio reciente no crea 30 días de evidencia. Gestiona la ausencia de tráfico, las series faltantes y los reinicios de contadores; divulga las limitaciones de percentiles de bajo volumen. Calcula los presupuestos de error usando los fallos permitidos y los fallos observados durante la misma ventana. Registra el período, el denominador y el valor en lugar de afirmar que se logró un “99,9 %” fijo.
7. Verifica el flujo y luego limpia
Antes de la limpieza, registra una solicitud cuyo ID de exemplar, ID de traza de Tempo e ID de traza de log coincidan; verifica las dependencias reales del grafo de servicios y la entrega de alertas. Conserva los valores medidos, las marcas de tiempo y las versiones de configuración en lugar de completar los resultados con estimaciones.
| Orden | Acción y condición de finalización |
|---|---|
| 1 | Detén k6/Locust, la inyección de fallos y los activadores de análisis de IA; guarda los resultados |
| 2 | Detén la recreación de GitOps ApplicationSet/padre y elimina en cascada la aplicación real |
| 3 | Elimina los LoadBalancers/Ingresses, workloads y PVCs del clúster de servicios; verifica la limpieza del LB/volumen externo |
| 4 | Elimina los recursos personalizados de telemetría antes de desinstalar sus operadores usando los nombres reales de release/namespace |
| 5 | Drena/elimina los NodeClaims de Karpenter antes de eliminar el controlador; conserva los controladores de API/LB/almacenamiento mientras existan dependencias |
| 6 | Revisa los planes de destrucción usando el mismo estado de IaC; usa los ID/ARN exactos registrados para los recursos de AWS creados manualmente |
| 7 | Elimina EKS/VPC después de limpiar las dependencias y luego verifica la eliminación de servicios administrados y recursos residuales |
No elimines namespaces compartidos ni CRDs de todo el clúster. Usa el release/namespace/versión de instalación registrado, no una URL de instalador latest. S3 versionado requiere comprobar las versiones antiguas y los marcadores de eliminación, así como los objetos actuales. Concilia la política de snapshots de Aurora, el bucket de MWAA/DAG, AMG, AMP, OpenSearch, SNS/SQS/DLQ, Lambda/API Gateway, las asociaciones de IAM, EBS/LBs, los grupos de logs y las alarmas con tu inventario. Las solicitudes de eliminación aceptadas no son eliminaciones completadas.
Revisa la propiedad de los recursos y conserva la evidencia/el estado en lugar de usar una destrucción con aprobación automática sin comprobar, suprimir todos los errores o eliminar todo el directorio de trabajo.
Alcance de la validación y referencias
El analizador actual de Tempo validó 12 consultas aceptadas y rechazó tres consultas erróneas anteriores. Un Loki local efímero 3.7.7 recibió dos líneas de log sintéticas; ambas consultas de LogQL recuperaron el ID de traza exacto esperado. No se ejecutaron la búsqueda real de Tempo del servicio, la recopilación de Loki, la vinculación de datos de Grafana ni la eliminación en la nube.