Infraestructura de IA en EKS
Última actualización: September 12, 2026 Líneas base: GPU Operator26.7.0 / NVIDIA DRA0.5.0 / Argo Workflows4.1.3 / JupyterHub chart4.4.2 / Mountpoint CSI2.8.0
La infraestructura de IA combina notebooks, pipelines, runtimes distribuidos, dispositivos/nodos, almacenamiento/redes y autorización. Una lista de herramientas o un release de Helm exitoso no establece la seguridad, la disponibilidad ni la ejecución de modelos de la plataforma.
Capas y responsabilidades
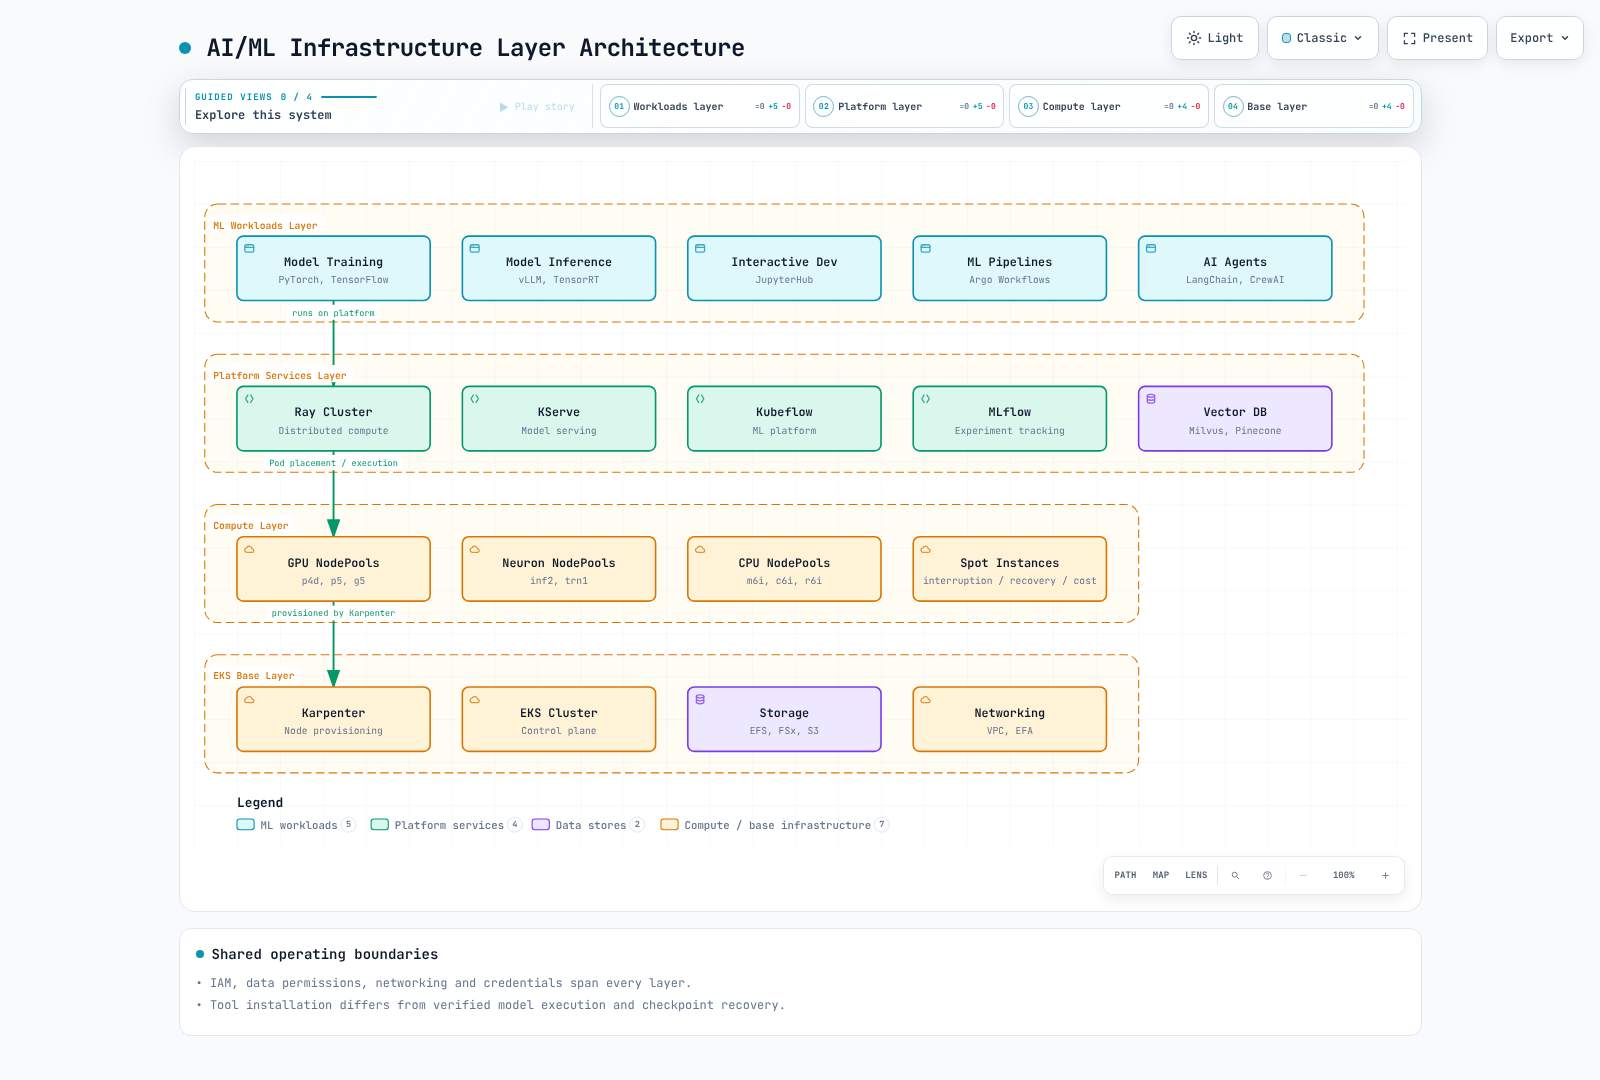
Las cargas de trabajo son dueñas del código de modelo/datos/ejecución; las plataformas son dueñas de los workflows, runtimes y registries; el cómputo es dueño de los dispositivos reales, los Pods y la capacidad de nodo. Las identidades de IAM, redes y almacenamiento atraviesan estas capas. Un NodePool habilitado para Spot no garantiza ni capacidad ni recuperación/ahorro.
Stack JARK
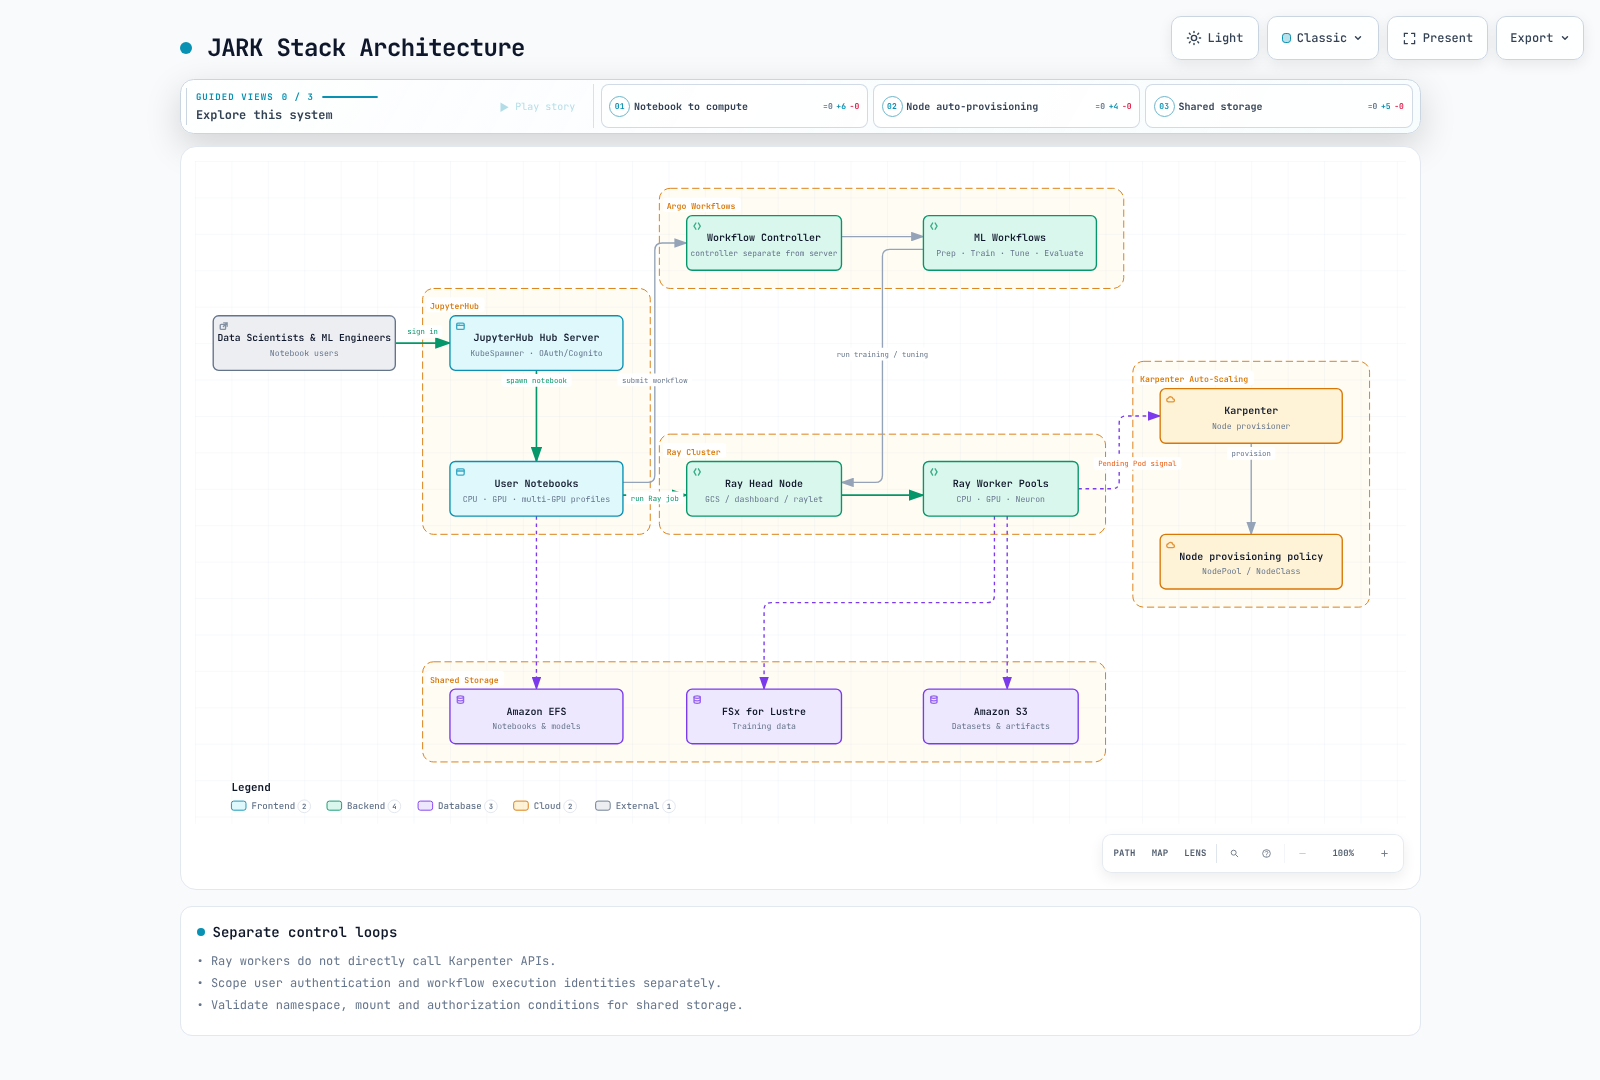
JARK combina JupyterHub, Argo Workflows, Ray y Karpenter. Es un patrón de integración, no un producto único conectado automáticamente. Conecte de forma explícita la autorización de notebooks, el envío de workflows, los jobs de Ray, la planificación (scheduling) de Kubernetes y el provisioning de nodos.
Autenticación de JupyterHub y perfiles de notebook
El chart4.4.2 declara appVersion5.5.2, distinta del Hub6.0.0 más reciente inspeccionado en PyPI. Las comprobaciones locales de la API usaron Hub6.0.0/OAuthenticator17.4.0/KubeSpawner7.1.0; verifique las combinaciones reales de paquetes dentro de la imagen del chart en operación.
Cognito es una de las opciones de proveedor OIDC. Haga coincidir las URLs de callback, los endpoints de token/userInfo, los scopes y un claim de nombre de usuario estable, y configure una política de permitidos explícita. El MFA y la federación corporativa deben configurarse en el proveedor; GenericOAuthenticator no los habilita automáticamente.
Esta configuración del Hub asume un Secret existente montado en /run/secrets/oidc. Mantenga los secretos reales fuera de los ConfigMaps, el código fuente y las variables de entorno. Enlace este archivo Python con la ruta de configuración real del Hub y reemplace las URIs y los valores de sub aprobados según su entorno.
from pathlib import Path

c.JupyterHub.authenticator_class = "oauthenticator.generic.GenericOAuthenticator"
c.GenericOAuthenticator.client_id = "prepared-client-id"
c.GenericOAuthenticator.client_secret = Path("/run/secrets/oidc/client-secret").read_text().strip()
c.GenericOAuthenticator.oauth_callback_url = "https://jupyter.example.com/hub/oauth_callback"
c.GenericOAuthenticator.authorize_url = "https://prepared-domain.auth.us-west-2.amazoncognito.com/oauth2/authorize"
c.GenericOAuthenticator.token_url = "https://prepared-domain.auth.us-west-2.amazoncognito.com/oauth2/token"
c.GenericOAuthenticator.userdata_url = "https://prepared-domain.auth.us-west-2.amazoncognito.com/oauth2/userInfo"
c.GenericOAuthenticator.scope = ["openid", "profile", "email"]
c.GenericOAuthenticator.username_claim = "sub"
c.GenericOAuthenticator.allow_all = False
c.GenericOAuthenticator.allow_existing_users = False
c.GenericOAuthenticator.allowed_users = {"replace-with-approved-cognito-sub"}
El ejemplo establece allow_all=False, un allowed_users explícito y allow_existing_users=False. Las comprobaciones locales permitieron una identidad aprobada y rechazaron usuarios no aprobados o previos. No se ejecutó ningún inicio de sesión OAuth ni intercambio de tokens real.
Distinga entre las garantías (requests) de CPU/RAM del notebook y los límites, y haga coincidir las imágenes, etiquetas, tolerations y drivers de GPU reales. No asuma que las etiquetas antiguas jupyter/*:gpu proporcionan CUDA. Los PVCs deben compartir el namespace del Pod que los consume; un Pod de jupyterhub no puede referenciar un PVC de ml-platform solo por su nombre. Revise los access points por usuario, el UID/GID, las cuotas y los permisos de escritura de modelos compartidos. El storage_capacity de EFS no es un límite de capacidad física.
Flujo de datos de Argo Workflows
El workflow anterior referenciaba templates, artifacts y scripts inexistentes. Este fixture mínimo de flujo de datos tiene seis etapas. Pasa parámetros mediante variables de entorno y JSON en lugar de inyectar valores en el código fuente de Python. Selecciona entre dos coeficientes; no es un pipeline real de entrenamiento de clasificación de imágenes, de cluster Ray ni de registry externo.
El lint offline de Argo4.1.3 y los seis cuerpos de script de Python se validaron localmente. Prepare prepared-workflow-runner con privilegios mínimos y configure los digests de imagen, las cuotas y el almacenamiento de artifacts por separado antes de operar.
apiVersion: argoproj.io/v1alpha1
kind: Workflow
metadata:
  generateName: toy-dataflow-
  namespace: argo
spec:
  entrypoint: pipeline
  serviceAccountName: prepared-workflow-runner
  parallelism: 1
  activeDeadlineSeconds: 600
  arguments:
    parameters:
    - name: data
      value: '[[1,2],[2,4],[3,6],[4,8]]'
  templates:
  - name: pipeline
    dag:
      tasks:
      - name: validate
        template: validate
        arguments:
          parameters:
          - name: data
            value: '{{workflow.parameters.data}}'
      - name: prepare
        template: prepare
        arguments:
          parameters:
          - name: data
            value: '{{tasks.validate.outputs.result}}'
        dependencies:
        - validate
      - name: tune
        template: tune
        arguments:
          parameters:
          - name: data
            value: '{{tasks.prepare.outputs.result}}'
        dependencies:
        - prepare
      - name: train
        template: train
        arguments:
          parameters:
          - name: scale
            value: '{{tasks.tune.outputs.result}}'
        dependencies:
        - tune
      - name: evaluate
        template: evaluate
        arguments:
          parameters:
          - name: model
            value: '{{tasks.train.outputs.result}}'
          - name: data
            value: '{{tasks.prepare.outputs.result}}'
        dependencies:
        - train
      - name: register
        template: register
        arguments:
          parameters:
          - name: model
            value: '{{tasks.train.outputs.result}}'
        dependencies:
        - evaluate
        when: '{{tasks.evaluate.outputs.result}} == 0'
  - name: validate
    inputs:
      parameters:
      - name: data
    script:
      image: python:3.12.14-slim-trixie
      command:
      - python
      env:
      - name: DATA
        value: '{{inputs.parameters.data}}'
      resources:
        requests:
          cpu: 100m
          memory: 64Mi
        limits:
          cpu: 500m
          memory: 128Mi
      source: 'import json, os

        rows = json.loads(os.environ["DATA"])

        assert rows and all(len(row) == 2 for row in rows)

        assert all(isinstance(v, (int, float)) for row in rows for v in row)

        print(json.dumps(rows))

        '
  - name: prepare
    inputs:
      parameters:
      - name: data
    script:
      image: python:3.12.14-slim-trixie
      command:
      - python
      env:
      - name: DATA
        value: '{{inputs.parameters.data}}'
      resources:
        requests:
          cpu: 100m
          memory: 64Mi
        limits:
          cpu: 500m
          memory: 128Mi
      source: 'import json, os

        rows = json.loads(os.environ["DATA"])

        print(json.dumps({"train": rows[:2], "test": rows[2:]}))

        '
  - name: tune
    inputs:
      parameters:
      - name: data
    script:
      image: python:3.12.14-slim-trixie
      command:
      - python
      env:
      - name: DATA
        value: '{{inputs.parameters.data}}'
      resources:
        requests:
          cpu: 100m
          memory: 64Mi
        limits:
          cpu: 500m
          memory: 128Mi
      source: 'import json, os

        data = json.loads(os.environ["DATA"])

        candidates = [1.0, 2.0]

        loss = lambda scale: sum((scale*x-y)**2 for x,y in data["train"]) / len(data["train"])

        print(min(candidates, key=loss))

        '
  - name: train
    inputs:
      parameters:
      - name: scale
    script:
      image: python:3.12.14-slim-trixie
      command:
      - python
      env:
      - name: SCALE
        value: '{{inputs.parameters.scale}}'
      resources:
        requests:
          cpu: 100m
          memory: 64Mi
        limits:
          cpu: 500m
          memory: 128Mi
      source: 'import json, os

        print(json.dumps({"scale": float(os.environ["SCALE"]), "fixture": True}))

        '
  - name: evaluate
    inputs:
      parameters:
      - name: model
      - name: data
    script:
      image: python:3.12.14-slim-trixie
      command:
      - python
      env:
      - name: MODEL
        value: '{{inputs.parameters.model}}'
      - name: DATA
        value: '{{inputs.parameters.data}}'
      resources:
        requests:
          cpu: 100m
          memory: 64Mi
        limits:
          cpu: 500m
          memory: 128Mi
      source: 'import json, os

        model = json.loads(os.environ["MODEL"])

        held_out = json.loads(os.environ["DATA"])["test"]

        print(sum((model["scale"]*x-y)**2 for x,y in held_out) / len(held_out))

        '
  - name: register
    inputs:
      parameters:
      - name: model
    script:
      image: python:3.12.14-slim-trixie
      command:
      - python
      env:
      - name: MODEL
        value: '{{inputs.parameters.model}}'
      resources:
        requests:
          cpu: 100m
          memory: 64Mi
        limits:
          cpu: 500m
          memory: 128Mi
      source: 'import json, os

        model = json.loads(os.environ["MODEL"])

        print(json.dumps({"candidate": model, "note": "fixture output only; no registry write"}))

        '
El MSE0 del fixture proviene de cuatro muestras sintéticas, no de una medición real de la calidad del modelo. Los workflows de producción necesitan separación de train/test, revisiones de datos/modelos, reglas de fallo/reintento/idempotencia y entregas reales de artifacts. artifactRepositoryRef no instala boto3 ni concede permisos de descarga a la aplicación.
Ray y Karpenter
Use las rutas auditadas de Ray2.58/KubeRay1.7 en la guía de Ray. GCS significa Global Control Service; la planificación interactúa con los raylets. El head puede ejecutar trabajo si anuncia CPU. Evite combinaciones no verificadas de Ray/Python entre workers de CPU/GPU/Neuron; las imágenes de Neuron también necesitan Ray y frameworks compatibles.
El autoscaling de Ray expresa la demanda de Pods worker, el scheduler de Kubernetes coloca los Pods y Karpenter suministra capacidad de nodo compatible. Los workers de Ray no invocan directamente las APIs de Karpenter. Haga coincidir las etiquetas de producto de memoria/GPU con los nodos reales; no seleccione p4d A100 de40GB con una etiqueta de80GB.
No duplique drivers en las AMIs NVIDIA de AL2023 ni sobrescriba la configuración completa de containerd. Los limits de Karpenter no son topes absolutos de admisión/costo, y la consolidación no usa directamente un umbral de utilización del20% de DCGM. Inspeccione los requests, la viabilidad de planificación, los precios y las restricciones de disruption.
APIs de DRA y límites de soporte
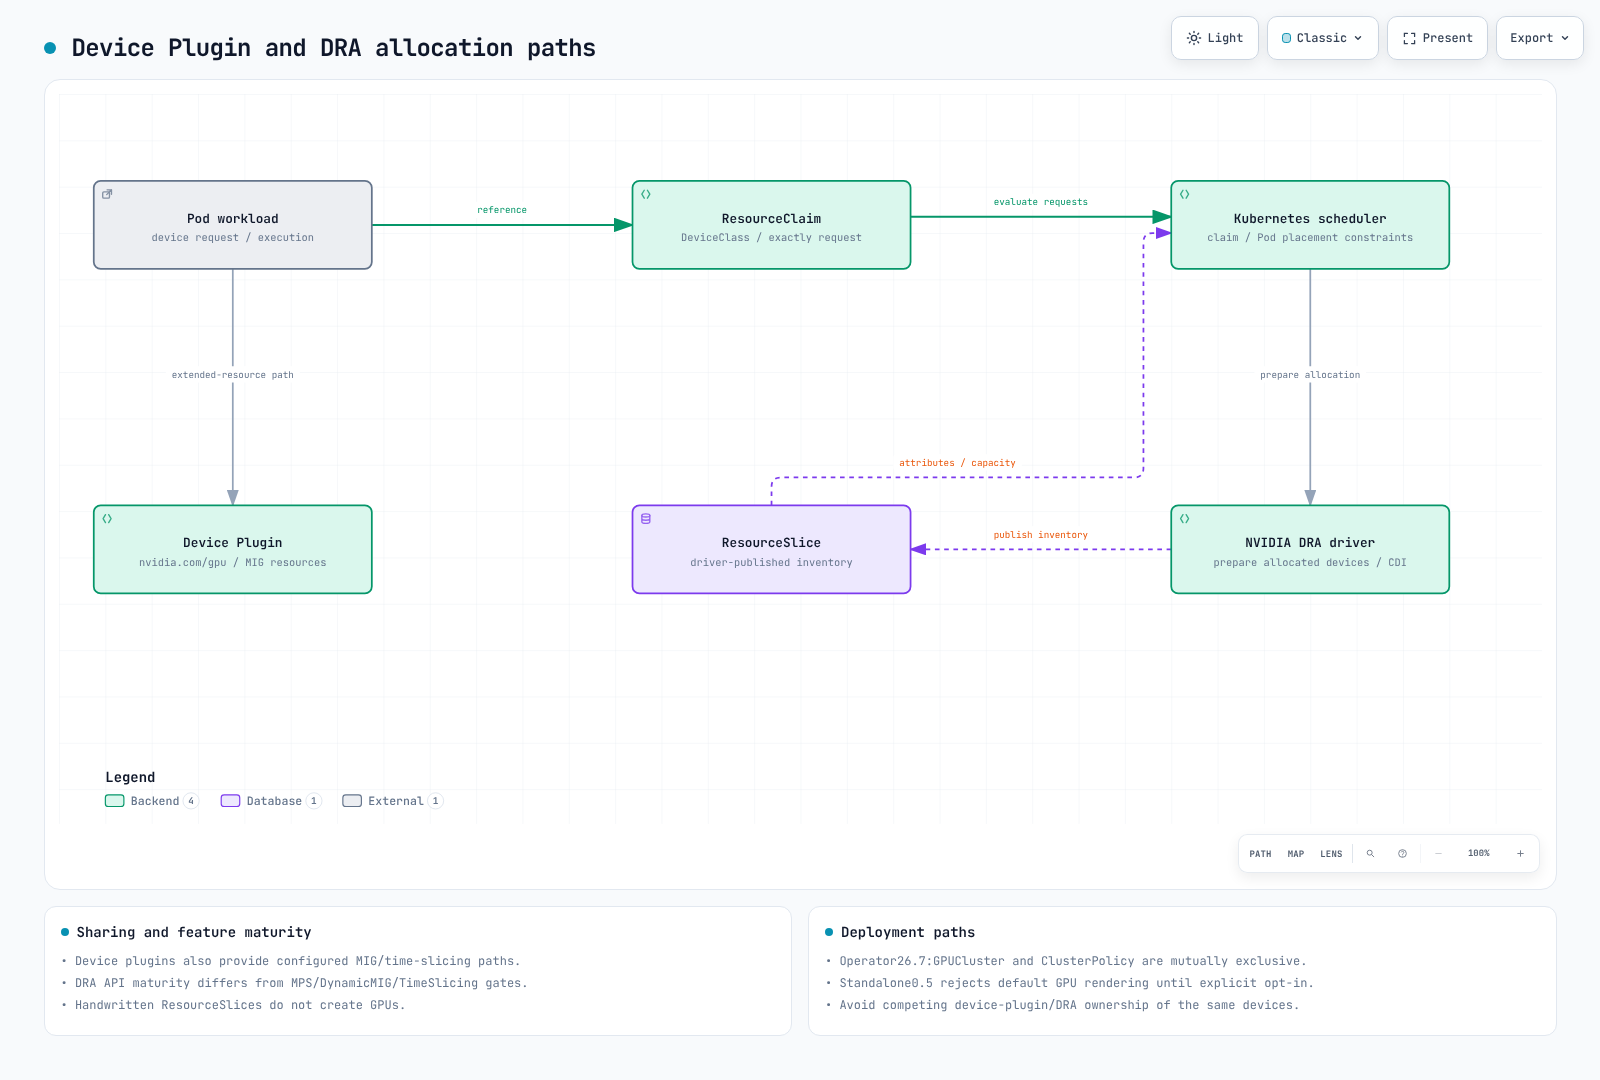
DRA representa atributos, solicitudes y asignación de dispositivos mediante DeviceClass, ResourceSlice y ResourceClaim/Template. Los drivers publican slices; los componentes de scheduler/driver asignan y preparan las claims. Los ResourceSlices escritos a mano no crean GPUs reales. La madurez de la API de Kubernetes y la madurez de las funcionalidades del driver de NVIDIA son cosas distintas.
Ejemplo de claim actual
El esquema resource.k8s.io/v1 de Kubernetes1.36.2 inspeccionado usa requests.exactly. Los prerrequisitos del driver NVIDIA0.5 distinguen la asignación de GPU(1.34.2+) de los ComputeDomains(1.32+). Verifique las APIs y las versiones de patch/plataforma que EKS realmente sirve. “Todas las funcionalidades de DRA en1.31+” es inexacto.
Este ejemplo de esquema define una claim de GPU y un Pod con un comando de inventario. Prepare el namespace ml-workloads, la DeviceClass gpu.nvidia.com, el driver/CDI, los nodos y los permisos por separado. En esta auditoría no se realizó ninguna ejecución en GPU.
apiVersion: resource.k8s.io/v1
kind: ResourceClaimTemplate
metadata:
  namespace: ml-workloads
  name: single-gpu
spec:
  spec:
    devices:
      requests:
      - name: gpu
        exactly:
          deviceClassName: gpu.nvidia.com
          count: 1
---
apiVersion: v1
kind: Pod
metadata:
  name: gpu-inventory-demo
  namespace: ml-workloads
spec:
  restartPolicy: Never
  automountServiceAccountToken: false
  containers:
  - name: inspect
    image: ubuntu:24.04
    command:
    - nvidia-smi
    - -L
    resources:
      claims:
      - name: gpu
      requests:
        cpu: 100m
        memory: 64Mi
      limits:
        cpu: 500m
        memory: 128Mi
  resourceClaims:
  - name: gpu
    resourceClaimTemplateName: single-gpu
  tolerations:
  - key: nvidia.com/gpu
    operator: Exists
    effect: NoSchedule
CEL debe usar la estructura real de atributos tipados/dominios publicada. El antiguo device.topology.node==device.topology.node no expresa colocación en el mismo nodo ni coincide con la API. matchAttribute necesita un atributo cualificado real. Una claim de GPU normal de un solo Pod no asigna automáticamente72GPUs a lo largo de un rack NVL72.
NVIDIA0.5 y GPU Operator26.7
El README de0.5 sigue describiendo la asignación de GPU como experimental y deshabilitada por defecto, lo que contradice la documentación de instalación/chart y del Operator26.7. El chart standalone real usa por defecto resources.gpus.enabled=true, pero rechaza el renderizado sin una habilitación explícita, para evitar colisiones con el device plugin. No describa la instalación por defecto como algo que deshabilita las GPUs silenciosamente y aun así tiene éxito.
La ruta gestionada del Operator26.7 usa el singleton GPUCluster llamado gpu-cluster, mutuamente excluyente con ClusterPolicy. Su ruta con driver preinstalado establece clusterPolicy.deployCR=false, gpuCluster.deployCR=true y driver.enabled=false. GPUCluster no reemplaza toda la preparación de driver/toolkit; provea los prerrequisitos de driver/CDI. No instale un release standalone de DRA duplicado. El renderizado local simuló una API DeviceClass servida; no habilitó una funcionalidad real del cluster.
Distinga el soporte de GPU completa/MIG existente y ComputeDomain del de DynamicMIG, MPS y TimeSlicingSettings en alpha. El código de feature gates de0.5 inspeccionado declara esos tres como false/Alpha. Algunas etiquetas GA de la documentación también difieren de las etiquetas Beta del código fuente; registre juntos la matriz de soporte, el código y la configuración exactos del release. GPU Operator25.3 por sí solo no establece soporte para todo.
Los device plugins también soportan las rutas de MIG existente, time-slicing y la experimental de MPS; el uso compartido de GPU no es exclusivo de DRA.3g.20gb nombra un perfil de instancia, no tres instancias de20GB. La asignación MIG/exclusiva no aísla automáticamente el host, el driver, los privilegios ni todos los canales laterales; MPS y time-slicing no son fronteras de seguridad.
NVLink multinodo y ComputeDomains
GB200 es Grace Blackwell, no Grace Hopper. Los ComputeDomains coordinan recursos MNNVL/IMEX entre Pods y nodos. Distinga entre racks, instancias EC2, nodos de Kubernetes y Pods, y verifique el soporte real de clique/fabric/dispositivo/driver. Campos inventados como nvswitchEnabled/graceHopperMode o scheduling gates no configuran la topología. Un scheduling gate sin un controlador que lo elimine deja el Pod esperando.
Plataformas de agentes y MCP
Use las APIs actuales de Kagent/LangGraph/Langfuse/Milvus en la guía de IA agéntica. GitLab es una plataforma opcional de código fuente/CI; los runners privilegiados y el ingress público no son requisitos de base. Separe la identidad de los jobs, las redes, los secretos y los permisos de construcción de imágenes, y verifique la entrega de credenciales del proveedor.
MCP define operaciones de protocolo como el listado y la invocación de herramientas; no es un controlador estándar de autodescubrimiento de Kubernetes ni una distribución de gateway. La antigua imagen ghcr.io/anthropics/mcp-gateway:latest y la etiqueta/configuración mcp.anthropic.com/tool eran implementaciones no verificadas y se eliminaron. Seleccione un release real de servidor/gateway y valide el transporte, la autenticación, la autorización, los timeouts y los esquemas de entrada de las herramientas. Una variable de entorno con una URL no implementa esas operaciones.
Solicitar recursos de GPU para Milvus no habilita la indexación en GPU. Haga coincidir las dimensiones de los embeddings y las revisiones de modelo, los parámetros de índice, el ciclo de vida de borrado/actualización y los filtros por tenant. No use un Deployment de Langfuse2.x como instalación actual de la plataforma4.x; revise las dependencias del backend, las credenciales en archivos, las APIs de instrumentación y la retención de datos sensibles.
Almacenamiento y redes
Verifique el IAM/UID/GID de los access points de EFS, los permisos de directorio y el consumo del PVC en el mismo namespace. La opción de montaje IAM no configura por sí sola las credenciales de identidad del controller ni del montaje.
Use parámetros y unidades de capacidad de FSx CSI soportados. No copie configuraciones inventadas de s3ImportPath/s3ExportPath para PERSISTENT_2 ni una capacidad inválida de10Ti. Distinga los filesystems existentes/estáticos de los recién provisionados, y la compatibilidad con DRA y backup, en la guía de almacenamiento.
Mountpoint CSI2.8.0 soporta PVs estáticos para buckets S3 existentes. Se eliminó el ejemplo de bucket dinámico basado solo en StorageClass/PVC. Mountpoint no es totalmente POSIX; revise el comportamiento de rename, escritura aleatoria, locking y checkpoints. La tabla de soporte de2.8 elimina AL2/Ubuntu22.04 y dirige las instalaciones a add-ons de EKS o charts oficiales en lugar de ramas del repositorio.
No multiplique el número de interfaces por el ancho de banda de la instancia, que ya es agregado. Las cifras anteriores de p4d “4×400Gbps” y trn1n “16×1600Gbps” eran incorrectas. Use la guía de redes para entrenamiento para la colocación en la misma AZ, las interfaces reales, driver/libfabric/NCCL, la asignación de dispositivos/Pods y los security groups. Las etiquetas RAID0 y efa-enabled no habilitan EFA.
Las subredes son solo una parte del aislamiento. Configure los requisitos de ingress/egress de la carga de trabajo y la autorreferencia de EFA mediante recursos reales de SG/IAM. Un YAML con apariencia de Terraform almacenado en un ConfigMap no aplica reglas de red. Evite el acceso por defecto desde un CIDR de VPC completo.
Observabilidad y alertas de GPU
DCGM Exporter4.6.0-4.8.3 define XID_ERRORS como un gauge del código del último error. increase(XID_ERRORS) no es un conteo de errores y puede interpretar erróneamente un cambio de código de31→13 como un reset. Observe el código actual o habilite por separado el counter XID_ERRORS_TOTAL. No todo XID indica un fallo de hardware.
FB_USED/FB_FREE son gauges en MiB; el ratio de abajo va de0–1. Una VRAM reservada alta no implica necesariamente OOM: inspeccione en conjunto los fallos de asignación, el comportamiento de la carga de trabajo, la caché de modelos y la memoria disponible. Los umbrales fijos de85C/20% no son estándares universales de fallo o reclamación. Verifique los tipos y unidades reales de las métricas antes de aplicar rate() a gauges de throughput de PCIe o de ancho de banda NVLink.
Estas reglas asumen un cluster por Prometheus. Para clusters combinados, incluya etiquetas de cluster en las agregaciones y los joins. Inspeccione las etiquetas reales de nodo/UUID/MIG y la normalización de etiquetas de recursos de kube-state-metrics.
groups:
- name: gpu-observations
  rules:
  - record: gpu:framebuffer_used_ratio
    expr: DCGM_FI_DEV_FB_USED / (DCGM_FI_DEV_FB_USED + DCGM_FI_DEV_FB_FREE)
  - alert: GPUReportedXIDCode
    expr: DCGM_FI_DEV_XID_ERRORS > 0
    for: 1m
    labels:
      severity: warning
    annotations:
      summary: "Inspect the reported XID code and workload context"
  - record: namespace:pending_gpu_requesting_pods:count
    expr: |
      count by (namespace) (
        max by (namespace, pod) (kube_pod_status_phase{phase="Pending"} == 1)
        and on (namespace, pod)
        max by (namespace, pod) (kube_pod_container_resource_requests{resource="nvidia_com_gpu"} > 0)
      )
La regla de pending cuenta los Pods en espera que solicitan GPUs; no prueba que la escasez de GPU haya causado la espera. Varios contenedores que solicitan GPU cuentan una sola vez por Pod. Inspeccione los events, los PVCs, la affinity, los taints, las cuotas, las claims y los pulls de imagen. No asuma que existe una etiqueta de nodo en cada alerta.
Configure la selección real de reglas de Prometheus y el scraping correcto de Service/puerto para DCGM, Ray y Karpenter. El provisioning por archivos de Grafana es distinto de un wrapper de dashboard por HTTP; una etiqueta por sí sola no conecta datasources. La salida del monitor de Neuron y los endpoints del exporter requieren preparación aparte.
Alcance de la verificación
Se revisaron toda la prosa original de la guía y el quiz y58bloques de código únicos. Las comprobaciones cubren los esquemas de DRA/Pod, el Helm oficial, las políticas de permitidos de OAuthenticator, el lint offline de Argo y los cuerpos de sus scripts, y los fixtures de Prometheus. No se ejecutó ninguna asignación real de OAuth/cluster/GPU/DRA, ni modelo, ni montaje de S3, ni servidor MCP; no se crearon recursos en la nube ni llamadas de pago.
Referencias
- GPU Operator26.7 DRA installation
- NVIDIA DRA0.5 source
- DRA0.5 prerequisites
- DRA0.5 feature gates
- OAuthenticator17.4
- JupyterHub chart4.4.2
- Argo Workflows4.1.3
- Mountpoint CSI2.8.0
- DCGM Exporter counter definitions
- MCP tools specification