EBS gp2 vs gp3: benchmark medido
Versiones compatibles: Kubernetes 1.36 (Amazon EKS), controlador EBS CSI, fio 3.36 Última actualización: September 2, 2026
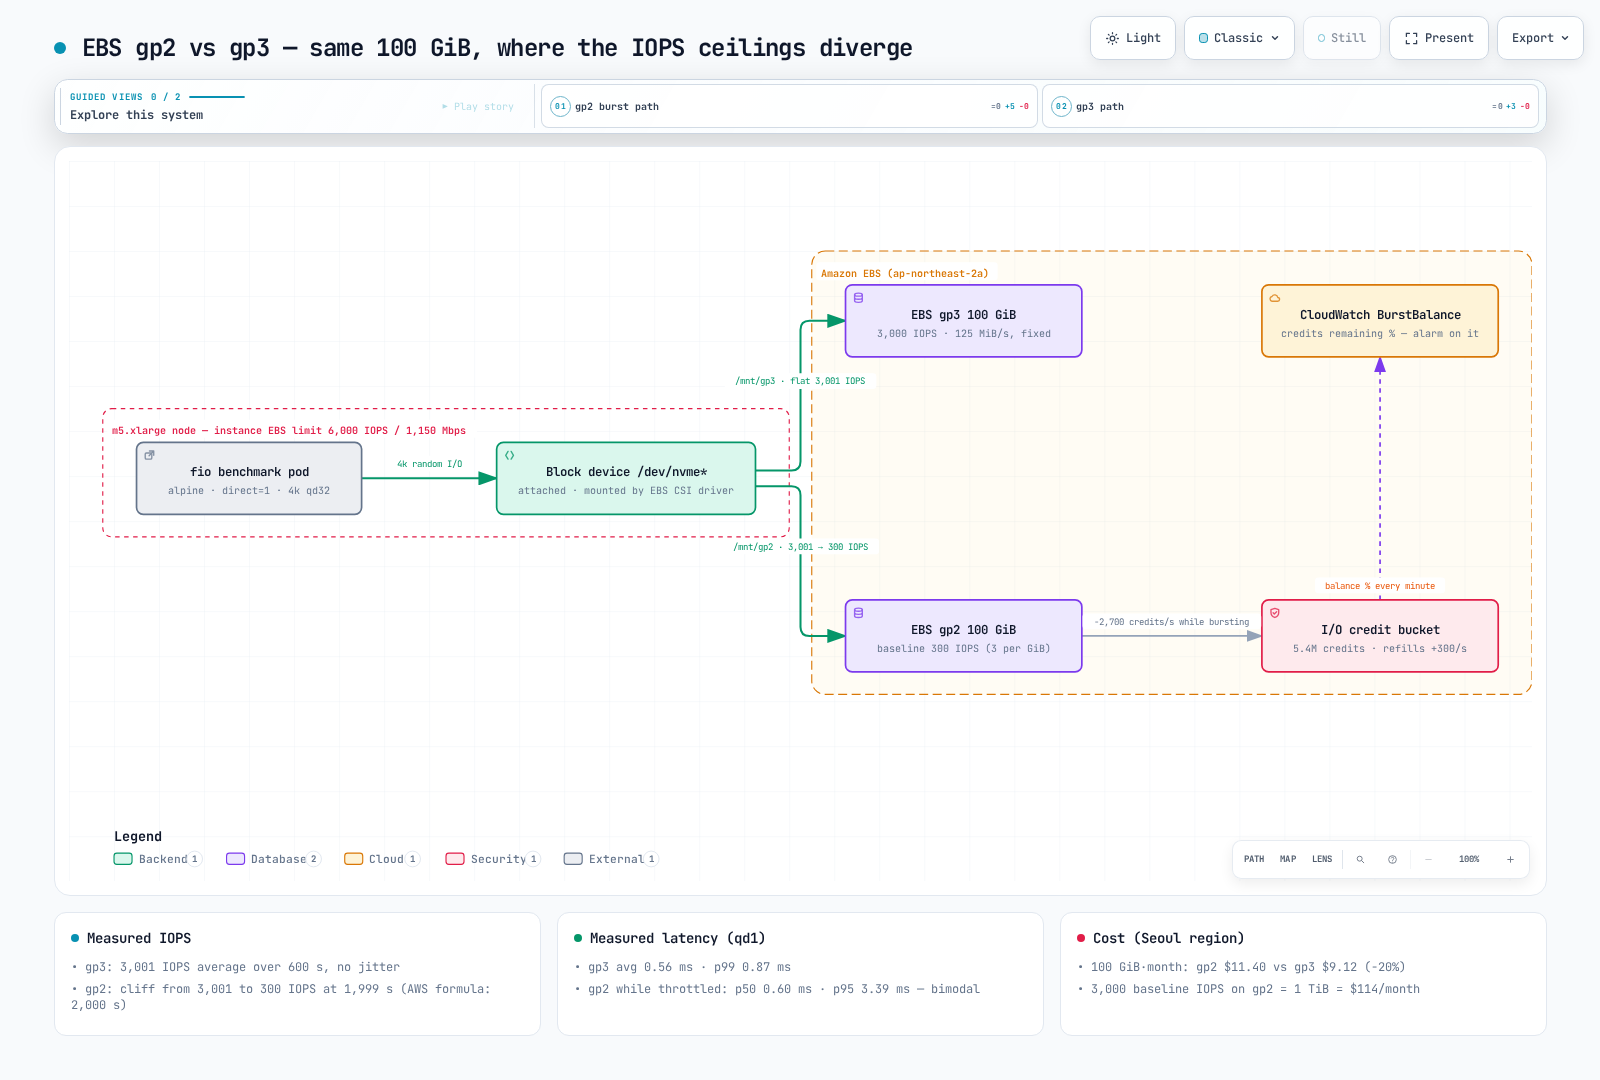
La frase breve de AWS — «mueva gp2 a gp3, ahorre un 20 %, obtenga un rendimiento igual o mejor» — es famosa, pero es difícil encontrar un gráfico que muestre cuándo y de qué forma aparece esa diferencia en un PVC de Kubernetes. Este artículo adjunta un PVC gp2 de 100 GiB y un PVC gp3 de 100 GiB a un único nodo EKS y somete ambos a carga con fio durante 45 minutos. La cuestión no es «gp2 es lento». Es esta: gp2 es indistinguible de gp3 durante 33 minutos y luego cae a una décima parte en un solo segundo. Cada cifra se reproduce a partir del manifiesto y los comandos de fio que aparecen a continuación.
TL;DR — Lo que medimos
| Métrica (100 GiB, m5.xlarge) | gp3 | gp2 |
|---|---|---|
| IOPS de lectura aleatoria de 4k (qd32) | 3.001 de promedio, plano durante 600 s (mín. 2.991) | 3.001 → 300, precipicio en 1.999 s |
| Latencia p99 de lectura aleatoria de 4k (qd32) | 12,9 ms | 109,6 ms (dominada por el período posterior al precipicio) |
| IOPS de escritura aleatoria de 4k (qd32, tras el agotamiento de créditos) | 3.025 | 601 (incluye un depósito parcialmente recargado) |
| Latencia de lectura aleatoria de 4k (qd1) | prom. 0,56 ms / p99 0,87 ms | prom. 1,65 ms — bimodal: p50 0,60 / p95 3,39 ms |
| Lectura / escritura secuencial de 1 MiB | 127 / 126 MiB/s (referencia de 125 MiB/s) | 130 / 129 MiB/s (límite de 128 MiB/s para ≤170 GiB) |
| Costo mensual (región de Seúl, 100 GiB) | $9.12 | $11.40 |
En una frase: para la misma capacidad, gp2 le vende 33 minutos de 3.000 IOPS a un precio un 25 % mayor.
Entorno de prueba
| Elemento | Valor |
|---|---|
| Clúster | Amazon EKS, Kubernetes 1.36, ap-northeast-2 |
| Nodo | m5.xlarge (4 vCPU, 16 GiB), aprovisionado por Karpenter — límites de EBS de la instancia: referencia de 6.000 IOPS / 1.150 Mbps (≈137 MiB/s), ráfaga de 18.750 IOPS / 4.750 Mbps |
| Volúmenes | un EBS gp2 de 100 GiB y un gp3 de 100 GiB, configuración predeterminada (StorageClass gp2 / gp3, controlador EBS CSI) |
| Pod | alpine:3.20 + fio 3.36, direct=1 (omite la caché de páginas), motor libaio, archivo de prueba de 8 GiB |
| Ejecución | los dos volúmenes nunca se midieron simultáneamente — 3.000 + 3.000 = 6.000 IOPS equivale al límite de la instancia m5.xlarge, lo que haría que la instancia, y no el volumen, fuera el cuello de botella |
| Precios | gp2 $0.114/GB-mes, gp3 $0.0912/GB-mes + IOPS adicionales $0.0057/IOPS-mes + rendimiento adicional $0.0456/MiB/s-mes (región de Seúl, Pricing API, septiembre de 2026) |
El nodeSelector fija m5.xlarge por exactamente un motivo: su límite de EBS a nivel de instancia (6.000 IOPS) está cómodamente por encima del límite del volumen (3.000), así que podemos asegurarnos de que el límite medido pertenece al volumen. En una instancia más pequeña (m5.large tiene una referencia de 3.600 IOPS), ambos límites se confunden y los resultados se vuelven difíciles de interpretar.
Manifiesto de Deployment
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: bench-gp2
  namespace: bench-storage
spec:
  accessModes: ["ReadWriteOnce"]
  storageClassName: gp2
  resources:
    requests:
      storage: 100Gi
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: bench-gp3
  namespace: bench-storage
spec:
  accessModes: ["ReadWriteOnce"]
  storageClassName: gp3
  resources:
    requests:
      storage: 100Gi
---
apiVersion: v1
kind: Pod
metadata:
  name: fio
  namespace: bench-storage
  annotations:
    karpenter.sh/do-not-disrupt: "true"   # keep consolidation from evicting a 45-minute measurement
spec:
  nodeSelector:
    node.kubernetes.io/instance-type: m5.xlarge
  containers:
    - name: fio
      image: alpine:3.20
      command: ["sh", "-c", "apk add --no-cache fio && sleep infinity"]
      resources:
        requests: { cpu: "1", memory: 1Gi }
        limits: { cpu: "2", memory: 2Gi }
      volumeMounts:
        - { name: gp2, mountPath: /mnt/gp2 }
        - { name: gp3, mountPath: /mnt/gp3 }
  volumes:
    - name: gp2
      persistentVolumeClaim: { claimName: bench-gp2 }
    - name: gp3
      persistentVolumeClaim: { claimName: bench-gp3 }
  restartPolicy: Never
La anotación
karpenter.sh/do-not-disruptexiste porque el primer intento de este benchmark de hecho falló sin ella. Cuando la otra carga de trabajo del nodo terminó, Karpenter consideró que el nodo estaba «infrautilizado», inició la consolidación y expulsó el Pod de fio (salida 137) a mitad de su ejecución de 45 minutos. Todo Pod de procesos por lotes o benchmark de larga duración necesita esta anotación (o un PodDisruptionBudget).
Comandos de fio
Cada fase usa las opciones comunes siguientes y se ejecutó de una en una, en este orden.
COMMON="--ioengine=libaio --direct=1 --group_reporting --output-format=json"

# 0. lay out the test files (8 GiB, sequential write)
fio --name=layout --filename=/mnt/gp3/testfile --size=8G --rw=write --bs=1M $COMMON
fio --name=layout --filename=/mnt/gp2/testfile --size=8G --rw=write --bs=1M $COMMON

# 1. 4k random read, qd32 — gp3 for 600 s, gp2 for 2,700 s (45 minutes, to catch the credit cliff)
fio --name=gp3-randread --filename=/mnt/gp3/testfile --size=8G --rw=randread --bs=4k \
    --iodepth=32 --runtime=600  --time_based --write_iops_log=gp3_rr --log_avg_msec=1000 $COMMON
fio --name=gp2-randread --filename=/mnt/gp2/testfile --size=8G --rw=randread --bs=4k \
    --iodepth=32 --runtime=2700 --time_based --write_iops_log=gp2_rr --log_avg_msec=1000 $COMMON

# 2. 4k random write, qd32, 120 s (gp2 has exhausted its credits by now)
fio --name=gp3-randwrite --filename=/mnt/gp3/testfile --size=8G --rw=randwrite --bs=4k --iodepth=32 --runtime=120 --time_based $COMMON
fio --name=gp2-randwrite --filename=/mnt/gp2/testfile --size=8G --rw=randwrite --bs=4k --iodepth=32 --runtime=120 --time_based $COMMON

# 3. 4k random read, qd1, 60 s — device latency without queueing
fio --name=gp3-lat --filename=/mnt/gp3/testfile --size=8G --rw=randread --bs=4k --iodepth=1 --runtime=60 --time_based $COMMON
fio --name=gp2-lat --filename=/mnt/gp2/testfile --size=8G --rw=randread --bs=4k --iodepth=1 --runtime=60 --time_based $COMMON

# 4. 1 MiB sequential read/write, qd8, 60 s — throughput ceiling
fio --name=gp3-seqread  --filename=/mnt/gp3/testfile --size=8G --rw=read  --bs=1M --iodepth=8 --runtime=60 --time_based $COMMON
fio --name=gp3-seqwrite --filename=/mnt/gp3/testfile --size=8G --rw=write --bs=1M --iodepth=8 --runtime=60 --time_based $COMMON
fio --name=gp2-seqread  --filename=/mnt/gp2/testfile --size=8G --rw=read  --bs=1M --iodepth=8 --runtime=60 --time_based $COMMON
fio --name=gp2-seqwrite --filename=/mnt/gp2/testfile --size=8G --rw=write --bs=1M --iodepth=8 --runtime=60 --time_based $COMMON
Medición 1 — 45 minutos de lecturas aleatorias de 4k: el precipicio de créditos
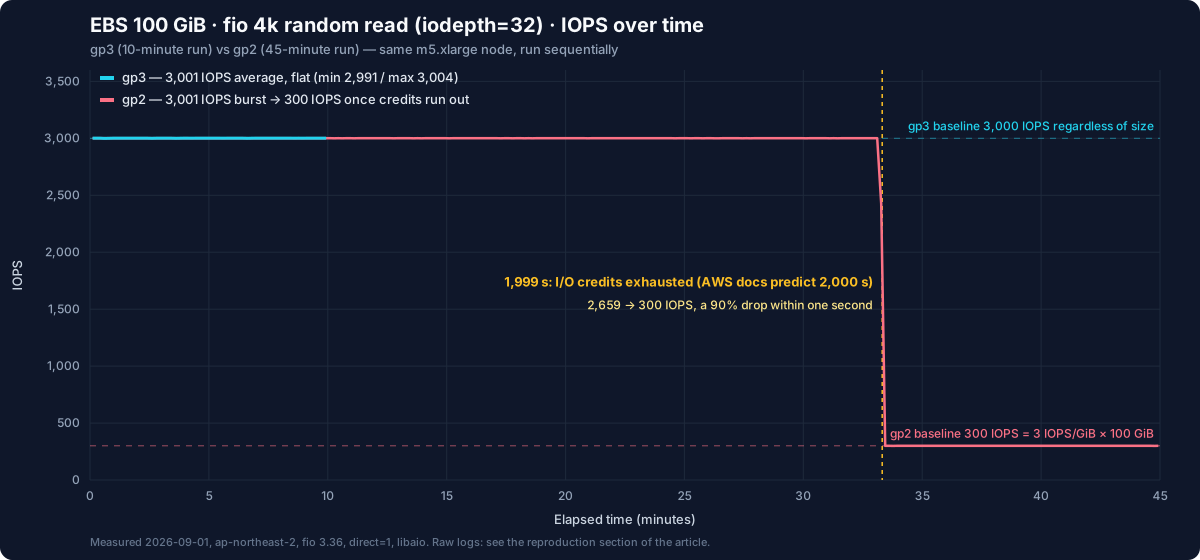
Este es el registro de IOPS por segundo que fio registró (2.699 muestras para gp2, 600 para gp3), representado tal cual. La tabla siguiente excluye la primera muestra de un segundo de cada registro (5.997 en ambos volúmenes: el llenado inicial de la cola, que el resumen de fio cuenta y por eso fio mismo informa 3.005 IOPS para gp3).
| gp3 (600 s) | gp2 antes del precipicio (0–1.999 s) | gp2 después del precipicio (2.000–2.700 s) | |
|---|---|---|---|
| IOPS promedio | 3.001 | 3.001 | 300 |
| Mín. / máx. | 2.991 / 3.004 | 2.997 / 3.005 | 297 / 304 |
| Latencia promedio (qd32) | 10,4 ms | ≈10,4 ms | ≈106 ms |
Cómo interpretarlo:
- Antes del precipicio, gp2 es indistinguible de gp3. Ambos entregan 3.001 IOPS, ambos se sitúan en un p50 de 10,0–10,2 ms. «gp2 es lento» simplemente es falso aquí: un volumen gp2 con créditos es un volumen de 3.000 IOPS.
- El precipicio tomó un segundo. 3.001 IOPS a los 1.998 s, 2.659 a los 1.999 s, 300 a los 2.000 s. No se degrada gradualmente; el 90 % de la capacidad desaparece como si se accionara un interruptor. Desde el punto de vista de la aplicación, este es el patrón de incidente «las consultas a la base de datos de repente son 10 veces más lentas y nadie desplegó nada».
- Las cifras coinciden con la documentación de AWS con una precisión de un segundo. Un volumen gp2 de 100 GiB tiene una referencia de 3 IOPS/GiB × 100 = 300 IOPS, un depósito de 5,4 M de créditos y una duración de ráfaga de
5,400,000 ÷ (3,000 − 300) = 2,000 s. La tabla de AWS indica «100 GiB → 2.000 segundos»; nosotros medimos 1.999. - La latencia de 106 ms no se debe a que el volumen sea lento. La ley de Little (latencia promedio = E/S pendientes ÷ rendimiento) da 32 ÷ 300 = 106,7 ms. Mantenemos 32 E/S en curso mientras que solo se completan 300 por segundo, por lo que la cola crece. Los 10,4 ms a 3.000 IOPS siguen la misma aritmética (32 ÷ 3.000 = 10,7 ms). La latencia en un benchmark qd32 es tiempo de espera en cola; la latencia del dispositivo es lo que muestra la Medición 3.
Divulgación de las condiciones de prueba: unos 13 minutos antes de la ejecución registrada, el primer intento (interrumpido por la expulsión de Karpenter) ya había cargado este mismo volumen gp2 a 3.000 IOPS durante aproximadamente 8 minutos (14:55–15:03 UTC). Un modelo de créditos ingenuo dice que ese drenaje previo debería haber adelantado el precipicio a antes de los 2.000 s; lo observamos a los 2.000 s. No pudimos determinar el motivo (la duración real de E/S antes de la expulsión es incierta). Considere la forma del precipicio (una caída del 90 % en un segundo) y el nivel mínimo (300 IOPS) como resultados definitivos, y use la fórmula de AWS (2.000 s) como la cifra de planificación para la duración exacta.
Medición 2 — Escrituras aleatorias tras el agotamiento de créditos: 3.025 frente a 601 IOPS
| Escritura aleatoria de 4k, qd32, 120 s | gp3 | gp2 (justo después del agotamiento) |
|---|---|---|
| IOPS | 3.025 | 601 |
| Latencia promedio | 10,3 ms | 52,0 ms |
| p50 / p95 / p99 | 10,2 / 11,2 / 12,0 ms | 11,1 / 109,6 / 133,7 ms |
La verdadera lección aquí es por qué gp2 produjo 601 IOPS en lugar de su referencia de 300. Durante los 120 segundos inmediatamente anteriores a la prueba de escritura de gp2 (mientras se ejecutaba la prueba de escritura de gp3), gp2 estuvo inactivo y acumuló 300 créditos/s × 120 s = 36.000 créditos. Gastar esos 36.000 durante una prueba de 120 segundos agrega 300 IOPS sobre la referencia de 300: exactamente 600 IOPS. Medido: 601.
Por tanto, el depósito de créditos de gp2 no está «vacío para siempre una vez agotado»; es una cuenta bancaria que se recarga lentamente cuando el volumen descansa. Por eso gp2 con tráfico intermitente a veces es rápido y a veces lento, un patrón doloroso de depurar porque rara vez se reproduce bajo demanda. La distribución bimodal — p50 en 11 ms, p95 en 110 ms — es la huella: los segundos en que quedan créditos son rápidos; los segundos sin ellos permanecen en la cola.
Medición 3 — Latencia qd1: mismo dispositivo, limitación diferente
Con una profundidad de cola de 1 no hay espera en cola, y lo que se ve es la latencia bruta de ida y vuelta de EBS.
| Lectura aleatoria de 4k, qd1, 60 s | gp3 | gp2 (limitado) |
|---|---|---|
| Latencia promedio | 0,564 ms | 1,651 ms |
| p50 | 0,569 ms | 0,602 ms |
| p95 | 0,627 ms | 3,391 ms |
| p99 | 0,872 ms | 3,555 ms |
| IOPS alcanzados | 1.759 | 603 |
- Los 0,56 ms de gp3 (p99 0,87 ms) son el tiempo real de ida y vuelta del SSD de uso general de EBS en este entorno. En qd1, 1.759 IOPS se mantiene por debajo del límite de 3.000, por lo que no hubo limitación y la latencia por sí sola determinó el rendimiento (1 ÷ 0,564 ms ≈ 1.773).
- Observe el p50 de gp2: 0,602 ms. La mitad de sus E/S son exactamente tan rápidas como gp3. El dispositivo no es diferente. La otra mitad llegó a 3,4–3,6 ms porque las E/S más allá de la asignación por segundo (603 IOPS — la misma aritmética que en la Medición 2: 18.000 créditos acumulados durante los 60 segundos de descanso más la referencia de 300) se retuvieron en la cola de limitación.
- Conclusión práctica: la limitación aparece en la forma de la distribución, no en el promedio. Un panel que muestra solo la latencia media registra 1,6 ms — «un poco más lento» — mientras que p95 se ha multiplicado por 6. Por eso los paneles de almacenamiento necesitan p50 junto a p95/p99.
Medición 4 — 1 MiB secuencial: ambos tienen un límite de 125–128 MiB/s
| Secuencial de 1 MiB, qd8, 60 s | lectura gp3 | escritura gp3 | lectura gp2 | escritura gp2 |
|---|---|---|---|---|
| Rendimiento | 127,3 MiB/s | 126,0 MiB/s | 130,3 MiB/s | 128,9 MiB/s |
| Latencia promedio | 58,0 ms | 58,5 ms | 56,7 ms | 57,3 ms |
Aquí gp2 y gp3 son efectivamente idénticos. gp3 se detiene en su referencia de 125 MiB/s; gp2 se detiene en 128 MiB/s, el límite para volúmenes de 170 GiB o menos. La aritmética también explica por qué la prueba secuencial de gp2 no se ralentizó debido a su depósito de créditos vacío: EBS cuenta una E/S de 1 MiB como cuatro operaciones de 256 KiB, así que 130 MiB/s ≈ 520 IOPS, dentro de los 36.000 créditos acumulados durante los 120 segundos de descanso anteriores. El límite de rendimiento se activó antes que el límite de IOPS.
Una cosa más: la referencia de ancho de banda EBS a nivel de instancia de este nodo (m5.xlarge) es 1.150 Mbps ≈ 137 MiB/s. Eleve el volumen gp3 a 250 MiB/s y en esta instancia seguirá deteniéndose cerca de 137 MiB/s (la ráfaga de 4.750 Mbps está disponible durante 30 minutos por cada 24 horas). Revise la columna de ancho de banda EBS de la hoja de especificaciones de la instancia antes de actualizar un volumen. El escaneo completo del benchmark de ClickHouse se estancó exactamente en esta banda de 125–137 MiB/s por el mismo motivo.
En dólares
Con precios de la región de Seúl (Pricing API, septiembre de 2026), «¿cómo obtengo 3.000 IOPS?» no deja ningún motivo para permanecer en gp2.
| Configuración | Costo mensual | IOPS sostenibles | Rendimiento |
|---|---|---|---|
| gp2 100 GiB | $11.40 | 300 (ráfaga de 3.000 durante como máximo 33 minutos) | 128 MiB/s |
| gp3 100 GiB (predeterminado) | $9.12 | 3.000, ilimitados | 125 MiB/s |
| gp3 100 GiB + 6.000 IOPS | $26.22 ($9.12 + 3.000 × $0.0057) | 6.000 | 125 MiB/s |
| gp3 100 GiB + 250 MiB/s | $14.82 ($9.12 + 125 × $0.0456) | 3.000 | 250 MiB/s |
| gp2 1.000 GiB (un volumen «dimensionado para IOPS») | $114.00 | 3.000 | 250 MiB/s |
La última fila es el desperdicio más común en la práctica. En la era de gp2, la práctica estándar para un conjunto de datos de 100 GiB que necesitaba IOPS era asignar 1 TiB. gp3 de 100 GiB proporciona los mismos 3.000 IOPS por $9.12: 12,5 veces más barato ($114.00 ÷ $9.12). Desacoplar los IOPS de la capacidad es la esencia de gp3, y esta tabla es la consecuencia.
Migrar a gp3 en Kubernetes
Volúmenes nuevos: hacer de gp3 el StorageClass predeterminado
Un clúster EKS de modo estándar todavía incluye gp2 como StorageClass predeterminado. Hacer de gp3 el predeterminado es el primer paso.
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: gp3
  annotations:
    storageclass.kubernetes.io/is-default-class: "true"
provisioner: ebs.csi.aws.com
parameters:
  type: gp3
  encrypted: "true"
volumeBindingMode: WaitForFirstConsumer
allowVolumeExpansion: truekubectl annotate storageclass gp2 storageclass.kubernetes.io/is-default-class-
kubectl apply -f gp3-storageclass.yamlPVC existentes: cambio in situ con VolumeAttributesClass
VolumeAttributesClass (storage.k8s.io/v1, GA desde Kubernetes 1.34) cambia el tipo de un volumen sin eliminar el PVC. El controlador EBS CSI admite los parámetros type, iops y throughput, y llama internamente a EBS Elastic Volumes (ModifyVolume), por lo que el Pod sigue ejecutándose.
apiVersion: storage.k8s.io/v1
kind: VolumeAttributesClass
metadata:
  name: gp3-baseline
driverName: ebs.csi.aws.com
parameters:
type: gp3kubectl patch pvc data-postgres-0 -p '{"spec":{"volumeAttributesClassName":"gp3-baseline"}}'
kubectl get pvc data-postgres-0 -o jsonpath='{.status.currentVolumeAttributesClassName}'Dos advertencias: EBS requiere que cada modificación alcance el estado completed antes de la siguiente en el mismo volumen (un volumen de 1 TiB puede tardar hasta seis horas en terminar) y permite como máximo cuatro modificaciones por volumen en un período continuo de 24 horas, así que agrupe los cambios de tipo, IOPS y rendimiento en una única solicitud; y en Kubernetes 1.31–1.33 la API es v1beta1 detrás de una feature gate. Ejecutar directamente aws ec2 modify-volume --volume-type gp3 también funciona, pero el objeto PV conserva gp2 como nombre de su StorageClass, lo que causa confusión más adelante.
Crear una alarma para cualquier gp2 restante
Hasta que termine la migración, cree una alarma sobre la métrica de EBS de CloudWatch BurstBalance (créditos restantes, en porcentaje). Para el volumen gp2 de este artículo, activarla alrededor del 15 % le da cinco minutos de advertencia antes del precipicio. El precipicio llega sin aviso; el saldo de créditos es el aviso.
Cómo reproducirlo
- Aplique el manifiesto anterior:
kubectl apply -f bench-storage.yaml, luegokubectl wait -n bench-storage pod/fio --for=condition=Ready. - Coloque el bloque de comandos de fio en un script de shell dentro del Pod y ejecútelo con
nohup, escribiendo los resultados en un volumen (/mnt/gp3/results). No suponga quekubectl execsobrevive 45 minutos, y el/tmpdel Pod desaparece con el Pod. - Represente directamente la salida de
--write_iops_log(*_iops.1.log, formatotime_ms, iops, ...) para la serie temporal de IOPS. - Termine con
kubectl delete ns bench-storage: los PVC usan la política de reclamaciónDelete, por lo que los volúmenes se eliminan con ellos. El tiempo total transcurrido es de unos 70 minutos; el costo es aproximadamente $0.30 de m5.xlarge más unos pocos centavos de horas de volumen.
Advertencias
- Un solo volumen, una sola ejecución. AWS diseña tanto gp2 como gp3 para «ofrecer el rendimiento aprovisionado el 99 % del tiempo», por lo que un volumen diferente en otro día puede desviarse unos pocos puntos porcentuales en IOPS. El tema de este artículo es la forma del modelo de créditos, no los valores absolutos.
- Consulte la divulgación de la Medición 1 sobre la carga previa en el volumen gp2 antes de medir el precipicio.
direct=1omite la caché de páginas. Una base de datos real, gracias a su buffer pool y a la caché del SO, sobrevive con muchos menos IOPS, que es precisamente la razón por la que el precipicio de gp2 aparece «solo a veces» y tarda tanto en diagnosticarse.- Los volúmenes gp2 de más de 100 GiB tienen referencias proporcionalmente mayores (334 GiB → 1.002 IOPS), y a partir de 1 TiB la referencia es 3.000, por lo que no hay precipicio. Las conclusiones aquí se aplican a volúmenes gp2 de menos de 1 TiB.
Lecturas relacionadas
- Descripción general de almacenamiento — cómo elegir el almacenamiento de EKS y dónde encaja este benchmark
- Almacenamiento de EKS, parte 1 — instalación del controlador EBS CSI y conceptos básicos de StorageClass
- Benchmark medido de ClickHouse en EKS — cómo el límite de rendimiento de 125 MiB/s de este artículo aparece en un escaneo completo de una base de datos real