EBS gp2 vs gp3 実測ベンチマーク
対応バージョン: Kubernetes 1.36 (Amazon EKS), EBS CSI driver, fio 3.36 最終更新: September 2, 2026
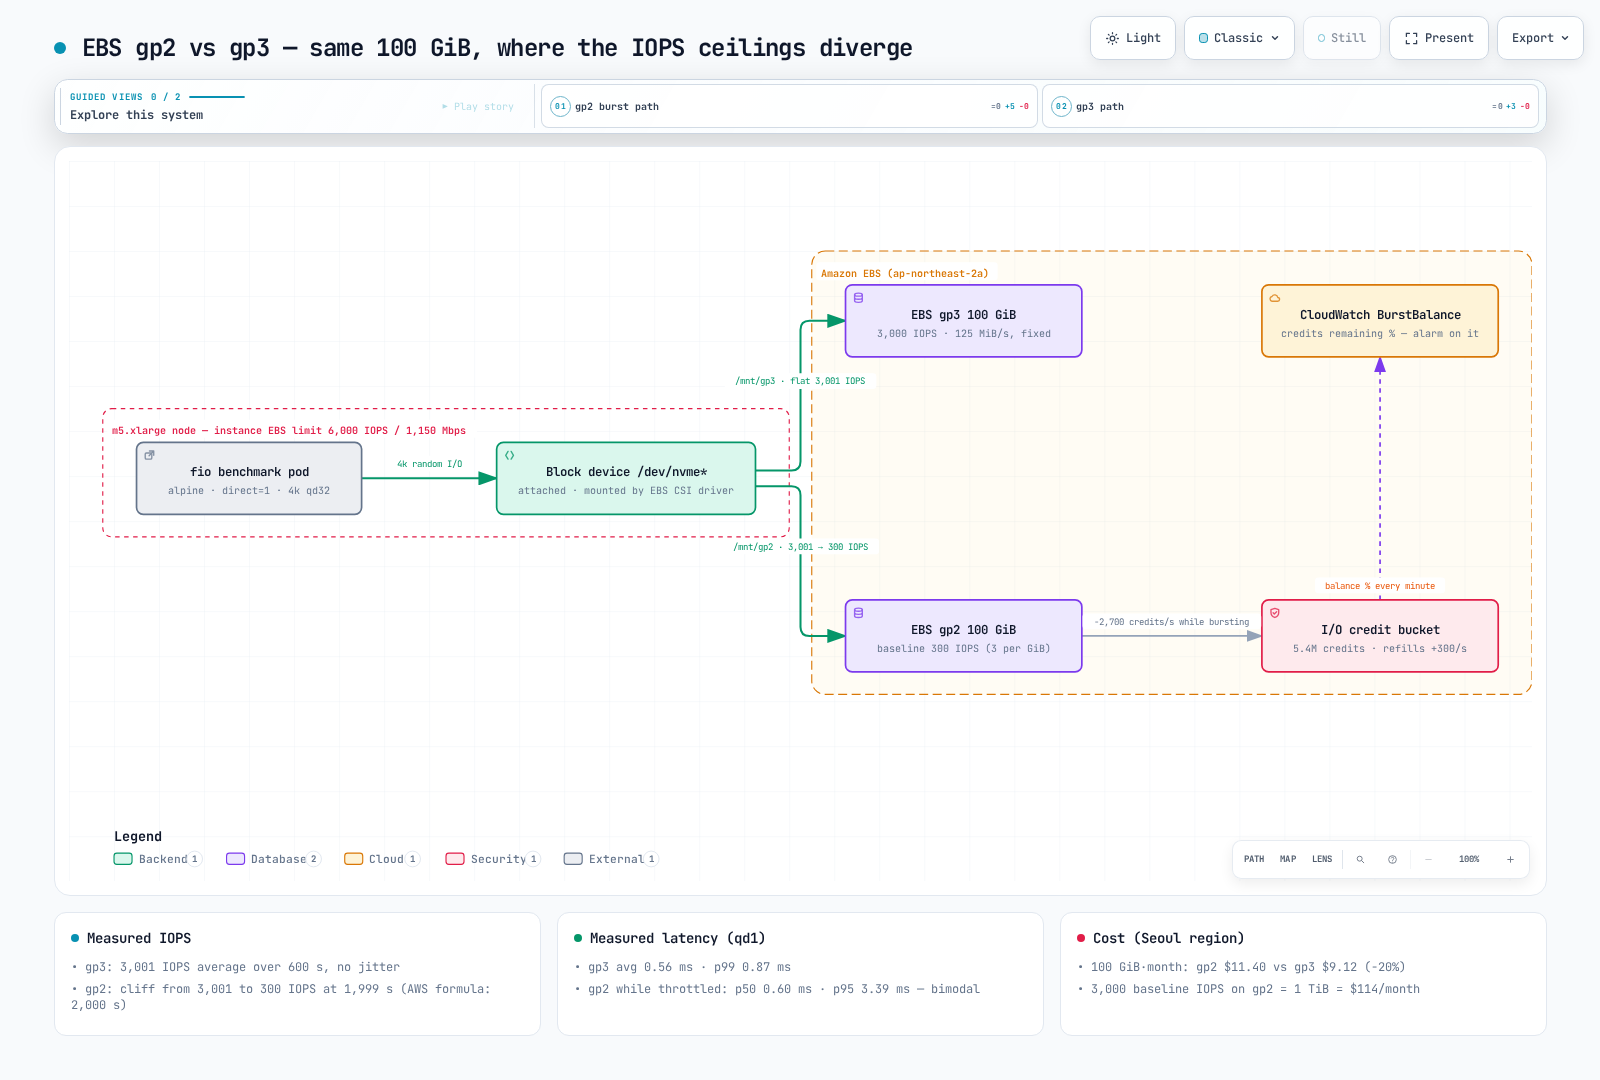
AWS の決まり文句である「gp2 から gp3 に移行すれば、20% 節約でき、同等以上のパフォーマンスを得られる」はよく知られています。しかし、その差が Kubernetes PVC でいつ、どのような形で現れるのかを示すグラフは見つけにくいものです。この記事では、1 つの EKS node に100 GiB の gp2 PVC 1 つと 100 GiB の gp3 PVC 1 つを接続し、両方に fio で 45 分間負荷をかけます。要点は「gp2 は遅い」ではありません。つまり、gp2 は 33 分間 gp3 と区別がつかず、その後わずか 1 秒以内に 10 分の 1 に低下するということです。すべての数値は、以下の manifest と fio コマンドで再現できます。
TL;DR — 測定結果
| 指標 (100 GiB, m5.xlarge) | gp3 | gp2 |
|---|---|---|
| 4k random read IOPS (qd32) | 3,001 平均、600 s にわたり横ばい (最小 2,991) | 3,001 → 300、1,999 s で急落 |
| 4k random read p99 latency (qd32) | 12.9 ms | 109.6 ms (急落後の期間が大半を占める) |
| 4k random write IOPS (qd32、credit 枯渇後) | 3,025 | 601 (一部再充填された bucket を含む) |
| 4k random read latency (qd1) | 平均 0.56 ms / p99 0.87 ms | 平均 1.65 ms — 二峰性: p50 0.60 / p95 3.39 ms |
| 1 MiB sequential read / write | 127 / 126 MiB/s (125 MiB/s ベースライン) | 130 / 129 MiB/s (≤170 GiB では 128 MiB/s 上限) |
| 月額コスト (Seoul region、100 GiB) | $9.12 | $11.40 |
一文で言えば、同じ容量に対して、gp2 は 25% 高い価格で 3,000 IOPS を 33 分間提供します。
テスト環境
| 項目 | 値 |
|---|---|
| Cluster | Amazon EKS, Kubernetes 1.36, ap-northeast-2 |
| Node | m5.xlarge (4 vCPU, 16 GiB)、Karpenter により provision — instance EBS 制限: ベースライン 6,000 IOPS / 1,150 Mbps (≈137 MiB/s)、burst 18,750 IOPS / 4,750 Mbps |
| Volumes | EBS gp2 100 GiB 1 つと gp3 100 GiB 1 つ、デフォルト設定 (StorageClass gp2 / gp3、EBS CSI driver) |
| Pod | alpine:3.20 + fio 3.36、direct=1 (page cache をバイパス)、libaio engine、8 GiB テストファイル |
| 実行 | 2 つの volume を同時に測定することはありませんでした — 3,000 + 3,000 = 6,000 IOPS は m5.xlarge の instance 制限と同じであり、volume ではなく instance がボトルネックになるためです |
| 料金 | gp2 $0.114/GB-month、gp3 $0.0912/GB-month + 追加 IOPS $0.0057/IOPS-month + 追加 throughput $0.0456/MiB/s-month (Seoul region、Pricing API、September 2026) |
nodeSelector が m5.xlarge を固定する理由は 1 つだけです。その instance レベルの EBS 制限 (6,000 IOPS) が volume 制限 (3,000) を十分に上回るため、測定された上限が volume によるものであることを確信できるからです。より小さい instance (m5.large のベースラインは 3,600 IOPS) では、2 つの制限が混ざり合い、結果の解釈が難しくなります。
Deployment Manifest
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: bench-gp2
  namespace: bench-storage
spec:
  accessModes: ["ReadWriteOnce"]
  storageClassName: gp2
  resources:
    requests:
      storage: 100Gi
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: bench-gp3
  namespace: bench-storage
spec:
  accessModes: ["ReadWriteOnce"]
  storageClassName: gp3
  resources:
    requests:
      storage: 100Gi
---
apiVersion: v1
kind: Pod
metadata:
  name: fio
  namespace: bench-storage
  annotations:
    karpenter.sh/do-not-disrupt: "true"   # keep consolidation from evicting a 45-minute measurement
spec:
  nodeSelector:
    node.kubernetes.io/instance-type: m5.xlarge
  containers:
    - name: fio
      image: alpine:3.20
      command: ["sh", "-c", "apk add --no-cache fio && sleep infinity"]
      resources:
        requests: { cpu: "1", memory: 1Gi }
        limits: { cpu: "2", memory: 2Gi }
      volumeMounts:
        - { name: gp2, mountPath: /mnt/gp2 }
        - { name: gp3, mountPath: /mnt/gp3 }
  volumes:
    - name: gp2
      persistentVolumeClaim: { claimName: bench-gp2 }
    - name: gp3
      persistentVolumeClaim: { claimName: bench-gp3 }
  restartPolicy: Never
karpenter.sh/do-not-disruptannotation があるのは、実際にこの benchmark の最初の試行がこれなしでは失敗したためです。node 上の別の workload がなくなると、Karpenter は node を「Underutilized」と判断して consolidation を開始し、45 分間の実行途中で fio pod を eviction しました (exit 137)。長時間実行される batch または benchmark pod には、この annotation (または PodDisruptionBudget) が必要です。
fio コマンド
各フェーズでは以下の共通オプションを使用し、次の順序で 1 つずつ実行しました。
COMMON="--ioengine=libaio --direct=1 --group_reporting --output-format=json"

# 0. lay out the test files (8 GiB, sequential write)
fio --name=layout --filename=/mnt/gp3/testfile --size=8G --rw=write --bs=1M $COMMON
fio --name=layout --filename=/mnt/gp2/testfile --size=8G --rw=write --bs=1M $COMMON

# 1. 4k random read, qd32 — gp3 for 600 s, gp2 for 2,700 s (45 minutes, to catch the credit cliff)
fio --name=gp3-randread --filename=/mnt/gp3/testfile --size=8G --rw=randread --bs=4k \
    --iodepth=32 --runtime=600  --time_based --write_iops_log=gp3_rr --log_avg_msec=1000 $COMMON
fio --name=gp2-randread --filename=/mnt/gp2/testfile --size=8G --rw=randread --bs=4k \
    --iodepth=32 --runtime=2700 --time_based --write_iops_log=gp2_rr --log_avg_msec=1000 $COMMON

# 2. 4k random write, qd32, 120 s (gp2 has exhausted its credits by now)
fio --name=gp3-randwrite --filename=/mnt/gp3/testfile --size=8G --rw=randwrite --bs=4k --iodepth=32 --runtime=120 --time_based $COMMON
fio --name=gp2-randwrite --filename=/mnt/gp2/testfile --size=8G --rw=randwrite --bs=4k --iodepth=32 --runtime=120 --time_based $COMMON

# 3. 4k random read, qd1, 60 s — device latency without queueing
fio --name=gp3-lat --filename=/mnt/gp3/testfile --size=8G --rw=randread --bs=4k --iodepth=1 --runtime=60 --time_based $COMMON
fio --name=gp2-lat --filename=/mnt/gp2/testfile --size=8G --rw=randread --bs=4k --iodepth=1 --runtime=60 --time_based $COMMON

# 4. 1 MiB sequential read/write, qd8, 60 s — throughput ceiling
fio --name=gp3-seqread  --filename=/mnt/gp3/testfile --size=8G --rw=read  --bs=1M --iodepth=8 --runtime=60 --time_based $COMMON
fio --name=gp3-seqwrite --filename=/mnt/gp3/testfile --size=8G --rw=write --bs=1M --iodepth=8 --runtime=60 --time_based $COMMON
fio --name=gp2-seqread  --filename=/mnt/gp2/testfile --size=8G --rw=read  --bs=1M --iodepth=8 --runtime=60 --time_based $COMMON
fio --name=gp2-seqwrite --filename=/mnt/gp2/testfile --size=8G --rw=write --bs=1M --iodepth=8 --runtime=60 --time_based $COMMON
測定 1 — 45 分間の 4k Random Read: Credit Cliff
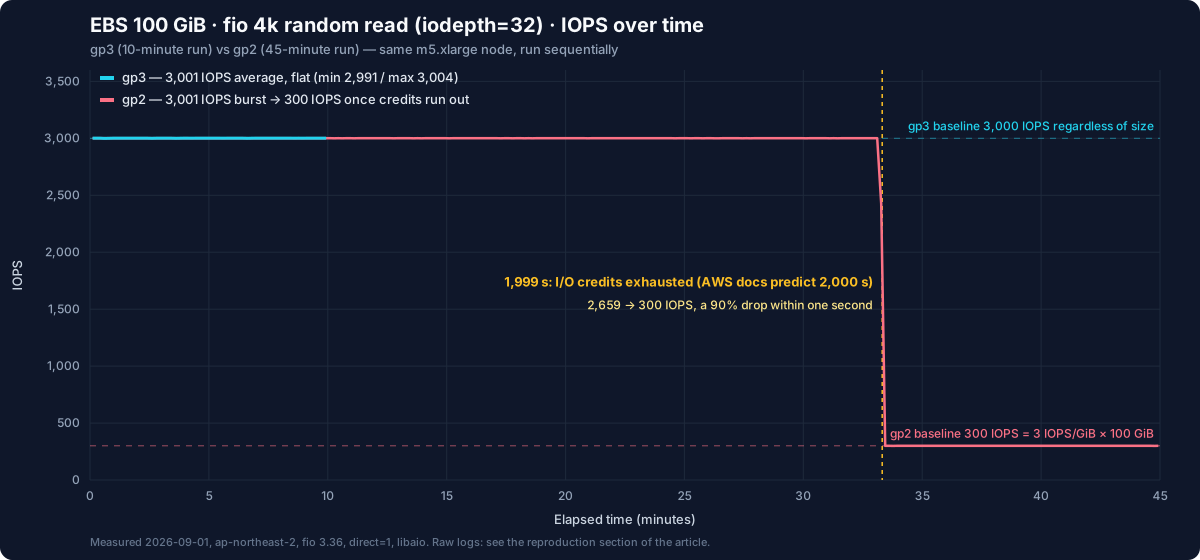
これは fio が記録した秒ごとの IOPS log (gp2 は 2,699 samples、gp3 は 600) をそのままプロットしたものです。以下の table は、各 log の最初の 1 秒 sample (両 volume とも 5,997 — 初期 queue fill。fio の summary に含まれており、これが fio 自身が gp3 で 3,005 IOPS と報告する理由です) を除外しています。
| gp3 (600 s) | cliff 前の gp2 (0–1,999 s) | cliff 後の gp2 (2,000–2,700 s) | |
|---|---|---|---|
| 平均 IOPS | 3,001 | 3,001 | 300 |
| 最小 / 最大 | 2,991 / 3,004 | 2,997 / 3,005 | 297 / 304 |
| 平均 latency (qd32) | 10.4 ms | ≈10.4 ms | ≈106 ms |
読み方:
- **cliff 前の gp2 は gp3 と区別がつきません。**どちらも 3,001 IOPS を提供し、どちらも p50 は 10.0–10.2 ms です。ここで「gp2 は遅い」は単純に誤りです。credit を持つ gp2 volume は 3,000 IOPS volume です。
- **cliff は 1 秒で発生しました。**1,998 s では 3,001 IOPS、1,999 s では 2,659、2,000 s では 300 です。徐々に劣化するのではなく、switch を切り替えたかのように容量の 90% が消えます。application の観点では、これは「database query が突然 10 倍遅くなったのに、誰も何も deploy していない」という incident pattern です。
- **数値は AWS documentation と 1 秒以内の精度で一致します。**100 GiB の gp2 volume には、3 IOPS/GiB × 100 = 300 IOPS のベースライン、5.4M-credit bucket、そして
5,400,000 ÷ (3,000 − 300) = 2,000 sの burst duration があります。AWS table には「100 GiB → 2,000 seconds」とあります。測定値は 1,999 でした。 - **106 ms の latency は volume 自体が遅いからではありません。**Little の法則 (平均 latency = outstanding I/O ÷ throughput) より、32 ÷ 300 = 106.7 ms となります。1 秒あたり 300 件しか完了しない間に 32 I/O を in-flight に保っているため、queue が増加します。3,000 IOPS での 10.4 ms も同じ計算です (32 ÷ 3,000 = 10.7 ms)。qd32 benchmark における latency は queueing time です。device latency は測定 3 で示します。
テスト条件の開示: 記録対象の実行の約 13 分前、最初の試行 (Karpenter eviction によって短縮) では、同じ gp2 volume におよそ 8 分間 (14:55–15:03 UTC)、すでに 3,000 IOPS の負荷がかかっていました。単純な credit model では、この事前 drain により cliff は 2,000 s より早く発生するはずです。しかし、観測値は 2,000 s でした。理由を特定できませんでした (eviction 前の実際の I/O duration は不確かです)。cliff の形状 (1 秒以内に 90% 低下) と下限 (300 IOPS) は決定的な結果として扱い、正確な duration の計画値には AWS formula (2,000 s) を使用してください。
測定 2 — Credit 枯渇後の Random Write: 3,025 vs 601 IOPS
| 4k random write, qd32, 120 s | gp3 | gp2 (枯渇直後) |
|---|---|---|
| IOPS | 3,025 | 601 |
| 平均 latency | 10.3 ms | 52.0 ms |
| p50 / p95 / p99 | 10.2 / 11.2 / 12.0 ms | 11.1 / 109.6 / 133.7 ms |
ここで本当に重要なのは、gp2 が 300 のベースラインではなく 601 IOPS を出した理由です。gp2 write test の直前の 120 秒間 (gp3 write test の実行中)、gp2 は idle であり、300 credits/s × 120 s = 36,000 credits が蓄積されました。120 秒の test でこの 36,000 を消費すると、300 のベースラインに 300 IOPS が追加されます。つまり、ちょうど 600 IOPS です。測定値は 601 でした。
つまり gp2 credit bucket は「一度 drain すると永遠に空」のではありません。volume が休止するたびにゆっくり再充填される銀行口座です。これが intermittent traffic 下の gp2 が「速いときもあれば遅いときもある」理由であり、on demand で再現することがほとんどなく debug が困難な pattern です。二峰性 distribution — p50 は 11 ms、p95 は 110 ms — がその指紋です。credit が残っている秒は高速で、残っていない秒は queue 内で待機します。
測定 3 — qd1 Latency: 同じ Device、異なる Throttle
queue depth が 1 では queueing はなく、生の EBS round-trip latency がそのまま見えます。
| 4k random read, qd1, 60 s | gp3 | gp2 (throttled) |
|---|---|---|
| 平均 latency | 0.564 ms | 1.651 ms |
| p50 | 0.569 ms | 0.602 ms |
| p95 | 0.627 ms | 3.391 ms |
| p99 | 0.872 ms | 3.555 ms |
| 達成 IOPS | 1,759 | 603 |
- **gp3 の 0.56 ms (p99 0.87 ms) は、この環境における EBS general-purpose SSD の実際の round-trip time です。**qd1 では 1,759 IOPS は 3,000 の上限を下回るため throttle はなく、latency のみが throughput を決定しました (1 ÷ 0.564 ms ≈ 1,773)。
- **gp2 の p50、0.602 ms に注目してください。**I/O の半分は gp3 とまったく同じ速度です。device は異なりません。残りの半分は 3.4–3.6 ms で到達しました。これは 1 秒あたりの allowance を超えた I/O (603 IOPS — 測定 2 と同じ計算: 60 秒の休止中に蓄積された 18,000 credits と 300 のベースライン) が throttle queue に保持されたためです。
- 実務上の結論: **throttling は平均値ではなく distribution の形状に現れます。**平均 latency だけを表示する dashboard は 1.6 ms —「少し遅い」— と示しますが、p95 は 6 倍に跳ね上がっています。これが storage dashboard で p95/p99 と並べて p50 が必要な理由です。
測定 4 — Sequential 1 MiB: 両方とも 125–128 MiB/s で上限
| 1 MiB sequential, qd8, 60 s | gp3 read | gp3 write | gp2 read | gp2 write |
|---|---|---|---|---|
| Throughput | 127.3 MiB/s | 126.0 MiB/s | 130.3 MiB/s | 128.9 MiB/s |
| 平均 latency | 58.0 ms | 58.5 ms | 56.7 ms | 57.3 ms |
ここでは gp2 と gp3 は実質的に同一です。gp3 は 125 MiB/s のベースラインで止まり、gp2 は 170 GiB 以下の volume に対する上限である 128 MiB/s で止まります。また、この計算は gp2 sequential test が空の credit bucket によって遅くならなかった理由も説明します。EBS は 1 MiB I/O を 256 KiB operations 4 回として数えるため、130 MiB/s ≈ 520 IOPS となり、直前の 120 秒の休止中に蓄積された 36,000 credits の範囲内です。IOPS ceiling より先に throughput ceiling が作用しました。
もう 1 点、この node (m5.xlarge) の instance レベルの EBS bandwidth ベースラインは 1,150 Mbps ≈ 137 MiB/s です。gp3 volume を 250 MiB/s に引き上げても、この instance では依然として 137 MiB/s 付近で止まります (4,750 Mbps の burst は 24 時間あたり 30 分間利用可能です)。volume を upgrade する前に、instance spec sheet の EBS bandwidth column を確認してください。ClickHouse benchmark の full scan は、まさに同じ理由でこの 125–137 MiB/s band に停滞しました。
金額で見る
Seoul region の料金 (Pricing API、September 2026) では、「3,000 IOPS を得るにはどうすればよいか」という問いに gp2 を使い続ける理由はありません。
| 構成 | 月額コスト | 持続可能な IOPS | Throughput |
|---|---|---|---|
| gp2 100 GiB | $11.40 | 300 (最大 33 分間の 3,000 burst) | 128 MiB/s |
| gp3 100 GiB (デフォルト) | $9.12 | 3,000、無制限 | 125 MiB/s |
| gp3 100 GiB + 6,000 IOPS | $26.22 ($9.12 + 3,000 × $0.0057) | 6,000 | 125 MiB/s |
| gp3 100 GiB + 250 MiB/s | $14.82 ($9.12 + 125 × $0.0456) | 3,000 | 250 MiB/s |
| gp2 1,000 GiB (「IOPS 用にサイズを確保した」volume) | $114.00 | 3,000 | 250 MiB/s |
最後の行は、実際に最もよくある無駄です。gp2 時代には、IOPS を必要とする 100 GiB dataset に対して 1 TiB を割り当てることが標準的な方法でした。gp3 100 GiB は同じ 3,000 IOPS を $9.12 で提供します。つまり 12.5 倍安価です ($114.00 ÷ $9.12)。IOPS を容量から切り離すことが gp3 の本質であり、この table はその結果です。
Kubernetes で gp3 に移行する
新規 volume: gp3 をデフォルトの StorageClass にする
standard-mode EKS cluster では、依然として gp2 がデフォルトの StorageClass として出荷されています。gp3 をデフォルトにすることが第一歩です。
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: gp3
  annotations:
    storageclass.kubernetes.io/is-default-class: "true"
provisioner: ebs.csi.aws.com
parameters:
  type: gp3
  encrypted: "true"
volumeBindingMode: WaitForFirstConsumer
allowVolumeExpansion: truekubectl annotate storageclass gp2 storageclass.kubernetes.io/is-default-class-
kubectl apply -f gp3-storageclass.yaml既存 PVC: VolumeAttributesClass でインプレース変更する
VolumeAttributesClass (storage.k8s.io/v1、Kubernetes 1.34 以降 GA) は、PVC を削除せずに volume の type を変更します。EBS CSI driver は type、iops、throughput parameters をサポートし、内部で EBS Elastic Volumes (ModifyVolume) を呼び出すため、pod は実行を継続します。
apiVersion: storage.k8s.io/v1
kind: VolumeAttributesClass
metadata:
  name: gp3-baseline
driverName: ebs.csi.aws.com
parameters:
type: gp3kubectl patch pvc data-postgres-0 -p '{"spec":{"volumeAttributesClassName":"gp3-baseline"}}'
kubectl get pvc data-postgres-0 -o jsonpath='{.status.currentVolumeAttributesClassName}'注意点は 2 つあります。EBS では同じ volume への次の modification の前に各 modification が completed state に到達する必要があり (1 TiB volume では完了まで最大 6 時間かかることがあります)、rolling 24-hour period あたり volume ごとに最大 4 回の modification しか許可されないため、type、IOPS、throughput の変更を 1 つの request にまとめてください。また、Kubernetes 1.31–1.33 では API は feature gate 配下の v1beta1 です。aws ec2 modify-volume --volume-type gp3 を直接実行しても機能しますが、PV object には StorageClass 名として gp2 が残るため、後で混乱を招きます。
残っている gp2 すべてに alarm を設定する
migration が完了するまで、CloudWatch EBS metric BurstBalance (残り credit、percent) に alarm を設定してください。この記事の gp2 volume では、約 15% で発火させると cliff の 5 分前に warning を得られます。cliff は予告なく到来します。credit balance が予告です。
再現方法
- 上の manifest を適用します:
kubectl apply -f bench-storage.yaml、続いてkubectl wait -n bench-storage pod/fio --for=condition=Ready。 - fio command block を pod 内の shell script に入れ、
nohupで実行し、結果を volume (/mnt/gp3/results) に書き込みます。kubectl execが 45 分間維持されると想定しないでください。また pod の/tmpは pod とともに消えます。 - IOPS time series 用に、
--write_iops_logの出力 (*_iops.1.log、format はtime_ms, iops, ...) を直接プロットします。 - 最後に
kubectl delete ns bench-storageを実行します。PVC はDeletereclaim policy を使用するため、volume も一緒に削除されます。合計 wall time は約 70 分、コストは m5.xlarge が約 $0.30 に volume-hours 数セントです。
注意事項
- **単一 volume、単一実行。**AWS は gp2 と gp3 の両方を「99% の時間で provisioned performance を提供する」よう設計しているため、別の日の別 volume では IOPS が数 percent 異なる可能性があります。この記事の対象は絶対値ではなく、credit model の形状です。
- cliff 測定前の gp2 volume に対する事前負荷については、測定 1 の開示を参照してください。
direct=1は page cache をバイパスします。実際の database は buffer pool と OS cache により、はるかに少ない IOPS で動作できます。まさにこれが、gp2 cliff が「ときどきだけ」現れ、diagnose に時間がかかる理由です。- 100 GiB より大きい gp2 volume は比例して高いベースラインを持ちます (334 GiB → 1,002 IOPS)。また 1 TiB 以上ではベースラインが 3,000 であるため cliff はありません。ここでの結論は 1 TiB 未満の gp2 volume に適用されます。
関連資料
- Storage Overview — EKS storage の選び方と、この benchmark の位置付け
- EKS Storage Part 1 — EBS CSI driver のインストールと StorageClass の基本
- ClickHouse on EKS 実測ベンチマーク — この記事の 125 MiB/s throughput ceiling が実際の database full scan でどのように現れるか