スケーリング動作を理解する
サポート対象バージョン: EKS Auto Mode GA; example baseline EKS 1.36 最終更新: October 12, 2026
この章では、プロビジョニング、統合、ドリフト、期限切れを区別します。Getting Started で確認したアカウント/コンテキストを使用してください。マニフェストは設定済みの default NodeClass を前提とし、ライフサイクル動作に焦点を当てるため On-Demand キャパシティを使用します。上限は例示であり、大きなコストを許容する場合があります。
この監査中に、クラスター、ワークロード、またはレイテンシーのベンチマークは実行されていません。設定および診断用の変換はローカルで確認済みです。本番環境の前に、管理された環境で admission、IAM、スケジューリング、および中断動作を検証してください。
スケジュール不可能な Pod からキャパシティへ
Auto Mode は、スケジューラーが既存のキャパシティに配置できない Pod を監視します。プロビジョニングが成功するには、適切な NodePool/NodeClass、互換性のある制約、利用可能なクォータ、および EC2 キャパシティが存在する必要があります。リクエスト、アフィニティ、taint、トポロジー、ボリューム配置、アーキテクチャはすべて重要です。HPA/KEDA または別のアプリケーションコントローラーはレプリカの増加を担い、ノード自動化はアプリケーションの CPU 使用率オートスケーラーではありません。
Pending だけではノード不足の証拠になりません。Pod は、イメージまたは初期化を待機している間にすでにノードへ割り当てられていることがあります。この図は成功したキャパシティの経路を示し、失敗の分岐は省略しています。互換性のあるインスタンス選択は、グローバル最適解または準備完了時刻の保証ではありません。Running もアプリケーションの準備完了を意味しません。
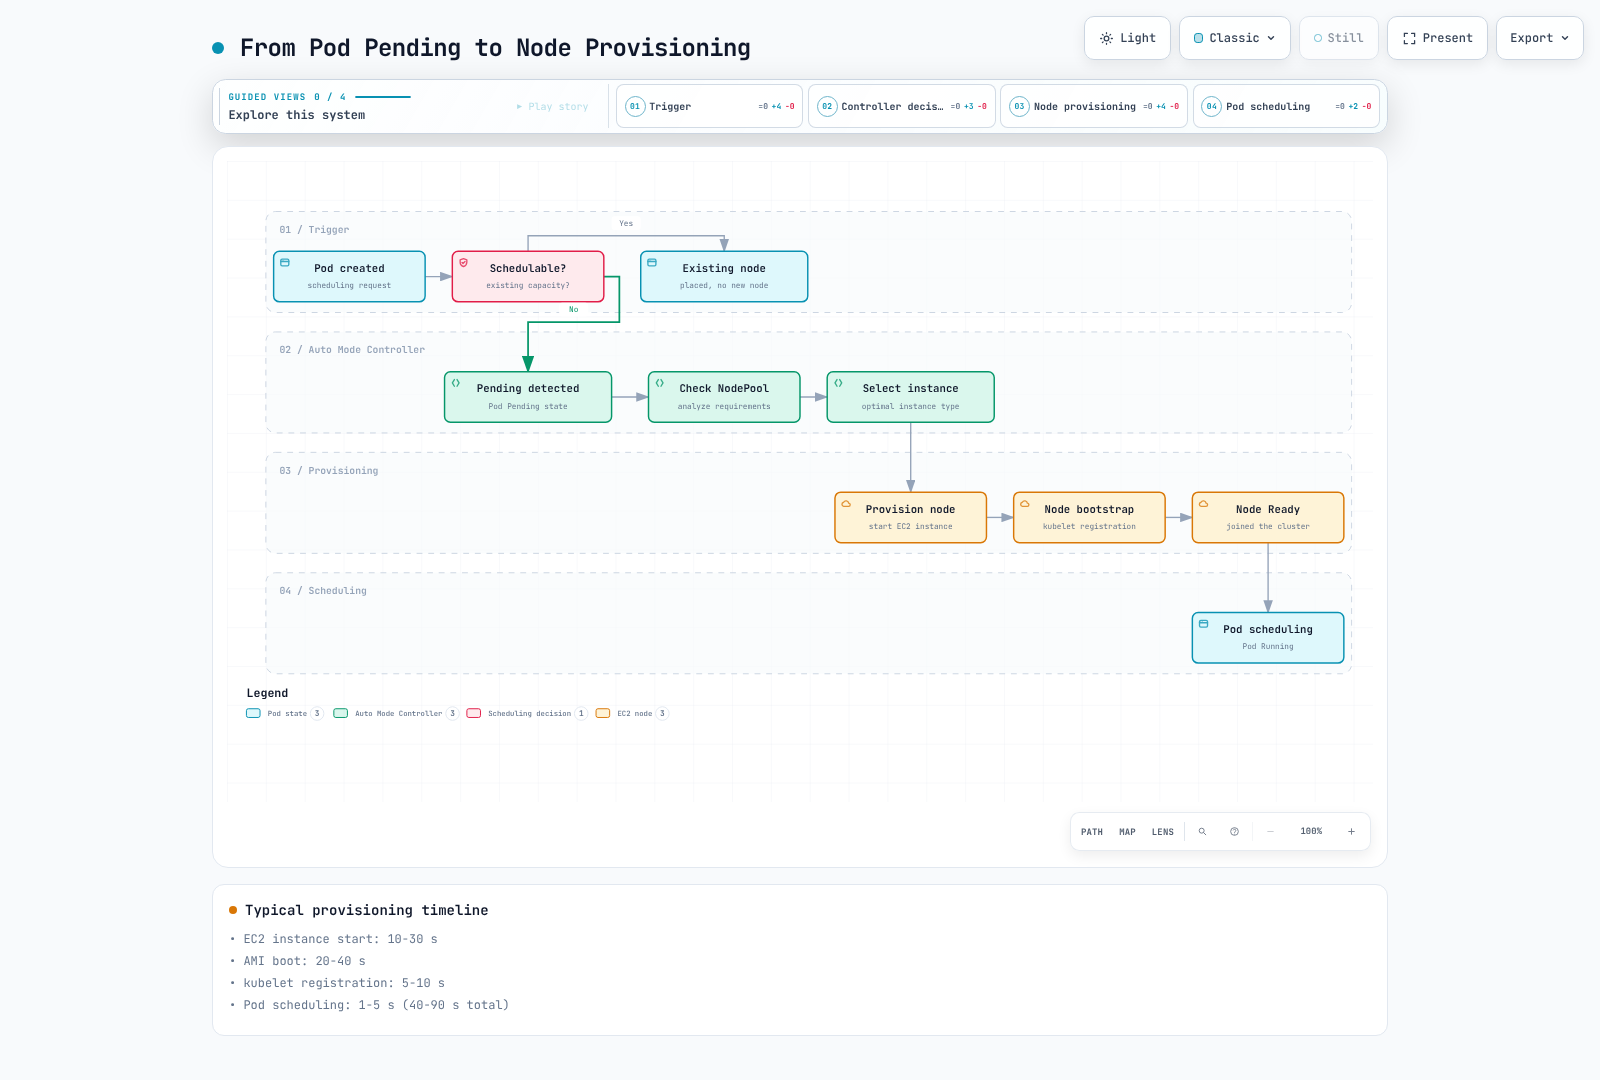
過去の説明用推定値
以前のガイドでは、生の観測結果や再現可能なベンチマークなしに、以下の数値が公開されていました。これらは、EKS 1.36 または AWS SLO で計測された時間ではなく、検証されていない過去の推定値として残されています。ステージの定義は重複する可能性があります。計測トレースとして合計しないでください。
| 以前の図におけるフェーズ | 公開された所要時間 |
|---|---|
| Pending 検出 | 1–5 seconds |
| インスタンス選択 | 1–3 seconds |
| EC2 起動 | 10–30 seconds |
| AMI ブート | 20–40 seconds |
| kubelet 登録 | 5–10 seconds |
| Pod スケジューリング | 1–5 seconds |
| 主張された合計 | 40–90 seconds |
統合: タイマーの保証ではなく適格性
統合では、スケジュール可能な状態を維持しつつコストを節約できる削除または置換を探します。これを、固定の測定済み CPU またはメモリ使用率しきい値としてモデル化しないでください。リソースリクエストと配置制約が重要です。PDB、中断バジェット、アノテーション、置換キャパシティ、およびドレインの進行状況により、アクションが妨げられたり遅延したりする可能性があります。
consolidateAfter は安定性/適格性の遅延です。Pod の追加/削除でタイマーはリセットされます。30 秒の値は、その 30 秒後の削除を約束するものではなく、置換の準備完了までの時間を制限するものでもありません。
WhenEmpty
このポリシーは、適格な空のノードを対象とします。「空」は kubectl get pods で Pod がゼロであることを必ずしも意味しません。DaemonSet のみが存在するノードも対象になる可能性があります。統合に対しては保守的ですが、ドリフト、期限切れ、または Spot 中断など、他の中断理由を無効にはしません。
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: when-empty-example
spec:
  template:
    spec:
      requirements:
      - key: eks.amazonaws.com/instance-category
        operator: In
        values:
        - m
        - c
      - key: karpenter.sh/capacity-type
        operator: In
        values:
        - on-demand
      nodeClassRef:
        group: eks.amazonaws.com
        kind: NodeClass
        name: default
  disruption:
    consolidationPolicy: WhenEmpty
    consolidateAfter: 30s
    budgets:
    - nodes: 10%
  limits:
    cpu: '100'
    memory: 400Gi
WhenEmptyOrUnderutilized
このポリシーは、関連する制約下でワークロードをより低コストで再パックできる場合、空でないノードの統合を許可します。既存の余剰キャパシティを使用してノードを削除するか、ノードをより安価なキャパシティで置き換える場合があります。常に新しいノードが必要になるわけではありません。
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: when-underutilized-example
spec:
  template:
    spec:
      requirements:
      - key: eks.amazonaws.com/instance-category
        operator: In
        values:
        - m
        - c
      - key: karpenter.sh/capacity-type
        operator: In
        values:
        - on-demand
      nodeClassRef:
        group: eks.amazonaws.com
        kind: NodeClass
        name: default
  disruption:
    consolidationPolicy: WhenEmptyOrUnderutilized
    consolidateAfter: 1m
    budgets:
    - nodes: 10%
  limits:
    cpu: '100'
    memory: 400Gi
Balanced
EKS 1.37 では、統合ポリシーを省略して新規作成されたカスタム NodePool のデフォルトは Balanced です。組み込みの general-purpose および system プールも Balanced を使用しており、そのポリシーは変更できません。別の動作を意図する場合は、カスタムプールのポリシーを明示的に設定してください。Balanced は節約額とともに中断コストを考慮するため、WhenEmptyOrUnderutilized なら実行する限界的なアクションをスキップする場合があります。これは中断なしを保証するものではありません。この章の例では、ポリシーを明示的に設定しています。
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: balanced-example
spec:
  template:
    spec:
      requirements:
      - key: eks.amazonaws.com/instance-category
        operator: In
        values:
        - m
        - c
      - key: karpenter.sh/capacity-type
        operator: In
        values:
        - on-demand
      nodeClassRef:
        group: eks.amazonaws.com
        kind: NodeClass
        name: default
  disruption:
    consolidationPolicy: Balanced
    consolidateAfter: 1m
    budgets:
    - nodes: 10%
  limits:
    cpu: '100'
    memory: 400Gi
パッキング図の解釈
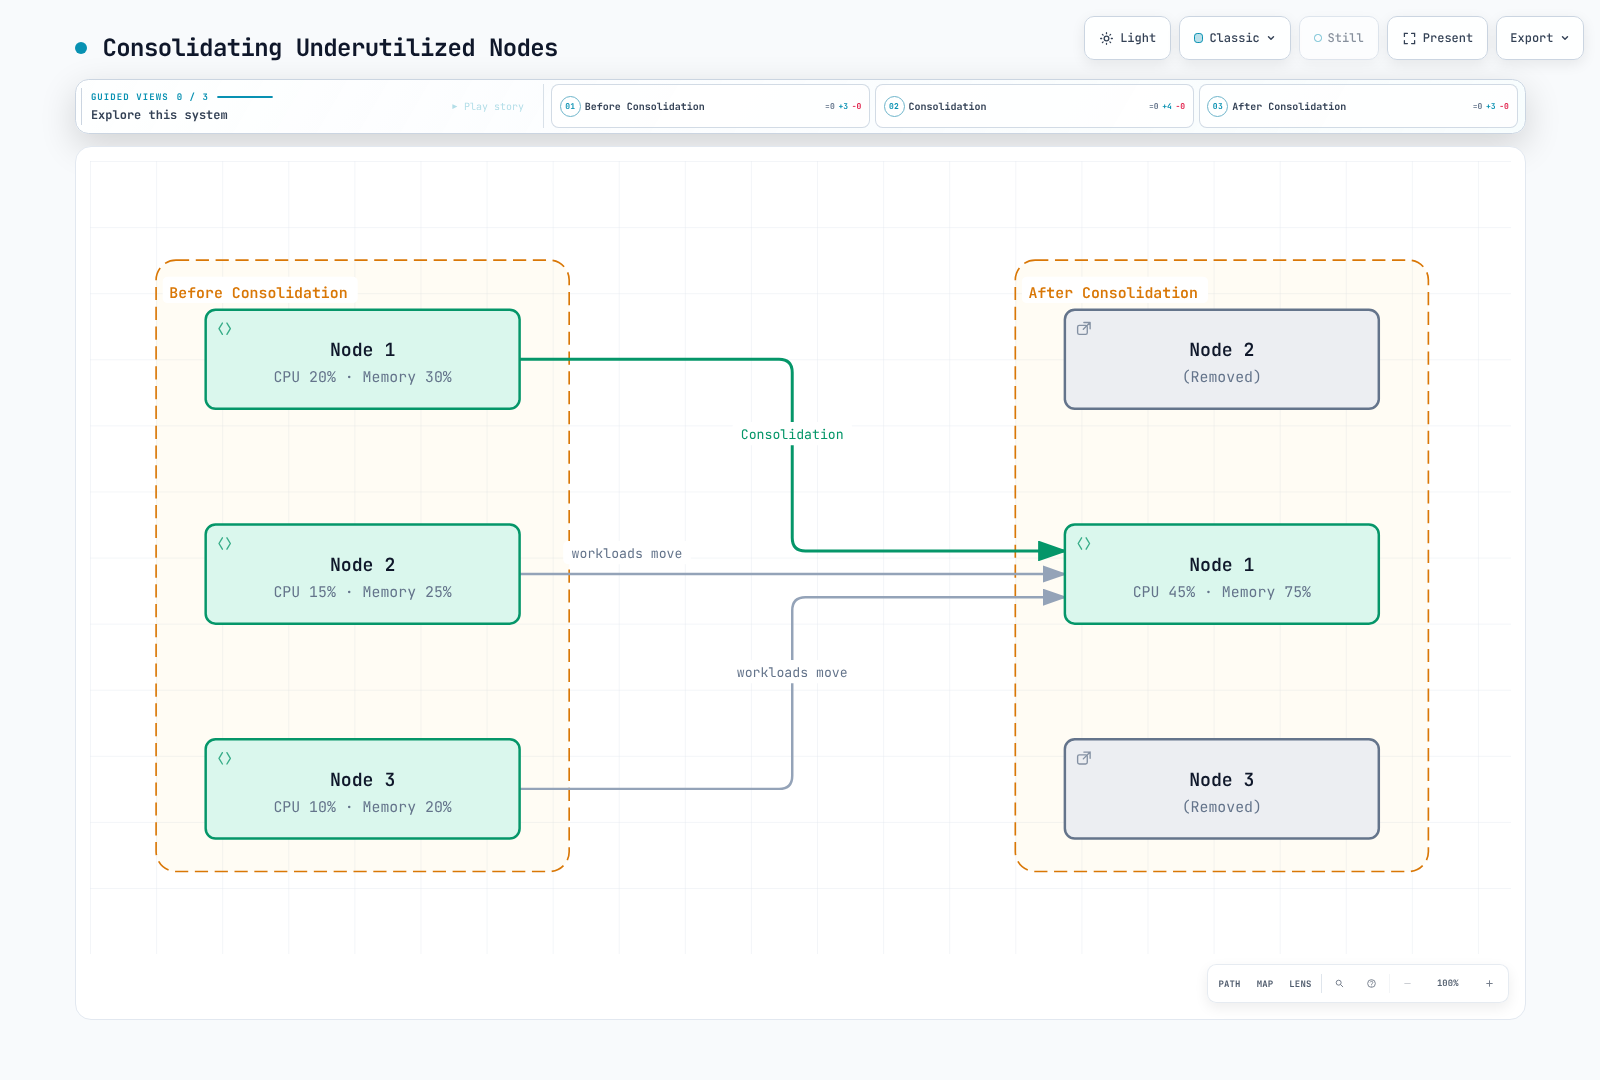
図の CPU 20/15/10% とメモリ 30/25/20% は、同じキャパシティのノードでは 45% と 75% になります。これらは説明用のパッキング値であり、普遍的な統合しきい値への測定済み入力ではありません。実際の配置は、リクエスト、トポロジー、ストレージ、および可用性要件も満たす必要があります。Pod はワークロードコントローラーによって退避および再作成され、ライブマイグレーションはされません。
ドリフトの検出と置換
ドリフトは、NodeClaim が関連する望ましい構成または解決済み構成と一致しなくなったことを意味します。Drifted condition を確認してください。以前の karpenter.sh/drift-hash ノードアノテーションのクエリは、有効な公開ドリフトステータス確認ではありませんでした。condition がない場合は、決定的な false 結果として作り出すのではなく、以下では NotReported として報告されます。
kubectl --context "$CLUSTER_NAME" --request-timeout=15s get nodeclaims -o json |
  jq '[.items[] | {
    claim: .metadata.name,
    node: .status.nodeName,
    pool: .metadata.labels["karpenter.sh/nodepool"],
    drift: ((.status.conditions // [] | map(select(.type == "Drifted") |
              {status, reason, lastTransitionTime, observedGeneration}) | first)
            // {status: "NotReported"})
}]'| 変更 | 解釈 |
|---|---|
| Requirements が現在のインスタンスを除外する | ドリフトを引き起こす可能性がある |
| Requirements が広がっても、引き続きインスタンスを許可する | 必ずしもドリフトを引き起こさない |
| 関連する NodeClass 設定、または解決済みの subnet/security-group 選択が変更される | ドリフトを引き起こす可能性がある。実際の condition を確認すること |
| AWS が新しいマネージド Auto Mode AMI を選択する | 置換を引き起こす可能性がある。ユーザーは amiFamily を選択しない |
| すでに参照されている security group のルール編集 | 別の group を選択することと同等ではない。常にノードドリフトを引き起こすと想定しないこと |
| NodePool の weight、limits、または中断動作 | それ自体はノードテンプレートのドリフトではない。許可されるアクションを変更する可能性がある |
expireAfter または terminationGracePeriod の変更 | 既存の NodeClaim フィールドは書き換えられない。置換では新しい値が取得される |
典型的なグレースフルな経路では、バジェットとスケジューリング可能性を確認し、選択されたノードへの新規配置を防止し、必要な場合に置換キャパシティを準備してから、古いノードを退避/ドレインして終了します。置換キャパシティは古いキャパシティと重複する場合があり、コストが発生します。並列性はバジェットによって制限されます。置換は必ずしも順次実行されません。強制的な中断/期限切れ経路を、常に最初に正常な置換を待つものとして説明してはいけません。
期限切れと終了猶予期間
AWS は、Auto Mode ノードの最大ライフタイムを 21 日間と文書化しています。デフォルトの期限は 336 時間であり、カスタム NodePool で省略した場合、Auto Mode は NodeClaim の terminationGracePeriod を 24 時間にデフォルト設定します。汎用的な upstream の 720 時間デフォルトを、Auto Mode の推奨として取り込まないでください。
以下は、明示的な猶予期間とともに 168 時間後の期限切れを要求します。期限切れによりドレインが開始されますが、正確に 7 日後の正常な置換を約束するものではありません。ノードは他の理由により、より早く中断される可能性があります。
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: with-expiration
spec:
  template:
    spec:
      requirements:
      - key: eks.amazonaws.com/instance-category
        operator: In
        values:
        - m
        - c
      - key: karpenter.sh/capacity-type
        operator: In
        values:
        - on-demand
      nodeClassRef:
        group: eks.amazonaws.com
        kind: NodeClass
        name: default
      expireAfter: 168h
      terminationGracePeriod: 24h
  disruption:
    consolidationPolicy: WhenEmptyOrUnderutilized
    consolidateAfter: 1m
    budgets:
    - nodes: 10%
  limits:
    cpu: '100'
memory: 400Gi| 以前のガイドで説明されたポリシー値 | 現在の解釈 |
|---|---|
| 24–72 hours | より多くの変動を伴う、任意の短命ポリシー。各サイクルに新しいパッチが存在する証拠ではない |
| 168 hours | 上記の 7 日間の例。可用性と置換オーバーヘッドを評価すること |
| 336 hours | 文書化された Auto Mode のデフォルト期限 |
| 720 hours / 30 days | Auto Mode で文書化された 21 日間の最大値を超える。ノード再利用の約束として使用しないこと |
NodePool の中断バジェットはグレースフルな方式をレート制限しますが、期限切れ、中断、または修復に対する万能の防御ではありません。PDB と do-not-disrupt はドレイン/中断の判断に影響しますが、無期限の保持を保証しません。設定された終了猶予期間の後、残っている Pod は強制的に削除される可能性があります。stateful ワークロード、ストレージのデタッチ、アプリケーションの猶予期間、および障害シナリオを考慮するポリシーを選択してください。
ベンチマークを捏造せずにレイテンシーを診断する
以下のコマンドは、完全な Pod 仕様ではなく、選択したメタデータとステータスを収集します。証拠は非公開にしてください。スナップショットの最後の condition transition は、最初の起動マイルストーンではなく、後の transition またはフラップを反映している可能性があります。
umask 077
: "${WORK_DIR:?Use the private evidence directory from the getting-started guide}"
kubectl --context "$CLUSTER_NAME" --request-timeout=15s get nodeclaims -o json |
  jq '[.items[] | {
    claim: .metadata.name, uid: .metadata.uid,
    node: .status.nodeName, createdAt: .metadata.creationTimestamp,
    pool: .metadata.labels["karpenter.sh/nodepool"],
    expireAfter: .spec.expireAfter,
    terminationGracePeriod: .spec.terminationGracePeriod,
    conditions: [.status.conditions[]? |
      select(.type == "Launched" or .type == "Registered" or .type == "Initialized" or .type == "Ready") |
      {type, status, reason, lastTransitionTime}]
}]' > "$WORK_DIR/nodeclaims-summary.json": "${WORKLOAD_NAMESPACE:?Set the controlled test namespace}"
: "${POD_NAME:?Set the controlled test Pod name}"
kubectl --context "$CLUSTER_NAME" --request-timeout=15s -n "$WORKLOAD_NAMESPACE" \
get pod "$POD_NAME" -o json |
jq '{name: .metadata.name, uid: .metadata.uid,
createdAt: .metadata.creationTimestamp, node: .spec.nodeName, phase: .status.phase,
conditions: [.status.conditions[]? |
select(.type == "PodScheduled" or .type == "Ready") |
{type, status, reason, lastTransitionTime}]}' > "$WORK_DIR/pod-summary.json"実際のベンチマークでは、ワークロード作成時に制御された観測を開始し、オブジェクト UID と NodeClaim/ノードの割り当てを関連付け、最初のスケジューリング、ノードの準備完了、およびアプリケーションの準備完了を個別に記録します。失敗した試行/タイムアウト、環境、イメージ、およびワークロード構成を含めてください。スナップショットデータと保持された Kubernetes イベントだけでは、完全なレイテンシー分布を確立できません。
サポートされるストレージチューニング
Auto Mode はその Bottlerocket バリアントを選択します。主張されたブート時間の改善を求めて amiFamily または blockDeviceMappings を設定しないでください。この有効なストレージテンプレートは ephemeralStorage を使用しています。プロファイルとセレクターを確認済みのリソースに置き換え、この NodeClass を意図したプールから参照してください。
apiVersion: eks.amazonaws.com/v1
kind: NodeClass
metadata:
  name: image-storage-example
spec:
  instanceProfile: eks-node-instance-profile
  subnetSelectorTerms:
  - tags:
      Name: private-subnet
  securityGroupSelectorTerms:
  - tags:
      Name: eks-cluster-sg
  advancedNetworking:
    associatePublicIPAddress: false
  ephemeralStorage:
    size: 50Gi
    iops: 3000
    throughput: 125
設定を変更する前に、実際のイメージ転送、展開、CPU、ネットワーク、およびストレージのボトルネックをプロファイルしてください。以前の「Bottlerocket は 10–20 秒節約する」、「小さい EBS は 5–10 秒節約する」、「高い IOPS は 5–10 秒節約する」という数値には、検証済みの測定値がありませんでした。これらは現在のチューニング保証ではありません。小さいキャパシティは、代わりにイメージ/ephemeral-storage の圧迫を引き起こす可能性があります。
より広範な互換性のあるインスタンス/AZ の選択はキャパシティの選択肢を改善できますが、ワークロードとボリュームの制約を尊重する必要があります。プレースホルダー Pod はアイドル時のコストを伴ってキャパシティを確保できますが、ほぼ瞬時のイメージプルやアプリケーションの準備完了を保証するものではありません。
適切なシグナルを監視する
すべての Pending Pod をキャパシティリクエストとして扱うのではなく、スケジュール不可能と明示的に報告された Pod を調べてください。
kubectl --context "$CLUSTER_NAME" --request-timeout=15s \
  get pods -A --field-selector=status.phase=Pending -o json |
  jq '[.items[] | select(any(.status.conditions[]?;
    .type == "PodScheduled" and .status == "False" and .reason == "Unschedulable")) |
    {namespace: .metadata.namespace, name: .metadata.name, uid: .metadata.uid,
     createdAt: .metadata.creationTimestamp}]'
イベントは判断を説明できますが、集約、繰り返し、または期限切れになる場合があります。このクエリは明示的な events.k8s.io リソースを使用し、ワークロードデータをダンプするのではなくステータス識別子を選択します。
kubectl --context "$CLUSTER_NAME" --request-timeout=15s \
  get events.events.k8s.io -A -o json |
  jq '[.items[] |
    select(.regarding.kind == "NodeClaim" or .regarding.kind == "Node" or .regarding.kind == "Pod") |
    {time: (.eventTime // .deprecatedLastTimestamp // .metadata.creationTimestamp),
     reason, regarding: {kind: .regarding.kind, name: .regarding.name, uid: .regarding.uid},
count: (.series.count // .deprecatedCount // 1)}] | sort_by(.time)'| シグナル | 証拠とアラート設計上の考慮事項 |
|---|---|
| 継続するスケジュール不可能な Pod | Kubernetes condition と設定済みのコレクター。以前の 5 分間で >10 のしきい値は単なる例だった |
| NodeClaim の作成/失敗率 | 永続的なイベント/ログまたは計測。現在のオブジェクトのスナップショットでは、削除済みの試行は省略される |
| プロビジョニング/アプリケーションのレイテンシー | 失敗を含む関連付けられた観測。以前の p99 >120 秒のしきい値は AWS SLO ではなかった |
| 上限に近づくプールリソース | NodePool ステータス、クォータ、およびキャパシティ確認。要求/予約済みリソースと実際の使用率を区別する |
以前の karpenter_* テーブル名が組み込みの Auto Mode CloudWatch メトリクスであると想定しないでください。セルフマネージド Karpenter Prometheus メトリクス、EKS コントロールプレーンメトリクス、および独自のコレクターは個別のインターフェイスです。実際に設定された発行元からメトリクス名とディメンションを選択してください。
AWS マネージドコンポーネントログ
Auto Mode は CloudWatch Vended Logs 配信を通じてマネージドコンポーネントログを公開します。これは通常の EKS コントロールプレーンログとは別に設定されます。
- マネージド Karpenter の判断用の
AUTO_MODE_COMPUTE_LOGS AUTO_MODE_BLOCK_STORAGE_LOGSAUTO_MODE_LOAD_BALANCING_LOGSAUTO_MODE_IPAM_LOGS
文書化されたセットアップでは、delivery source、delivery destination、および delivery を使用します。有効化する前に、宛先の権限と配信/ストレージ料金を確認してください。既存のコントロールプレーン監査ログには、DisruptionBlocked、Unconsolidatable、FailedScheduling、NodeClassNotReady、終了失敗などの Kubernetes イベントも表示される場合があります。AWS のトラブルシューティングリファレンスと対象を絞った時間範囲を使用してください。これらは診断イベントであり、自動的に公開されたレイテンシーヒストグラムではありません。
参考資料
- EKS Auto Mode の動作と最大ノードライフタイム
- Auto Mode NodePool ポリシーと猶予期間
- Karpenter v1.14 の中断とドリフト
- Auto Mode NodeClass フィールド
- Auto Mode のトラブルシューティング
- AWS マネージドコンポーネントログの配信
< 前へ: NodePool 構成 | 目次 | 次へ: Spot 戦略 >