Prometheus
最終更新: September 13, 2026. 以下ではローカルでの設定/クエリ検証について説明します。クラスターやクラウドへのデプロイは実施していません。
目次
- 概要とバージョン
- アーキテクチャとコンポーネント
- PromQL
- ディスカバリと Operator セレクター
- kube-prometheus-stack のインストール
- ルールと Alertmanager
- Remote write と AMP
- パフォーマンス、HA、トラブルシューティング
概要とバージョン
Prometheus は、もともと SoundCloud で開発された CNCF の監視ツールキットです。数値の時系列を収集してローカル TSDB に保存し、PromQL と recording/alert ルールを評価して、アラートを Alertmanager に送信します。通常の収集は HTTP スクレイピングを使用し、remote write やオプションのバッチ連携が別の配信経路を追加します。イベントログ、トレースストア、リクエスト単位の正確な課金台帳ではありません。
ローカルの保持期間は設定可能で、30 日を超えることもできます。別のストアを使うかどうかは、保持期間、容量、共有クエリ、障害/復旧の要件によって決まる選択です。
この章では、2026 年 9 月 6 日にリリースされた公式の kube-prometheus-stack 90.0.0 パッケージを使用します。そのコンポーネントバージョンは一つのまとまりとして確認しました。
| コンポーネント | パッケージのデフォルト |
|---|---|
| Prometheus Operator | 0.93.1 |
| Prometheus | 3.14.0, distroless イメージ |
| Alertmanager | 0.34.0 |
| Grafana | 13.2.1, サブチャート 13.2.2 |
| kube-state-metrics | 2.20.0, サブチャート 8.4.2 |
| node-exporter | 1.12.1, サブチャート 4.56.3 |
チャートの kubeVersion ガードは >=1.25.0-0 です。これは完全な互換性マトリクスではなく、Kubernetes 1.25 以降のすべてのバージョンが引き続きサポートされるという意味でもありません。実際のクラスター、コンポーネントのサポート状況、admission ポリシー、ストレージドライバーを確認してください。
このプロファイルは Linux EC2 ベースの EKS ワーカー を対象としています。Fargate には DaemonSet がありません。Auto Mode、Hybrid Nodes、Windows では、プラットフォーム固有のコレクター/ストレージ確認が必要です。
2026 年 7 月の更新履歴
- 7 月 14 日の Kubernetes exporter に関する記事 では、アプリケーションの計装とカスタム exporter について説明されています。HPA で利用するには、適切な metrics API/アダプターも必要です。スクレイピングだけでは任意のメトリクスが HPA に接続されるわけではありません。
- 7 月 21 日の AMP のアナウンス では、ワークスペースあたり最大 15 億のアクティブ系列と 200,000 の recording/alerting ルールが説明されています。これらはアナウンスされたスケーリング上限であり、自動的に付与されるデフォルトクォータや承認の保証ではありません。対象のワークスペース/アカウントの現在のクォータを確認してください。
アーキテクチャとコンポーネント
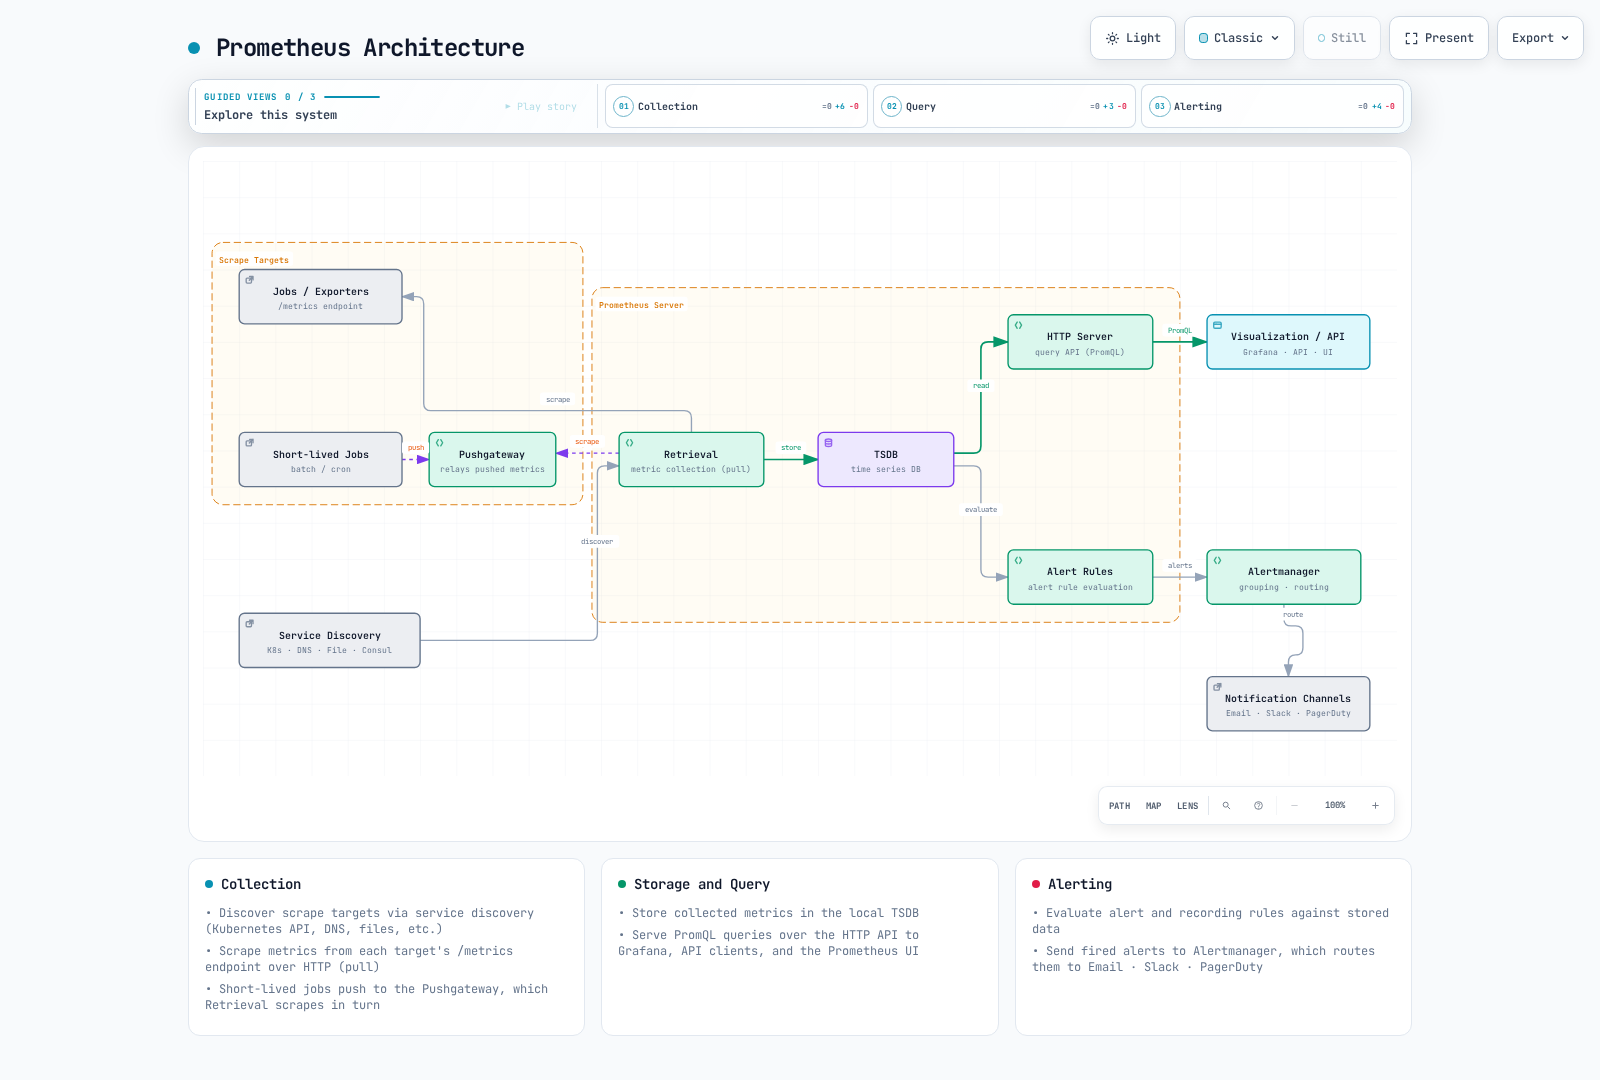
Pushgateway の分岐は、適切なサービスレベルのバッチジョブに対するオプションであり、すべての短命な Pod のためのものではありません。グループにはライフサイクル管理が必要です。メトリクス概要を参照してください。up はスクレイピングの健全性を示すもので、アプリケーションの可用性ではありません。
| コンポーネント | 役割と前提条件 |
|---|---|
| Prometheus | ディスカバリ、スクレイピング、ローカル TSDB、クエリ API、ルール評価 |
| kube-state-metrics | API オブジェクトの状態。ServiceAccount、RBAC、スクレイプエンドポイントが必要 |
| node-exporter | ホスト OS のメトリクス。ホストアクセス/マウントとプラットフォームサポートの確認が必要 |
| kubelet/cAdvisor | コンテナの測定値。サービング証明書、認可、エンドポイントの可用性を検証 |
| metrics-server / アダプター | オートスケーリング用のリソース/カスタムメトリクス API。履歴用 TSDB ストレージとは別物 |
| Alertmanager | アラートのグループ化、重複排除、抑止、設定済みレシーバーへのルーティング |
| Grafana | データソースのクエリ/可視化。認証とデータベース/ストレージには個別の設定が必要 |
チャートは exporter と補助リソースを提供します。不完全な単体の Deployment/DaemonSet スニペットは、不足している ServiceAccount、RBAC、Service を補うものではなく、監視スタックを重複して作成すべきではありません。
TSDB と設定のレイヤー
直近のサンプルは head/WAL を使用します。コンパクション済みブロックには chunk、index、メタデータが含まれます。tombstone は削除された範囲を示します。WAL のリプレイはクラッシュ復旧に役立ちますが、バックアップの代わりにはならず、ボリューム消失に耐えることも、すべてのイベントの復旧を保証することもできません。
| レイヤー | 正しい設定項目 |
|---|---|
| プロセスのフラグ | --storage.tsdb.path, --storage.tsdb.retention.time, --storage.tsdb.retention.size |
| Prometheus の設定 | global, scrape_configs, rule_files, remote_write |
Operator の Prometheus.spec | retention, retentionSize, storage, replicas, shards |
| このチャートの values | prometheus.prometheusSpec.retention, storageSpec および以下の値 |
古い storage.tsdb.path/retention.time/... の YAML は、有効なプロセス設定ではありません。別個のスタンドアロンインストール では、基本的なフラグは次のようになります。
prometheus --config.file=prometheus.yml \
  --storage.tsdb.path=/prometheus \
  --storage.tsdb.retention.time=15d \
  --storage.tsdb.retention.size=15GB
Operator によるインストールでは、所有元の Helm values を設定します。保持サイズはディスク全体のハードリミットではありません。WAL、head、index、コンパクション用の余裕を残してください。サポートされているローカル/ブロックストレージを使用してください。任意の NFS はサポートされた代替ではありません。
PromQL
例では job="example-app" と、チャートの node-exporter/kube-state-metrics のジョブラベルを前提としています。実際のターゲットに合わせて調整してください。example_queue_depth と temperature_celsius はアプリケーション定義の Gauge であり、Kubernetes 組み込みのメトリクスではありません。
セレクター、範囲、レート
インスタントセレクターは lookback/staleness のルールに従って対象となるサンプルを探します。「現在」の値であっても、評価時点そのものに観測値があることは保証されません。範囲セレクターはサンプル区間を選択します。サブクエリは指定した解像度で式を評価するもので、保存された生サンプルの N 個ごとを選択するものではありません。
| 目的 | PromQL |
|---|---|
| インスタントセレクター | http_requests_total{job="example-app"} |
| 肯定/正規表現によるフィルタリング | http_requests_total{job="example-app",method="GET",status=~"2[0-9]{2}"} |
| 否定の正規表現 | http_requests_total{job="example-app",status!~"5[0-9]{2}"} |
| 範囲ベクトル | http_requests_total{job="example-app"}[5m] |
| 5 分解像度の 1 時間サブクエリ | rate(http_requests_total{job="example-app"}[5m])[1h:5m] |
| 1 時間前のレートウィンドウ | rate(http_requests_total{job="example-app"}[5m] offset 1h) |
| Counter の平均秒間レート | rate(http_requests_total{job="example-app"}[5m]) |
| 直近の利用可能な 2 サンプルからのレート | irate(http_requests_total{job="example-app"}[5m]) |
| 外挿された Counter の増加量 | increase(http_requests_total{job="example-app"}[1h]) |
否定のマッチャーは、そのラベルを持たない系列を選択することがあります。rate() と increase() は観測されたリセットを処理し外挿を行いますが、見逃されたすべての増分を復元できるわけではありません。集約の前に rate を適用 してください。irate() は最新のサンプルに敏感で、安定したアラート条件にはあまり適していません。
範囲ベクトルは範囲関数への入力であり、そのままレンジクエリのグラフになるものではありません。たとえば、評価済みのレート系列が必要な場合は rate(counter[5m]) を使用します。
集約、Gauge、時刻
| 目的 | PromQL |
|---|---|
| メソッド別のリクエストレート | sum by (method) (rate(http_requests_total{job="example-app"}[5m])) |
| instance を集約で除去 | sum without (instance) (rate(http_requests_total{job="example-app"}[5m])) |
| 重複排除した Running 指標の合計 | sum(max by (namespace,pod,uid) (kube_pod_status_phase{job="kube-state-metrics",phase="Running"})) |
| 利用可能メモリの最大値 | max(node_memory_MemAvailable_bytes{job="node-exporter"}) |
| 空/インフラコンテナラベルを除いた Pod CPU 上位 | topk(5, sum by (namespace,pod) (rate(container_cpu_usage_seconds_total{job="kubelet",container!="",container!="POD"}[5m]))) |
| 現在のキュー深度 Gauge 全体の分位点 | quantile(0.95, example_queue_depth{job="example-app"}) |
| レートの標準偏差 | stddev(rate(http_requests_total{job="example-app"}[5m])) |
| 外挿された Gauge の変化量 | delta(temperature_celsius{job="example-app"}[1h]) |
| Gauge の秒あたり傾き | deriv(temperature_celsius{job="example-app"}[1h]) |
| 20°C からの絶対偏差 | abs(temperature_celsius{job="example-app"} - 20) |
| 切り上げ | ceil(example_queue_depth{job="example-app"}) |
| 範囲へのクランプ | clamp(example_queue_depth{job="example-app"}, 0, 100) |
| 平方根 | sqrt(example_queue_depth{job="example-app"}) |
| 自然対数 | ln(example_queue_depth{job="example-app"}) |
| Unix 秒での評価時刻 | time() |
| 選択されたサンプルのタイムスタンプ | timestamp(up{job="example-app"}) |
| サンプルの UTC 時 | hour(timestamp(up{job="example-app"})) |
kube_pod_status_phase{phase="Running"} の系列をカウントすると、値が 0 のものも数えてしまいます。重複した exporter の識別情報を除いたうえで 0/1 の指標を合計すると、0 の指標だけが存在する場合は 0 になり、テレメトリが存在しない場合は依然として欠損のままになります。
Gauge に対する quantile() の例は、系列間で値を比較します。ヒストグラムのリクエストレイテンシ p95 を計算するものではなく、Summary の p99 値を統合するものでもありません。数学関数には入力の定義域の制約があります。たとえば、非正の値の対数は意図的な処理が必要です。関連する関数として floor、round、clamp_min、clamp_max があります。
次の営業時間フィルターは UTC であり、ブラウザやクラスターのタイムゾーンではありません。
sum(rate(http_requests_total{job="example-app"}[5m])) and on() (hour() >= 9 < 18)分布と予測
histogram_quantile(0.95, sum by (le) (rate(http_request_duration_seconds_bucket{job="example-app"}[5m])))histogram_quantile(0.99, sum by (le,method) (rate(http_request_duration_seconds_bucket{job="example-app"}[5m])))sum(rate(http_request_duration_seconds_sum{job="example-app"}[5m])) / sum(rate(http_request_duration_seconds_count{job="example-app"}[5m]))互換性のあるクラシックバケットを集約し、le を保持してください。分位点はバケット内で補間されます。Summary の分位点も近似値であり、平均をとってフリート全体のパーセンタイルにすることはできません。sum/count はフリート全体の平均を計算できます。
predict_linear() は Gauge にフィットさせたトレンドを外挿します。負の予測値は調査すべき理由であり、将来のディスク障害が保証されるわけではありません。
predict_linear(node_filesystem_avail_bytes{job="node-exporter",mountpoint="/",fstype!~"tmpfs|overlay"}[6h], 86400)Prometheus 3 では holt_winters が double_exponential_smoothing に改名されました。これは Holt の線形スムージングであり、季節性を扱う三重指数平滑法の予測ではありません。また Gauge の float サンプルが必要です。任意で使える式: double_exponential_smoothing(example_queue_depth{job="example-app"}[1h], 0.5, 0.5)。評価するサーバーには --enable-feature=promql-experimental-functions が必要です。ローカル監査ではパーサー構文を確認しました。実験的機能の値の評価が通ったとは主張していません。
運用上の例
| 目的 | PromQL |
|---|---|
| CPU の非アイドル率 | 100 * (1 - avg by (instance) (rate(node_cpu_seconds_total{job="node-exporter",mode="idle"}[5m]))) |
| MemAvailable として報告されていない割合 | 100 * (1 - node_memory_MemAvailable_bytes{job="node-exporter"} / node_memory_MemTotal_bytes{job="node-exporter"}) |
| 再起動の推定増加が 3 を超える場合 | increase(kube_pod_container_status_restarts_total{job="kube-state-metrics"}[1h]) > 3 |
| ファイルシステムの利用不可領域の割合 | 100 * (1 - node_filesystem_avail_bytes{job="node-exporter",mountpoint="/"} / node_filesystem_size_bytes{job="node-exporter",mountpoint="/"}) |
| 受信 + 送信バイト毎秒 | rate(node_network_receive_bytes_total{job="node-exporter",device="eth0"}[5m]) + rate(node_network_transmit_bytes_total{job="node-exporter",device="eth0"}[5m]) |
エラー率については、正常なサービスには 5xx の系列が存在しないこともあります。以下のゼロフォールバックは、トラフィック総量のグループと一致させるためだけに存在します。欠損しているサービスに対して正常なデータを作り出すものではありません。
100 * (sum by (namespace, service) (rate(http_requests_total{job="example-app",status=~"5[0-9]{2}"}[5m])) or on (namespace, service) (0 * (sum by (namespace, service) (rate(http_requests_total{job="example-app"}[5m]))))) / (sum by (namespace, service) (rate(http_requests_total{job="example-app"}[5m])))観測された正常なトラフィックでは 0 になり、すべて 5xx のトラフィックでは 100 になり、分母が 0 の場合は未定義のままです。欠損したテレメトリは欠損したままです。収集の失敗は別に監視してください。
ディスカバリと Operator セレクター
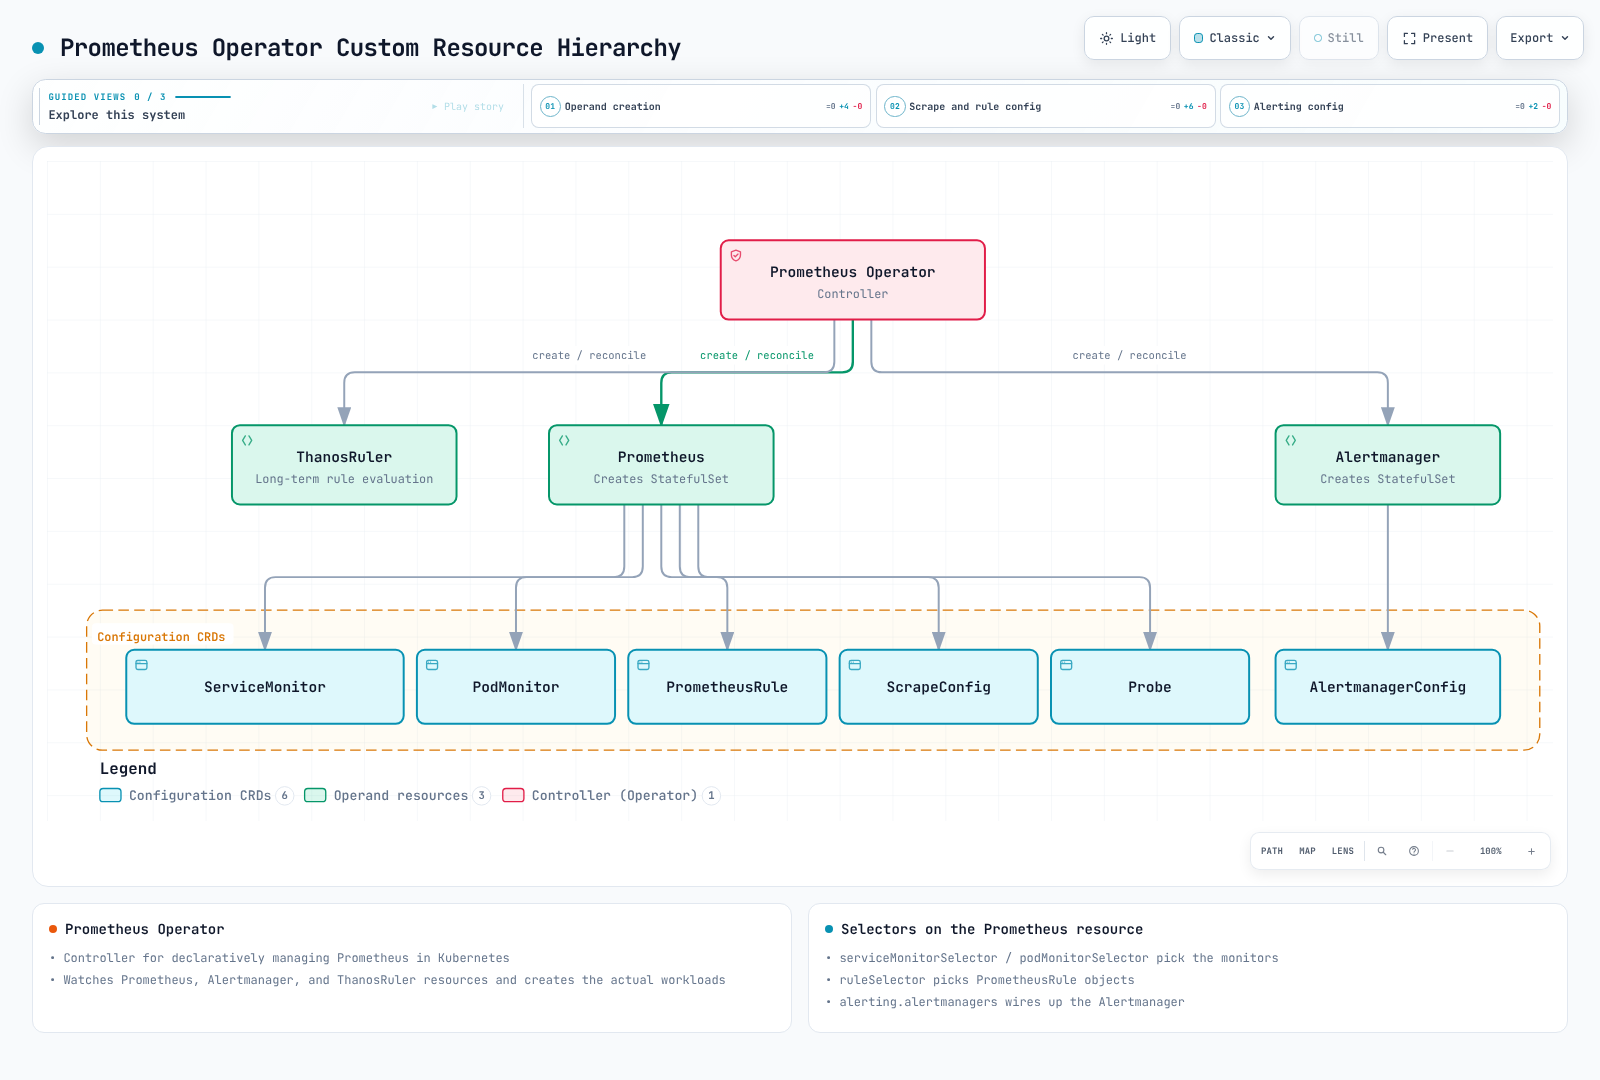
この図中の Prometheus/Alertmanager ノードは カスタムリソース を意味します。Operator がそれらを読み取り、StatefulSet などの実際のワークロードを調整(reconcile)します。オブジェクトや Prometheus サーバー自体が独自に StatefulSet を作成するわけではありません。
| 選択の段階 | 選択されるオブジェクト |
|---|---|
Prometheus の serviceMonitorNamespaceSelector | ServiceMonitor オブジェクトを含む Namespace |
Prometheus の serviceMonitorSelector | それら ServiceMonitor オブジェクトのラベル |
ServiceMonitor の namespaceSelector / selector | 対象 Service の Namespace とラベル |
ServiceMonitor エンドポイントの port | Service のポート名。任意のコンテナポート番号ではない |
PodMonitor の selector / エンドポイントの port | Pod のラベルと宣言されたコンテナポート名 |
RBAC、ディスカバリ、ネットワーク/TLS アクセスは別個の要件です。セレクターは認可の代わりにはなりません。Helm の *SelectorNilUsesHelmValues の真偽値はラベルセレクターのデフォルトに影響するもので、すべての対象 Namespace に影響するわけではありません。
一貫したアプリケーションのスクレイピング
example-app に計装済みの Deployment が既に存在し、Pod ラベルが app: example-app、/metrics を提供する metrics という名前のポートが宣言されていることを前提とします。以下の Service はアプリケーションを作成するものではありません。
# service.yaml
apiVersion: v1
kind: Service
metadata:
  name: example-app
  namespace: example-app
  labels:
    app: example-app
    metrics-job: example-app
spec:
  selector:
    app: example-app
  ports:
  - name: http-metrics
    port: 8080
targetPort: metrics# servicemonitor.yaml
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
name: example-app
namespace: monitoring
labels:
release: kube-prom
spec:
jobLabel: metrics-job
selector:
matchLabels:
app: example-app
namespaceSelector:
matchNames:
- example-app
endpoints:
- port: http-metrics
path: /metrics
interval: 30s
scrapeTimeout: 10s
relabelings:
- sourceLabels:
- __meta_kubernetes_service_name
targetLabel: service
- sourceLabels:
- __meta_kubernetes_namespace
targetLabel: namespace
- sourceLabels:
- __meta_kubernetes_pod_name
targetLabel: podServiceMonitor の release: kube-prom はインストールと一致します。その jobLabel は Service の metrics-job: example-app を読み取り、アプリケーションクエリ用のジョブラベルを確立します。
PodMonitor は同じ Pod に対する 代替手段 です。重複した取り込みを避けるため、あるエンドポイントには意図した収集経路を 1 つ選んでください。
# podmonitor.yaml
apiVersion: monitoring.coreos.com/v1
kind: PodMonitor
metadata:
  name: example-app-pods
  namespace: monitoring
  labels:
    release: kube-prom
spec:
  selector:
    matchLabels:
      app: example-app
  namespaceSelector:
    matchNames:
    - example-app
  podMetricsEndpoints:
  - port: metrics
    interval: 30s
    path: /metrics
    relabelings:
    - targetLabel: job
      replacement: example-app
    - targetLabel: service
      replacement: example-app
その他のディスカバリ経路
- スタンドアロン/エージェントの Pod ディスカバリでは、概要の名前付きポート設定を使用でき、ディスカバリが提供する IPv4/IPv6 アドレスを保持できます。
prometheus.io/schemeのようなアノテーションは、実際の設定がそれを利用しない限り効果はありません。 - Service のブラックボックス監視には、インストール済みの exporter、定義済みの probe モジュール、適切なターゲット URL/スキーム、そして
Probe/スクレイプ設定が必要です。upは exporter のスクレイピングを表します。probe の成否は別のシグナルです。 - ノードのディスカバリが到達するのは kubelet のエンドポイントであり、自動的に node-exporter に到達するわけではありません。サービング証明書、正しい CA、ノードメトリクスの RBAC を検証してください。Kubernetes API の CA は、任意のノード証明書に対する信頼を証明しません。
- 無制限なノードの
labelmapではなく、レビュー済みの namespace/service/team ラベルを使用してください。識別ラベルの削除は集約操作ではありません。
kube-prometheus-stack のインストール
以下はクラスターを変更するオペレーター向けのコマンドであり、監査で実行したコマンドではありません。意図したコンテキストと自分が所有するリリースを使用してください。既存のインストールに対しては、スタックを重複してインストールするのではなく、実際の values、CRD、ストレージ、アップグレードノートを確認してください。
このプロファイルの前提条件:
- 権限のある Helm/Kubernetes アクセスと、十分な Linux EC2 ノードリソース。
- 動作するデフォルトのブロックストレージ StorageClass/CSI ドライバー、またはすべての PVC に対して明示的にレビュー済みのクラス名。
gp3の存在は保証されません。 - Linux EC2 ノード上に、既存の
monitoringNamespace、Secrets Store CSI ドライバー、AWS プロバイダー(ASCP)。AWS Secrets Manager(ap-northeast-2)でobservability/grafana-adminを JSON 文字列キーadmin-passwordとして用意してください。Kubernetes Secret へ同期しないでください。 metrics-demo-grafanaサービスアカウントには、そのシークレットに限定した IRSA ロールが必要です。以下の例の IAM ロール ARN を置き換え、対応する SecretProviderClass を適用してください。アイデンティティ、KMS、マウント、ローテーションの完全な前提条件を参照してください。- 検証済みの kubelet TLS 信頼。このプロファイルは証明書検証を有効にします。証明書が別の発行者を使用している場合は、検証を回避するのではなく適切な CA を提供してください。
サイジングは例示です。各 Prometheus レプリカは専用の PVC を持ちます。保持サイズは WAL/head/コンパクションの使用量を制限しません。Grafana は PVC ベースのデータベースを持つ 1 レプリカのままです。レプリカを増やすだけでは、共有データベースによる HA にはなりません。
# kube-prometheus-stack 90.0.0; replace the example IRSA role ARN before use.
fullnameOverride: metrics-demo
kubeControllerManager:
  enabled: false
kubeScheduler:
  enabled: false
kubeEtcd:
  enabled: false
kubeProxy:
  enabled: false
kubelet:
  serviceMonitor:
    tlsConfig:
      insecureSkipVerify: false
prometheus:
  serviceAccount:
    create: true
    name: metrics-demo-prometheus
  prometheusSpec:
    replicas: 1
    shards: 1
    retention: 15d
    retentionSize: 15GB
    storageSpec:
      volumeClaimTemplate:
        spec:
          accessModes:
          - ReadWriteOnce
          resources:
            requests:
              storage: 20Gi
    resources:
      requests:
        cpu: 500m
        memory: 2Gi
      limits:
        memory: 4Gi
    externalLabels:
      cluster: eks-metrics-demo
    serviceMonitorSelectorNilUsesHelmValues: true
    serviceMonitorNamespaceSelector: &id001
      matchExpressions:
      - key: kubernetes.io/metadata.name
        operator: In
        values:
        - monitoring
        - example-app
    podMonitorSelectorNilUsesHelmValues: true
    podMonitorNamespaceSelector: *id001
    ruleSelectorNilUsesHelmValues: true
    ruleNamespaceSelector:
      matchLabels:
        kubernetes.io/metadata.name: monitoring
alertmanager:
  alertmanagerSpec:
    replicas: 1
    storage:
      volumeClaimTemplate:
        spec:
          accessModes:
          - ReadWriteOnce
          resources:
            requests:
              storage: 5Gi
grafana:
  fullnameOverride: metrics-demo-grafana
  replicas: 1
  persistence:
    enabled: true
    size: 10Gi
  sidecar:
    dashboards:
      searchNamespace: monitoring
      skipReload: true
      initDashboards: true
      provider:
        updateIntervalSeconds: 30
    datasources:
      searchNamespace: monitoring
      skipReload: true
      initDatasources: true
  serviceAccount:
    create: true
    name: metrics-demo-grafana
    annotations:
      eks.amazonaws.com/role-arn: arn:aws:iam::111122223333:role/metrics-grafana-secrets
  env:
    GF_SECURITY_ADMIN_USER: admin
    GF_SECURITY_ADMIN_PASSWORD: $__file{/mnt/grafana-secrets/admin-password}
  grafana.ini:
    security:
      admin_user: admin
      admin_password: $__file{/mnt/grafana-secrets/admin-password}
  extraVolumes:
  - name: grafana-secrets
    csi:
      driver: secrets-store.csi.k8s.io
      readOnly: true
      volumeAttributes:
        secretProviderClass: metrics-grafana-admin
  extraVolumeMounts:
  - name: grafana-secrets
    mountPath: /mnt/grafana-secrets
    readOnly: true
この EKS プロファイルは、マネージドなコントロールプレーンコンポーネントと、ここでは公開を前提としない kube-proxy エンドポイントに対するモニターを無効化します。Kubernetes 自体を無効化するものではありません。monitoring/example-app の ServiceMonitor には一致するリリースラベルが必要です。ルールは monitoring から選択されます。
Grafana の GF_SECURITY_ADMIN_PASSWORD には、パスワードの値ではなく リテラルのファイルプロバイダー式 が渡されます。これによりチャートの自動的な認証情報の環境変数参照が抑制されます。Grafana 13.2.1 は、環境変数によるオーバーライドの後に設定内で $__file{...} を評価します。__FILE のエントリポイントやシェルがファイル内容をエクスポートするわけではありません。読み取り専用の CSI ファイルは UID/GID 472 で読み取れる必要があり(fsGroup: 472、モード 0440)、マウントするのはメインの Grafana コンテナのみです。パスワードは先頭・末尾に空白を含まないものを使用してください。ファイルプロバイダーはそれをトリムします。
ダッシュボード/データソースの init コンテナは、起動前にプロビジョニングファイルを配置します。サイドカーはファイルを監視し続けますが skipReload: true を使用するため、いずれも管理者の認証情報を必要としません。Grafana はダッシュボードファイルを 30 秒ごとにポーリングします。データソースの更新には制御された Pod の再起動が必要です。admin_password は新規データベースの初期化時のみ有効です。AWS のシークレット変更、CSI のローテーション、再起動によって、既存の PVC/データベース内の管理者パスワードがリセットされることはありません。承認されたパスワード変更/SSO の手順を使用し、シークレットを整合させてください。PVC は保持してください。
grafana-secret-provider.yaml を含む再利用可能なプロファイル全体を使用してください。ローカルでのレンダリング/テストは設定とマウントを対象としており、実環境の CSI 権限、ログイン、ローテーションは対象外です。主要な契約: Grafana の設定とAWS ASCP。
リポジトリのルートから、前提条件を整えたうえで一度インストールします。
PROFILE=examples/observability/secret-profiles
kubectl apply -f "$PROFILE/grafana-secret-provider.yaml"
helm repo add prometheus-community https://prometheus-community.github.io/helm-charts
helm repo update prometheus-community
helm template kube-prom prometheus-community/kube-prometheus-stack \
  --version 90.0.0 --namespace monitoring -f "$PROFILE/prometheus-values.yaml" \
  > grafana-reviewed-render.yaml
# Review resources, prerequisites and ownership before this cluster-changing command.
helm upgrade --install kube-prom prometheus-community/kube-prometheus-stack \
  --version 90.0.0 --namespace monitoring -f "$PROFILE/prometheus-values.yaml" \
  --wait --timeout 15m
CRD の確立、Operator の健全性、PVC のバインド、実際のターゲットを確認してください。選択したアプリケーションのモニター/ルールは、それらの CRD が確立された後にのみ適用してください。
チャートの CRD アップグレードの扱いはバージョン固有です。すべての CRD 移行が単純な Helm アップグレードでカバーされると想定せず、アップグレードノートを読んでください。チャート 90 では Grafana の依存関係もコミュニティリポジトリに変更されます。アップグレード時は既存の認証/プロビジョニングの values を検証し、データベース/PVC のバックアップを保持してください。
ルールと Alertmanager
以下で選択している PrometheusRule には、alert と recording の例が含まれます。CPU の recording は rate と比率の単位を一貫して使用します。エラーの式はパーセンテージなので、しきい値は 1 であり、アノテーションはパーセンテージを出力します。
# prometheusrule.yaml
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: example-rules
  namespace: monitoring
  labels:
    release: kube-prom
spec:
  groups:
  - name: example-alerts
    interval: 30s
    rules:
    - alert: NodeMemoryHigh
      expr: 100 * (1 - node_memory_MemAvailable_bytes{job="node-exporter"} / node_memory_MemTotal_bytes{job="node-exporter"})
        > 90
      for: 5m
      labels:
        severity: warning
        team: infrastructure
      annotations:
        summary: Node {{ $labels.instance }} memory availability is low
        description: '{{ printf "%.2f" $value }}% is not reported as MemAvailable.'
    - alert: PodRestartingFrequently
      expr: increase(kube_pod_container_status_restarts_total{job="kube-state-metrics"}[1h]) > 5
      for: 10m
      labels:
        severity: warning
      annotations:
        summary: Pod {{ $labels.namespace }}/{{ $labels.pod }} is restarting
        description: '{{ printf "%.2f" $value }} estimated restarts in one hour.'
    - alert: ProjectedDiskExhaustion
      expr: predict_linear(node_filesystem_avail_bytes{job="node-exporter",mountpoint="/",fstype!~"tmpfs|overlay"}[6h],
        86400) < 0
      for: 1h
      labels:
        severity: warning
      annotations:
        summary: Projected disk exhaustion on {{ $labels.instance }}
        description: The fitted six-hour trend projects negative free space in 24 hours; inspect the filesystem
          and workload.
    - alert: HighErrorRate
      expr: (100 * (sum by (namespace, service) (rate(http_requests_total{job="example-app",status=~"5[0-9]{2}"}[5m]))
        or on (namespace, service) (0 * (sum by (namespace, service) (rate(http_requests_total{job="example-app"}[5m])))))
        / (sum by (namespace, service) (rate(http_requests_total{job="example-app"}[5m])))) > 1
      for: 5m
      labels:
        severity: warning
        team: backend
      annotations:
        summary: High error rate on {{ $labels.namespace }}/{{ $labels.service }}
        description: '{{ printf "%.2f" $value }}% of requests are 5xx, above the 1% threshold.'
  - name: example-recording
    rules:
    - record: instance:node_cpu_utilization:ratio_rate5m
      expr: 100 * (1 - avg by (instance) (rate(node_cpu_seconds_total{job="node-exporter",mode="idle"}[5m])))
        / 100
    - record: instance:node_memory_not_available:ratio
      expr: max by (instance) ((1 - node_memory_MemAvailable_bytes{job="node-exporter"} / node_memory_MemTotal_bytes{job="node-exporter"}))
for は、発火する前に同じアラートラベルセットが評価を通じて式を満たし続けなければならないことを意味します。データの欠損やラベルの変化は pending 状態を中断させることがあります。これは Alertmanager の通知遅延や再送間隔ではありません。予測に基づくアラートは見通しを表すもので、障害の確定を示すものではありません。
AlertmanagerConfig と Namespace の境界
Operator 0.93.1 に同梱される AlertmanagerConfig CRD は v1alpha1 を提供します。この例では、管理者が所有する グローバル設定 として使用します。参照される Secret は monitoring に存在しなければなりません。配信を有効にする前に、アドレス、チャンネル、プロバイダーの宛先を置き換え/承認してください。
Operator の API は alertmanagerConfiguration を experimental としています。バージョンの境界を維持し、アップグレードをテストしてください。通常の選択された Namespace 付き AlertmanagerConfig には、通常 Namespace のマッチャーが付与されます。monitoring にある設定が、すべての Namespace のアプリケーションアラートを自動的に受け取るわけではありません。グローバル設定は意図的に、より広い管理境界を持ちます。
# alertmanagerconfig.yaml
apiVersion: monitoring.coreos.com/v1alpha1
kind: AlertmanagerConfig
metadata:
  name: main-config
  namespace: monitoring
spec:
  route:
    receiver: default
    groupBy:
    - alertname
    - namespace
    - severity
    groupWait: 30s
    groupInterval: 5m
    repeatInterval: 4h
    routes:
    - receiver: pagerduty-critical
      matchers:
      - name: severity
        matchType: '='
        value: critical
      groupWait: 10s
      repeatInterval: 1h
    - receiver: slack-backend
      matchers:
      - name: team
        matchType: '='
        value: backend
    - receiver: slack-warnings
      matchers:
      - name: severity
        matchType: '='
        value: warning
      groupWait: 1m
  inhibitRules:
  - sourceMatch:
    - name: severity
      matchType: '='
      value: critical
    targetMatch:
    - name: severity
      matchType: '='
      value: warning
    equal:
    - alertname
    - cluster
    - namespace
    - service
    - instance
    - pod
    - container
  receivers:
  - name: default
    emailConfigs:
    - to: alerts@example.com
      from: alertmanager@example.com
      smarthost: smtp.example.com:587
      authUsername: alertmanager
      authPassword:
        name: alertmanager-smtp
        key: password
      requireTLS: true
  - name: slack-backend
    slackConfigs:
    - apiURL:
        name: alertmanager-slack
        key: webhook-url
      channel: '#team-backend-alerts'
      sendResolved: true
  - name: slack-warnings
    slackConfigs:
    - apiURL:
        name: alertmanager-slack
        key: webhook-url
      channel: '#alerts'
      sendResolved: true
  - name: pagerduty-critical
    pagerdutyConfigs:
    - routingKey:
        name: alertmanager-pagerduty
        key: routing-key
      sendResolved: true
デフォルトでは、同階層のルートは最初にマッチした時点で停止します。critical のルートが先に来ます。backend のルートは一般的な warning のルートより前にあるため、到達可能です。複数の配信を意図する場合にのみ、continue を意図的に設定してください。抑止はアラート名だけでなくリソースの識別情報にも一致します。あるサービス/ノードの critical アラートが、無関係な warning を抑止してはいけません。アラートのファミリーに対して意味のある equal ラベルのフィールドを選んでください。両方のアラートに存在しないラベルは、等しいとみなされます。
CR の groupBy は、ネイティブな Alertmanager 設定では group_by になります。グルーピングは通知のバッチを制御するもので、同一アラートの重複排除と同じではありません。groupWait、groupInterval、repeatInterval は、PrometheusRule の for とは別に通知のタイミングを制御します。
参照される Secret と AlertmanagerConfig を作成した後、この追加の values ファイルを 同じ 固定リリースにマージします。
# alerting-values.yaml
alertmanager:
  alertmanagerSpec:
    alertmanagerConfiguration:
name: main-confighelm upgrade --install kube-prom prometheus-community/kube-prometheus-stack \
--version 90.0.0 --namespace monitoring \
-f values.yaml -f alerting-values.yaml --wait --timeout 15mネイティブなルーティングの確認では、通知を送信せずにレシーバー名を使用しました。Secret の取得、プロバイダーの認証、実際の通知配信は、依然として管理された検証が必要です。
Remote write と AMP
remote write は、設定されたバックエンドへサンプルを非同期に転送します。アラートを配信するものではなく、無制限のバッファリングを保証するものでも、バックアップの代わりになるものでもありません。バックログ、リトライ、レシーバーの上限を監視してください。レビュー済みの集約/破棄ポリシーによってその影響が明確になっていない限り、ヒストグラムの分布は完全な形で保持してください。
権限を限定した AMP への取り込み
以下のアカウントとワークスペースの識別子は 架空のプレースホルダー です。エンドポイント、IAM リソース、ロールのアノテーションで、承認済みの Region/アカウント/ワークスペースに一貫して置き換えてください。取り込み用ロールに必要なのは、そのワークスペースに対する aps:RemoteWrite のみです。クエリ権限は適切なクエリクライアントに属するもので、コレクターに自動的に与えられるものではありません。
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": "aps:RemoteWrite",
      "Resource": "arn:aws:aps:ap-northeast-2:111122223333:workspace/ws-11111111-1111-4111-8111-111111111111"
    }
  ]
}
ロールは、環境の既存の IaC のオーナーを通じて作成/管理してください。IRSA の例では、その信頼関係が対象クラスターの IAM OIDC プロバイダーを参照し、audience sts.amazonaws.com と subject system:serviceaccount:monitoring:metrics-demo-prometheus の両方を要求する必要があります。OIDC の issuer URL だけでは、IAM プロバイダー/信頼関係が存在することの証明にはなりません。
このプロファイルの ServiceAccount とアノテーションは Helm が所有します。同じ ServiceAccount を別のオーナーからも作成しないでください。既存のアカウントを再利用する場合は、所有関係とチャートの create 設定を整合させてください。EKS Pod Identity は別の認証情報配布の設計です。互換性のない前提を混在させるのではなく、個別に設定・検証してください。
# amp-values.yaml
prometheus:
  serviceAccount:
    create: true
    name: metrics-demo-prometheus
    annotations:
      eks.amazonaws.com/role-arn: arn:aws:iam::111122223333:role/metrics-prometheus-amp
  prometheusSpec:
    replicas: 2
    shards: 1
    podAntiAffinity: hard
    podAntiAffinityTopologyKey: kubernetes.io/hostname
    replicaExternalLabelName: __replica__
    externalLabels:
      cluster: eks-metrics-demo
    remoteWrite:
    - url: https://aps-workspaces.ap-northeast-2.amazonaws.com/workspaces/ws-11111111-1111-4111-8111-111111111111/api/v1/remote_write
      sigv4:
        region: ap-northeast-2
      queueConfig:
        capacity: 10000
        maxSamplesPerSend: 2000
        maxShards: 10
アイデンティティ/ワークスペースの検証後、オプションの AMP ファイルを同じリリースでベースの values とマージしてください。ノードに対する hard な anti-affinity を持つ 2 レプリカには、少なくとも 2 つの適切なノードと、レプリカごとに機能する PVC が必要です。
AMP の HA 重複排除は cluster と __replica__ を前提とします。Operator の replicaExternalLabelName は、サポートされた Pod 単位の識別情報を提供します。手書きの追加レプリカラベルは代替になりません。既存のメトリクスラベルと HA ラベルの衝突を確認してください。
この例では意図的に shards: 1 を使用しています。シャーディングはターゲットの集合を分割し、レプリケーションはターゲット集合を複製します。シャーディングを導入する場合、各シャードの HA レプリカグループには個別の重複排除の識別情報と、完全なクエリを行える設計が必要です。独立したシャードを 1 つの HA 識別情報の下で送信し、データが欠落しないと想定してはいけません。
これらのクエリはローカルクラスターを対象としています。クラスターをまたぐ中央/AMP のクエリでは、意図したクラスターのスコープを含めるか、明示的に集約する必要があります。
その他のレシーバー
VictoriaMetrics のシングルノードは、一般的に設定された HTTP ポートで /api/v1/write を受け付けます。クラスターの vminsert エンドポイントは /insert/<tenant>/prometheus/api/v1/write を使用します。vmauth または他の承認されたアクセス層が、意図したルーティング/認証を提供しなければなりません。テナント ID は認証情報ではありません。Mimir やその他のレシーバーには、独自の URL、アイデンティティ、HA の契約があります。
サブ秒のヒストグラムバケットすべてや、コントロールプレーンのレイテンシファミリー全体を破棄する古いルールを、その結果として生じる分位点/SLO の損失を評価せずにコピーしないでください。キューのデフォルト値は出発点であり、計測に基づく本番環境の最適値ではありません。
パフォーマンス、HA、トラブルシューティング
計測に基づくチューニング
head の系列/chunk、カーディナリティのチャーン、スクレイプ負荷、同時クエリ数がメモリに影響します。履歴の保持期間を短縮することは、アクティブな head やクエリによる OOM の万能な解決策ではありません。上限を変更する前に、実際の使用状況とクエリのワークロードを確認してください。
以下のオプションの values 断片はクエリの上限を示すもので、サイジングの推奨ではありません。
# tuning-values.yaml
prometheus:
  prometheusSpec:
    query:
      maxConcurrency: 10
      maxSamples: 50000000
      timeout: 2m
タイムアウトを長くしたり maxSamples を大きくすると、リソースへの露出が増える可能性があります。両方の上限を引き上げる前に、コストの高い式、範囲、集約、recording ルールを確認してください。
スタンドアロン のスクレイプ設定では、次の例が 1 つのジョブに制限を設け、レビュー済みのデバッグ用ファミリー 1 つを破棄します。
# scrape-limits.yaml
scrape_configs:
- job_name: example-app
  scrape_interval: 30s
  scrape_timeout: 10s
  sample_limit: 10000
  static_configs:
  - targets:
    - example-app.example-app.svc:8080
  metric_relabel_configs:
  - source_labels:
    - __name__
    regex: example_debug_payload_total
    action: drop
sample_limit は、メトリクスのリラベル後に適用されるスクレイプ受け入れの上限です。超過するとスクレイプは失敗します。エンドポイントを 10,000 サンプルにきれいに切り詰めるものではありません。間隔を長くすると解像度が下がり検知が遅くなります。また go_.*/process_.* のメトリクスをすべて削除すると、ランタイムの診断情報が失われます。
labeldrop は、それまで区別されていたサンプルを同一の系列に潰してしまうことがあります。それらを合計するわけではありません。一意性を保ち、識別ラベルを削除する前にレシーバーやカーディナリティへの影響を評価してください。カーディナリティのクエリは意図したジョブにスコープしてください。
topk(10, count by (__name__) ({job="example-app"}))サポートされていない TSDB のフラグや、文字列形式の additionalArgs を Operator の CR にコピーしないでください。その additionalArgs は名前付きの引数オブジェクトを使用し、CR のスキーマが妥当であることは、選択した Prometheus バイナリにそのフラグが存在することの証明にはなりません。バージョン固有の裏付けなしに、内部のブロック/chunk の挙動を上書きすることは避けてください。
HA の境界
Prometheus の replicas と shards は Pod 数を増やしますが、解決する問題は異なります。anti-affinity には十分な数のノードが必要です。ゾーン耐性には、適切な配置とストレージも必要です。1 つのシャードにクエリしても、すべてのターゲットのデータが得られるわけではありません。
コレクターの HA は、Alertmanager、Grafana、PVC、リモートストレージを自動的に高可用にはしません。Alertmanager のレプリカには、機能するピア接続と独立した配置/ストレージが必要です。Grafana の HA には、適切な共有データベース/認証の設計が必要です。レシーバー固有の重複排除ラベルとアラートの識別情報は一貫させてください。
自分が所有するリリースでのトラブルシューティング
コンテキスト、リリースの識別情報、生成されるリソース名を検証してください。以下の名前は例の fullnameOverride: metrics-demo に対応するもので、すべてのチャートインストールに当てはまるものではありません。
kubectl config current-context
helm status kube-prom --namespace monitoring
kubectl get prometheus,alertmanager,servicemonitor,podmonitor,prometheusrule \
  --namespace monitoring
kubectl get pods,pvc --namespace monitoring
kubectl get pods --namespace monitoring -l app.kubernetes.io/name=prometheus -o wide
kubectl top pod --namespace monitoring
kubectl top には機能する Resource Metrics API が必要です。これは Prometheus のメモリ圧迫のあらゆる原因を測定するものではありません。
プライベートな API を確認する場合は、port-forward をループバックにバインドし、そのプロセスを別のターミナルで実行し続けてください。
kubectl port-forward --namespace monitoring --address 127.0.0.1 \
service/metrics-demo-prometheus 9090:9090curl --fail --silent --show-error --max-time 10 \
http://127.0.0.1:9090/api/v1/targets \
| jq '.data.activeTargets[] | select(.health != "up") | {labels, scrapeUrl, lastError}'
curl --fail --silent --show-error --max-time 10 http://127.0.0.1:9090/api/v1/status/tsdb
curl --fail --silent --show-error --max-time 10 http://127.0.0.1:9090/api/v1/status/flags
curl --fail --silent --show-error --max-time 10 http://127.0.0.1:9090/api/v1/status/runtimeinfo
curl --fail --silent --show-error --max-time 10 http://127.0.0.1:9090/api/v1/rules
curl --fail --silent --show-error --max-time 10 http://127.0.0.1:9090/api/v1/alerts| 症状 | リソースを変更する前に確認すること |
|---|---|
| OOMKilled | コンテナの limit、head の系列/チャーン、クエリの同時実行数/範囲、サンプル数、ワークロードのピーク |
| PVC Pending | 実際の StorageClass/CSI の可用性、アクセスモード、容量、ゾーンのスケジューリング |
| ターゲットが見つからない | 両方のモニターセレクター、Namespace の選択、Service のラベル/ポート、Pod のラベル、Operator の調整 |
| ターゲットが down | ターゲット URL、CA/SAN/認証、RBAC/ネットワーク経路、エンドポイントの応答。エラーは不在の証拠ではない |
| 通知が来ない | ルールの状態、ラベルの安定性、選択された/グローバルな設定、Namespace の強制、ルートの順序/抑止、Secret、プロバイダーの状態 |
| リモートのバックログ | 認証情報/Region/ワークスペース、レシーバーのエラー/クォータ、キュー/WAL の容量、重複ラベルの契約 |
distroless の Prometheus イメージにシェルや wget、curl が含まれることは保証されません。kubectl exec ... wget が動作すると想定しないでください。Pod のネットワークコンテキストからテストする場合は、承認された診断ツールを使用してください。設定/ターゲット/ログの出力は運用データとして扱い、機密性の高いエンドポイントや認証情報を公開しないでください。
検証と参考資料
ローカル監査では、固定バージョンの Helm のベース/アラート/AMP プロファイルをレンダリングし、リリース済み CRD の構造を検証し、主要な PromQL/ルールを合成サンプルで評価し、ネイティブな Alertmanager のルーティングを確認しました。ディスカバリ、admission/CEL、ストレージのバインド、IAM の強制、外部シークレット、通知配信は実行していません。実験的なスムージングはパーサーのみの検証でした。フィーチャーフラグを指定しても、その値のフィクスチャはリリース済みの promtool テストエンジンで受け入れられませんでした。