ネットワークの基礎 Part 1 — レイヤーモデル、リンク層とルーティング層
最終更新: September 14, 2026
全4部シリーズです
Part 1: レイヤーモデル、リンク層とルーティング層 (このドキュメント) · Part 2: トランスポート層と TLS · Part 3: アプリケーションプロトコル · Part 4: リクエストの経路とクラウド
ブラウザからのリクエストは、複数のプロトコルが連携して処理します。正確な順序はキャッシュ、接続の再利用、IP バージョン、HTTP バージョンに依存するため、トラブルシューティングでは HTTP だけでなく、それ以上の範囲を調べる必要があります。
このシリーズでは、25 のネットワーキングプロトコルとメカニズムを、下位層から上位層へ、レイヤーごとに解説します。下位層から組み立てる理由は単純です。各上位層は、その下のレイヤーがすでに動作していることを前提に設計されています。上から下へ読んでいくと、「では その 部分はどのように動作するのか?」という疑問に繰り返し突き当たります。
各項目は同じ構成に従います。1 行の定義 → 仕組み → 実務で問題になる場面です。
0. 1 ページで分かるレイヤーマップ
| レイヤー | 役割 | ここで扱うプロトコル |
|---|---|---|
| アプリケーション | 実際のサービスセマンティクス | HTTP/3, WebSocket, WebRTC, gRPC, DNS, DoH, DHCP, MQTT, SSH, SMTP |
| セキュリティ | 暗号化と認証(トランスポート層上で動作) | TLS |
| トランスポート | エンドツーエンドのデータ配信 | TCP, UDP, QUIC |
| インターネット / ルーティング | ネットワーク間の経路選択 | IPv4, IPv6, ICMP, BGP, OSPF, NAT |
| リンク | 1 つの物理セグメント内での配信 | Ethernet, Wi-Fi, VLAN, PPP, ARP |
いくつかの項目は、明確なレイヤー境界に収まりません。TLS はトランスポート層とアプリケーション層の間に位置し、QUIC はトランスポート層の役割を果たしながら UDP 上で動作し、ARP は IP とリンク層を橋渡しします。NAT はプロトコルというより機能です。こうした「例外」が、実際のトラブルシューティングの大部分を占めます。
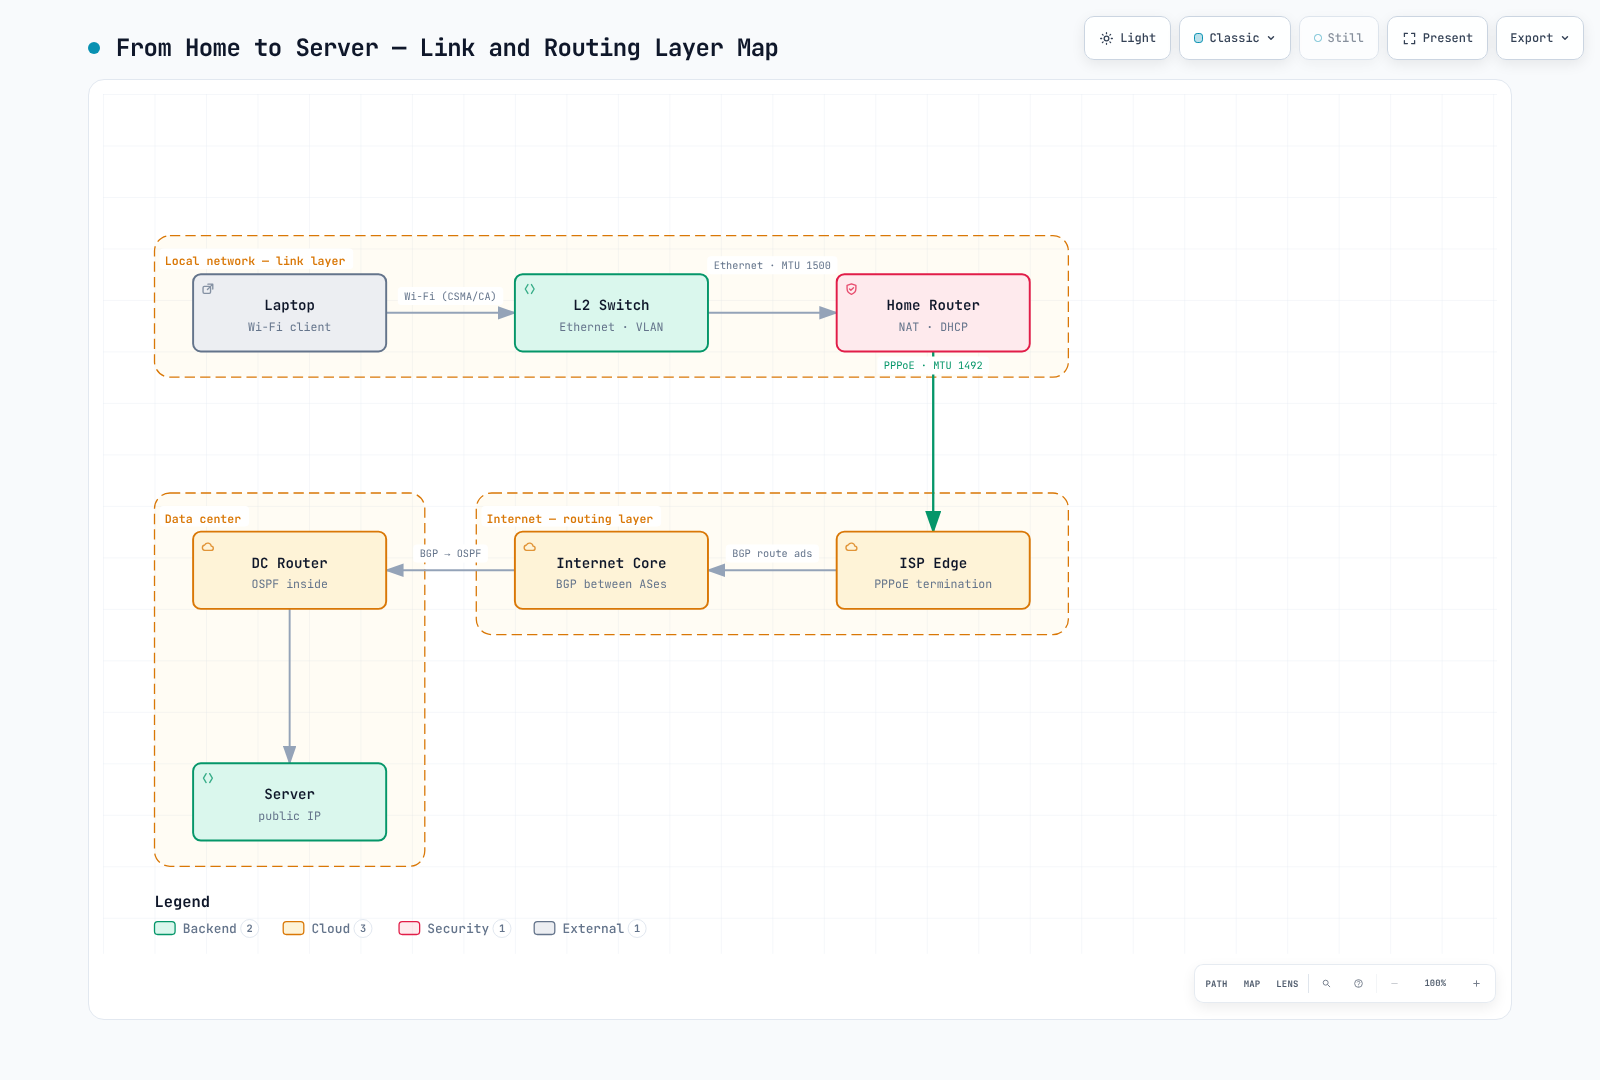
1. リンク層 — 1 つのセグメント内でビットを移動する
リンク層が扱うことは 1 つだけです。すぐ隣にあるデバイスへビットを渡す方法です。最終的な宛先が次のラックであっても地球の裏側であっても、この層が責任を負うのは次のホップだけです。
Ethernet
定義: 有線ローカルネットワーク上でフレームを運ぶリンク層標準。
仕組み: データはフレームにカプセル化され、先頭には宛先と送信元の MAC アドレスが付加されます。既知のユニキャストでは、スイッチは MAC テーブルを使用して宛先ポートを選択します。ブロードキャストおよび未知のユニキャストフレームは通常 VLAN 内にフラッディングされます。マルチキャストの動作は設定に依存します。初期の Ethernet は衝突検出(CSMA/CD)に依存していましたが、現代のスイッチド全二重ネットワークでは衝突は実質的になくなっています。
実務では: Ethernet の IP トラフィックで MTU が 1500 の場合、Ethernet ヘッダー/FCS を除き、フレーム内の IP パケットは 1500 バイトです。Jumbo MTU はデバイス/経路固有です。9001 は EC2 がサポートする値であり、汎用的な Ethernet サイズではありません。クラウドでは、VPN やオーバーレイネットワークを上に重ねるとカプセル化ヘッダーが追加され、有効 MTU が縮小します。MTU ディスカバリーに失敗すると、「ping は通るが大きな応答がハングする」として現れるブラックホールが発生することがあります。これは診断に最も時間がかかる障害モードの 1 つです。
MTU と MSS: MSS は完全なフレームではなく TCP データのバイト数を制限します。MTU 1500 では、基本ヘッダーの計算により IPv4 では 1460(1500−20−20)、IPv6 では 1440(1500−40−20)となります。送信者はさらに、含める IP/TCP オプションに応じて実際のデータ量を減らします。TCP はハンドシェイク中に MSS を交換するため、トンネルをまたいで MTU 問題が繰り返し発生する場合は、ルーターでの MSS クランプ(より小さい TCP MSS を強制すること)が広く使われる回避策です。
Wi-Fi
定義: 無線セグメント(IEEE 802.11)上で LAN フレームを運ぶリンク層標準。
仕組み: 空中は共有媒体であるため、Wi-Fi は Ethernet とは根本的に異なります。Wi-Fi は送信中の衝突検出に依存せず、CSMA/CA を使用します。送信前にチャネルが空いていることを確認し、通常のユニキャストトラフィックには ACK/再試行を使用します。ブロードキャスト/マルチキャストの動作は異なります。つまり、再送はすでにリンク層に組み込まれています。
実務では: TCP 再送の上にリンク層再送が重なると、レイテンシのばらつき(ジッター)が増加します。実際の原因がクライアントの無線セグメントであるにもかかわらず、リアルタイム品質の問題が「サーバーのせい」として報告されることがあります。サーバー RTT だけでは原因を特定できません。アプリケーション処理時間、およびクライアント/AP の再試行、信号、キューのメトリクスと相関させてください。
VLAN
定義: 共有スイッチインフラストラクチャを論理的な L2 ネットワークに分割する技術(IEEE 802.1Q)。
仕組み: 802.1Q タグ付きフレームには、4 バイトの VLAN タグが含まれます。アクセスポートは、スイッチが VLAN に割り当てるタグなしフレームを運ぶことができます。ブロードキャストは同じ VLAN 内のホストにしか届かないため、配線に手を加えずにネットワークを分割できます。VLAN 間のトラフィックは、L3 デバイス(ルーターまたは L3 スイッチ)を通過する必要があります。
実務では: VLAN は論理的な L2 分離を提供しますが、物理的または暗号学的な分離を提供するものではありません。許可されるセグメント間トラフィックは、ルーティングとファイアウォール制御によって決まります。VPC、サブネット、セキュリティグループは、それぞれ異なるクラウドネットワーキングの役割を担います。VLAN と一対一で置き換えられるものではありません。
📎 EKS が VPC をどのように構成するかについては、EKS Networking Fundamentals を参照してください。
PPP
定義: 正確に 2 つのノードを接続するポイントツーポイントリンク上でパケットを運ぶプロトコル。
仕組み: Ethernet と異なり、リンクの各端にはノードが 1 つしかないため、アドレッシングは不要です。その代わり、PPP はリンク確立、任意の認証、上位プロトコルネゴシエーション(LCP/NCP)を提供します。
実務では: ダイヤルアップ時代の遺物のように見えますが、住宅向けインターネット回線の大きな割合で PPPoE として今も使われています。標準的な 1500 バイトの Ethernet ペイロードでは、通常の 6 バイト PPPoE ヘッダーと 2 バイト PPP プロトコルフィールドによって、IP に使えるのは 1492 バイトになります。より大きいアンダーレイをネゴシエーションできれば 1500 を維持できます。1492 への縮小を考慮しないと、前述の MTU 問題を引き起こす可能性があります。
ARP
定義: オンリンクの IPv4 次ホップアドレスを MAC アドレスへ解決するプロトコル。
仕組み: IP 層は「これを 10.0.1.5 に送信する」と指示しますが、Ethernet が理解できるのは MAC アドレスだけです。そのため、ホストは「10.0.1.5 を持っているのは誰か?」とブロードキャストし、所有するホストが応答します。結果は OS 固有の近隣状態/タイムアウトとともにキャッシュされます。オフリンクの宛先の場合、ホストはリモートホストの MAC ではなく、ゲートウェイの MAC を解決します。
実務では: ARP には認証がありません。誰でも「その IP は自分のものだ」と応答でき、これがまさに ARP spoofing を可能にする性質です。同じ性質は正当な目的にも使われます。フェイルオーバー時、新たにアクティブになったノードは Gratuitous ARP をブロードキャストし、近隣ノードに VIP から MAC へのマッピングを通知します。スイッチもフレームから送信元 MAC の位置を学習します。VIP ベースの HA 構成でフェイルオーバーが遅い場合、キャッシュ更新の遅延が有力な疑いです。
📎 Cilium が eBPF と L2/ルーティングの動作をどのように統合するかについては、Cilium Networking を参照してください。
2. インターネット層とルーティング層 — ネットワークを越える
リンク層が「隣」へ到達させるなら、この層は「地球の裏側」へ到達させます。中心となる問いは、このパケットを次にどこへ送るべきか? です。
IPv4
定義: 32 ビットアドレスを基盤とするインターネット層プロトコル。
仕組み: すべてのパケットには送信元 IP と宛先 IP が含まれます。各ルーターはルーティングテーブルで最も具体的なルート(最長プレフィックス一致)を見つけ、次のホップへ転送します。配信はベストエフォートです。保証も順序制御もありません。これらの保証は上位層(TCP)の役割です。
実務では: IPv4 には約 43 億のアドレスがあり、アドレス不足によって NAT が広く使われるようになり、プライベート範囲(10.0.0.0/8、172.16.0.0/12、192.168.0.0/16)が内部ネットワークの標準となりました。クラウド移行で大規模組織が最初に直面する壁は、これらのプライベート範囲の重複です。オンプレミス/VPC の CIDR が重複すると、再採番、変換、またはプロキシの解決策を設計しなければ、VPN や Direct Connect を介した単純なルーティングはできません。IP アドレス設計はプロジェクト開始時に確定すべきものです。
IPv4、CIDR、およびサブネットの例
IPv4 は 8 ビットのオクテット 4 つで構成されます。CIDR 表記では、/26 は最初の 26 ビットをネットワークプレフィックスとして固定し、32 − 26 = 6 ビットをホスト用に残します。以下のアドレスは、公開テストエンドポイントではなく、RFC 5737 のドキュメント例です。
インターフェイスアドレス 192.0.2.130/26 の場合:
| 手順 | 計算または結果 |
|---|---|
| サブネットマスク | 255.255.255.192、最後のオクテットは 2 進数で 11000000 |
| ブロックあたりのアドレス数 | 2^6 = 64、最後のオクテットのブロックは 0、64、128、192 から開始 |
| ネットワークアドレス | 130 AND 192 = 128(10000010 AND 11000000 = 10000000)のため、192.0.2.128/26 |
| ブロードキャストアドレス | 6 ビットのホスト部をすべて 1 に設定: 192.0.2.191 |
| 通常のホスト範囲 | 192.0.2.129–192.0.2.190: 62 アドレス |
インターフェイスが所有するのは .130 です。.128/26 はそのサブネットを識別します。通常のブロードキャストサブネットでは、ホスト部がすべて 0 およびすべて 1 のアドレスは、ネットワークアドレスとブロードキャストアドレスを識別します。ゲートウェイを設定する場合は、ホスト範囲内のアドレスを 1 つ使用します。CIDR はそれが最初のホストであることを要求しません。
すべてのプレフィックスに「2 を引く」を適用しないでください。RFC 3021 は、サポートされるポイントツーポイントリンク上で /31 の両方のアドレスを許可します。/32 は 1 つのアドレスを、しばしばホストルートとして識別します。直接接続された Ethernet ピアを意味するわけではありません。クラウドの割り当てルールは別です。標準の AWS VPC IPv4 サブネットでは、最初の 4 つと最後のアドレスが予約されるため、BYOIP などの例外を除き、/26 で割り当て可能なアドレスは 59 個です。割り当てモードについては、VPC subnet rules を確認してください。
最長プレフィックス、次ホップ、ARP
ルート検索は近隣解決より先に行われます。eth0 に 192.0.2.130/26 が設定された Linux ホスト上の、次の例示的なルーティングテーブルを考えてみましょう。
| 宛先プレフィックス | 次ホップ / インターフェイス |
|---|---|
192.0.2.128/26 | eth0 に直接接続(オンリンク) |
198.51.100.0/24 | eth0 上で 192.0.2.129 経由 |
198.51.100.128/25 | eth0 上で 192.0.2.190 経由 |
0.0.0.0/0 | eth0 上でデフォルト、192.0.2.129 経由 |
選択されたテーブル内で、最長プレフィックスに一致するルートを選択します(RFC 1812 §5.2.4.3)。
192.0.2.150の場合、/26ルートはオンリンクです。近隣エントリがない場合は、ARP で.150自体を解決します。198.51.100.140の場合、/24、/25、/0はすべて一致します。/25が優先されます。ARP ではリモート宛先ではなく、ゲートウェイ192.0.2.190を解決します。203.0.113.10の場合、/0だけが一致します。ゲートウェイ192.0.2.129を使用します。
ルーティングされたパケットでは、Ethernet の宛先はゲートウェイの MAC であり、IP 宛先は(NAT がなければ)リモートホストのままです。デフォルトルートのメトリクスが低くても、一致する /25 より優先されることはありません。Linux のポリシールールでは異なるテーブルを選択できます。実際の検索は、ip-route(8) manual で説明されているように、該当するネットワーク名前空間で ip route get を使用して調べてください。ホストとコンテナでは、ルートと近隣テーブルが異なる場合があります。
IPv6
定義: 128 ビットアドレスを持つ次世代のインターネット層プロトコル。
仕組み: 128 ビットアドレスでは、アドレス枯渇は問題になりません。基本ヘッダーは固定の 40 バイトレイアウトで、ヘッダーチェックサムはありません。ルーターは IPv6 パケットをフラグメント化しません。SLAAC はホストが DHCP なしでアドレスを自己設定できるようにし、ARP は NDP(Neighbor Discovery Protocol)に置き換えられます。
実務では: IPv6 は IPv4 と後方互換性がないため、実際のデプロイではデュアルスタックで運用します。つまり、2 組のファイアウォールルールとセキュリティポリシーを維持することになります。IPv6 経路にルールがないことは一般的なセキュリティギャップです。グローバル IPv6 アドレスがあるだけでは、ワークロードがインターネットから到達可能になるわけではありません。AWS では、依然としてルーティングと、許可されたセキュリティグループ/NACL トラフィックが必要です。egress-only internet gateway を使用すると、要求されていないインバウンド接続なしで、アウトバウンド IPv6 を許可できます。
移行メカニズム: IPv4 と共存する実用的な方法は 3 つあります。デュアルスタック(両方を並行して実行する。ポリシーが重複するコストはあるものの、最も一般的)、トンネリング(IPv6 パケットを IPv4 でラップして v4 専用セグメントを越える)、NAT64/DNS64(IPv6 専用クライアントが IPv4 サーバーに到達できるように変換する。モバイルキャリアは 464XLAT として大規模に使用)です。Kubernetes はデュアルスタック Service もサポートするため、クラスター CIDR 設計では開始時から IPv6 範囲を考慮できます。
ICMP
定義: ネットワークエラーと状態を報告する制御プロトコル。
仕組み: ICMP は制御情報を運び、Echo ペイロードまたは引用された元のパケットデータを含めることができます。宛先到達不能、TTL 超過、フラグメンテーションが必要、などです。ping は Echo Request/Reply を使用します。traceroute は TTL(または IPv6 Hop Limit)を一度に 1 ホップずつ増やし、返される Time Exceeded メッセージを読み取ります。
実務では: 「セキュリティのため」に ICMP を一律にブロックすることはよくあります。そしてそれが、前述の MTU ブラックホールの直接的な原因です。従来の IPv4 PMTUD は ICMP Type 3 Code 4 を使用し、IPv6 は ICMPv6 Packet Too Big Type 2 を使用します。必要なメッセージをブロックするとブラックホールが発生する可能性があります。PLPMTUD では、ICMP に依存せずパケットサイズをプローブできます。IP バージョンとポリシーに応じて、必要なエラー/ディスカバリートラフィックを維持してください。
📎 この障害が EKS でどのように現れるかについては、EKS Networking Deep Dive を参照してください。
ICMP と traceroute の証拠を読む
IPv4 転送では、ルーターがパケットの TTL を減らします。TTL が期限切れになると、ルーターはそのプローブを破棄し、通常は ICMP Time Exceeded (Type 11, Code 0) を返します。これは意図的に短い TTL のプローブでは想定どおりの動作であり、通常のアプリケーションパケットが失敗している証拠ではありません。このエラーには元のパケットの一部が引用され、送信者は応答をそのプローブに関連付けられます(RFC 792)。
送信するプローブと返される応答を分けて考えてください。以下の一般的な traceroute 手法はいずれも、中間ルーターから ICMP Time Exceeded を受信できます。
| 送信するプローブ | 宛先に到達したときの典型的な応答 |
|---|---|
| 未使用の宛先ポートへの UDP | ICMP Destination Unreachable, Port Unreachable (IPv4 Type 3, Code 3) |
| ICMP Echo Request | ICMP Echo Reply |
| 選択したポートへの TCP SYN | リッスン中ポートなら TCP SYN/ACK、閉じたポートなら RST |
デフォルトとオプションは実装によって異なります。Linux traceroute(8) manual には UDP、ICMP、TCP の手法が記載されています。TCP プローブはそのポートの処理をテストしますが、SYN/ACK であっても TLS や HTTP が機能することの証明にはなりません。
* は、待機時間が切れる前に一致する応答が到着しなかったことを意味します。プローブがフィルタリングされた、ルーターが応答を抑制またはレート制限した、あるいは応答が復路で失われた可能性があります。後続ホップから応答がある 1 つの無応答ホップは、エンドツーエンドの損失を示すものではありません。表示される各 RTT には、順路とは異なる場合がある復路が含まれます。ロードバランシングによって、プローブごとに異なるルーターが現れることもあります。障害箇所を特定する前に、繰り返した観測を宛先およびアプリケーションの結果と比較してください。
traceroute が主に調べるのはホップです。小さなプローブが成功しても、パス MTU を検証するものではありません。DF をセットした大きな IPv4 パケットでは、より小さい MTU を検出するために Fragmentation Needed (Type 3, Code 4) が必要になる場合があります。このメッセージを Time Exceeded や Port Unreachable と区別してください。また、前述の IPv6 と PLPMTUD の違いも維持してください。
📎 Linux routing and ICMP lab でルートとプローブの考え方を適用し、それをコンテナおよび Kubernetes のトラブルシューティングに活かしてください。
OSPF
定義: 1 つの自律システム内で最適経路を計算するリンクステートルーティングプロトコル。
仕組み: 各ルーターはエリア全体に自身のリンク状態をフラッディングします。そのため、同じエリアのルーターは一貫したリンクステート情報に収束し、その後それぞれが Dijkstra のアルゴリズムを実行して最短経路を計算します。インターフェイスコストは設定され(多くの場合、帯域幅から導出されます)、スケールさせるためにネットワークはエリアに分割されます。
実務では: OSPF は内部ネットワーク用の IGP です。収束は高速で、経路は自動的に見つかります。しかし、各ルーターは接続先エリアのリンクステート情報を維持するため、大規模環境ではエリア設計がパフォーマンスを左右します。
BGP
定義: 自律システム(AS)間で到達可能性を交換するパスベクタールーティングプロトコル。
仕組み: BGP の目標は OSPF とは異なります。「最も速い経路」ではなく、「ポリシーが優先する経路」を選択します。各 AS は到達可能なプレフィックスを AS パスとともに広告します。受信側は AS_PATH 長、Local Preference、MED などの属性でルートを順位付けします。インターネット全体のルーティングはこれに依存しています。
実務では: BGP はデフォルトで広告を信頼します。これが、不正なプレフィックス広告が広範な障害を引き起こす理由です。RPKI origin validation はプレフィックスのオリジンが認可されているかを確認しますが、AS パス全体を検証したり、すべての route leak を防止したりするものではありません。クラウドの観点では、Direct Connect は BGP を使用します。Site-to-Site VPN は BGP またはサポートされる静的ルーティングを使用できます。そのため、AS 番号、広告するプレフィックス設計、冗長性のための経路優先(AS_PATH prepending など)が実際の設計項目になります。
📎 Calico がクラスター内で BGP をどのように使用するかについては、Calico BGP Deep Dive を参照してください。
NAT
定義: IP アドレス、および NAPT/PAT ではトランスポートポートを変換する機能。
仕組み: 一般的なケースは、多数のプライベートホストが PAT/NAPT を通じて 1 つのパブリックアドレスを共有することです。変換はプライベートからプライベートの場合もあります。常にパブリックインターネットアドレスの共有とは限りません。変換テーブルはセッションごとのマッピングを維持するため、戻りパケットは正しい内部ホストへ戻れます。
実務では: NAT はレイヤー違反の代表例です。L4 ポートを書き換える L3 デバイスであり、インターネット本来の前提であるエンドツーエンド接続を壊します。その結果、P2P は困難になり、STUN/TURN などの回避策が必要になります(後述の WebRTC を参照)。クラウドでは、NAT Gateway のポート枯渇とデータ処理料金が実務上の問題です。アウトバウンド量の多いワークロードでは、VPC endpoint によってサポート対象 AWS サービスの NAT 処理を減らせます。節約できると決めつける前に、時間単価/データ料金とトラフィック経路を比較してください。
検証用リファレンス
- https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/network_mtu.html
- https://www.rfc-editor.org/rfc/rfc894
- https://www.rfc-editor.org/rfc/rfc6691
- https://www.rfc-editor.org/rfc/rfc4638
- https://www.rfc-editor.org/rfc/rfc5227
- https://www.rfc-editor.org/rfc/rfc792
- https://www.rfc-editor.org/rfc/rfc8899
- https://www.rfc-editor.org/rfc/rfc2328
- https://www.rfc-editor.org/rfc/rfc6811
- https://docs.kernel.org/networking/bridge.html
- https://docs.aws.amazon.com/vpc/latest/userguide/VPC_Internet_Gateway.html
- https://docs.aws.amazon.com/vpc/latest/userguide/egress-only-internet-gateway.html
- https://docs.aws.amazon.com/vpn/latest/s2svpn/VPNRoutingTypes.html
- https://docs.aws.amazon.com/vpc/latest/userguide/nat-gateway-scenarios.html
- https://docs.aws.amazon.com/vpc/latest/userguide/nat-gateway-pricing.html