パート2: Flink Kubernetes Operator
最終更新日: 2026年9月12日。Operator/Helm chart 1.15.0、Flink 2.2.1/Java 17。
Operator は、クラスター/ジョブの望ましい状態を調整し、アップグレード、スナップショット、復旧、オートスケーリングを管理します。すべての変更について、ダウンタイムやデータ損失がゼロになることを保証するものではありません。Native/Standalone と Application/Session の境界については、パート1を参照してください。
1. リソースと運用上の境界
| CR | 役割 |
|---|---|
| FlinkDeployment | Application または Session クラスターの望ましい状態 |
| FlinkSessionJob | 既存の管理対象 Session クラスターへ送信されるジョブ |
| FlinkStateSnapshot | 関連付けられた Deployment/SessionJob の savepoint/checkpoint 管理 |
| FlinkBlueGreenDeployment | 2つの子 Deployment を使った blue/green 切り替え |
SessionJob は個別の spec を持ちますが、JM/TM のキャパシティと、基盤クラスターの障害を共有します。Application クラスターも、共有 EKS ノード、ネットワーク、ストレージ、クォータから完全に分離されているわけではありません。blue/green の CR があっても、Kafka のコンシューマーグループ、transactional ID、sink への書き込みが安全に切り替わるとは限りません。状態/データ経路の互換性、重複処理、一時的に追加で必要なキャパシティを検証してください。
2. インストール: cert-manager と namespace を準備する
サポート対象の EKS/Kubernetes バージョンと、互換性のある kubectl/Helm を使います。このリリースでデフォルトの webhook chart が作成するのは、内部の証明書生成 Job ではなく、cert-manager Certificate と Issuer のリソースです。まず、互換性のある cert-manager と、その controller/webhook/cainjector の稼働を確認してください。インストール失敗に対するデフォルトの対処は、検証を無効にすることではありません。
以下の operator-values.yaml は、ワークロード namespace を data-processing に限定し、検証済みの Operator イメージ digest を固定します。chart の短いデフォルトタグと 1.15.0 タグは、同じマルチアーキテクチャ digest に解決されました。
watchNamespaces:
- data-processing
image:
  repository: ghcr.io/apache/flink-kubernetes-operator
  tag: 1.15.0
  digest: sha256:5372e4461b433ee37391b0ee3fc3e4029980d14e9b64576b0cb78493d1cafe3a
webhook:
create: true# Existing cert-manager installation; adjust its namespace if necessary.
kubectl get crd certificates.cert-manager.io issuers.cert-manager.io
kubectl rollout status deployment/cert-manager -n cert-manager --timeout=180s
kubectl rollout status deployment/cert-manager-webhook -n cert-manager --timeout=180s
kubectl rollout status deployment/cert-manager-cainjector -n cert-manager --timeout=180s
# Create the watched workload namespace before Helm creates its SA/RBAC.
kubectl create namespace data-processing --dry-run=client -o yaml | kubectl apply -f -
helm repo add flink-operator-repo https://downloads.apache.org/flink/flink-kubernetes-operator-1.15.0/
helm repo update flink-operator-repo
helm upgrade --install flink-kubernetes-operator flink-operator-repo/flink-kubernetes-operator \
--version 1.15.0 \
--namespace flink-operator --create-namespace \
-f operator-values.yaml \
--wait --timeout 10m
kubectl wait --for=condition=Ready certificate/flink-operator-serving-cert \
-n flink-operator --timeout=180s
kubectl get serviceaccount/flink -n data-processingwatchNamespaces が空の場合は、すべての namespace を監視します。上のようにリストを明示すると、chart はワークロード namespace 内に flink の Job service account、Role、RoleBinding も作成します。この namespace は事前に存在する必要があります。監視範囲、実際の RBAC、その他の許可を合わせて確認してください。namespace を限定しても、信頼されていないテナント間の完全な分離にはなりません。
アップグレードでは、chart のバージョン/値と合わせて、CRD の変更、webhook の互換性、実行中のジョブをレビューします。Helm upgrade だけですべての既存 CRD が crds/ から更新されるわけではありません。レビュー済みリリースに合わせて CRD とイメージを維持してください。
3. バンドル済みジョブで最初の実行を確認する
flink-smoke.yaml は、公式イメージに含まれる StateMachineExample を実行します。そのイメージに存在しない、架空の order-events JAR や entry class があるとは想定しません。これはステートレスなアップグレードを行う長時間稼働のデモであり、本番向けの状態維持設定ではありません。
apiVersion: flink.apache.org/v1beta1
kind: FlinkDeployment
metadata:
  name: flink-smoke
  namespace: data-processing
spec:
  image: flink:2.2.1-java17
  flinkVersion: v2_2
  mode: native
  flinkConfiguration:
    taskmanager.numberOfTaskSlots: '2'
  serviceAccount: flink
  jobManager:
    resource:
      memory: 2048m
      cpu: 1
  taskManager:
    resource:
      memory: 2048m
      cpu: 1
  job:
    jarURI: local:///opt/flink/examples/streaming/StateMachineExample.jar
    parallelism: 2
    upgradeMode: stateless
state: running# This readiness sequence is for the initial deployment.
kubectl apply -f flink-smoke.yaml
kubectl wait --for=condition=Running flinkdeployment/flink-smoke \
-n data-processing --timeout=300s
kubectl get flinkdeployment/flink-smoke -n data-processing -o yaml
kubectl get pods -n data-processing -l app=flink-smoke
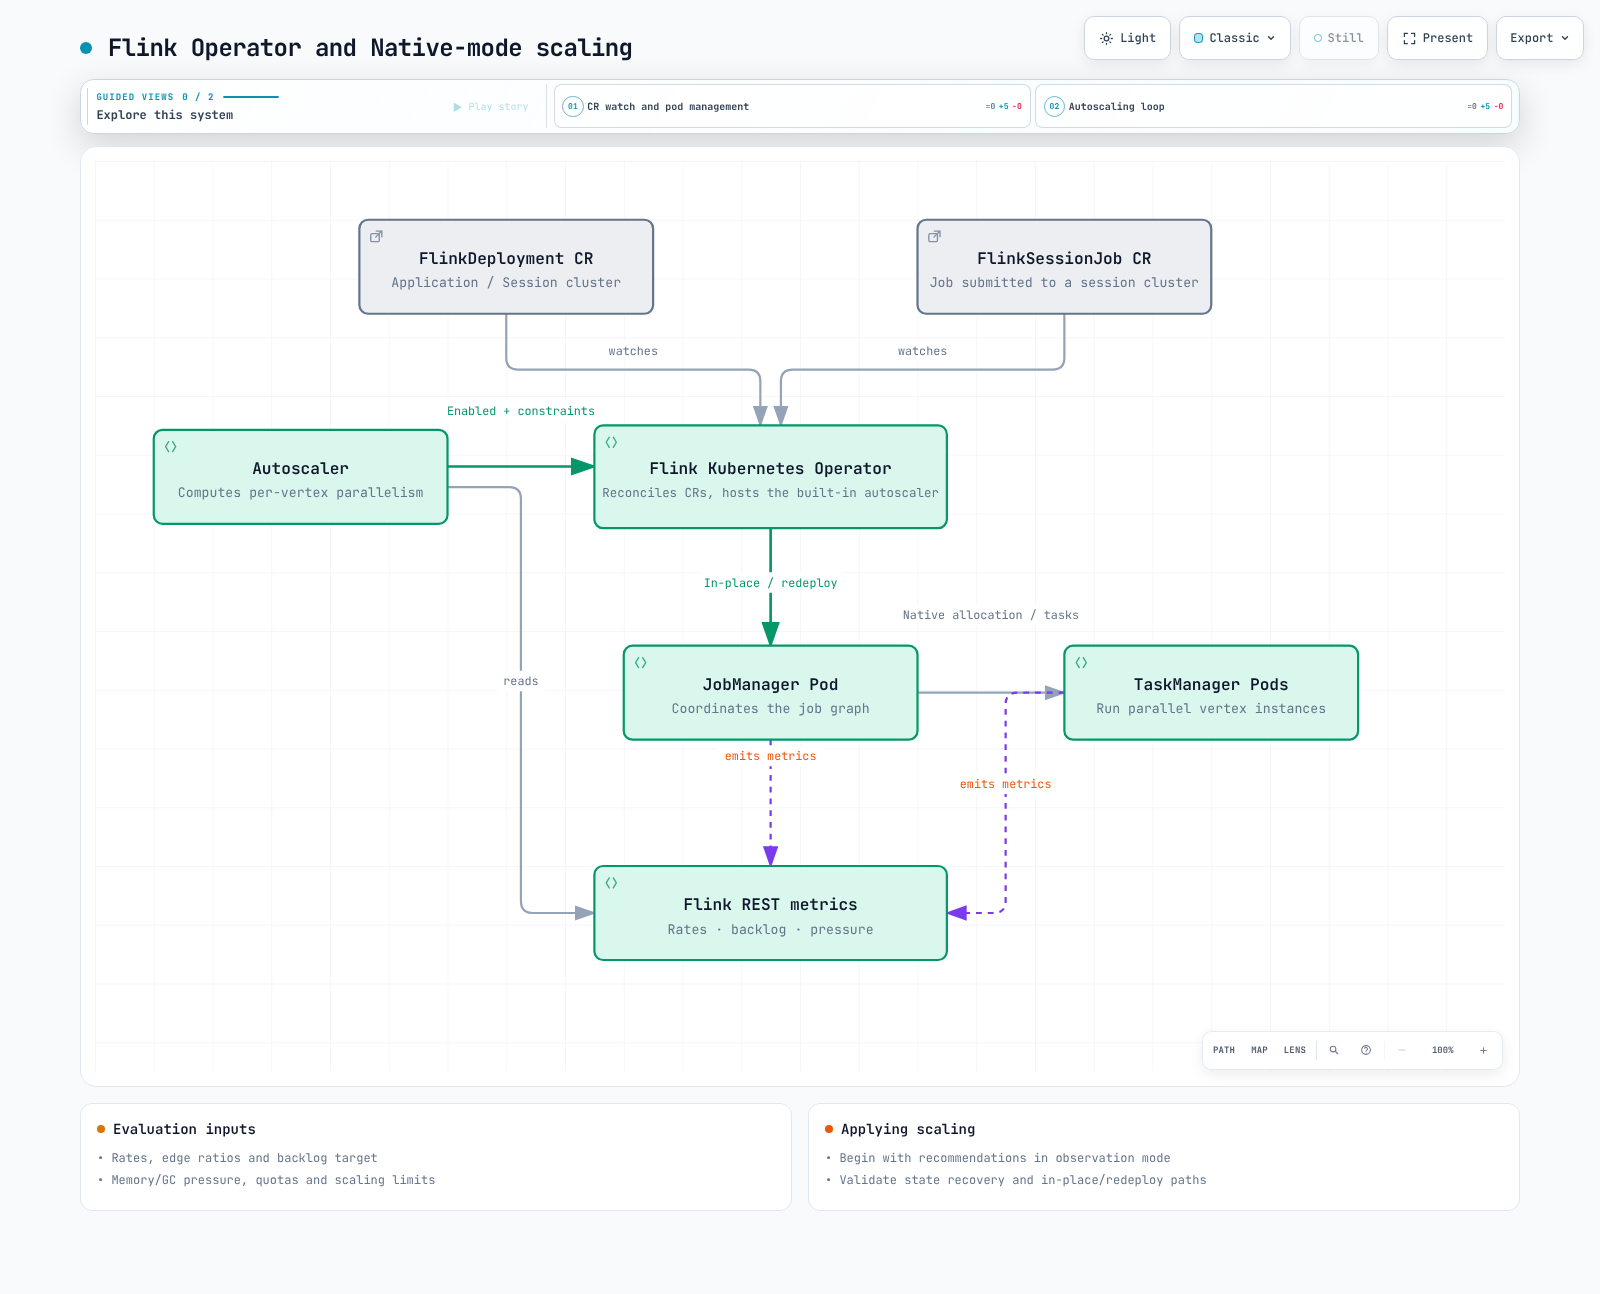
kubectl logs deployment/flink-smoke -n data-processing --tail=100Native モードでは、Operator/Flink が JM Deployment を作成し、JM ResourceManager が TM Pod を動的に管理します。Native の TM が必ず Deployment になるわけではありません。これを Standalone モードで外部管理される TM Deployment と区別してください。
1.15.0 の Condition は Available ではなく Running です。観測された RUNNING 状態の Application ジョブ、または READY 状態の Session JM Deployment に対して True になります。データの正確性、checkpoint の成功、目標スループットを証明するものではありません。 この実装では Condition の observedGeneration を設定しません。既存 CR を更新した後、保持されている Running=True を、新しい spec が調整された証拠として扱わないでください。調整状態と、実際のイメージ/設定/ジョブの状態も確認してください。
4. ステートフルなデプロイに必要な追加要件
互換性のあるランタイム/コネクターを含む実際のアプリケーション JAR をパッケージ化するか、サポート対象のアーティファクト配信経路を使います。SessionJob については、Operator が許可するアーティファクトのスキーム/ホストも確認してください。
S3 URL とサービスアカウントの annotation だけでは、ステートフルなデプロイに必要な設定は完了しません。
- 適切な S3 filesystem plugin と認証情報プロバイダーを JM/TM イメージにインストールする。
- IRSA または Pod Identity の trust/association、Agent/SDK、バケットプレフィックス/KMS 権限を検証する。
- checkpoint 間隔、アクセス可能な checkpoint/savepoint ストレージ、HA メタデータ/復旧を設定する。
- state serializer、Operator UID、最大並列度、コネクターの状態の互換性を検証する。
バックエンド/plugin/checkpoint の設定はパート3で、HA はパート4で扱います。 RocksDB はローカルディスク I/O を使い、復旧時には state のダウンロードが必要になる場合があります。TM のメモリ/ディスク/ネットワーク容量と再配置時間を測定してください。ノード/AZ に分散するだけではジョブ継続性を保証できません。リクエスト、taint、affinity、余剰キャパシティを計画してください。
5. 復元の前提条件とあわせてアップグレードモードを選ぶ
| モード | 状態の扱い | 確認する内容 |
|---|---|---|
| stateless | 以前の状態を使わずに再起動する | ソースオフセットや外部副作用を含め、再生が許容されるか |
| savepoint | savepoint を作成し、そこから復元する | 実行可能なジョブ、ストレージ/状態の互換性、失敗時のフォールバックポリシー |
| last-state | アクセス可能な HA メタデータまたは最後の checkpoint/savepoint を使って復元する | checkpoint、メタデータ/状態の有効性、認証情報、実際の復旧可能性 |
savepoint が常に最も遅く、安全で、処理をすべて停止する選択肢とは限りません。所要時間と復元可能性は、ジョブ、バックエンド、状態変更によって異なります。デフォルトの last-state フォールバックが有効で、HA メタデータにアクセスできる場合、異常状態のジョブに対する savepoint アップグレードは last-state に切り替わることがあります。フォールバックポリシーを明示してください。
last-state は、メタデータが失われた場合や、古い/互換性のない状態からの復旧を保証しません。checkpoint の経過時間の上限によって、正常なジョブでも savepoint が起動する場合があります。SessionJob でも last-state を使えますが、基盤となる Session の設定と checkpoint ストレージが必要です。モード文字列だけでは不十分です。
6. オートスケーラー: まず観測から始める
オートスケーラーが主に対象とするのは、ジョブ頂点の並列度です。スループットモデルでは、ソースの取り込み量/遅延、処理レート/ビジー時間、エッジの出力比率を使います。 下流の頂点では、上流の目標レート × そのエッジの出力比率を合計します。観測された上流の出力レートを単に足し合わせる方法とは異なります。
CPU ベースの HPA とは異なりますが、CPU/メモリのシグナルをすべて無視するわけではありません。レビューしたコードは GC/メモリ圧迫と CPU/メモリのクォータを確認し、必要に応じて TM のメモリを調整できます。メモリ調整はデフォルトで false です。
既存の spec に、以下の観測モード設定を統合します。実際の再スケーリングは無効です。新しいジョブの設計時に pipeline.max-parallelism を選び、既存ジョブでは安易に変更しないでください。
flinkConfiguration:
  job.autoscaler.enabled: 'true'
  job.autoscaler.scaling.enabled: 'false'
  job.autoscaler.utilization.target: '0.6'
  job.autoscaler.utilization.min: '0.4'
  job.autoscaler.utilization.max: '0.8'
  job.autoscaler.stabilization.interval: 5m
  job.autoscaler.metrics.window: 10m
  job.autoscaler.catch-up.duration: 10m
  pipeline.max-parallelism: '360'
現在のキーは utilization.target/min/max です。以前の target.utilization および境界設定は非推奨です。ここでは 0.4/0.8 が使用率の範囲を定義しますが、判断にはバックログ、再起動時間、メトリクスウィンドウ、クォータ、上下限、安定化も考慮されます。一時的なビジー時間がしきい値を超えても、ただちに再スケーリングされるとは限りません。
catch-up.duration は、再スケーリング後にバックログを処理する目標時間です。レコード6,000件のバックログを処理する場合、600秒なら1秒あたり10件、60秒なら1秒あたり100件の追加処理能力が必要です。時間を短くするほど多くのキャパシティが必要になり、0にするとバックログベースのスケーリングが無効になります。バックログを無視する猶予期間ではありません。
メトリクスウィンドウの3~60分は、調整を始める際の目安であり、普遍的な要件ではありません。安定化、スケールダウン間隔、SLO と合わせて調整してください。最大並列度に約数が多いと、オートスケーラーの key-group/partition の調整に役立つ場合がありますが、Flink 自体はすべての並列度が最大並列度を割り切れることを要求しません。 配置の選択には、alignment mode、ソースパーティション、keyed/non-keyed の入力も影響します。
スケーリングでは並列度の override を適用し、可能な場合は adaptive scheduler の resource-requirements API をその場で使います。サポート状況、変更の種類、設定、成功結果によっては、完全な再デプロイにフォールバックする場合があります。常に last-state アップグレードになるわけではありません。インプレーススケーリングでも、タスクの再起動や state の復旧が起こる場合があります。推奨内容をレビューし、ステートフルな復旧とピーク負荷をテストした後に、scaling.enabled を有効にしてください。
検証範囲
公式 chart の digest を確認し、デフォルト、namespace スコープ、webhook 無効の各パターンを Helm でレンダリングしました。CRD スキーマ、イメージマニフェスト、リリース済みソースの Ready 状態/スケーリング、例の構造を確認しました。Kubernetes へのデプロイ、証明書の発行、S3/HA の運用、実ジョブのスループットテスト、再スケーリングは実施していません。