パート 4: Katib — ハイパーパラメータチューニングと AutoML
対応バージョン: Katib 0.19.0, Kubeflow Community Distribution 26.03.1 最終更新: September 12, 2026
ラボ環境のセットアップ
Katib 0.19.0 の controller、DB manager/storage、必要な Suggestion イメージ、および Experiment を作成するための namespace 権限を使用します。フルプラットフォームの Profile アクセスとスタンドアロンインストールを区別してください。GPU 容量は任意であり、Karpenter はプロビジョナーの一つです。
Katib とは
Katib はハイパーパラメータ最適化(HPO)とニューラルアーキテクチャ探索(NAS)をサポートします。Experiment は objective/search space/algorithm/Trial template を定義し、Suggestion とその algorithm service が候補を提案し、Trial が一つの候補実行を管理します。過去の結果が Suggestion に与える影響は algorithm によって異なります。
これらは CRD によって定義されたカスタムリソースオブジェクトであり、実行のたびにインストールされる新しい CRD 定義ではありません。Trial controller は設定された job resource を作成します。その job の controller と Kubernetes が Pod の作成と node 配置を処理します。0.19.0 のデフォルト trialResources には TrainJob.v1alpha1.trainer.kubeflow.org、Kubernetes Job、およびレガシーな training-job kind が含まれます。実際の Trainer API/runtime、権限、success/failure conditions、および collector の対象 Pod/container を一致させてください。互換性は自動的には保証されません。
状態は kubectl get experiments.kubeflow.org と kubectl get trials.kubeflow.org で確認します。これらは KFP の同名の Experiment API とは異なります。
検索アルゴリズム
Algorithm 名は、インストール済みの KatibConfig エントリおよび Suggestion イメージと一致している必要があります。0.19.0 のデフォルト設定には以下が含まれます。
| 名前 | 戦略と制約 |
|---|---|
random | 設定された space/distribution からのサンプリング。すべての parameter で必ずしも一様ではない |
grid | 有限の組み合わせ。goal、failure、または Trial 制限により網羅的な実行が妨げられる場合がある |
bayesianoptimization, tpe, multivariate-tpe | 異なるモデルベースの候補戦略。より少ない Trial 数や optimum は保証されない |
hyperband | resource budget と successive halving。training code は budget parameter に従う必要がある |
cmaes, sobol | それぞれ共分散適応進化と低偏差サンプリングであり、同じ algorithm ではない |
pbt | checkpoint 共有要件を持つ population-based training。CMA-ES とは異なる |
enas, darts | 独自の template/dependency を持つ architecture-search algorithm |
PBT ガイドでは RWX volume と resumePolicy: FromVolume が必要です。algorithm 名を変更しても、任意の training code が互換になるわけではありません。
Experiment の構成
| フィールド | 意味 |
|---|---|
objective | metric 名、maximize/minimize、および任意の target |
parameters | double/int/discrete/categorical の space、range/list/distribution |
algorithm | インストール済みの Suggestion algorithm と設定 |
trialTemplate | trialParameters の置換と job spec、primary container/Pod の選択、success/failure conditions |
parallelTrialCount | 同時に処理される Trial 数。Pod/GPU/EC2 数ではない |
maxTrialCount | 完了数による停止基準。成功した training 数や不変のライフタイムコスト上限ではない |
maxFailedTrialCount | failed および metrics-unavailable Trial を含む failure threshold |
metricsCollectorSpec / earlyStopping | metric reporting と独立した early-stopping 設定 |
Goal の達成、完了数上限、または候補の枯渇により Experiment は正常終了できます。failure threshold または Suggestion error により Experiment は失敗します。完了ステータスは、succeeded、failed、killed、early-stopped、および metrics-unavailable Trial をカウントします。Resume policy と spec の変更もライフサイクルに影響するため、maxTrialCount を不変のライフタイム作成数または支出上限として扱わないでください。
Succeeded は control-loop の結果であり、model quality の認定ではありません。status.currentOptimalTrial は収集された最良の observation を示します。metric が欠けていると、使用可能な最良の model が存在しない場合があります。
Early Stopping と 0.19.0 の medianstop 実装
Early stopping は実行中の Trial を終了できます。公式ガイドでは StdOut/File collector と timestamp 付き log が必要です。すべての collector や任意の training loop で同等のサポートがあると仮定しないでください。デフォルトは min_trials_required=3 と start_step=4 です。
ドキュメント化されたルールと、この release の実装を区別してください。 公式ガイドでは、完了した Trial の running average の中央値について説明しています。しかし v0.19.0 では、get_median_value は成功した各 Trial の最初の start_step observations の average を保存し、それらの保存済み average の算術平均を返します。変更していない関数を [1, 2, 100] でローカル実行すると、統計的中央値の 2 ではなく約 34.333 になりました。この release では algorithm 名が median calculation を保証しません。
Hyperband の budget allocation と early-stopping service は、別々の configuration/execution path です。有望な candidate を破棄するリスク、および metric format、reporting frequency、budget parameter の影響を検証してください。
Experiment のエンドツーエンドの実行方法
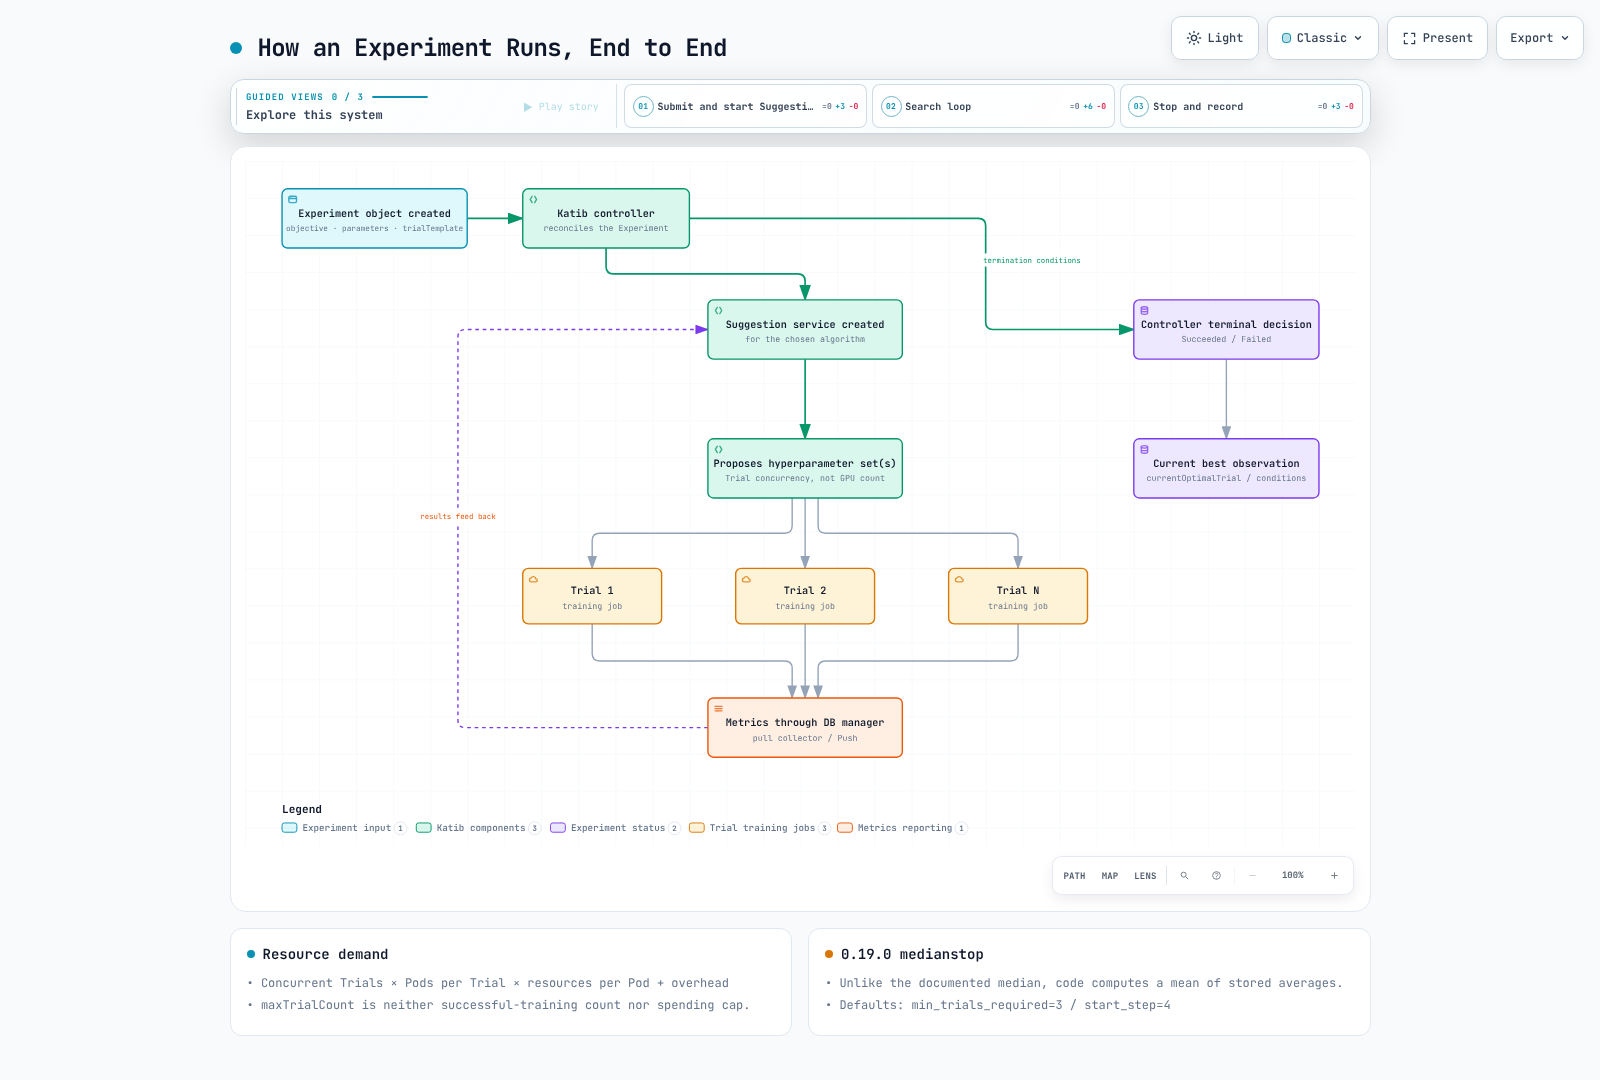
Experiment controller は Suggestion resource を介して候補をリクエストし、Trial object を作成します。Trial controller と training-job controller が実行を駆動し、metric は DB manager を介して報告されます。Algorithm は実装に応じて結果を消費します。終了条件と残っている child job を確認してください。最適なハイパーパラメータそのものは deployable model artifact ではありません。
Metric の収集
| モード | 設定と制約 |
|---|---|
StdOut | デフォルトの pull mode。primary container の log format から metric を抽出する |
File | TEXT または行区切り JSON。path と filter を設定する |
TensorFlowEvent | compatible TensorBoard writer を含む event-file directory |
Custom | ユーザー提供の collector 実装。任意の HTTP scraping は組み込みのデフォルトではない |
Push | training code が SDK の report_metrics() を DB manager に呼び出す。collector sidecar が常に必要とは限らない |
Pull injection には namespace label katib.kubeflow.org/metrics-collector-injection: enabled、動作する webhook、および正しい対象 Pod/container の選択が必要です。Distributed training には明示的な reporting-rank policy が必要です。metric 名、数値 format、timestamp、connectivity、および policy を検証してください。training job が成功しても、metric が収集されたとは限りません。
EKS の容量とコスト
需要は概ね同時 Trial 数 × Trial あたりの Pod 数 × Pod あたりの resourceに、collector/Suggestion/database の overhead を加えたものです。各 Trial にそれぞれ四つの GPU を要求する Pod が二つあり、parallelTrialCount が 8 の場合、要求される GPU は八つではなく 64 個になる可能性があります。
Pending Pod については、event、scheduling constraint、quota、NodePool/EC2 capacity、driver、および bootstrap state を確認します。Karpenter は常に capacity を供給できるわけではなく、concurrency を高めても総実行時間が短縮されるとは限りません。Early stopping は Pod resource を解放できますが、維持されている node に対する EC2 課金は継続します。
総 Trial 基準、concurrency、job retry/distributed size、deadline、および data retention をまとめて設定してください。GPU scale を増やす前に、小規模な CPU workload で metric collection と termination を検証してください。
検証とソース
v0.19.0 の configuration、controller/API、collector path、および medianstop source を確認しました。変更していない medianstop function は、preloaded successful-Trial history を使用し、network call をブロックした状態でローカル実行しました。Experiment または GPU workload は実行していません。
次のステップ
パート 5: Trainer で distributed-training API と runtime を続けて学びます。
クイズ
この章で学んだ内容を確認するには、トピッククイズに挑戦してください。