AI/ML ワークロード
レビュー基準: GPU Operator 26.7.0 / NVIDIA device plugin 0.20.0 / FSx CSI 1.10.0 最終更新: September 12, 2026
Kubernetes は AI/ML ワークロードを実行するための強力なプラットフォームです。この章では、EKS で AI/ML ワークロードを実行する方法とベストプラクティスを学びます。
AI/ML ワークロードの特性
AI/ML ワークロードには、一般的なアプリケーションワークロードとは異なる特性があります。
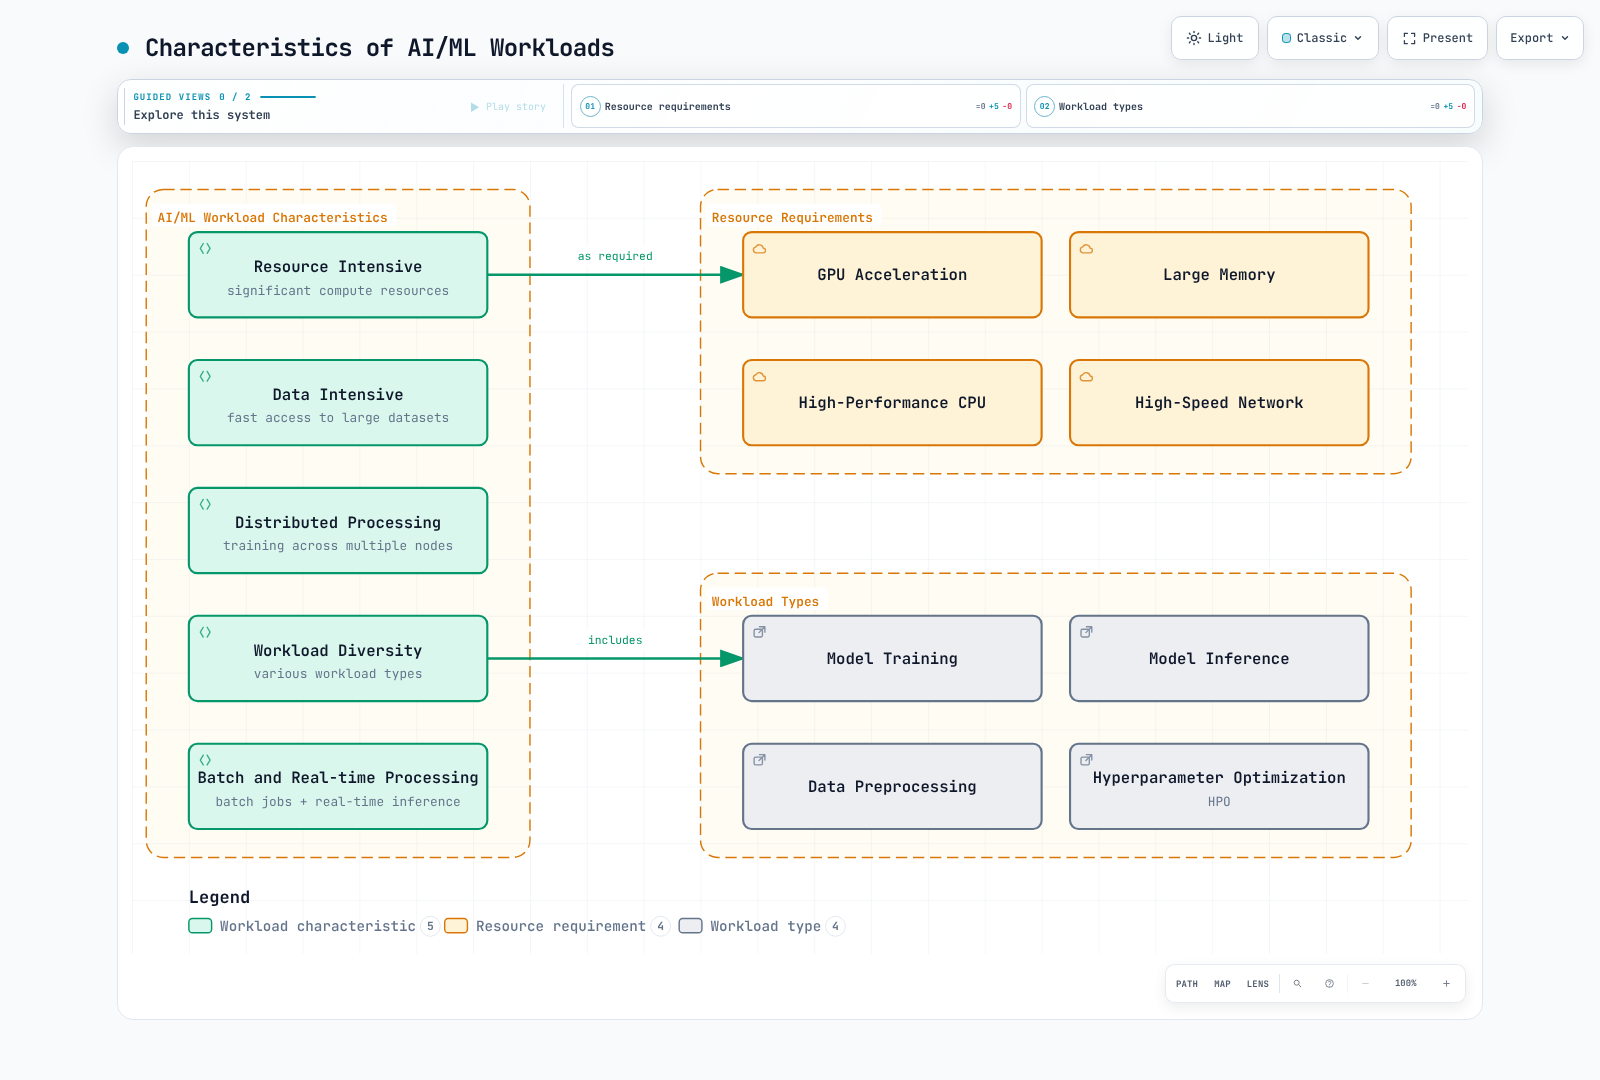
- リソース集約型: GPU、高性能 CPU、大容量メモリを含む大規模なコンピューティングリソースを必要とします。
- データ集約型: 大規模なデータセットへの高速なアクセスを必要とします。
- 分散処理: 大規模なモデル学習では、複数ノードにまたがる分散処理を必要とします。
- ワークロードの多様性: 学習、推論、データ前処理など、さまざまな種類のワークロードが含まれます。
AI/ML 設計における留意点
選択したフレームワーク、イメージ、デバイス、Kubernetes バージョンに対するサポートを確認します。
1. Large Language Model (LLM) のデプロイ
Large Language Model (LLM) は、近年の AI における最も注目すべき技術の一つです。Kubernetes 上で LLM を効率的にデプロイする際の主な考慮事項は次のとおりです。
- モデルシャーディング: 大規模モデルを複数の GPU に分散すること
- 精度の選択: FP16/BF16 演算と INT8/INT4 量子化を区別し、精度とデバイスのサポートを検証すること
- 推論の最適化: vLLM、TensorRT、ONNX Runtime などを使用して推論パフォーマンスを向上させること
- スケーリング戦略: 水平スケーリングによってスループットを向上させること
2. AI オーケストレーションフレームワーク
Kubernetes 上で AI/ML ワークロードを管理するための専用オーケストレーションフレームワーク:
- Kubeflow: 機械学習ワークフローの包括的なプラットフォーム
- Ray on Kubernetes: 分散コンピューティングフレームワーク
- KServe: Knative/Standard およびその他のパスによる推論管理
- Seldon Core: モデルサービングとモニタリング
3. GPU 共有と最適化
GPU リソースを効率的に利用するための技術:
- MIG (Multi-Instance GPU): NVIDIA A100/H100 GPU のパーティショニング
- 共有アプローチ: MPS とタイムスライシングは、分離性とサポートの点で互いに、また MIG とも異なります
- 動的割り当て: 必要に応じた GPU リソースの動的な割り当て
- GPU Operator: Kubernetes における GPU 管理の自動化
4. MLOps と GitOps の統合
AI/ML ライフサイクル管理に DevOps 原則を適用します。
- モデルのバージョン管理: Git と統合されたモデルのバージョン管理
- CI/CD パイプライン: モデル学習とデプロイの自動化
- A/B テストとカナリア: 実験的な比較と段階的ロールアウトでは、目的と指標が異なります
- モニタリングとフィードバックループ: モデルパフォーマンスのモニタリングと再学習
5. ベクトルデータベースの統合
埋め込みとセマンティック検索のためのベクトルデータベース統合:
- Pinecone: マネージドベクトル検索
- Milvus: オープンソースのベクトルデータベース
- Faiss: Facebook AI の効率的な類似度検索ライブラリ
- OpenSearch: ベクトル検索機能を持つ検索エンジン
バッチ推論とオンライン推論では、レイテンシーとスループットの目標が異なります。
EKS における AI/ML インフラストラクチャの構成
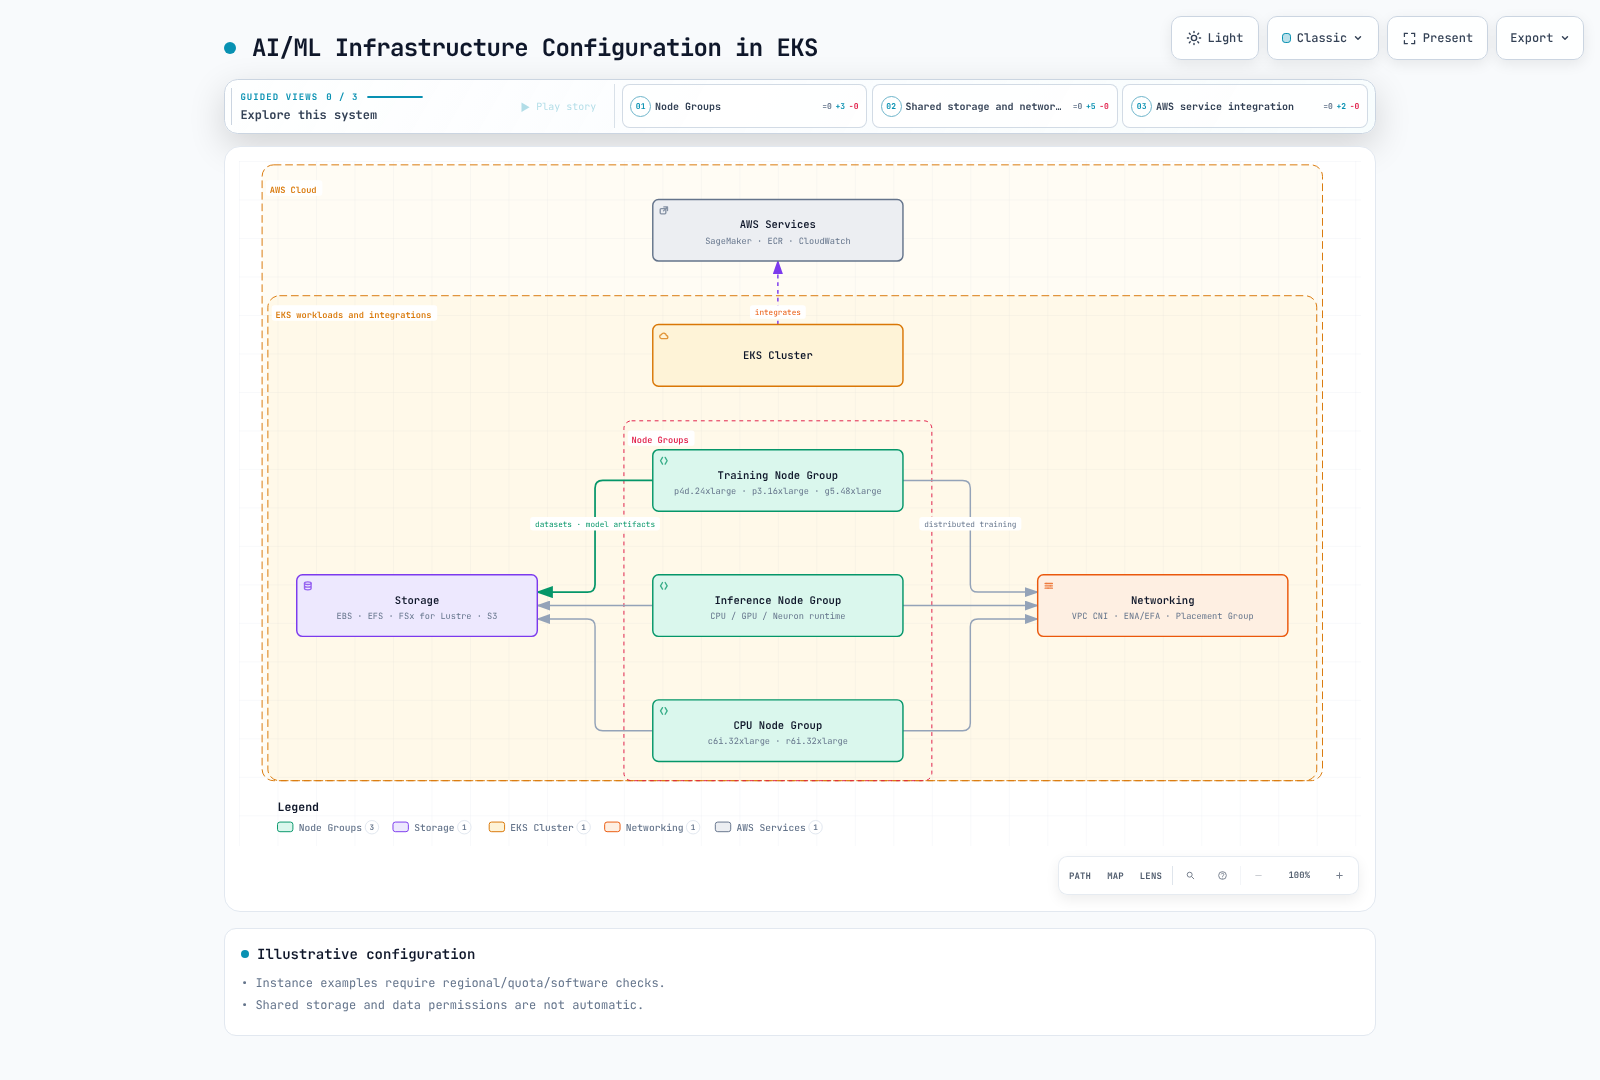
ノードタイプの選択
これらはキャパシティの例であり、最新カタログやランキングを網羅するものではありません。リージョンでの可用性、クォータ、CPU アーキテクチャ、GPU メモリ、ソフトウェア互換性を確認してください。
GPU インスタンス:
- p4d.24xlarge: 8x NVIDIA A100 GPU、320GB GPU メモリ
- p3.16xlarge: 8x NVIDIA V100 GPU、128GB GPU メモリ
- g5.xlarge~g5.48xlarge: NVIDIA A10G GPU、最大 8 GPU
- g4dn.12xlarge: 4 T4 GPU、g4dn.16xlarge: 1 T4 GPU — サイズと GPU 数は単調には増加しません
CPU 最適化インスタンス:
- c6i.32xlarge: 128 vCPU、256GB メモリ
- c7g.16xlarge: 64 vCPU (AWS Graviton3)、128GB メモリ
メモリ最適化インスタンス:
- r6i.32xlarge: 128 vCPU、1024GB メモリ
- x2gd.16xlarge: 64 vCPU、1024GB メモリ
Inferentia インスタンス:
- inf1.24xlarge: 16 AWS Inferentia チップ、96 vCPU、192GB メモリ
Trainium インスタンス:
- trn1.32xlarge: 16 AWS Trainium チップ、128 vCPU、512GB メモリ
ストレージ構成
AI/ML ワークロードには高性能ストレージが必要です。
Amazon EBS:
- gp3: デフォルトの汎用 SSD ストレージ
- io2: 高性能 SSD ストレージ
- st1: スループット最適化 HDD ストレージ
Amazon EFS:
- 複数のノードが共有データにアクセスする必要がある場合に有用
- パフォーマンスモード: General Purpose を推奨します。旧世代の Max I/O は Elastic スループットと互換性がありません
- スループットモード: Elastic、Provisioned、Bursting — ワークロード要件、料金、制限を比較してください
Amazon FSx for Lustre:
- 高性能な並列ファイルシステム
- 大規模データセットへの高速アクセスを提供
- S3 統合によりデータのインポートとエクスポートを簡素化
Amazon S3:
- 大規模データセットを保存
- 学習データとモデルアーティファクトを保存
ネットワーク構成
分散学習のためのネットワーク構成:
Cluster Placement Groups:
- ノード間のレイテンシーを最小化
- 同じアベイラビリティーゾーン内にノードを配置
Enhanced Networking:
- Elastic Network Adapter (ENA)
- ENA Express
- Elastic Fabric Adapter (EFA)
VPC CNI 構成:
- 大規模 Pod デプロイのための IP アドレス管理
- セカンダリ IP アドレス範囲の構成
AI/ML ワークロードのデプロイ
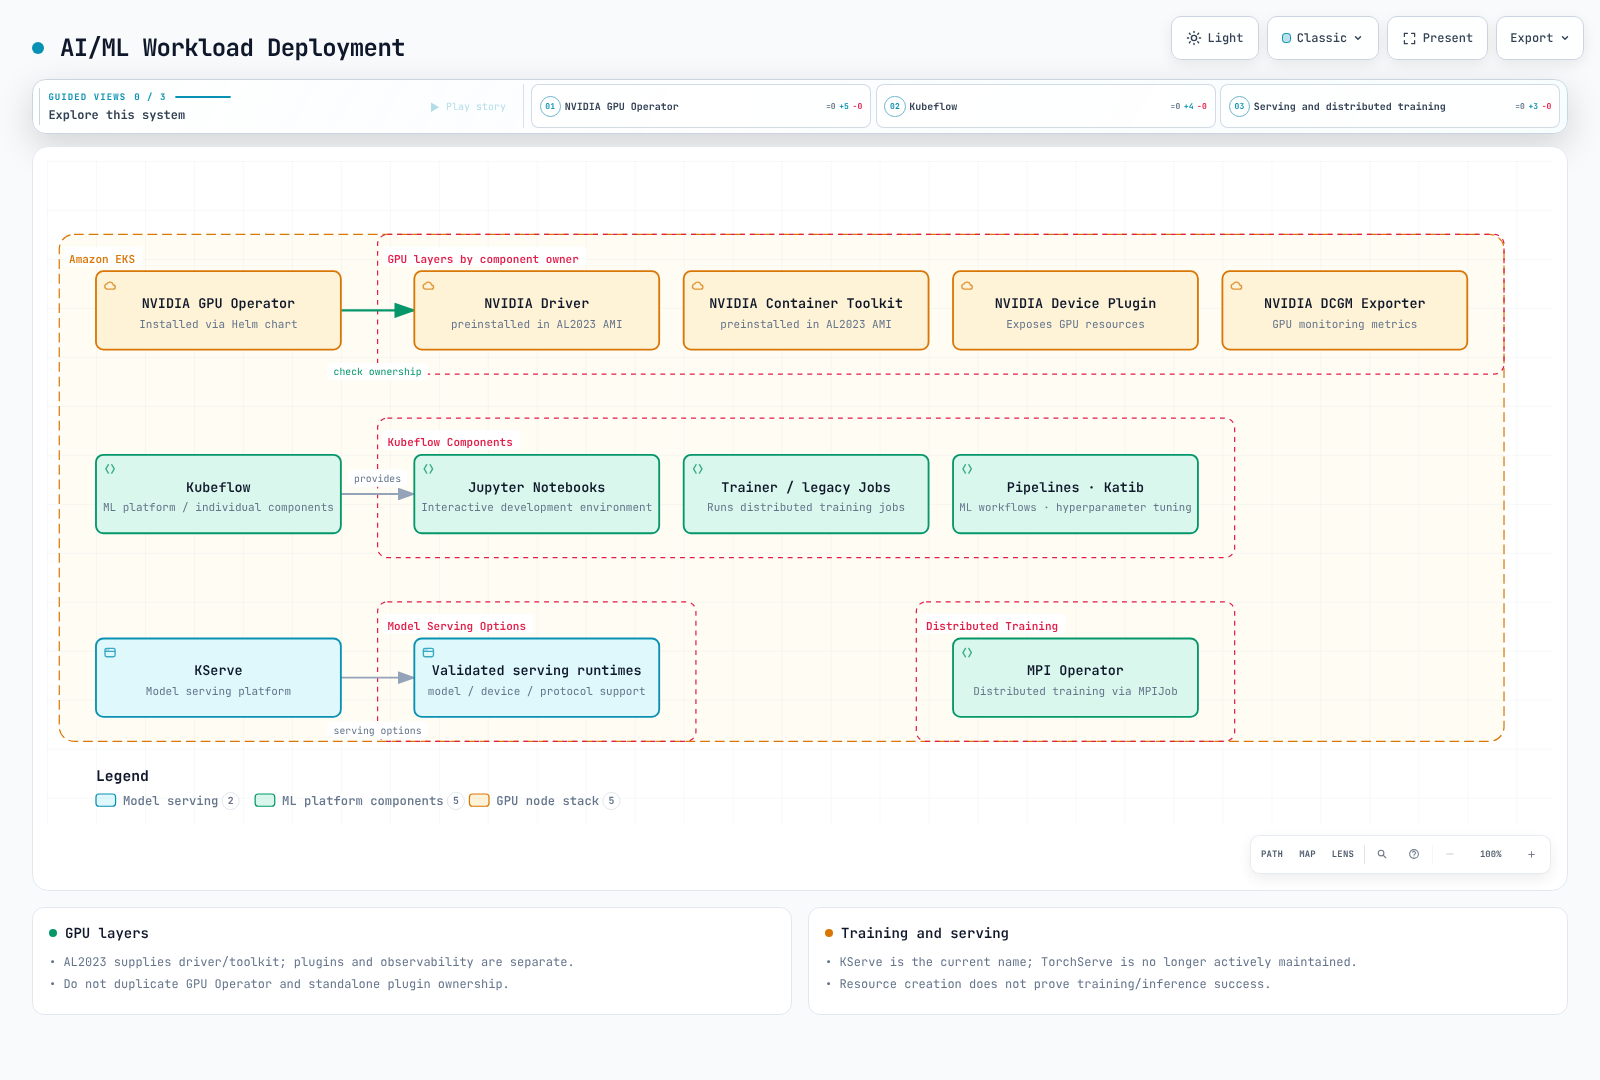
NVIDIA GPU Operator とデバイス割り当て
EKS AL2023 NVIDIA AMI にはすでにドライバーと Container Toolkit が含まれているため、GPU Operator によるそれらのインストールを無効にします。これらには device plugin/DRA driver は含まれないため、構成が必要です。Bottlerocket NVIDIA AMI には device plugin が含まれます。所有者の重複インストールを避けてください。
このコマンドは、レビュー済みの Operator chart をローカルでレンダリングします。デプロイ前に ClusterPolicy/RBAC と実際のインストール要件を確認してください。
# AL2023 NVIDIA AMI profile: host driver/toolkit are already installed.
helm repo add nvidia https://helm.ngc.nvidia.com/nvidia
helm repo update nvidia
helm template gpu-operator nvidia/gpu-operator \
  --version v26.7.0 --namespace gpu-operator \
  --set driver.enabled=false --set toolkit.enabled=false \
  > gpu-operator.rendered.yaml
NVIDIA 拡張リソースは nvidia.com/gpu です。整数の limits は同じ requests を意味し、両方を指定する場合は一致している必要があります。0.5 は有効な GPU 割り当てではありません。この CUDA 12.8 イメージは例示です。デプロイ前にホストドライバー/アーキテクチャの互換性を検証し、イメージ digest を固定してください。このレビューでは GPU 実行は行っていません。
apiVersion: v1
kind: Pod
metadata:
  name: gpu-allocation-check
spec:
  restartPolicy: Never
  containers:
    - name: check
      image: nvidia/cuda:12.8.1-base-ubuntu22.04
      command: ["nvidia-smi", "-L"]
      resources:
        requests:
          cpu: "100m"
          memory: 128Mi
        limits:
          memory: 256Mi
          nvidia.com/gpu: 1
Kubeflow と分散学習
master ブランチのワンラインインストールではなく、依存関係、アイデンティティ、ストレージには固定された 26.03.1 installation guide を使用してください。サービングプロジェクトは KServe であり、KFServing はその旧称です。
分散実行には Trainer、レガシーな TFJob/PyTorchJob、または独立した MPI Operator を使用できます。インストール済みの CRD/バージョンに基づき、MPI Operator API とレガシー Training Operator を区別してください。Job controller は Pod を作成し、MPI launcher または torchrun がプロセスを開始します。
単一の Pod で torchrun --nnodes=2 を満たすことはできず、架空の Pod DNS 名は rendezvous を提供しません。実際の学習コード/イメージ、worker 数、Service/DNS、rank/backend、データシャーディング、チェックポイント/タイムアウト/リトライ動作を指定してください。Gang scheduling には別途ポリシー/スケジューラーのサポートが必要です。
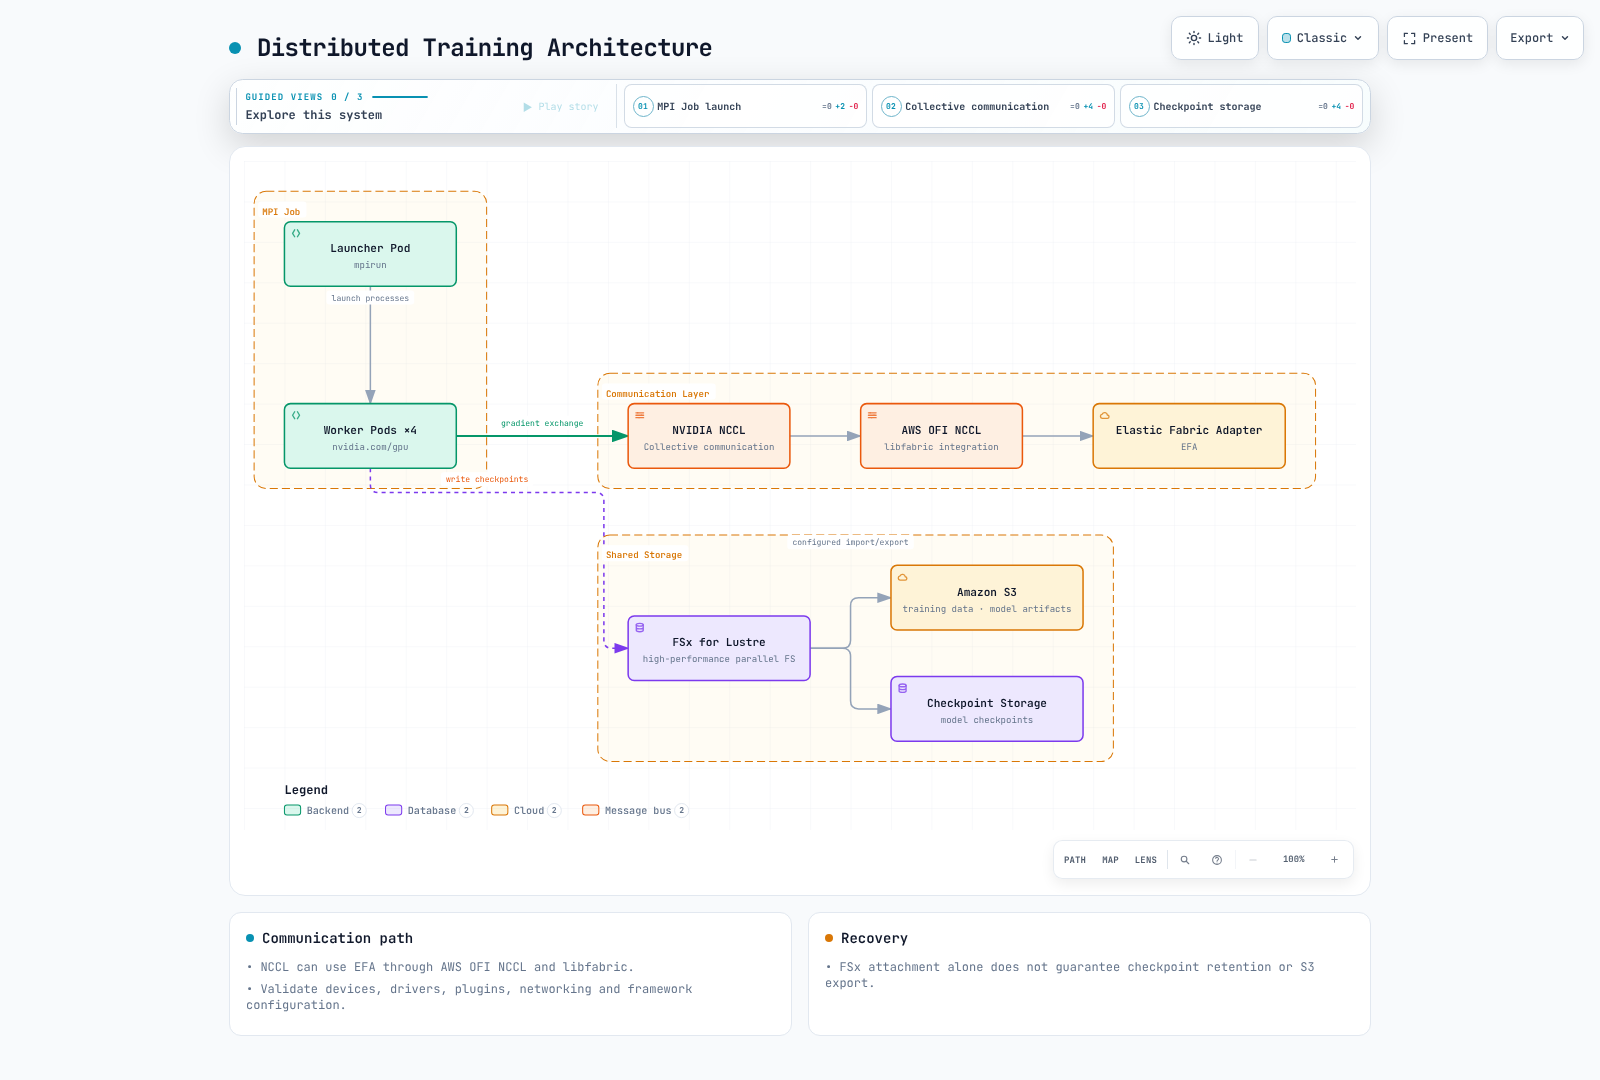
EFA 経由の NCCL では、パスは AWS OFI NCCL plugin → libfabric → EFA です。MPI は、NCCL の必須トランスポートレイヤーではなくてもプロセスを起動できます。ENA/EFA、GPUDirect、security group、AMI、ライブラリを個別に確認してください。Multus/SR-IOV またはデバイスの hostPath mount だけでは、EKS 上の EFA/GPUDirect は構成されません。
モデルサービング
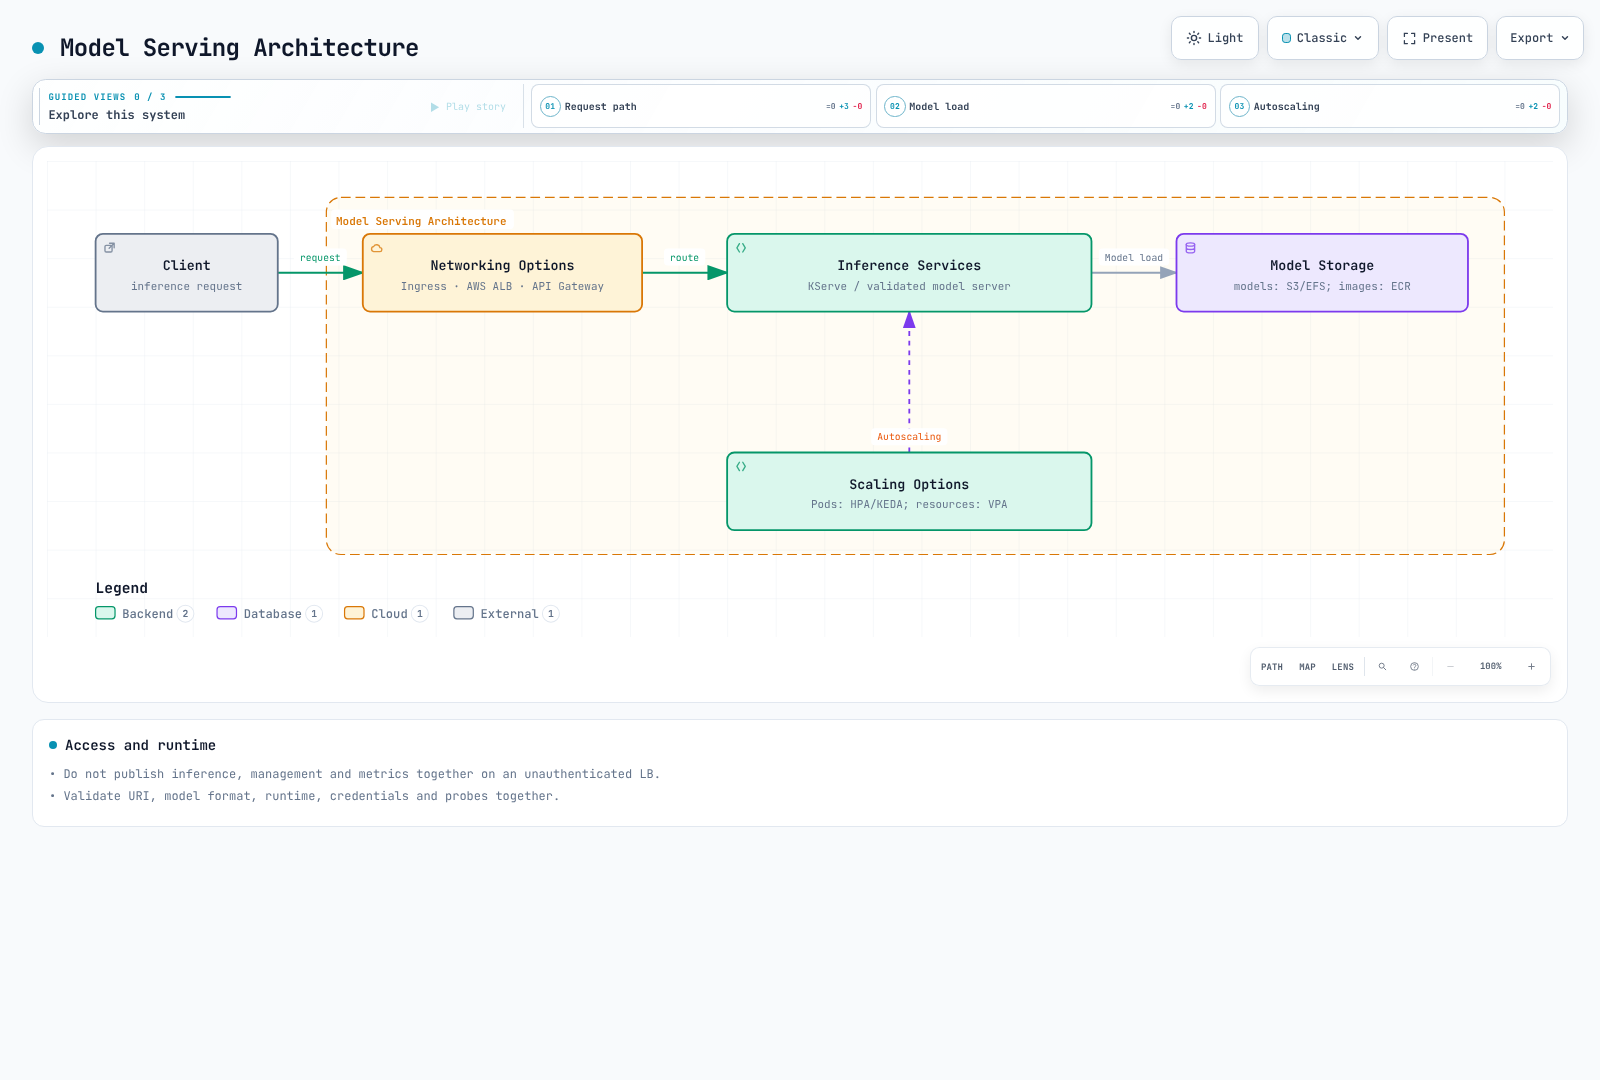
KServe の Knative/Standard モード、runtime/モデル形式、URI アクセス、プロトコル、GPU デバイス構成を確認してください。GPU request だけでは GPU 推論は有効になりません。Triton にはモデルリポジトリ、backend 構成、readiness 検証も必要です。
TorchServe はアクティブなメンテナンスや予定されたセキュリティ修正がないと表明しているため、新規デプロイの維持されるデフォルトではありません。認証されていない LoadBalancer を通じて、推論、管理、metrics のポートをまとめて公開しないでください。認証された ingress と、適切な内部管理アクセスを構成してください。
AI/ML ワークロードの最適化
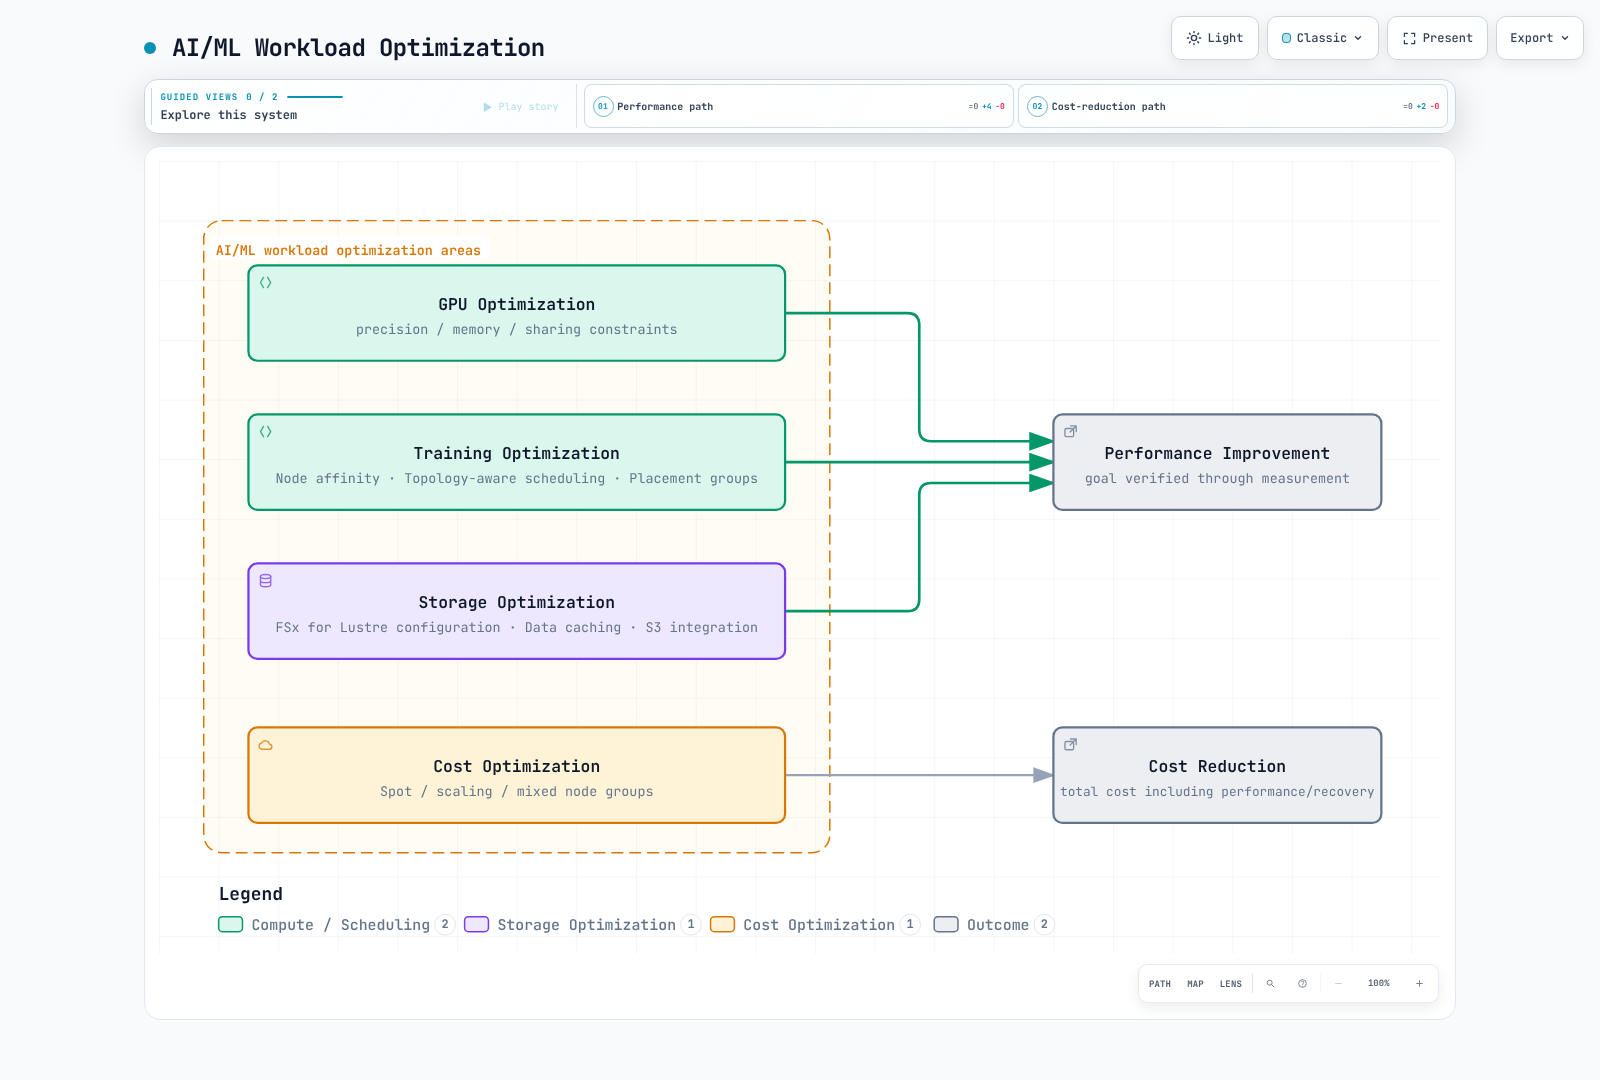
GPU 共有とメモリ
タイムスライシングは、メモリ/障害分離や比例的なパフォーマンス保証なしに、共有 GPU アクセスを公開します。MPS は別の制御デーモンを使用します。レビュー済み plugin のドキュメントでは、サポートは experimental とされ、MIG が有効なデバイスは除外されます。RuntimeClass と privileged MPS Pod だけでは、ノード全体の共有は構成されません。
これはスタンドアロンの device-plugin 構成です。GPU Operator が plugin を所有している場合は、その所有者の構成パスを使用してください。
# device-plugin-sharing.yaml: NVIDIA device plugin configuration, not a Pod.
version: v1
sharing:
  timeSlicing:
    renameByDefault: true
    failRequestsGreaterThanOne: true
    resources:
      - name: nvidia.com/gpu
replicas: 2# Alternative to an operator-owned plugin; do not install a second owner.
helm repo add nvdp https://nvidia.github.io/k8s-device-plugin
helm repo update nvdp
helm template nvdp nvdp/nvidia-device-plugin \
--version 0.20.0 --namespace nvidia-device-plugin \
--set config.default=shared \
--set-file config.map.shared=device-plugin-sharing.yaml \
> device-plugin.rendered.yamlこれにより nvidia.com/gpu.shared が公開され、Pod はそのリソースを整数 1 単位で request します。replicas=2 は GPU メモリの半分を保証しません。実際の GPU ハードウェア上で、選択したノード、割り当て、競合を検証してください。
配置とトポロジー
ゾーン/リージョンの annotation は Pod の配置を制御しません。実際のノードラベルに対して nodeSelector/affinity を使用してください。anti-affinity/spread selector も Pod ラベルと一致している必要があります。以下の実際の AZ に置き換えてください。同一 AZ への配置、ノード間への分散、gang admission はそれぞれ異なる制約です。
apiVersion: v1
kind: Pod
metadata:
  name: placement-check
  labels:
    app: placement-check
spec:
  restartPolicy: Never
  nodeSelector:
    topology.kubernetes.io/zone: us-west-2a
  affinity:
    podAntiAffinity:
      preferredDuringSchedulingIgnoredDuringExecution:
        - weight: 100
          podAffinityTerm:
            labelSelector:
              matchLabels:
                app: placement-check
            topologyKey: kubernetes.io/hostname
  containers:
    - name: check
      image: python:3.12-slim
      command: ["python", "-c", "print('placement check')"]
      resources:
        requests:
          cpu: "100m"
          memory: 64Mi
        limits:
          cpu: "1"
          memory: 128Mi
ストレージとキャッシュ
静的 FSx CSI プロビジョニングは、既存のファイルシステムを PV/PVC で接続します。ファイルシステム ID、DNS、mount name、容量、namespace を実際の値に置き換えてください。Retain はファイルシステムの自動削除を回避しますが、別途クリーンアップするまで料金は発生し続けます。
apiVersion: v1
kind: PersistentVolume
metadata:
  name: ml-fsx-existing
spec:
  capacity:
    storage: 1200Gi
  volumeMode: Filesystem
  accessModes: [ReadWriteMany]
  storageClassName: ""
  persistentVolumeReclaimPolicy: Retain
  mountOptions: [flock]
  csi:
    driver: fsx.csi.aws.com
    volumeHandle: fs-0123456789abcdef0
    volumeAttributes:
      dnsname: fs-0123456789abcdef0.fsx.us-west-2.amazonaws.com
      mountname: replace-with-actual-mount-name
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: ml-dataset
  namespace: ml-workloads
spec:
  accessModes: [ReadWriteMany]
  storageClassName: ""
  volumeName: ml-fsx-existing
  resources:
    requests:
      storage: 1200Gi
動的プロビジョニングは StorageClass/PVC からファイルシステムを作成します。静的な volumeHandle/DNS 設定を StorageClass に入れたり、未定義の fsx.aws.k8s.io/Lustre リソースを混在させたりしないでください。driver の動的な例 を使用し、デプロイタイプ固有のスループット/バックアップルールを確認してください。SCRATCH_2 は persistent 専用のオプションを使用できません。
Alluxio worker DaemonSet だけでは完全なキャッシュデプロイではありません。master/worker の役割、パス、メモリ、ネットワーク、一貫性、保持を設計してください。実際に mount した PVC 上の別のテストパスでベンチマークを実行してください。mount されていない /data に対する FIO は FSx のパフォーマンスを測定しません。
モニタリングとロギング
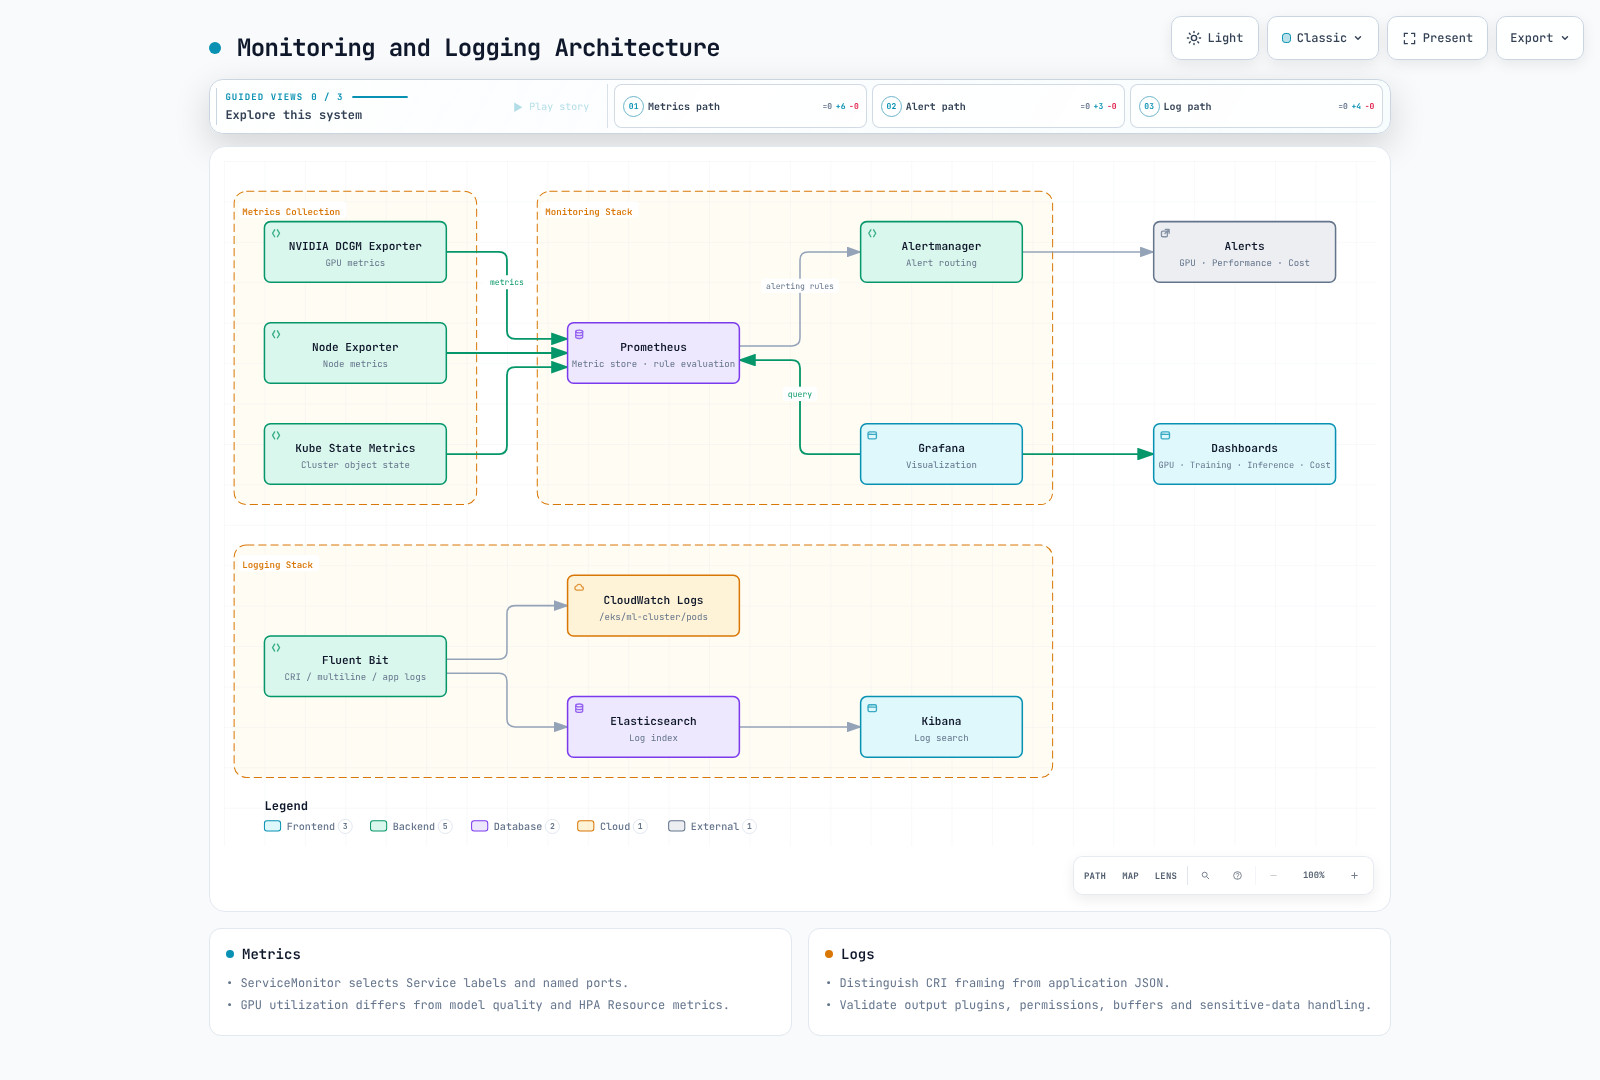
Prometheus と Grafana
DCGM Exporter は GPU metrics を提供し、device-plugin の allocatable capacity とは異なります。Operator が所有する exporter を別の DaemonSet で重複させないでください。containerd のセットアップでは Docker-socket mount は不要です。
ServiceMonitor は Pod ラベルを直接選択するのではなく、Service ラベルと名前付きポートを選択します。これらの値をインストール済み exporter Service に一致させ、Prometheus も ServiceMonitor の namespace/ラベルを選択するようにしてください。
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: gpu-metrics
  namespace: monitoring
spec:
  namespaceSelector:
    matchNames: [gpu-operator]
  selector:
    matchLabels:
      app: nvidia-dcgm-exporter
  endpoints:
    - port: gpu-metrics
      interval: 15s
GPU の utilization/memory/errors を、アプリケーションの requests、errors、latency histogram とともに監視してください。精度には ground truth を備えた評価パスが必要です。replica を追加してもモデル品質は向上しません。古い Grafana graph/flot JSON を最新の time-series/gauge 形式と実際の datasource UID に置き換え、インポートを検証してください。
ログ収集
containerd の CRI ログフレーミングとアプリケーション JSON は異なるレイヤーです。Fluent Bit の CRI/multiline parsing、パス、position database/rotation、Kubernetes metadata RBAC を構成してください。削除済みの Elasticsearch/OpenSearch document type や未定義の parser 名をコピーしないでください。CloudWatch/output 統合には、イメージ plugin、ワークロード IAM、ネットワークアクセスが必要です。機密性の高いモデルペイロードと retry-buffer の増加を管理してください。選択した収集パスについては observability guide を参照してください。
コスト最適化
Spot とノードプロビジョニング
Spot interruption/capacity shortage には、外部チェックポイント、retry/idempotency、復旧時間の検証が必要です。イメージ/AMI revision、taint/toleration、limits、interruption handling を含め、Karpenter guide の最新の NodePool/EC2NodeClass 構成を使用してください。CPU/GPU node group の混在は EKS Hybrid Nodes 製品とは異なります。
HPA とメトリクス
metrics-server が提供する CPU/メモリには HPA Resource metrics を使用します。nvidia.com/gpu の割り当ては GPU-utilization Resource metric ではありません。GPU/request シグナルには exporter と custom/external metrics adapter が必要です。
この例では、adapter により namespace/Pod ごとに公開される RPS を使用します。対象 Deployment と adapter は別途インストールが必要です。100 RPS は測定を通じて調整する例示的な目標です。同じ replica 数を制御する複数の HPA/KEDA controller を使用せず、スケーリングの所有者を一つ割り当ててください。
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: inference-hpa
  namespace: ml-workloads
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: inference-service
  minReplicas: 1
  maxReplicas: 10
  metrics:
    - type: Pods
      pods:
        metric:
          name: inference_requests_per_second
        target:
          type: AverageValue
          averageValue: "100"
不適切な集約/ラベルグループ化により、adapter が Pod ごとの値を返せなくなる場合があります。histogram percentile やモデル精度は、自動的に適切な比例 HPA シグナルになるわけではありません。負荷/キュー/レイテンシー/utilization と達成スループットを合わせて測定してください。Pod を削減しても、ノードが終了するまで EC2 料金は残る場合があります。時刻だけでは On-Demand 料金は下がりません。
データとモデルへのアクセス
Kubernetes RBAC は API アクセスを制御し、S3/KMS 権限にはワークロード IAM を使用します。大規模モデルの Secret や環境変数内の復号鍵ではなく、オブジェクトストレージ、暗号化、ファイルベースの認証情報を使用してください。Secret の base64 は暗号化ではありません。一つの peer 内の NetworkPolicy namespaceSelector と podSelector は AND であり、別々のエントリは OR です。実際の DNS/ストレージ/metrics の通信方向も許可してください。
検証と参考資料
この章は、公式 GPU Operator/device-plugin の Helm レンダリングおよび manifest/構成レビューに基づいて修正されました。実際の GPU、FSx の作成/mount、分散学習、サービング、autoscaling の実行は行っていません。対象環境でコンポーネントのバージョンとノード要件を検証してください。
- EKS accelerated AMIs
- Kubernetes GPU scheduling
- NVIDIA device plugin 0.20.0
- FSx CSI 1.10.0
- EFS performance modes
- Kubernetes HPA
クイズ
この章で学んだ内容を確認するには、トピッククイズ に挑戦してください。