パート4: 負荷テストとオートスケーリング
難易度: 中級 · 所要時間: 45分 最終更新: September 13, 2026
k6 と Locust で同じ order/payment/read フローを実行し、観測された Pod と node の変化を説明します。対象は使い捨てのラボ API のみにしてください。VU 数とレイテンシーしきい値は演習の設定値であり、測定済みのスループットやスケーリング結果ではありません。
前提条件
- パート3 の API が準備できている必要があります:
POST /ordersは201とidを返し、POST /paymentsは200/201とstatus: completedを返し、GET /orders/{id}はその ID を返します。別の API を使用する場合は、パス、payload、assertion をまとめて変更してください。 - Service cluster context は
serviceであり、すべてのコマンドで明示的に指定します。 - 例は k6 2.2.0 と Locust 2.46.5/Python 3.12 で確認しました。OS/CPU アーキテクチャに対応した 公式インストールガイド に従ってください。
- パート3 で KEDA ScaledObject と Karpenter NodePool/EC2NodeClass を設定してください。インフラストラクチャのクエリには、実際の kube-state-metrics/cAdvisor の取り込みが必要です。
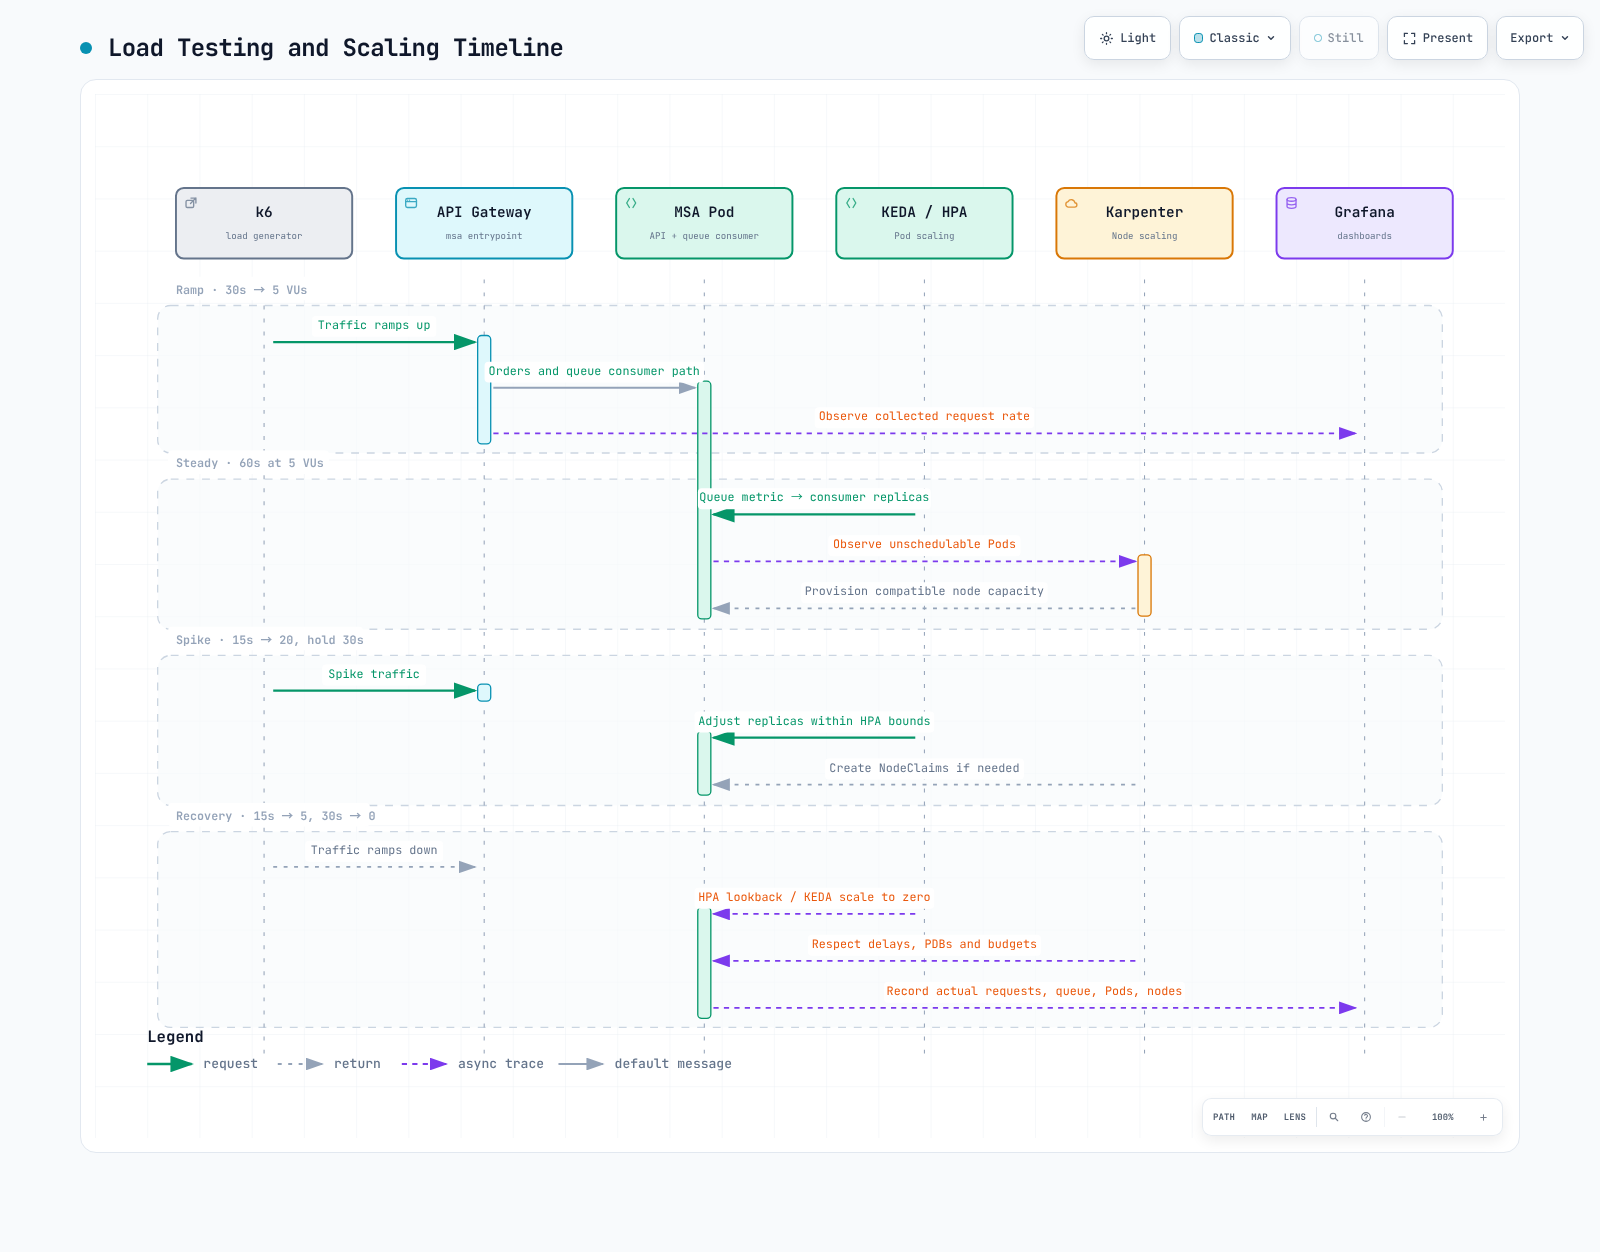
1. 小規模テストで API を検証する
実行可能な例 の k6-scenario.js を使用します。port-forward は実行した terminal で継続させてください。
# Run from the repository root.
cd examples/labs/observability/load-test
kubectl --context service -n msa port-forward svc/api-gateway 8080:8080# In another terminal, from the same directory.
BASE_URL=http://127.0.0.1:8080 LOAD_PROFILE=smoke \
k6 run --no-usage-report k6-scenario.jsデフォルトの smoke test は 1 VU で 2 回の iteration を実行します。テストで作成された ID のみを読み取り、無効な JSON、ID の欠落、拒否された payment、レスポンス内の異なる order を拒否します。しきい値により、失敗した check() の結果はゼロ以外の exit になります。k6-summary.json と exit code の両方を確認してください。summary に表示されるため、summaryTrendStats には p(99) が含まれます。
2. 継続的な負荷ステージを実行する
BASE_URL=http://127.0.0.1:8080 LOAD_PROFILE=scale \
k6 run --no-usage-report k6-scenario.js| ステージ | 期間 | 目標 VU 数 |
|---|---|---|
| ランプアップ | 30s | 5 |
| 定常 | 60s | 5 |
| スパイク・ランプアップ | 15s | 20 |
| スパイク維持 | 30s | 20 |
| 復旧 | 15s | 5 |
| クールダウン | 30s | 0 |
ステージの合計は 3 分で、追加の graceful-stop 時間が発生する可能性があります。単一の stages シーケンスにより、独立した scenario の重複を回避します。VU は RPS ではありません。レスポンスタイム、iteration あたりのリクエスト数、sleep がスループットを決定します。NodePool の capacity と予算を確認してから負荷を増やしてください。controller の制限と AWS Budgets の通知は、絶対的な支出上限ではありません。
k6-job.yaml は cluster 内で使用する smoke-only の代替手段です。最初に README のコマンドを使用して obs-lab-k6 ConfigMap を作成してください。この Job の retry はゼロで、deadline は 120 秒、resource limit が設定されています。Job の作成はテスト成功を証明しません。log、Pod exit code、Complete/Failed condition を確認してください。
3. Locust の代替手段
python3.12 -m venv .venv
.venv/bin/python -m pip install -r requirements.txt
.venv/bin/locust -f locustfile.py --headless \
  --host http://127.0.0.1:8080 --users 1 --spawn-rate 1 \
  --run-time 10s --stop-timeout 5 --exit-code-on-error 99 \
  --csv locust-results
headless mode は、management UI や worker RPC Service の公開を回避します。分散実行には、それぞれの authentication、内部 network、worker 設定が必要です。両ツールは同じ API フローをテストしますが、scheduler が異なります。VU/user 数が等しいだけでは、実験は同等になりません。
4. Pod と node を分けて観測する
kubectl --context service -n msa get scaledobject,hpa
kubectl --context service -n msa describe scaledobject
kubectl --context service -n msa get pods -o wide
kubectl --context service get nodepools,nodeclaims
kubectl --context service get nodes -L karpenter.sh/nodepool,karpenter.sh/capacity-type
kubectl --context service -n msa get events --sort-by=.metadata.creationTimestamp
SQS scaler は queue attribute を読み取ります。message を消費するわけではありません。consumer queue と ScaledObject URL が一致していることを確認してください。queueLength は Pod ごとの目標値です。message count、in-flight/delayed 設定、replica の上下限、HPA の動作が結果に影響します。API producer だけをスケーリングしても、consumer backlog は解消されません。
Karpenter は、要件を NodePool で満たせる unschedulable Pod に対して capacity をプロビジョニングします。image pull、PVC、taint も診断してください。node を増やしても解決しない場合があります。hostname の部分文字列ではなく、実際の NodePool label を使用して node を選択してください。
5. Dashboard とクエリ
# Running Pods: phase series also exist with value zero.
sum(kube_pod_status_phase{namespace="msa", phase="Running"})

# Deployment total/ready replicas are different measurements.
kube_deployment_status_replicas{namespace="msa"}
kube_deployment_status_replicas_ready{namespace="msa"}

# HPA desired/current replicas.
kube_horizontalpodautoscaler_status_desired_replicas{namespace="msa"}
kube_horizontalpodautoscaler_status_current_replicas{namespace="msa"}

# Container resource usage; exclude the empty and Pod infrastructure series.
sum by (pod) (rate(container_cpu_usage_seconds_total{namespace="msa", container!="", container!="POD"}[5m]))
sum by (pod) (container_memory_working_set_bytes{namespace="msa", container!="", container!="POD"})
Running phase の 0/1 gauge を合計すると、観測対象のすべての Pod が Pending の場合はゼロを返し、telemetry がない場合は欠損のままです。すべての series を == 1 でフィルタリングすると、この区別が失われます。
kube_deployment_status_replicas は ready count ではありません。Rollout workload の場合は、Deployment metric が存在すると仮定せず、Rollouts exporter/ReplicaSet/Pod state を使用してください。カスタム node label は、kube-state-metrics で許可されている場合にのみ kube_node_labels に表示されます。changes(kube_node_created[10m]) は一定の作成 timestamp を観測するため、新しく作成された node を検出しません。
RED panel を追加する前に、実際の application metric 名、unit、label を確認してください。OTel HTTP histogram とカスタム Prometheus counter は異なる場合があります。範囲が限定された Service/route/status label を集約し、order や customer ID を label として使用しないでください。同じ Service/route 範囲で error ratio を計算し、traffic がない間隔は欠損した measurement として表示してください。
6. Scale-in と検証記録
| 制御項目 | 実際の意味 |
|---|---|
KEDA cooldownPeriod | ゼロへのスケーリング時に、最後の active trigger の後で待機する |
HPA scaleDown.stabilizationWindowSeconds | 1→N のスケーリングについて、lookback window 内の最も高い recommendation を考慮する |
Karpenter consolidateAfter | Pod の変更後、consolidation の検討を開始するまでの遅延 |
| PDB/disruption budget/constraint | consolidation/termination を遅延または阻止する可能性がある |
空の node が直ちに削除されることや、特定の時点で正確な replica 数になることを約束しないでください。実際の baseline/peak/recovery RPS、error、p99、queue depth、desired/ready Pod、NodeClaim、Pending reason を記録してください。node 数だけでは、AWS の総節約額を定量化できません。
クリーンアップと次の手順
テストが停止したことを確認し、使用した場合は obs-lab-k6-smoke Job/ConfigMap を削除して、port-forward を停止してください。alert の検証については パート5 に進んでください。インフラストラクチャのクリーンアップについては パート6 に従ってください。
参照資料と検証範囲
実際の k6/Locust ツールは、6 種類の成功/失敗ケースについて synthetic loopback HTTP server を対象にテストしました。cluster、実際の MSA、AWS 負荷、node スケーリング、capacity テストは実行していません。