パート 6: 分散トレーシング分析
難易度: 上級 · 推定時間: 45 分 最終更新: September 13, 2026
メトリクスから exemplar を経由して trace とログに至る実際の 1 リクエストを追跡し、観測結果と因果仮説を分けます。これには パート 2 の取り込みパスと、パート 3 のコンテキスト伝播が必要です。以下の TraceQL は実際の Tempo 3.0.3 パーサーで確認済みであり、現在の OTel 属性を使用します。
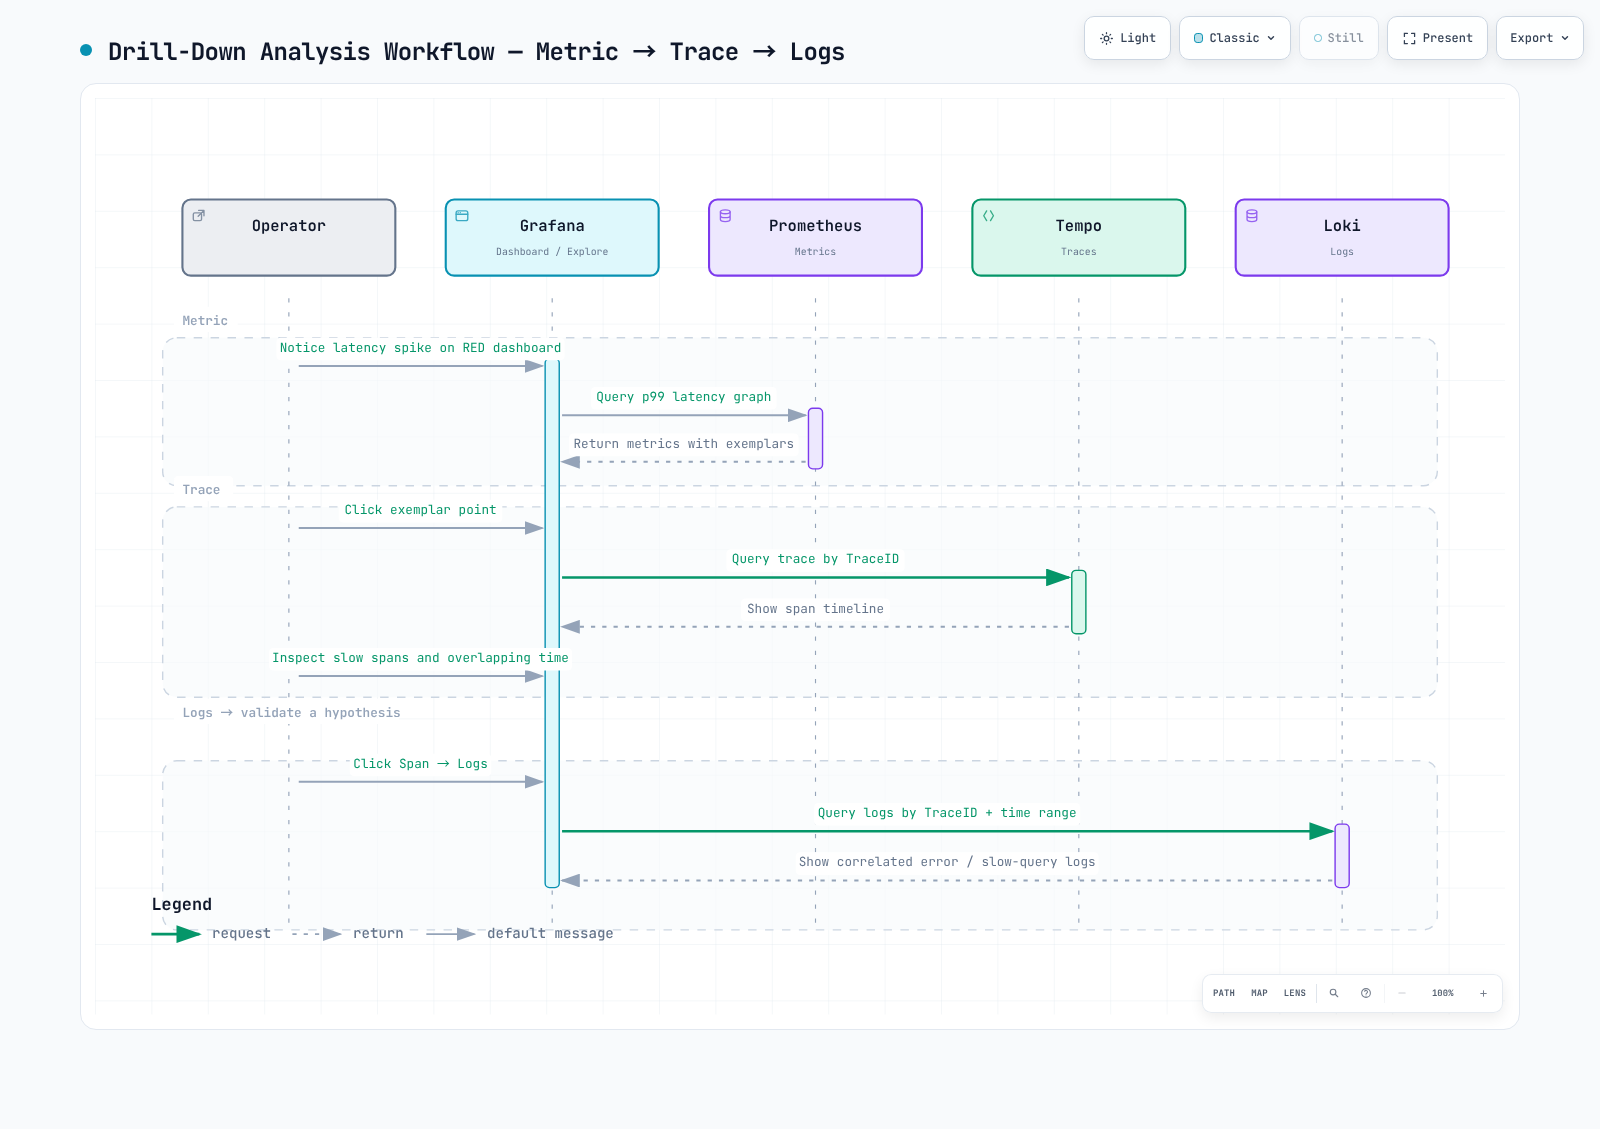
1. TraceQL 検索
{ resource.service.name = "order-service" && span:duration > 1s }

{ trace:duration > 2s && resource.service.name = "order-service" }

{ span:kind = server && span.http.response.status_code >= 500 }

{ span.db.system.name = "postgresql" && span:duration > 100ms }

{ span.messaging.system = "aws_sqs" && span.messaging.operation.type = "send" }

{ resource.service.name = "api-gateway" } >> { resource.service.name = "order-service" }

{ resource.service.name = "order-service" } >> { span.db.system.name = "postgresql" }

{ span:status = error } | select(resource.service.name, span.http.response.status_code, span:duration)
span:duration は個々の span を測定し、trace:duration は trace 全体を測定します。明示的な組み込み属性には span: を、属性には span./resource. を使用します。>> は左側の span の子孫である右側の span を検索します。DB span の子孫を検索することは、Service 配下の DB 処理を検索することとは異なります。
sort(duration)、SQL の order by、| limit 20、{ duration > p99 } はこの検索構文ではありません。Grafana で結果のソート、検索上限、時間範囲を設定し、計測した p99 は 800ms のような duration リテラルに置き換えます。select() は表示する属性を要求します。保存されなかった span を再作成することはできません。
古い SDK は http.status_code、http.method、db.system、db.statement、または messaging.operation を出力する場合があります。現在の http.response.status_code、http.request.method、db.system.name、db.query.text、messaging.operation.type を使用する前に、実際の span と SDK バージョンを確認してください。クエリ属性の名前を変更しても、収集済みデータは変換されません。クエリテキストは明示的なサニタイズポリシーの下でのみ取得し、パスワード、SQL リテラル、顧客データを除外してください。
2. Service graph の前提条件
Tempo で trace を受信するだけでは、Grafana の Service graph は完成しません。metrics-generator の service-graphs processor を有効化し、そのメトリクスを実際のメトリクスバックエンドに配信して、Grafana Tempo datasource の serviceMap UID をそのバックエンドにリンクしてください。client/server または producer/consumer の span はコンテキストを共有する必要があります。サンプリング、欠落した span、不正確な span kind は、生成される edge に影響します。
sum by (client, server) (rate(traces_service_graph_request_total[5m]))

(
  sum by (client, server) (rate(traces_service_graph_request_failed_total[5m]))
  or on (client, server)
  (0 * sum by (client, server) (rate(traces_service_graph_request_total[5m])))
)
/ on (client, server)
(sum by (client, server) (rate(traces_service_graph_request_total[5m])) > 0)

sum by (client, server) (rate(traces_service_graph_request_server_seconds_sum[5m]))
/
sum by (client, server) (rate(traces_service_graph_request_server_seconds_count[5m]))
障害カウンターは、最初の障害が発生するまで series を持たない場合があります。対応する request-total series から欠損した分子をゼロで補い、正の分母を必須にすることで、正常な 0% とトラフィックなしまたは取り込み欠落を区別します。
最後のクエリは、平均 server 側 duration を測定します。client 側 duration には traces_service_graph_request_client_seconds_* を使用してください。存在しない traces_service_graph_request_duration_seconds_* family をクエリしてはいけません。トラフィックがゼロの間隔は、欠損した証拠として扱います。色と edge の幅は Grafana/dashboard の設定に依存します。固定の 1%/5% の色ルールを想定するのではなく、request/error/duration の値を確認してください。
3. waterfall からボトルネック仮説を立てる
| 観測結果 | 次の調査 |
|---|---|
| 遅い DB span | クエリプラン、lock、connection pool、DB メトリクスを確認する |
| 長い client span | DNS/TLS/network/server wait/retry の間隔を比較する |
| parent と child の間のギャップ | 計装されていない処理、queue、GC、scheduling を確認する |
| 並列の child span | duration を合計するのではなく、重なりと critical path を分析する |
| Messaging の遅延 | send/receive/process duration を queue wait と redelivery から分離する |
parent の duration には child の duration が含まれます。すべての span を合計すると時間を二重計上します。1.8 秒の DB span だけでは、index の欠落を証明できません。仮説を受け入れる前に、同じ release、トラフィック、時間範囲でログとメトリクスを比較してください。
4. ログと trace をリンクする
{service_name="order-service"} | json | level="ERROR"

{service_name="order-service"} | json | trace_id="0123456789abcdef0123456789abcdef"
これらのクエリは、実際の service_name stream label と JSON の trace_id field を前提としています。32 文字の例の trace ID は、実際の request ID に置き換えてください。traceID、traceId、trace_id は異なる field です。trace ID は一意な stream label ではなく、ログ field/structured metadata に保持してください。時間境界は Grafana/HTTP parameters で設定してください。timestamp >= 2025-... を LogQL に追加してはいけません。
Loki derived field は trace ID を抽出し、Tempo datasource UID にリンクします。Grafana provisioning YAML では、内部リンク式を $${__value.raw} としてエスケープしてください。二重引用符で囲んだ regex と広範な shell envsubst は backslash や Grafana 変数を変更することがあります。適切な単一引用符と、限定した置換を使用してください。
Tempo の tracesToLogsV2 は Loki UID、実際の resource-to-log label mapping、time padding、trace-ID filtering を設定します。「Logs for this span」をクリックした後、生成された LogQL を確認してください。リンクが存在することと、同じ request を正常に取得できることは別の確認事項です。
5. Exemplar の意味と検証
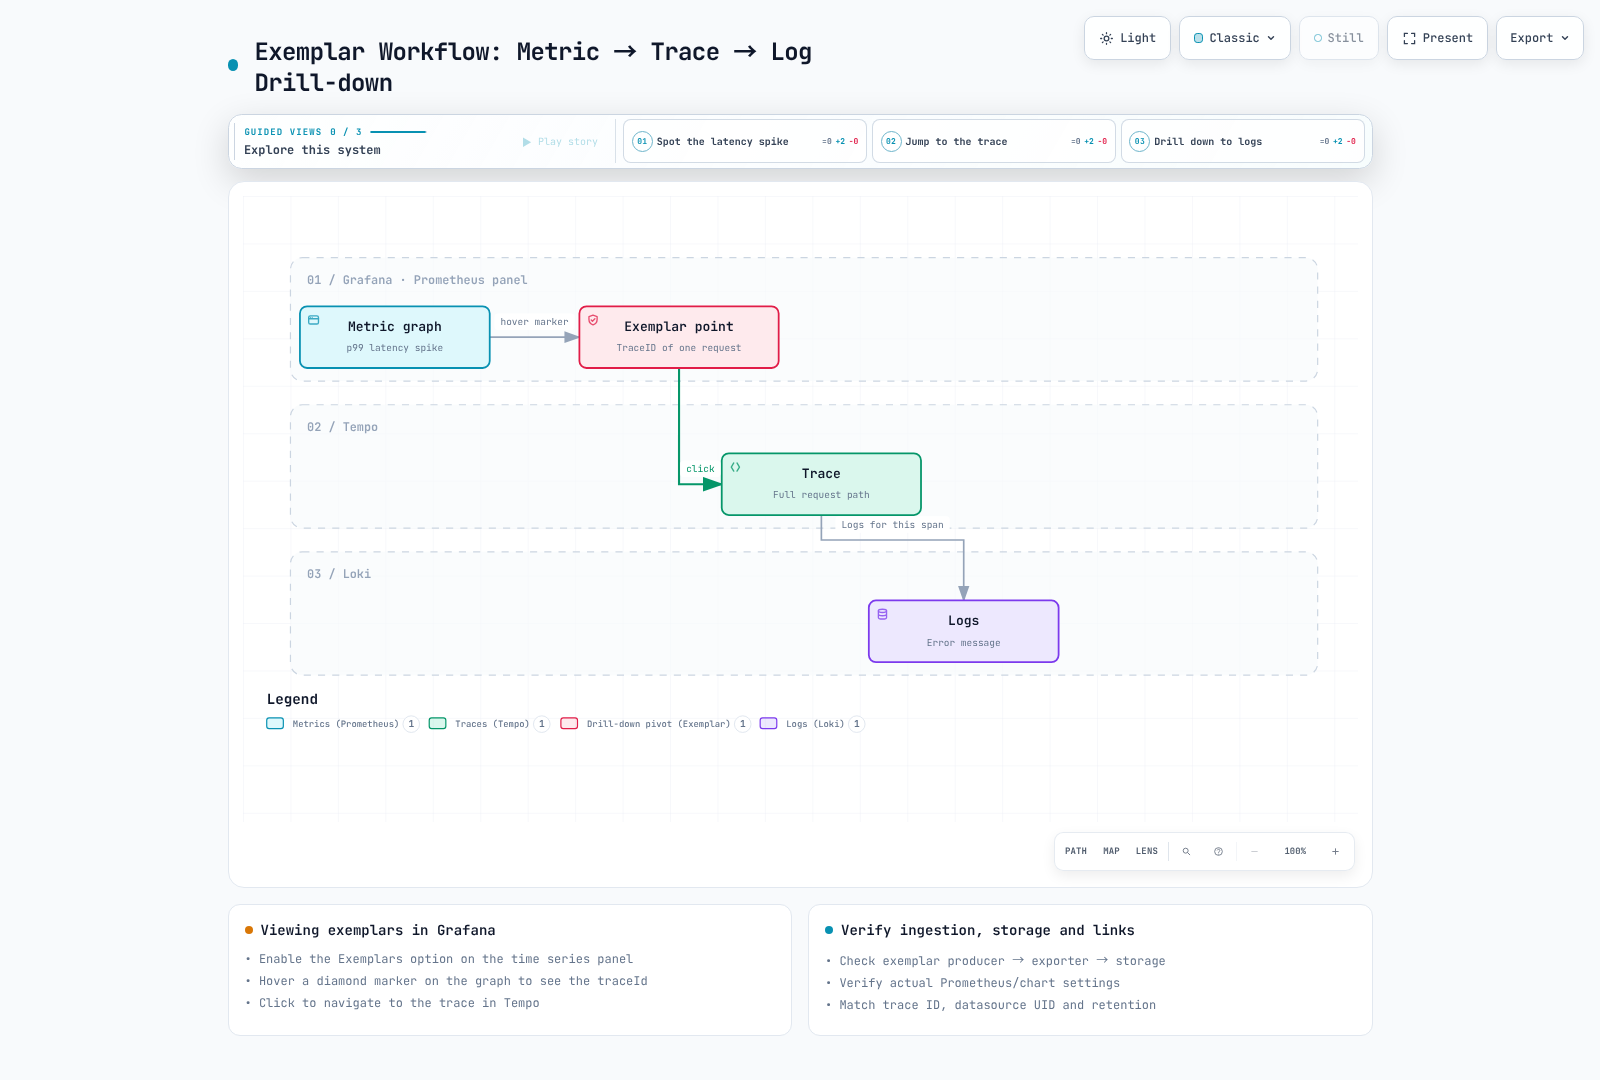
exemplar は aggregate に関連付けられた代表的な観測値です。p99 グラフ上の点をクリックしても、その request が正確な percentile 境界を決定したことは証明されません。exemplar の生成、exporter/remote-write による保持、Prometheus の保存、Grafana datasource のリンクがすべて機能する必要があります。サンプリングや保持期間により、trace を利用できない exemplar ID が残る場合があります。
実際の Prometheus exemplar API の結果を確認し、返された trace_id で Tempo をクエリしてください。Grafana の表示オプションを有効にしたり、存在しない Prometheus ConfigMap を検索したりすることは、取り込みの検証ではありません。インストール済みの Prometheus/chart バージョンとレンダリングされた Prometheus resource/runtime arguments に対して、exemplar-storage の設定を確認してください。
6. RED と SLI/SLO dashboard
実際のメトリクス名、label、histogram 単位から RED panel を構築します。同じ Service/route のスコープで request rate、failure ratio、duration distribution を比較してください。availability を計算する前に、対象となる request と成功を定義し、4xx response、health check、retry をどのように扱うかを明記してください。
30 日間の SLO には、その期間にわたる実際の retention と観測値が必要です。新しい lab での [30d] クエリは、30 日分の証拠を作成しません。トラフィックなし、欠損 series、counter reset を処理し、少量データでの percentile の制約を開示してください。同じ window における許容失敗数と観測された失敗数を使用して error budget を計算します。固定の「99.9% 達成」と主張するのではなく、期間、分母、値を記録してください。
7. フローを検証してからクリーンアップする
クリーンアップの前に、exemplar ID、Tempo trace ID、ログの trace ID が一致する request を 1 件記録してください。実際の Service graph の依存関係と alert 配信を検証します。推定値で結果を埋めるのではなく、計測値、timestamp、設定バージョンを保持してください。
| 順序 | アクションと完了条件 |
|---|---|
| 1 | k6/Locust、fault injection、AI analysis trigger を停止し、結果を保存する |
| 2 | GitOps ApplicationSet/parent による再作成を停止し、実際の application を cascade-delete する |
| 3 | service-cluster LoadBalancer/Ingress、workload、PVC を削除し、外部 LB/volume のクリーンアップを検証する |
| 4 | 実際の release/namespace 名を使用して、operator をアンインストールする前に telemetry custom resource を削除する |
| 5 | controller を削除する前に Karpenter NodeClaim を drain/delete し、依存関係が存在する間は API/LB/storage controller を保持する |
| 6 | 同じ IaC state を使用して destroy plan を確認し、手動で作成した AWS resource には記録済みの正確な ID/ARN を使用する |
| 7 | 依存関係のクリーンアップ後に EKS/VPC を削除し、managed service の削除と残存 resource を検証する |
共有 namespace や cluster 全体の CRD を削除してはいけません。latest の installer URL ではなく、記録したインストールの release/namespace/version を使用してください。バージョン管理された S3 では、現行 object だけでなく古い version と delete marker も確認する必要があります。Aurora snapshot policy、MWAA/DAG bucket、AMG、AMP、OpenSearch、SNS/SQS/DLQ、Lambda/API Gateway、IAM attachment、EBS/LB、log group、alarm を inventory と照合してください。受け付けられた削除リクエストは、削除完了ではありません。
未確認の自動承認された destroy を使用したり、すべての error を抑制したり、作業ディレクトリ全体を削除したりするのではなく、resource ownership を確認し、証拠/state を保持してください。
検証範囲と参考資料
現在の Tempo parser は、受理された 12 件のクエリを検証し、以前の誤った 3 件のクエリを拒否しました。一時的なローカル Loki 3.7.7 は 2 行の合成ログを受信し、どちらの LogQL クエリでも完全に想定どおりの trace ID を取得しました。実際の Service に対する Tempo 検索、Loki の収集、Grafana データリンク、クラウドの削除は実行していません。