EKS 上の Ray 詳細解説
レビュー基準: Ray 2.58.0, KubeRay v1.7.0 ドキュメントレビュー日: September 12, 2026
概要
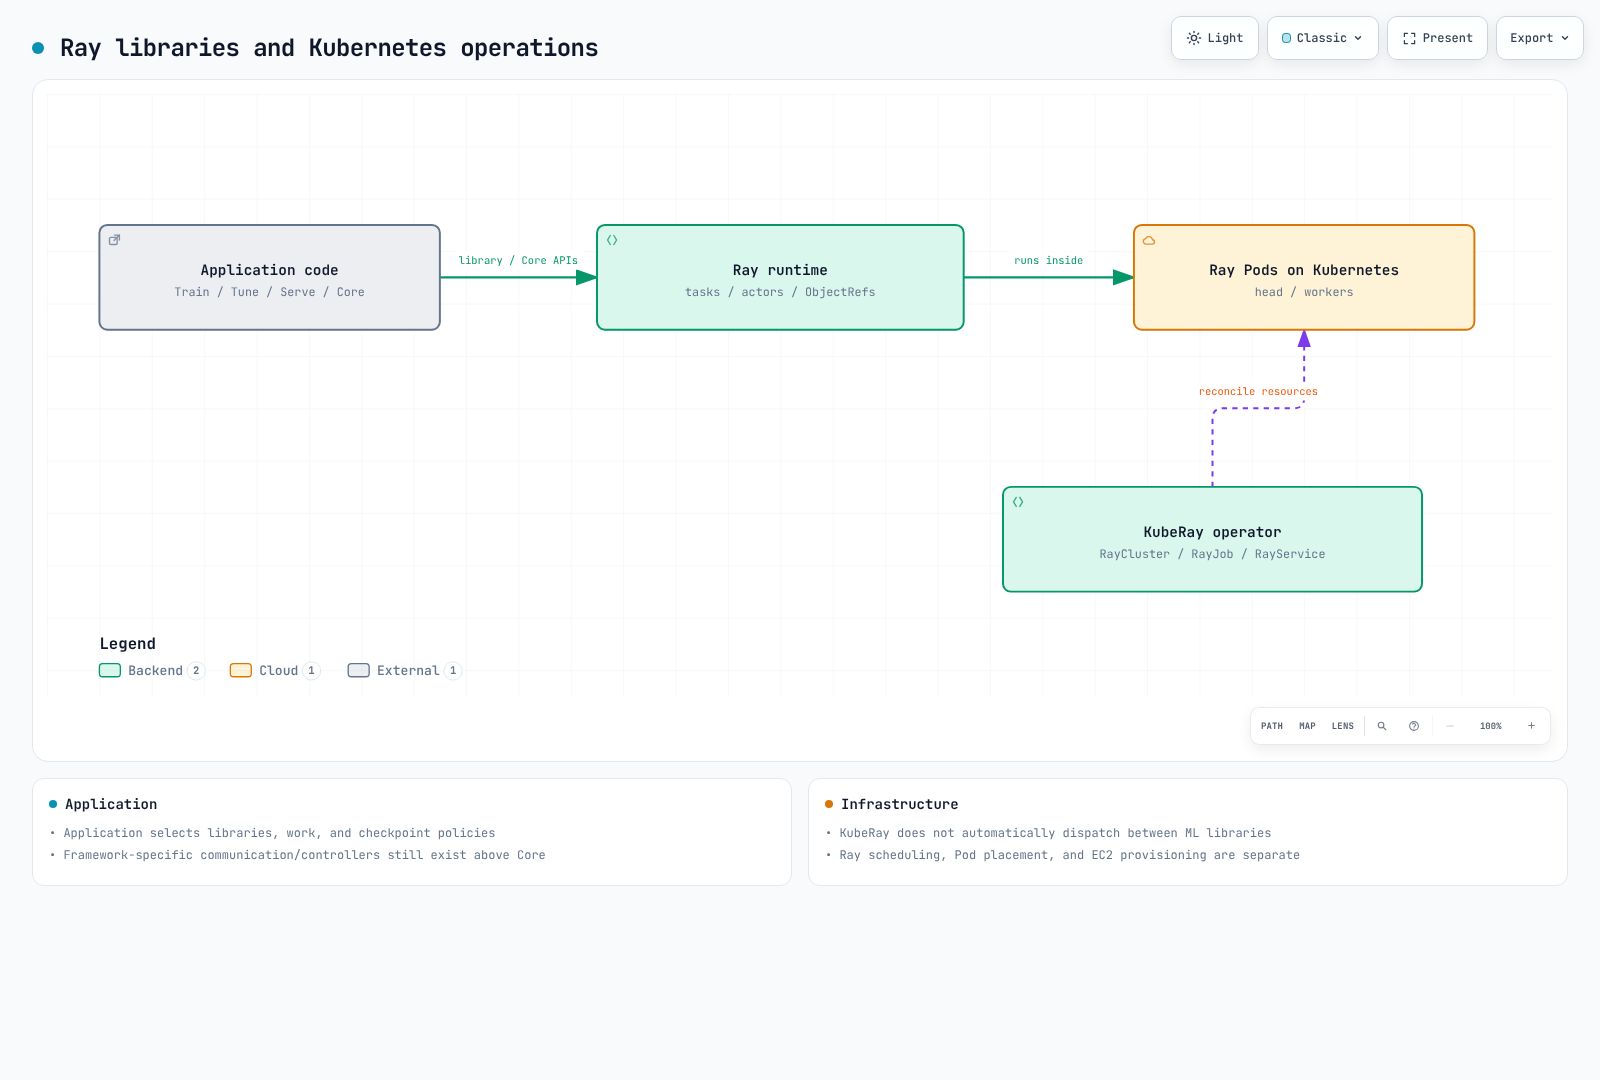
Ray は、tasks、actors、ObjectRefs、およびノードごとの object stores を使用して Python の処理を分散します。Train、Tune、Serve はこの基盤を利用しながら、トレーニング、探索、サービングのポリシーを追加します。単一の object-store パスですべての通信やリカバリの課題を自動的に処理できるわけではありません。
KubeRay は、RayCluster、RayJob、RayService を reconcile する Kubernetes operator です。アプリケーションの ML library を dispatcher として選択するものではありません。Ray のワークスケジューリング、Kubernetes Pod の配置、EC2 node のプロビジョニングは、それぞれ独立したレイヤーです。
コンポーネントマップ
| 概念 | 解決する課題 | 詳細解説 |
|---|---|---|
| アーキテクチャ | すべての基盤となる tasks、actors、object store | Part 1 |
| KubeRay Operator | Ray clusters をネイティブ Kubernetes resources(RayCluster/RayJob/RayService)として実行 | Part 2 |
| Ray Train & Tune | 分散モデル学習とハイパーパラメータ探索 | Part 3 |
| Ray Serve | 専用の LLM-serving building blocks を含むモデルサービング | Part 4 |
EKS でこれを実行する理由
トレードオフは、このドキュメントサイトの data/ML セクションの他の箇所で扱ったものと同じです。すでに EKS を運用しているチームは、managed alternative を使用する代わりに KubeRay operator とその RayCluster/RayJob/RayService resources を直接運用することで、クラスター上の他のすべてのワークロードと同様に、Ray workloads に対して同じ node-pool autoscaling(Karpenter 経由)、IAM、observability patterns を再利用できます。
基盤の確認は、小規模な single-node Ray run です。これは GPU training、multi-node recovery、稼働中の EKS installation、または autoscaling の証拠ではありません。
現在カバーしている内容
- Part 1: Ray アーキテクチャ — tasks、actors、object store、head/worker cluster model
- Part 2: KubeRay Operator — RayCluster、RayJob、RayService、および Karpenter を使用した two-tier autoscaling pattern
- Part 3: Ray Train と Ray Tune — 分散トレーニングとハイパーパラメータチューニング
- Part 4: Ray Serve — モデルサービング、Ray Serve LLM、RayService ベースの本番デプロイメント