Kubernetes スケジューリング、プリエンプション、Eviction
サポート対象バージョン: Kubernetes 1.34 - 1.36 (Descheduler v0.36 の例) 最終更新: September 17, 2026
Kubernetes において、スケジューリングは Pod を適切な Node に配置するプロセスです。プリエンプションは高優先度の Pod のための空きを確保するために低優先度の Pod を削除するプロセスであり、Eviction は Pod を終了します。ワークロードコントローラーは置き換え用の Pod を作成する場合があり、その Pod はスケジューラーによって別途配置されます。この章では、Kubernetes のスケジューリングメカニズム、Node 選択、プリエンプション、Eviction、および Amazon EKS におけるスケジューリング最適化手法について学びます。
ラボ環境のセットアップ
このドキュメントの例に従うには、以下のツールと環境が必要です。
必要なツール
- API サーバーと 1 マイナーバージョン以内の kubectl
- 動作する Kubernetes クラスター(EKS、minikube、kind など)
- 複数の Node を持つクラスター(スケジューリングテスト用)
スケジューリング例のセットアップ
# Create namespace
kubectl create namespace scheduling-demo

# Add labels to nodes (if you have multiple nodes)
kubectl label nodes <node-name> disktype=ssd
kubectl label nodes <node-name> gpu=true

# Create a pod using node affinity
kubectl -n scheduling-demo apply -f - <<EOF
apiVersion: v1
kind: Pod
metadata:
  name: nginx-ssd
  labels:
    app: nginx
spec:
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
        - matchExpressions:
          - key: disktype
            operator: In
            values:
            - ssd
  containers:
  - name: nginx
    image: nginx
EOF

# Create priority class
kubectl apply -f - <<EOF
apiVersion: scheduling.k8s.io/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 1000000
globalDefault: false
description: "This priority class should be used for critical service pods only."
EOF

# Create Pod Disruption Budget (PDB)
kubectl -n scheduling-demo apply -f - <<EOF
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: nginx-pdb
spec:
  minAvailable: 1
  selector:
    matchLabels:
      app: nginx
EOF
Kubernetes スケジューリングアーキテクチャ
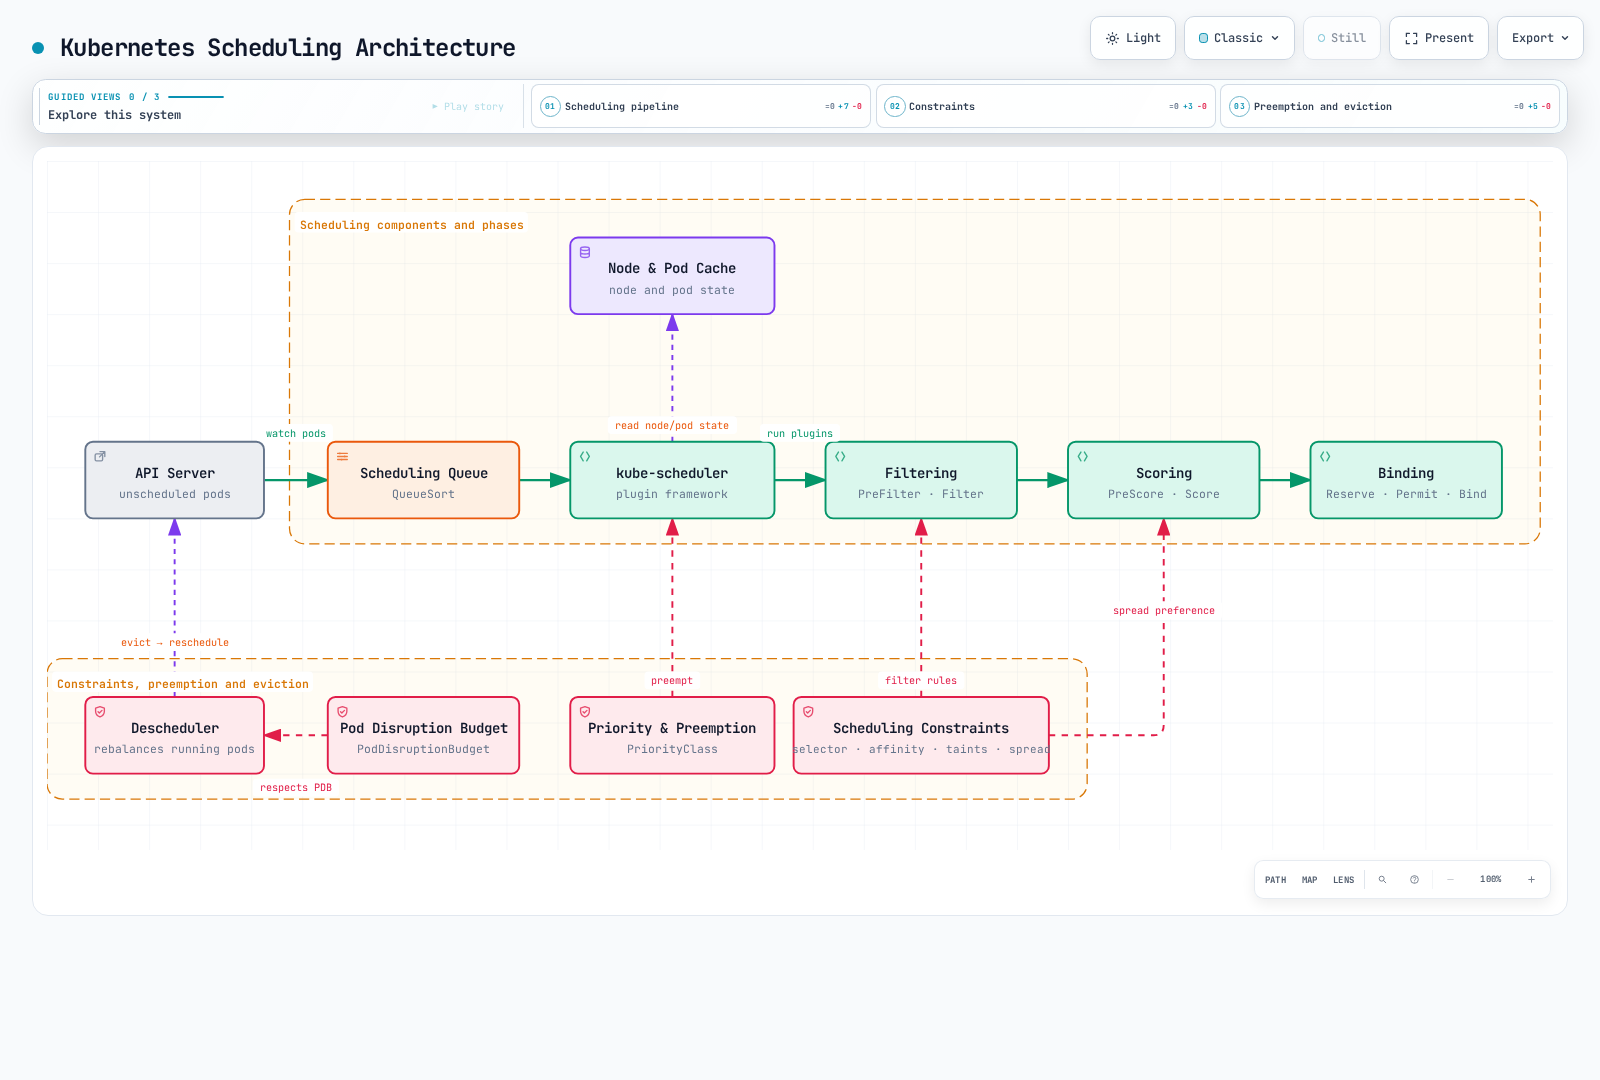
スケジューリング概念の比較
| 概念 | 目的 | ユースケース | Kubernetes バージョン |
|---|---|---|---|
| Node Selector | 特定のラベルを持つ Node に Pod を配置 | 単純な Node 選択 | すべてのバージョン |
| Node Affinity | 複雑な Node 選択ルールを定義 | 高度な Node 選択 | 1.6+ |
| Pod Affinity | 他の Pod の近くに Pod を配置 | 関連 Service の同一配置 | 1.6+ |
| Pod Anti-Affinity | 他の Pod から離して Pod を配置 | 高可用性の確保 | 1.6+ |
| Taints and Tolerations | 特定の Pod のみを Node 上で許可 | 専用 Node、Node 分離 | 1.6+ |
| Topology Spread Constraints | トポロジードメイン全体に Pod を分散 | アベイラビリティーゾーン間の分散 | 1.16+ (1.19 で GA) |
| Priority and Preemption | 重要なワークロードを優先 | クリティカルな Service の保証 | 1.8+ (1.11 で GA) |
| Pod Disruption Budget | 同時に中断される Pod を制限 | 高可用性の確保 | 1.4+ (1.21 で GA) |
基本的なスケジューリングの概念
重要な概念: Kubernetes スケジューラーは、Pod を実行する最適な Node を選択するコントロールプレーンコンポーネントです。フィルタリングとスコアリングの 2 フェーズで動作します。
スケジューリングプロセス
フィルタリングフェーズ(Predicates)
- Pod を実行できる適切な Node のセットを特定します
- リソース要件、Node Selector、Affinity ルール、Taint/Toleration などを考慮します
- いずれかの条件を満たさない Node を除外します
スコアリングフェーズ(Priorities)
- フィルタリングを通過した Node にスコアを付与します
- リソース使用率、Pod 分散、Affinity 設定などを考慮します
- 最も高いスコアの Node を選択します
バインディングフェーズ
- 選択した Node に Pod を割り当てます
- API サーバーのバインディング情報を更新します
目次
- スケジューリングの概要
- スケジューラーの仕組み
- Node 選択
- Pod Affinity と Anti-Affinity
- Taints and Tolerations
- Node Affinity
- Pod Priority と Preemption
- Pod Eviction
- Pod Disruption Budget (PDB)
- Node Pressure Eviction
- TopologySpreadConstraints
- Pod Deletion Cost
- Descheduler
- Amazon EKS におけるスケジューリング最適化
- スケジューリングのベストプラクティス
- まとめ
スケジューリングの概要
Kubernetes スケジューラーは、Pod を適切な Node に配置するコントロールプレーンコンポーネントです。スケジューラーは Pod を配置する最適な Node を決定するために、さまざまな要素を考慮します。
- リソース要件: Pod が要求する CPU、メモリ、その他のリソース
- ハードウェア/ソフトウェア/ポリシー制約: Node Selector、Node Affinity、Taint など
- Affinity/Anti-Affinity の仕様: 他の Pod との配置関係
- データローカリティ: データに近い場所への Pod 配置
- ワークロード間の干渉: 異なるワークロード間の干渉を最小化
- カスタム目標: デッドライン認識またはワークロード干渉認識のスケジューリングには適切なカスタムロジックが必要であり、デフォルトスケジューラーはアプリケーションのデッドラインを推論しません
スケジューリングプロセス
スケジューリングプロセスは大きく 2 フェーズに分けられます。
フィルタリング: Pod を実行できる Node のセットを特定します
- リソース要件が満たされているかを確認
- Node Selector、Affinity、Taint などの制約を確認
スコアリング: フィルタリングされた Node をスコアリングして最適な Node を選択します
- リソース使用率のバランス
- Pod 間 Affinity/Anti-Affinity
- データローカリティ
- Taint/Toleration
スケジューラーの仕組み
Kubernetes スケジューラーは次のプロセスで動作します。
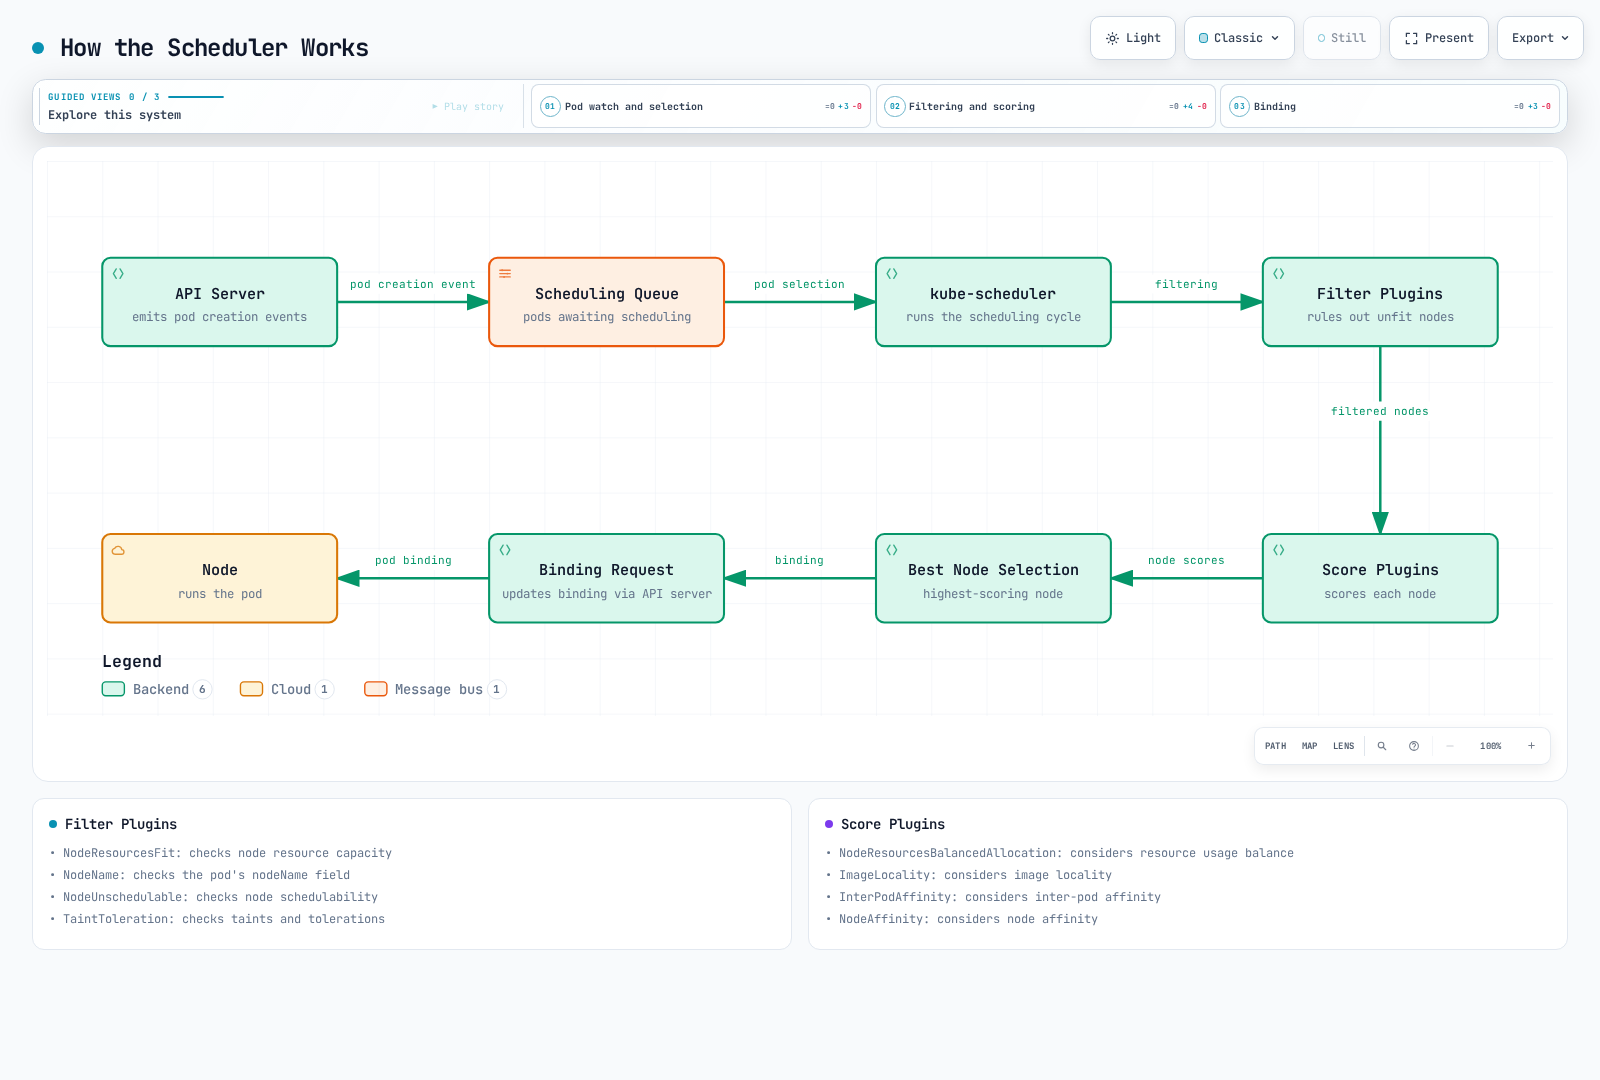
- Pod キューの監視: スケジューラーは、未スケジュールの Pod を API サーバーで監視します。
- Node のフィルタリング: Pod を実行できる Node のセットを特定します。
- Node のスコアリング: フィルタリングされた Node をスコアリングします。
- Node の選択: 最も高いスコアの Node を選択します。
- バインディング: 選択した Node に Pod をバインドします。
スケジューリングプラグイン
Kubernetes スケジューラーはプラグインアーキテクチャを使用して拡張できるよう設計されています。さまざまなプラグインがスケジューリングプロセスの異なる段階で動作します。
Filter プラグイン: Pod を実行できない Node をフィルタリングします
- NodeResourcesFit: Node のリソース容量を確認
- NodeName: Pod の nodeName フィールドを確認
- NodeUnschedulable: Node のスケジュール可否を確認
- TaintToleration: Taint と Toleration を確認
Score プラグイン: Node にスコアを付与します
- NodeResourcesBalancedAllocation: リソース使用量のバランスを考慮
- ImageLocality: イメージローカリティを考慮
- InterPodAffinity: Pod 間 Affinity を考慮
- NodeAffinity: Node Affinity を考慮
NodeResourcesFit スコアリング戦略: LeastAllocated と MostAllocated
NodeResourcesFit は Filter プラグイン(Node に Pod のための十分な割り当て可能 CPU/メモリがあるか)と Score プラグインの両方です。Score プラグインの挙動は、KubeSchedulerConfiguration で設定する scoringStrategy.type により制御されます。
LeastAllocated(デフォルト): すでに割り当てられているリソースが少ない Node ほど高いスコアを付けます。新しい Pod は最も空いている Node に引き寄せられ、負荷を均等に分散します。MostAllocated: すでに割り当てられているリソースが多い Node ほど高いスコアを付けます(Pod が収まる限り)。新しい Pod は最も使用率の高い Node に先に詰め込まれ、他の Node は未使用または空のままになります。RequestedToCapacityRatio: 両者の間を設定可能な曲線で表す戦略です。純粋な最小/最大ではなくカスタム形状が必要な GPU などの拡張リソースに有用です。
apiVersion: kubescheduler.config.k8s.io/v1
kind: KubeSchedulerConfiguration
profiles:
- schedulerName: most-allocated-scheduler
  pluginConfig:
  - name: NodeResourcesFit
    args:
      scoringStrategy:
        type: MostAllocated
        resources:
        - name: cpu
          weight: 1
        - name: memory
          weight: 1
Amazon EKS のコントロールプレーンはフルマネージドであるため、デフォルト kube-scheduler の KubeSchedulerConfiguration を直接編集することはできません。MostAllocated を使用するには、2 番目のスケジューラー(この設定で kube-scheduler バイナリを実行し、専用の ServiceAccount を介して system:kube-scheduler/system:volume-scheduler にバインドする Deployment)を実行し、以下の 複数スケジューラー で示すように特定の Pod を spec.schedulerName で指定します。これは カスタムスケジューラーの構築 と同じパターンです。
検証済みテスト — 分散とビンパッキングの動作。 実際の違いを確認するため、不均一なベースライン負荷を nodeName に固定したフィラー Pod で設定した使い捨ての 3 worker kind クラスター(kubectl version v1.37.0、隔離済み、テスト後に削除済み — 共有インフラストラクチャには一切影響していません)を使用しました(Node あたり CPU 割り当て可能量は 16)。worker=12 Pod(75%)、worker2=6 Pod(37%)、worker3=0 Pod(0%)です。その後、同一の 1-CPU Pod 6 個を、同じ初期状態に対してデフォルトスケジューラー(LeastAllocated)と MostAllocated を設定した 2 番目のスケジューラーで、それぞれスケジュールしました。
| スケジューラー / 戦略 | 新しい 6 Pod の配置先 | 最終 CPU 使用率(worker / worker2 / worker3) |
|---|---|---|
デフォルト(LeastAllocated) | すべて worker3(最も空いている Node) | 75% / 37% / 37% — 3 Node すべてが使用中 |
MostAllocated | worker に 3 個、worker2 に 3 個(最も使用率の高い 2 Node) | 93% / 56% / 0% — worker3 は完全にアイドル状態のまま |
LeastAllocated は worker3 を worker2 と同じ状態になるまで使用率を上げるため、すべての Node が部分的に使用され、どの Node も安全にスケールダウンできなくなります。MostAllocated はすでに使用率の高い Node に負荷を集中させ続け、worker3 を未使用のままにしました。これはまさに、クラスターオートスケーラーまたは Karpenter の統合処理によって終了される Node です。
このため、Karpenter または Cluster Autoscaler と並行して実行する バッチ/短命な Job ワークロードでは、MostAllocated が一般的に推奨されます。Job を少数の Node にビンパッキングすると、完全にアイドル状態となり統合の対象になる Node 数が最大化され、コンピューティングコストを直接削減できます。LeastAllocated は、トラフィックの急増や単一のパックされた Node にカスケードする圧力を発生させずに kubectl drain を吸収する余裕をすべての Node に残すため、長時間実行されるレイテンシーに敏感な Service には引き続き優れたデフォルトです。
この比較を完全に再現する手順については、Scheduler Scoring Strategy Lab を参照してください。
複数スケジューラー
Kubernetes は複数のスケジューラーを同時に実行できます。これにより、特定のワークロード向けにカスタムスケジューリングロジックを実装できます。
apiVersion: v1
kind: Pod
metadata:
  name: custom-scheduled-pod
spec:
  schedulerName: my-custom-scheduler
  containers:
  - name: container
image: nginx上記の例では、schedulerName フィールドが Pod をスケジュールするスケジューラーを指定します。
Node 選択
Kubernetes には Pod を特定の Node に配置する複数のメカニズムがあります。
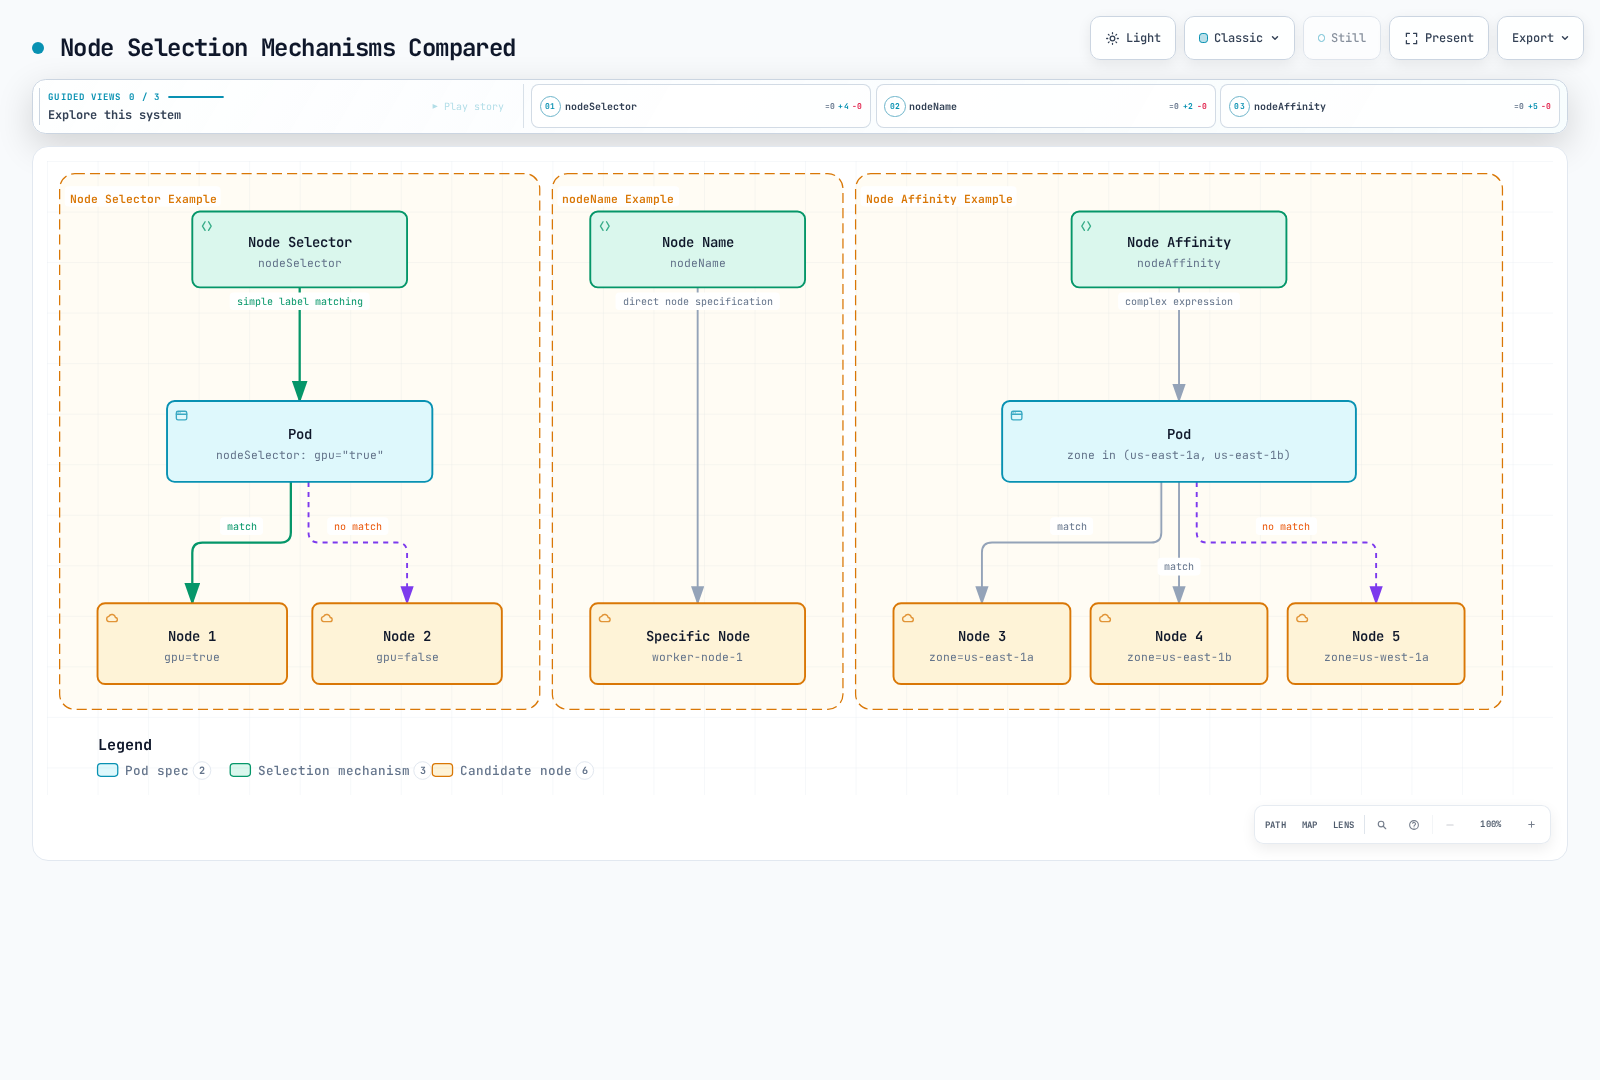
Node Selector
Node Selector は、特定のラベルを持つ Node にのみ Pod を配置するよう制限する最も簡単な方法です。
apiVersion: v1
kind: Pod
metadata:
  name: gpu-pod
spec:
  nodeSelector:
    gpu: "true"
  containers:
  - name: gpu-container
    image: busybox:1.36
    command: ["sh", "-c", "sleep 3600"]
    resources:
      limits:
        nvidia.com/gpu: 1
上記の例では、Pod は gpu=true ラベルを持つ Node にのみ配置されます。
GPU の例はスケジューリングのみをテストします。Node には実際に GPU があり、nvidia.com/gpu をアドバタイズする動作中のデバイスプラグインが必要です。gpu=true ラベルだけでは GPU リソースは割り当てられません。
nodeName
nodeName フィールドを使用して、Pod を特定の Node に直接配置できます。この方法はスケジューラーをバイパスするため、通常は推奨されません。
apiVersion: v1
kind: Pod
metadata:
  name: specific-node-pod
spec:
  nodeName: worker-node-1
  containers:
  - name: container
    image: nginx
上記の例では、Pod は worker-node-1 という名前の Node に直接配置されます。
Pod Affinity と Anti-Affinity
Pod Affinity と Anti-Affinity は、Pod 間の関係に基づいて Pod を配置する方法を提供します。
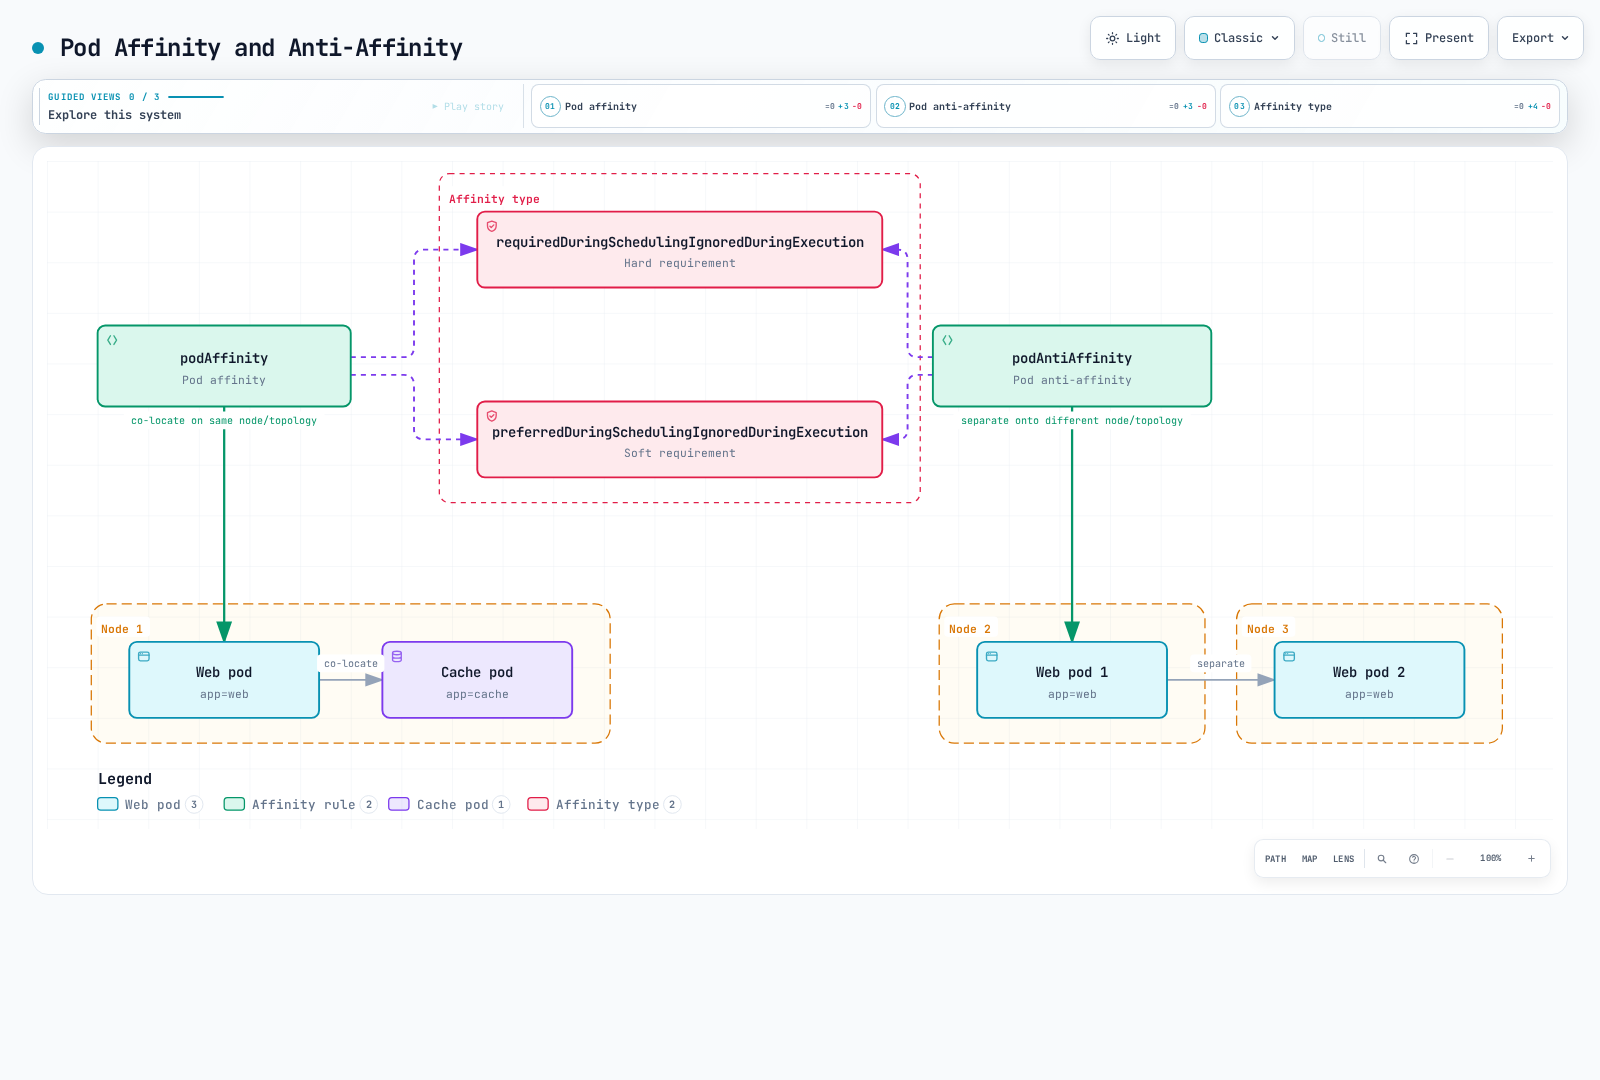
Pod Affinity
Pod Affinity は、特定のラベルを持つ Pod と同じ Node またはトポロジードメインに Pod を配置します。
apiVersion: v1
kind: Pod
metadata:
  name: frontend
spec:
  affinity:
    podAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
      - labelSelector:
          matchExpressions:
          - key: app
            operator: In
            values:
            - cache
        topologyKey: kubernetes.io/hostname
  containers:
  - name: frontend
image: nginx上記の例では、frontend Pod は app=cache ラベルを持つ Pod と同じホストに配置されます。
Pod Anti-Affinity
Pod Anti-Affinity は、特定のラベルを持つ Pod とは異なる Node またはトポロジードメインに Pod を配置します。
apiVersion: v1
kind: Pod
metadata:
  name: frontend
  labels:
    app: frontend
spec:
  affinity:
    podAntiAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
      - labelSelector:
          matchExpressions:
          - key: app
            operator: In
            values:
            - frontend
        topologyKey: kubernetes.io/hostname
  containers:
  - name: frontend
image: nginx上記の例では、frontend Pod は app=frontend ラベルを持つ他の Pod とは異なるホストに配置されます。これは、同じアプリケーションのインスタンスを複数の Node に分散して高可用性を実現する場合に便利です。
Affinity の種類
Pod Affinity と Anti-Affinity には 2 種類あります。
- requiredDuringSchedulingIgnoredDuringExecution: スケジューリング時に満たす必要があるハード要件
- preferredDuringSchedulingIgnoredDuringExecution: 優先されますが必須ではないソフト要件
# preferredDuringSchedulingIgnoredDuringExecution example
affinity:
  podAffinity:
    preferredDuringSchedulingIgnoredDuringExecution:
    - weight: 100
      podAffinityTerm:
        labelSelector:
          matchExpressions:
          - key: app
            operator: In
            values:
            - cache
topologyKey: kubernetes.io/hostname上記の例では、weight フィールドはこの設定の重みを示します。複数の設定がある場合、重みが大きい設定ほど重要と見なされます。
Taints and Tolerations
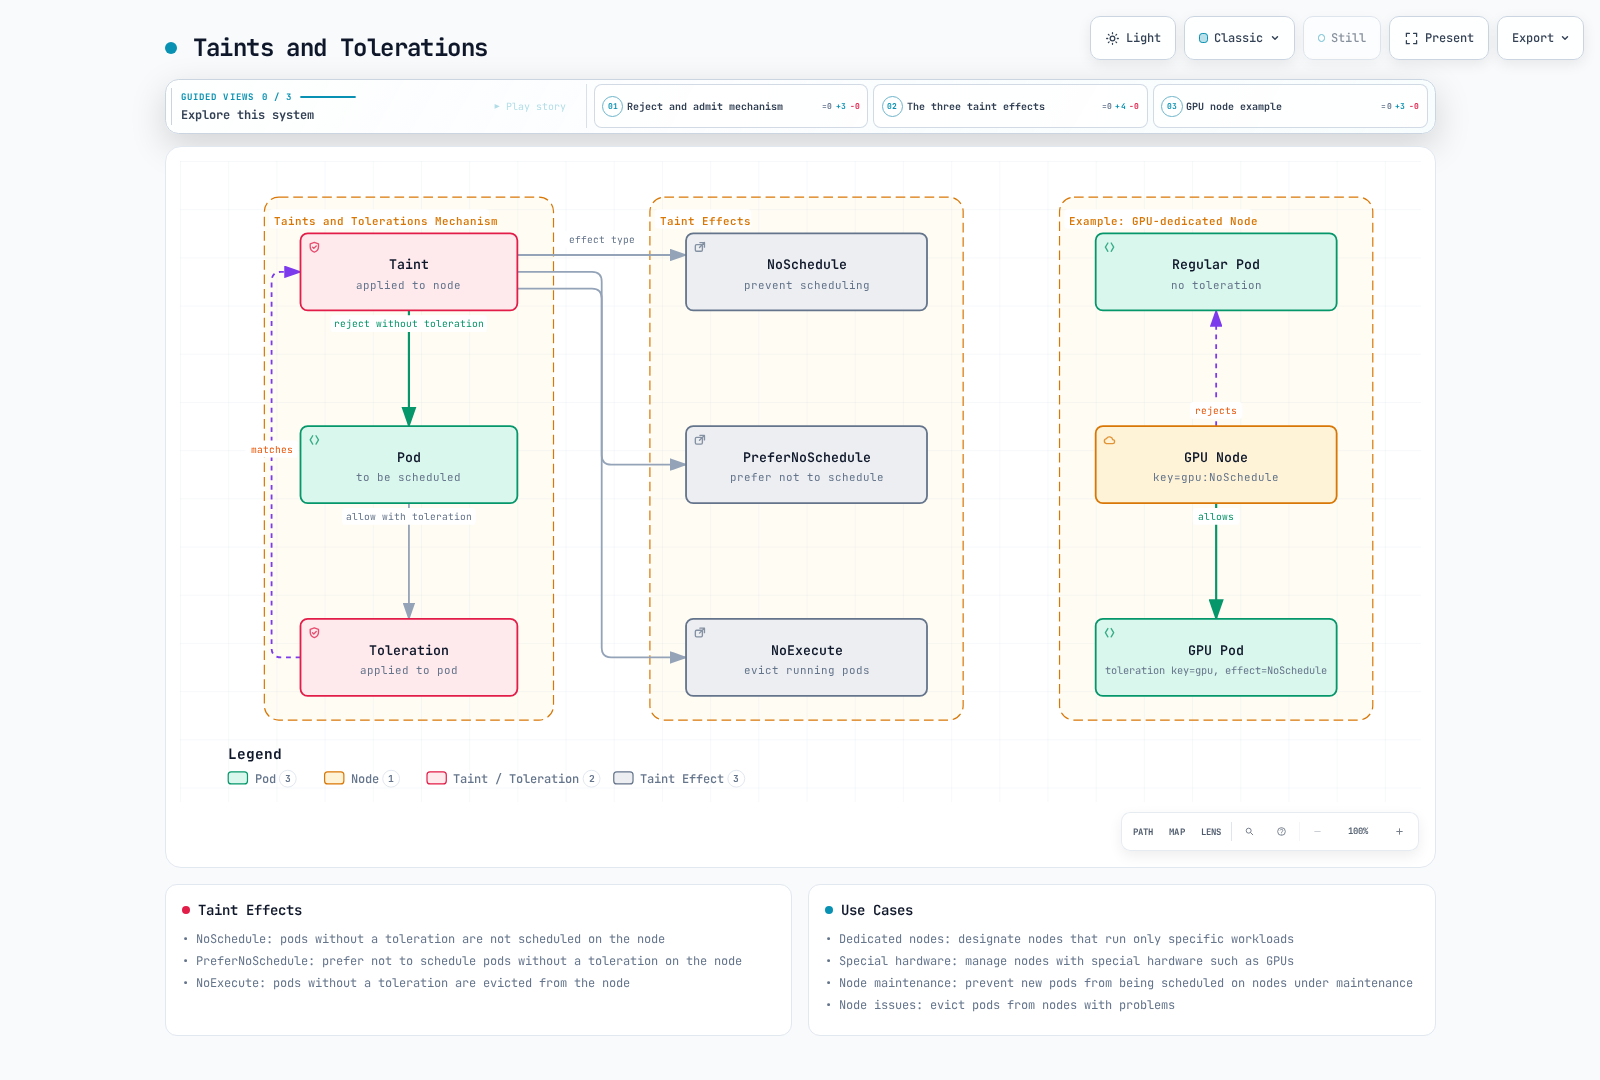
Taint と Toleration は、Node が特定の Pod を拒否できるようにするメカニズムです。
Taint
Taint は、Pod が Node にスケジュールされるのを制限するために Node に適用されます。
# Add taint to node
kubectl taint nodes node1 key=value:NoSchedule
Taint effect には 3 種類あります。
- NoSchedule: Toleration のない Pod は Node にスケジュールされません
- PreferNoSchedule: Toleration のない Pod を Node にスケジュールしないことを優先します
- NoExecute: Toleration のない Pod は Node から Eviction されます
Toleration
Toleration は、Pod が Taint のある Node にスケジュールされることを許可するために Pod に適用されます。
apiVersion: v1
kind: Pod
metadata:
  name: nginx
spec:
  tolerations:
  - key: "key"
    operator: "Equal"
    value: "value"
    effect: "NoSchedule"
  containers:
  - name: nginx
    image: nginx
上記の例では、Pod は key=value:NoSchedule Taint のある Node にスケジュールできます。
ユースケース
Taint と Toleration の一般的なユースケースは以下のとおりです。
- 専用 Node: 特定のワークロードのみを実行する Node を指定
- 特殊なハードウェア: GPU などの特殊なハードウェアを持つ Node を管理
- Node メンテナンス: メンテナンス中の Node への新しい Pod のスケジューリングを防止
- Node の問題: 問題のある Node から Pod を Eviction
デフォルト Taint
Kubernetes は一部の Node にデフォルト Taint を適用します。
- node.kubernetes.io/not-ready: Node の準備ができていません
- node.kubernetes.io/unreachable: Node に到達できません
- node.kubernetes.io/memory-pressure: Node にメモリプレッシャーがあります
- node.kubernetes.io/disk-pressure: Node にディスクプレッシャーがあります
- node.kubernetes.io/pid-pressure: Node に PID プレッシャーがあります
- node.kubernetes.io/network-unavailable: Node ネットワークを利用できません
- node.kubernetes.io/unschedulable: Node はスケジュール不可です
Node Affinity
Node Affinity は、Pod を特定の Node セットに配置する、より表現力の高い方法を提供します。Node Selector よりも複雑な条件を指定できます。
Node Affinity の種類
Node Affinity には 2 種類あります。
- requiredDuringSchedulingIgnoredDuringExecution: スケジューリング時に満たす必要があるハード要件
- preferredDuringSchedulingIgnoredDuringExecution: 優先されますが必須ではないソフト要件
apiVersion: v1
kind: Pod
metadata:
  name: with-node-affinity
spec:
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
        - matchExpressions:
          - key: topology.kubernetes.io/zone
            operator: In
            values:
            - us-west-2a
            - us-west-2b
      preferredDuringSchedulingIgnoredDuringExecution:
      - weight: 1
        preference:
          matchExpressions:
          - key: another-node-label-key
            operator: In
            values:
            - another-node-label-value
  containers:
  - name: with-node-affinity
    image: nginx
上記の例では、Pod は topology.kubernetes.io/zone ラベルが us-west-2a または us-west-2b である Node にのみ配置されます。さらに、another-node-label-key=another-node-label-value ラベルを持つ Node に優先的に配置されます。
演算子
Node Affinity はさまざまな演算子をサポートします。
- In: ラベル値が指定した値のいずれかに一致
- NotIn: ラベル値が指定した値のいずれにも一致しない
- Exists: 指定したキーを持つラベルが存在
- DoesNotExist: 指定したキーを持つラベルが存在しない
- Gt: ラベル値が指定値より大きい
- Lt: ラベル値が指定値より小さい
Pod Priority と Preemption
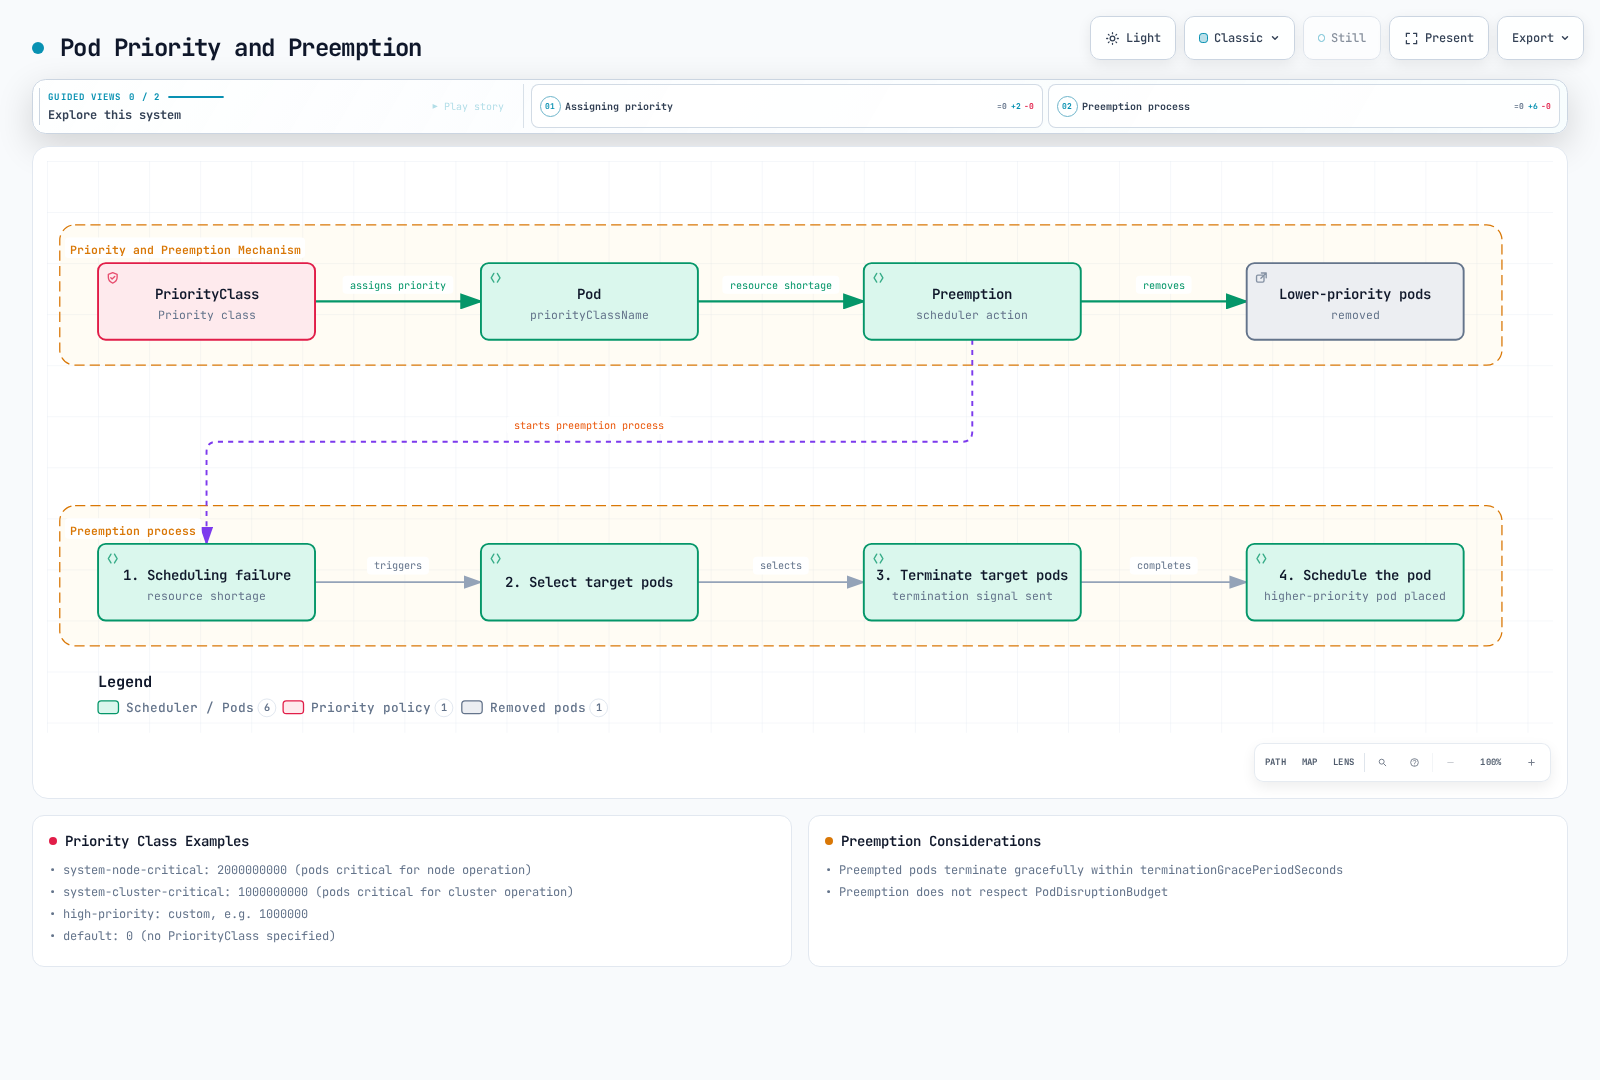
Kubernetes は、重要なワークロードがクラスターリソースを確保できるよう、Pod Priority と Preemption の機能を提供します。
PriorityClass
PriorityClass は Pod の相対的な重要度を定義します。優先度の値が高いほど、Pod は重要です。
apiVersion: scheduling.k8s.io/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 1000000
globalDefault: false
description: "This priority class should be used for critical workloads."上記の例では、value フィールドは優先度の値を示します。値が高いほど、優先度も高くなります。globalDefault フィールドを true に設定すると、この PriorityClass は PriorityClass を指定していない Pod に適用されます。
Pod への PriorityClass の適用
Pod に PriorityClass を適用するには、priorityClassName フィールドを使用します。
apiVersion: v1
kind: Pod
metadata:
  name: high-priority-pod
spec:
  priorityClassName: high-priority
  containers:
  - name: container
    image: nginx
Preemption
Preemption は、高優先度の Pod をスケジュールするために低優先度の Pod を削除するプロセスです。スケジューラーが高優先度 Pod をスケジュールする Node を見つけられない場合、リソースを確保するために低優先度 Pod を Preemption します。
Preemption プロセス:
- スケジューラーが高優先度 Pod をスケジュールする Node を見つけられない
- スケジューラーが Preemption により低優先度 Pod を削除する Node を選択
- API を介して選択した低優先度 Pod の削除をリクエストし、kubelet/runtime が終了を実行
- Pod が正常に終了すると、その Node に高優先度 Pod をスケジュール
Preemption に関する考慮事項
Preemption を使用する際の考慮事項は以下のとおりです。
- 正常終了期間: Preemption された Pod は、
terminationGracePeriodSecondsで指定した時間だけ正常終了プロセスを実行します - PodDisruptionBudget: スケジューラーは違反の回避を試みますが、PDB を回避できる適切な犠牲 Pod がない場合、Preemption が PDB に違反することがあります
- システム PriorityClass: Kubernetes はシステムコンポーネント用の PriorityClass を提供します
system-cluster-critical: クラスター運用に不可欠な Podsystem-node-critical: Node 運用に不可欠な Pod
Pod Eviction
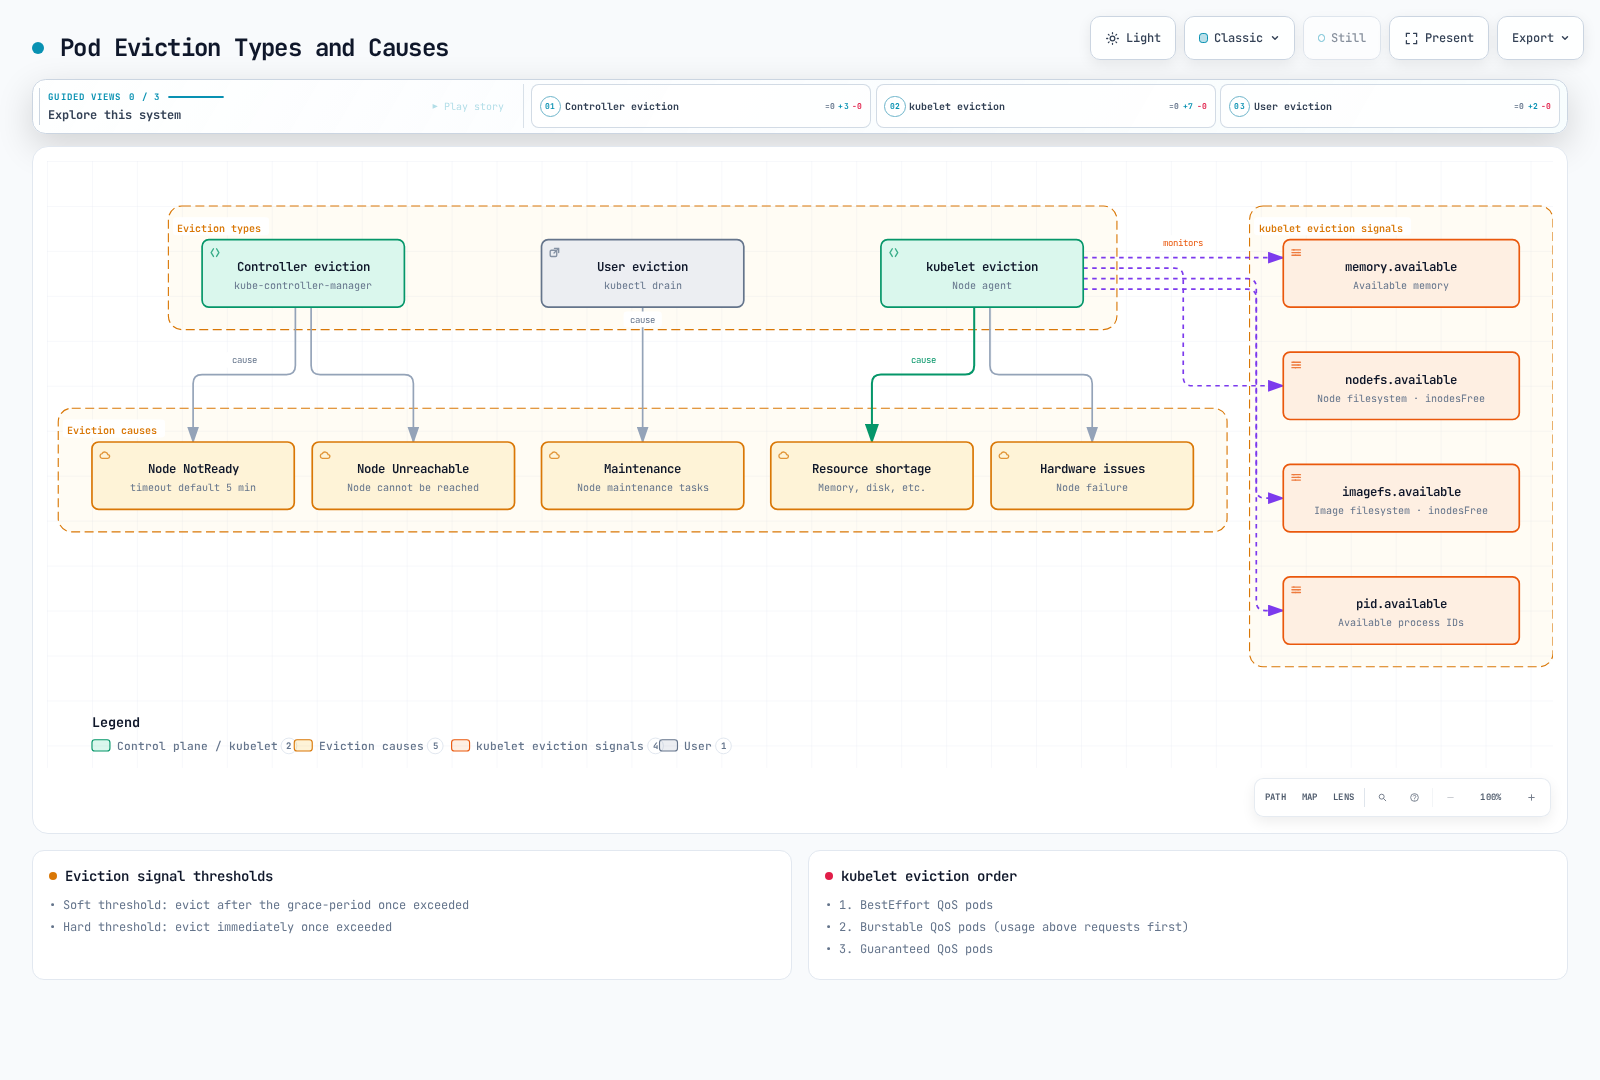
Pod Eviction は Pod を終了します。ワークロードコントローラーは置き換え用の Pod を作成する場合があり、その Pod はスケジューラーによって別途配置されます。Eviction はさまざまな理由で発生します。
Eviction の種類
kube-controller-manager による Eviction:
- taint-eviction-controller が NoExecute Taint を処理します。Pod には通常、300 秒の not-ready/unreachable Toleration が付与され、Eviction はその Toleration 設定に従います
- Node が Unreachable 状態の場合
kubelet による Eviction:
- Node のリソース不足(メモリ、ディスクなど)
- ハードウェア障害は Node を利用不能にする可能性がありますが、汎用の kubelet プレッシャー Eviction シグナルではありません
ユーザーによる Eviction:
kubectl drainコマンドの実行- Node メンテナンスタスク
kubelet Eviction シグナル
kubelet は次の Eviction シグナルを監視します。
- memory.available: 利用可能なメモリ
- nodefs.available: Node ファイルシステムの利用可能な領域
- nodefs.inodesFree: Node ファイルシステムの利用可能な inode
- imagefs.available: イメージファイルシステムの利用可能な領域
- imagefs.inodesFree: イメージファイルシステムの利用可能な inode
- pid.available: 利用可能なプロセス ID
各シグナルにソフトおよびハードしきい値を設定できます。
- ソフトしきい値: しきい値超過後、
grace-periodの経過時に Pod を Eviction - ハードしきい値: しきい値超過時に Pod を即座に Eviction
# kubelet configuration example
evictionHard:
  memory.available: "100Mi"
  nodefs.available: "10%"
  nodefs.inodesFree: "5%"
  imagefs.available: "15%"
  imagefs.inodesFree: "5%"
evictionSoft:
  memory.available: "200Mi"
  nodefs.available: "15%"
evictionSoftGracePeriod:
  memory.available: "1m"
  nodefs.available: "2m"
evictionMaxPodGracePeriod: 30
evictionPressureTransitionPeriod: "30s"
Eviction の優先順位
kubelet は、使用量がリクエストを超過しているか、次に Pod Priority、さらにリクエストに対する使用量の順で候補を順位付けします。BestEffort、Burstable、Guaranteed Pod の順にすべてを単純に Eviction するわけではありません。ディスク/PID プレッシャーには異なるアカウンティング上の制約があり、QoS は普遍的な Eviction 順序ではありません。
Pod Disruption Budget (PDB)
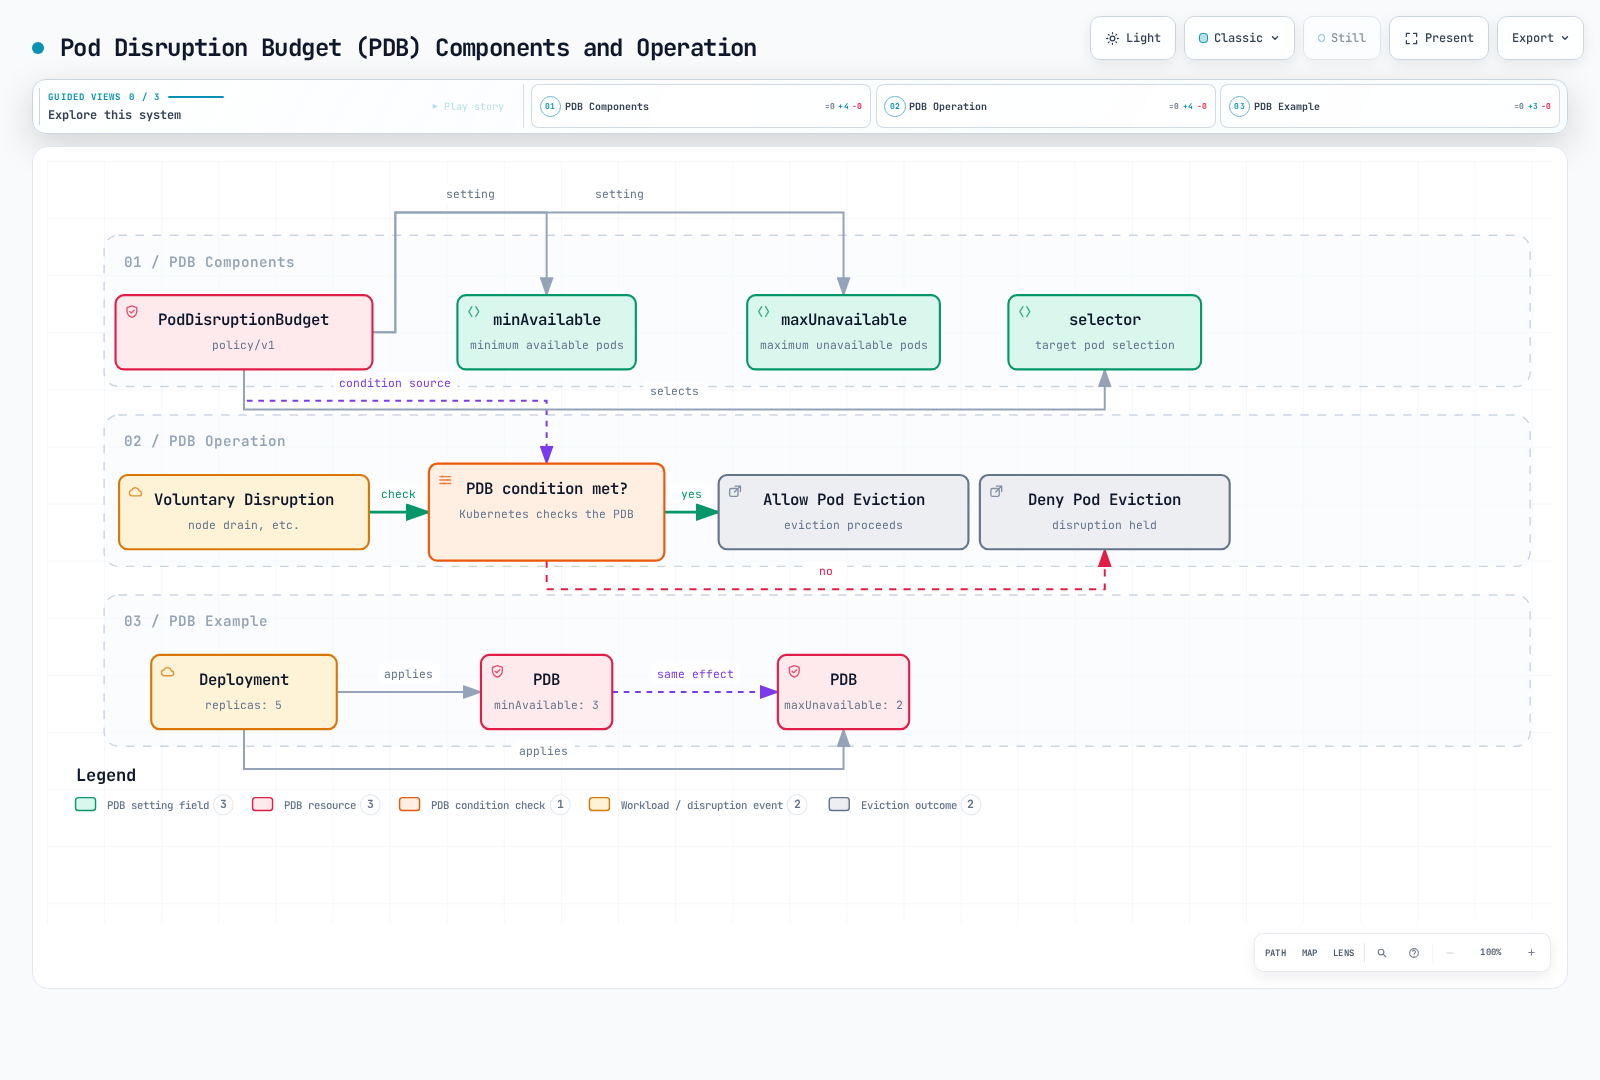
Pod Disruption Budget (PDB) は、自発的な中断の間にアプリケーションの可用性を維持する方法です。PDB は同時に中断できる Pod の数を制限します。
PDB の定義
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: frontend-pdb
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: frontend
または
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: frontend-pdb
spec:
  maxUnavailable: 1
  selector:
    matchLabels:
      app: frontend
上記の例では:
minAvailable: 常に利用可能でなければならない最小 Pod 数maxUnavailable: 同時に利用不能になり得る最大 Pod 数selector: PDB が適用される Pod を選択するラベルセレクター
PDB の動作
- Node drain などの自発的な中断が発生すると、Kubernetes は PDB を確認します
- PDB 条件を満たす場合、Pod Eviction を続行します
- PDB 条件を満たさない場合、Pod Eviction を拒否します
PDB は通常の drain/descheduler 操作などの Eviction API リクエストを制御します。直接的な Pod 削除、コントローラーのロールアウト、Node プレッシャー Eviction はこの制御をバイパスします。minAvailable: 2 と maxUnavailable: 1 が等価なのは、必要なレプリカ数が 3 のワークロードに限られ、どちらも置き換え用の容量を作成しません。
PDB のベストプラクティス
- すべてのクリティカルなワークロードに PDB を設定: 高可用性を必要とするすべてのワークロードに PDB を設定します
- 適切な値を選択: ワークロードの特性に適した
minAvailableまたはmaxUnavailableの値を選択します - レプリカ数を考慮:
minAvailableをレプリカ数と同じにすると自発的 Eviction をブロックできますが、メンテナンスが停止する可能性があるため、意図的な中断許容量を設定します - 定期テスト: Node drain などのタスクを通じて PDB の動作をテストします
Node Pressure Eviction
Node Pressure Eviction は、Node のリソース不足によって Pod が Eviction されるメカニズムです。
Node Condition の状態
kubelet は次の Node Condition 状態をレポートします。
- MemoryPressure: Node のメモリが不足
- DiskPressure: Node のディスク領域が不足
- PIDPressure: Node のプロセス ID が不足
これらの状態が発生すると、kubelet はリソースを確保するために Pod を Eviction します。
Eviction ポリシーの設定
Eviction ポリシーは kubelet 設定で設定できます。
# kubelet configuration example
evictionHard:
  memory.available: "100Mi"
  nodefs.available: "10%"
  nodefs.inodesFree: "5%"
  imagefs.available: "15%"
  imagefs.inodesFree: "5%"
evictionSoft:
  memory.available: "200Mi"
  nodefs.available: "15%"
evictionSoftGracePeriod:
  memory.available: "1m"
  nodefs.available: "2m"
evictionMinimumReclaim:
  memory.available: "50Mi"
  nodefs.available: "5%"
evictionMaxPodGracePeriod: 30
evictionPressureTransitionPeriod: "30s"
上記の例では:
evictionMinimumReclaim: Eviction 後に再確保する必要がある最小リソースevictionPressureTransitionPeriod: プレッシャー状態の遷移間の待機時間
TopologySpreadConstraints
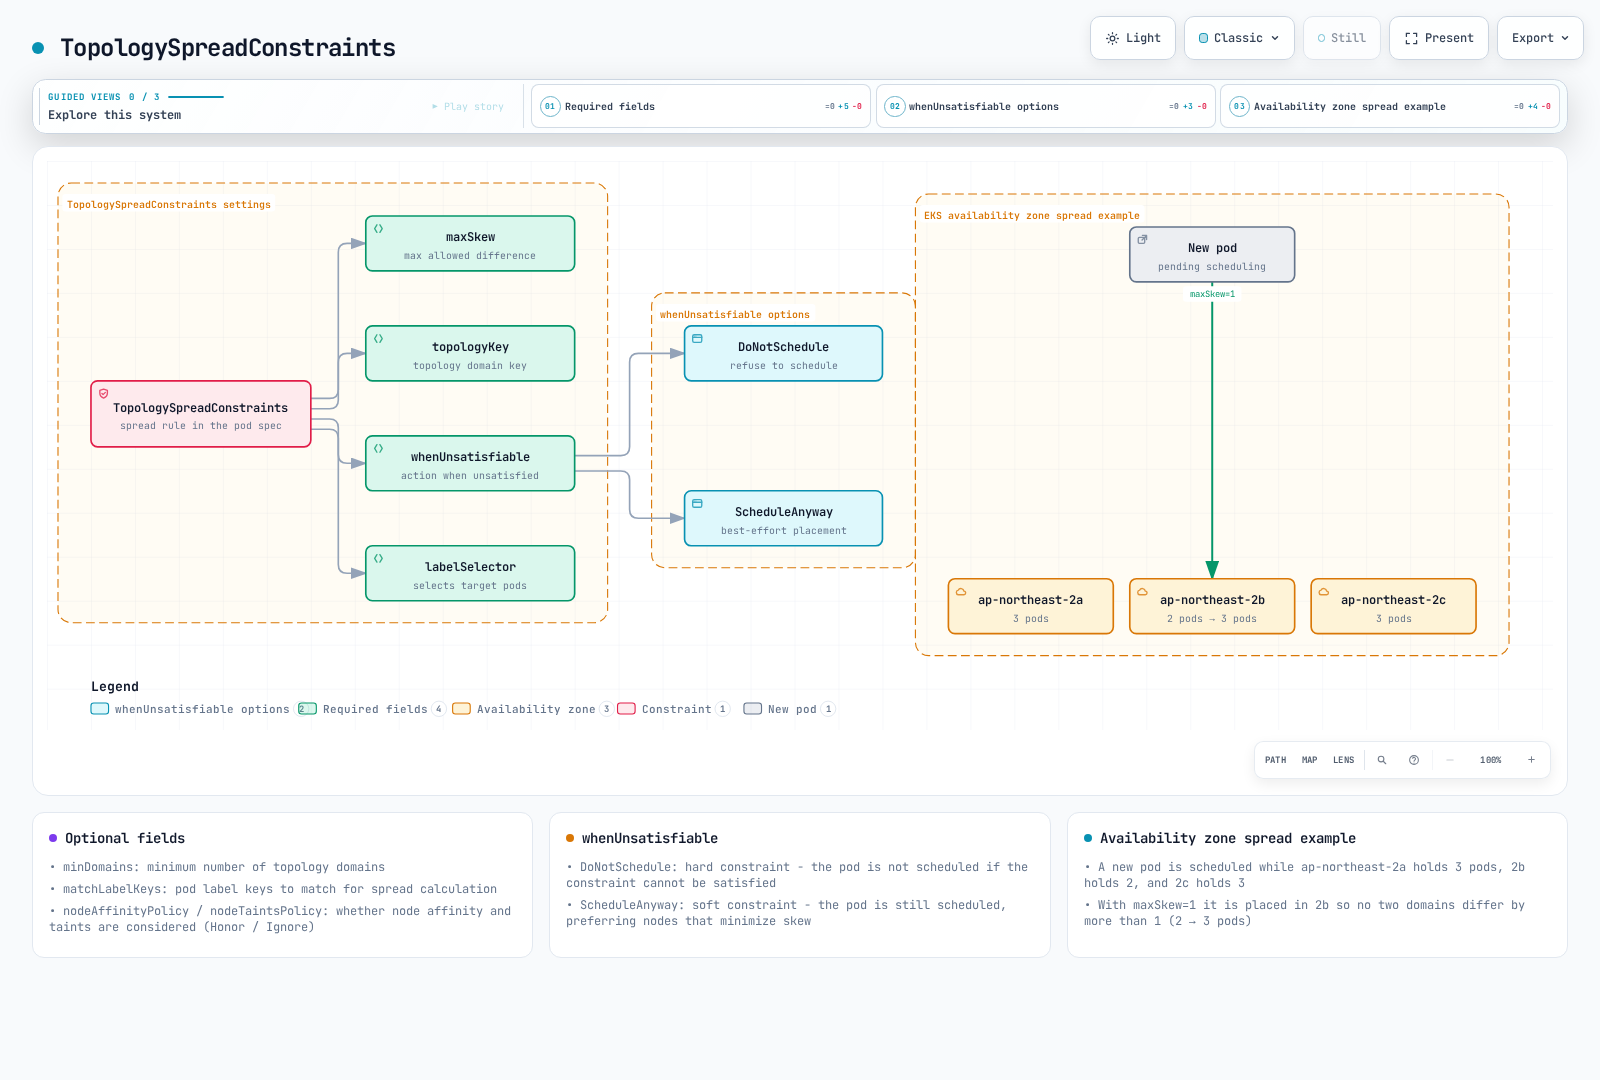
TopologySpreadConstraints は、アベイラビリティーゾーン、Node、リージョンなどのトポロジードメイン全体に Pod をどのように分散するかをきめ細かく制御します。この機能は、高可用性と効率的なリソース使用率を達成する際に Pod Anti-Affinity より柔軟性を提供します。
主要フィールド
| フィールド | 説明 | 必須 |
|---|---|---|
| maxSkew | DoNotSchedule の場合は対象ドメインとグローバル最小値の許容差。ScheduleAnyway は skew を設定として使用 | はい |
| topologyKey | トポロジードメインを定義する Node ラベルキー | はい |
| whenUnsatisfiable | 制約を満たせない場合のアクション: DoNotSchedule または ScheduleAnyway | はい |
| labelSelector | カウントする Pod を選択。通常はこれと一致する Pod ラベルを指定 | いいえ(null は Pod に一致しない) |
| minDomains | skew 計算の対象となる最小の適格ドメイン数(v1.30 以降 stable) | いいえ |
| matchLabelKeys | 分散計算のために一致させる Pod ラベルキー(1.27+) | いいえ |
whenUnsatisfiable オプション
- DoNotSchedule: 制約を満たせない場合、スケジューラーは Pod をスケジュールしません(ハード制約)
- ScheduleAnyway: スケジューラーは Pod をスケジュールしますが、skew を最小化する Node をより高く優先します(ソフト制約)
EKS アベイラビリティーゾーン分散の例
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web-app
spec:
  replicas: 6
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      topologySpreadConstraints:
      - maxSkew: 1
        topologyKey: topology.kubernetes.io/zone
        whenUnsatisfiable: DoNotSchedule
        labelSelector:
          matchLabels:
            app: web
      - maxSkew: 1
        topologyKey: kubernetes.io/hostname
        whenUnsatisfiable: ScheduleAnyway
        labelSelector:
          matchLabels:
            app: web
      containers:
      - name: web
        image: nginx:1.30.4
        resources:
          requests:
            cpu: 100m
            memory: 128Mi
この設定は以下を保証します。
- Pod はアベイラビリティーゾーン全体に均等に分散されます(ハード制約)
- Pod は各 Zone 内の Node 全体に優先的に分散されます(ソフト制約)
minDomains と matchLabelKeys
apiVersion: apps/v1
kind: Deployment
metadata:
  name: app-with-min-domains
spec:
  replicas: 4
  selector:
    matchLabels:
      app: distributed-app
  template:
    metadata:
      labels:
        app: distributed-app
        version: v1
    spec:
      topologySpreadConstraints:
      - maxSkew: 1
        topologyKey: topology.kubernetes.io/zone
        whenUnsatisfiable: DoNotSchedule
        labelSelector:
          matchLabels:
            app: distributed-app
        minDomains: 3
        matchLabelKeys:
        - version
      containers:
      - name: app
image: myapp:v1- minDomains: 適格なドメインが 3 未満の場合、グローバル最小値はゼロになります。maxSkew 1 では、適格なドメインごとに一致する Pod を 1 つずつスケジュールできますが、追加の Pod は Pending のままになることがあります。すべての Pod を直ちにブロックするわけではありません。
- matchLabelKeys: Pod の
versionラベル値をセレクターで自動的に使用し、セレクターを変更せずにリビジョンごとの分散を可能にします。
Pod Anti-Affinity に対する利点
| 項目 | TopologySpreadConstraints | Pod Anti-Affinity |
|---|---|---|
| 柔軟性 | 制御された skew を許可(maxSkew > 1) | 二値: 同一または異なるドメイン |
| ソフト制約 | ベストエフォートのための ScheduleAnyway | preferredDuringScheduling ですが制御は少ない |
| マルチレベル | 異なる topologyKey による複数の制約 | 複雑なネストルールが必要 |
| パフォーマンス | 大規模でより良いスケジューラーパフォーマンス | 多数の Pod があるとスケジューリングが遅くなる場合がある |
| ユースケース | 許容範囲を持つ均等な分散 | 厳格な分離 |
Pod Deletion Cost
Pod Deletion Cost は、スケールダウン時に ReplicaSet コントローラーが使用するベストエフォートの設定です。HPA は必要なレプリカ数を変更しますが、個々の犠牲 Pod を選択しません。この annotation は Job/StatefulSet を保護せず、Eviction を防止せず、削除順序も保証しません。
仕組み
コントローラー(HPA または手動スケールダウンなど)がレプリカを減らす必要がある場合、以下を考慮します。
- 削除コストが低い Pod が先に削除される
- デフォルトの削除コストは 0
- 有効範囲: -2147483648 ~ 2147483647
基本例
apiVersion: v1
kind: Pod
metadata:
  name: worker-pod
  annotations:
    controller.kubernetes.io/pod-deletion-cost: "100"
spec:
  containers:
  - name: worker
    image: worker:latest
HPA スケールダウン優先度の制御
HPA スケールダウン中に重要な Pod を保護するには、削除コストを使用します。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web-service
spec:
  replicas: 5
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
      # Lower cost pods are deleted first during scale-down
      annotations:
        controller.kubernetes.io/pod-deletion-cost: "0"
    spec:
      containers:
      - name: web
        image: nginx:1.30.4
キャッシュ保護パターン
CPU 使用率 HPA でスケーリングする場合、キャッシュには明示的な CPU リクエストを設定します。以下はスケジューリング例であり、完全な Redis 本番設定ではありません。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: cache-service
spec:
  replicas: 3
  selector:
    matchLabels:
      app: cache
  template:
    metadata:
      labels:
        app: cache
    spec:
      automountServiceAccountToken: false
      containers:
      - name: cache
        image: redis:7
        resources:
          requests:
            cpu: 100m
            memory: 128Mi
実際のキャッシュの温まり具合を測定した後、認可されたオペレーター/コントローラーは、スケールダウン前に選択した ReplicaSet 所有 Pod に一度 annotation を付与できます。
kubectl -n default annotate pod "$CACHE_POD" \
  controller.kubernetes.io/pod-deletion-cost="1000" --overwrite
CACHE_POD を実際のキャッシュ Pod に設定します。頻繁な annotation 書き込みは API 負荷を発生させます。カスタムアップデーターには Redis と Kubernetes の両方のクライアントツールに加え、狭くスコープされた Pod patch 権限が必要です。経過時間だけではキャッシュが温まっている証拠にはなりません。この例ではアップデーターをインストールしません。
実用的なユースケース
- ReplicaSet で管理されるステートフルキャッシュ: 温まったレプリカの維持を優先
- リーダー選出: リーダー Pod の稼働時間を延長
- 接続ドレイン: 長時間接続を処理する時間を確保
- キャッシュウォームアップ: 温まったキャッシュを持つ Pod を保持
- 制限事項: Job および StatefulSet コントローラーはこの設定を使用しません
Descheduler
Descheduler は、Pod を Node から Eviction して、スケジューラーがより適切な Node に再スケジュールできるようにする Kubernetes コンポーネントです。新しい Pod だけを配置するスケジューラーとは異なり、Descheduler は時間の経過とともに最適な Pod 配置を維持するのに役立ちます。
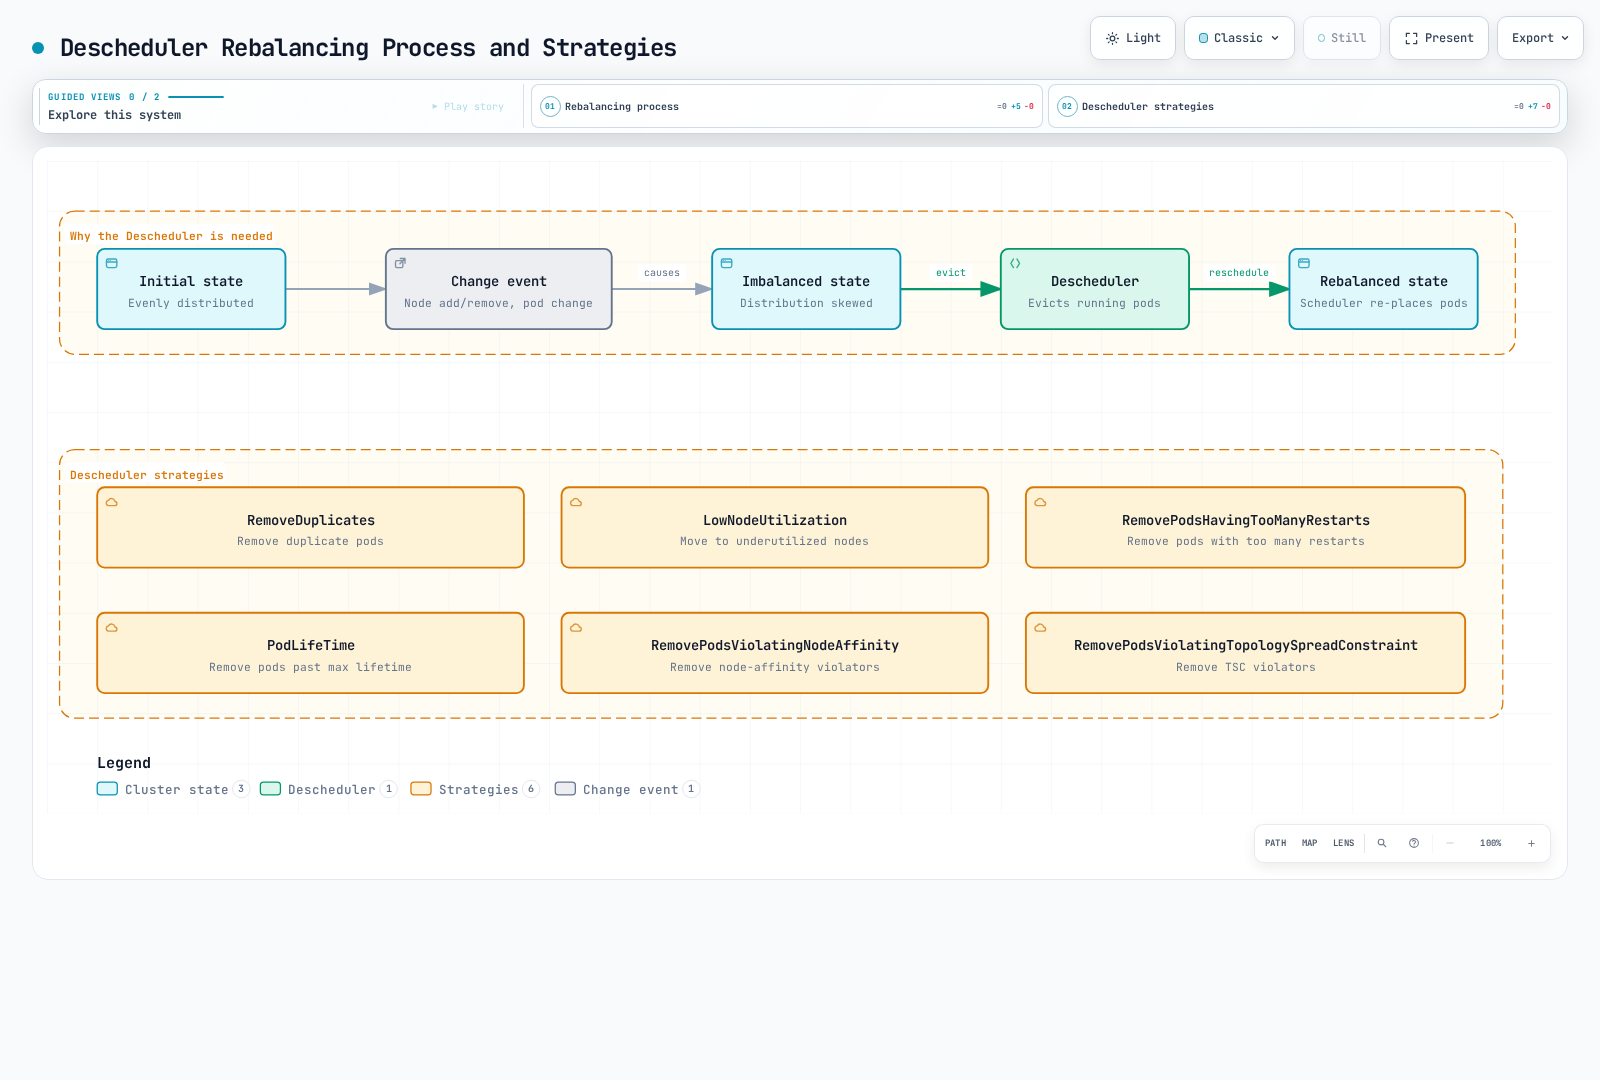
再スケジューリングが必要な理由
- クラスターの変更: 新しい Node の追加、Node ラベルの変更
- Pod のドリフト: 初期配置が時間の経過とともに最適でなくなる
- Affinity 違反: クラスター変更後にルールが違反される
- リソースの不均衡: 一部の Node は過剰使用、他は過少使用
- 失敗した Pod: 再起動ループで停止した Pod
主な戦略
| 戦略 | 説明 | ユースケース |
|---|---|---|
| RemoveDuplicates | 同一 Node から重複 Pod を削除 | Node 障害後の HA を確保 |
| LowNodeUtilization | 過剰使用 Node から過少使用 Node に Pod を移動 | クラスターリソースのバランス調整 |
| RemovePodsHavingTooManyRestarts | 過剰に再起動した Pod を Eviction | 問題のある Pod をクリーンアップ |
| PodLifeTime | 指定した経過時間より古い Pod を Eviction | 新しいスケジューリングを強制 |
| RemovePodsViolatingInterPodAntiAffinity | Anti-Affinity ルールに違反する Pod を Eviction | Affinity 準拠を復元 |
| RemovePodsViolatingNodeAffinity | Node Affinity に違反する Pod を Eviction | Affinity 準拠を復元 |
| RemovePodsViolatingTopologySpreadConstraint | 分散制約に違反する Pod を Eviction | 均等な分散を復元 |
Helm インストール
Descheduler v0.36.0 は検証済みの例のリリースであり、テスト対象には Kubernetes v1.36 と、その前の 2 マイナーバージョンが含まれます。別のリリースに適用する前に、互換性マトリックスを確認してください。schedule と deschedulerPolicy.profiles(以下に示すポリシープロファイル)を含むレビュー済みの Helm values を descheduler-values.yaml に保存します。古い strategies.*.enabled の値ではこの API を設定できません。
helm repo add descheduler https://kubernetes-sigs.github.io/descheduler/
helm upgrade --install descheduler descheduler/descheduler \
  --version 0.36.0 --namespace kube-system \
  --values descheduler-values.yaml
DeschedulerPolicy の設定
apiVersion: descheduler/v1alpha2
kind: DeschedulerPolicy
profiles:
- name: default
  pluginConfig:
  - name: DefaultEvictor
    args:
      nodeFit: true
  - name: RemoveDuplicates
    args:
      excludeOwnerKinds: [StatefulSet]
  - name: LowNodeUtilization
    args:
      thresholds:
        cpu: 20
        memory: 20
        pods: 20
      targetThresholds:
        cpu: 50
        memory: 50
        pods: 50
  - name: RemovePodsHavingTooManyRestarts
    args:
      podRestartThreshold: 100
      includingInitContainers: true
  - name: PodLifeTime
    args:
      maxPodLifeTimeSeconds: 86400
      labelSelector:
        matchLabels:
          app.kubernetes.io/lifecycle: ephemeral
  - name: RemovePodsViolatingNodeAffinity
    args:
      nodeAffinityType: [requiredDuringSchedulingIgnoredDuringExecution]
  - name: RemovePodsViolatingTopologySpreadConstraint
    args:
      constraints: [DoNotSchedule]
  plugins:
    balance:
      enabled:
      - RemoveDuplicates
      - LowNodeUtilization
      - RemovePodsViolatingTopologySpreadConstraint
    deschedule:
      enabled:
      - RemovePodsHavingTooManyRestarts
      - PodLifeTime
      - RemovePodsViolatingNodeAffinity
PDB の遵守
Descheduler は Pod Disruption Budget (PDB) を遵守します。Pod を Eviction すると PDB に違反する場合、Descheduler はその Pod を Eviction しません。
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: web-pdb
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: web
この PDB がある場合、Descheduler は再スケジューリング操作中に app: web ラベルを持つ Pod が少なくとも 2 個利用可能なままであることを保証します。
上記のポリシーは Descheduler 設定ファイルであり、kubectl apply 用の API オブジェクトではありません。グループの再分散には Balance プラグインを、Pod 単位の判断には Deschedule プラグインを使用します。LowNodeUtilization は通常、実際の CPU 使用量ではなくリソースリクエストを評価し、Eviction しても置き換え用 Pod が別の場所に配置されるとは限りません。定期的な Eviction を有効にする前に、保護措置を確認し、dry-run でテストしてください。
Descheduler CronJob の例
apiVersion: batch/v1
kind: CronJob
metadata:
  name: descheduler
  namespace: kube-system
spec:
  schedule: "*/30 * * * *"
  concurrencyPolicy: Forbid
  jobTemplate:
    spec:
      template:
        spec:
          serviceAccountName: descheduler
          containers:
          - name: descheduler
            image: registry.k8s.io/descheduler/descheduler:v0.36.0
            args:
            - --policy-config-file=/policy/policy.yaml
            - --v=3
            volumeMounts:
            - name: policy
              mountPath: /policy
          volumes:
          - name: policy
            configMap:
              name: descheduler-policy
          restartPolicy: OnFailure
スタンドアロンの CronJob は Helm の代替であり、追加のインストールではありません。descheduler ServiceAccount/RBAC と、キー policy.yaml を持つ descheduler-policy ConfigMap が必要です。これらの前提条件を提供するには公式 chart/manifests を使用してください。
詳細: カスタムスケジューラーの詳細については、以下を参照してください。
Amazon EKS におけるスケジューリング最適化
Amazon EKS では、Kubernetes のスケジューリング機能を使用してワークロードを最適化できます。
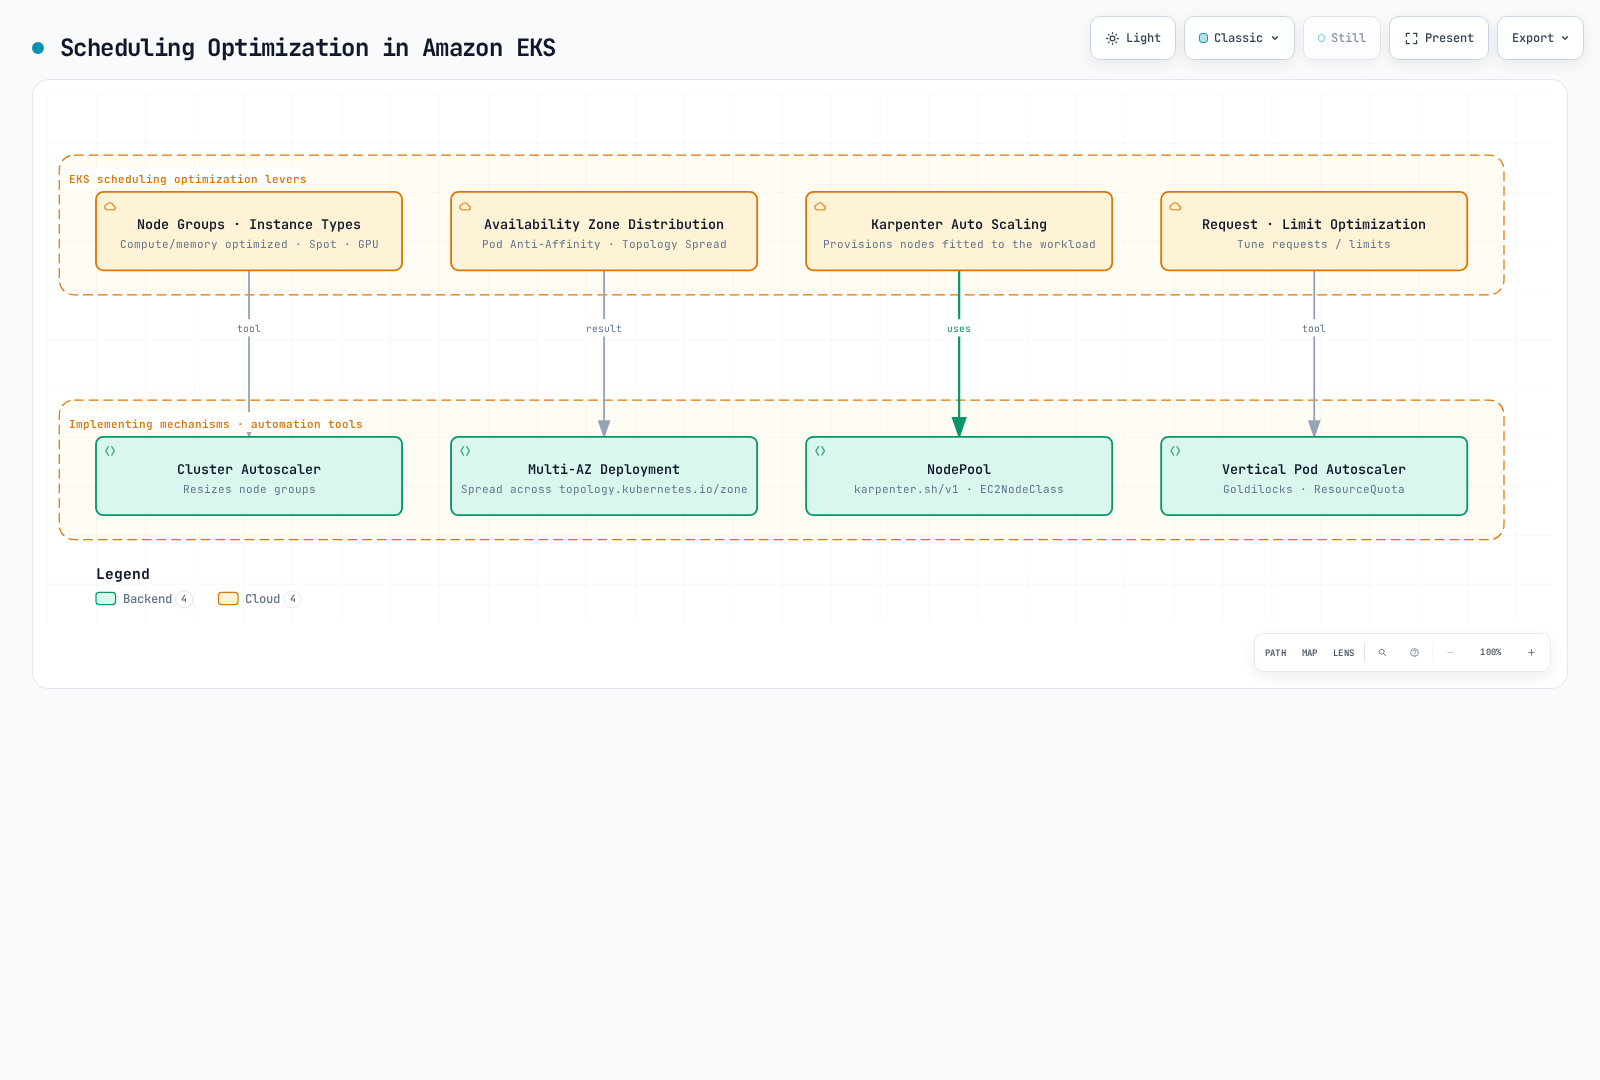
Node Group とインスタンスタイプ
EKS では、さまざまな Node group とインスタンスタイプを活用して、ワークロードに適したリソースを提供できます。
- さまざまなインスタンスタイプ: コンピューティング最適化、メモリ最適化、ストレージ最適化など
- Spot Instance: コスト効率の高いワークロード向けの Spot Instance
- GPU Instance: AI/ML ワークロード向けの GPU Instance
Node ラベルと Taint を使用して、特定のワークロードを特定の Node group に配置できます。
既存のクラスターに対して、Region が一致し、サポート対象の GPU インスタンス/AMI と必要な IAM 権限を備えたレビュー済みの eksctl 設定を使用してください。
# gpu-nodegroup.yaml
apiVersion: eksctl.io/v1alpha5
kind: ClusterConfig
metadata:
  name: my-cluster
  region: us-west-2
managedNodeGroups:
- name: gpu-nodes
  instanceType: p3.2xlarge
  desiredCapacity: 1
  privateNetworking: true
  labels:
    workload-type: gpu
  taints:
  - key: gpu
    value: "true"
effect: NoScheduleeksctl create nodegroup --config-file=gpu-nodegroup.yamlアベイラビリティーゾーン分散
EKS では、Pod Anti-Affinity と Topology Spread Constraints を使用して、複数のアベイラビリティーゾーンにワークロードを分散できます。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web-server
spec:
  replicas: 3
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      topologySpreadConstraints:
      - maxSkew: 1
        topologyKey: topology.kubernetes.io/zone
        whenUnsatisfiable: DoNotSchedule
        labelSelector:
          matchLabels:
            app: web
      containers:
      - name: web
image: nginx上記の例では、topologySpreadConstraints が複数のアベイラビリティーゾーン全体に Pod を均等に分散します。
Karpenter による Auto Scaling
Amazon EKS では、Karpenter を使用してワークロードに適した Node を自動プロビジョニングできます。
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: default
spec:
  template:
    spec:
      requirements:
        - key: karpenter.sh/capacity-type
          operator: In
          values: ["spot", "on-demand"]
        - key: kubernetes.io/arch
          operator: In
          values: ["amd64", "arm64"]
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: default-class
  limits:
    cpu: 1000
    memory: 1000Gi
  disruption:
    consolidationPolicy: WhenEmpty
    consolidateAfter: 30s
---
apiVersion: karpenter.k8s.aws/v1
kind: EC2NodeClass
metadata:
  name: default-class
spec:
  role: KarpenterNodeRole-my-cluster
  amiSelectorTerms:
    - alias: al2023@latest
  subnetSelectorTerms:
    - tags:
        karpenter.sh/discovery: my-cluster
  securityGroupSelectorTerms:
    - tags:
        karpenter.sh/discovery: my-cluster
Karpenter は Pod のリソース要件に最適なインスタンスタイプを選択してコストを最適化します。
リソースリクエストと制限の最適化
EKS において、ワークロードのリソースリクエストと制限を最適化することは重要です。
- Vertical Pod Autoscaler (VPA): 実際のワークロードリソース使用量に基づいてリソースリクエストを最適化
- Goldilocks: VPA 推奨値を可視化してリソースリクエストの最適化を支援
- Resource Quotas: Namespace ごとのリソース使用量を制限
# VPA example
apiVersion: autoscaling.k8s.io/v1
kind: VerticalPodAutoscaler
metadata:
  name: frontend-vpa
spec:
  targetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: frontend
  updatePolicy:
    updateMode: "Recreate"
スケジューリングのベストプラクティス
Kubernetes と EKS におけるスケジューリング最適化のベストプラクティスは以下のとおりです。
適切なリソースリクエストと制限を設定:
- 実際のワークロードリソース使用量に基づいてリソースリクエストを設定
- 重要なワークロードに適切なリソース制限を設定
- VPA を使用してリソースリクエストを自動最適化
ワークロード分散:
- Pod Anti-Affinity を使用して重要なワークロードを複数の Node に分散
- Topology Spread Constraints を使用してワークロードを複数のアベイラビリティーゾーンに分散
- Node Affinity を使用して特定のワークロードを特定の Node に配置
Node リソースの最適化:
- さまざまなインスタンスタイプを使用してワークロードに適したリソースを提供
- コスト最適化のために Spot Instance を使用
- Karpenter を使用してワークロードに適した Node を自動プロビジョニング
PDB 設定:
- 重要なワークロードに PDB を設定
- ワークロードの特性に適した
minAvailableまたはmaxUnavailableの値を選択 - PDB の動作を定期的にテスト
Priority と Preemption の設定:
- 重要なワークロードに高い PriorityClass を設定
- システムコンポーネントには
system-cluster-criticalまたはsystem-node-criticalPriorityClass を使用 - Preemption の影響を理解し、テスト
Node Taint と Toleration:
- 特殊なワークロード向けに専用 Node を設定
- メンテナンス中の Node に Taint を適用
- 適切な Toleration を設定
まとめ
Kubernetes のスケジューリング、Preemption、Eviction のメカニズムは、クラスターリソースを効率的に管理し、ワークロードの可用性を維持するうえで重要な役割を果たします。これらの機能を理解して活用することで、Amazon EKS クラスターのワークロードを最適化し、信頼性高く運用できます。
スケジューリング最適化は継続的なプロセスであり、ワークロードの特性とクラスターの状態に従って調整を続ける必要があります。監視ツールを使用してクラスターのリソース使用量を追跡し、必要に応じてスケジューリングポリシーを調整することが重要です。
クイズ
この章で学んだ内容をテストするには、スケジューリング、Preemption、Eviction クイズ に挑戦してください。