EKS Spot の本番実験と結果評価
最終更新日: 2026年9月14日 測定状況: 一部測定済み (定常負荷、drain、Spot reclaim 1回、PDB による阻止、明示的な On-Demand への移行)。結果と生データはセクション7に記載。 対象範囲: EKS Auto Mode、セルフマネージド Karpenter、EKS マネージドノードグループ上で中断を許容する workload
Spot の採用は、まずノード reclaim 時にもサービス SLO とデータの正しさを維持できるかで評価し、次にコスト削減を確認します。On-Demand のベースラインを測定し、同等負荷で混在構成の可用性と実効コストを比較します。セクション1~6の提案値/期間は実験設計の例です。実測値はセクション7に別記しており、どちらも AWS の保証ではありません。
補完的な設計として、起動時に CPU を多く割り当てる → 初期化後にインプレースで CPU を下げる → Guaranteed QoS を維持する方法があります。定常状態のリソース設定に一貫性を持たせながら、置き換え Pod の初期化を短縮する狙いです。以下のフェーズを考慮したリソース設定と複合 E10 実験を参照してください。既存の E0~E9 測定では、この構成を検証していません。
元の実験レポートと workload 対応関係には、提供された Go controller の文書へのリンクと、Deployment、StatefulSet、DaemonSet、Argo Rollouts の範囲を記載しています。
現在の判断は、本番拡大を保留: reclaim/移行時のエラー、バージョン互換性、中断処理に対処することです。合成 HTTP 測定で診断できるのは導入構成であり、業務サービスが中断せず動くことや、対応バージョンの構成を実証するものではありません。
1. 検証する挙動と制約
| 項目 | 文書化された挙動/制約 | 実験で得る証拠 |
|---|---|---|
| Spot 通知 | EC2 の終了/停止通知は、best-effort で中断の2分前に届くのが通常です。休止はすぐに始まります。S1 | イベントの配送遅延、通知を処理できない場合の動作 |
| Pod の終了時間 | 2分間がアプリケーション専用に確保されるわけではありません。検出、eviction、hook、LB への反映に時間がかかります。MNG の Pod には終了通知が届かないこともあります。S2 | SIGTERM から終了までの時間、強制終了、失敗した要求 |
| PDB | PodDisruptionBudget は Eviction API による任意 disruption を制限します。インスタンス損失を防いだり Deployment の rolling update 並列度を制御したりはできません。S3 | 任意 drain と強制ノード損失を別々に評価 |
| 容量の置き換え | Node Ready と、アプリケーションがトラフィックを提供できる状態は別の段階です。S2、S4 | Node Ready → イメージ pull → Pod Ready → LB target healthy → SLO 回復 |
| Spot 比率 | NodePool の優先度や許可する capacity type では固定比率を保証できません。S5 | ノード、vCPU、Pod、要求の比率を別々に計測 |
コンピューティング管理方式別の経路
| コンピューティング管理方式 | 容量ラベル | 中断処理 | On-Demand への復旧 |
|---|---|---|---|
| EKS Auto Mode | karpenter.sh/capacity-type: spot / on-demand | 管理機能、Kubernetes event、NodeClaim を観測します。OSS Karpenter のインストール手順を Auto Mode に流用しないでください。S6 | NodePool と Pod の両方の制約が On-Demand を許可することを確認 |
| セルフマネージド Karpenter | karpenter.sh/capacity-type: spot / on-demand | EventBridge → SQS → Karpenter --interruption-queue、IAM、event、controller log を検証します。rebalance recommendation の処理は中断通知と異なります。S4 | NodePool と互換性のある Pod selector、affinity、toleration で spot と on-demand を許可。S5 |
| EKS マネージドノードグループ (MNG) | eks.amazonaws.com/capacityType: SPOT / ON_DEMAND | マネージド Capacity Rebalancing と実際の ASG 設定を確認します。drain が Ready な置き換えノードを常に待つわけではありません。S2 | Spot MNG は Spot 専用です。別の On-Demand MNG、Cluster Autoscaler 設定、Pod の適格性をテストします。S2 |
NodePool の disruption budget を 0 にしても EC2 reclaim は止められません。任意の Karpenter consolidation/drift と中断を分けて記録します。S4 Auto Mode に Node Termination Handler を別途インストールすることは、この実験の前提条件ではありません。
2. 環境と比較グループ
本番と同じデプロイ成果物、ネットワーク、ロードバランサー経路を使える指定のテストクラスターから始めます。既存の本番クラスターを当然の選択肢としないでください。負荷生成器とテレメトリー収集器は reclaim 対象外に置きます。
各 run の前に記録を固定する
| 項目 | 記録内容 |
|---|---|
| Run ID | Run ID、担当者、UTC 開始/終了、構成 Git SHA、FIS experiment ID |
| プラットフォーム | AWS アカウント別名とリージョン、テストクラスター、Kubernetes/プラットフォームのバージョン、Auto Mode または Karpenter/CA のバージョン |
| ノード | AMI/OS、アーキテクチャ、インスタンスタイプ/AZ、NodePool/MNG 設定、上限、クォータ、サブネット IP の余裕 |
| アプリケーション | イメージ digest、replica、request/limit、HPA、PDB、配置、終了 hook、retry/timeout |
| トラフィック | endpoint と操作、payload サイズ、request レート/並列度、keep-alive、retry ポリシー、データ seed |
| テレメトリー | 収集間隔、dashboard/log query、生のクライアント記録、時計の同期、保持先 |
| コスト | 実使用時間とノード別単価の基準、割引/commitment の扱い、共有費用の按分 |
公開結果には実アカウント ID、内部 endpoint、顧客データを含めず、アクセス制御された証拠で追跡可能性を維持します。グループ間で同じイメージアーキテクチャを使います。MNG と Cluster Autoscaler では、vCPU/メモリーサイズの近いインスタンスタイプをまとめます。アーキテクチャやインスタンスサイズの変更を Spot の影響と混同しないでください。S2
比較グループ
| グループ | 構成 | 目的 |
|---|---|---|
| A | On-Demand のみ | 同等負荷でのエラー、遅延、スループット、コストのベースライン |
| B | On-Demand でサービスの最低容量を確保し、Spot を追加 | 本番候補。継続性とコストを比較 |
| C | Spot のみ | 中断と容量リスクを明らかにする。本番向け推奨ではない |
グループ B の構成例では、On-Demand のみを使う Deployment に replica 3つ、Spot のみを使う Deployment に replica 3つを配置し、共通の Service で配信します。それぞれの Deployment には重複しない selector を割り当て、Service 用の label だけを共有します。これでノード、コスト、request の割合が50%ずつになるとは限りません。
この固定比率の実験と、Spot を優先するが On-Demand も許可する Deploymentでの fallback テストは別にします。Spot 専用 selector を設定すると、ノードに空きがあっても Pod は On-Demand へ移動できません。1つの NodePool で両方の capacity type を許可しても、実行中の On-Demand の最低容量は確保されません。S5
On-Demand の最低容量は、任意の割合ではなくサービスの存続要件から決めます。
Required surviving replicas = ceil(required degraded-mode RPS / per-Pod RPS meeting SLO)
Surviving replicas after failure = all replicas - replicas on reclaimed nodes
Requirement: surviving replicas >= required surviving replicas
例として、各 Pod が SLO 内で 100 RPS を処理でき、縮退時の需要が300 RPS であると仮定すると、少なくとも3 replica が存続する必要があります。この計算は CPU、メモリー、接続、下流の容量が十分であると仮定しており、実システムで3 replica が十分という証拠ではありません。AZ 障害を範囲に含めるなら、障害 AZ の On-Demand 容量も除外してください。
最初は HPA と任意 consolidation の設定を固定し、その後、別の相互作用テストで本番設定に戻します。Pod の実配置も記録します。hostname/AZ の topology spread、DoNotSchedule、minDomains、PV の zone 制約により復旧が妨げられることがあります。S8
Guaranteed QoS を維持する起動時 CPU の増量
Kubernetes roadmap の1.36節にある MAP とフェーズを考慮した CPU downscale の prototype を、Spot の置き換え経路に適用します。コンテナーレベルのインプレース resize は既に利用可能なため、feature gate の追加で有効にできる拡張としては記述しないでください。 MAP はこの prototype の実装部品です。
コンテナーレベルのインプレース resize は1.35で GA となり、MutatingAdmissionPolicy (MAP) は1.36で GA となりました。MAP は mutating admission webhook の代替として、API server 内で CEL を使います。この例では外部 webhook server をデプロイしません。S14、S16
この方法で短縮を狙う「初期化時間」とは、アプリケーションのCPU 集約型の初期化または warmup 段階です。完了済みの通常 initContainers のリソースは変更しません。イメージ pull、ノード起動、外部 I/O の待ち時間、単純な sleep が支配的なら、CPU 設定を変えても所要時間は比例して短縮しません。roadmap の BusyBox sleep 例は状態遷移を示すものであり、起動性能のベンチマークではありません。
次の比較用プロファイルの例は roadmap の値を使用します。どのプロファイルも、コンテナーのメモリー request/limit を 64Mi に揃えています。リソース値を決める前に、実際のアプリケーションの起動、ピーク負荷、メモリー使用量を測定してください。
| プロファイル | 起動時 CPU request=limit | 定常時 CPU request=limit | 目的 |
|---|---|---|---|
| G-steady | 50m | 50m | 低い固定 CPU のベースライン |
| G-phase | 200m | 50m | 初期化中に CPU を増やし、完了後に downscale |
| G-high | 200m | 200m | 起動/定常時の両方で使う大きめの固定 CPU 対照 |
この方法は最初に Burstable で起動して後から Guaranteed にするものではありません。 Pod の QoS クラスは作成時に決まり、resize では変更できません。このコンテナーレベル構成では、app、sidecar、init のすべてで、CPU とメモリーの各 request を対応する正の limit と同じ値にします。downscale する際は CPU request と limit を同時に変更します。CPU の値だけ一致していても、メモリー値が異なるなら Guaranteed の要件を満たしません。S14、S15
既存 prototype の契約も適用されます。
WATCH_NAMESPACEは1つだけ、MIN_STEADY_CPUはレビュー済みの値を設定します。MAP の binding はmap-demo: "true"label が付いた namespace を選びます。Pod template にはresize.example.com/managed: "true"label とresize.example.com/enabled: "true"annotation が必要です。これらの selector は認可境界の代替にはなりません。resize.example.com/trigger: StartupProbePassedを使用し、すべての対象となる通常 container について、本物のstartupProbeとstatus.containerStatuses[].started=trueの両方を確認します。startedだけでも、固定待ち時間でも warmup の完了を証明できません。S17resize.example.com/steady-resources内の container 名を実際の名前に一致させます。現行 Spot 例でhttpという名前の container なら、CPU だけの値は{"http":{"requests":{"cpu":"50m"},"limits":{"cpu":"50m"}}}です。この annotation だけでは MAP/resizer は導入されず、起動時 CPU も増えません。- Linux の Pod OS と Linux ノードを明示的に選び、コンテナーレベルのリソースを使います。既存 prototype は Pod レベルの予算、メモリー変更、upscale、再起動が必要な CPU policy、進行中の resize、観測されたリソースの不一致を拒否します。通常 init/ephemeral container は対象にしません。static CPU/Memory manager policy など、選択したノードの resize 制約を確認します。S14
- より大きい CPU request で新しい Pod をスケジュールするため、起動容量の余裕を確保します。後で downscale 予定でも、現在の request が収まらなければ Pod は Pending のままです。既存 prototype は同じ Pod 内で container が再起動したとき、起動時 CPU を復元しません。このケースは別途テストします。reclaim された Spot 容量を置き換える新しい Pod では、template と admission 経路が再び適用されます。
Guaranteed を維持するとリソース構成と QoS 条件は保たれますが、適切なサービス品質を決めるのはアプリケーション SLOです。低い定常 CPU limit は throttle と遅延を生む場合があり、メモリー limit を超えると OOM になることがあります。Guaranteed は Spot ノードの reclaim を防ぎません。まず HPA、VPA、GitOps、resizer 間のリソース設定の所有者を明確にします。E7 では、CPU 利用率ベースの HPA が使う分母に CPU request の変更が与える影響を検証します。S1、S14、S15
元の実験レポートと workload 対応関係
添付ソース: Go controller による自動フェーズ対応 resize: Deployment / StatefulSet / DaemonSet / Argo Rollouts。この Notion 文書には Go コード、Dockerfile、RBAC/deployment manifest、報告された EKS 観測結果が含まれます。参照には Notion の共有権限が必要な場合があります。
元ソースの中心的な考え方は、Guaranteed QoS を一貫して維持しながら、起動時と定常時で異なる CPU 予算を使うことです。downscale が実際に適用された後は、request が減ることで追加 Pod のための余裕が生まれ、定常時 CPU limit は使用量の上限として残ります。ノイジーネイバー対策や bin-packing 改善は評価すべき設計上の利点として記述されています。以下の CPU/QoS 表は、性能向上、ノード密度改善、コスト削減を測定したものではありません。
共通の入口は workload の種類ではなくPodです。Deployment と Rollout の Pod は通常 ReplicaSet を直接の controller owner とし、StatefulSet と DaemonSet も Pod を作成します。以下の所有関係は実験群を識別するものであり、親 controller の種類ごとに別の resizer コードが必要という意味ではありません。
| Workload | Pod の所有経路 | 元ソースが示す証拠 |
|---|---|---|
| Deployment | Deployment → ReplicaSet → Pod | セクション6.2~6.3に2 Pod の自動 resize log と前後の値を報告 |
| StatefulSet | StatefulSet → Pod | セクション6.2~6.3に自動 resize log と前後の値を報告 |
| DaemonSet | DaemonSet → Pod | セクション6.2~6.3に自動 resize log と前後の値を報告 |
| Argo Rollouts | Rollout → ReplicaSet → Pod | セクション4.1に直接の spec.template 例と構造上の適用可能性を説明。セクション6.3の測定表にはない |
元ソースで直接編集する Pod template では、共通設定を各リソースの spec.template に適用します。annotation は spec.template.metadata.annotations、起動用リソース、startupProbe、resizePolicy は対象となる spec.template.spec.containers[] に設定します。元ソースでは明示的に設定する policy と MAP による注入を区別しています。Deployment manifest の kind だけを変えても不十分です。StatefulSet の serviceName/Service、ストレージと順序の policy、DaemonSet の配置、Rollout strategy など、workload 固有の設定を保ちます。
次の値は元ソースが報告した変更前/変更後の値です。示された環境は EKS 1.36.1、containerd 2.2.3、arm64/Graviton 上の cgroup v2 を使う AL2023 です。提供された実験レポートの要約であり、このドキュメント更新では再実行していません。
| 報告された workload | CPU request=limit | Memory request=limit | QoS | restartCount / containerID |
|---|---|---|---|---|
| Deployment Pod 2つ | 200m → 50m | 64Mi のまま | Guaranteed → Guaranteed | 0 → 0 / 変更なし |
| StatefulSet Pod | 200m → 50m | 64Mi のまま | Guaranteed → Guaranteed | 0 → 0 / 変更なし |
| DaemonSet Pod | 200m → 50m | 64Mi のまま | Guaranteed → Guaranteed | 0 → 0 / 変更なし |
Argo Rollouts については、構造上の適用可能性と観測済みの検証を区別します。元ソースの導入部は4種類すべてに言及していますが、詳細な測定表に載っているのは上記3種類です。Argo についての説明は Pod の所有関係が共通であることに基づきます。ReplicaSet という log label だけでは Deployment と Rollout を区別できず、Rollout のテスト完了も証明できません。実際の stable/canary の所有関係を記録し、promotion、abort/rollback、traffic/Analysis metric、CPU request 変更の影響を別々に検証します。
元ソースのクラスター全体の watch、resized marker、sync.Map は以前の実装に属します。旧コードを現行デプロイ仕様として置き換えず、現在の roadmap prototype の namespace scope、管理 label、CPU floor、本物の startupProbe、UID/resourceVersion テスト、retry queueを維持します。containerID/restartCount が変わらないだけでは cgroup への適用や request 損失がないことを証明できません。ソースレポート、実際のリソース/SLO 観測、未実行の複合 Spot E10 テストは分けて扱ってください。
3. 実験と合格条件
共通プロトコルの例: warm-up を10分、定常負荷を15分、fault 注入/回復を行い、回復後に15分測定します。各 fault シナリオは最低5回の独立 run から始め、時刻と対象インスタンスタイプを変えます。このサンプル数だけでは本番の信頼性を立証しません。
SLO の例: 1分間の窓で request エラー率0.1%以下、p99 が500 ms以下、120秒以内に回復、確認応答済み処理の損失なし。テスト前にサービスで合意した SLO/error budget に置き換えます。HTTP エラーとあわせて timeout、接続失敗、不正な response content も失敗に数えます。retry 前の生の試行結果と、retry 後に成功したユーザー操作を分けて報告します。
| ID | 仮説と刺激 | 手順 | 観測と判断 |
|---|---|---|---|
| E0 | fault がない状態で B が A と同じ SLO を満たす | warm-up を除き、A/B/C に同等の代表的負荷 | エラー、遅延分布、成功スループット、実際の Spot 比率 |
| E1 | drain とアプリケーション終了処理が機能する | Eviction API でテストノード1台を drain し、その後復元 | PDB の待機、shutdown hook、処理中 work の完了。Spot reclaim の代わりではない |
| E2 | Spot instance 1台の reclaim 後も SLO を維持する | 以下の FIS 手順で実 Spot instance 1台を中断 | 通知→drain→置き換え→サービス回復、失敗、強制終了 |
| E3 | 複数同時 reclaim 後も存続容量を確保する | E2 合格後、同一 AZ/type の Spot instance 2台を明示的に対象化 | 同時に利用不可となった最大数、PDB による阻止、残存数、損失。対象がなければ N/A |
| E4 | Spot が利用できない場合に On-Demand でサービスを復旧する | 先に On-Demand のみへの Deployment 変更を試し、別途以下の容量エラーをテスト | 移行訓練と容量エラーによる自動 fallback を別々に評価 |
| E5 | 通知処理がない場合の復旧 | 専用テスト環境で、中断処理を壊すか指定 Spot VM を突然終了し、別 run で試す | 通常の通知テストと分け、通知なしでの検出/再スケジュール遅延と処理の正しさを測る |
| E6 | 制約と遅い終了処理による失敗を明らかにする | run ごとに条件を1つ変更: drain を阻止する PDB、長い preStop、Spot 専用 affinity、AZ 制約 | 想定した失敗を検出し、本番設定を診断/修正して再実行 |
| E7 | スケーリングと reclaim が重なる | 本番 HPA/CA/Karpenter 設定を復元し、代表的なピーク需要で E2 を実行 | Pending Pod、クォータ/IP、image pull、容量増加が SLO を満たすまでの時間 |
| E8 | retry 後も処理の正しさが保たれる | 固定したテスト job-ID 一覧を使い、処理中に E2 を実行 | 送信/確認応答/永続化済み結果を突合し、重複実行と副作用の重複を区別 |
| E9 | コスト改善が持続する | 比較可能な A/B 期間を交互に実行するか、同等負荷で十分な期間観測 | retry、二重容量、オーバーヘッドを含む成功操作あたりの費用。性能低下なし |
| E10 | 起動時 CPU の増量で置き換え Pod の初期化を短縮し、downscale 後も品質を保つ | 同じ配置、アプリ、負荷で G-steady/G-phase/G-high を比較し、その後 E2 を再実行 | 起動時間、resize の実適用、Guaranteed QoS 維持、restart、throttling、request SLO |
E3 で試すのは複数 Spot instance の同時 reclaimです。ネットワーク、ストレージ、On-Demand 容量にも影響する AZ 全体の停止を再現するものではありません。
E4: 移行訓練と容量不足を区別する
NodePool を On-Demand のみへ変更するテストでは、設定、スケジューリング、アプリケーション起動を確認できます。EC2 が Spot 容量不足を返した後の自動 fallback は検証できません。
制御された容量エラーには、AWS FIS の EC2 API insufficient-capacity または ASG insufficient-capacity action が、公式 action リファレンスと現在の get-action 出力を踏まえて、実際のプロビジョニング経路に適合するか確認します。Karpenter の Fleet 呼び出し、MNG の ASG、AWS 管理下の Auto Mode は別の経路です。注入対象は指定テスト role/ASG と AZ に限定し、On-Demand のプロビジョニング経路もブロックしないことを検証します。
実際の経路を対象にする再現可能な注入方法がなければ、自動 fallback は未検証 (UNVERIFIED) とします。自然発生した容量不足は補足証拠にできます。インスタンスタイプ/AZ を制限しても、容量不足が発生するとは限りません。
E10: 初期化短縮と定常品質をあわせて検証する
最初は構成 A または B のどちらかに固定し、CPU プロファイルだけを変えます。アプリイメージ、入力、replica、定常時メモリー、インスタンスタイプ、AZ、イメージキャッシュ状態を揃え、実際の CPU 処理を行う初期化を使います。CPU プロファイル間で通常負荷を比較した後、同じ E2 reclaim テストを再実行します。autoscaler との相互作用に関する E7 は別段階で確認します。
| 評価項目 | 必要な証拠 |
|---|---|
| 初期化の短縮 | アプリ初期化の開始/終了、container 起動、startupProbe 成功、Ready/LB 時刻を別々に計測。ノード起動や image pull と混同せず、run 間の分布を比較 |
| Resize の適用 | 希望する spec.containers[].resources、kubelet が報告する status.containerStatuses[].resources、generation/observed generation、PodResizePending/PodResizeInProgress をまとめて保存 |
| 処理継続と QoS | 同一 Pod UID の変更前/後の CPU・メモリー request/limit、qosClass=Guaranteed、containerID、restartCount。これだけでは request 損失ゼロは立証できない |
| 定常時の品質 | downscale 後、代表的/ピーク負荷で既存 SLO を満たすエラー、p99、スループット、CPU throttling、OOM、readiness の変化、業務処理の正確さ |
| 置き換えとリソース競合 | 複数 Pod 起動中の Pending Pod、追加ノード、起動容量。同一 Pod 内の再起動、controller 失敗、Deferred/Infeasible resize、復旧経路 |
Resize PATCH の成功が立証するのは要求の受理です。Deferred または Infeasible の PodResizePending、PodResizeInProgress、実際に報告されたリソースを確認します。適用されていない値を定常時の結果として記録しないでください。以下は所有する Pod 1つの読み取り専用 snapshotであり、繰り返し観測する代わりにはなりません。S14
set -euo pipefail
: "${KUBE_CONTEXT:?}"; : "${NAMESPACE:?}"; : "${POD_NAME:?}"
kubectl --context "$KUBE_CONTEXT" --request-timeout=15s \
  -n "$NAMESPACE" get pod "$POD_NAME" -o json |
  jq '{
    capturedAt:(now|todateiso8601),
    uid:.metadata.uid,generation:.metadata.generation,
    observedGeneration:.status.observedGeneration,qosClass:.status.qosClass,
    desired:[.spec.containers[] | {name,resources}],
    reported:[.status.containerStatuses[]? |
      {name,started,ready,runningStartedAt:.state.running.startedAt,
       resources,restartCount,containerID}],
    resizeConditions:[.status.conditions[]? |
      select(.type=="PodResizePending" or .type=="PodResizeInProgress")]
  }'
G-phase による初期化の改善、CPU downscale の実適用、downscale 後の SLO 維持、Spot reclaim 中のサービス条件を別々に評価します。測定していない項目はそのまま記録します。QoS class 名だけでは「品質問題なし」を立証できません。このガイドでは、起動時 CPU の増量とその後の downscale による影響をまだ測定していません。
4. E2 の再現: AWS FIS で Spot ノード1台を reclaim する
前提条件
必要なツール: Bash、AWS CLI、kubectl、jq。
- テストクラスターと専用の実験用 NodePool/MNG を特定します。対象ノード上のすべての Podを確認し、業務 workload と共有 controller を対象から除外します。必要な node DaemonSet とそのリソースオーバーヘッドを一覧化します。
- レビュー済み FIS 実行 role と、実際のサービスエラー/遅延を監視する CloudWatch stop alarm を準備します。対象 action は指定した実験インスタンス/tag に限定し、
fis.amazonaws.comの信頼関係、SourceAccount/SourceArn制限、呼び出し元のiam:PassRole範囲を確認します。S10 - alarm が実際のメトリクスを受け取り、
OKであることを確認します。fault を注入する前に alarm の状態遷移をテストし、しきい値、評価期間、欠損データの扱いを記録します。 - 注入前に UTC timestamp 付きのクライアント負荷ログと、Kubernetes/controller/LB の観測を開始します。
対象を特定した後に限り、次の shell 入力を設定します。
export SPOT_PROFILE=''
export SPOT_REGION=''
export SPOT_CLUSTER=''
export SPOT_NODE=''
export SPOT_INSTANCE_ID=''
export SPOT_RUN_ID=''
export SPOT_FIS_ROLE_ARN=''
export SPOT_STOP_ALARM_ARN=''
専用 kubeconfig を使用し、workstation のデフォルト current-context は変更しないでください。次の読み取り操作で cluster ARN、EC2 lifecycle、providerID、Pod を突合します。ノード label だけでは EC2 capacity が Spot である証拠になりません。
set -euo pipefail
: "${SPOT_PROFILE:?}" "${SPOT_REGION:?}" "${SPOT_CLUSTER:?}"
: "${SPOT_NODE:?}" "${SPOT_INSTANCE_ID:?}" "${SPOT_RUN_ID:?}"
: "${SPOT_FIS_ROLE_ARN:?}" "${SPOT_STOP_ALARM_ARN:?}"
umask 077
SPOT_RESULT_DIR=$(mktemp -d "$PWD/eks-spot-run.XXXXXX")
SPOT_KUBECONFIG="$SPOT_RESULT_DIR/kubeconfig"
spot_aws() { aws --profile "$SPOT_PROFILE" --region "$SPOT_REGION" --output json "$@"; }
spot_kubectl() { kubectl --kubeconfig "$SPOT_KUBECONFIG" "$@"; }

spot_aws eks update-kubeconfig --name "$SPOT_CLUSTER" \
  --kubeconfig "$SPOT_KUBECONFIG" --alias "$SPOT_CLUSTER"
spot_aws sts get-caller-identity > "$SPOT_RESULT_DIR/caller.json"
spot_aws eks describe-cluster --name "$SPOT_CLUSTER" \
  > "$SPOT_RESULT_DIR/cluster.json"
spot_kubectl get node "$SPOT_NODE" -o json \
  > "$SPOT_RESULT_DIR/node-before.json"
spot_kubectl get pods -A --field-selector "spec.nodeName=$SPOT_NODE" -o json \
  > "$SPOT_RESULT_DIR/pods-on-target.json"
spot_aws ec2 describe-instances --instance-ids "$SPOT_INSTANCE_ID" \
  > "$SPOT_RESULT_DIR/instance-before.json"

jq -e --arg id "$SPOT_INSTANCE_ID" \
  '.spec.providerID | endswith("/" + $id)' \
  "$SPOT_RESULT_DIR/node-before.json"
jq -e '[.Reservations[].Instances[]] |
  length == 1 and .[0].InstanceLifecycle == "spot" and .[0].State.Name == "running"' \
  "$SPOT_RESULT_DIR/instance-before.json"
caller.json と cluster.json 内の account、Region、cluster が指定テスト環境に一致し、ノードがこの実験専用であることを確認します。以下の JSON を $SPOT_RESULT_DIR/fis-template.example.json として保存します。実行前に、以下のコマンドで例の ARN を確認済みの入力値に置き換えます。明示的なリソース ARN を1つ、COUNT(1) を指定してください。
{
  "description": "E2: interrupt one isolated EKS Spot test node",
  "roleArn": "arn:aws:iam::111122223333:role/eks-spot-test-fis",
  "targets": {
    "oneSpotNode": {
      "resourceType": "aws:ec2:spot-instance",
      "resourceArns": ["arn:aws:ec2:ap-northeast-2:111122223333:instance/i-0123456789abcdef0"],
      "selectionMode": "COUNT(1)"
    }
  },
  "actions": {
    "interrupt": {
      "actionId": "aws:ec2:send-spot-instance-interruptions",
      "parameters": {"durationBeforeInterruption": "PT2M"},
      "targets": {"SpotInstances": "oneSpotNode"}
    }
  },
  "stopConditions": [
    {
      "source": "aws:cloudwatch:alarm",
      "value": "arn:aws:cloudwatch:ap-northeast-2:111122223333:alarm:eks-spot-test-slo"
    }
  ]
}
この FIS action は実際にインスタンスを中断します。また開始時に rebalance recommendation も送るため、E2 だけでは中断通知処理の効果を独立して分離できません。durationBeforeInterruption をアプリケーションの猶予期間と解釈せず、実際の event 時刻を記録します。S7、S9
開始前に template を読み戻し、対象を検証します。alarm による停止や stop-experiment によって、既に要求された中断が取り消されたり、終了したインスタンスが復元されたりすると考えないでください。それ以上の注入を止めることと、サービスを復旧することは別の操作です。S11
SPOT_ACCOUNT_ID=$(jq -r '.Account' "$SPOT_RESULT_DIR/caller.json")
SPOT_PARTITION=$(jq -r '.Arn | split(":")[1]' "$SPOT_RESULT_DIR/caller.json")
SPOT_INSTANCE_ARN="arn:$SPOT_PARTITION:ec2:$SPOT_REGION:$SPOT_ACCOUNT_ID:instance/$SPOT_INSTANCE_ID"
jq --arg instance "$SPOT_INSTANCE_ARN" \
  --arg role "$SPOT_FIS_ROLE_ARN" --arg alarm "$SPOT_STOP_ALARM_ARN" \
  '.roleArn = $role |
   .targets.oneSpotNode.resourceArns = [$instance] |
   .stopConditions[0].value = $alarm' \
  "$SPOT_RESULT_DIR/fis-template.example.json" > "$SPOT_RESULT_DIR/fis-template.json"

SPOT_TEMPLATE_ID=$(spot_aws fis create-experiment-template \
  --cli-input-json "file://$SPOT_RESULT_DIR/fis-template.json" \
  --query experimentTemplate.id --output text)
spot_aws fis get-experiment-template --id "$SPOT_TEMPLATE_ID" \
  > "$SPOT_RESULT_DIR/template-resolved.json"

# Run after target review and telemetry startup: the test instance is reclaimed.
SPOT_EXPERIMENT_ID=$(spot_aws fis start-experiment \
  --experiment-template-id "$SPOT_TEMPLATE_ID" \
  --tags "RunId=$SPOT_RUN_ID" \
  --query experiment.id --output text)
spot_aws fis get-experiment --id "$SPOT_EXPERIMENT_ID" \
  > "$SPOT_RESULT_DIR/experiment-start.json"
spot_aws fis list-experiment-resolved-targets \
  --experiment-id "$SPOT_EXPERIMENT_ID" \
  > "$SPOT_RESULT_DIR/targets.json"
experiment が終了状態になるまで get-experiment を照会し、解決済みの対象が意図したインスタンスそのものであることを確認します。completed が示すのは fault action の完了であり、サービスが SLO を満たしたことではありません。failed、stopped、対象なしの run を合格にしないでください。S7
5. 測定と結果の記録
観測タイムライン
| 時刻 | 証拠 |
|---|---|
| T0 | FIS action の開始と実際に解決された対象 |
| T1 | EventBridge event の time、observer の受信/処理時刻。IMDS spot/instance-action または識別済み controller 情報から取得できる場合のみ、推定中断時刻を別途記録 |
| T2 | cordon/taint、eviction の開始、Pod の SIGTERM/終了ログ |
| T3 | 対象 EC2 状態の変化、置き換え instance 作成、Node Ready |
| T4 | 置き換え Pod Ready、EndpointSlice 状態、LB target healthy |
| T5 | 合意したエラー、遅延、スループット条件を連続5分間満たした開始時刻 |
回復を T0 から T5 までと、最初の SLO 違反から回復するまでに分けて報告します。run 中ずっとサービスが基準内ならサービス downtime は0です。ノード/Pod 置き換え時間は別に報告してください。計測されていない場合に、回復時間を0秒としてはいけません。
EventBridge event に独立した scheduled-interruption-time フィールドはありません。IMDS が示すのは概算時刻です。取得できない場合は unavailable と記録します。この項目のためだけに Auto Mode ノードへアクセスできる必要はありません。推定時刻にはその旨を明記し、T3 の実際の EC2 状態変化も記録します。S1
注入前、注入中、注入後の Node/Pod JSON、event、PDB、EndpointSlice、NodePool/MNG 構成を保持します。event は期限切れになり、テレメトリーの到着が遅れる場合があるため、完了後の照会1回だけでは不十分です。セルフマネージド Karpenter では controller/SQS メトリクス、MNG では ASG activity、Auto Mode では利用可能な管理 event も追加します。
LB の 5xx メトリクスだけで合否を判断しないでください。client の connection reset、timeout、DNS failure、応答内容の検証を含め、retry によって隠れた失敗を特定します。各観測窓の p99 は、生サンプルまたは統合した histogram から計算します。複数の p99 を平均して全体の p99 としてはいけません。
実験状況
測定値はセクション7と生データを参照してください。NOT RUN や UNVERIFIED は合格ではありません。測定したのは合成 HTTP request であり、業務データの損失や副作用の重複はテストしていません。
| 実験 | 実際の範囲 | 状況 |
|---|---|---|
| E0 | 3つの観測経路で定常負荷を120秒 | 1回。各経路2,400件成功 |
| E1 | 専用 Spot node 1台を drain。180秒観測 | 1回。経路全体で失敗8件 |
| E2 | FIS で Spot instance 1台を reclaim。900秒観測 | 1回。経路全体で失敗10件 |
| E3 | 複数 instance の同時 reclaim | NOT RUN |
| E4 | Pod selector を On-Demand に変更。240秒観測 | 1回。容量不足後の実際の自動 fallback は UNVERIFIED |
| E5 | 突然の損失または通知配送失敗 | NOT RUN |
| E6 | PDB minAvailable: 2 で eviction を拒否し、後で1に戻す | 一部実施。shutdown hook/AZ 制約の variant は NOT RUN |
| E7 | ピーク負荷と HPA の相互作用 | NOT RUN |
| E8 | 業務処理の正確性 | NOT RUN |
| E9 | instance-hour 価格を照会 | 価格 snapshot のみ。実請求額と成功操作あたりの費用は NOT MEASURED |
| E10 | 起動時 CPU 増量、downscale、Guaranteed QoS 維持を組み合わせた Spot テスト | NOT RUN。roadmap prototype と過去の報告は、このガイドの Spot 測定とは別の証拠 |
各 run を 仮説 → 注入の確認 → 観測 → 判定 → 原因 → 修正 → 再実行 ID に結び付けます。失敗した run と除外した run も保持します。各 run、中央値、最悪値を報告し、通知の見逃し、収集失敗、負荷生成器の飽和を開示してください。
コスト計算
Effective cost =
  actual Spot/On-Demand usage cost
  + additional capacity consumed by replacement overlap and retries
  + allocated EBS, LB, transfer, telemetry, EKS/Auto Mode costs

Cost per successful operation = effective cost / unique successful operations passing correctness checks
Savings = 1 - (B cost per successful operation / A cost per successful operation)
実際の EC2 料金に含まれている置き換え/再試行用容量を二重計上しないでください。2行目は漏れを防ぐための費用按分に関する注意です。固定/共有 EKS コストの按分方法を示し、FIS 実験料金は継続的な運用費と分けて報告します。
短時間の run から月額を外挿する場合は推定値と明記します。Spot 割引だけで実効的な節約とは言えません。A の実際の Savings Plans/RI 割引と未使用 commitment にも同じ会計基準を適用し、Region/期間別の請求データで金額を検証します。S12
6. 採用とロールバック
判断
| 判断 | 条件 |
|---|---|
| 採用可能 | 合意済みの必須シナリオに合格し、代表負荷と正確性の証拠があり、コストが改善し、On-Demand 復旧訓練に合格 |
| 条件付き採用 | 制約、範囲を限定した workload/Spot 比率、評価期間、canary の責任者を明示 |
| 拡大を保留 | 必須実験/証拠の不足、SLO 違反、処理損失/副作用の重複、復旧容量不足、自動 fallback 未検証 |
外部の永続状態を使う stateless API と、retry/idempotency が検証済みの worker から始めます。別途 replication/recovery をテストせずに、quorum、ローカル状態、猶予時間内の終了を前提とする workload に同じ結論を広げないでください。クラスター制御や可観測性機能の存続容量も確保します。
rollout の例は テスト → 1サービスの canary → 検証済み範囲内で拡大です。各段階で実際の Spot vCPU、Pod、traffic 比率と error budget への影響を再確認します。「どこでも Spot 70%」のようなデフォルトの正解はありません。
ロールバック手順
- 新しい fault 注入と Spot 拡大を止めます。実行中の FIS experiment に
stop-experimentを要求し、既に予定されている reclaim の影響は引き続き観測します。 - テスト済み On-Demand 構成を GitOps のソースに適用します。ad-hoc patch が reconciliation で上書きされないよう変更の所有者を明確にします。
- On-Demand 上限、サブネットの IP 余裕、Pod 制約を確認し、置き換え Deployment を拡大します。Pod Ready、LB target の health、サービス SLO を確認します。
- 存続容量を確保した後、Spot 専用 Deployment を段階的に縮小します。NodePool で許可する capacity type だけを変えても、既存 Pod は直ちに移動しません。
- エラー、遅延、処理の正確さを再確認し、証拠を保持します。修正と再テストに合格するまで Spot を再拡大しません。
クリーンアップ
最初に、アクセス制御された耐久性のあるストレージへ証拠をエクスポートします。変更前/後の manifest を比較し、HPA、PDB、スケジューリング、中断処理の設定を復元します。適切な場合は、E1 後に残ったノードの cordon を解除します。この実験のために作成した FIS template、alarm、テスト workload、専用ノードだけを削除します。node manager がリソースを再作成しないよう先に desired capacity を調整し、残存する EBS/LB 料金も確認します。/tmp は耐久性のある証拠保管先ではありません。
7. 2026-09-12 の測定
環境と解釈
既存の EKS テストクラスターに専用 namespace、NodePool、EC2NodeClass を作成しました。FIS は新規作成した Spot instance 1台を対象にしました。既存の Karpenter Pod 構成はテスト前後で同一でした。証拠をエクスポートした後、実験リソースを削除し、削除済みであることを検証しました。
| 項目 | 実際の構成 |
|---|---|
| プラットフォーム | EKS 1.36 / kubelet 1.36.3-eks-cb19647、Karpenter 1.4.0 |
| ノード | arm64 c6g.large、観測 AZ ID apne2-az1、初期状態は On-Demand 1台 + Spot 2台 |
| 柔軟性と配置 | インスタンスタイプ4種類、AZ 2つを許可。初期ノードはすべて1タイプ/1 AZ に配置 |
| アプリケーション | Fortio 1.69.4、digest 固定済みイメージ、Pod request 50m / 64Mi、終了猶予30秒、readiness は2秒ごと |
| 配置 | 2つの Spot Pod に hostname anti-affinity、PDB minAvailable: 1 |
| 要求 | 経路ごとに20 RPS、HTTP GET /、応答 body は0 byte、各 request で新しい接続、retry なし |
| 測定 | 専用 On-Demand Pod 上の Python 3.12 probe、request ごとの JSONL、約5秒ごとの Kubernetes 観測、別の EventBridge 観測 queue |
| Stop alarm | 経路全体のエラー率5%超またはデータ欠損を監視。10秒間隔、データポイント2/2。例示した0.1%合格条件とは別 |
これらのデータはフェーズ対応 resize を検証していません。 公開された初期 Deployment template内の3つの Deployment は CPU/memory request が 50m/64Mi、limit が 500m/256Mi です。この設定自体は Guaranteed の要件を満たしません。template にフェーズ対応 resize の opt-in、resizePolicy、startupProbe はありません。公開測定には、リソースと QoS の変更前後の証拠や warmup 性能の比較がありません。初期 template を admission 後の実 Pod 状態の観測として扱わないでください。E10 には独立した run が必要です。
対応バージョン構成の検証ではありません。 確認した公式互換性マトリクスでは、Kubernetes 1.36 に Karpenter 1.13 以降が必要です。導入済みの 1.4.0 はその下限未満です。アップグレードの効果は測定していません。S13
Karpenter に中断 queue は構成されていませんでした。新規作成した queue は観測専用 queueであり、Karpenter に接続していません。この結果を、中断処理を構成した Karpenter の場合に一般化しないでください。
On-Demand control には Pod が3つ、混在経路には On-Demand Pod 1つと Spot Pod 2つがありました。Spot 観測経路は混在経路と同じ Spot Pod 2つを選択します。control Pod、混在経路の安定 Pod、probe が On-Demand ノードを共有していたため、独立したコスト/スループット比較群ではありません。E4 の生データファイル名 spot-only は移行中の Service を指し、移行後は On-Demand Pod を選択します。
request の結果
各シナリオは1回のみ実行しました。すべての経路で予定した request はすべて送信され、生成器による skip は0でした。失敗には HTTP error のほか接続エラーと socket timeout も含まれます。p99 は失敗 request を含む完了済みの生の遅延から nearest rank で計算しました。
| 試行 / 経路 | Request | 失敗 | 全体のエラー率 | 全体 p99 | 最悪の60秒エラー率 |
|---|---|---|---|---|---|
| E0 / On-Demand control | 2,400 | 0 | 0% | 3.41 ms | 0% |
| E0 / 混在 | 2,400 | 0 | 0% | 4.90 ms | 0% |
| E0 / Spot 観測経路 | 2,400 | 0 | 0% | 3.91 ms | 0% |
| E1 / On-Demand control | 3,600 | 0 | 0% | 5.93 ms | 0% |
| E1 / 混在 | 3,600 | 8 | 0.2222% | 3.30 ms | 0.5833% |
| E1 / Spot 観測経路 | 3,600 | 1 | 0.0278% | 5.11 ms | 0.0833% |
| E2 / On-Demand control | 18,000 | 0 | 0% | 5.17 ms | 0% |
| E2 / 混在 | 18,000 | 10 | 0.0556% | 5.63 ms | 0.8333% |
| E2 / Spot 観測経路 | 18,000 | 5 | 0.0278% | 5.09 ms | 0.4167% |
| E4 / On-Demand control | 4,800 | 0 | 0% | 5.60 ms | 0% |
| E4 / 混在 | 4,800 | 9 | 0.1875% | 6.20 ms | 0.5833% |
| E4 / 移行コホート | 4,800 | 16 | 0.3333% | 6.99 ms | 1.3333% |
最悪の60秒エラー率は、1秒ずつ進む完全な60秒観測窓で算出しています。終了時の不完全な窓は除外します。E2 混在経路の全体エラー率は0.0556%、p99 は5.63msですが、最悪の60秒エラー率は0.8333%で、事前に記載した設計例の0.1%を超えました。これは診断基準であり、業務サービスで合意した SLO ではありません。
E1 と E4 にも失敗した request がありました。drain や rollout が完了しても、エラーなしの移行を実証したことにはなりません。最初に失敗 request が始まった時刻から、最後に失敗が完了した時刻までの幅は、継続的な downtime でもサービス回復時間でもありません。生データには別時刻に発生した失敗もすべて保持しています。
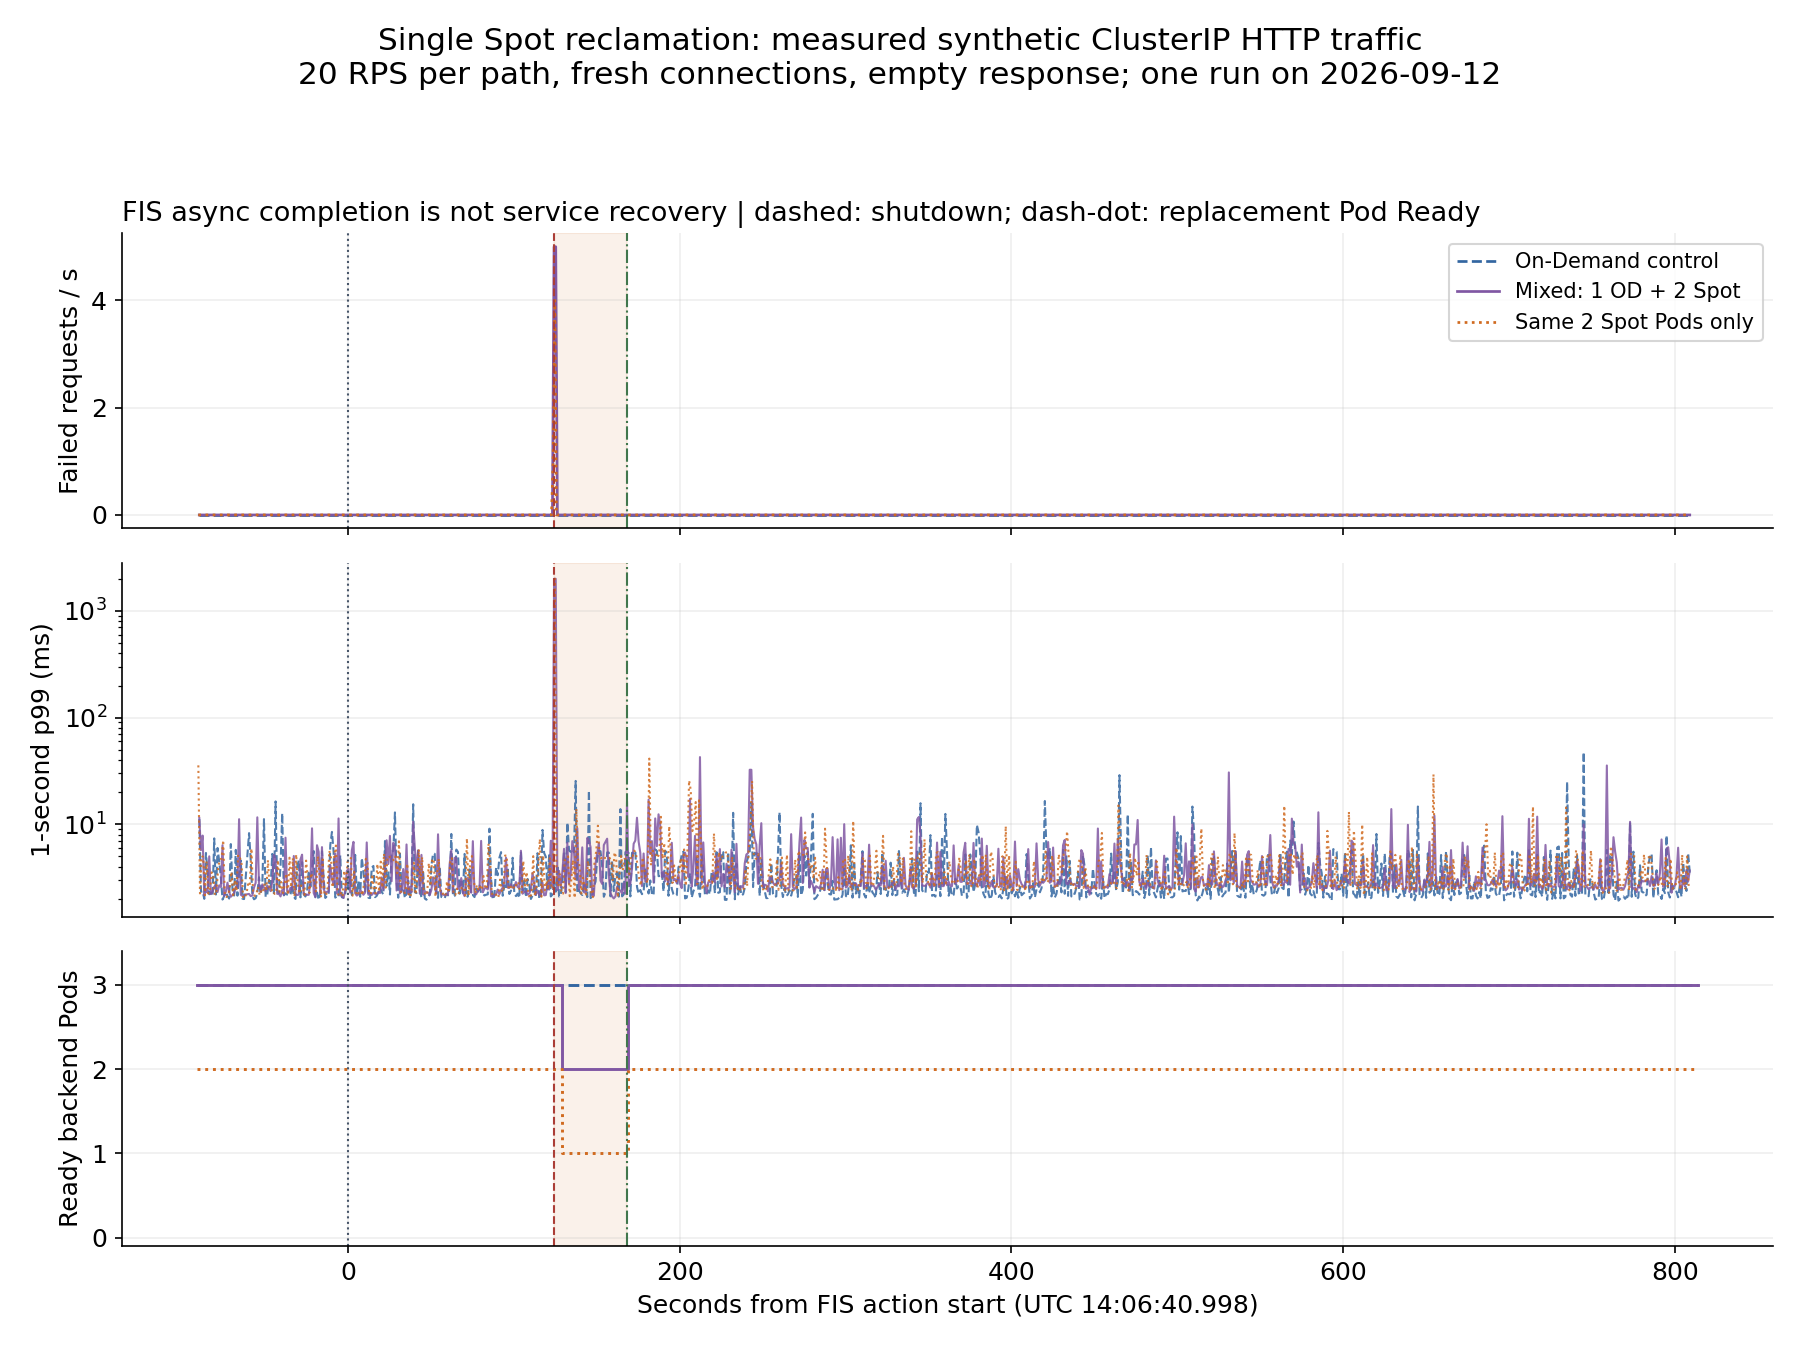
グラフは E2 の観測時間全体を表示します。遅延軸は対数で、毎秒約20サンプルです。1秒単位の p99 を全体の p99 と同一視しないでください。網掛けは報告されたノード shutdown から置き換え Pod Ready までであり、サービス全体の downtime ではありません。
Reclaim のタイムライン
| 観測 | UTC 時刻 | 証拠 |
|---|---|---|
| FIS action 開始 | 14:06:40.998 | FIS startTime |
| 中断通知 | 14:06:41 | EventBridge event の time |
FIS completed | 14:06:41.755 | サービス回復とは異なる FIS endTime |
| kubelet が shutdown を報告 / 元 Pod 終了 | 14:08:45 | KubeletNotReady、TerminationByKubelet |
| 置き換え NodeClaim 作成 | 14:08:48.212 | Karpenter controller log |
| 置き換え Node Ready | 14:09:23 | Node condition |
| 置き換え Pod Ready | 14:09:29 | Pod condition |
通知が届いた後、reclaim 前の観測中は対象のスケジュール可能状態が保たれていました。ノード shutdown 後に置き換え NodeClaim が作成されました。置き換え Pod が Ready になるまでの報告値は shutdown から44秒です。これはサービス回復時間でも、44秒間連続して downtime があったことを示す値でもありません。kubelet status から Pod 終了は確認できましたが、アプリが SIGTERM を受け取ったことは別途計測していません。API のサンプリング間隔と秒単位の event 時刻も考慮してください。
移行、価格、判断
明示的な On-Demand 移行では rollout が 47.05秒で完了しました。実際のノード label で、移行対象の Pod 2つが両方とも On-Demand 容量上にあることを確認しました。EC2 の容量エラーは注入していないため、自動 fallback は未検証です。
2026-09-12 14:08:41 UTC の価格照会では、パブリックな On-Demand Linux c6g.large の料金は $0.077/instance-hour、観測 AZ の Spot 料金は $0.0248/instance-hourでした。単価の差は67.79%ですが、実請求額や workload の削減額ではありません。EBS、EKS、FIS、telemetry、commitment、retry、置き換え容量、同等の可用性要件も比較してください。
本番利用を拡大する前に、次の対応が必要です。
- Karpenter を Kubernetes 互換性マトリクスに合わせ、CRD、IAM、アップグレード経路を検証する。
- 実際の Karpenter 中断 queue、EventBridge、IAM 経路を設定して reclaim テストを繰り返す。観測 queue に届いただけでは不十分。
- アプリケーションの終了処理、readiness の反映、client retry ポリシー、外部 LB 経路を request SLO に照らしてテストする。
- 存続する On-Demand 容量、AZ 配置、実際の容量エラー fallback、同時 reclaim を検証する。
- 代表的な業務負荷、正確性チェック、異なる時刻での反復 run、実効コストの証拠を得る。
実験用 namespace、NodePool 2つ、EC2NodeClass、新しい instance profile、FIS template/role、alarm、EventBridge rule、SQS queue を削除しました。稼働中の実験 EC2 instance、残存 EBS volume、Kubernetes resource がゼロであることを検証済みです。過去の FIS 実行記録と metric data は AWS サービスの保持期間内に残っています。
測定ツールとテストと生 request 記録、集計、timelineを参照してください。公開証拠からはアカウント、ノード、ネットワーク識別子を除外しています。詳細なインフラの原本は別途保持しています。
8. 関連ガイドと情報源
- スケーリング戦略
- Kubernetes バージョン roadmap: MAP とフェーズ対応 CPU resize
- Go Phase-Aware Resize ソース: 4 workload の対応関係と報告済みの実験結果 (Notion)
- Event の容量計画
- FinOps コスト管理
- トラブルシューティング playbook
- このガイドのクイズ
公式ドキュメントはサービス挙動の主張を裏付けますが、このリポジトリで実験を実行した証拠ではありません。既存の S1~S13 リンクは2026-09-12に確認しました。追加した S14~S17 リンクは2026-09-14に確認しました。
N1 は2026-09-14に提供され、閲覧した実装/実験レポートです。Kubernetes の公式仕様でも、新たな Spot 測定でもありません。