パート 1: SageMaker Qwen PII プラットフォームアーキテクチャ
最終更新日: 2026年9月12日。この図は目標設計を示したものであり、過去の AWS 記録では、どちらの GPU トレーニング経路も実行されていません。
GPU の実行は、固定されている PyTorch 2.8 DLC がパッチ提供終了に達したためブロックされています。まず、実行の章に記載されている、サポート対象ランタイムへのアップグレード要件に従ってください。
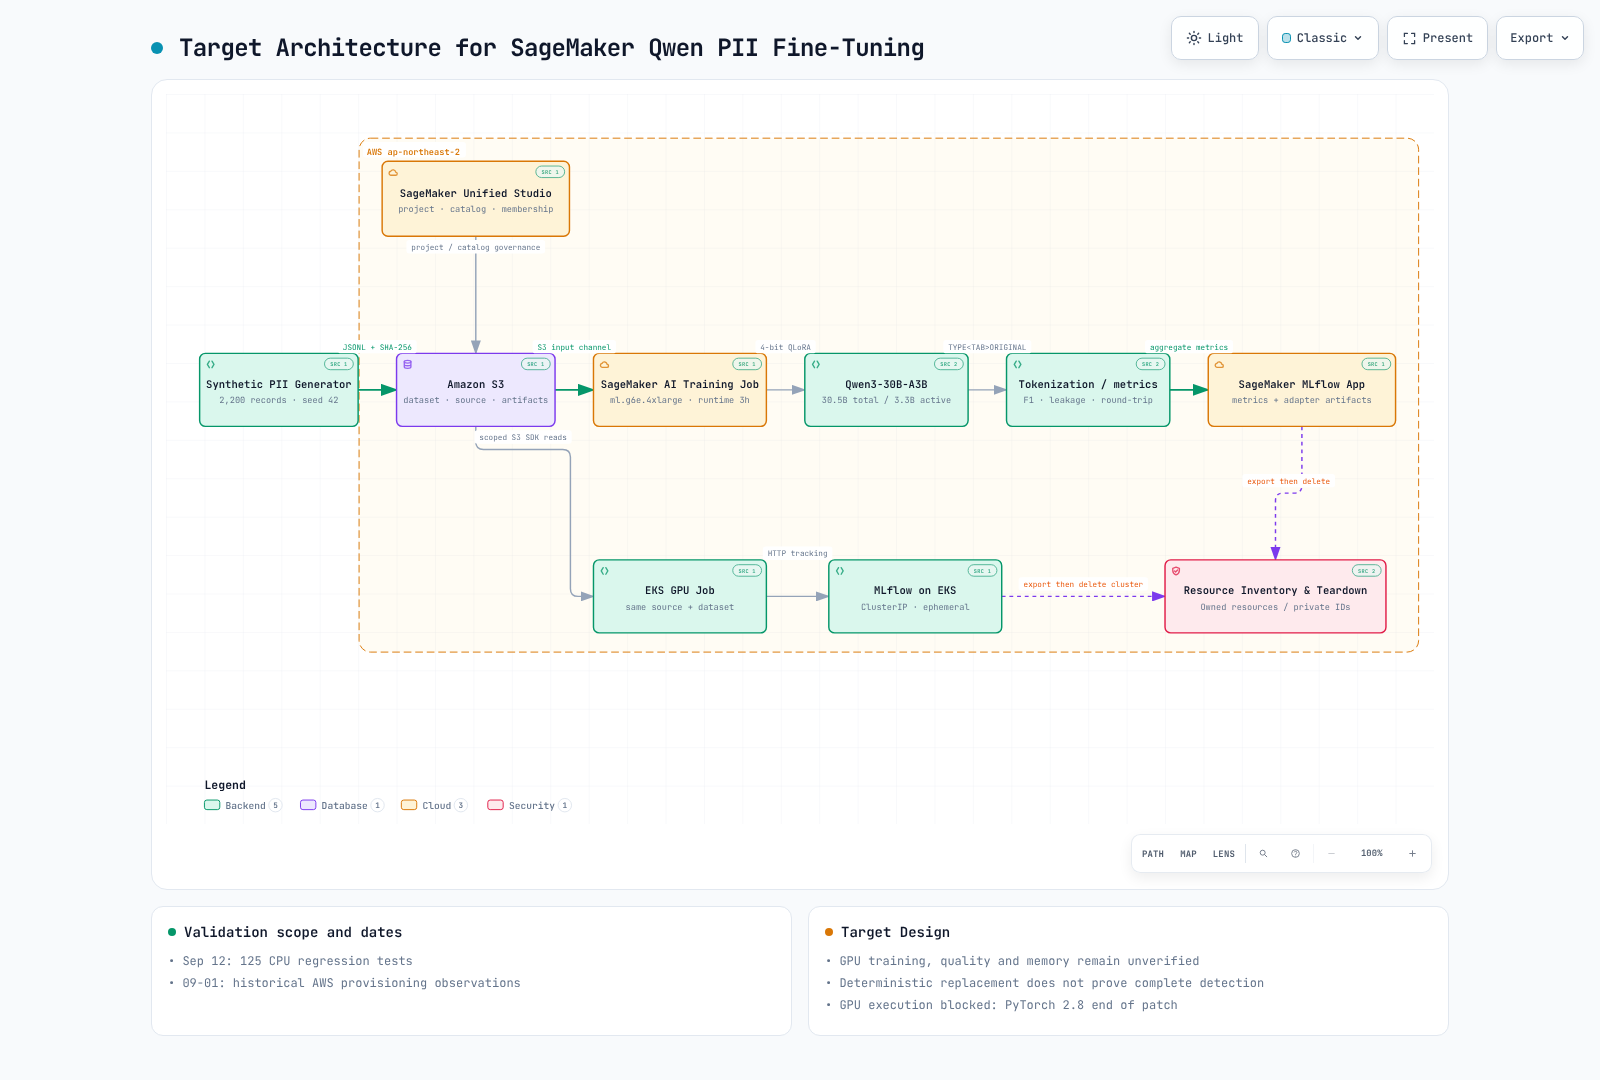
1. 責任範囲と記録の境界
| コンポーネント | 責任と制限 |
|---|---|
| 合成データ生成器 | 1,600/200/400 の分割、合計 2,200 レコードを設定し、生成器、シード、ハッシュを追跡する |
| S3 / データ配信 | ソース/データ/アーティファクトを保存し、IAM、暗号化、保持、転送を個別に管理する |
| Qwen + QLoRA | エンティティ候補を対象とするアダプタートレーニングの設計。最終的な置換と完全な検出は別の課題 |
| Python による処理/評価 | 型/ソースの検査、置換/復元、集計を行う。モデルが見逃したエンティティを自動的に復元するものではない |
| MLflow | 設定、バージョン、集計を比較し、サーバーへのアクセスとログ/アーティファクトの内容を検証する |
| Unified Studio | この実験におけるガバナンス上の選択であり、QLoRA、EKS、Training Jobs の必須依存関係ではない |
| インベントリ / ティアダウン | 識別子、所有者、依存関係を非公開で記録し、エクスポート、クリーンアップ、検証を行う |
ソーステキストやトークンの対応表を含む制御用アーティファクトを管理してください。対応表があれば置換は元に戻せますが、暗号化ではありません。ログポリシーは設計/契約であり、すべてのライブラリ、コールバック、例外、自動トレースがテスト済みであることの証明ではありません。リソース ID/ARN は非公開のインベントリで必要になる場合がありますが、公開レポートとは分けてください。
2. 異なる環境における共通の契約
| 項目 | SageMaker AI 経路 | EKS 経路 |
|---|---|---|
| 実行 | マネージド Training Job | この実験用に準備した GPU Job/クラスター |
| トラッキング | SageMaker MLflow App | ClusterIP MLflow |
| データ | S3 入力チャネル | ServiceAccount のスコープに限定された AWS 権限を用いた S3 SDK ダウンロード |
| ライフサイクル | Job の終了と、外部 Apps/bucket のクリーンアップを区別する | 結果をエクスポートしてから、所有する一時リソースを解放する |
Training Job や namespace/Job の境界だけでは、セキュリティ分離が自動的に完了するわけではありません。実際の IAM/service account、ネットワーク、ストレージ、エンドポイント/MLflow へのアクセス、コンテナ設定を検証してください。EKS 経路では、ServiceAccount と SDK の認証情報チェーンを通じてワークロード ID を使用します。Pod の環境変数に事前署名済み bearer URL を設定せず、入力マニフェストの SHA-256 とバケットの所有権を検証します。
比較には、設定、分割データのハッシュ、トレーニング/評価コードとステップ数に加え、モデル/トークナイザーのリビジョン、イメージダイジェスト、推移的依存関係、CUDA/ドライバー/ハードウェア、デコード設定が必要です。シードを固定しても、環境間で GPU の結果が同一になるとは限りません。requirements.lock が固定するのは直接依存するパッケージであり、推移的環境全体ではありません。
3. モデルと提案する QLoRA 設定
ベースラインは Qwen/Qwen3-30B-A3B-Instruct-2507 です。モデルカードでは、非思考動作を備えた 合計 30.5B / アクティブ 3.3B パラメーターの MoE と説明されています。アクティブパラメーターは、保存されているすべての重みや必要な GPU メモリを表すものではありません。これを最新モデルとして提示しているわけでも、特定の GPU で動作すると実証済みとしているわけでもありません。
レビュー時に確認したモデルリポジトリのリビジョンは 0d7cf23991f47feeb3a57ecb4c9cee8ea4a17bfe でした。現在のローダー/設定では、モデル ID は指定されていますが、このリビジョンは明示的に固定されていません。再現可能な実行を主張する前に、モデル/トークナイザーのリビジョンとアーティファクトを固定してください。
| 設定 | 提案する構成 |
|---|---|
| 量子化 / 計算精度 | 4-bit NF4、二重量子化 / bfloat16 |
| LoRA rank / alpha / dropout | 16 / 32 / 0.05 |
| シーケンス長 | 1,024 |
| デバイスバッチ / 勾配累積 | 1 / 8 |
| スモーク / フル | 10 / 80 ステップ |
| Job の実行時間設定 | 10,800 秒 |
これらは、トレーニングの成功、品質の十分さ、GPU のピークメモリを測定した値ではありません。Job の期限は、プロビジョニング/トラッキング/ストレージのエンドツーエンドの存続期間やコスト上限ではありません。QLoRA は低精度のベース重みを使用し、アダプターをトレーニングします。実行時に、対象モジュールの範囲、オプティマイザー、メモリ、モデルとの互換性を検証してください。
4. ガバナンスと実行準備
この実験では、GPU の送信前に、意図したドメイン/プロファイル、呼び出し元のメンバーシップ、MLflow へのアクセスを確認します。CreateProject の membershipAssignments では同じリクエストで所有者を指定できますが、すべてのプロビジョニングがアトミックにロールバックされることを保証するものではありません。Project が ACTIVE であることと、必要なツール/環境の準備状況も個別に確認する必要があります。
過去の試行で示されているように、プロジェクトの失敗前に App などのリソースが作成される場合があります。権限の事前チェックと、作成後のインベントリ確認および補償処理を組み合わせてください。クリーンアップはこの実行で所有するリソースに限定し、過去の記録から現在の残存リソースを推測しないでください。ID と削除の境界については、Unified Studio の章に従ってください。
検証範囲
設定、trainer のソース、公開モデルカード、過去のレポートを比較しました。最初のローカルテスト 30 件に続いて、トークン化、実行、クリーンアップの回帰テストを追加しました。モデルの重みはダウンロードしていません。GPU トレーニング、推論品質の評価、現在の AWS リソースの調査も実施していません。