パート 1: Kubernetes 上の Airflow アーキテクチャ
レビュー対象のベースライン: Airflow 3.3.1 / Helm chart 1.22.0 確認した上流の最新パッチ: Airflow 3.3.2。例は引き続き 3.3.1 を使用 · 2026 年 10 月 12 日
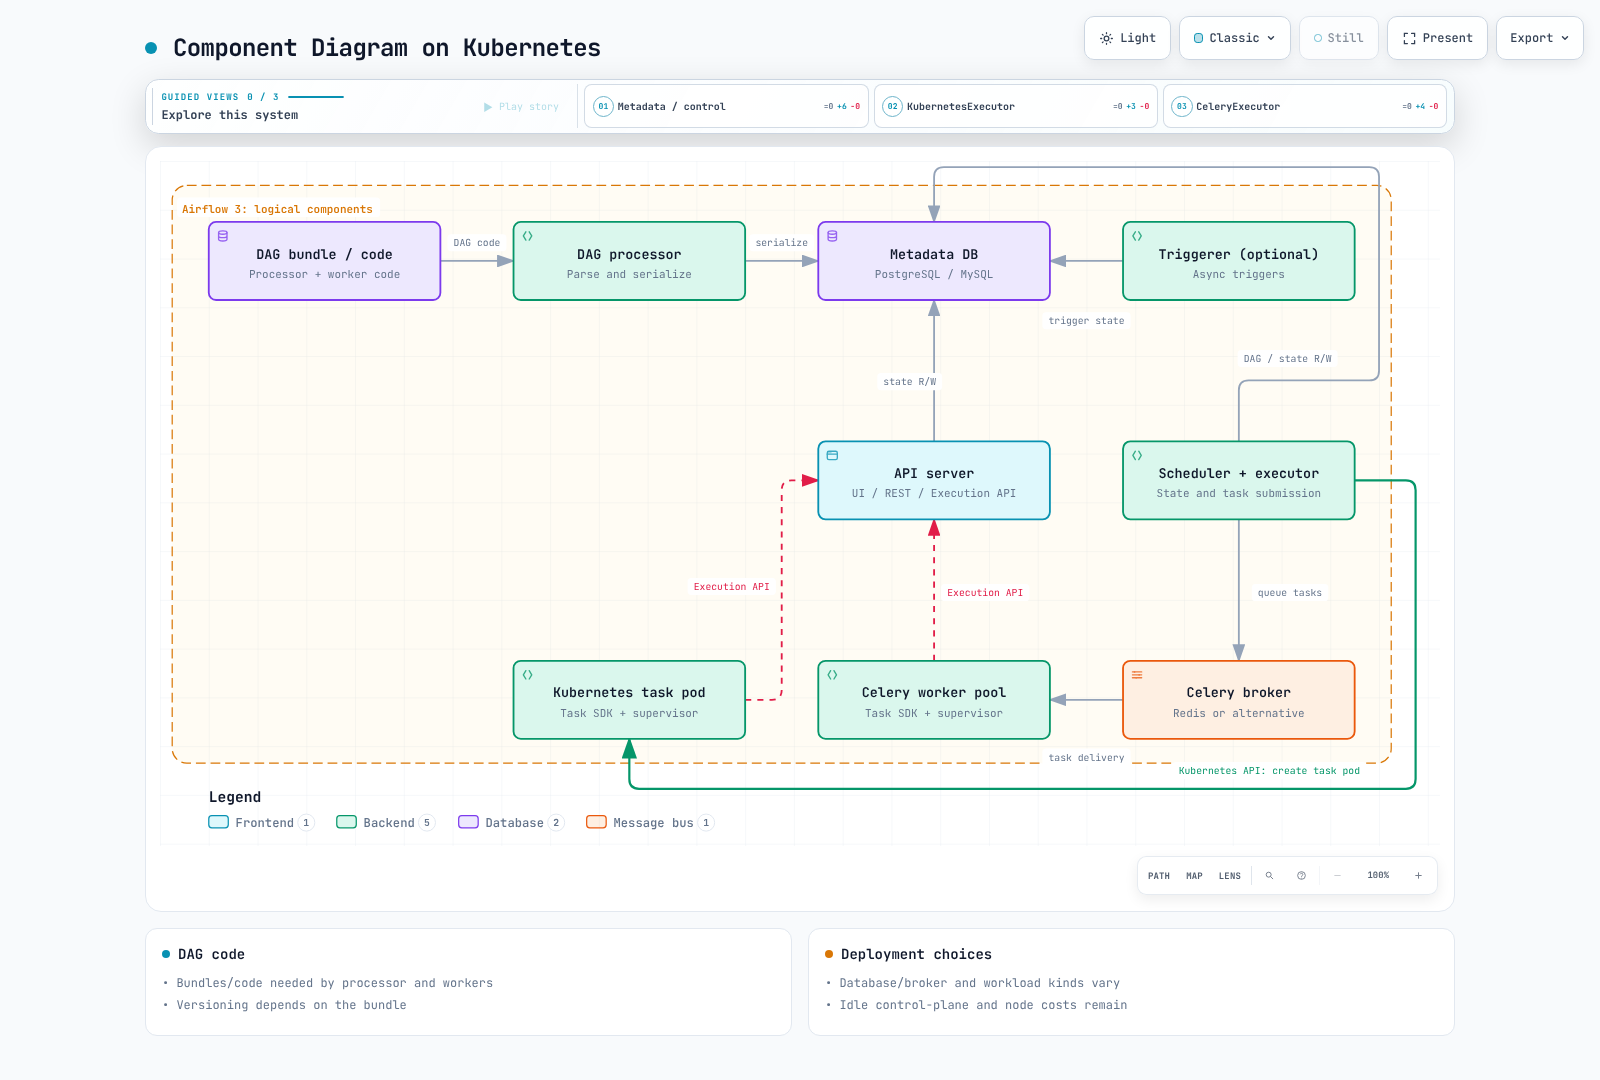
1. コンポーネントとタスクの実行
Airflow は DAG の依存関係に基づいてタスクインスタンスをスケジュールし、状態を監視します。 処理は Executor の worker、外部 Pod、またはタスクが呼び出すサービスで実行できます。 Kubernetes API サーバーはリクエストと状態を処理し、scheduler と kubelet が Pod を配置して起動します。
| コンポーネント | 責務と範囲 |
|---|---|
| Scheduler + executor | DAG/タスクの準備状況を評価し、処理を提出して、状態/ハートビートを管理する。メタデータの読み書きも行う |
| DAG processor | bundle にアクセスし、DAG を解析/シリアライズして、バージョン関連のメタデータを更新する。Airflow 3 では必須の独立ロール |
| API server | UI、REST API v2、Execution API を提供する。認証/認可は auth manager とデプロイ構成で行う |
| Task runtime / worker | Operator/Task SDK のコードを実行し、Execution API と必要なサービスに接続する |
| Triggerer | 非同期ループで遅延タスクの trigger を実行する。deferral を使わない場合は任意 |
| Metadata database | DAG/タスクの共有状態、シリアライズされた構造、関連メタデータを保存する |
Airflow 3 の Execution API
通常の管理下にある Python Task SDK 実行では、worker が supervisor プロセスを起動し、そのプロセスが task-runner サブプロセスを実行します。ユーザーのタスクコードは socket 経由で supervisor と通信し、supervisor は有効期間の短い task JWT を使って Execution API を呼び出します。Connections、Variables、XCom、状態にアクセスするための公開 SDK により、タスクコードからメタデータデータベースへ直接アクセスする必要がなくなります。
worker から API server へのアドレス、認証、ネットワークは実際に満たす必要のある依存関係です。scheduler から worker への矢印だけでは Airflow 3 の説明として不十分です。Executor の内部処理、system worker、Celery の result backend のようなストアについては別途調べてください。バックエンドプロセスがデータベースに一切接続しない、という一般論に拡張しないでください。dag.test のようなインプロセス実行でも、管理下のデプロイと同じサブプロセス/HTTP 経路を使うとは限りません。
Triggerer と worker の違い
Operator は worker 上で開始し、trigger を登録して待機中に defer できます。triggerer がその trigger を実行します。イベントが発生すると、タスクは再スケジュールされて worker 上で再開します。Operator 全体を triggerer が実行するわけではありません。deferral 中のタスクは worker スロットを解放し、既定では pool スロットも解放します。pool の動作は構成で変更できます。通常の非同期タスクは worker スロットを保持する場合があり、deferral とは異なります。
2. Airflow 2 から 3 への実際の変更点
Airflow 2 は 2026 年 4 月 22 日に EOL を迎えました。以下の比較は移行時の参考情報です。
| 項目 | Airflow 2.x | Airflow 3.x |
|---|---|---|
| UI/API | Flask ベースの webserver | FastAPI ベースの api-server とタスク Execution API の経路 |
| DAG の解析 | manager とファイル処理用サブプロセス。独立 dag-processor は任意 | DAG processor が独立した必須ロール |
| DAG の構造 | シリアライズ済み DAG によるスケジューリングはすでに存在 | シリアライズ済み構造とバージョンメタデータを継続して使用 |
| Scheduler HA | データベースベースの複数 scheduler によるサポートはすでに存在 | HA、容量、データベース負荷は引き続き検証が必要 |
| 同時 Executor | 2.10.0 からサポート | 構成を維持し、汎用化 |
| 固定のハイブリッド Executor | LocalKubernetesExecutor と CeleryKubernetesExecutor を利用可能 | 3.0 から非サポート |
Airflow 2 ではすべてのファイルが scheduler の同じ Python ループで解析された、あるいは scheduler HA が可能になったのは Airflow 3 からだ、と説明するのは正確ではありません。役割を分離すると個別に調整できますが、新しい DAG の解析が遅い場合、CPU/メモリ/データベースの共有競合、parser の過剰な並行性は、引き続きスケジューリングのレイテンシーに影響します。レプリカを増やすだけでは信頼性は証明されません。
3. メタデータ、broker、DAG コード
Airflow 3.3.1 でテスト済みの PostgreSQL は 14–18、MySQL は 8.0/8.4/Innovation、SQLite は 3.15.0 以降です。SQLite は開発/テスト用で、本番用ではありません。 MariaDB はサポートされていません。このシリーズの PostgreSQL の例は、MySQL が非サポートであることを意味しません。マネージドデータベースでも、実際の HA、バックアップ保持期間、削除ポリシーを構成する必要があります。
CeleryExecutor には互換性のある broker が必要で、Redis や RabbitMQ などを選択できます。KubernetesExecutor と LocalExecutor が Redis を必須とするわけではありません。メタデータストレージ、broker、選択した Celery result backend を区別してください。Connections/Variables には secrets backend を使用でき、XCom ペイロードの保存先にも別の backend を使用できます。
worker と DAG processor の両方に、実行可能な DAG/タスクコードとそのパッケージが必要です。通常のタスク実行では、API server が DAG ファイルを解析する必要はありません。ただし、plugin、auth manager、trigger には、適切なコード/依存関係の配布が引き続き必要です。
| DAG bundle | 現在のバージョニングサポート |
|---|---|
| GitDagBundle | サポート |
| LocalDagBundle | 非サポート。現在のローカルコードを使用 |
| S3DagBundle / GCSDagBundle | 非サポート。オブジェクトストレージのバージョニングとは別機能 |
chart 1.22.0 では引き続き git-sync を利用できます。レンダリング結果では、processor/triggerer の sidecar と init container、および Kubernetes タスク Pod テンプレートの init container が確認できます。適切な方式として git-sync、イメージに DAG を組み込む方法、共有ボリューム、リモート bundle から選択してください。bundle が実行時点のコードバージョンを保持するか、再試行時にどのコードを読み込むかも確認してください。
4. Executor の選択と同時 Executor
| 選択肢 | 実行単位 | コスト、レイテンシー、分離に関する考慮事項 |
|---|---|---|
| LocalExecutor | scheduler 側で実行するローカルタスクプロセス | 個別の broker は不要。scheduler のリソース/境界を共有 |
| KubernetesExecutor | タスクインスタンスごとの worker Pod | Pod/イメージの起動レイテンシー。上限と ID は実際の Pod spec に依存 |
| CeleryExecutor | broker メッセージを消費する worker プール | 常時稼働 worker ならすばやく開始できる。ゼロまでスケールするとコールドスタートが発生 |
KubernetesExecutor のアイドル worker Pod がなくても、コントロールプレーン、データベース、ノード、ログのコストは残ります。Pod を分けるだけで強固なセキュリティ境界が成立するわけではありません。KubernetesPodOperator は別の Pod を起動するOperatorであり、KubernetesExecutor とは異なります。
同時 Executor では、最初に構成した項目が既定値になります。タスクの executor フィールドで選択し、DAG では default_args={"executor": "KubernetesExecutor"} を使ってタスクの既定値を設定できます。個々のタスクで上書きもできます。Executor/alias に互換性のある provider、バージョン、権限が実際に構成されている必要があります。この機能は 2.10.0 で追加されており、3.0 でのハイブリッド Executor 廃止とは別の変更です。
5. パート 2 の準備と検証の制約
chart 1.22.0 の対象は Helm 3.19.0 以降、Airflow 3.1.0 以降です。 Airflow 3.3.1 でテスト済みの Kubernetes バージョンは 1.30–1.35 です。これは将来のバージョンすべてを保証するものでも、古い EKS 1.30 を選ぶ推奨でもありません。 EKS のサポート期間と、選択した provider/chart の互換性も確認してください。
パート 2 では、イメージ、データベース/broker 接続、DAG の配布、権限、ストレージを準備します。API server、scheduler、processor、triggerer が常に軽量だと想定しないでください。DAG 数、解析コスト、API 負荷、タスクの並行性を測定します。
helm version --short
helm repo add apache-airflow https://airflow.apache.org
helm repo update apache-airflow
helm show chart apache-airflow/airflow --version 1.22.0
kubectl config current-context
# Prints the namespace manifest; does not create it.
kubectl create namespace airflow --dry-run=client -o yaml
Deployment が正確に 4 つできるとは限りません。レンダリングされた chart の種類によって、triggerer は永続化の設定に応じて StatefulSet または Deployment になります。値に応じて StatsD、データベース、broker、worker のリソースも追加されます。外部データベースを使う場合、クラスタ内に PostgreSQL Pod は必要ありません。
この章では、3.3.1 の override を使って KubernetesExecutor、CeleryExecutor、git-sync の各バリアントをレンダリングします。レンダリングは、実環境でのデータベース、タスク、イメージ取得、HA 復旧のテストではありません。パート 2 で環境を確認する必要があります。