Part 3: Ray Train と Ray Tune
レビュー基準: Ray 2.58.0 · 2026-09-12
ラボ環境のセットアップ
検証には Python 3.12 と ray[train,tune]==2.58.0 を使用しました。これらの extras は Ray の Train/Tune 依存関係をインストールしますが、PyTorch などのフレームワークは別途必要です。実際のワークロードに合わせて PyTorch、CUDA、ドライバーの組み合わせを確認してください。
ここでの確認対象は、設定、callback/checkpoint API、および小規模な CPU スカラー Tune の例です。PyTorch のトレーニング、GPU、分散勾配、EKS の autoscaling のテストではありません。
Ray Train V2 とトレーニングコードの責務
2.58.0 では、RAY_TRAIN_V2_ENABLED が未設定の場合に V2 がデフォルトになります。ray.train.torch.TorchTrainer の import はそれに応じて V2 実装を選択します。環境変数によって旧実装が選択されている場合、契約が同一であると想定しないでください。
Trainer は worker と、その基盤となる分散プロセスグループを調整します。モデル、optimizer、損失/データループ、データ分割、状態の保存/復元ロジックを自動的に記述するわけではありません。PyTorch では、デバイス/DDP/sampler のセットアップに prepare_model や prepare_data_loader などの適切なヘルパーを使用し、その上でデータの重複、勾配の同期、評価を検証してください。フレームワークの collective 通信のすべてを Ray object store の転送として説明することはできません。
ScalingConfig とリソース要求
ScalingConfig は worker 数と worker あたりの論理 CPU/GPU リソースを指定します。サポートされている elastic 構成も存在するため、実際のモードとそのデータ/復旧要件を確認してください。従来の trainer_resources を設定すると、2.58.0 の V2 では非推奨エラーが発生します。V2 controller、トレーニング worker、Tune の trial driver のリソースを区別してください。
placement group と worker bundle には、フレームワークのプロセスが初期化できるだけの十分なキャパシティが事前に必要です。これは Kubernetes のスケジューリングを置き換えるものではなく、すべての Pod がアトミックにスケジュールされることを保証するものでもありません。GPU が不足すると待機、タイムアウト、失敗が発生する可能性があり、Ray/KubeRay の上限値、quota、イメージの準備状況、EC2 の在庫状況も影響します。
Checkpoint とレポート
Checkpoint.from_directory() は、自分で準備したファイルから checkpoint の参照を構築します。モデル、optimizer、RNG、scheduler、データセットの位置を自動的に取得するわけではありません。必要な状態を明示的に保存し、worker 内で train.get_checkpoint() が返す checkpoint をロードしてください。
2.58.0 の V2 における train.report の呼び出しは barrier であり、すべての worker が同じ回数到達しなければなりません。 rank 0 だけがファイルを保存する場合でも、他の rank は checkpoint=None で参加します。一部の worker でレポートをスキップすると、トレーニングが停止することがあります。メトリクスは worker 間で自動的に平均化されないため、必要な集約はトレーニングコード内で計算してください。
checkpoint のアップロードはデフォルトで同期モードです。非同期アップロードや検証を使用する場合は、完了状況、一時ファイルの保持期間、機能固有の制約を確認してください。複数の worker がシャードを保存する場合は、ファイル名の衝突を避けてください。
複数ノード構成では、すべての worker からアクセスできる永続ストレージを train.RunConfig(storage_path=...) に設定してください。Pod のローカルディレクトリでは、ノード/Pod の削除後の復旧は保証されません。S3 パスであっても IAM、ネットワーク、保持設定は別途必要です。
障害クラスと再試行
2.58.0 の V2 における FailureConfig のデフォルトは、トレーニング worker のエラーに対して max_failures=0、controller のエラーに対して controller_failure_limit=-1、preemption に対して max_preemption_failures=-1 です。max_failures=0 を設定するだけでは、すべての再試行クラスが無効になるわけではありません。 各上限値を RayJob や運用上のデッドラインとあわせて設定してください。checkpoint が存在しない、または不完全な場合、再試行によって進捗を復旧することはできません。
Ray Tune: Searcher と Scheduler
Tune は trial の設定と実行を管理します。searcher はパラメーターの候補を選択し、trial scheduler は中間メトリクスを用いて trial を停止、一時停止、継続します。grid/random search は、以前のメトリクスから次の候補を適応的に決めるとは限りません。
max_concurrent_trials、trial のリソース、placement group、クラスターのキャパシティをあわせてレビューしてください。trial driver が、その配下の Train worker に必要なリソースをすべて占有しないようにしてください。CPU/GPU の合計数だけでは、各 worker bundle が配置できることは保証されません。
小規模な Tune の例
これはモデルのトレーニングではなく、2 つのスカラー目的関数の trial を実行します。実際の確認では両方の結果を収集し、スコア 0 の x=3 が選択されました。
from pathlib import Path
import ray
from ray import tune

def objective(config):
    for step in range(2):
        tune.report({"score": -(config["x"] - 3) ** 2, "step": step})

try:
    ray.init(address="local", num_cpus=2, include_dashboard=False,
             object_store_memory=80 * 1024 * 1024)
    tuner = tune.Tuner(
        tune.with_resources(objective, {"cpu": 1}),
        param_space={"x": tune.grid_search([1, 3])},
        tune_config=tune.TuneConfig(
            metric="score", mode="max", max_concurrent_trials=1),
        run_config=tune.RunConfig(
            storage_path=str(Path(".tune-demo").resolve()),
            name="scalar-example", verbose=0),
    )
    results = tuner.fit()
    assert len(results) == 2 and not results.errors
    best = results.get_best_result()
    assert best.config["x"] == 3 and best.metrics["score"] == 0
finally:
    ray.shutdown()
Ray の論理リソースと object store のサイズは、プロセス全体に対する OS の制限ではありません。結果ディレクトリを再利用する前に、新規実行か復旧かを決めてください。
現在の Train/Tune 連携
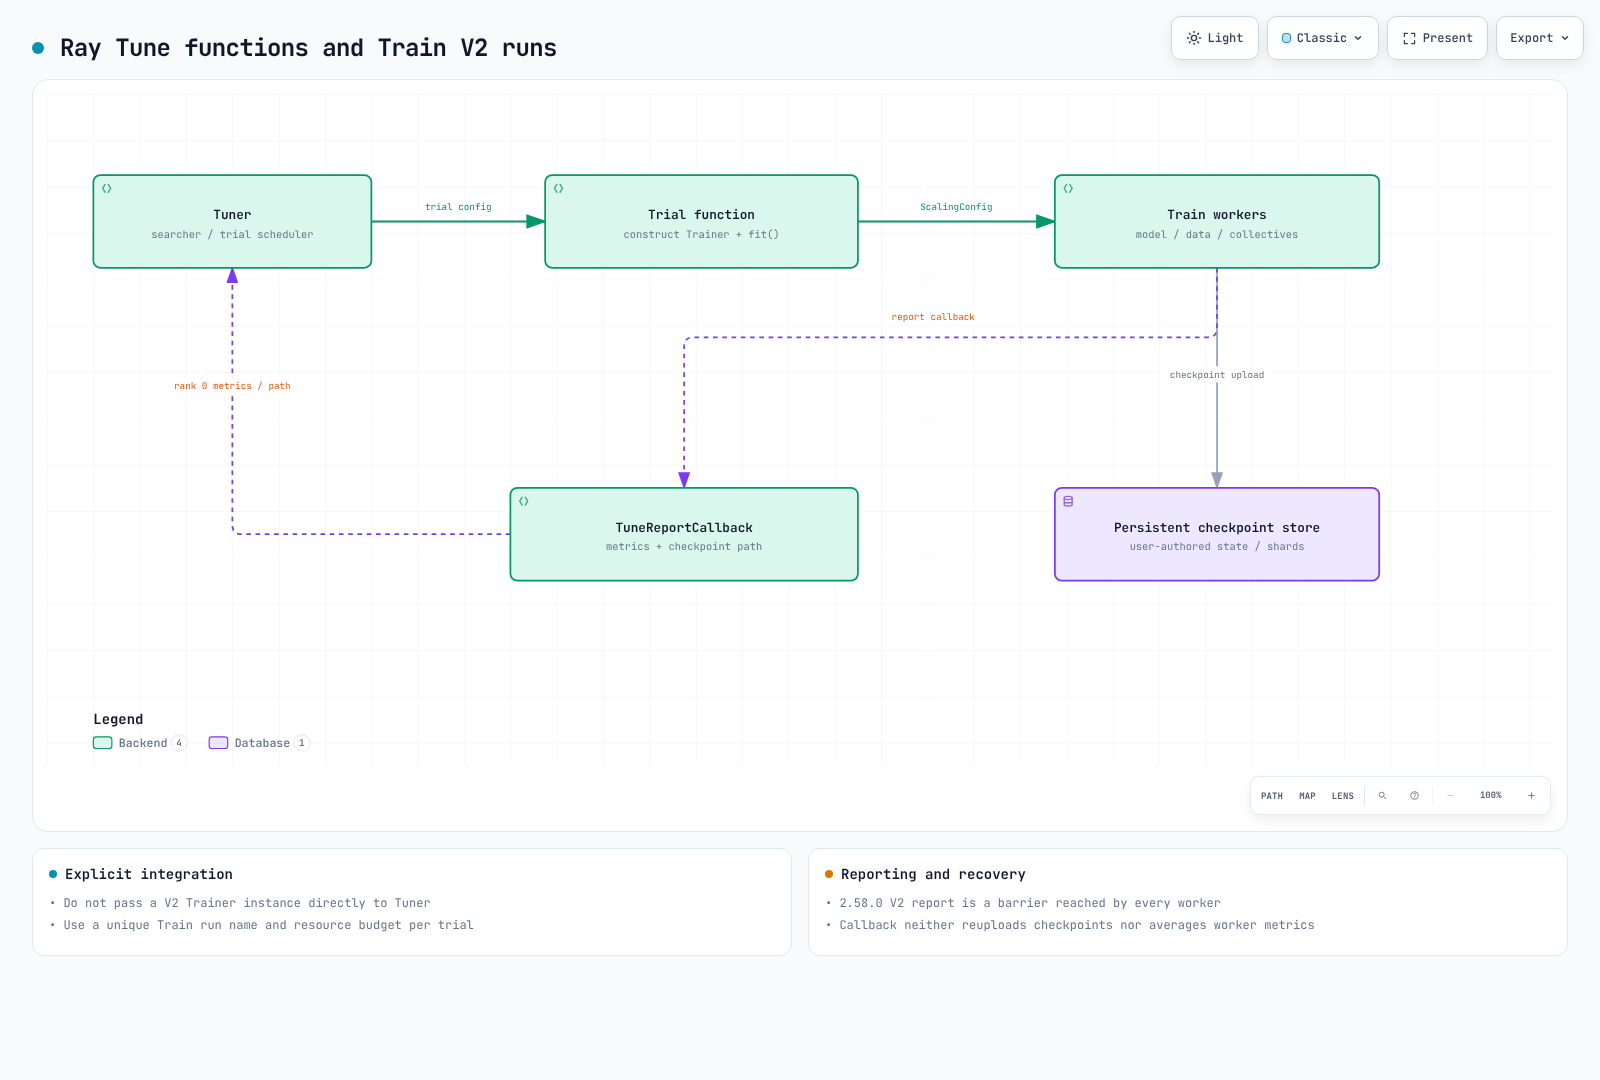
V2 の Trainer インスタンスを直接 Tuner に渡す方法を、現在推奨されるパスとして提示しないでください。 ネイティブな確認では、V2 の DataParallelTrainer インスタンスに対して TuneError が発生しました。旧 BaseTrainer の互換性/非推奨の扱いと V2 を区別してください。
現在ドキュメント化されているパターンは、フレームワークの Trainer を構築して .fit() を呼び出す 関数 trainable を使用します。trial のパラメーターは train_loop_config 経由で渡し、trial ごとに一意な Train の実行名とストレージパスを使用してください。
中間メトリクスと checkpoint のパスを転送するには、Train の RunConfig(callbacks=[...]) を通じて ray.tune.integration.ray_train.TuneReportCallback をアタッチします。これは Tune セッション内で構築してください。2.58.0 の実装は、最初の worker のメトリクス辞書を平均化せずに転送します。また、checkpoint を再度アップロードするのではなく、既存の checkpoint パスをメトリクスに追加します。
Tuner には tune.RunConfig、Trainer には train.RunConfig を使用してください。それぞれの障害、ストレージ、callback の設定は分けて管理します。この連携には明示的な結線とリソース計画が必要です。
EKS の運用上の確認事項
Ray のリソース/placement の要求、KubeRay の worker group の上限値、Kubernetes の Pod 配置、および物理ノードの供給を、それぞれ分けて確認してください。キャパシティに余裕があっても、イメージの pull、データセットへのアクセス、フレームワークの初期化/通信、checkpoint の権限によって起動が遅延することがあります。
autoscaling は GPU を即座に提供するものでも、コスト/完了時間の上限を自動的に保証するものでもありません。trial の同時実行数、worker、最大レプリカ数、再試行クラス、運用上のデッドラインを調整してください。RayJob やクラスターを削除する前に、結果と checkpoint が保存されていることを検証してください。
一次情報
- Train overview
- Train + Tune
- Checkpoints
- Persistent storage
- Failures/preemption
- PyTorch preparation
- 2.58.0 report implementation
次: Ray Serve · メインページ · クイズ