Parte 3: Ray Train y Ray Tune
Base de la revisión: Ray 2.58.0 · 2026-09-12
Configuración del entorno de laboratorio
La validación utilizó Python 3.12 y ray[train,tune]==2.58.0. Estos extras instalan las dependencias de Train/Tune de Ray; los frameworks como PyTorch son independientes. Verifica la combinación de PyTorch, CUDA y el driver para la carga de trabajo real.
Las comprobaciones de aquí cubren la configuración, las API de callbacks/checkpoints y un pequeño ejemplo escalar de Tune en CPU. No son pruebas de entrenamiento de PyTorch, GPU, gradiente distribuido ni autoscaling de EKS.
Ray Train V2 y responsabilidades del código de entrenamiento
En 2.58.0, V2 es el valor predeterminado cuando RAY_TRAIN_V2_ENABLED no está definido. La importación de ray.train.torch.TorchTrainer selecciona su implementación V2 según corresponda. No asumas contratos idénticos cuando una variable de entorno selecciona la implementación anterior.
El Trainer coordina los workers y los grupos de procesos distribuidos subyacentes. No crea automáticamente modelos, optimizadores, bucles de pérdida/datos, particionamiento de datos ni lógica para guardar/restaurar estado. Con PyTorch, utiliza asistentes adecuados como prepare_model y prepare_data_loader para la configuración de device/DDP/sampler; después verifica la duplicación de datos, la sincronización de gradientes y la evaluación. No todas las collectives de los frameworks pueden describirse como transferencias del object store de Ray.
ScalingConfig y demanda de recursos
ScalingConfig especifica el número de workers y los recursos lógicos de CPU/GPU por worker. También existen configuraciones elásticas compatibles, así que verifica el modo real y sus requisitos de datos/recuperación. Configurar el trainer_resources heredado genera un error de deprecación en V2 de 2.58.0. Distingue los recursos del controller de V2, los workers de entrenamiento y los trial drivers de Tune.
Los placement groups y los bundles de workers necesitan capacidad suficiente antes de que los procesos del framework puedan inicializarse. Esto no reemplaza la programación de Kubernetes ni garantiza la programación atómica de cada Pod. Una cantidad insuficiente de GPUs puede causar esperas, timeouts o fallos; también importan los límites de Ray/KubeRay, las cuotas, la disponibilidad de las imágenes y la disponibilidad de EC2.
Checkpoints e informes
Checkpoint.from_directory() construye una referencia de checkpoint a partir de los archivos que prepares. No captura automáticamente el modelo, el optimizador, el RNG, el scheduler ni la posición del dataset. Guarda explícitamente el estado requerido y, a continuación, carga el checkpoint devuelto por train.get_checkpoint() dentro del worker.
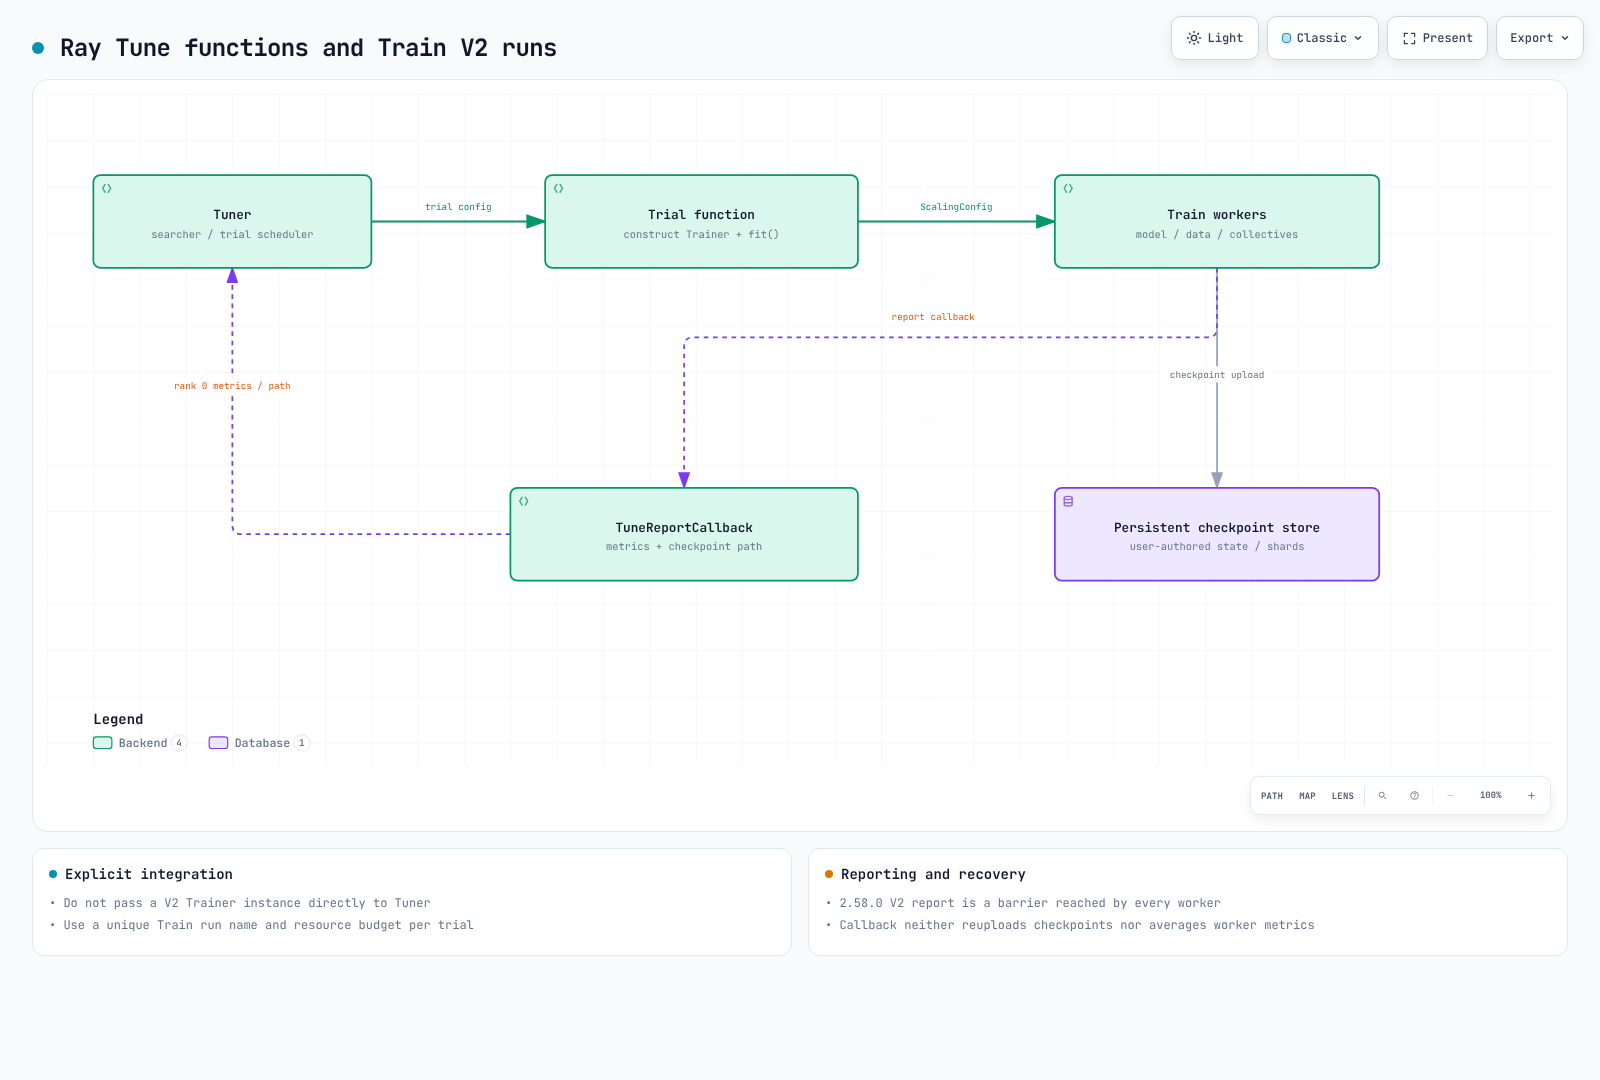
La llamada a train.report de V2 en 2.58.0 es una barrera a la que todos los workers deben llegar el mismo número de veces. Aunque solo el rank 0 guarde archivos, los demás ranks participan con checkpoint=None. Omitir informes en algunos workers puede bloquear el entrenamiento. Las métricas no se promedian automáticamente entre workers; calcula los agregados necesarios en el código de entrenamiento.
La carga de checkpoints utiliza de forma predeterminada el modo síncrono. Si usas carga o validación asíncrona, verifica la finalización, la vida útil de los archivos temporales y las restricciones específicas de la característica. Evita colisiones de nombres de archivo cuando varios workers guardan shards.
Para varios nodos, configura train.RunConfig(storage_path=...) en almacenamiento persistente accesible para todos los workers. Un directorio local de un Pod no garantiza la recuperación después de eliminar un nodo o Pod. Las rutas de S3 aún necesitan configuración de IAM, red y retención.
Clases de fallos y reintentos
Los valores predeterminados de FailureConfig de V2 en 2.58.0 son max_failures=0 para errores de workers de entrenamiento, controller_failure_limit=-1 para errores del controller y max_preemption_failures=-1 para preemption. Configurar solo max_failures=0 no desactiva todas las clases de reintentos. Configura cada límite junto con los plazos operativos/RayJob. Los reintentos no pueden recuperar el progreso de un checkpoint ausente o incompleto.
Ray Tune: Searchers y Schedulers
Tune administra las configuraciones y la ejecución de los trials. Los searchers seleccionan candidatos de parámetros; los trial schedulers utilizan métricas intermedias para detener, pausar o continuar trials. La búsqueda grid/aleatoria no necesariamente adapta su siguiente candidato a partir de métricas anteriores.
Revisa conjuntamente max_concurrent_trials, los recursos de los trials, los placement groups y la capacidad del clúster. Evita que los trial drivers ocupen todos los recursos necesarios para sus workers de Train anidados. Los totales de CPU/GPU por sí solos no garantizan que pueda ubicarse cada bundle de workers.
Ejemplo pequeño de Tune
Esto ejecuta dos trials de objetivo escalar, no entrenamiento de modelos. La comprobación real recopiló ambos resultados y seleccionó x=3 con puntuación 0.
from pathlib import Path
import ray
from ray import tune

def objective(config):
    for step in range(2):
        tune.report({"score": -(config["x"] - 3) ** 2, "step": step})

try:
    ray.init(address="local", num_cpus=2, include_dashboard=False,
             object_store_memory=80 * 1024 * 1024)
    tuner = tune.Tuner(
        tune.with_resources(objective, {"cpu": 1}),
        param_space={"x": tune.grid_search([1, 3])},
        tune_config=tune.TuneConfig(
            metric="score", mode="max", max_concurrent_trials=1),
        run_config=tune.RunConfig(
            storage_path=str(Path(".tune-demo").resolve()),
            name="scalar-example", verbose=0),
    )
    results = tuner.fit()
    assert len(results) == 2 and not results.errors
    best = results.get_best_result()
    assert best.config["x"] == 3 and best.metrics["score"] == 0
finally:
    ray.shutdown()
Los recursos lógicos de Ray y el tamaño del object store no son límites del sistema operativo para todo el proceso. Decide si pretendes una nueva ejecución o una recuperación antes de reutilizar un directorio de resultados.
Integración actual de Train/Tune
No presentes pasar directamente una instancia de Trainer V2 a Tuner como la ruta recomendada actual. La comprobación nativa generó TuneError para una instancia V2 de DataParallelTrainer. Distingue el manejo de compatibilidad/deprecación del BaseTrainer anterior de V2.
El patrón documentado actual utiliza un function trainable que construye un Trainer de framework y llama a .fit(). Pasa los parámetros del trial mediante train_loop_config y usa nombres de ejecución de Train y rutas de almacenamiento únicos para cada trial.
Para reenviar métricas intermedias y rutas de checkpoints, adjunta ray.tune.integration.ray_train.TuneReportCallback mediante el RunConfig(callbacks=[...]) de Train. Constrúyelo dentro de una sesión de Tune. La implementación 2.58.0 reenvía el diccionario de métricas del primer worker, sin promediar. Agrega una ruta de checkpoint existente a las métricas en lugar de cargar el checkpoint nuevamente.
Utiliza tune.RunConfig para Tuner y train.RunConfig para el Trainer. Mantén separadas sus configuraciones de fallos, almacenamiento y callbacks. Esta integración necesita conexión explícita y planificación de recursos.
Comprobaciones operativas de EKS
Inspecciona por separado la demanda de recursos/placement de Ray, los límites de los worker groups de KubeRay, la ubicación de Pods de Kubernetes y el suministro físico de nodos. Incluso con capacidad disponible, las descargas de imágenes, el acceso al dataset, la inicialización/comunicación del framework y los permisos de checkpoints pueden retrasar el inicio.
El autoscaling no proporciona GPUs instantáneas ni un límite automático de coste/finalización. Coordina la concurrencia de trials, los workers, las réplicas máximas, las clases de reintentos y los plazos operativos. Verifica la preservación de resultados/checkpoints antes de eliminar un RayJob o clúster.