Benchmark medido de ClickHouse en EKS
Entorno de prueba registrado: ClickHouse 24.8 (versión medida; la serie 24.x ya llegó al fin de vida, consulta la nota de versión en «Entorno de prueba»), Kubernetes 1.36 (Amazon EKS) Última actualización: 12 de octubre de 2026
Todos los informes de pruebas comparativas dicen que «ClickHouse es rápido», pero cuesta sorprendentemente encontrar cifras medidas en un nodo EKS normal con un volumen gp3 predeterminado. Este documento carga 100 millones de filas de registros de Kubernetes en un entorno deliberadamente modesto (un nodo de 4 vCPU y un volumen gp3 de 100 GiB con la configuración predeterminada) y mide el resultado. Son resultados históricos. Esta página no incluye el query_log original completo, todas las consultas exactas ni el estado de las cachés, así que no se garantiza que las cifras se repitan exactamente. En los ejemplos para nuevas ejecuciones que siguen, conserva las consultas SQL exactas, la configuración, las versiones y los resultados sin procesar.
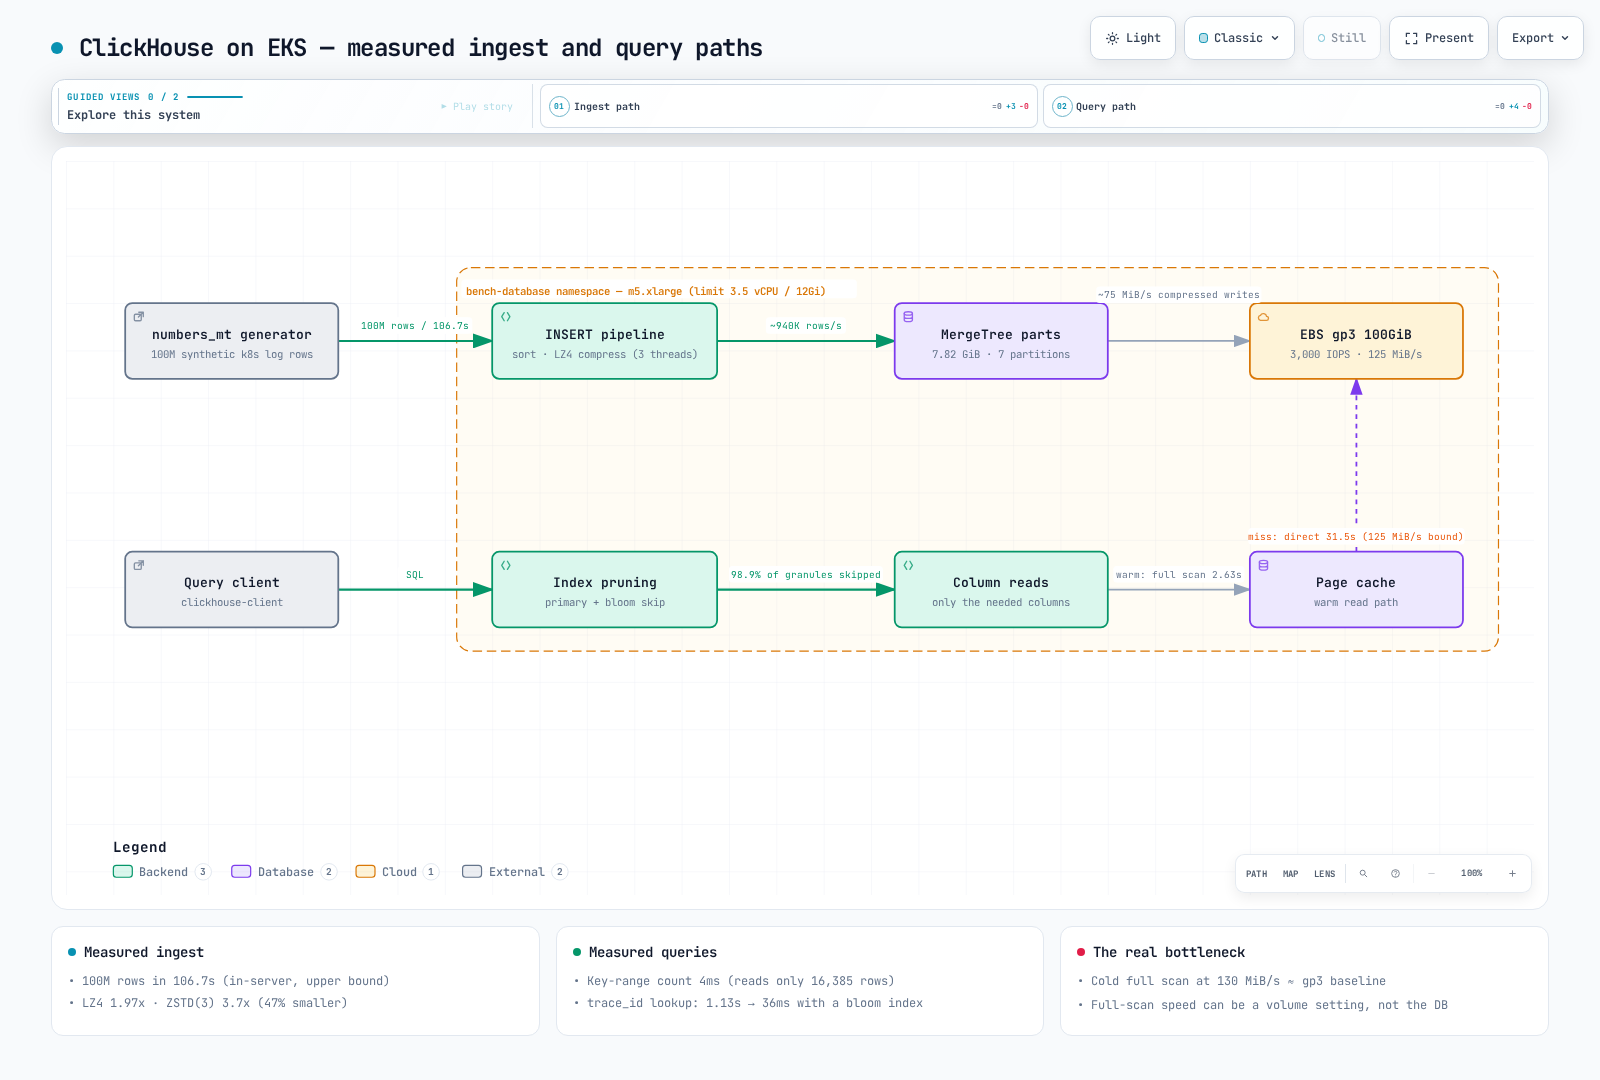
Resumen: resultados medidos
| Medición | Resultado |
|---|---|
| Ingesta (generación e inserción dentro del servidor) | 100 M de filas / 106.7 s = ~940 K filas/s |
| Tamaño de almacenamiento (LZ4 predeterminado) | 15.37 GiB → 7.82 GiB (1.97×) |
| Tamaño de almacenamiento (ZSTD(3)) | 15.37 GiB → 4.16 GiB (3.7×), un 47 % menos que con LZ4 |
| Conteo en rango de clave ORDER BY (ventana de 1 hora) | 4 ms (cuenta 59,916 filas y solo lee 16,385 de 100 M) |
| Conteo de ERROR por Pod con GROUP BY (ventana de 2 días) | 0.36 s (se recorren 28 M de filas) |
Recorrido completo con LIKE '%timeout%' | caché caliente 2.63 s / se solicita Direct I/O 31.5 s (12×) |
| Búsqueda puntual por trace_id | recorrido completo 1.13 s → 0.036 s con índice bloom filter (31×) |
Entorno de prueba
| Elemento | Valor |
|---|---|
| Clúster | Amazon EKS, Kubernetes 1.36, ap-northeast-2 |
| Nodo | m5.xlarge (4 vCPU, 16 GiB), un nodo dedicado aprovisionado por Karpenter (el Pod de prueba se ejecutó solo en ese nodo) |
| Recursos del Pod | requests 2.5 vCPU / 9 Gi, limits 3.5 vCPU / 12 Gi |
| Almacenamiento | EBS gp3 de 100 GiB, configuración predeterminada (3,000 IOPS / 125 MiB/s de referencia), controlador EBS CSI |
| ClickHouse | imagen oficial clickhouse/clickhouse-server:24.8 (24.8.14.39), configuración predeterminada |
| Costo por hora | m5.xlarge bajo demanda: $0.236/h + gp3 de 100 GiB a $0.0912/GB-mes (región de Seúl; consulta a Pricing API, 2026-09) |
Nota de versión. 24.8 era la versión LTS usada al realizar la medición, pero la política de seguridad de ClickHouse ya no incluye ninguna versión 24.x entre las compatibles (al 12 de octubre de 2026, las ramas compatibles son 26.9, 26.8 LTS, 26.7 y 26.3 LTS). Para proyectos nuevos, usa una etiqueta LTS actual. Los mecanismos medidos a continuación (poda por clave principal, códecs LZ4/ZSTD e índices skip bloom filter) también están presentes en las versiones actuales, pero vuelve a medir con la versión que implementes antes de usar estas cifras para dimensionar.
El entorno es deliberadamente sencillo. La pregunta de esta prueba no es «¿qué velocidad alcanza ClickHouse en una instancia i con NVMe dedicada?», sino «¿hasta dónde llegas con el tipo de nodo de uso general y el volumen gp3 predeterminado que ya tiene tu clúster?»
Manifiesto de implementación
Este ejemplo de nueva ejecución usa la versión LTS compatible 26.3.33.24; las mediciones históricas de 24.8 no cambian. Se requiere aprovisionamiento normal de EC2 EBS CSI/IAM y PVC. Conserva la restricción de red del usuario predeterminado y ejecuta la prueba con un cliente localhost dentro de kubectl exec. Registra el digest de la imagen, la configuración de EBS y el uso real de CPU/memoria.
apiVersion: v1
kind: Namespace
metadata:
  name: bench-database
---
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: bench-clickhouse-gp3
provisioner: ebs.csi.aws.com
parameters:
  type: gp3
  encrypted: "true"
  iops: "3000"
  throughput: "125"
volumeBindingMode: WaitForFirstConsumer
reclaimPolicy: Delete
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: clickhouse-data
  namespace: bench-database
spec:
  accessModes: ["ReadWriteOnce"]
  storageClassName: bench-clickhouse-gp3
  resources:
    requests:
      storage: 100Gi
---
apiVersion: v1
kind: Pod
metadata:
  name: clickhouse
  namespace: bench-database
  annotations:
    karpenter.sh/do-not-disrupt: "true"
spec:
  nodeSelector:
    node.kubernetes.io/instance-type: m5.xlarge
  containers:
    - name: clickhouse
      image: clickhouse/clickhouse-server:26.3.33.24
      resources:
        requests: { cpu: "2500m", memory: 9Gi }
        limits: { cpu: "3500m", memory: 12Gi }
      readinessProbe:
        exec:
          command: ["clickhouse-client", "--host", "127.0.0.1", "--query", "SELECT 1"]
        initialDelaySeconds: 5
        periodSeconds: 5
      volumeMounts:
        - name: data
          mountPath: /var/lib/clickhouse
  volumes:
    - name: data
      persistentVolumeClaim:
        claimName: clickhouse-data
Para automatizar el ciclo de vida y la recuperación en producción, una opción es usar un
ClickHouseInstallationadministrado por clickhouse-operator de Altinity, en lugar de un Pod independiente. Aquí, un Pod independiente mantiene simple el objeto de medición.
Conjunto de datos: 100 millones de filas realistas de registros de Kubernetes
Los datos aleatorios uniformes (generateRandom) distorsionan las relaciones de compresión; por eso, las filas se generan como los registros reales: plantillas repetidas y campos variables, con 10 espacios de nombres, un nombre de Pod por espacio de nombres (el sufijo del Pod se obtiene mediante hash del mismo grupo que determina el espacio de nombres, por lo que solo hay 10 valores distintos de Pod; esta simplificación influye en las cifras de compresión, consulta la Medición 2), una tasa de ERROR del 0.8 % y marcas de tiempo que abarcan 7 días.
CREATE TABLE logs
(
  timestamp   DateTime64(3),
  namespace   LowCardinality(String),
  pod         String,
  container   LowCardinality(String),
  level       LowCardinality(String),
  message     String,
  trace_id    String,
  duration_ms Float32
)
ENGINE = MergeTree
PARTITION BY toDate(timestamp)
ORDER BY (namespace, timestamp);INSERT INTO logs (timestamp, namespace, pod, container, level, trace_id, duration_ms, message)
WITH
['payment','order','user','search','catalog','cart','shipping','auth','gateway','recommend'] AS nss,
['GET /api/v1/orders','POST /api/v1/payments','GET /api/v1/users','GET /api/v1/search',
'POST /api/v1/cart/items','GET /api/v1/products','POST /api/v1/shipments','POST /oauth/token',
'GET /healthz','GET /api/v1/recommendations'] AS eps
SELECT
toDateTime64('2026-08-25 00:00:00', 3) + toIntervalMillisecond(number * 6) AS timestamp,
nss[(cityHash64(number) % 10) + 1] AS namespace,
concat(namespace, '-7c7dd4f9c-', substring(lower(hex(sipHash64(cityHash64(number) % 10))), 1, 5)) AS pod,
if(cityHash64(number + 2) % 10 < 8, 'app', 'istio-proxy') AS container,
multiIf(cityHash64(number + 3) % 1000 < 8, 'ERROR',
cityHash64(number + 3) % 1000 < 50, 'WARN',
cityHash64(number + 3) % 1000 < 300, 'DEBUG', 'INFO') AS level,
lower(hex(sipHash128(number))) AS trace_id,
round(if(level = 'ERROR', 2000 + (cityHash64(number + 4) % 30000) / 10,
(cityHash64(number + 4) % 20000) / 100), 1) AS duration_ms,
multiIf(
level = 'ERROR', concat('upstream request timeout after ', toString(round(duration_ms)),
'ms endpoint=', eps[(cityHash64(number + 5) % 10) + 1],
' status=503 trace_id=', trace_id),
concat(eps[(cityHash64(number + 5) % 10) + 1], ' completed status=200 in ',
toString(duration_ms), 'ms trace_id=', trace_id)
) AS message
FROM numbers_mt(100000000)
SETTINGS max_threads = 3, max_insert_threads = 2, max_memory_usage = 9000000000;Medición 1. Ingesta: 100 M de filas en 106.7 segundos
Elapsed: 106.747 sec → ~936,800 rows/s, 7 daily partitions, 36 active partsInterpreta esta cifra dentro de su contexto. Las filas se generaron dentro del servidor y se insertaron directamente (INSERT…SELECT), así que no se incluyen la transferencia de red ni el análisis del texto; se mide una ruta dentro del servidor. También incluye el trabajo de CPU para generar los datos, así que no representa un límite matemático para la ingesta externa. El cliente, el formato, la red, el procesamiento por lotes y la concurrencia pueden cambiar el rendimiento externo en cualquiera de los dos sentidos. Aun así, la cifra principal es real: con un límite de 3.5 vCPU, ClickHouse ordenó, comprimió y escribió unas 940 K filas por segundo en un volumen gp3 predeterminado de 125 MiB/s. El tamaño final comprimido dividido por el tiempo transcurrido equivale a unos 75 MiB/s; no es una medición de la velocidad física de escritura en EBS. Comprueba por separado la caché de páginas/escritura diferida, las fusiones y las condiciones de vaciado duradero.
Medición 2. Compresión: qué columnas consumen el almacenamiento
En total: 15.37 GiB → 7.82 GiB (1.97×, LZ4 predeterminado). El desglose por columna resulta mucho más interesante:
| Columna | Comprimido | Sin comprimir | Relación |
|---|---|---|---|
| message | 3.97 GiB | 8.75 GiB | 2.2× |
| trace_id | 3.08 GiB | 3.07 GiB | 1.0× (no compresible) |
| timestamp | 404.07 MiB | 762.94 MiB | 1.89× |
| duration_ms | 289.17 MiB | 381.47 MiB | 1.32× |
| level | 45.88 MiB | 95.72 MiB | 2.09× |
| container | 39.27 MiB | 95.72 MiB | 2.44× |
| pod | 9.32 MiB | 2.15 GiB | 236× |
| namespace | 488.63 KiB | 95.72 MiB | 201× |
Los tamaños y las relaciones coinciden exactamente con los valores informados por system.parts_columns (suma de bytes comprimidos/sin comprimir con formatReadableSize); las relaciones se calculan con los recuentos de bytes sin redondear, no con los tamaños mostrados.
Se destacan dos conclusiones:
- LowCardinality y la localidad de ORDER BY tienen un efecto enorme: namespace es la primera clave ORDER BY, así que los valores idénticos aparecen en secuencias largas: 95.7 MiB se reducen a 489 KiB. pod se comprime 236× por el mismo motivo, con una salvedad: este generador produce exactamente un nombre de Pod por espacio de nombres (10 valores distintos), así que pod se comporta como una segunda copia de namespace. En un clúster real, con decenas de Pods por espacio de nombres y nombres nuevos en cada reinicio, pod se comprimirá bastante menos.
- Los ID de alta entropía consumen cerca del 40 % del almacenamiento: en esta ejecución, LZ4 apenas comprimió trace_id (cadena hexadecimal de 32 caracteres; 1.0×), que ocupa 3.08 GiB de los 7.82 GiB totales (39.4 %). Al diseñar un esquema de registros, «¿guardamos los ID como cadenas?» es la decisión que más influye en el costo de almacenamiento. La codificación hexadecimal representa cuatro bits de información por byte, así que otros códecs aún pueden aprovechar oportunidades de compresión. La representación binaria UUID/FixedString(16) reduce el ancho original, pero mide el almacenamiento final y evalúa los efectos en códecs e índices y la compatibilidad con las consultas.
LZ4 frente a ZSTD(3): 47 % menos almacenamiento y recorridos 1.9× más lentos
Se volvió a insertar el mismo conjunto de datos en una tabla CODEC(ZSTD(3)):
| LZ4 (predeterminado) | ZSTD(3) | |
|---|---|---|
| Tamaño comprimido | 7.82 GiB (1.97×) | 4.16 GiB (3.7×) |
| Inserción con recompresión (100 M de filas) | - | 120.0 s |
Recorrido completo con LIKE '%timeout%' (caché caliente) | 2.63 s | 4.9 s |
El almacenamiento disminuye un 47 %, pero el recorrido completo limitado por CPU se ralentiza 1.9×. Usar LZ4 para los datos activos y recompresión mediante TTL con ZSTD es una opción que conviene evaluar. El mejor códec depende de los datos reales y de las limitaciones de CPU y E/S.
Medición 3. Consultas: qué es rápido, qué es lento y por qué
Cada consulta se ejecutó tras vaciar las cachés de marcas/datos sin comprimir: ① una vez con min_bytes_to_use_direct_io=1 para omitir la caché de páginas (solicitud de Direct I/O); ② tres ejecuciones con caché caliente (se informa el mínimo).
| # | Patrón de consulta | Directo desde disco | Caché caliente | Filas leídas (read_rows) |
|---|---|---|---|---|
| Q1 | WHERE namespace='payment' AND timestamp BETWEEN … (conteo de 1 hora) | 13 ms | 4 ms | 16,385 (0.016 %); resultado: 59,916 |
| Q2 | Conteo de ERROR por Pod, GROUP BY de 2 días (LIMIT 10 no supone una restricción real aquí: el conjunto solo tiene 10 Pods) | 0.57 s | 0.36 s | 28 M |
| Q3 | Recorrido completo de todo el rango con message LIKE '%timeout%' | 31.5 s | 2.63 s | 100 M |
| Q4 | p50/p99 de duration por espacio de nombres, rango completo | 1.34 s | 1.03 s | 100 M (sin filtro) |
| Q5 | Búsqueda puntual de trace_id = '…' (sin índice) | 24.3 s | 1.13 s | 100 M |
Cómo interpretar estas cifras:
- Por qué Q1 tarda 4 ms: PARTITION BY (día) y ORDER BY (namespace, timestamp) coinciden, de modo que la ventana de una hora para
paymentforma un único rango continuo de claves. La consulta cuenta 59,916 filas, perosystem.query_logmuestra solo 16,385 filas leídas: desde ClickHouse 24.6, el índice permite contar directamente los granules que quedan por completo dentro del rango de clave principal y descomprimir solo los granules parciales de los extremos (unos dos granules de 8,192 filas). Comprueba conEXPLAIN indexes = 1y el valor real de read_rows si se aplica esta optimización; no se aplica incondicionalmente a todas las consultas de conteo. - Q3: 31.5 s (lectura directa) frente a 2.63 s (caché caliente): leer del disco la columna message comprimida (~4 GiB) equivale a 4 GiB ÷ 31.5 s ≈ 130 MiB/s, justo en la estrecha franja entre el límite del volumen gp3 (125 MiB/s) y la capacidad de EBS de referencia de esta m5.xlarge (1,150 Mbps ≈ 137 MiB/s); estos dos límites están demasiado cerca para determinar cuál se alcanzó primero en esta ejecución. Al servir la misma consulta desde la caché de páginas, pasa a estar limitada por CPU (~38 M filas/s). Es una prueba medida de que el rendimiento de un recorrido completo puede depender de la configuración del rendimiento del volumen, no de una propiedad de la base de datos. (Consulta la prueba comparativa de EBS gp2 frente a gp3). La ejecución de Q5 sin índice cuenta la misma historia: 3.08 GiB de trace_id en 24.3 s ≈ 130 MiB/s.
- Por qué Q4 recorre 100 M de filas en aproximadamente 1 s: es un ejemplo puro de almacenamiento columnar. Según el tamaño de las columnas, solo accede a duration_ms (289 MiB) y namespace (0.5 MiB), no a los 7.8 GiB; la ejecución con caché caliente está limitada por CPU al calcular cuantiles Float32 sobre 100 M de valores.
- Las mediciones breves de Q2/Q4 no aíslan el rendimiento físico del disco. Una relación entre el tamaño final y el tiempo superior a 125 MiB/s no demuestra por sí sola que se haya encontrado un acierto en la caché de páginas. Vaciar las cachés de marcas/datos sin comprimir tampoco vacía la caché de páginas del sistema operativo. La ejecución original terminó antes de rastrear los efectos de caché, método de lectura y ventanas cortas; en nuevas ejecuciones, conserva los ProfileEvents de query_log junto con las métricas de E/S del nodo/EBS.
Medición 4. Índice skip bloom filter: de 1.13 s a 0.036 s
La clave ORDER BY no incluye las búsquedas puntuales por trace_id, que por eso requieren recorrer todos los datos (1.13 s) de forma predeterminada. Añade un índice skip:
ALTER TABLE logs ADD INDEX trace_bf trace_id TYPE bloom_filter(0.01) GRANULARITY 4;
ALTER TABLE logs MATERIALIZE INDEX trace_bf; -- asynchronous; wait for system.mutations.is_done| Sin índice | bloom_filter(0.01) | |
|---|---|---|
| Tiempo de búsqueda con caché caliente | 1.13 s | 0.036 s (31×) |
| Filas leídas | 100 M | 1.08 M (se omite el 98.9 %) |
| Datos leídos | 3.82 GiB | 42.6 MiB |
| Tamaño del índice | - | 119.7 MiB (1.5 % de la tabla) |
«Ir directamente a un trace ID» es la consulta más habitual en un almacén de registros de observabilidad. Cuesta un 1.5 % más de almacenamiento y 20 segundos de materialización, a cambio de acelerar la búsqueda 31×. Si ejecutas Grafana con un backend de registros ClickHouse, evalúa este índice con la selectividad real, los falsos positivos, los costos de escritura y fusión y los planes de consulta.
En términos de costos
La consulta a Pricing API del 11 de septiembre de 2026 confirma que Linux m5.xlarge bajo demanda cuesta $0.236/h en Seúl y gp3 cuesta $0.0912/GB-mes. EBS factura la capacidad aprovisionada. Tanto si el conjunto de datos ocupa 7.82 como 4.16 GiB, el volumen de 100 GiB de este ejemplo cuesta $9.12 al mes; $0.71/$0.38 calculados con los bytes usados no representan la factura real del volumen.
Con 100 M de filas al día durante 30 días, esta relación de compresión sintética con LZ4 implica unos 235 GiB solo para los datos. No cabe en el volumen de ejemplo de 100 GiB. Al dimensionar, agrega espacio de trabajo para fusiones, índices, réplicas, copias de seguridad y margen adicional. Aprovisionar solo 235 GiB cuesta unos $21.43 al mes, sin contar nodos, EKS, redes ni operaciones. Comparar únicamente el almacenamiento de EBS con la ingesta de CloudWatch Logs no demuestra que el costo total sea inferior.
Cómo reproducir la prueba
Estos ejemplos sirven para comparar patrones en una nueva ejecución. No se conservan aquí las ventanas exactas de las consultas Q1/Q2 ni el ID de Q5 del experimento histórico, así que no se afirma que reproduzcan la cantidad de filas o los tiempos originales. Guarda juntos el SQL exacto, las versiones, la zona horaria, la configuración de lectura y los resultados sin procesar.
-- Q1: explicit example window for a new run, not recovered historical SQL.
SELECT count() FROM logs
WHERE namespace = 'payment'
  AND timestamp >= toDateTime64('2026-08-26 00:00:00', 3)
  AND timestamp < toDateTime64('2026-08-26 01:00:00', 3);

-- Q2: a two-day example window.
SELECT namespace, pod, count() AS errors FROM logs
WHERE level = 'ERROR'
  AND timestamp >= toDateTime64('2026-08-26 00:00:00', 3)
  AND timestamp < toDateTime64('2026-08-28 00:00:00', 3)
GROUP BY namespace, pod ORDER BY errors DESC LIMIT 10;

-- Q3: full-range message scan.
SELECT count() FROM logs WHERE message LIKE '%timeout%';

-- Q4: approximate quantiles; all candidate rows are still processed.
SELECT namespace, quantiles(0.5, 0.99)(duration_ms) AS p50_p99
FROM logs GROUP BY namespace;

-- Q5: a trace ID that the generator creates for number=42.
SELECT * FROM logs
WHERE trace_id = lower(hex(sipHash128(toUInt64(42))));kubectl apply -f clickhouse.yaml
kubectl wait -n bench-database pod/clickhouse --for=condition=Ready --timeout=300s
kubectl exec -n bench-database clickhouse -- \
clickhouse-client --host 127.0.0.1 --query 'SELECT version(), timezone()'
# Save the CREATE TABLE block as schema.sql and INSERT block as insert.sql.
kubectl exec -i -n bench-database clickhouse -- \
clickhouse-client --host 127.0.0.1 --multiquery < schema.sql
kubectl exec -i -n bench-database clickhouse -- \
clickhouse-client --host 127.0.0.1 --time --multiquery < insert.sql
# Run the selected query with a unique ID; store its exact SQL with the results.
kubectl exec -i -n bench-database clickhouse -- \
clickhouse-client --host 127.0.0.1 --query_id benchmark-q3-run1 \
--time --multiquery < q3.sqlPara solicitar Direct I/O, agrega SETTINGS min_bytes_to_use_direct_io=1 a ese SELECT. Repite la prueba con la configuración de lectura predeterminada y conserva todas las muestras y la mediana, no solo el mínimo. Después de SYSTEM FLUSH LOGS, exporta las filas correspondientes de query_log; antes de comparar, espera a que se materialice el índice en system.mutations. Registra también las condiciones de las cachés de consultas, del sistema de archivos y del sistema operativo, así como las fusiones en segundo plano.
Exporta los resultados fuera del clúster antes de eliminar el espacio de nombres dedicado bench-database y StorageClass bench-clickhouse-gp3. La política de recuperación Delete del ejemplo elimina los datos de prueba junto con el PVC.
Limitaciones
- Un único nodo y una sola ejecución. Los valores absolutos variarán si se usa replicación o fragmentación, o con otros tipos de instancia. Lo que puede trasladarse son los patrones relativos: poda, almacenamiento columnar, efectos de caché y efectos de los índices.
- La cifra de ingesta mide la generación e inserción dentro del servidor, no el rendimiento de la recopilación externa (consulta la Medición 1).
- Las relaciones de compresión de datos sintéticos dependen de la composición de los campos. Incluir trace_id, de alta entropía, dentro de message hace que esta medición sea conservadora; en cambio, la columna pod (solo 10 nombres distintos; consulta la Medición 2) produce una estimación optimista. Los registros reales pueden comprimirse mejor o peor, según el esquema.
- La primera ejecución con caché caliente es más lenta mientras se llena la caché (Q3: 8.7 s al principio y después 2.6 s). En las tablas se informa el mínimo de tres ejecuciones con caché caliente.
Lecturas relacionadas
- ClickHouse como backend de registros: integración con pipelines de recopilación (Fluent Bit/Vector)
- Prueba medida de EBS gp2 frente a gp3: límites de rendimiento del volumen y de la instancia, relevantes para interpretar Q3
- Introducción a bases de datos en Kubernetes: panorama de operadores y criterios para elegir entre servicios administrados y autogestionados