Parte 4: Ray Serve
Base de la revisión: Ray 2.58.0 · KubeRay 1.7.0 · 2026-09-12
Entorno y alcance de la validación
Se comprobó un pequeño ejemplo de respuesta en CPU con Python 3.12 y ray[serve]==2.58.0. En este entorno, el módulo de HAProxy importaba Jinja2 aunque la instalación del extra no lo había proporcionado; añadir explícitamente Jinja2==3.1.6 corrigió la importación. Otros entornos pueden tenerlo ya a través de otra dependencia.
El extra ray[llm] añade dependencias de inferencia de gran tamaño como vLLM. No se instaló aquí, y no se ejecutaron pesos de modelo, GPU ni cargas de trabajo en EKS. La validación siguiente cubre la configuración de Serve, las respuestas HTTP y las llamadas mediante DeploymentHandle.
Deployments, applications y rutas de las solicitudes
Un Deployment de Serve administra réplicas de actors; es distinto de un Deployment de Kubernetes. Varios actors de réplica pueden ubicarse en un mismo Pod de Ray, por lo que el número de réplicas y el de Pods no son intercambiables.
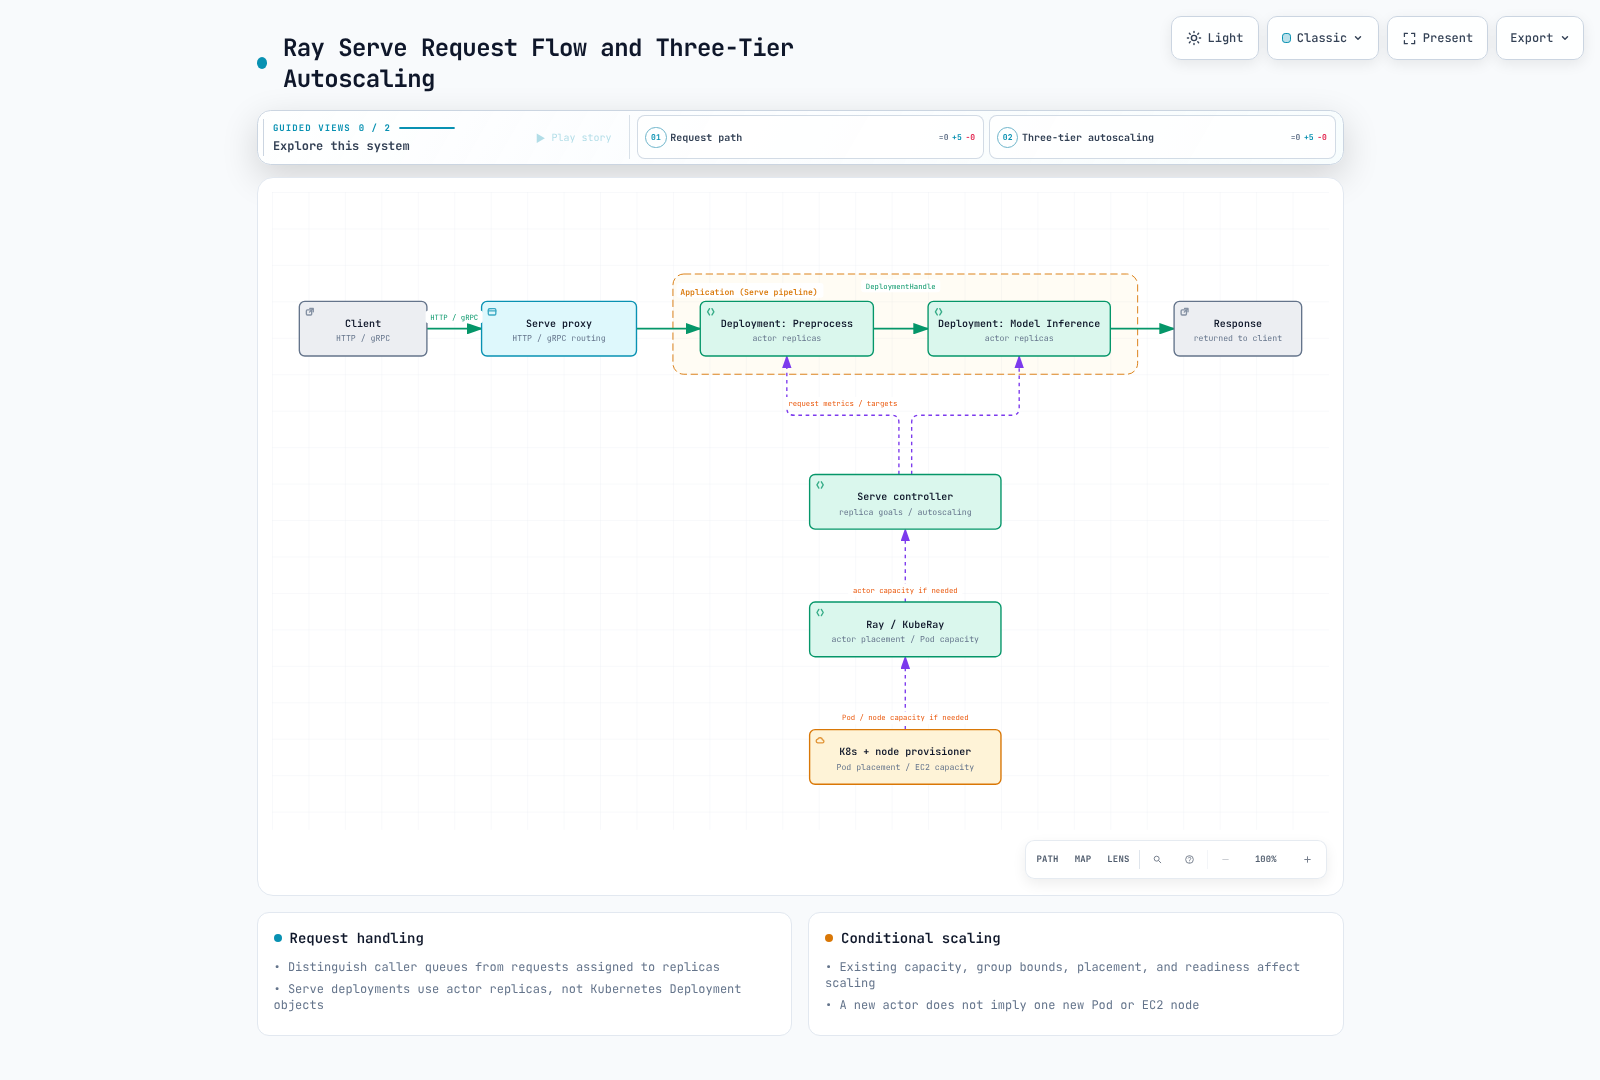
Una Application (aplicación) contiene uno o varios deployments y un deployment de ingress. Los DeploymentHandles pueden conectar el preprocesamiento y la inferencia sin que cada llamada interna atraviese HTTP ni sea necesario crear un Service de Kubernetes por deployment.
El Controller administra el estado de control de Serve y los ciclos de vida de los actors. Los proxies reciben tráfico HTTP/gRPC y lo reenvían a los deployments. La ubicación predeterminada del proxy en 2.58.0 es EveryNode en los nodos que alojan réplicas. HeadOnly y Disabled pueden seleccionarse explícitamente. El valor predeterminado de solo head de una página de arquitectura más antigua no debe prevalecer sobre el contrato actual de la API.
Distingue las colas de los llamadores en los proxies/handles de las solicitudes en curso asignadas a las réplicas. Revisa los handlers síncronos/asíncronos, el trabajo bloqueante, los timeouts y el comportamiento de cancelación en la aplicación.
Pequeño ejemplo local de HTTP/Handle
Esto valida las API de respuesta en lugar de la inferencia de modelos. La comprobación real utilizó un puerto de loopback privado disponible y confirmó HTTP 200 y double(4) == 8.
import requests
import ray
from ray import serve

try:
    ray.init(address="local", num_cpus=2, include_dashboard=False,
             object_store_memory=80 * 1024 * 1024)
    serve.start(proxy_location="HeadOnly",
                http_options={"host": "127.0.0.1", "port": 18080})

    @serve.deployment(num_replicas=1,
                      ray_actor_options={"num_cpus": 1},
                      max_ongoing_requests=2, max_queued_requests=4)
    class Echo:
        async def __call__(self, request):
            return {"echo": request.query_params.get("value", "")}
        def double(self, value):
            return value * 2

    handle = serve.run(Echo.bind(), name="echo", route_prefix="/echo")
    response = requests.get("http://127.0.0.1:18080/echo",
                            params={"value": "fixture"}, timeout=15)
    assert response.status_code == 200
    assert response.json() == {"echo": "fixture"}
    assert handle.double.remote(4).result(timeout_s=15) == 8
finally:
    serve.shutdown()
    ray.shutdown()
Ejecútalo en un proceso de ejercicio separado con el puerto 18080 disponible. Los recursos lógicos de Ray y el tamaño del object store no son límites de memoria/CPU del sistema operativo para todo el proceso. serve.shutdown() detiene la instancia de Serve conectada; no uses la limpieza de este ejemplo contra un clúster de producción compartido.
Réplicas, autoscaling y backpressure
Distingue estos valores predeterminados verificados de 2.58.0:
| Configuración | Valor o significado |
|---|---|
| Deployment predeterminado | una réplica, autoscaling sin configurar |
num_replicas="auto" | aplica mín. 1, máx. 100, objetivo de solicitudes en curso 2 |
AutoscalingConfig() directo | mín. 1, máx. 1; omitir el máximo restringe la expansión |
max_ongoing_requests | solicitudes enviadas a una réplica sin respuesta; predeterminado 5 |
max_queued_requests | límite de cola en cada llamador (proxy/handle); predeterminado -1, ilimitado |
| Retardo de escalado | predeterminado: 30 segundos al escalar hacia arriba/600 segundos hacia abajo; no es la latencia real de readiness |
El objetivo de autoscaling observa la carga de solicitudes; es distinto del máximo de solicitudes en curso y de un límite global de cola. Superar los límites de cola puede generar un BackPressureError en los handles o devolver HTTP 503 de forma predeterminada. La configuración de backpressure puede personalizar la respuesta HTTP.
Ajusta en conjunto el mín./máx., las ventanas/retardos de medición, los arranques en frío, la carga de modelos, el batching y el tiempo real de procesamiento. Escalar a cero con min_replicas=0 no elimina la latencia de reinicio. Un número deseado de réplicas no garantiza que todas las réplicas estén listas.
Capas de control en EKS
- Serve ajusta los objetivos de réplicas del deployment a partir de la carga de solicitudes y de la política.
- Ray ubica los actors/bundles; el autoscaling de Ray habilitado y KubeRay pueden ajustar la capacidad de los Pods de worker.
- Kubernetes ubica los Pods y un provisioner como Karpenter suministra capacidad de nodos cuando es necesario.
Un actor pendiente no se convierte automáticamente en un Pod Pending ni en un nodo EC2. Los Pods de Ray existentes pueden ganar capacidad libre, o los límites de grupo, la ubicación y las cuotas pueden impedir el avance. Inspecciona la demanda y el estado de readiness en cada capa.
Inferencia en GPU y Ray Serve LLM
Las réplicas de GPU ordinarias utilizan opciones de recursos de Ray como ray_actor_options. Alinea los dispositivos, los drivers, los límites del Pod y la precedencia de los recursos estructurados de Ray/rayStartParams. Como explica la Parte 2, los límites del Pod no siempre son el único valor configurado.
API como LLMConfig y build_openai_app proporcionan una capa de configuración de LLM independiente. La documentación y el paquete de 2.58.0 muestran backends de vLLM y SGLang. Las dependencias verificadas de ray[llm] incluyen vllm[audio]==0.26.0 y paquetes NIXL; esto no implica que también estén instaladas todas las dependencias de SGLang.
Distingue model_loading_config, deployment_config, engine_kwargs y server_cls. Comprueba los campos específicos del motor y las combinaciones admitidas en lugar de suponer que toda opción de la CLI vllm serve se transfiere sin cambios. Los backends pueden diferir en los nombres de las opciones de tensor-parallel y en la ubicación de los workers. Algunas API están en beta, y las rutas más antiguas de LLMServer/LLMRouter tienen avisos de deprecación.
Valida por separado el acceso al modelo, la revisión, las descargas de pesos, la compatibilidad del motor/CUDA/driver, la caché KV y los recursos de paralelismo de tensores/pipeline. Un formato de solicitud compatible con OpenAI no establece autenticación, seguridad ni una cobertura de características idéntica. La comprobación de Echo en CPU no demuestra el rendimiento ni la compatibilidad de LLM.
RayService y actualizaciones operativas
RayService es una opción para la administración declarativa del ciclo de vida de las aplicaciones de Serve y de los RayClusters en EKS, no un requisito universal para toda implementación en producción. Distingue los cambios de configuración de la aplicación de los cambios del clúster, y NewCluster de las estrategias de actualización incremental basadas en Gateway.
La feature gate incremental habilitada de KubeRay 1.7 aún requiere Gateway APIs/implementación, capacidad libre, readiness y condiciones de drenaje. Prueba las solicitudes en streaming y de larga duración frente a los límites de apagado. No describas toda actualización como una pérdida de solicitudes garantizada de cero.
Las opciones de arranque con alcance de clúster, como las opciones HTTP, tienen límites de actualización dinámica. Los cambios en un deployment pueden ser una reconfiguración ligera o el reemplazo de actors. Las réplicas reiniciadas o reemplazadas asumen los costes de inicialización del modelo y de recuperación del estado.
Control de acceso y límites
Restringe por separado los puntos de entrada de la API/dashboard/cliente, el acceso a los artefactos del modelo y el acceso de los usuarios de la aplicación. Los tokens del clúster de Ray y ClusterIP no implementan automáticamente autenticación/autorización para todos los endpoints de Serve. Revisa las entradas, respuestas, prompts y logs sensibles, y configura límites de cola, timeout y recursos.
Las comprobaciones de aquí cubren la configuración/los decoradores nativos y una aplicación HTTP/Handle mínima de un solo nodo. No se realizaron pruebas de carga de autoscaling, ejecución de GPU/LLM, failover multinodo ni despliegues de RayService.