Análisis profundo de Flink en EKS
Apache Flink es un motor distribuido con estado para flujos acotados y no acotados. Los JobManagers coordinan la ejecución y la recuperación; los TaskManagers ejecutan las tareas de los operadores e intercambian datos. La coherencia de los checkpoints y el comportamiento exactly-once en un sink externo tienen requisitos distintos. La parte 3 examina conjuntamente las fuentes, el estado y los sinks.
Última actualización: 12 de septiembre de 2026 Línea base de integración: Flink 2.2.1 / Java 17 / Operator 1.15.0.
El ejemplo de Iceberg de la parte 3 usa por separado Flink 2.1.3 / Iceberg 1.11.0 para coincidir con su runtime. Consulte las limitaciones de cada capítulo sobre la compatibilidad del SDK del plugin de S3 y las diferencias entre servicios administrados.
La versión estable más reciente de Flink es la 2.3.0. Estos ejemplos usan la 2.2.1 como línea base y deben verificarse frente a las tablas publicadas de compatibilidad de Operator y conectores. Que un CRD acepte una cadena de versión en un enum no demuestra que exista compatibilidad de integración. Elija las versiones de Kubernetes/kubectl según el soporte actual de EKS y las políticas de desfase de versiones; «Kubernetes 1.21+» no garantiza que esa versión tenga soporte vigente en EKS.
¿Quién gestiona qué en Kubernetes?
- FlinkDeployment define un clúster Application o Session.
- FlinkSessionJob define un trabajo enviado a un clúster Session administrado que ya existe.
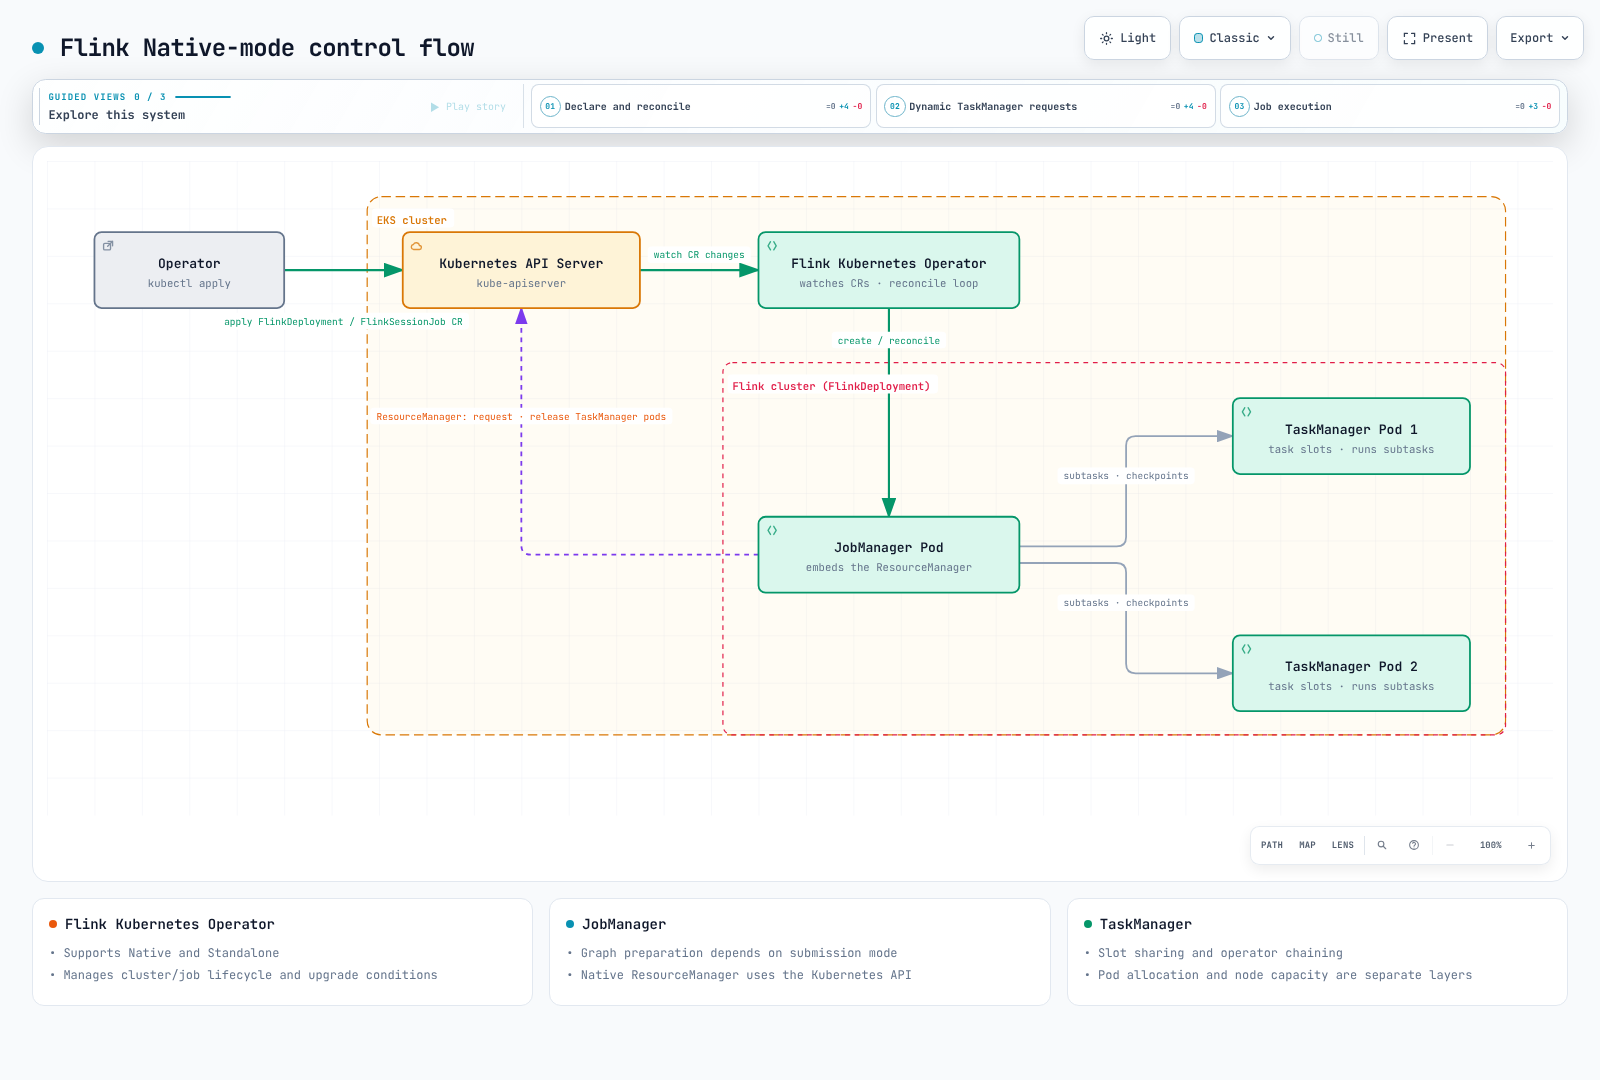
- El Operator reconcilia el ciclo de vida del clúster y del trabajo, y admite los modos Native y Standalone.
- En el modo Native, el Kubernetes ResourceManager del JobManager solicita y libera pods de TaskManager. En el modo Standalone, un administrador externo, como el Operator, gestiona los recursos de Kubernetes.
- Un task slot no equivale a un núcleo de CPU ni exactamente a una subtarea del operador. El encadenamiento y el uso compartido de slots pueden colocar varios operadores en un slot; dimensione el estado, la memoria y la CPU por separado.
El siguiente diagrama muestra el flujo lógico de control en el modo Native. La liberación de pods depende de los tiempos de espera por inactividad, las necesidades de capacidad y la política de limpieza; completar un trabajo no elimina de inmediato los costos de los nodos.
Capítulos
- Arquitectura: procesos, uso compartido de slots y los ejes Application/Session y Native/Standalone.
- Flink Kubernetes Operator: CRD, instalación, actualizaciones y escalado automático.
- Estado, checkpoints y streaming: backends, recuperación y garantías reales de los conectores.
- Operaciones y alta disponibilidad: métricas, almacenamiento de alta disponibilidad, capacidad de nodos y comparación de servicios administrados.
La gestión declarativa con Operator es el enfoque principal de esta guía; los ejemplos de CLI explican el runtime subyacente. Ejecutar Flink sin Operator sigue siendo una opción compatible.