Amazon OpenSearch Service
Última actualización: September 13, 2026 Línea base del ejemplo: OpenSearch Service 3.5 aprovisionado; Terraform 1.15.7/proveedor de AWS 6.64.0; AWS for Fluent Bit 3.4.15 (Fluent Bit 5.0.9). Solo comprobaciones de configuración locales; no se implementó ningún dominio, recopilador, sesión SAML ni prueba de entrega de datos.
Amazon OpenSearch Service administra clústeres de búsqueda y admite versiones seleccionadas de OpenSearch y Elasticsearch OSS heredado. Este capítulo cubre un dominio VPC y los niveles tradicionales hot/UltraWarm/cold. Las colecciones Serverless y las opciones más recientes de almacenamiento en instancias optimizadas tienen requisitos independientes de configuración, API y disponibilidad.
Descripción general
OpenSearch es un proyecto de búsqueda con licencia Apache-2.0. Su linaje de Elasticsearch 7.10 no implica compatibilidad con todos los clientes, plugins o API actuales de Elasticsearch. Las decisiones actuales de licencia de código fuente de Elastic incluyen AGPLv3 para partes de código fuente elegibles junto con SSPL/Elastic License 2.0; compruebe el componente y la distribución exactos en vez de tratar Elasticsearch como un único modelo de licenciamiento sin cambios.
La tabla de soporte de AWS actualmente enumera OpenSearch 3.5 entre las versiones admitidas. El ejemplo anterior de 2.11 sigue bajo soporte estándar hasta el 7 de noviembre de 2027; no deja de ser compatible simplemente porque exista una versión más reciente. Para un dominio existente, compruebe las rutas de actualización admitidas, los cambios incompatibles, las snapshots y la compatibilidad del cliente antes de solicitar una actualización de versión.
OpenSearch Service puede admitir análisis de logs, búsqueda de texto completo, agregaciones y flujos de trabajo de análisis de seguridad. Habilitar un servicio o conservar logs de auditoría no satisface por sí mismo un requisito de conformidad.
Arquitectura
Arquitectura del clúster de OpenSearch
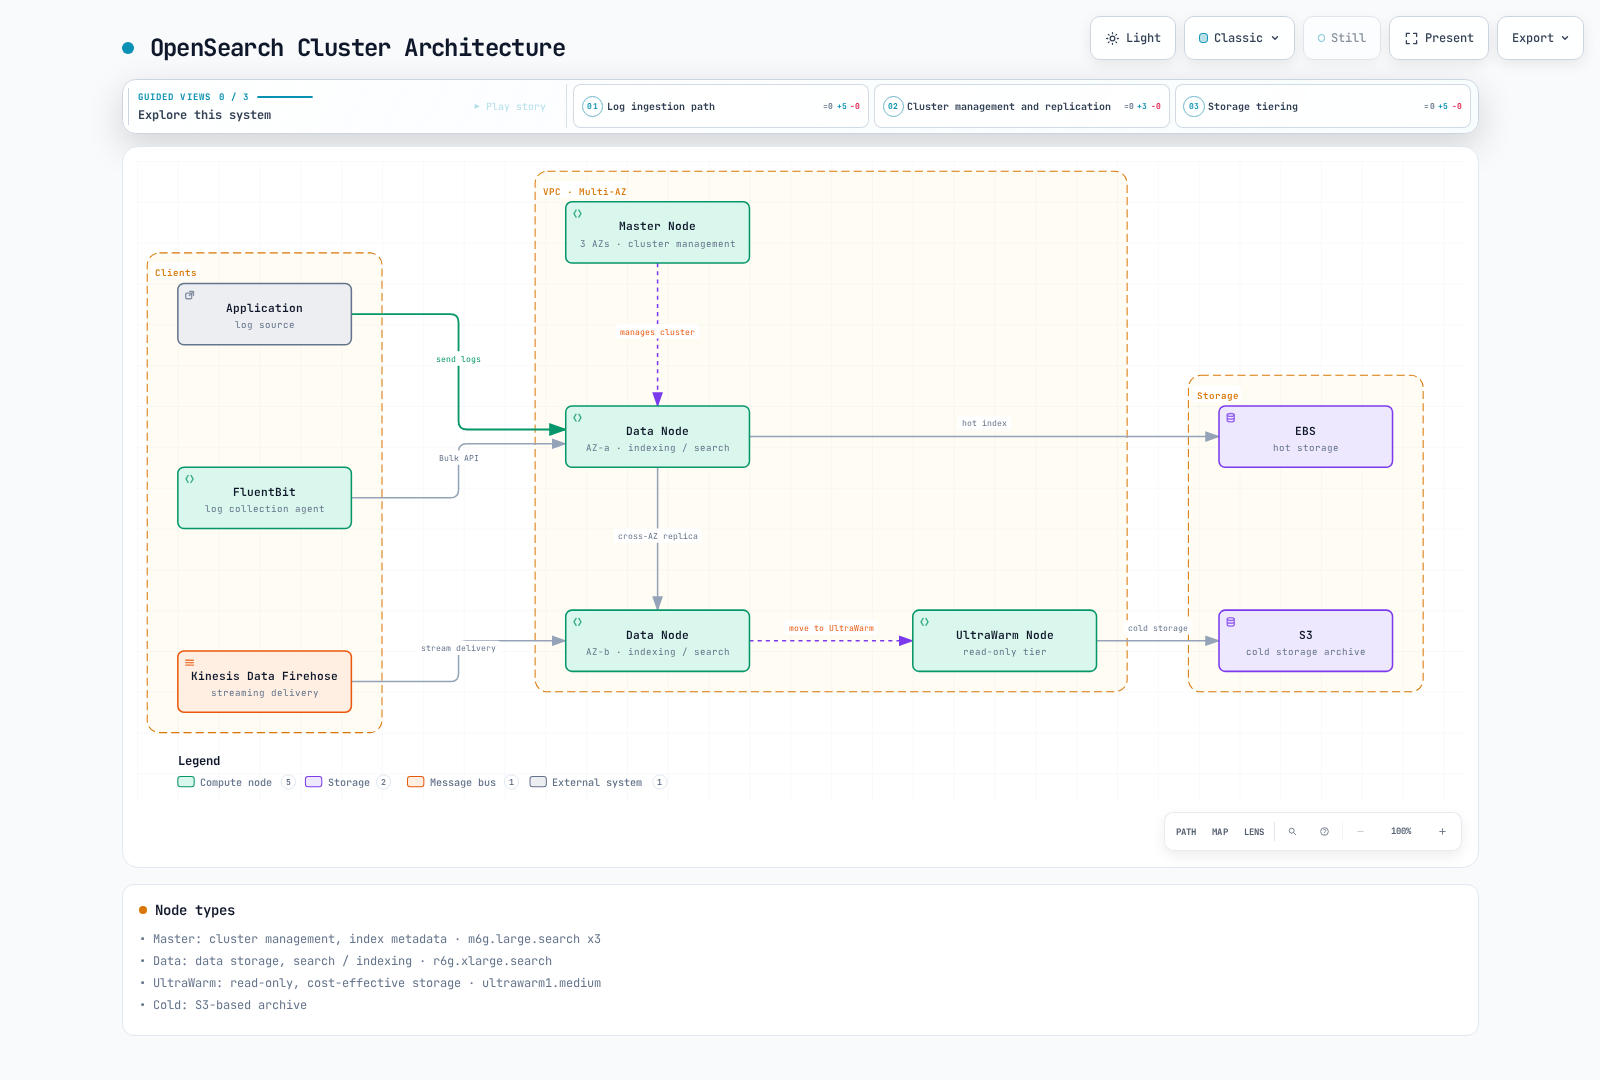
El diagrama es esquemático, no una réplica exacta del diseño de réplicas/AZ ni una recomendación de dimensionamiento. Su etiqueta “Master” se refiere al rol dedicado de administración del clúster; los campos de configuración de AWS todavía usan dedicated_master_*. “Kinesis Data Firehose” es el nombre anterior de Amazon Data Firehose. Tanto el almacenamiento UltraWarm como cold usan almacenamiento respaldado por S3; los datos cold deben adjuntarse a UltraWarm antes de consultarse.
| Rol o nivel | Función |
|---|---|
| Nodos dedicados de administración del clúster | Estado del clúster, metadatos y administración de la asignación de shards. Tres es la configuración convencional de administradores dedicados; no son réplicas de datos. |
| Nodos de datos / almacenamiento hot | Indexación y consultas. La disponibilidad y los límites de EBS dependen de la familia de instancias seleccionada. |
| UltraWarm | Índices de solo lectura respaldados por S3, con caché/cómputo de nodos warm. Compruebe los requisitos de motor, instancia y administrador dedicado. |
| Almacenamiento cold | Almacenamiento de índices separados con un ciclo de vida independiente. Vuelva a adjuntar índices seleccionados a UltraWarm para consultarlos. |
Multi-AZ with Standby tiene requisitos adicionales de topología y réplicas. Simplemente habilitar la conciencia de zona no habilita Standby ni establece sus garantías de disponibilidad. Revise las restricciones actuales de instancias, incluidos VPC Encryption Controls y la compatibilidad de almacenamiento. Los tamaños originales r6g/m6g son entradas de ejemplo, no un benchmark.
Recurso complementario: AWS Instance Benchmark. La capacidad del servicio todavía requiere una prueba representativa de carga de trabajo de OpenSearch.
Flujo de datos
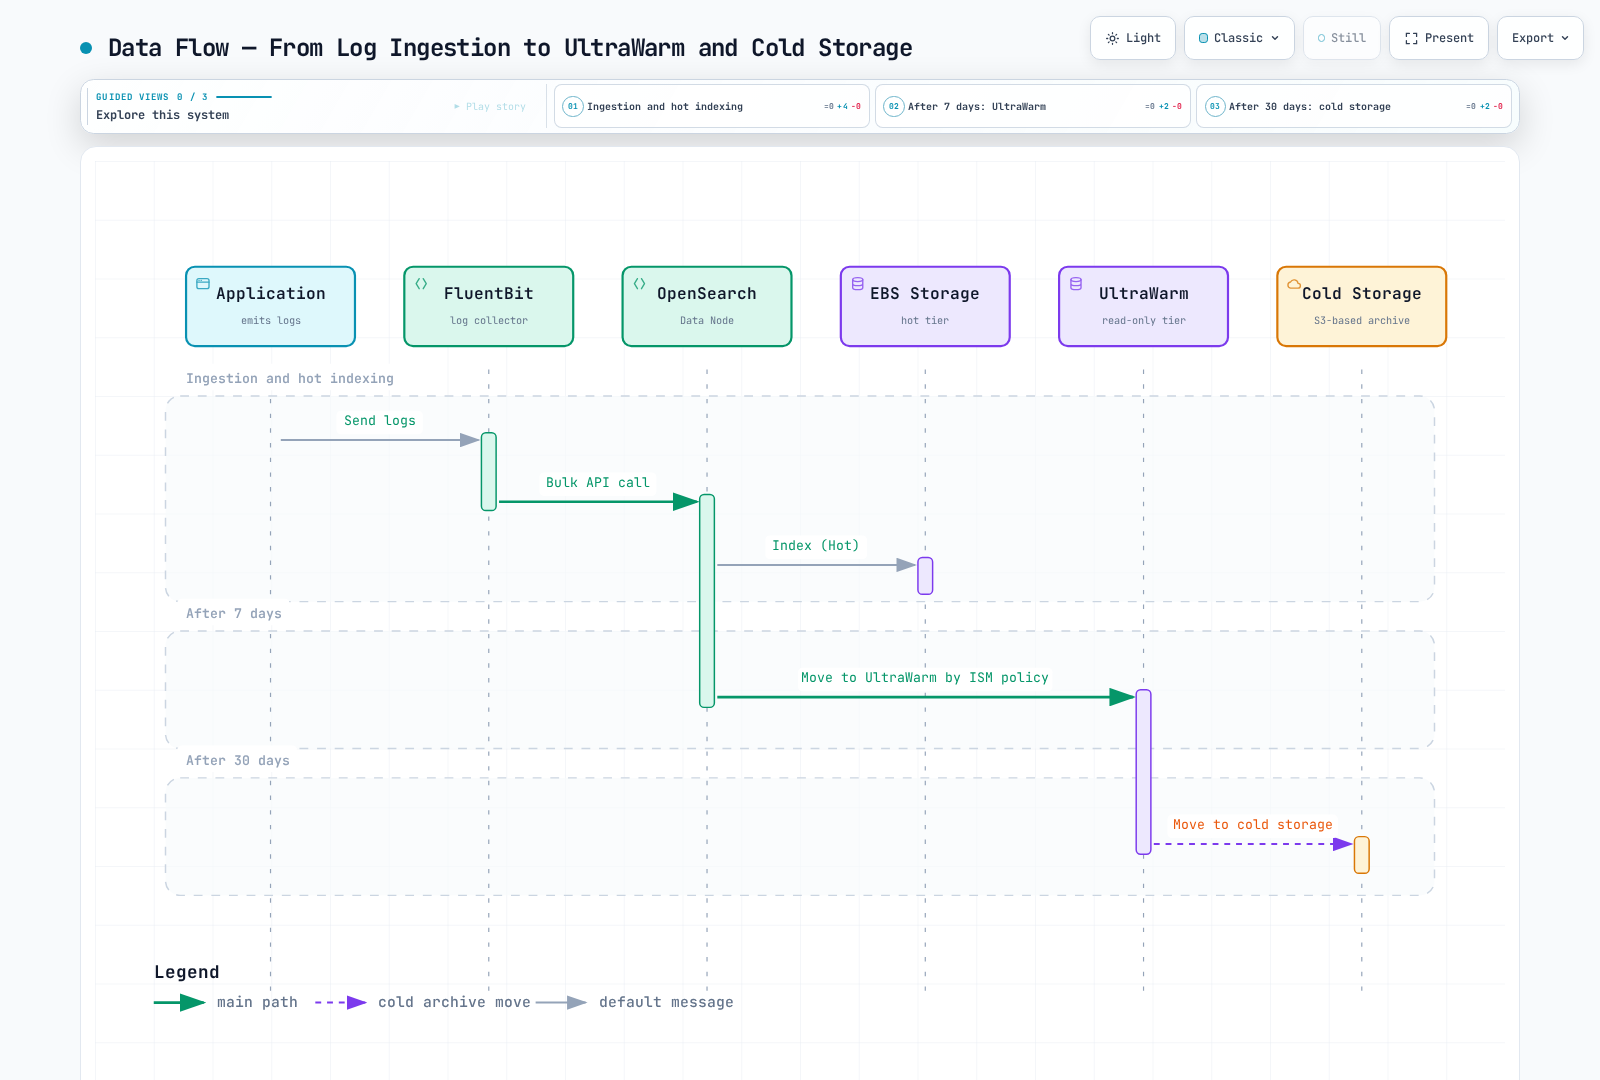
Las etiquetas de 7/30 días son condiciones de edad del índice de ejemplo, no valores predeterminados automáticos ni retención exacta según la edad del evento. ISM se ejecuta periódicamente y la migración es asíncrona. Los eventos tardíos o reproducidos pueden dirigirse a un índice antiguo de solo lectura con indexación basada en fechas; decida cómo enrutar o archivarlos antes de habilitar la migración.
Creación de dominios
Requisitos previos
Prepare tres subredes privadas en AZ distintas de la misma VPC, grupos de seguridad de clientes accesibles, un rol vinculado al servicio existente y roles IAM aprobados de administrador/escritor/lector. El ejemplo valida IDs de subred distintos, pero no verifica remotamente sus AZ, rutas, capacidad ni propiedad.
El perfil de Terraform usa solicitudes de API firmadas por IAM y un rol maestro de IAM. Evita una contraseña maestra interna en el estado de Terraform. Configure las asignaciones de roles FGAC antes de enviar logs. El SSO del navegador es un perfil de acceso independiente tratado más adelante; una política de dominio de principal IAM requiere SigV4 y no acepta automáticamente solicitudes de navegador SAML sin firmar.
Creación mediante Terraform
El ejemplo usa la partición comercial de AWS y la Región de Seúl. Reemplace las entradas de forma coherente y compruebe la disponibilidad regional. Crea recursos si se aplica; la auditoría solo ejecutó validación local.
terraform {
  required_providers {
    aws = {
      source  = "hashicorp/aws"
      version = "6.64.0"
    }
  }
}

variable "region" {
  type    = string
  default = "ap-northeast-2"
}

variable "account_id" {
  type = string
  validation {
    condition     = can(regex("^[0-9]{12}$", var.account_id))
    error_message = "Use the owning AWS account ID."
  }
}

variable "vpc_id" {
  type = string
}

variable "subnet_ids" {
  type = list(string)
  validation {
    condition     = length(var.subnet_ids) == 3 && length(distinct(var.subnet_ids)) == 3
    error_message = "Provide three distinct subnet IDs, one in each intended AZ."
  }
}

variable "client_security_group_ids" {
  type = set(string)
}

variable "admin_role_arn" {
  type = string
}

variable "writer_role_arns" {
  type = set(string)
}

variable "reader_role_arns" {
  type    = set(string)
  default = []
}

provider "aws" {
  region = var.region
}

locals {
  domain_name = "logs-production"
  domain_arn  = "arn:aws:es:${var.region}:${var.account_id}:domain/${local.domain_name}"
  log_types   = toset(["INDEX_SLOW_LOGS", "SEARCH_SLOW_LOGS", "ES_APPLICATION_LOGS", "AUDIT_LOGS"])
  callers     = setunion(toset([var.admin_role_arn]), var.writer_role_arns, var.reader_role_arns)
}

resource "aws_security_group" "search" {
  name_prefix = "logs-search-"
  description = "OpenSearch HTTPS from approved client security groups"
  vpc_id      = var.vpc_id
}

resource "aws_vpc_security_group_ingress_rule" "clients" {
  for_each                     = var.client_security_group_ids
  security_group_id            = aws_security_group.search.id
  referenced_security_group_id = each.value
  from_port                    = 443
  to_port                      = 443
  ip_protocol                  = "tcp"
}

resource "aws_vpc_security_group_egress_rule" "outbound" {
  security_group_id = aws_security_group.search.id
  cidr_ipv4         = "0.0.0.0/0"
  ip_protocol       = "-1"
}

resource "aws_cloudwatch_log_group" "search" {
  for_each          = local.log_types
  name              = "/aws/opensearch/${local.domain_name}/${lower(each.value)}"
  retention_in_days = 30
}

resource "aws_cloudwatch_log_resource_policy" "search" {
  policy_name = "logs-production-opensearch"
  policy_document = jsonencode({
    Version = "2012-10-17"
    Statement = [{
      Effect    = "Allow"
      Principal = { Service = "es.amazonaws.com" }
      Action    = ["logs:CreateLogStream", "logs:PutLogEvents"]
      Resource  = [for group in aws_cloudwatch_log_group.search : "${group.arn}:*"]
      Condition = {
        StringEquals = { "aws:SourceAccount" = var.account_id }
        ArnEquals    = { "aws:SourceArn" = local.domain_arn }
      }
    }]
  })
}

resource "aws_opensearch_domain" "logs" {
  domain_name    = local.domain_name
  engine_version = "OpenSearch_3.5"

  cluster_config {
    instance_type                 = "r6g.xlarge.search"
    instance_count                = 3
    dedicated_master_enabled      = true
    dedicated_master_type         = "m6g.large.search"
    dedicated_master_count        = 3
    zone_awareness_enabled        = true
    multi_az_with_standby_enabled = false
    zone_awareness_config {
      availability_zone_count = 3
    }
    warm_enabled = true
    warm_type    = "ultrawarm1.medium.search"
    warm_count   = 2
    cold_storage_options {
      enabled = true
    }
  }

  ebs_options {
    ebs_enabled = true
    volume_type = "gp3"
    volume_size = 500
  }

  vpc_options {
    subnet_ids         = var.subnet_ids
    security_group_ids = [aws_security_group.search.id]
  }

  encrypt_at_rest {
    enabled = true
  }
  node_to_node_encryption {
    enabled = true
  }
  domain_endpoint_options {
    enforce_https       = true
    tls_security_policy = "Policy-Min-TLS-1-2-PFS-2023-10"
  }
  advanced_security_options {
    enabled                        = true
    internal_user_database_enabled = false
    master_user_options {
      master_user_arn = var.admin_role_arn
    }
  }

  access_policies = jsonencode({
    Version = "2012-10-17"
    Statement = [{
      Effect    = "Allow"
      Principal = { AWS = sort(tolist(local.callers)) }
      Action    = ["es:ESHttp*"]
      Resource  = "${local.domain_arn}/*"
    }]
  })

  dynamic "log_publishing_options" {
    for_each = aws_cloudwatch_log_group.search
    content {
      cloudwatch_log_group_arn = log_publishing_options.value.arn
      log_type                 = log_publishing_options.key
      enabled                  = true
    }
  }

  depends_on = [aws_cloudwatch_log_resource_policy.search]
}

output "domain_endpoint" {
  value = aws_opensearch_domain.logs.endpoint
}

output "dashboards_endpoint" {
  value = aws_opensearch_domain.logs.dashboard_endpoint
}
Los tamaños iniciales, los volúmenes EBS de 500 GiB y la retención de CloudWatch de 30 días son ilustrativos. El perfil usa explícitamente Multi-AZ sin Standby. El acceso saliente del grupo de seguridad sigue siendo amplio en esta referencia; diseñe restricciones de salida para las conexiones compatibles reales antes de producción.
La política de acceso al dominio admite los roles IAM indicados para operaciones HTTP; FGAC debe restringir sus permisos de índice/clúster. Los permisos IAM basados solo en URI no restringen los nombres de índice incrustados en cuerpos de solicitudes bulk. Asigne al rol del recopilador únicamente la asignación de escritor prevista.
El rol vinculado al servicio de la plataforma es una dependencia a nivel de cuenta. Reutilícelo o impórtelo mediante el estado de infraestructura de su propietario en vez de intentar crear el mismo rol en cada implementación.
Los dominios OpenSearch reciben snapshots automatizadas cada hora que se conservan durante 14 días (hasta 336). El antiguo ejemplo automated_snapshot_start_hour se aplica a versiones mucho más antiguas de Elasticsearch, no a este perfil de OpenSearch. Las snapshots son mecanismos de recuperación, no sustitutos de un plan de retención/restauración probado. El estado red del clúster puede impedir las snapshots.
La publicación en CloudWatch necesita la política de recursos con alcance definido antes de configurar el dominio. Publicar destinos de slow logs no habilita todos los umbrales de slow log, y publicar logs de auditoría no configura todos los eventos de auditoría. Configure deliberadamente los ajustes correspondientes del motor/auditoría; las consultas y el contenido de documentos en los logs también necesitan controles de acceso y retención.
Administración de índices
El recopilador principal siguiente escribe índices diarios llamados logs-production-YYYY.MM.DD. La plantilla, el patrón ISM y los ejemplos de consulta usan ese patrón. A continuación hay un ejercicio de rollover independiente; no combine silenciosamente las dos estrategias de escritura.
Los siguientes bloques de solicitudes usan la sintaxis de Dev Tools de OpenSearch Dashboards. No son archivos JSON independientes ni comandos ejecutados por la auditoría. Use un cliente de plano de datos autorizado y el dominio previsto.
Plantillas de índices
PUT _index_template/logs-template
{
  "index_patterns": [
    "logs-production-*"
  ],
  "priority": 100,
  "template": {
    "settings": {
      "number_of_shards": 3,
      "number_of_replicas": 1,
      "refresh_interval": "5s",
      "index.codec": "best_compression",
      "index.translog.durability": "request"
    },
    "mappings": {
      "dynamic": false,
      "properties": {
        "@timestamp": {
          "type": "date"
        },
        "cluster_name": {
          "type": "keyword"
        },
        "environment": {
          "type": "keyword"
        },
        "stream": {
          "type": "keyword"
        },
        "log": {
          "type": "text",
          "index": false
        },
        "kubernetes": {
          "properties": {
            "namespace_name": {
              "type": "keyword"
            },
            "pod_name": {
              "type": "keyword"
            },
            "container_name": {
              "type": "keyword"
            },
            "host": {
              "type": "keyword"
            }
          }
        },
        "app": {
          "properties": {
            "level": {
              "type": "keyword"
            },
            "message": {
              "type": "text",
              "fields": {
                "keyword": {
                  "type": "keyword",
                  "ignore_above": 256
                }
              }
            },
            "error_type": {
              "type": "keyword"
            },
            "trace_id": {
              "type": "keyword"
            },
            "span_id": {
              "type": "keyword"
            },
            "request_id": {
              "type": "keyword"
            },
            "http": {
              "properties": {
                "method": {
                  "type": "keyword"
                },
                "status_code": {
                  "type": "integer"
                },
                "path": {
                  "type": "keyword"
                },
                "response_time_ms": {
                  "type": "float"
                }
              }
            }
          }
        }
      }
    }
  }
}
El filtro Kubernetes produce kubernetes.namespace_name, no kubernetes.namespace. El JSON de la aplicación está anidado bajo app para mantenerlo separado de los metadatos del recopilador. Las aplicaciones deben emitir los campos y unidades documentados; los ejemplos usan app.level en minúsculas y milisegundos en app.http.response_time_ms.
Un registro de aplicación ilustrativo de una línea antes del enriquecimiento del recopilador es:
{"level":"error","message":"request failed","error_type":"upstream_timeout","http":{"method":"GET","path":"/orders","status_code":503,"response_time_ms":1250}}El subcampo message.keyword se define explícitamente como app.message.keyword; una asignación text por sí sola no lo crea automáticamente. Los valores por encima de su límite ignore_above no se indexan en ese subcampo. Considere una taxonomía delimitada de error_type para agregaciones en vez de mensajes arbitrarios.
dynamic: false limita los campos asignados nuevos, pero no elimina campos desconocidos de _source. El campo log sin procesar se almacena sin un índice de búsqueda. Revise la duplicación, el enmascaramiento y el acceso a los datos sin procesar. translog.durability: request es una línea base más segura que una compensación de durabilidad async/30s sin explicación; ninguno de los dos ajustes garantiza la recuperación ante cada fallo de almacenamiento o réplica.
Políticas ISM (Index State Management)
PUT _plugins/_ism/policies/logs-lifecycle
{
  "policy": {
    "description": "Illustrative daily-index hot/warm/cold retention; confirm ownership and late-arrival handling.",
    "schema_version": 1,
    "default_state": "hot",
    "states": [
      {
        "name": "hot",
        "actions": [],
        "transitions": [
          {
            "state_name": "warm",
            "conditions": {
              "min_index_age": "7d"
            }
          }
        ]
      },
      {
        "name": "warm",
        "actions": [
          {
            "warm_migration": {}
          }
        ],
        "transitions": [
          {
            "state_name": "cold",
            "conditions": {
              "min_index_age": "30d"
            }
          }
        ]
      },
      {
        "name": "cold",
        "actions": [
          {
            "cold_migration": {
              "timestamp_field": "@timestamp"
            }
          }
        ],
        "transitions": [
          {
            "state_name": "delete",
            "conditions": {
              "min_index_age": "90d"
            }
          }
        ]
      },
      {
        "name": "delete",
        "actions": [
          {
            "cold_delete": {}
          }
        ],
        "transitions": []
      }
    ],
    "ism_template": [
      {
        "index_patterns": [
          "logs-production-*"
        ],
        "priority": 100
      }
    ]
  }
}
Esta política se adjunta a índices coincidentes recién creados. Los índices existentes necesitan una operación deliberada de adjuntar políticas; inspeccione _plugins/_ism/explain/INDEX y las versiones de las políticas antes de modificarlos.
Cada objeto de acción tiene una acción (con sus metadatos de reintento/tiempo de espera admitidos). Las acciones administradas warm_migration, cold_migration y cold_delete difieren de las operaciones ISM autoadministradas. Los índices cold requieren cold_delete, y la migración cold de ISM necesita un campo de marca de tiempo explícito. No combine la migración warm, los cambios de réplica y force merge en un solo objeto de acción.
ISM normalmente evalúa los trabajos cada 5–8 minutos y no los ejecuta mientras el estado del clúster sea red. La edad del índice se mide desde su creación. La eliminación de ejemplo a los 90 días es una elección organizativa, no un requisito legal universal ni una expiración exacta por registro. Verifique el comportamiento de datos tardíos, las snapshots y la recuperación antes de habilitar la eliminación.
Alias de índices y rollover
Este ejercicio independiente usa el prefijo rollover-logs-* y un alias de escritor. No cambia la configuración diaria del recopilador.
PUT _index_template/rollover-logs
{
  "index_patterns": [
    "rollover-logs-*"
  ],
  "priority": 100,
  "template": {
    "settings": {
      "number_of_shards": 3,
      "number_of_replicas": 1,
      "plugins.index_state_management.rollover_alias": "rollover-logs-write"
    },
    "mappings": {
      "properties": {
        "@timestamp": {
          "type": "date"
        },
        "message": {
          "type": "text"
        }
      }
    }
  }
}

PUT _plugins/_ism/policies/rollover-logs
{
  "policy": {
    "description": "Independent rollover example; not attached to date-based collector indexes.",
    "schema_version": 1,
    "default_state": "write",
    "states": [
      {
        "name": "write",
        "actions": [
          {
            "rollover": {
              "min_index_age": "1d",
              "min_primary_shard_size": "30gb"
            }
          }
        ],
        "transitions": []
      }
    ],
    "ism_template": [
      {
        "index_patterns": [
          "rollover-logs-*"
        ],
        "priority": 100
      }
    ]
  }
}

PUT rollover-logs-000001
{
  "aliases": {
    "rollover-logs-write": {
      "is_write_index": true
    }
  }
}

POST rollover-logs-write/_doc
{
  "@timestamp": "2026-09-13T00:00:00Z",
  "message": "synthetic rollover example"
}

GET _plugins/_ism/explain/rollover-logs-000001

POST rollover-logs-write/_rollover
{
  "conditions": {
    "max_age": "1d",
    "max_size": "90gb"
  }
}
El rollover automático de ISM necesita el ajuste de alias de rollover, un índice numerado adecuado y el alias de escritura. Un escritor de fechas diarias no usará ese alias simplemente porque exista uno.
min_primary_shard_size: 30gb de ISM se refiere a un único shard principal. El analizador REST de rollover de OpenSearch 3.5 acepta max_age, max_docs y max_size; max_size mide el almacenamiento total de shards principales, excluyendo réplicas. Por lo tanto, el ejemplo REST de 90 GB no es la misma condición que un umbral de 30 GB por shard principal. Las condiciones de rollover son alternativas, no un requisito de satisfacer todos los umbrales simultáneamente.
Ingesta de datos
Ingesta directa desde Fluent Bit
Los siguientes seis recursos forman una configuración de recopilador de referencia para nodos Linux EC2 elegibles. Fargate usa su enrutador de logs de plataforma; Windows y otras plataformas de nodo requieren sus propias rutas y modelo de implementación. Confirme las rutas de host, las excepciones de políticas de admisión y las necesidades de recursos antes de implementar un lector de logs de nodo.
Establezca el hostname de dominio, la Región y el rol IRSA reales. La confianza OIDC del rol debe coincidir con system:serviceaccount:logging:fluent-bit; autorice también su acceso IAM/plano de datos y el rol de escritor FGAC. Pod Identity es una alternativa solo con soporte compatible de nodo/agente/SDK.
apiVersion: v1
kind: Namespace
metadata:
  name: logging
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: fluent-bit
  namespace: logging
  annotations:
    eks.amazonaws.com/role-arn: arn:aws:iam::123456789012:role/FluentBitOpenSearchRole
---
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
  name: fluent-bit-metadata
rules:
- apiGroups:
  - ''
  resources:
  - namespaces
  - pods
  verbs:
  - get
  - list
  - watch
---
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRoleBinding
metadata:
  name: fluent-bit-metadata
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: ClusterRole
  name: fluent-bit-metadata
subjects:
- kind: ServiceAccount
  name: fluent-bit
  namespace: logging
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: fluent-bit-config
  namespace: logging
data:
  fluent-bit.conf: |
    [SERVICE]
        Flush          5
        Log_Level      info
        HTTP_Server    Off
        storage.path   /buffers/storage
        storage.sync   normal

    [INPUT]
        Name               tail
        Tag                kube.*
        Path               /var/log/containers/*.log
        Exclude_Path       /var/log/containers/fluent-bit-*_logging_fluent-bit-*.log
        multiline.parser   docker, cri
        DB                 /buffers/tail.db
        Mem_Buf_Limit      50MB
        Skip_Long_Lines    On
        Refresh_Interval   10
        storage.type       filesystem

    [FILTER]
        Name                kubernetes
        Match               kube.*
        Kube_Tag_Prefix     kube.var.log.containers.
        Merge_Log           On
        Merge_Log_Key       app
        Keep_Log            On
        Labels              Off
        Annotations         Off
        K8S-Logging.Parser  Off
        K8S-Logging.Exclude Off

    [FILTER]
        Name    modify
        Match   kube.*
        Set     cluster_name example-eks
        Set     environment example

    [OUTPUT]
        Name                    opensearch
        Match                   kube.*
        Host                    REPLACE_WITH_DOMAIN_ENDPOINT
        Port                    443
        tls                     On
        tls.verify              On
        AWS_Auth                On
        AWS_Region              ap-northeast-2
        Suppress_Type_Name      On
        Logstash_Format         On
        Logstash_Prefix         logs-production
        Time_Key                @timestamp
        Generate_ID             On
        Retry_Limit             5
        Buffer_Size             5MB
        Compress                gzip
        storage.total_limit_size 1G
---
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: fluent-bit
  namespace: logging
spec:
  selector:
    matchLabels:
      app: fluent-bit
  template:
    metadata:
      labels:
        app: fluent-bit
    spec:
      serviceAccountName: fluent-bit
      nodeSelector:
        kubernetes.io/os: linux
      tolerations:
      - operator: Exists
        effect: NoSchedule
      containers:
      - name: fluent-bit
        image: public.ecr.aws/aws-observability/aws-for-fluent-bit:3.4.15@sha256:88e1b56cedb230486afeca6eeb26c5f6bd59c48879d0054d1674d5a58838c607
        args:
        - -c
        - /fluent-bit/custom/fluent-bit.conf
        securityContext:
          runAsUser: 0
          allowPrivilegeEscalation: false
          readOnlyRootFilesystem: true
          capabilities:
            drop:
            - ALL
          seccompProfile:
            type: RuntimeDefault
        resources:
          requests:
            cpu: 100m
            memory: 128Mi
          limits:
            memory: 512Mi
        volumeMounts:
        - name: logs
          mountPath: /var/log
          readOnly: true
        - name: buffers
          mountPath: /buffers
        - name: config
          mountPath: /fluent-bit/custom
          readOnly: true
        - name: tmp
          mountPath: /tmp
        command:
        - /fluent-bit/bin/fluent-bit
      volumes:
      - name: logs
        hostPath:
          path: /var/log
          type: Directory
      - name: buffers
        hostPath:
          path: /var/lib/fluent-bit-opensearch
          type: DirectoryOrCreate
      - name: config
        configMap:
          name: fluent-bit-config
      - name: tmp
        emptyDir: {}
El índice de imágenes está fijado y se comprobó su metadato Linux amd64/arm64. El CMD predeterminado de esta imagen es un script de punto de entrada; el ejemplo invoca explícitamente /fluent-bit/bin/fluent-bit con la salida OpenSearch nativa. No carga los plugins heredados de salida Go ni prueba la imagen en tiempo de ejecución.
Relaciones de configuración importantes:
multiline.parser docker, crimaneja el framing de contenedor compatible; después, el filtro Kubernetes fusiona el JSON de la aplicación bajoapp.- El montaje
/var/logde solo lectura es para la entrada de logs. La base de datos Tail y los buffers de sistema de archivos usan una ruta de nodo separada con escritura. Sobreviven al reinicio de un Pod solo mientras sobreviva ese nodo/ruta; no son almacenamiento duradero entre nodos. - El RBAC de metadatos se limita a operaciones de lectura en Pods/namespaces. El agente mismo lee los logs de nodo, por lo que debe proteger su namespace, rol y configuración.
- Las anotaciones de aplicaciones no pueden sobrescribir silenciosamente el análisis ni excluir logs en este ejemplo. Los valores de clúster/entorno generados por el recopilador se establecen deliberadamente. Excluya los propios logs del recopilador de este pipeline para reducir los bucles de retroalimentación.
Suppress_Type_Name Ones obligatorio para la API sin tipos de OpenSearch 2.x/3.x.Type _docno es un sustituto compatible.Logstash_Format Oncrea nombres de índices basados en fechas y el campo@timestamp. No escribe en el alias de rollover opcional.- Los reintentos,
Generate_ID, los buffers de memoria y el límite de almacenamiento de la salida no son una garantía de entrega exactamente una vez ni sin pérdidas. Pruebe errores bulk parciales, líneas sobredimensionadas, offsets de reinicio, el límite de reintentos, presión de disco y registros tardíos. El límite de salida no limita todo el uso de disco del nodo.
El log sin procesar conservado puede contener datos también presentes bajo app. Enmascare el contenido prohibido antes de almacenarlo y supervise los registros rechazados. No habilite el rastreo de cuerpos de solicitudes como un ajuste de diagnóstico permanente.
Ingesta mediante Amazon Data Firehose
Data Firehose es una ruta de entrega administrada alternativa con controles de almacenamiento en búfer, reintentos y respaldo; no es automáticamente la opción más barata ni la más simple para cada carga de trabajo. Su recurso Terraform sigue llamándose aws_kinesis_firehose_delivery_stream.
Este archivo de recursos opcional usa el dominio anterior y las entradas existentes aprobadas de rol de entrega, subred, grupo de seguridad y bucket de respaldo privado:
variable "firehose_role_arn" {
  type = string
}

variable "firehose_subnet_ids" {
  type = list(string)
}

variable "firehose_security_group_ids" {
  type = list(string)
}

variable "backup_bucket_arn" {
  type = string
}

resource "aws_cloudwatch_log_group" "firehose" {
  name              = "/aws/kinesisfirehose/logs-to-opensearch"
  retention_in_days = 30
}

resource "aws_cloudwatch_log_stream" "firehose" {
  name           = "opensearch-delivery"
  log_group_name = aws_cloudwatch_log_group.firehose.name
}

resource "aws_kinesis_firehose_delivery_stream" "logs" {
  name        = "logs-to-opensearch"
  destination = "opensearch"

  opensearch_configuration {
    domain_arn            = aws_opensearch_domain.logs.arn
    role_arn              = var.firehose_role_arn
    index_name            = "logs-production-firehose"
    index_rotation_period = "OneDay"
    buffering_interval    = 60
    buffering_size        = 5
    retry_duration        = 300
    s3_backup_mode        = "FailedDocumentsOnly"

    vpc_config {
      subnet_ids         = var.firehose_subnet_ids
      security_group_ids = var.firehose_security_group_ids
      role_arn           = var.firehose_role_arn
    }

    cloudwatch_logging_options {
      enabled         = true
      log_group_name  = aws_cloudwatch_log_group.firehose.name
      log_stream_name = aws_cloudwatch_log_stream.firehose.name
    }

    s3_configuration {
      role_arn           = var.firehose_role_arn
      bucket_arn         = var.backup_bucket_arn
      prefix             = "opensearch-failed/"
      buffering_size     = 10
      buffering_interval = 400
      compression_format = "GZIP"
    }
  }
}
El rol de entrega necesita los permisos relevantes de OpenSearch/FGAC, S3, CloudWatch y VPC/ENI, además de los permisos KMS requeridos; su confianza y los permisos iam:PassRole del implementador son independientes. Incluya el rol de entrega en las entradas de llamadores del dominio y en la asignación de escritor, y permita sus conexiones VPC al puerto 443.
FailedDocumentsOnly elige el modo de respaldo; nombrar un prefijo S3 failed/ por sí solo no lo hace. Pruebe los fallos y la reproducción desde el bucket de respaldo privado. Los registros de Firehose necesitan un esquema compatible con la asignación de índices, incluidas las marcas de tiempo; el servicio no crea automáticamente el sobre de metadatos Kubernetes/aplicación mostrado aquí.
OpenSearch Dashboards
Acceso y patrones de índices
Use conectividad VPC aprobada y un método de autenticación compatible con la política de acceso del dominio. Un túnel SSH simple no conserva por sí mismo el hostname TLS original, las redirecciones SSO ni la firma SigV4. No deshabilite la verificación de certificados para hacer que https://localhost:9200 parezca funcionar. Un ALB no es una receta completa de integración nativa de dominio/Dashboards.
Después de configurar el acceso autenticado, cree una vista de datos/patrón de índice para logs-production-* y seleccione @timestamp. Los nombres de menú varían según la versión de Dashboards y la experiencia habilitada.
Ejemplos de consultas de búsqueda
GET logs-production-*/_search
{
  "query": {
    "bool": {
      "filter": [
        {
          "term": {
            "app.level": "error"
          }
        },
        {
          "range": {
            "@timestamp": {
              "gte": "now-1h"
            }
          }
        },
        {
          "term": {
            "kubernetes.namespace_name": "production"
          }
        }
      ]
    }
  },
  "sort": [
    {
      "@timestamp": {
        "order": "desc"
      }
    }
  ],
  "size": 100
}

GET logs-production-*/_search
{
  "size": 0,
  "query": {
    "bool": {
      "filter": [
        {
          "term": {
            "app.level": "error"
          }
        },
        {
          "range": {
            "@timestamp": {
              "gte": "now-24h"
            }
          }
        }
      ]
    }
  },
  "aggs": {
    "by_namespace": {
      "terms": {
        "field": "kubernetes.namespace_name",
        "size": 20
      },
      "aggs": {
        "by_type": {
          "terms": {
            "field": "app.error_type",
            "size": 10
          }
        }
      }
    }
  }
}

GET logs-production-*/_search
{
  "size": 0,
  "query": {
    "bool": {
      "filter": [
        {
          "exists": {
            "field": "app.http.response_time_ms"
          }
        },
        {
          "range": {
            "@timestamp": {
              "gte": "now-1h"
            }
          }
        }
      ]
    }
  },
  "aggs": {
    "response_time_percentiles": {
      "percentiles": {
        "field": "app.http.response_time_ms",
        "percents": [
          50,
          75,
          90,
          95,
          99
        ]
      }
    }
  }
}
Estos ejemplos usan contexto de filtro para condiciones exactas de keyword/tiempo. La segunda consulta realmente filtra errores antes de agregar namespaces. La agregación Terms devuelve un conjunto top-N seleccionado y puede tener aproximación distribuida/buckets omitidos; no es un recuento completo de cada namespace. Los percentiles son aproximados y usan el campo asignado en milisegundos.
Para las visualizaciones, elija app.level, un histograma de tiempo sobre @timestamp o los campos asignados explícitamente app.message.keyword/app.error_type. Un nombre de campo mencionado en un dashboard no crea su asignación.
Configuración de seguridad
Control de acceso detallado
El acceso de red, la política de recursos del dominio y FGAC son capas independientes. La política de principal IAM de Terraform requiere SigV4. Ni una regla de grupo de seguridad ni una solicitud IAM correcta conceden automáticamente acceso al índice.
Un administrador puede definir un rol de escritor para el recopilador y un lector restringido por namespace:
PUT _plugins/_security/api/roles/logs-writer
{
  "cluster_permissions": [
    "cluster_composite_ops"
  ],
  "index_permissions": [
    {
      "index_patterns": [
        "logs-production-*"
      ],
      "allowed_actions": [
        "create_index",
        "write"
      ]
    }
  ]
}

PUT _plugins/_security/api/rolesmapping/logs-writer
{
  "backend_roles": [
    "arn:aws:iam::123456789012:role/FluentBitOpenSearchRole"
  ]
}

PUT _plugins/_security/api/roles/team-a-logs
{
  "cluster_permissions": [
    "cluster_composite_ops_ro"
  ],
  "index_permissions": [
    {
      "index_patterns": [
        "logs-production-*"
      ],
      "dls": "{\"term\":{\"kubernetes.namespace_name\":\"team-a\"}}",
      "allowed_actions": [
        "read"
      ]
    }
  ]
}

PUT _plugins/_security/api/rolesmapping/team-a-logs
{
  "backend_roles": [
    "arn:aws:iam::123456789012:role/TeamAReaderRole"
  ]
}
Reemplace los ARN de rol por las identidades aprobadas. La asignación de escritor también debe incluir un rol de entrega Firehose si se usa esa ruta. No conceda a lectores rutinarios cluster_all ni el rol maestro. Las asignaciones de roles de backend de IAM y los nombres de usuario internos/SAML son mecanismos de identidad diferentes.
Seguridad a nivel de documento y seguridad a nivel de campo
DLS filtra documentos por campos almacenados. En este ejemplo, los metadatos de namespace deben provenir del recopilador de confianza; las cadenas proporcionadas por aplicaciones no son prueba de identidad del inquilino.
Para un lector más restringido, el siguiente rol combinado conserva la restricción de namespace e incluye solo campos de respuesta seleccionados:
PUT _plugins/_security/api/roles/team-a-limited
{
  "cluster_permissions": [
    "cluster_composite_ops_ro"
  ],
  "index_permissions": [
    {
      "index_patterns": [
        "logs-production-*"
      ],
      "fls": [
        "@timestamp",
        "kubernetes.namespace_name",
        "app.level",
        "app.message"
      ],
      "allowed_actions": [
        "read"
      ],
      "dls": "{\"term\":{\"kubernetes.namespace_name\":\"team-a\"}}"
    }
  ]
}
Use la asignación de rol prevista en vez de agregar un rol restringido a una identidad que ya tiene acceso más amplio. Evalúe el conjunto completo de roles efectivos. El campo log sin procesar está ausente intencionalmente de esta lista de permitidos porque puede duplicar campos JSON ocultos de otro modo.
FLS controla los campos devueltos, no el contenido de una cadena de mensaje permitida. No elimina información de _source, snapshots ni archivos de logs. Pruebe el acceso de búsqueda, get, búsqueda múltiple y agregación, e impida que los datos prohibidos se registren en primer lugar.
Configuración de autenticación SAML
SAML administrado de OpenSearch Service se configura mediante la API de configuración de dominio de AWS, no subiendo un opensearch-security/config.yml autoadministrado.
El siguiente asistente local serializa XML de IdP aprobado sin escaparlo manualmente. Reemplace el grupo administrativo de ejemplo y la clave de atributo de rol con la configuración de IdP que revisó:
from pathlib import Path
import json
import xml.etree.ElementTree as ET

metadata = Path("idp-metadata.xml").read_text(encoding="utf-8")
root = ET.fromstring(metadata)
if root.tag.rsplit("}", 1)[-1] != "EntityDescriptor" or not root.get("entityID"):
    raise ValueError("Provide approved metadata for one IdP EntityDescriptor")
options = {
    "SAMLOptions": {
        "Enabled": True,
        "Idp": {"EntityId": root.get("entityID"), "MetadataContent": metadata},
        "MasterBackendRole": "opensearch-admin",
        "RolesKey": "Role",
        "SessionTimeoutMinutes": 60,
    }
}
Path("advanced-security-saml.json").write_text(json.dumps(options, indent=2) + "\n")aws opensearch update-domain-config \
--domain-name logs-production --region ap-northeast-2 \
--advanced-security-options file://advanced-security-saml.jsonEste es un ejemplo de payload, no una implementación SSO de extremo a extremo. Valide la confianza de metadatos, el ID de entidad, los certificados, las URL de ACS/Dashboards y las asignaciones. El tráfico de navegador SAML necesita un diseño de política de acceso al dominio coincidente; habilitar SAMLOptions no convierte ese tráfico en SigV4 para la política solo IAM anterior. Siga un perfil de autenticación coherente y pruebe la recuperación del administrador antes de cambiar un dominio existente.
Optimización de costos
Ajustes de almacenamiento e índices
Calcule el precio de la Región seleccionada, familias/recuentos de nodos, réplicas, EBS, cómputo/almacenamiento de nodos warm, almacenamiento cold y rutas de transferencia/ingesta de datos. Los totales anteriores en dólares de 100 GB/día y los porcentajes fijos de ahorro carecían de suficientes supuestos para reproducirse; no son un presupuesto actual ni una comparación medida.
La compresión de índices, el intervalo de actualización, los recuentos de shards y las asignaciones de campos intercambian almacenamiento/CPU, frescura de búsqueda, capacidad de consulta y costo de recuperación. Establezca opciones estáticas como index.codec en la plantilla de creación; no envíe ciegamente cambios de ajustes estáticos a todos los índices de producción abiertos. Eliminar posiciones de texto o deshabilitar campos puede romper consultas.
Los ahorros de Reserved Instance dependen del uso elegible, la Región, el plazo y la opción de pago. Un horizonte de un año por sí solo no justifica una compra, y un descuento de nodo no hace que desaparezcan todos los cargos de almacenamiento/entrega. Use precios actuales y demanda medida en lugar de las antiguas cifras fijas de 21/24/36%.
Limitaciones en entornos de logs a gran escala
OpenSearch combina índices invertidos con valores de documento orientados a columnas para muchas agregaciones y ordenaciones. No vuelve a leer universalmente cada documento _source completo para una agregación. La asignación, selectividad, shards, cachés, diseño de segmentos y trabajo simultáneo afectan al rendimiento.
Las cifras originales de latencia y compresión de OpenSearch/ClickHouse no tenían hardware, versiones, datos ni consultas reproducibles. No las convierta en un umbral de migración universal de 100 GB ni en una afirmación de que el 90% de las consultas de todas las organizaciones tienen un patrón.
Compare consultas representativas de texto completo, filtro, agregación e investigación con los mismos requisitos de datos, retención, durabilidad y simultaneidad. Evalúe el costo de ingesta/relleno histórico, evolución de esquemas, permisos, dashboards, habilidades operativas y reversión. Un experimento de escritura dual necesita reconciliación y controles de costos; un calendario fijo de dos semanas o dos meses no es una garantía.
Comparación con Loki
| Área | OpenSearch | Loki |
|---|---|---|
| Modelo de índice/consulta | Campos asignados, índices invertidos y valores de documento; Query DSL y características SQL/PPL compatibles | Índice de etiquetas de stream, escaneo de chunks y pipelines/métricas LogQL |
| Búsqueda de texto | Analizadores, relevancia y capacidades de consulta de texto completo | Filtrado/búsqueda de texto dentro de streams y rangos de tiempo seleccionados |
| Control de acceso | Red/IAM/FGAC y controles de documento/campo configurados | Gateway de autenticación, autorización de inquilinos y controles de política/operación |
| Costos y operaciones | Dependen del modelo aprovisionado/administrado y de la carga de trabajo | Dependen del modo de implementación, streams, almacenamiento de objetos, cachés y consultas |
| Migración | Reconstruir asignaciones/consultas y validar permisos/corrección de datos | Rediseñar etiquetas/metadatos/consultas y validar permisos/corrección de datos |
Ningún producto es automáticamente la opción de conformidad, la opción más barata ni operacionalmente simple. Loki todavía admite búsqueda de texto y métricas derivadas; una migración cambia la semántica y las capacidades en vez de ajustarse a una regla fija de costo de 3–5× o ahorro de 60–80%.
Validación y referencias
Las comprobaciones locales cubren la configuración de recursos Terraform y los contratos publicados de datos/configuración. No demuestran autorización de AWS en vivo, capacidad de SKU compatible en una Región, entrega del recopilador, transiciones/eliminación ISM, autenticación SAML ni rendimiento de consultas. Se inspeccionaron los metadatos de índice/configuración de imágenes sin descargar capas ejecutables ni ejecutar un contenedor.
- Soporte de servicio/versión
- Tipos de instancia admitidos y Multi-AZ
- Acceso VPC, políticas de acceso y FGAC
- UltraWarm, almacenamiento cold, ISM administrado y referencia de políticas ISM
- API de rollover y valores de documento
- Snapshots, logs de CloudWatch y SAML
- Historial de versiones de AWS for Fluent Bit y configuración de salida OpenSearch
- Configuración de destino de Data Firehose
- Precios actuales del servicio
- Preguntas frecuentes sobre licencias de Elastic
Cuestionario
Pruebe las distinciones en el cuestionario de OpenSearch.