Cuestionario de observabilidad
Última actualización: October 12, 2026
Versiones: Istio 1.31, que admite Kubernetes 1.32–1.37. Consulta los capítulos de instalación y dashboards para los límites de compatibilidad de EKS y Kiali.
Este cuestionario cubre la telemetría configurada de sidecar/waypoint. Cada ejemplo desarrollado es independiente y presupone que existen los backends, namespaces, permisos y tráfico indicados. Las comprobaciones de YAML/API/consulta no son pruebas de producción ni de clúster en vivo; ztunnel L4, sidecars nativos y despliegues HA necesitan su configuración de recopilación específica.
Preguntas de opción múltiple (1-5)
Pregunta 1: Métricas de Prometheus
¿Cuál no es un nombre/familia de métrica de servicio estándar de Istio?
A. istio_requests_total (recuento total de solicitudes)
B. istio_request_duration_milliseconds (latencia de solicitudes)
C. istio_request_bytes (tamaño de solicitud)
D. istio_pod_cpu_usage (uso de CPU del Pod)
Mostrar respuesta
Respuesta: D
Las métricas de servicio estándar de Istio describen el tráfico; Envoy también expone estadísticas internas del proxy. Prometheus obtiene el uso de CPU de contenedores desde kubelet/cAdvisor (o la canalización de recursos del runtime). Metrics Server proporciona métricas de recursos para el autoescalado y kubectl top; kube-state-metrics expone el estado de los objetos y las solicitudes/límites configurados, no el consumo de CPU medido.
Explicación:
Métricas recopiladas por Istio:
- istio_requests_total (A - O)
# Request rate by service (per second)
sum(rate(istio_requests_total{reporter="destination"}[5m])) by (destination_service_name, destination_service_namespace)- istio_request_duration_milliseconds (B - O)
# P95 latency
histogram_quantile(0.95,
  sum(rate(istio_request_duration_milliseconds_bucket{reporter="destination"}[5m])) by (le)
)- istio_request_bytes (C - O)
# Request body byte rate (bytes/second), not mean request size
sum(rate(istio_request_bytes_sum{reporter="destination"}[5m])) by (destination_service_name, destination_service_namespace)- istio_pod_cpu_usage (D - X)
- Esta no es una métrica de Istio
- Métrica de Kubernetes:
container_cpu_usage_seconds_total - Realiza scrape de kubelet/cAdvisor; kube-state-metrics es útil al comparar el uso con los límites configurados
Categorías de métricas de Istio:
| Categoría | Métrica de ejemplo | Descripción |
|---|---|---|
| Solicitud | istio_requests_total | Recuento de solicitudes, códigos de respuesta |
| Duración | istio_request_duration_milliseconds | Distribución de latencia |
| Tamaño | istio_request_bytes, istio_response_bytes | Tamaño del tráfico |
| TCP | istio_tcp_connections_opened_total | Conexiones TCP |
Ejemplos de Golden Signals:
# 1. Latency
histogram_quantile(0.95,
  sum(rate(
    istio_request_duration_milliseconds_bucket{reporter="destination",
      destination_service_name="reviews", destination_service_namespace="default"
    }[5m]
  )) by (le)
)

# 2. Traffic
sum(rate(
  istio_requests_total{reporter="destination",
    destination_service_name="reviews", destination_service_namespace="default"
  }[5m]
))

# 3. Errors (error rate)
sum(rate(
  istio_requests_total{reporter="destination",
    destination_service_name="reviews", destination_service_namespace="default",
    response_code=~"5.."
  }[5m]
))
/
sum(rate(
  istio_requests_total{reporter="destination",
    destination_service_name="reviews", destination_service_namespace="default"
  }[5m]
))

# 4. Saturation - Uses Kubernetes metrics
sum(rate(
  container_cpu_usage_seconds_total{
    namespace="default", container="istio-proxy", pod=~"reviews-.*"
  }[5m]
))
Comprobación de métricas:
# Check metrics via Envoy Admin API
istioctl x envoy-stats <pod-name>.default --output prom

# Check in Prometheus
kubectl port-forward -n istio-system svc/prometheus 9090:9090
# Query at http://localhost:9090
Referencia:
Pregunta 2: Trazado distribuido
Con un proveedor/backend de trazado operativo, ¿qué responsabilidad de la aplicación se requiere para unir los spans del proxy entre llamadas de servicio?
A. La aplicación debe generar IDs de traza
B. La aplicación debe propagar encabezados HTTP
C. El cliente Jaeger debe instalarse en todos los servicios
D. Envoy gestiona todo automáticamente
Mostrar respuesta
Respuesta: B
Los proxies configurados pueden generar spans e IDs de traza, pero la aplicación debe propagar el contexto de trazado a sus llamadas salientes. Un SDK debe inyectar el contexto activo, por lo que los IDs de span hijos pueden cambiar mientras el ID de traza permanece igual. Las aplicaciones transparentes sin sus propios spans pueden reenviar los encabezados de propagación seleccionados.
Explicación:
Cómo funciona el trazado distribuido:
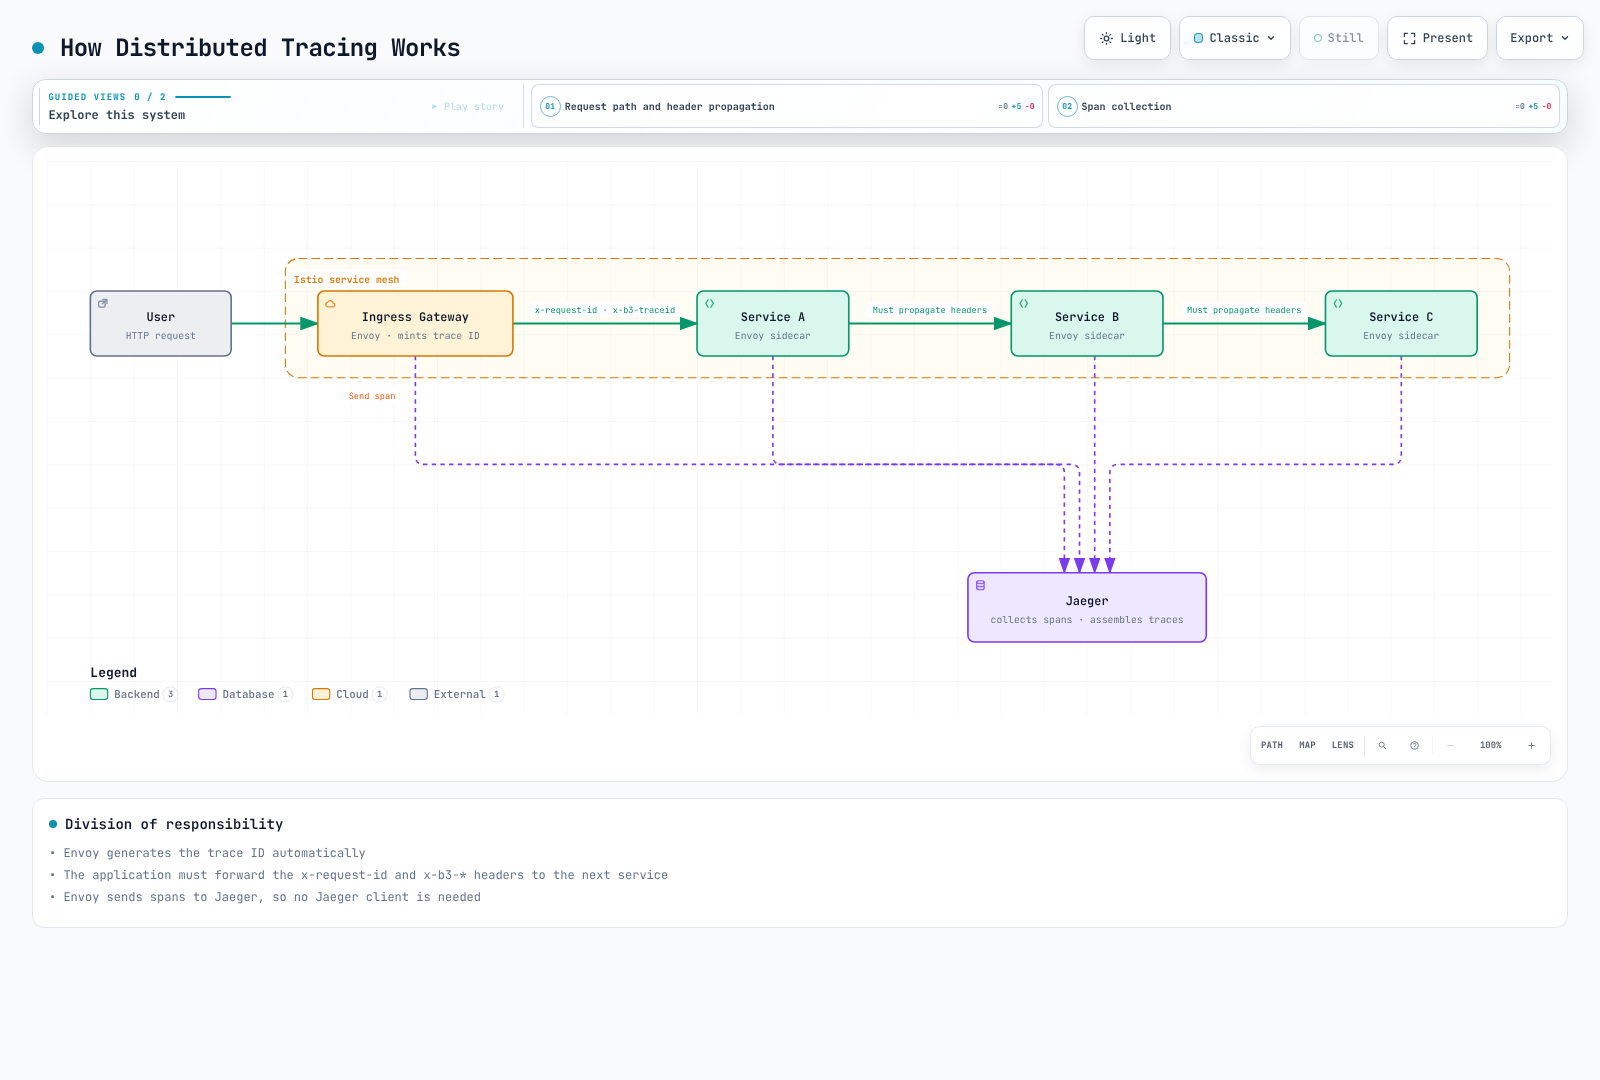
El diagrama ilustra la propagación B3 hacia un backend Jaeger configurado. También se admiten la propagación W3C y un OpenTelemetry Collector intermedio; las aplicaciones instrumentadas inyectan su contexto de span activo en vez de copiar todos los encabezados sin cambios.
Encabezados HTTP que se deben propagar:
W3C: traceparent, tracestate
B3 (if configured): b3 OR x-b3-traceid, x-b3-spanid, x-b3-parentspanid, x-b3-sampled
Istio correlation: x-request-id
B3 debug flag: x-b3-flags (do not force debug sampling on ordinary traffic)
Ejemplos de código de aplicación:
# Python Flask example
from flask import Flask, request
import requests

app = Flask(__name__)

@app.route('/api/users')
def get_users():
    # 1. Extract received headers
    headers = {}
    for header in ['x-request-id', 'traceparent', 'tracestate', 'b3', 'x-b3-traceid', 'x-b3-spanid',
                   'x-b3-parentspanid', 'x-b3-sampled', 'x-b3-flags']:
        if header in request.headers:
            headers[header] = request.headers[header]

    # 2. Propagate headers when calling next service
    response = requests.get(
        'http://user-service/users',
        headers=headers, timeout=3  # Selected propagation format
    )

    response.raise_for_status()
return response.json()// Node.js Express example
const express = require('express');
const axios = require('axios');
const app = express();
app.get('/api/users', async (req, res) => {
// 1. Extract received headers
const tracingHeaders = {};
['x-request-id', 'traceparent', 'tracestate', 'b3', 'x-b3-traceid', 'x-b3-spanid',
'x-b3-parentspanid', 'x-b3-sampled', 'x-b3-flags'].forEach(header => {
if (req.headers[header]) {
tracingHeaders[header] = req.headers[header];
}
});
// 2. Propagate headers when calling next service
try {
const response = await axios.get('http://user-service/users', {
headers: tracingHeaders, timeout: 3000
});
res.json(response.data);
} catch (error) {
res.status(502).json({error: 'Downstream request failed'});
}
});Análisis de cada opción:
- A (X): Envoy genera automáticamente IDs de traza
- B (O): La aplicación debe propagar encabezados HTTP (obligatorio)
- C (X): No se necesita cliente Jaeger, Envoy envía spans
- D (X): Envoy crea/envía spans, pero la propagación de encabezados es responsabilidad de la aplicación
Configuración de muestreo:
Esto presupone el proveedor otel-tracing del capítulo de trazado. 1.0 significa 1 %, no 100 %; la configuración del proveedor/exportador y la propagación de contexto son requisitos independientes.
apiVersion: telemetry.istio.io/v1
kind: Telemetry
metadata:
  name: tracing-sample
  namespace: default
spec:
  tracing:
  - providers:
    - name: otel-tracing
    randomSamplingPercentage: 1.0
Acceso a Jaeger:
kubectl port-forward -n observability svc/jaeger-query 16686:16686Referencia:
Pregunta 3: Visualización de Kiali
¿Qué funcionalidad NO proporciona Kiali?
A. Visualización de topología de servicios
B. Análisis de flujo de tráfico
C. Ejecución automática de despliegue Canary
D. Validación de configuración de Istio
Mostrar respuesta
Respuesta: C
Kiali es una herramienta de observación y análisis, mientras que la ejecución de despliegues la gestionan herramientas como Argo Rollouts.
Explicación:
Funciones principales de Kiali:
1. Visualización de topología de servicios (A - O)
# Open Kiali dashboard
istioctl dashboard kiali

# Features:
# - Real-time service connection display
# - Traffic flow direction display
# - Service status (healthy/error)
# - Response time display
Ejemplo de vista Graph:
Frontend → Backend → Database
   ↓
External API

Color codes:
- Green: Normal
- Red: Error
- Gray: No traffic
2. Análisis de flujo de tráfico (B - O)
Kiali muestra:
- Recuento de solicitudes (RPS)
- Tasa de errores (%)
- Latencia P50/P95/P99
- Recuento de conexiones TCP
3. Ejecución automática de despliegue Canary (C - X)
- Kiali puede mostrar tráfico y, con permiso, editar la configuración de Istio/usar asistentes de tráfico
- No sustituye a un controlador automatizado de entrega progresiva
- Ejecución de despliegue: Argo Rollouts, Flagger
4. Validación de configuración de Istio (D - O)
Ejemplos del catálogo de validación de Kiali:
- VirtualService: subset no definido (
KIA1107). - DestinationRule: definiciones host/subset superpuestas (
KIA0201). - AuthorizationPolicy: namespace referenciado no encontrado (
KIA0101), o principal no asociado a un ServiceAccount de workload detectado (KIA0106).
Las comprobaciones dependen de la versión de Kiali, el alcance de detección y el acceso. Inspecciona el código/mensaje real y la política efectiva del proxy; Kiali no demuestra que políticas arbitrarias entren en conflicto ni que todos los certificados y rutas de runtime funcionen.
Instalación de Kiali:
Sigue el capítulo de dashboards para el operador fijado, la autenticación y los límites de compatibilidad actuales. Kiali se instala por separado; los addons de ejemplo son demostraciones, y una instalación Helm sin configuración de backend/RBAC no es una configuración de producción.
Menús principales de Kiali:
1. Overview: Service summary by Namespace
2. Graph: Service topology
3. Applications: Application list
4. Workloads: Deployment, StatefulSet, etc.
5. Services: Kubernetes Service
6. Istio Config: VirtualService, DestinationRule, etc.
Kiali frente a otras herramientas:
| Herramienta | Función | Entrega progresiva automatizada |
|---|---|---|
| Kiali | Visualización, análisis, validación | No |
| Argo Rollouts | Entrega progresiva | Sí |
| Flagger | Despliegue Canary automático | Sí |
| Grafana | Dashboard de métricas | No |
| Jaeger | Trazado distribuido | No |
Ejemplo de uso práctico:
# 1. Check service topology in Kiali
istioctl dashboard kiali

# 2. Detect anomalies in Graph view
#    - reviews service error rate 5%
#    - productpage → reviews latency increase

# 3. Check details in Workload view
#    - Check reviews-v2 Pod logs
#    - Check Envoy metrics

# 4. Validate configuration in Istio Config view
#    - Found typo in VirtualService
#    - Fix and redeploy
Referencia:
Pregunta 4: Configuración de Access Log
¿Cómo se configura la salida de Access Log en formato JSON en Istio?
A. Establecer meshConfig.accessLogEncoding en JSON en IstioOperator
B. Modificar directamente Envoy ConfigMap
C. Añadir una anotación a cada Pod
D. Convertir a JSON mediante una consulta de Prometheus
Mostrar respuesta
Respuesta: A
A es un método MeshConfig válido: utiliza accessLogEncoding: JSON con el logging habilitado en una entrada de istioctl install -f. No es un recurso de operador dentro del clúster. Un proveedor personalizado envoyFileAccessLog.logFormat.labels es otro método admitido, descrito en el capítulo de logging.
Explicación:
Configuración de Access Log en formato JSON:
apiVersion: install.istio.io/v1alpha1
kind: IstioOperator
spec:
  meshConfig:
    # Enable Access Log
    accessLogFile: /dev/stdout

    # Output in JSON format
    accessLogEncoding: JSON

    # Define custom JSON format
    accessLogFormat: |
      {
        "log_type": "access",
        "start_time": "%START_TIME%",
        "method": "%REQ(:METHOD)%",
        "path": "%REQ_WITHOUT_QUERY(X-ENVOY-ORIGINAL-PATH?:PATH)%",
        "protocol": "%PROTOCOL%",
        "response_code": "%RESPONSE_CODE%",
        "response_flags": "%RESPONSE_FLAGS%",
        "bytes_received": "%BYTES_RECEIVED%",
        "bytes_sent": "%BYTES_SENT%",
        "duration": "%DURATION%",
        "upstream_service_time": "%RESP(X-ENVOY-UPSTREAM-SERVICE-TIME)%",
        "x_forwarded_for": "%REQ(X-FORWARDED-FOR)%",
        "user_agent": "%REQ(USER-AGENT)%",
        "request_id": "%REQ(X-REQUEST-ID)%",
        "authority": "%REQ(:AUTHORITY)%",
        "upstream_host": "%UPSTREAM_HOST%",
        "upstream_cluster": "%UPSTREAM_CLUSTER%",
        "upstream_local_address": "%UPSTREAM_LOCAL_ADDRESS%",
        "downstream_local_address": "%DOWNSTREAM_LOCAL_ADDRESS%",
        "downstream_remote_address": "%DOWNSTREAM_REMOTE_ADDRESS%",
        "requested_server_name": "%REQUESTED_SERVER_NAME%",
        "route_name": "%ROUTE_NAME%"
      }
Ejemplo de salida:
{
  "log_type": "access",
  "start_time": "2025-01-20T10:30:00.123Z",
  "method": "GET",
  "path": "/api/users",
  "protocol": "HTTP/1.1",
  "response_code": 200,
  "response_flags": "-",
  "bytes_received": 0,
  "bytes_sent": 1234,
  "duration": 42,
  "upstream_service_time": "40",
  "x_forwarded_for": "192.168.1.100",
  "user_agent": "Mozilla/5.0",
  "request_id": "abc-123-def",
  "authority": "example.com",
  "upstream_host": "10.0.1.20:8080",
  "upstream_cluster": "outbound|8080||backend.default.svc.cluster.local",
  "upstream_local_address": "10.0.1.10:54321",
  "downstream_local_address": "10.0.1.10:8080",
  "downstream_remote_address": "10.0.1.5:12345",
  "requested_server_name": "-",
  "route_name": "default"
}
Configuración por namespace:
Para esta alternativa, define primero mesh-json como en el capítulo de logging. Telemetry selecciona el proveedor/alcance; no cambia por sí mismo el formato de un proveedor.
apiVersion: telemetry.istio.io/v1
kind: Telemetry
metadata:
  name: access-logging
  namespace: production
spec:
  accessLogging:
  - providers:
    - name: mesh-json
    # Select the already-defined JSON provider
Variables de formato de Envoy:
# Key variables:
%START_TIME%: Request start time
%REQ(HEADER)%: Request header
%RESP(HEADER)%: Response header
%RESPONSE_CODE%: HTTP response code
%DURATION%: Total duration (ms)
%BYTES_RECEIVED%: Bytes received
%BYTES_SENT%: Bytes sent
%UPSTREAM_HOST%: Upstream server address
%DOWNSTREAM_REMOTE_ADDRESS%: Client address
Integración de CloudWatch Logs:
Esto es solo un fragmento de salida para un agente Fluent Bit ya desplegado con etiquetas de entrada coincidentes, análisis CRI/JSON, credenciales IAM y montajes de logs. Un ConfigMap por sí solo no recopila logs. EKS Fargate necesita su configuración de router de logs admitida.
apiVersion: v1
kind: ConfigMap
metadata:
  name: fluent-bit-config
  namespace: istio-system
data:
  output.conf: |
    [OUTPUT]
        Name cloudwatch_logs
        Match *
        region us-east-1
        log_group_name /aws/eks/istio/access-logs
        log_stream_prefix istio-
        auto_create_group true
Comprobación de logs:
# Check Pod's Access Log
kubectl logs <pod-name> -c istio-proxy

# Real-time monitoring
kubectl logs -f <pod-name> -c istio-proxy | jq -R 'fromjson?'

# Filter specific response codes
kubectl logs <pod-name> -c istio-proxy | \
  jq -R 'fromjson? | select((.response_code | tonumber?) == 500)'
Formato TEXT frente a formato JSON:
| Elemento | TEXT | JSON |
|---|---|---|
| Legibilidad | Alta (humana) | Baja (humana) |
| Análisis | Difícil | Fácil (máquina) |
| Tamaño | Pequeño | Grande |
| Estructura | No estructurada | Estructurada |
| Consulta | Difícil | Fácil (jq, etc.) |
Ejemplo de formato TEXT:
[2025-01-20T10:30:00.123Z] "GET /api/users HTTP/1.1" 200 - "-" "-" 0 1234 42 40 "192.168.1.100" "Mozilla/5.0" "abc-123-def" "example.com" "10.0.1.20:8080" outbound|8080||backend.default.svc.cluster.local 10.0.1.10:54321 10.0.1.10:8080 10.0.1.5:12345 - defaultReferencia:
Pregunta 5: Dashboards de Grafana
¿Qué dashboard no forma parte del conjunto publicado de dashboards de Grafana de Istio?
A. Istio Service Dashboard
B. Istio Workload Dashboard
C. Istio Performance Dashboard
D. Istio Cost Dashboard
Mostrar respuesta
Respuesta: D
D. Istio publica dashboards de tráfico/control plane, pero Grafana es un addon independiente; instalar Istio no instala automáticamente estos dashboards.
Explicación:
El catálogo 1.31 incluye Service7636, Workload7630, Mesh7639, Performance11829, Control Plane7645, Wasm13277 y Ztunnel21306. Performance se centra en el uso de recursos/datos; los paneles xDS/webhook pertenecen principalmente a Control Plane. Mesh incluye tráfico global y versiones de componentes, no todos los paneles de latencia que se enumeraban anteriormente aquí. Selecciona la revisión que coincida con la versión de Istio instalada.
El coste no se puede calcular multiplicando istio_requests_total por un precio de transferencia GB: las solicitudes no son bytes, y source_cluster/destination_cluster identifican clústeres en lugar de Availability Zones. La memoria del proxy es uso, no una factura. El cálculo de costes de red necesita mediciones de bytes facturables y reglas de ubicación/servicio de origen/destino reales; la asignación de costes de recursos necesita precios de nodos, tiempo y un modelo de asignación explícito. Concilia las estimaciones con los datos de facturación/CUR de AWS y los precios aplicables en vez de afirmar una fórmula fija.
Usa el capítulo de dashboards para revisiones de catálogo verificadas y ejemplos completos de JSON/provisioning personalizados. Los ConfigMaps y las etiquetas por sí solos no instalan un cargador de dashboards ni resuelven las entradas de datasource.
Preguntas de respuesta corta (6-10)
Pregunta 6: Monitorización de Golden Signals
Explica cómo monitorizar las Golden Signals (Latency, Traffic, Errors, Saturation) de Google SRE utilizando Istio y Prometheus. Incluye consultas de Prometheus y reglas de alerta para cada señal.
Mostrar respuesta
Usa un reporter por cálculo de salto de servicio y conserva el namespace de servicio (más el clúster donde corresponda). Las métricas destination miden las solicitudes recibidas por el servicio; las métricas source se necesitan para los fallos upstream que nunca llegan. HTTP5xx es solo una definición de error; los fallos gRPC requieren grpc_response_status y reglas SLI específicas de la aplicación. La siguiente latencia está en milisegundos y las tasas son por segundo:
histogram_quantile(0.95, sum by (destination_service_name, destination_service_namespace, le) (rate(istio_request_duration_milliseconds_bucket{reporter="destination"}[5m])))

histogram_quantile(0.99, sum by (destination_service_name, destination_service_namespace, le) (rate(istio_request_duration_milliseconds_bucket{reporter="destination"}[5m])))

sum by (destination_service_name, destination_service_namespace) (rate(istio_requests_total{reporter="destination"}[5m]))

sum by (destination_service_name, destination_service_namespace) (rate(istio_requests_total{reporter="destination",response_code=~"5.."}[5m])) / sum by (destination_service_name, destination_service_namespace) (rate(istio_requests_total{reporter="destination"}[5m]))
Para un despliegue clásico de sidecar de un solo clúster, las proporciones de uso/límite requieren kubelet/cAdvisor y kube-state-metrics. Excluye los límites ausentes/cero. Los sidecars nativos pueden informar límites declarados en series de recursos de init-container; confirma la familia de métricas real antes de usar estas expresiones:
sum by (namespace, pod, container) (rate(container_cpu_usage_seconds_total{container="istio-proxy"}[5m])) / on (namespace, pod, container) (max by (namespace, pod, container) (kube_pod_container_resource_limits{container="istio-proxy",resource="cpu",unit="core"}) > 0)

max by (namespace, pod, container) (container_memory_working_set_bytes{container="istio-proxy"}) / on (namespace, pod, container) (max by (namespace, pod, container) (kube_pod_container_resource_limits{container="istio-proxy",resource="memory",unit="byte"}) > 0)

envoy_cluster_upstream_cx_active
envoy_cluster_upstream_rq_pending_active
envoy_cluster_circuit_breakers_default_cx_open
La métrica _cx_open es un gauge de estado 0/1; dividir las conexiones activas por ella no es utilización. Inspecciona los umbrales de circuit breaker configurados cuando se requieran proporciones de capacidad. La tasa de CPU son cores antes de la división; el working set de memoria son bytes antes de la división. Un desglose por método requiere añadir primero una etiqueta Telemetry request_method acotada.
La siguiente PrometheusRule debe ser seleccionada por el Prometheus Operator instalado. Los umbrales y ventanas de comparación son ilustrativos; la estacionalidad del tráfico, la ausencia de datos, el fallo de scrape y una condición de volumen mínimo necesitan un manejo específico del entorno. Una ventana anterior de una hora no es una línea base normal aprendida.
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: istio-golden-signals
  namespace: monitoring
spec:
  groups:
  - name: golden-signals
    rules:
    - alert: HighLatency
      expr: histogram_quantile(0.95, sum by (destination_service_name, destination_service_namespace,
        le) (rate(istio_request_duration_milliseconds_bucket{reporter="destination"}[5m]))) > 500
      for: 5m
      labels:
        severity: warning
      annotations:
        summary: P95 request duration exceeds500ms
    - alert: TrafficSpike
      expr: sum by (destination_service_name, destination_service_namespace) (rate(istio_requests_total{reporter="destination"}[5m]))
        > 2 * sum by (destination_service_name, destination_service_namespace) (rate(istio_requests_total{reporter="destination"}[1h]
        offset 1h))
      for: 5m
      labels:
        severity: warning
      annotations:
        summary: Traffic exceeds the previous comparison window
    - alert: HighErrorRate
      expr: sum by (destination_service_name, destination_service_namespace) (rate(istio_requests_total{reporter="destination",response_code=~"5.."}[5m]))
        / sum by (destination_service_name, destination_service_namespace) (rate(istio_requests_total{reporter="destination"}[5m]))
        > 0.01
      for: 5m
      labels:
        severity: warning
      annotations:
        summary: HTTP5xx fraction exceeds1%
    - alert: HighEnvoyCPU
      expr: sum by (namespace, pod, container) (rate(container_cpu_usage_seconds_total{container="istio-proxy"}[5m]))
        / on (namespace, pod, container) (max by (namespace, pod, container) (kube_pod_container_resource_limits{container="istio-proxy",resource="cpu",unit="core"})
        > 0) > 0.8
      for: 5m
      labels:
        severity: warning
      annotations:
        summary: Proxy CPU consumption exceeds80% of its configured limit
    - alert: HighEnvoyMemory
      expr: max by (namespace, pod, container) (container_memory_working_set_bytes{container="istio-proxy"})
        / on (namespace, pod, container) (max by (namespace, pod, container) (kube_pod_container_resource_limits{container="istio-proxy",resource="memory",unit="byte"})
        > 0) > 0.8
      for: 5m
      labels:
        severity: warning
      annotations:
        summary: Proxy working set exceeds80% of its configured limit
    - alert: ConnectionBreakerAtCapacity
      expr: envoy_cluster_circuit_breakers_default_cx_open == 1
      for: 5m
      labels:
        severity: warning
      annotations:
        summary: Connection breaker at capacity
Crea paneles separados para tasa de solicitudes, fracción de error, latencia y unidades de recursos utilizando la plantilla de dashboard comprobada. No coloques cores de CPU y bytes de memoria en una escala compartida sin etiqueta.
Pregunta 7: Búsqueda de cuellos de botella de rendimiento con Jaeger
Explica cómo utilizar la herramienta de trazado distribuido Jaeger para encontrar cuellos de botella de rendimiento en una arquitectura de microservicios. Incluye métodos de análisis de Trace y escenarios prácticos de depuración.
Mostrar respuesta
Comienza con la configuración de trazado Jaeger2/OTLP, un proveedor Telemetry configurado y la propagación de contexto de la aplicación. No presupongas que un addon Jaeger/puerto Zipkin antiguo o solo un valor de muestreo despliegan el trazado. Los spans de aplicación/base de datos requieren instrumentación de SDK o agente; los spans de proxy no pueden revelar los detalles internos de una consulta de base de datos.
- Localiza el servicio/ventana de tiempo afectados con una consulta de latencia de Prometheus con alcance de namespace y, después, encuentra trazas lentas y normales representativas en Jaeger. Una consulta de histograma de Prometheus devuelve estadísticas agregadas, no IDs de traza.
- Sigue la ruta crítica y distingue la duración padre del tiempo exclusivo. Un padre largo incluye sus hijos; no es automáticamente la causa.
- Compara errores, reintentos, espera de conexión, ejecución de consultas y paralelismo. La temporización de trazas, el muestreo y los spans ausentes limitan las conclusiones.
histogram_quantile(0.99, sum by (destination_service_name, destination_service_namespace, le) (rate(istio_request_duration_milliseconds_bucket{reporter="destination"}[5m]))) > 2000kubectl port-forward -n observability svc/jaeger-query 16686:16686Estos son escenarios hipotéticos de depuración, no resultados de benchmark ni respuestas literales de la API de Jaeger:
| Observación | Qué verificar | Respuesta adecuada |
|---|---|---|
| Solicitud de2.1s, con operación de base de datos instrumentada de1.8s | Separa la espera de pool, el tiempo de consulta, los bloqueos y el retraso de red; verifica el plan de ejecución de DB | Corrige la causa medida. Un ConfigMap llamado redis.conf no añade caché de aplicación |
| Solicitud de~10s con timeout de pool de conexiones | Inspecciona el pool de cliente DB de la aplicación, la concurrencia y la capacidad de DB | Ajusta el pool de aplicación/DB y corrige fugas; un Envoy DestinationRule no configura el pool de aplicación, y la configuración de pool HTTP no ajusta PostgreSQL |
| Llamadas independientes2s+2s+1s se ejecutan secuencialmente | Confirma dependencias, límites de carga y contexto de trazado | Paraleliza solo I/O independiente con clientes asíncronos reales o threads acotados; el tiempo esperado puede acercarse a la llamada más larga más overhead, no a2s garantizados |
Para callbacks de I/O síncrono existentes, este fragmento de Python3.9+ conserva el orden de retorno y utiliza threads de trabajo. La aplicación debe proporcionar callbacks y aplicar sus propios timeouts; cancelar la tarea en espera no detiene un thread que ya se está ejecutando:
import asyncio

async def get_user_data(user_id):
    # Application-owned synchronous I/O functions; each must enforce its timeout.
    profile, orders, recommendations = await asyncio.gather(
        asyncio.to_thread(call_backend_a, user_id),
        asyncio.to_thread(call_backend_b, user_id),
        asyncio.to_thread(call_backend_c, user_id),
    )
    return merge(profile, orders, recommendations)
Los timeouts limitan la espera; no reparan una base de datos lenta, y los reintentos pueden amplificar la carga. Al mostrar un timeout de VirtualService, incluye el destino de ruta real y utiliza reintentos solo teniendo en cuenta la idempotencia/carga. Los mapas de dependencias persistentes de Jaeger pueden requerir agregación adicional; una cascada de una sola traza y un mapa de dependencias global son vistas distintas. Valida una corrección sospechada con tráfico repetido y métricas/trazas, no solo con una traza atractiva.
Pregunta 8: Solución de problemas de Service Mesh con Kiali
Explica cómo diagnosticar y resolver problemas comunes (errores de configuración, anomalías de tráfico, conflictos de políticas de seguridad) en el service mesh de Istio usando Kiali.
Mostrar respuesta
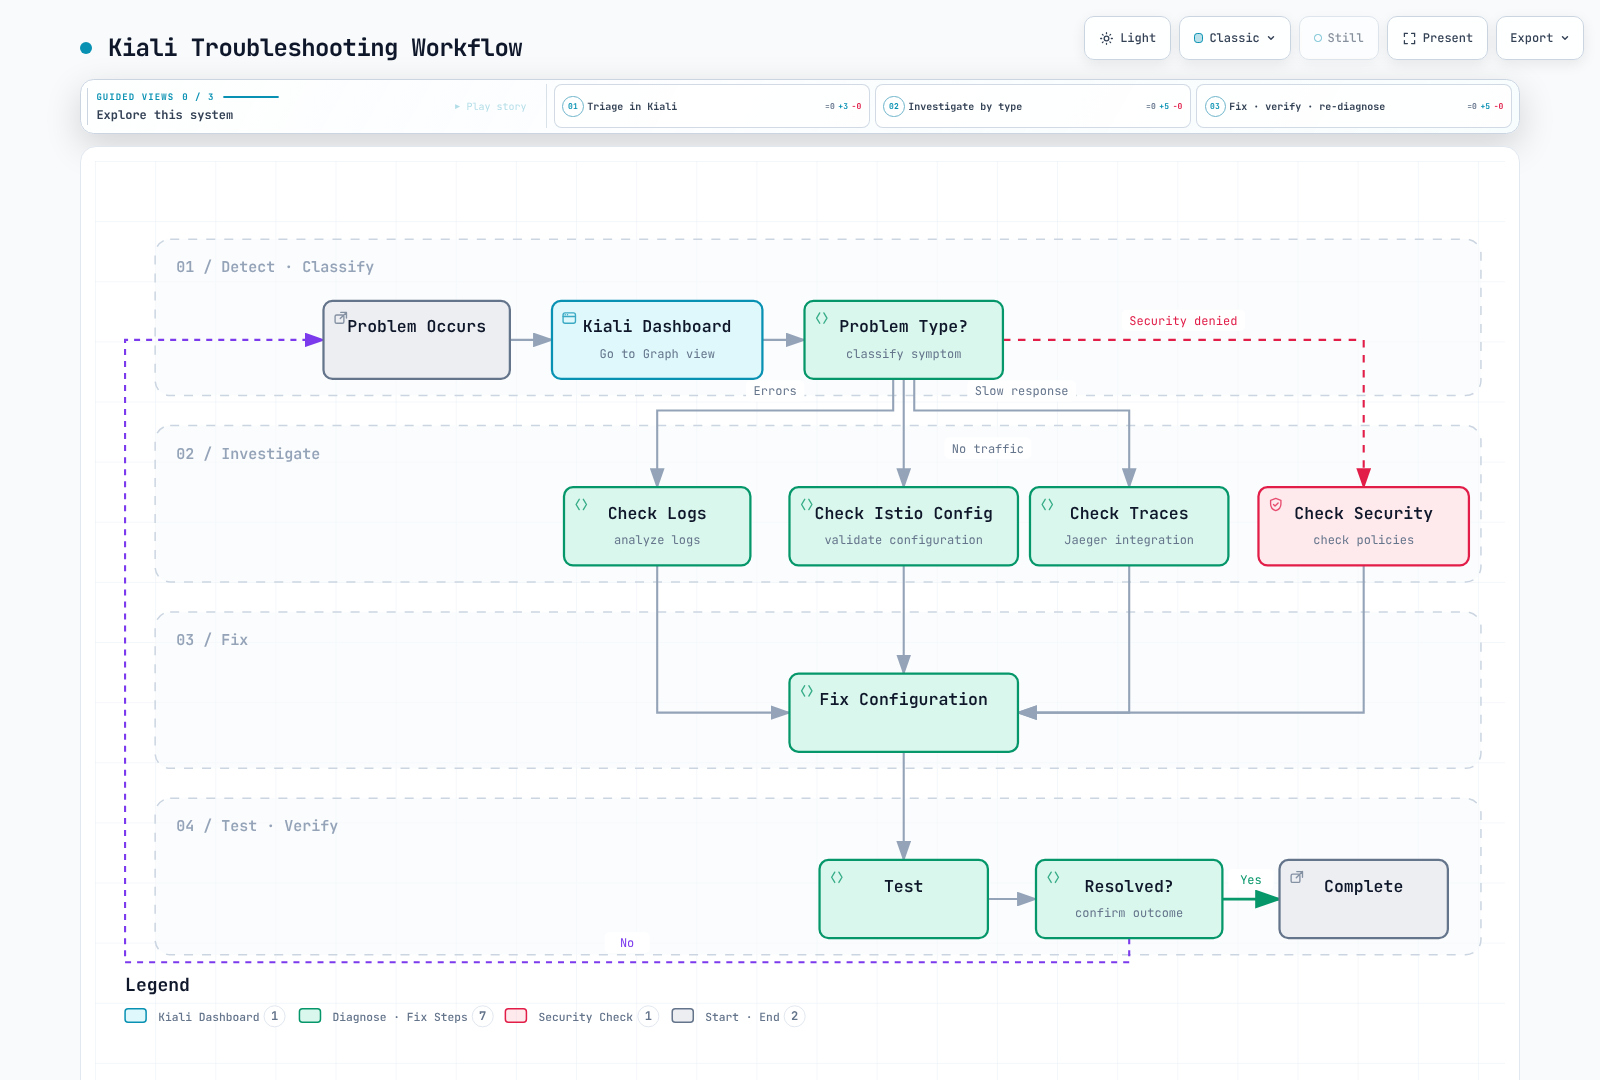
Utiliza las comprobaciones de configuración de Kiali, el tráfico observado, los logs de Pod y las trazas como evidencia y, después, verifica la configuración efectiva del proxy. El capítulo de dashboards documenta los requisitos previos de versión/autenticación. No inventes una advertencia de Kiali a partir de la forma de un gráfico ni trates un icono verde como una garantía de runtime.
| Síntoma | Interpretación y comprobaciones correctas |
|---|---|
| Servicio/subset ausente | En default, reviews y reviews.default.svc.cluster.local se resuelven al mismo host. Acortar el nombre no crea un Service ausente. KIA1107 identifica un subset no definido; comprueba Service/EndpointSlice, DestinationRule y las etiquetas reales del Pod |
| Desajuste de etiqueta de subset | El valor de etiqueta1.0 no es intrínsecamente incorrecto; haz coincidir las etiquetas de Deployment previstas con el subset. Incluye metadata, host y separadores de documentos al escribir DestinationRules completos |
| Se observa90/10 en vez de50/50 configurado | Comprueba los pesos efectivos, las reglas coincidentes, la afinidad de conexión, los reintentos, el estado de endpoint/ejection y la ventana de tiempo. Menos réplicas listas por sí solas no redefine los pesos de subset de VirtualService ni garantiza una división posterior50/50 |
| Ciclo A↔B | Un gráfico bidireccional no prueba llamadas recursivas, deadlock ni una alerta automática de Kiali. Usa una traza para identificar un ciclo no deseado real antes de rediseñar la aplicación |
| HTTP403 | Inspecciona la política, identidad y detalles de respuesta del proxy que aplica. AuthorizationPolicy con spec vacío es una política ALLOW sin reglas coincidentes; otra ALLOW puede proporcionar una excepción. No es un DENY que anula |
| Fallo mTLS | PeerAuthentication describe al receptor. Comprueba la configuración TLS del emisor, la política del receptor, la inscripción, el certificado/confianza y el protocolo de puerto para la dirección específica. Los distintos modos de receptor no son automáticamente un conflicto; STRICT generalizado es una decisión de migración, no una corrección genérica |
Una línea base scoped de denegación predeterminada con una excepción frontend es válida, suponiendo que mTLS proporciona el principal frontend nombrado y ningún CUSTOM/DENY anterior rechaza la solicitud:
apiVersion: security.istio.io/v1
kind: AuthorizationPolicy
metadata:
  name: backend-default-deny
  namespace: default
spec:
  selector:
    matchLabels:
      app: backend
---
apiVersion: security.istio.io/v1
kind: AuthorizationPolicy
metadata:
  name: backend-allow-frontend
  namespace: default
spec:
  selector:
    matchLabels:
      app: backend
  action: ALLOW
  rules:
  - from:
    - source:
        principals:
- cluster.local/ns/default/sa/frontendkubectl get service reviews -n default
kubectl get endpointslice -n default -l kubernetes.io/service-name=reviews
kubectl get pods -n default -l app=reviews --show-labels
istioctl analyze -n default
istioctl proxy-config clusters <source-pod> -n default --fqdn reviews.default.svc.cluster.local -o json
istioctl x authz check <backend-pod>.defaultLa animación de tráfico resume una ventana seleccionada; no es una inspección de paquetes exacta en bytes. Repite el ciclo de diagnóstico/configuración/prueba si falla la hipótesis en vez de reiniciar workloads a ciegas.
Pregunta 9: Configuración de la pila de observabilidad de producción
Explica cómo desplegar la pila de observabilidad de Istio (Prometheus, Grafana, Jaeger, Kiali) en configuración de High Availability (HA) para un clúster Kubernetes de producción. Incluye estrategias de almacenamiento persistente, escalado y backup.
Mostrar respuesta
Una pila HA de producción es una tarea de diseño y verificación específica del entorno. Lo siguiente cubre los requisitos principales; no es un paquete de despliegue probado en producción. Fija versiones compatibles de Kubernetes/Istio/operator/chart/backend, revisa los valores de chart realmente utilizados y valida el comportamiento de fallo y restauración antes del rollout. El capítulo de dashboards registra la brecha actual de compatibilidad de Kiali; no infieras la compatibilidad a partir de las versiones más recientes.
| Componente | Requisitos de estado y HA |
|---|---|
| Prometheus | Ejecuta réplicas independientes con un PVC por réplica, etiquetas de clúster compartidas por las réplicas de ese clúster y etiquetas de réplica distintas (las demás etiquetas deben coincidir para la deduplicación). Distribuye los dominios de fallo y dimensiona la retención para la ingesta observada. Un load balancer no fusiona sus historiales |
| Thanos | Los sidecars exponen StoreAPI y opcionalmente cargan bloques; Query descubre endpoints StoreAPI reales y deduplica la etiqueta de réplica configurada. Store Gateway lee almacenamiento de objetos; Compactor gestiona la compactación/retención de bloques con una propiedad adecuada de escritor único/sharding |
| Grafana | Dos réplicas requieren una base de datos HA PostgreSQL/MySQL compartida, configuración coherente de provisioning/plugins/secrets y un load balancer. Dos réplicas que comparten SQLite o un volumen EBS ReadWriteOnce entre nodos no son Grafana HA |
| Alertmanager | Las réplicas necesitan configuración de deduplicación de pares/notificaciones, estado persistente y credenciales de receptor protegidas; colocar un webhook de Slack en valores de chart no es un diseño completo de secrets/notificaciones |
| Jaeger2/collector | Utiliza réplicas stateless de query/collector con un backend duradero admitido y su propio HA/TLS/credenciales. Los tail samplers necesitan afinidad de trace-ID; múltiples réplicas detrás de un Service aleatorio no reciben trazas completas |
| Kiali | Utiliza un operator/server compatible, comportamiento compartido de configuración/session-secret y ubicación de Pod adecuada. Protege las API de backend y los permisos de namespace del usuario. La estrategia de token es de un solo clúster; elige autenticación multiclúster documentada cuando sea necesaria |
Almacenamiento y conexión de object store:
- Conserva la persistencia local de Prometheus incluso con object storage: los datos recientes de head/WAL pueden no haberse cargado aún. Para las cargas de sidecar, sigue los requisitos de compactación local/duración de bloque de la versión de Thanos instalada.
- Deben existir bucket S3, endpoint regional, cifrado, retención y permisos IAM. Vincula el ServiceAccount con credenciales a los Pods que ejecutan realmente sidecar/Store/Compactor. Un comentario YAML que dice “IRSA” no crea credenciales. La configuración actual de S3 de Thanos puede usar
aws_sdk_auth: truecon la cadena de credenciales AWS SDK admitida. - En los valores actuales de kube-prometheus-stack, un Secret de object store existente se selecciona bajo
prometheus.prometheusSpec.thanos.objectStorageConfig.existingSecretcon el nombre/clave reales. Montar la clavethanos.yamlno crea un archivo llamadoobjstore.yaml. Verifica las rutas de archivo, los puertos gRPC de Service nombrados y los destinos DNS-SRV. - Thanos Query actual utiliza
--endpointy--query.replica-labelpara la configuración de endpoint/deduplicación. No arrastres un ejemplo antiguo de--storesin comprobar la versión elegida. Kiali que consulta un backend compatible con Prometheus también puede necesitar los ajustesthanos_proxydocumentados. - Cada Deployment/StatefulSet necesita selectors/etiquetas de Pod y Services coincidentes; los recursos incompletos originales no podían formar una topología StoreAPI funcional. En EKS, el estado respaldado por EBS necesita configuración EC2/CSI y ubicación admitidas; Fargate no monta EBS ni ejecuta DaemonSets arbitrarios.
Configuración, backup y demostración:
- Configura los selectors de monitor/reglas y los objetivos de scrape reales. En kube-prometheus-stack,
alertmanager.configes hermano dealertmanager.alertmanagerSpec; verifica el esquema del chart fijado. Conserva contraseñas/webhooks en referencias Secret admitidas. - Haz backup de la base de datos/configuración/dashboards provisionados/plugins de Grafana, del estado de Prometheus según sea necesario y del almacenamiento de Jaeger mediante procedimientos consistentes con la aplicación. La retención de object store por sí sola no es una estrategia de restauración para todos los componentes.
- Los manifiestos Velero PVC/PV por sí solos no demuestran que se capturaron datos de volumen. Configura la ruta admitida de snapshot/data-mover CSI o de backup de sistema de archivos, clases/plugins de snapshot, credenciales y los recursos necesarios para restaurar workloads. Inspecciona el estado de backup y realiza restauraciones aisladas.
- Un Job de backup debe tener una imagen probada que contenga las herramientas requeridas, URL de origen correcta, identidad con alcance limitado, bucket de destino y gestión de fallos. La antigua imagen AWS CLI/CronJob supuesto con curl+jq/S3 no era una solución de backup verificada.
- Monitoriza fallos de receiver/exporter, colas, salud de scrape y métricas reales de capacidad PVC.
prometheus_tsdb_storage_blocks_bytes_totalno es un denominador de capacidad válido. Una pila no puede informar de forma fiable su propia caída total; usa un heartbeat/observador independiente y maneja las series ausentes/sin datos por separado deup == 0. - Prueba la pérdida de una réplica/nodo/zona, la interrupción de almacenamiento, el fallo de backend/autenticación, rollout y restauración. Los PDB ayudan con la interrupción planificada; no crean HA de base de datos ni de nivel de zona. Registra RPO/RTO y la capacidad observada en vez de afirmarlos a partir de recuentos de réplicas.
Consulta Grafana HA, Thanos Sidecar, Thanos Query, Thanos storage y Velero CSI backup.
Pregunta 10: Métricas personalizadas y creación de dashboards
Explica cómo recopilar métricas de negocio (por ejemplo, recuento de pedidos, tasa de éxito de pago) más allá de las métricas predeterminadas recopiladas por Istio Envoy, y crear un dashboard personalizado de Grafana.
Mostrar respuesta
Define el evento de negocio y el límite de recuento antes de elegir métricas. Envoy conoce las solicitudes, no si un pedido se creó de forma duradera o un pago se liquidó. Los siguientes fragmentos de integración cuentan intentos de procesamiento completados, no pedidos únicos ni ingresos contables. La aplicación debe proporcionar sus funciones de procesamiento/contrato de error, idempotencia y validación. Para una métrica de éxito de pago real, instrumenta los resultados de pago en el límite de pago y deriva una proporción de contadores de resultados; un Gauge sin mantenimiento no es una tasa de éxito.
Usa etiquetas de categoría/estado acotadas, un Counter para intentos e Histograms para importes/duración no negativos. Observa la duración en finally para que se incluyan los fallos. No etiquetes métricas con IDs de pedido, IDs de usuario ni URL sin procesar. Estos ejemplos son de proceso único; la agregación multi-worker necesita la configuración admitida por la biblioteca cliente.
Python/Flask (la aplicación proporciona process_order y PaymentException):
from flask import Flask, request, jsonify, Response
from prometheus_client import Counter, Histogram, generate_latest, CONTENT_TYPE_LATEST
import time

# Integration fragment: your application supplies process_order and PaymentException.
# process_order returns a validated nonnegative USD amount and category after processing.
app = Flask(__name__)
CATEGORIES = {"books", "electronics", "other"}
STATUSES = ("success", "payment_failed", "error")
orders_total = Counter("orders_total", "Completed order-processing attempts", ["status", "product_category"])
order_amount = Histogram("order_amount_dollars", "Observed amounts of successful attempts in USD",
                         buckets=[10, 50, 100, 500, 1000, 5000])
order_duration = Histogram("order_processing_duration_seconds", "Order attempt duration, including failures",
                           buckets=[0.1, 0.5, 1.0, 2.0, 5.0])
for status in STATUSES:
    for category in CATEGORIES:
        orders_total.labels(status=status, product_category=category).inc(0)

@app.post("/api/orders")
def create_order():
    payload = request.get_json()
    started = time.perf_counter()
    try:
        order = process_order(payload)
        category = order["category"] if order["category"] in CATEGORIES else "other"
        orders_total.labels(status="success", product_category=category).inc()
        order_amount.observe(order["amount"])
        return jsonify(order), 201
    except PaymentException:
        orders_total.labels(status="payment_failed", product_category="other").inc()
        return jsonify({"error": "Payment failed"}), 400
    except Exception:
        orders_total.labels(status="error", product_category="other").inc()
        return jsonify({"error": "Order processing failed"}), 500
    finally:
        order_duration.observe(time.perf_counter() - started)

@app.get("/metrics")
def metrics():
    return Response(generate_latest(), content_type=CONTENT_TYPE_LATEST)

# Use the application's server lifecycle. Do not treat a Flask development server
# or process-local counters as a production accounting system.Node.js/Express: el paquete mantenido es @prometheus-io/client (API de ejemplo comprobada con 0.16.1 en Node 22). prom-client está obsoleto en favor de este paquete; los proyectos existentes deben revisar el changelog de migración. Configura el middleware JSON y espera register.metrics():
const express = require('express');
const client = require('@prometheus-io/client'); // Example verified with 0.16.1, Node 22
const app = express();
app.use(express.json());
const register = new client.Registry();
const categories = new Set(['books', 'electronics', 'other']);
const ordersTotal = new client.Counter({
  name: 'orders_total', help: 'Completed order-processing attempts',
  labelNames: ['status', 'product_category'], registers: [register]
});
const orderAmount = new client.Histogram({
  name: 'order_amount_dollars', help: 'Observed successful attempt amounts in USD',
  buckets: [10, 50, 100, 500, 1000, 5000], registers: [register]
});
const orderDuration = new client.Histogram({
  name: 'order_processing_duration_seconds', help: 'Order attempt duration, including failures',
  buckets: [0.1, 0.5, 1, 2, 5], registers: [register]
});
for (const status of ['success', 'payment_failed', 'error']) {
  for (const product_category of categories) ordersTotal.inc({status, product_category}, 0);
}
// The application supplies async processOrder with validated amount/category output.
app.post('/api/orders', async (req, res) => {
  const end = orderDuration.startTimer();
  try {
    const order = await processOrder(req.body);
    const product_category = categories.has(order.category) ? order.category : 'other';
    ordersTotal.inc({status: 'success', product_category});
    orderAmount.observe(order.amount);
    res.status(201).json(order);
  } catch (error) {
    const status = error.code === 'PAYMENT_FAILED' ? 'payment_failed' : 'error';
    ordersTotal.inc({status, product_category: 'other'});
    res.status(status === 'payment_failed' ? 400 : 500).json({error: 'Order processing failed'});
  } finally {
    end();
  }
});
app.get('/metrics', async (req, res) => {
  try {
    res.set('Content-Type', register.contentType);
    res.end(await register.metrics());
  } catch (error) {
    res.status(500).end();
  }
});
// Integrate app.listen/shutdown with the application's server lifecycle.
Recopilación de Kubernetes: este laboratorio sidecar utiliza el endpoint fusionado de Istio para no asumir que un scrape de aplicación de texto plano pasará mTLS STRICT. Fusiona estas etiquetas/anotaciones en el Deployment order-service real en default; su imagen debe contener la aplicación y exponer /metrics en8080. El mesh debe tener habilitada la fusión de Prometheus. El endpoint agent15020 es cleartext, así que restringe el acceso de red. Si un scraper existente ya recopila estas métricas de negocio, no añadas un monitor duplicado.
spec:
  template:
    metadata:
      labels:
        app: order-service
      annotations:
        prometheus.io/scrape: 'true'
        prometheus.io/path: /metrics
        prometheus.io/port: '8080'
prometheus.istio.io/merge-metrics: 'true'apiVersion: v1
kind: Service
metadata:
name: order-service
namespace: default
labels:
app: order-service
spec:
selector:
app: order-service
ports:
- name: http
port: 8080
targetPort: 8080
- name: merged-metrics
port: 15020
targetPort: 15020
---
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
name: order-service-metrics
namespace: istio-system
spec:
namespaceSelector:
matchNames:
- default
selector:
matchLabels:
app: order-service
targetLabels:
- app
endpoints:
- port: merged-metrics
path: /stats/prometheus
interval: 30s
metricRelabelings:
- sourceLabels:
- __name__
regex: orders_total|order_amount_dollars_(bucket|sum|count)|order_processing_duration_seconds_(bucket|sum|count)
action: keepEl recurso Prometheus debe seleccionar el ServiceMonitor en istio-system; descubre el Service en default. Mantener solo las familias de métricas de negocio evita duplicar métricas de proxy ya recopiladas en otra parte. targetLabels añade explícitamente la etiqueta app del Service. Este es un ejemplo sidecar; el scraping ambient/TLS directo necesita su propio diseño admitido.
Consultas (en orden: recuento de intentos del intervalo, intentos/segundo, fracción de éxito, P95 de importe observado, P99 de duración, tasa por categoría, fracción de fallos de pago entre intentos de pedido):
sum(increase(orders_total{namespace="default",app="order-service"}[5m]))

sum(rate(orders_total{namespace="default",app="order-service"}[5m]))

sum(rate(orders_total{namespace="default",app="order-service",status="success"}[5m])) / sum(rate(orders_total{namespace="default",app="order-service"}[5m]))

histogram_quantile(0.95, sum by (le) (rate(order_amount_dollars_bucket{namespace="default",app="order-service"}[5m])))

histogram_quantile(0.99, sum by (le) (rate(order_processing_duration_seconds_bucket{namespace="default",app="order-service"}[5m])))

sum by (product_category) (rate(orders_total{namespace="default",app="order-service"}[5m]))

sum(rate(orders_total{namespace="default",app="order-service",status="payment_failed"}[5m])) / sum(rate(orders_total{namespace="default",app="order-service"}[5m]))
increase estima el total del intervalo; rate es por segundo. Los reinicios de proceso, los reintentos y los scrapes perdidos significan que los contadores/sumas de importes operativos no son un libro contable. Para pedidos únicos confirmados o ingresos, concilia con el sistema de negocio duradero en vez de asumir que la telemetría es exactamente una vez.
Grafana: este objeto de dashboard completo espera el UID de datasource prometheus y las etiquetas del monitor anterior. Guárdalo sin un wrapper de API y utiliza el provisioning documentado de archivos de dashboard. Una etiqueta ConfigMap por sí sola no configura un proveedor.
{
  "uid": "order-business-metrics",
  "title": "Order Processing Operational Metrics",
  "timezone": "browser",
  "panels": [
    {
      "id": 1,
      "title": "Completed Attempts per Minute",
      "type": "timeseries",
      "datasource": {
        "type": "prometheus",
        "uid": "prometheus"
      },
      "targets": [
        {
          "expr": "sum(rate(orders_total{namespace=\"default\",app=\"order-service\"}[5m])) * 60",
          "refId": "A"
        }
      ],
      "gridPos": {
        "x": 0,
        "y": 0,
        "w": 12,
        "h": 8
      }
    },
    {
      "id": 2,
      "title": "Attempt Success Fraction",
      "type": "gauge",
      "datasource": {
        "type": "prometheus",
        "uid": "prometheus"
      },
      "targets": [
        {
          "expr": "sum(rate(orders_total{namespace=\"default\",app=\"order-service\",status=\"success\"}[5m])) / sum(rate(orders_total{namespace=\"default\",app=\"order-service\"}[5m]))",
          "refId": "A"
        }
      ],
      "gridPos": {
        "x": 12,
        "y": 0,
        "w": 12,
        "h": 8
      },
      "fieldConfig": {
        "defaults": {
          "unit": "percentunit"
        }
      }
    },
    {
      "id": 3,
      "title": "Processing P95",
      "type": "timeseries",
      "datasource": {
        "type": "prometheus",
        "uid": "prometheus"
      },
      "targets": [
        {
          "expr": "histogram_quantile(0.95, sum by (le) (rate(order_processing_duration_seconds_bucket{namespace=\"default\",app=\"order-service\"}[5m])))",
          "refId": "A"
        }
      ],
      "gridPos": {
        "x": 0,
        "y": 8,
        "w": 12,
        "h": 8
      },
      "fieldConfig": {
        "defaults": {
          "unit": "s"
        }
      }
    },
    {
      "id": 4,
      "title": "Observed Successful Attempt Amount (Last Hour)",
      "type": "stat",
      "datasource": {
        "type": "prometheus",
        "uid": "prometheus"
      },
      "targets": [
        {
          "expr": "sum(increase(order_amount_dollars_sum{namespace=\"default\",app=\"order-service\"}[1h]))",
          "refId": "A"
        }
      ],
      "gridPos": {
        "x": 12,
        "y": 8,
        "w": 12,
        "h": 8
      },
      "fieldConfig": {
        "defaults": {
          "unit": "currencyUSD"
        }
      }
    }
  ],
  "time": {
    "from": "now-1h",
    "to": "now"
  },
  "refresh": "30s"
}Alertas: selecciona esta regla con el Prometheus Operator instalado. El umbral mínimo de tráfico evita una alerta de proporción sin tráfico; la ausencia/fallo de scrape necesita una señal separada. Los umbrales son ejemplos, no garantías de SLO de negocio.
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: business-metrics-alerts
  namespace: istio-system
spec:
  groups:
  - name: business-metrics
    rules:
    - alert: LowOrderAttemptSuccessFraction
      expr: (sum(rate(orders_total{namespace="default",app="order-service",status="success"}[5m])) / sum(rate(orders_total{namespace="default",app="order-service"}[5m]))
        < 0.95) and (sum(rate(orders_total{namespace="default",app="order-service"}[5m])) > 0.1)
      for: 5m
      labels:
        severity: warning
      annotations:
        summary: Order-processing attempt success fraction below95%
    - alert: SlowOrderProcessing
      expr: histogram_quantile(0.95, sum by (le) (rate(order_processing_duration_seconds_bucket{namespace="default",app="order-service"}[5m])))
        > 2
      for: 5m
      labels:
        severity: warning
      annotations:
        summary: P95 processing attempt duration exceeds2s
Consulta la documentación del cliente Python y del cliente JavaScript para tipos de métrica, exposición y modelos de proceso.
Cálculo de puntuación
- Opción múltiple 1-5: 10 puntos cada una (Total 50 puntos)
- Respuesta corta 6-10: 10 puntos cada una (Total 50 puntos)
- Total: 100 puntos
Criterios de evaluación:
- 90-100 puntos: Excelente comprensión de estos temas
- 80-89 puntos: Buena comprensión; la validación del despliegue sigue siendo independiente
- 70-79 puntos: Media (se recomienda aprendizaje adicional)
- 60-69 puntos: Por debajo de la media (se necesita revisión de conceptos básicos)
- 0-59 puntos: Se necesita volver a aprender