Observabilidad de Cilium Service Mesh
Última actualización: 11 de septiembre de 2026 · Cilium/chart 1.20.1 · Hubble CLI 1.19.4 · Collector Contrib 0.160.0 · Loki 3.7.7. Consulte la introducción para requisitos Kubernetes/EKS y plataforma.
Descripción general
Hubble expone observaciones del tráfico de Cilium. L3/L4 procede del datapath; HTTP requiere además una ruta proxy/política L7 compatible. Activarlo no descifra TLS arbitrario, descubre todas las dependencias ni genera trazas distribuidas de aplicaciones.
Los ejemplos suponen cargas preparadas en production y Cilium correctamente instalado. Aplique los límites de cifrado/ztunnel del capítulo de seguridad al interpretar la visibilidad.
Arquitectura Hubble
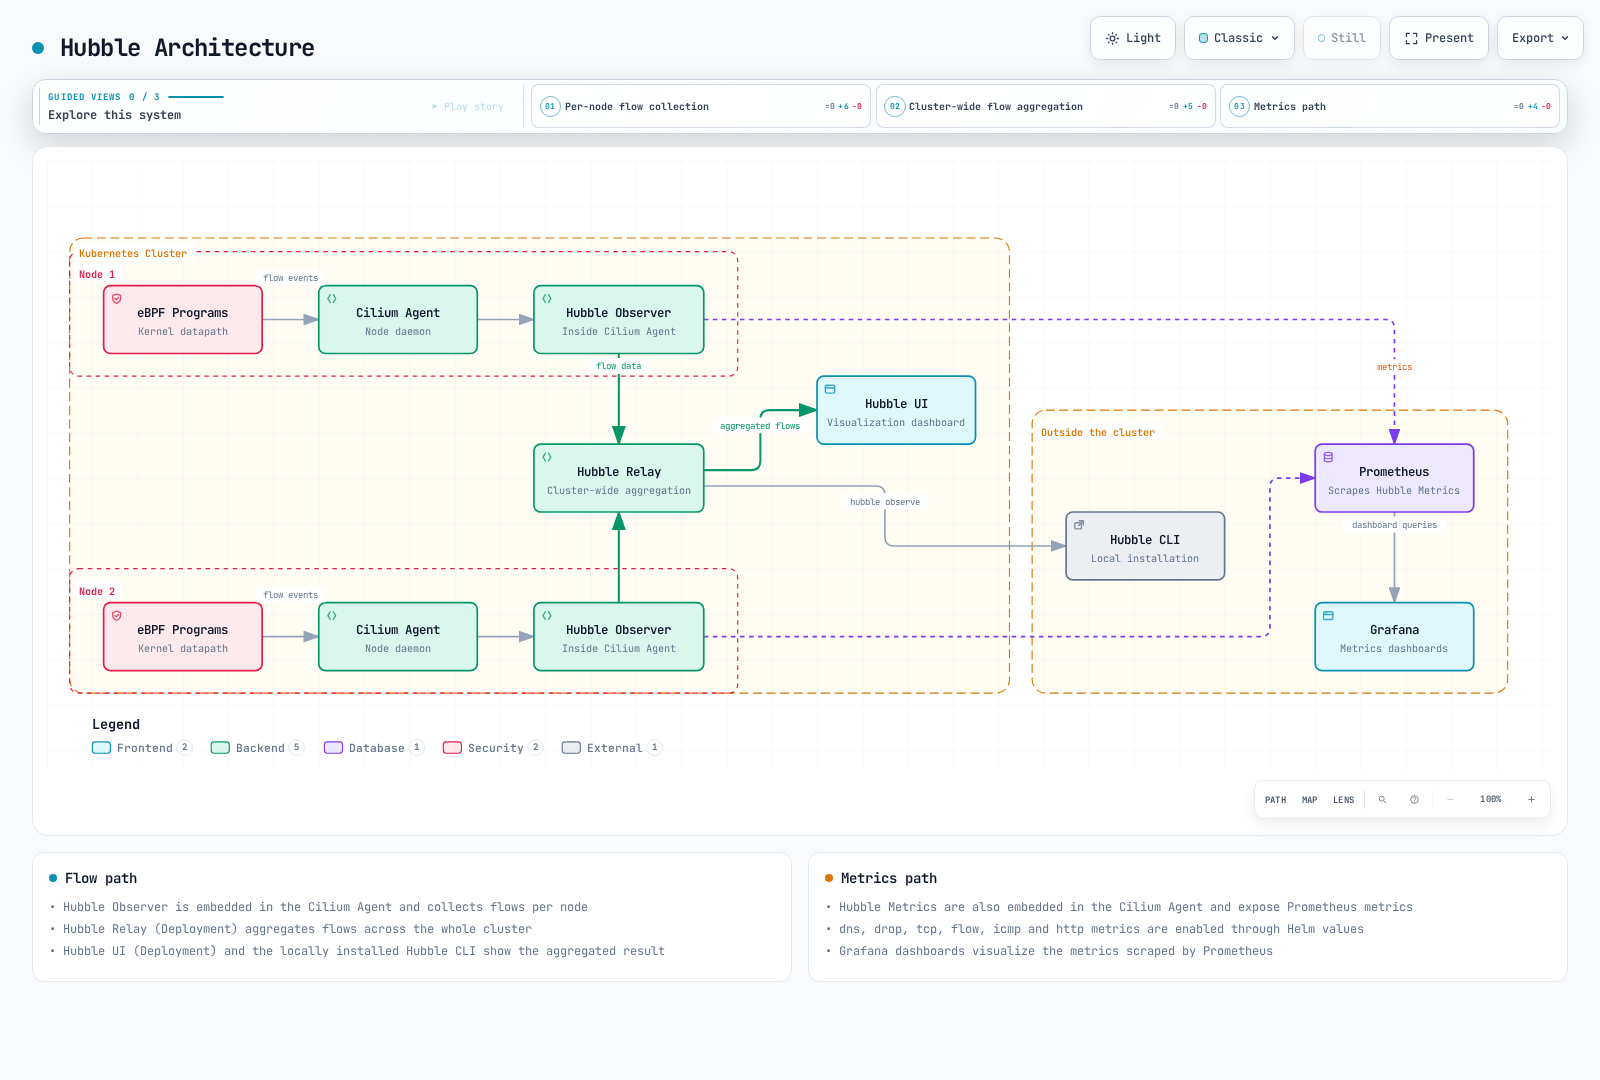
La figura agrupa componentes. Envoy también suministra eventos L7 donde está configurado; eBPF no es la única entrada HTTP. Prometheus recoge métricas aparte de la API de flujos Relay.
| Componente | Función |
|---|---|
| Observer del Agent Cilium | Guarda/sirve historial limitado por nodo |
| Hubble Relay | Agrega observaciones de servidores conectados |
| Hubble UI | Muestra relaciones y detalles observados |
| Hubble CLI | Consulta API o registros JSON exportados |
| Handlers de métricas | Transforman observaciones elegibles en métricas Prometheus |
El buffer no es un almacén de logs a largo plazo. Buffers llenos, nodos ausentes, errores de exportación y pérdidas se interpretan aparte de la salud de aplicación.
Instalación y configuración
Mediante Helm
Combine este overlay con los values revisados de Cilium 1.20.1. Publica métricas y activa Relay/UI mediante port-forward, pero no instala Prometheus, Grafana, Collector o Loki:
prometheus:
  enabled: true
hubble:
  enabled: true
  relay:
    enabled: true
    replicas: 1
    resources:
      requests:
        cpu: 100m
        memory: 128Mi
      limits:
        cpu: 1000m
        memory: 1024Mi
  ui:
    enabled: true
    replicas: 1
    ingress:
      enabled: false
  metrics:
    enabled:
    - dns
    - drop
    - tcp
    - flow
    - icmp
    - port-distribution
    - httpV2:labelsContext=source_namespace,source_workload,destination_namespace,destination_workload
  tls:
    enabled: true
    auto:
      enabled: true
      method: cronJob
      certValidityDuration: 365
      schedule: 0 0 1 */4 *
Los recursos son ejemplos, no resultados de dimensionamiento. Algunos cambios del agente requieren rollout controlado; inspeccione el render y procedimiento antes de aplicar.
El mTLS entre el servidor Hubble y Relay protege el transporte de observaciones. El ingreso de la interfaz, la API Relay orientada al cliente, los endpoints de métricas y el tráfico de aplicaciones tienen ajustes de TLS/autenticación separados. Una interfaz accesible públicamente necesita un límite apropiado de control de acceso; un Secret TLS por sí solo no es autenticación de usuarios.
Esta superposición selecciona la renovación de certificados mediante cronJob. La validez predeterminada del chart seleccionado es de 365 días; la guía TLS también muestra ejemplos de 1,095 días configurados explícitamente. method: helm puede generar certificados, pero no programa su renovación. Compruebe los trabajos de certificados, la caducidad y la confianza; Hubble admite recarga de certificados, que no sustituye la operación del proceso de renovación.
Instalar Hubble CLI
El ejemplo Unix fija versión, selecciona Linux/macOS y amd64/arm64 y se detiene si falla descarga/checksum:
set -eu
HUBBLE_VERSION=v1.19.4
case "$(uname -s)" in
  Linux) HUBBLE_RELEASE_OS=linux ;;
  Darwin) HUBBLE_RELEASE_OS=darwin ;;
  *) echo "Use the matching release archive for this operating system." >&2; exit 1 ;;
esac
case "$(uname -m)" in
  x86_64|amd64) HUBBLE_RELEASE_ARCH=amd64 ;;
  aarch64|arm64) HUBBLE_RELEASE_ARCH=arm64 ;;
  *) echo "Unsupported architecture for this example." >&2; exit 1 ;;
esac
HUBBLE_ARCHIVE="hubble-${HUBBLE_RELEASE_OS}-${HUBBLE_RELEASE_ARCH}.tar.gz"
HUBBLE_RELEASE_BASE="https://github.com/cilium/hubble/releases/download/${HUBBLE_VERSION}"
curl -fSLO "${HUBBLE_RELEASE_BASE}/${HUBBLE_ARCHIVE}"
curl -fSLO "${HUBBLE_RELEASE_BASE}/${HUBBLE_ARCHIVE}.sha256sum"
if command -v sha256sum >/dev/null 2>&1; then
  sha256sum --check "${HUBBLE_ARCHIVE}.sha256sum"
else
  shasum -a 256 -c "${HUBBLE_ARCHIVE}.sha256sum"
fi
tar -xzf "$HUBBLE_ARCHIVE" hubble
sudo install -m 0755 hubble /usr/local/bin/hubble
hubble version
Utilice un directorio de trabajo adecuado para la descarga. La versión oficial también proporciona archivos para Windows amd64/arm64; verifique sus valores SHA-256 publicados y siga el procedimiento de instalación de la plataforma. La disponibilidad de la CLI para una plataforma no implica compatibilidad para ejecutar el plano de datos Linux de Cilium en ese sistema operativo.
Conectar con Relay
# Terminal 1
cilium hubble port-forward --port-forward 4245
# Terminal 2
hubble status --server localhost:4245
hubble observe --server localhost:4245 --namespace production --last 100
hubble observe --server localhost:4245 --namespace production --follow
Conserve estado y errores completos. Un grep de «Hubble» o una salida ilustrativa con tres nodos no demuestra salud real.
Hubble CLI
Uso y filtros
hubble observe devuelve normalmente observaciones recientes del buffer. Solo es continuo con --follow. --last limita historial, y Relay puede devolver ese límite por instancia conectada.
hubble observe --pod production/frontend --last 100
hubble observe --from-ip 10.0.1.5 --to-ip 10.0.2.10
hubble observe --to-port 8080
hubble observe --protocol http --http-status '5+'
hubble observe --protocol http --http-status '2+'
hubble observe --http-method POST --http-method PUT
hubble observe --http-path '^/api/v1/users/.*$'
hubble observe --to-label 'k8s:app=backend,k8s:version=v2'
hubble observe --from-namespace production --to-namespace production --from-workload frontend --to-workload backend
hubble observe --to-service production/backend
hubble observe --namespace production --verdict DROPPED --drop-reason-desc POLICY_DENIED
Reglas importantes:
- Nombres Pod/Service son prefijos; sin namespace se usa
default. - Use
--from-ip/--to-ip;--ip-source/--ip-destinationson inválidos. - Estados HTTP admiten código exacto o prefijos como
5+, no500-599. - Los métodos son valores exactos. Repita flags para POST o PUT;
"POST|PUT"es literal, no regex. - Una cadena de etiquetas separadas por comas usa AND; selectores repetidos son alternativas.
- Filtros Service usan metadatos Service/ClusterIP.
--from-service frontendno selecciona genéricamente todos los Pods del Service; use filtros workload/Pod/etiqueta para callers. --to-service production/backendse usa solo; combinar--to-servicey--namespacese rechaza.
Formatos y retención
json y jsonpb son alias del mismo mapeo protobuf JSON. También se admiten dict, compact y table.
hubble observe --namespace production --last 100 -o json
hubble observe --input-file flows.jsonl --last 100 -o json
hubble observe --since 5m
Los timestamps RFC3339 de --since/--until solo consultan datos disponibles. Un buffer de memoria no proporciona años de historia; conserve exports para investigación histórica.
Hubble UI
Mapa de servicios
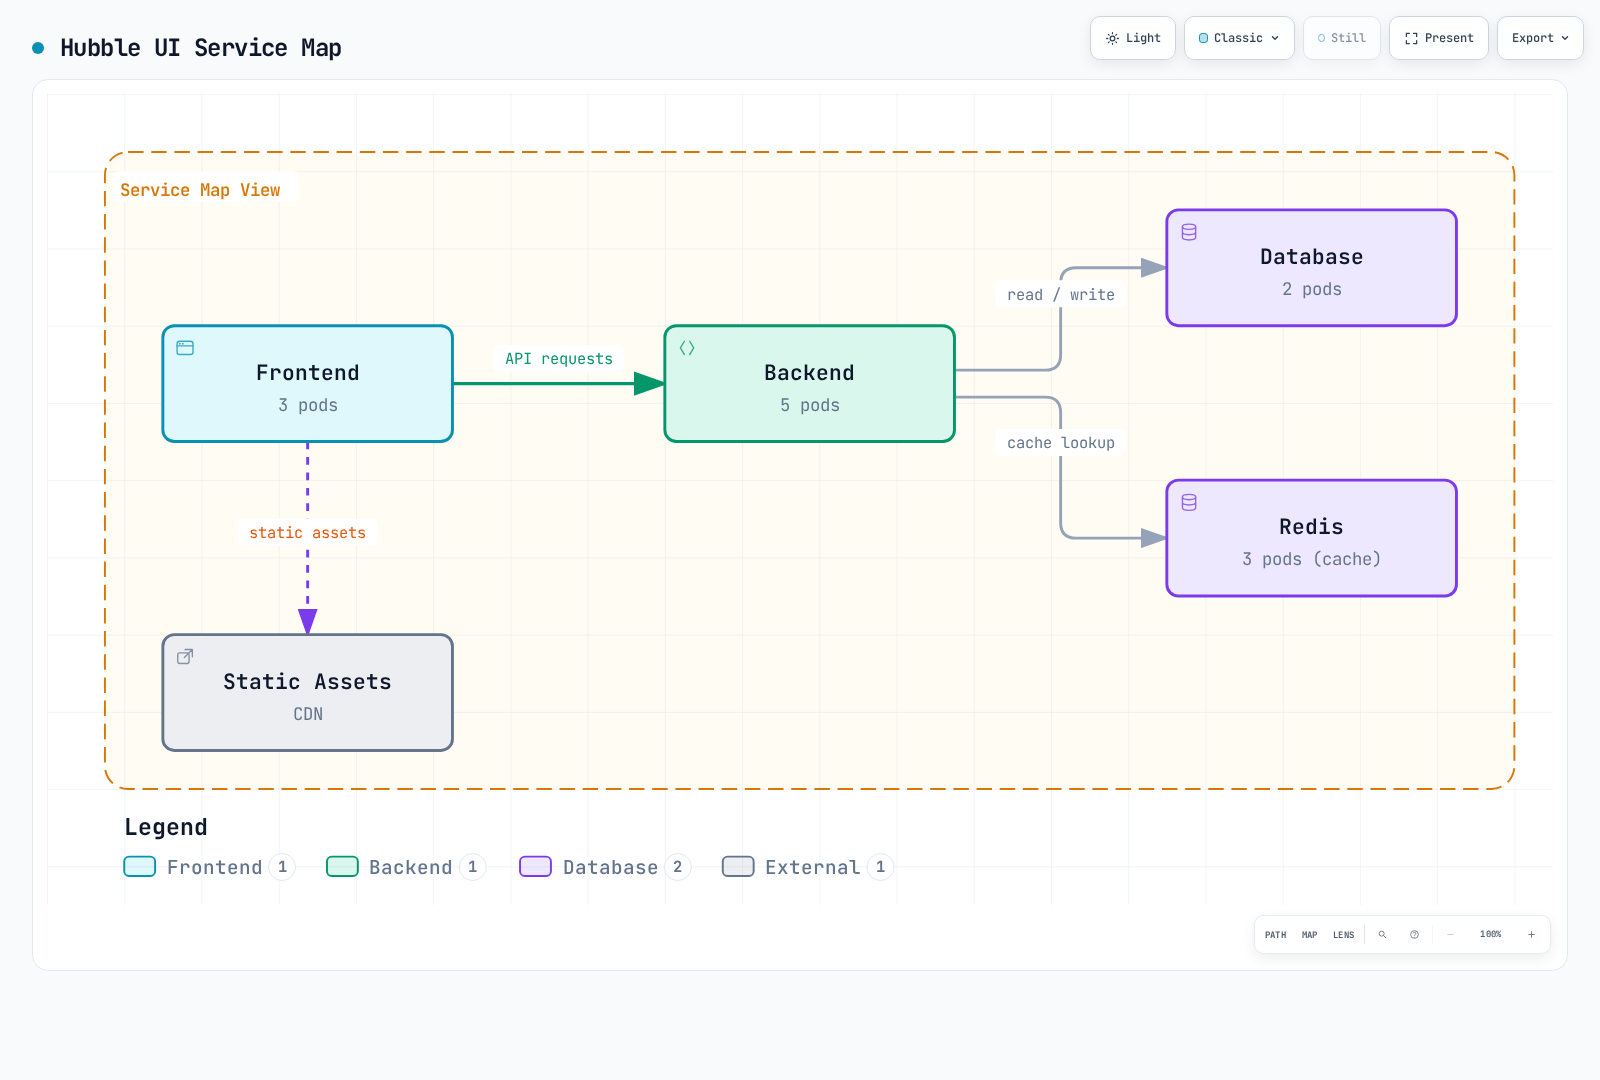
Las relaciones derivan de tráfico observado. Cargas silenciosas, rutas no soportadas, navegador/CDN externo o metadatos ausentes pueden no aparecer. Una arista ausente no demuestra que no haya dependencia.
Funciones y acceso UI
Ofrece filtros namespace/veredicto, flujos recientes y mapa observado. Los detalles L7 requieren visibilidad L7.
kubectl -n kube-system port-forward --address 127.0.0.1 service/hubble-ui 12000:80
# Open http://localhost:12000
Visibilidad de flujos L7
HTTP, gRPC y DNS
hubble observe --protocol http --last 100 -o json |
  jq 'select(.flow.l7.type == "RESPONSE") | .flow.l7.http'
hubble observe --protocol http --last 100 -o json |
  jq 'select(.flow.l7.type == "RESPONSE") |
      select((.flow.l7.latency_ns // "0" | tonumber) > 1000000000)'
hubble observe --protocol dns --last 100 -o json |
  jq 'select(.flow.l7.dns.rcode == 3)'
hubble observe --protocol http --http-path '^/myapp[.]UserService/GetUser$'
hubble observe --port 9092
El JSON codifica latency_ns de 64 bits como cadena. Convierta con tonumber antes de comparar; una cadena comparada directamente con un número JSON da resultados de lentitud incorrectos.
Las respuestas HTTP llevan estado; las solicitudes pueden no tenerlo todavía. Se puede seleccionar un método gRPC por ruta HTTP, pero 200 no significa éxito gRPC. Recoja resultados RPC aparte cuando proceda.
No existe la opción --dns-rcode en la CLI seleccionada. Inspeccione el código numérico de respuesta DNS en JSON; 3 indica NXDOMAIN. El filtro kafka de la CLI puede leer datos históricos compatibles, pero no restaura el procesamiento L7 de Kafka eliminado de Cilium 1.20.1. El filtrado del puerto 9092 proporciona observaciones L4, no inspección de temas/operaciones.
Métricas Prometheus
Activar recopilación
Habilite cada gestor una sola vez. Por ejemplo, dns emite sus familias de métricas DNS; dns:query añade contexto del nombre de consulta en vez de habilitar un contador de consultas independiente. Repetir gestores dns o http como entradas separadas de consultas/respuestas/duración intenta registrar familias de métricas superpuestas.
httpV2 sustituye http obsoleto; no pueden coexistir. hubble_http_requests_total usa eventos de respuesta, incluye status y muestra contexto origen/destino en dirección de la solicitud. No emite el antiguo hubble_http_responses_total.
La superposición base solicita explícitamente etiquetas de contexto de espacio de nombres/carga de trabajo. destination_service no es uno de los nombres compatibles de labelsContext. Añada recopilación real de Prometheus solo después de instalar los CRD/controlador de Prometheus Operator y comprobar sus selectores:
prometheus:
  serviceMonitor:
    enabled: true
    labels:
      release: prometheus
    relabelings:
    - sourceLabels:
      - __meta_kubernetes_pod_node_name
      targetLabel: node
      action: replace
      replacement: ${1}
    - targetLabel: cluster
      replacement: example-cluster
      action: replace
hubble:
  metrics:
    serviceMonitor:
      enabled: true
      labels:
        release: prometheus
      relabelings:
      - sourceLabels:
        - __meta_kubernetes_pod_node_name
        targetLabel: node
        action: replace
        replacement: ${1}
      - targetLabel: cluster
        replacement: example-cluster
        action: replace
Sustituya example-cluster por la etiqueta de métricas única prevista y release: prometheus por etiquetas que coincidan con los selectores de Prometheus instalados. Conserve el reetiquetado de nodos al personalizar la lista. Las reglas siguientes también requieren una selección coincidente de ruleSelector/espacio de nombres.
Este reetiquetado añade cluster a los destinos de recopilación y a las muestras. Establecer únicamente external_labels de Prometheus no añade esa etiqueta a las muestras de consultas locales. Compruebe las etiquetas reales de destinos; los ejemplos con job="hubble-metrics" o job="cilium-agent" presuponen los nombres habituales de trabajos derivados de Service.
Reglas de grabación y alertas
Prometheus evalúa reglas; Alertmanager enruta notificaciones. Cargue las reglas antes de sus consultas/dashboard dependientes.
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: cilium-hubble-observation
  namespace: monitoring
  labels:
    release: prometheus
spec:
  groups:
  - name: cilium.hubble.httpv2
    rules:
    - record: cilium_hubble:http_responses:rate5m
      expr: sum by (cluster, destination_namespace, destination_workload) (rate(hubble_http_requests_total{reporter="server",cluster!="",destination_namespace!="",destination_workload!=""}[5m]))
    - record: cilium_hubble:http_5xx:rate5m
      expr: 'sum by (cluster, destination_namespace, destination_workload) (rate(hubble_http_requests_total{reporter="server",cluster!="",destination_namespace!="",destination_workload!="",status=~"5.."}[5m]))

        or on (cluster, destination_namespace, destination_workload) (0 * cilium_hubble:http_responses:rate5m)'
    - record: cilium_hubble:http_5xx_percent:rate5m
      expr: '(100 * cilium_hubble:http_5xx:rate5m / cilium_hubble:http_responses:rate5m)

        and on (cluster, destination_namespace, destination_workload) (cilium_hubble:http_responses:rate5m
        > 0)'
    - record: cilium_hubble:http_latency_bucket:rate5m
      expr: sum by (le, cluster, destination_namespace, destination_workload) (rate(hubble_http_request_duration_seconds_bucket{reporter="server",cluster!="",destination_namespace!="",destination_workload!=""}[5m]))
    - alert: HighObservedHTTP5xx
      expr: (cilium_hubble:http_5xx_percent:rate5m > 5) and on (cluster, destination_namespace,
        destination_workload) (cilium_hubble:http_responses:rate5m > 1)
      for: 5m
      labels:
        severity: warning
      annotations:
        summary: High observed HTTP 5xx ratio
        description: '{{ $labels.cluster }}/{{ $labels.destination_namespace }}/{{
          $labels.destination_workload }}: {{ $value }}%'
    - alert: HighObservedHTTPP99
      expr: (histogram_quantile(0.99, cilium_hubble:http_latency_bucket:rate5m) >
        1) and on (cluster, destination_namespace, destination_workload) (cilium_hubble:http_responses:rate5m
        > 1)
      for: 5m
      labels:
        severity: warning
      annotations:
        summary: High observed HTTP latency
        description: '{{ $labels.cluster }}/{{ $labels.destination_namespace }}/{{
          $labels.destination_workload }}: {{ $value }}s'
    - alert: HubbleMetricsScrapeFailed
      expr: up{job="hubble-metrics"} == 0
      for: 5m
      labels:
        severity: warning
      annotations:
        summary: Known Hubble metrics target cannot be scraped
    - alert: CiliumBPFMapPressure
      expr: cilium_bpf_map_pressure > 0.9
      for: 5m
      labels:
        severity: warning
      annotations:
        summary: High pressure in an instrumented BPF map
        description: '{{ $labels.cluster }}/{{ $labels.node }} {{ $labels.map_name
          }}: {{ $value }}'
El ejemplo elige el límite de observación de servidor/ingreso. Las observaciones de cliente/salida pueden describir el mismo intercambio; mezclar límites puede contar las observaciones dos veces. Valide la ruta real del proxy cuando intervengan varios gateways o políticas L7.
5xx ausentes se convierten en cero solo con un total observado coincidente. Un total ocioso no se divide para fingir salud; ausencias siguen ausentes. No cubre todo fallo TCP, rechazo, respuesta perdida o fallo de aplicación.
Umbrales, mínimo de una respuesta/s y cinco minutos son ejemplos para el presupuesto de error. up == 0 detecta targets conocidos fallidos; targets ausentes necesitan inventario/readiness aparte. La presión solo cubre mapas instrumentados y puede faltar por debajo del umbral de reporte.
Consultas principales
Las tres primeras usan las reglas anteriores. Unidades y alcance forman parte del significado.
Respuestas HTTP del servidor observadas/s
cilium_hubble:http_responses:rate5mPorcentaje HTTP5xx observado
cilium_hubble:http_5xx_percent:rate5mP99 HTTP observado en segundos
histogram_quantile(0.99, cilium_hubble:http_latency_bucket:rate5m)Eventos de descarte de flujo Hubble/s
sum by (cluster, reason) (rate(hubble_drop_total[5m]))Consultas DNS observadas/s
sum by (cluster) (rate(hubble_dns_queries_total[5m]))Apariciones de flag SYN/s
sum by (cluster) (rate(hubble_tcp_flags_total{flag="SYN"}[5m]))Eventos de flujo observados/s
sum by (cluster) (rate(hubble_flows_processed_total[5m]))Bytes reenviados Cilium/s
sum by (cluster, node, direction) (rate(cilium_forward_bytes_total[5m]))Éxito de scrape Prometheus
up{job=~"cilium-agent|hubble-metrics"}Endpoints administrados
cilium_endpointPolíticas cargadas
cilium_policyPresión de mapas BPF instrumentados
cilium_bpf_map_pressureEntradas CT en la última recolección de basura
cilium_datapath_conntrack_gc_entriesRedirecciones proxy de endpoints instaladas
cilium_proxy_redirectshubble_flows_processed_total cuenta eventos, no bytes. Los descartes Hubble difieren de contadores de paquetes del agente. SYN incluye retransmisiones, no es un gauge de conexiones activas.
El agente exporta cilium_endpoint y cilium_policy, no los antiguos *_count. cilium_datapath_conntrack_gc_entries describe entradas observadas en GC; cilium_datapath_conntrack_active/max no es una pareja actual documentada. cilium_proxy_redirects cuenta redirecciones instaladas, no solicitudes. Presión/capacidad BPF tienen etiquetas y reporte propios; no invente denominadores ajenos.
Dashboards Grafana
Dashboards publicados
Cilium incluye JSON de paneles en la versión seleccionada. Revise cada panel respecto a las métricas habilitadas y las etiquetas de destinos: el panel general de Hubble todavía tiene una consulta heredada de respuestas HTTP, mientras que el panel de cargas de trabajo HTTP utiliza datos de estilo HTTPv2 y variables de clúster/carga de trabajo. Sus paneles de proporción de éxito también necesitan atención cuando no existe una serie de éxitos.
La antigua lista de ID de paneles v1.12 no es un procedimiento de instalación ajustado a la versión de esta guía. El panel personalizado siguiente utiliza las reglas de grabación corregidas, una entrada de fuente de datos explícita, disposición y unidades. Impórtelo en una instancia existente de Grafana y elija la fuente de datos Prometheus correspondiente.
Ejemplo personalizado
{
  "__inputs": [
    {
      "name": "DS_PROMETHEUS",
      "label": "Prometheus",
      "type": "datasource",
      "pluginId": "prometheus",
      "pluginName": "Prometheus"
    }
  ],
  "id": null,
  "uid": "cilium-hubble-observed",
  "title": "Cilium Hubble Observations",
  "tags": [
    "cilium",
    "hubble"
  ],
  "schemaVersion": 38,
  "version": 1,
  "timezone": "browser",
  "time": {
    "from": "now-1h",
    "to": "now"
  },
  "refresh": "30s",
  "panels": [
    {
      "id": 1,
      "title": "Observed HTTP responses/s",
      "type": "timeseries",
      "gridPos": {
        "x": 0,
        "y": 0,
        "w": 12,
        "h": 8
      },
      "datasource": {
        "type": "prometheus",
        "uid": "${DS_PROMETHEUS}"
      },
      "targets": [
        {
          "refId": "A",
          "expr": "cilium_hubble:http_responses:rate5m",
          "legendFormat": "{{cluster}} / {{destination_namespace}} / {{destination_workload}}"
        }
      ],
      "fieldConfig": {
        "defaults": {
          "unit": "reqps"
        },
        "overrides": []
      }
    },
    {
      "id": 2,
      "title": "Observed HTTP5xx (%)",
      "type": "timeseries",
      "gridPos": {
        "x": 12,
        "y": 0,
        "w": 12,
        "h": 8
      },
      "datasource": {
        "type": "prometheus",
        "uid": "${DS_PROMETHEUS}"
      },
      "targets": [
        {
          "refId": "A",
          "expr": "cilium_hubble:http_5xx_percent:rate5m",
          "legendFormat": "{{cluster}} / {{destination_namespace}} / {{destination_workload}}"
        }
      ],
      "fieldConfig": {
        "defaults": {
          "unit": "percent"
        },
        "overrides": []
      }
    },
    {
      "id": 3,
      "title": "Observed HTTP P99",
      "type": "timeseries",
      "gridPos": {
        "x": 0,
        "y": 8,
        "w": 12,
        "h": 8
      },
      "datasource": {
        "type": "prometheus",
        "uid": "${DS_PROMETHEUS}"
      },
      "targets": [
        {
          "refId": "A",
          "expr": "histogram_quantile(0.99, cilium_hubble:http_latency_bucket:rate5m)",
          "legendFormat": "{{cluster}} / {{destination_namespace}} / {{destination_workload}}"
        }
      ],
      "fieldConfig": {
        "defaults": {
          "unit": "s"
        },
        "overrides": []
      }
    },
    {
      "id": 4,
      "title": "Observed flow drops/s",
      "type": "timeseries",
      "gridPos": {
        "x": 12,
        "y": 8,
        "w": 12,
        "h": 8
      },
      "datasource": {
        "type": "prometheus",
        "uid": "${DS_PROMETHEUS}"
      },
      "targets": [
        {
          "refId": "A",
          "expr": "sum by (cluster, reason) (rate(hubble_drop_total[5m]))",
          "legendFormat": "{{cluster}} / {{reason}}"
        }
      ],
      "fieldConfig": {
        "defaults": {
          "unit": "ops"
        },
        "overrides": []
      }
    }
  ]
}
Muestra observaciones, no un SLI extremo a extremo garantizado. Si faltan datos, investigue tráfico, L7 y scrape.
Mapas de dependencias
Extracción
El ejemplo agrupa solicitudes HTTP observadas en la frontera ingress, conserva dirección y evita errores ante metadatos ausentes:
hubble observe --namespace production --protocol http --traffic-direction ingress --last 1000 -o json |
  jq -r 'select(.flow.l7.type == "REQUEST") |
    [.flow.source.namespace,
     (.flow.source.workloads[0].name // .flow.source.pod_name // "unknown"),
     .flow.destination.namespace,
     (.flow.destination.workloads[0].name // .flow.destination.pod_name // "unknown")] |
    @tsv' |
  sort | uniq -c | sort -rn
Son conteos de observaciones seleccionadas, no automáticamente tasas ni inventario completo. Endpoints desconocidos y dependencias fuera de la ruta necesitan más evidencia.
Ejemplo de mapa
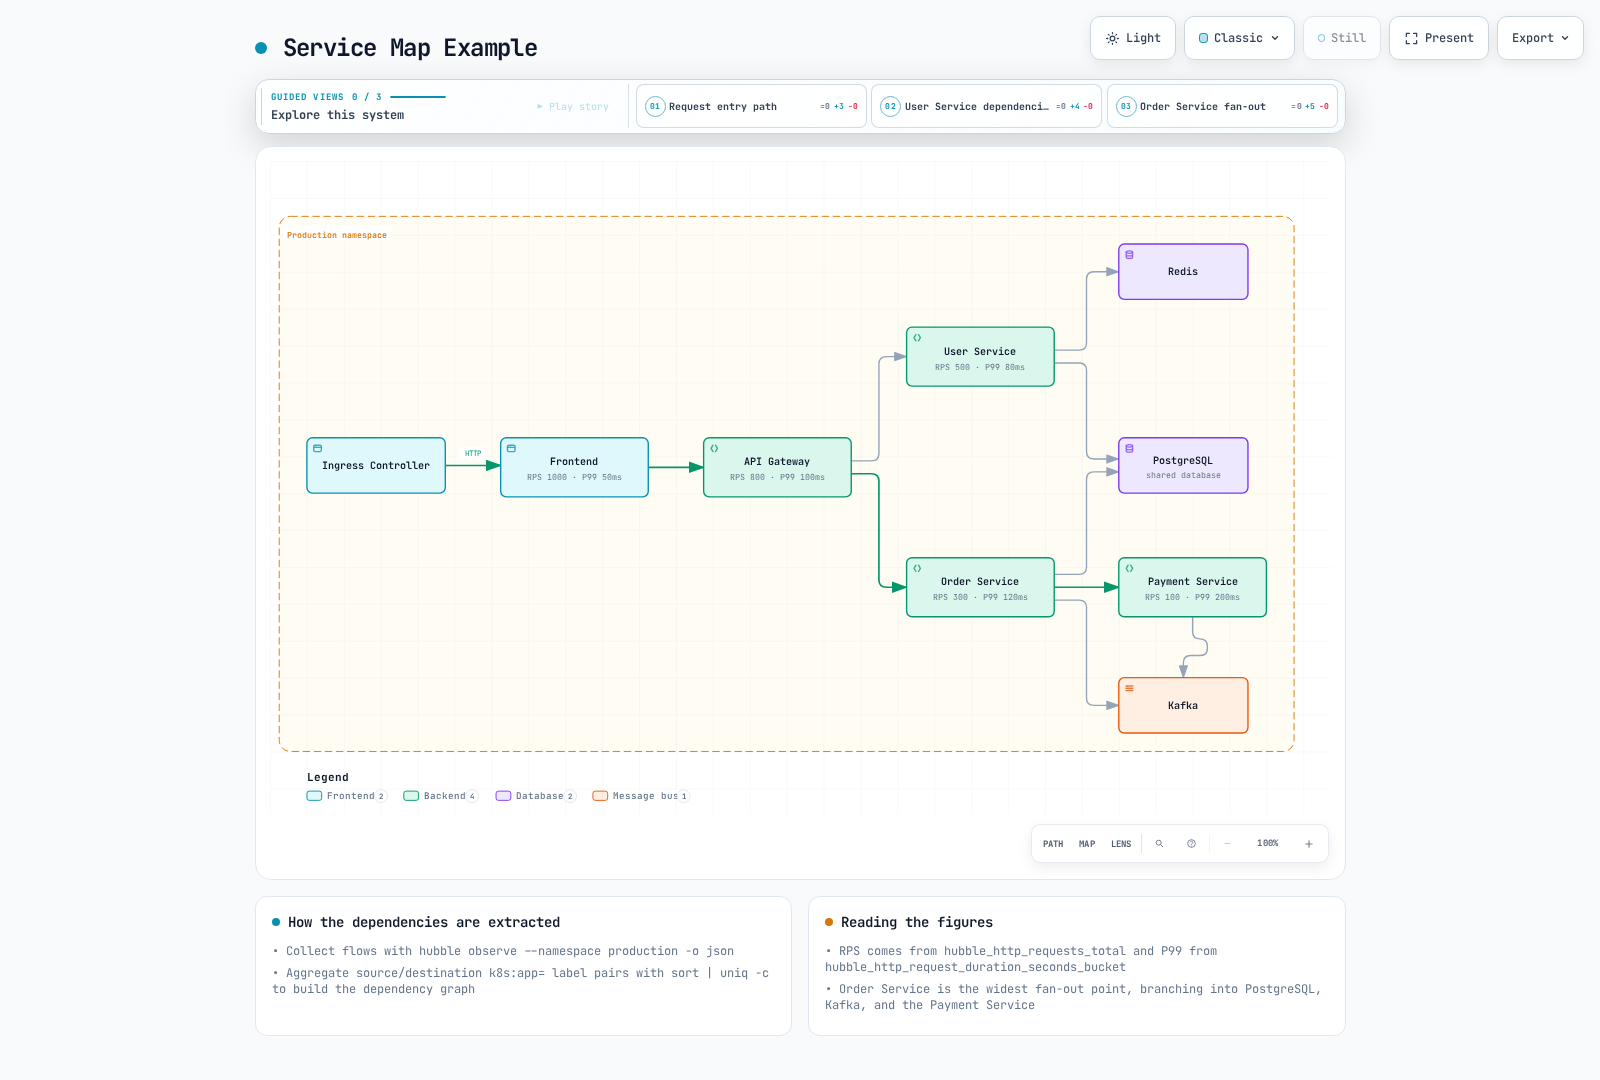
Los números de la figura no tienen aquí procedencia de medición. Utilícela para explicar relaciones, no para elegir capacidad ni umbrales de SLO. Cilium puede observar tráfico L4 hacia Kafka sin visibilidad a nivel de temas de Kafka.
Monitorización de Golden Signals
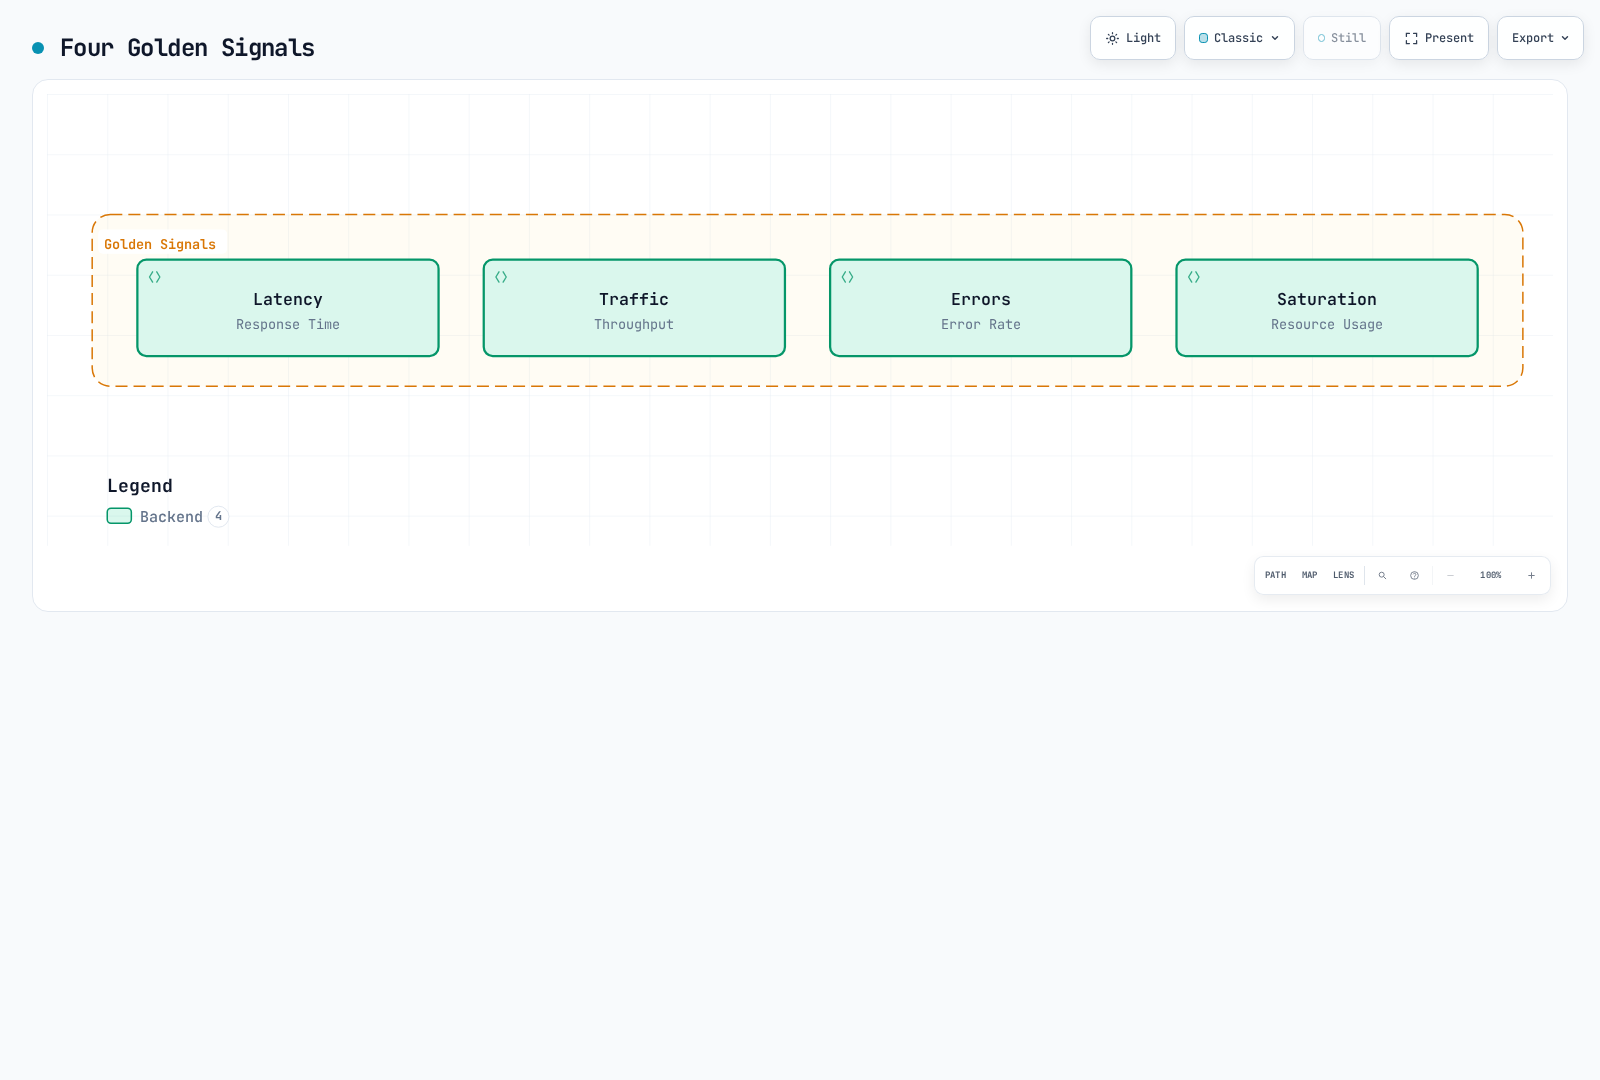
Utilice las señales con definiciones apropiadas para el servicio. La disponibilidad no es uno de los cuatro nombres, pero sigue requiriendo un SLI explícito; una proporción HTTP 5xx observada no es una medición completa de disponibilidad. Los cuantiles de histogramas deben agregar intervalos compatibles conservando le, en vez de promediar percentiles por instancia.
Integración OpenTelemetry
Exportación de flujos Hubble
El chart soporta exportación a archivos estática/dinámica. hubble.export.opentelemetry y fileOutput antiguos no configuran un emisor OTLP.
Este exportador dinámico selecciona observaciones relacionadas con production, rotación acotada y campos concretos:
hubble:
  export:
    static:
      enabled: false
    dynamic:
      enabled: true
      config:
        createConfigMap: true
        configMapName: cilium-flowlog-config
        content:
        - name: production
          filePath: /var/run/cilium/hubble/events.log
          fileMaxSizeMb: 10
          fileMaxBackups: 5
          fileCompress: false
          includeFilters:
          - source_pod:
            - production/
          - destination_pod:
            - production/
          excludeFilters: []
          fieldMask:
          - time
          - node_name
          - source.namespace
          - source.pod_name
          - source.workloads
          - destination.namespace
          - destination.pod_name
          - destination.workloads
          - IP
          - l4
          - verdict
          - drop_reason_desc
          - l7.type
          - l7.latency_ns
          - l7.http.code
          - l7.http.method
          - l7.http.protocol
          - l7.dns.rcode
Los dos filtros include son alternativas: origen o destino en el namespace. La máscara omite URL/cabeceras HTTP y etiquetas de carga; elija otros campos deliberadamente. Tras habilitarlo, los cambios dinámicos no requieren reiniciar agentes, pero la activación inicial/cambios de instalación necesitan rollout adecuado.
Rotación significa retención local, no almacenamiento central durable. Confirme nodo/archivo y prepare un lector apropiado.
Configuración Collector
Lo siguiente es una configuración de Collector Contrib 0.160.0, no un Deployment. Debe proporcionarse un DaemonSet de Collector local al nodo con acceso de lectura al directorio de registros correspondiente del host, almacenamiento persistente de puntos de control con escritura y K8S_NODE_NAME obtenido de la API descendente.
extensions:
  file_storage:
    directory: /var/lib/otelcol/file_storage
    create_directory: true
receivers:
  filelog/hubble:
    include:
    - /var/run/cilium/hubble/events*.log
    start_at: end
    storage: file_storage
    operators:
    - type: json_parser
      parse_from: body
      parse_to: body
      timestamp:
        parse_from: body.time
        layout_type: gotime
        layout: 2006-01-02T15:04:05.999999999Z07:00
processors:
  memory_limiter:
    check_interval: 1s
    limit_mib: 128
    spike_limit_mib: 32
  resource/hubble:
    attributes:
    - key: service.name
      value: hubble-flow-logs
      action: upsert
    - key: k8s.node.name
      value: ${env:K8S_NODE_NAME}
      action: upsert
  batch:
    timeout: 5s
exporters:
  otlphttp/loki:
    endpoint: https://logs.example.com/otlp
    headers:
      X-Scope-OrgID: example-tenant
    tls:
      ca_file: /etc/otel/tls/backend-ca.crt
service:
  extensions:
  - file_storage
  pipelines:
    logs:
      receivers:
      - filelog/hubble
      processors:
      - memory_limiter
      - resource/hubble
      - batch
      exporters:
      - otlphttp/loki
Sustituya la dirección de backend, el inquilino y la ruta de CA ilustrativos por el endpoint OTLP de Loki y la configuración de confianza reales. Proporcione la autenticación requerida por el gateway elegido; X-Scope-OrgID identifica un inquilino y no es autenticación.
filelog analiza JSON y timestamp. Checkpoints file_storage persistentes conservan offsets; almacenamiento efímero puede cambiar reinicios. start_at: end omite contenido previo sin posición guardada, no configura replay/importación.
Loki 3.7.7 acepta logs en /otlp/v1/logs; el exportador añade /v1/logs a /otlp. Loki debe soportar/activar metadatos estructurados y almacenamiento compatible. No use el exportador loki eliminado. service.name se convierte en service_name; el cuerpo estructurado queda como contenido.
Flujos, métricas y trazas son señales distintas:
| Señal | Ruta de esta guía |
|---|---|
| Registros Hubble | Archivo → filelog local → backend de logs OTLP/HTTP |
| Métricas Hubble/agente | Endpoints → Prometheus |
| Trazas de aplicación/Envoy | Instrumentación y pipeline/backend de trazas separados |
El antiguo exportador jaeger de Collector también está ausente en la distribución seleccionada. Jaeger actual puede recibir trazas OTLP mediante una canalización de trazas correctamente configurada; dirigir registros de flujos a un exportador de trazas no crea trazas distribuidas. La canalización de Collector de este capítulo exporta solo registros.
Resolución de problemas
Estado y configuración
cilium status
hubble status --server localhost:4245
kubectl -n kube-system get daemonset cilium
kubectl -n kube-system get deployment hubble-relay hubble-ui
kubectl -n kube-system get configmap cilium-config -o yaml
kubectl -n kube-system get pods -l k8s-app=cilium -o wide
CILIUM_POD='<agent-on-the-node-being-inspected>'
kubectl -n kube-system exec "$CILIUM_POD" -c cilium-agent -- cilium-dbg status --verbose
kubectl -n kube-system exec "$CILIUM_POD" -c cilium-agent -- cilium-dbg bpf ct list global
kubectl -n kube-system logs deployment/hubble-relay --since=10m
Use el Agent del nodo pertinente. La CLI cliente cilium difiere de cilium-dbg dentro del agente. Conserve errores/estado completo; grep no acredita readiness.
Sin flujos o métricas
Compruebe generación de tráfico, retención y filtros antes de declarar roto el datapath. Verifique instancias conectadas y renovación TLS, y distinga:
- Filtros incorrectos de namespace, prefijo, dirección o protocolo.
- Ausencia HTTP por falta de L7 compatible o datos todavía cifrados.
- Relay/servidor indisponible o target inaccesible.
- ServiceMonitor/PrometheusRule no seleccionados.
- Etiquetas context/cluster ausentes o consultas para otro handler.
- Fallos de exportación/lectura, huecos de rotación/retención o pérdida de observación.
No ejecute bucles ilimitados solo para llenar un grafo. Use tráfico controlado y verifique el significado de cada observación.
Próximos pasos
Referencias
- Configuración Hubble Cilium1.20.1
- TLS y renovación Hubble
- Exportación Hubble
- Hubble CLI
- Release Hubble CLI1.19.4
- Hubble UI
- Definiciones de métricas
- Implementación de métricas HTTP
- Etiquetas de contexto
- Dashboard HTTP por carga publicado
- Dashboard general Hubble publicado
- Receiver filelog Collector0.160
- Ingesta OTLP Loki3.7.7
- Mapeo y endpoint OTLP Loki3.7.7
- Parser JSON Collector
- Golden Signals de Google SRE