Networking de Kubernetes
Última actualización: October 15, 2026
Ejemplos fijados: Cilium 1.20.1, Calico Open Source 3.32.2, Flannel 0.28.9 y AWS VPC CNI/gráfico Helm upstream 1.23.0.
Información de la versión actual: AWS enumera el complemento de VPC CNI administrado por EKS
v1.23.1-eksbuild.1para Kubernetes 1.31–1.37. Calico 3.33.0 es la última versión de Open Source y se prueba en Kubernetes 1.35–1.37. Revise sus notas de versión antes de cambiar los ejemplos fijados.Estas versiones no constituyen una configuración de clúster probada de forma conjunta. Compruebe la matriz de Kubernetes/plataforma de cada producto antes de instalarlo.
Descripción general
El networking de Kubernetes es la capa de infraestructura central que permite la comunicación entre aplicaciones en contenedores. Esta sección abarca desde conceptos básicos de networking de Kubernetes hasta soluciones avanzadas de CNI (Container Network Interface) y patrones de networking en entornos de AWS EKS.
Ruta de aprendizaje
Después del curso para principiantes, use la ruta de networking experto para conectar proyectos de protocolos, políticas de enrutamiento, EVPN, rendimiento de Linux, diseño de nube y evaluación de automatización. Compruebe primero los criterios de entorno, evidencia y recuperación de cada cuaderno.
Si es nuevo en Linux o networking, comience con el curso para principiantes. Sus ocho lecciones conectan la CLI, direccionamiento, DNS, SSH, firewalls, monitoreo y un proyecto final. La ruta siguiente amplía esa base hacia protocolos, el kernel e implementaciones de clúster.
Construya desde conceptos de protocolos hasta observaciones y, después, conéctelos con las responsabilidades de contenedores, clúster y nube. Use los requisitos previos para elegir un punto de entrada y los resultados para comprobar su comprensión antes de continuar.
| Etapa | Función | Requisitos previos | Resultado | Leer / practicar |
|---|---|---|---|---|
| Protocolos, direccionamiento, HTTP | Establecer el vocabulario | Uso básico de línea de comandos | Rastrear una solicitud y distinguir el comportamiento de direccionamiento, transporte y aplicación | Fundamentos de red Parte 1, Parte 2, Parte 3, Parte 4 |
| Sockets de Linux, VFS, rutas de paquetes | Conectar las API con el kernel | Fundamentos de TCP/IP | Distinguir FD, búferes de socket, ventanas y colas | Pila de networking del kernel |
| Diagnóstico de red de Linux | Probar hipótesis con evidencia | Conceptos de socket y ruta de paquetes | Correlacionar observaciones de socket, paquete y aplicación | Práctica de diagnóstico · Cuestionario |
| Docker y networking de contenedores | Localizar límites de namespace | Rutas de paquetes de Linux y diagnóstico básico | Explicar el networking de bridge, puertos publicados y resolución de nombres de contenedores | Tecnología de contenedores |
| Kubernetes Service, DNS, Ingress | Mapear abstracciones del clúster | Networking de contenedores | Rastrear un nombre a través de un Service hasta sus endpoints e identificar la función de ingress | Services y networking · Laboratorio |
| eBPF, CNI, políticas | Comparar responsabilidades de implementación | Rutas de Pod y Service | Distinguir reenvío de paquetes, aplicación de políticas y observabilidad | Fundamentos de eBPF · Cilium · Calico |
| Límites y rendimiento de red de AWS | Aplicar el modelo a rutas de nube | Conceptos de CNI y habilidades de medición | Identificar límites de VPC, nodo y AZ e interpretar las mediciones en contexto | VPC CNI · AWS Load Balancer Controller · Conectividad VPC entre organizaciones · Benchmark de red de Pod |
Modelo de networking de Kubernetes
El modelo actual de Kubernetes proporciona una red de Pod en la que los Pods pueden comunicarse directamente entre nodos sin traducción de direcciones ni proxies, sujeto a una segmentación de red intencional. Los agentes de nodo como kubelet deben poder llegar a los Pods de su propio nodo. La política de red, el enrutamiento y los listeners de aplicación aún determinan si una conexión concreta tiene éxito.
Los Pods ordinarios tienen su propio namespace de red y direcciones de todo el clúster; los contenedores de un Pod comparten ese namespace y localhost. Los Pods de red de host comparten la red del nodo, y las configuraciones de pila dual o multirred necesitan un manejo de direcciones más preciso. Recrear un Pod puede asignar una IP distinta; reiniciar un contenedor dentro del mismo Pod no recrea necesariamente su sandbox de red.
| Componente | Función |
|---|---|
| Red de Pod | Direccionamiento y conectividad entre namespaces de red de cargas de trabajo |
| Service/descubrimiento | Nombres de Service estables o direcciones virtuales sobre endpoints cambiantes |
| Implementación de Ingress/Gateway | Punto de entrada externo configurado y enrutamiento de aplicaciones |
| Motor de políticas de red | Aplica las políticas admitidas por la implementación seleccionada |
Estas funciones no forman una ruta de paquetes serie obligatoria. La traducción de Service, un proxy L7 y la política de carga de trabajo pueden cambiar cómo una solicitud concreta atraviesa la red.
Networking de Pod
El networking de Pod suministra el direccionamiento y las rutas para la comunicación de Pod. La ilustración siguiente muestra Pods IPv4 ordinarios; sus conexiones suponen que las políticas y controles de red aplicables las permiten.
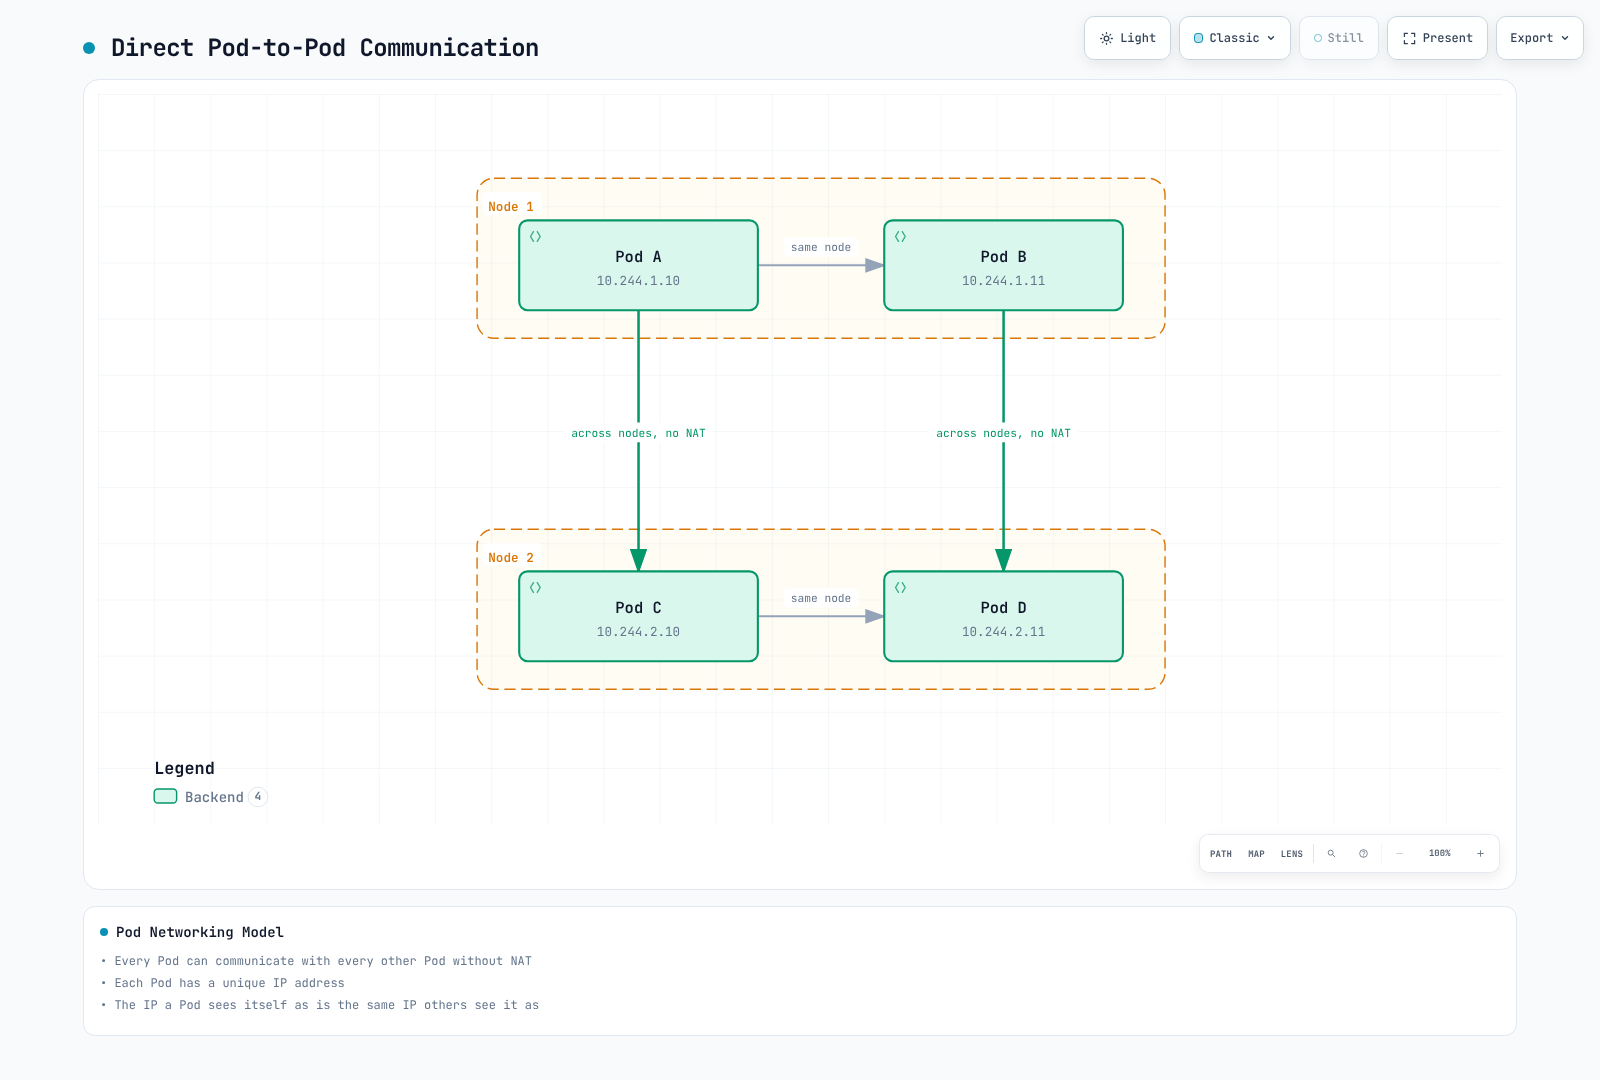
Las direcciones son direcciones ordinarias ilustrativas de Pod. El aislamiento intencional y las configuraciones de red de host o multirred requieren su propia interpretación.
Métodos de implementación de networking de Pod
| Método | Descripción | CNI de ejemplo |
|---|---|---|
| Red superpuesta | Encapsula el tráfico sobre la red existente | Flannel VXLAN, Calico VXLAN/IPIP, Cilium VXLAN/Geneve |
| Enrutamiento nativo | Usa rutas en la red subyacente sin esa encapsulación superpuesta | AWS VPC CNI, enrutamiento/BGP de Calico, enrutamiento nativo de Cilium |
| Encapsulación condicional | Usa rutas directas o encapsulación según la topología configurada | Modos compatibles de Calico/Flannel/Cilium, con requisitos previos diferentes |
Networking de Service
Los Services describen un conjunto lógico de endpoints, normalmente Pods, y cómo llegar a ellos. ClusterIP proporciona una IP virtual estable de forma predeterminada; los Services sin headless omiten esa IP virtual y ExternalName usa la asignación DNS CNAME. Un Service también puede tener endpoints gestionados sin un selector de Pod.
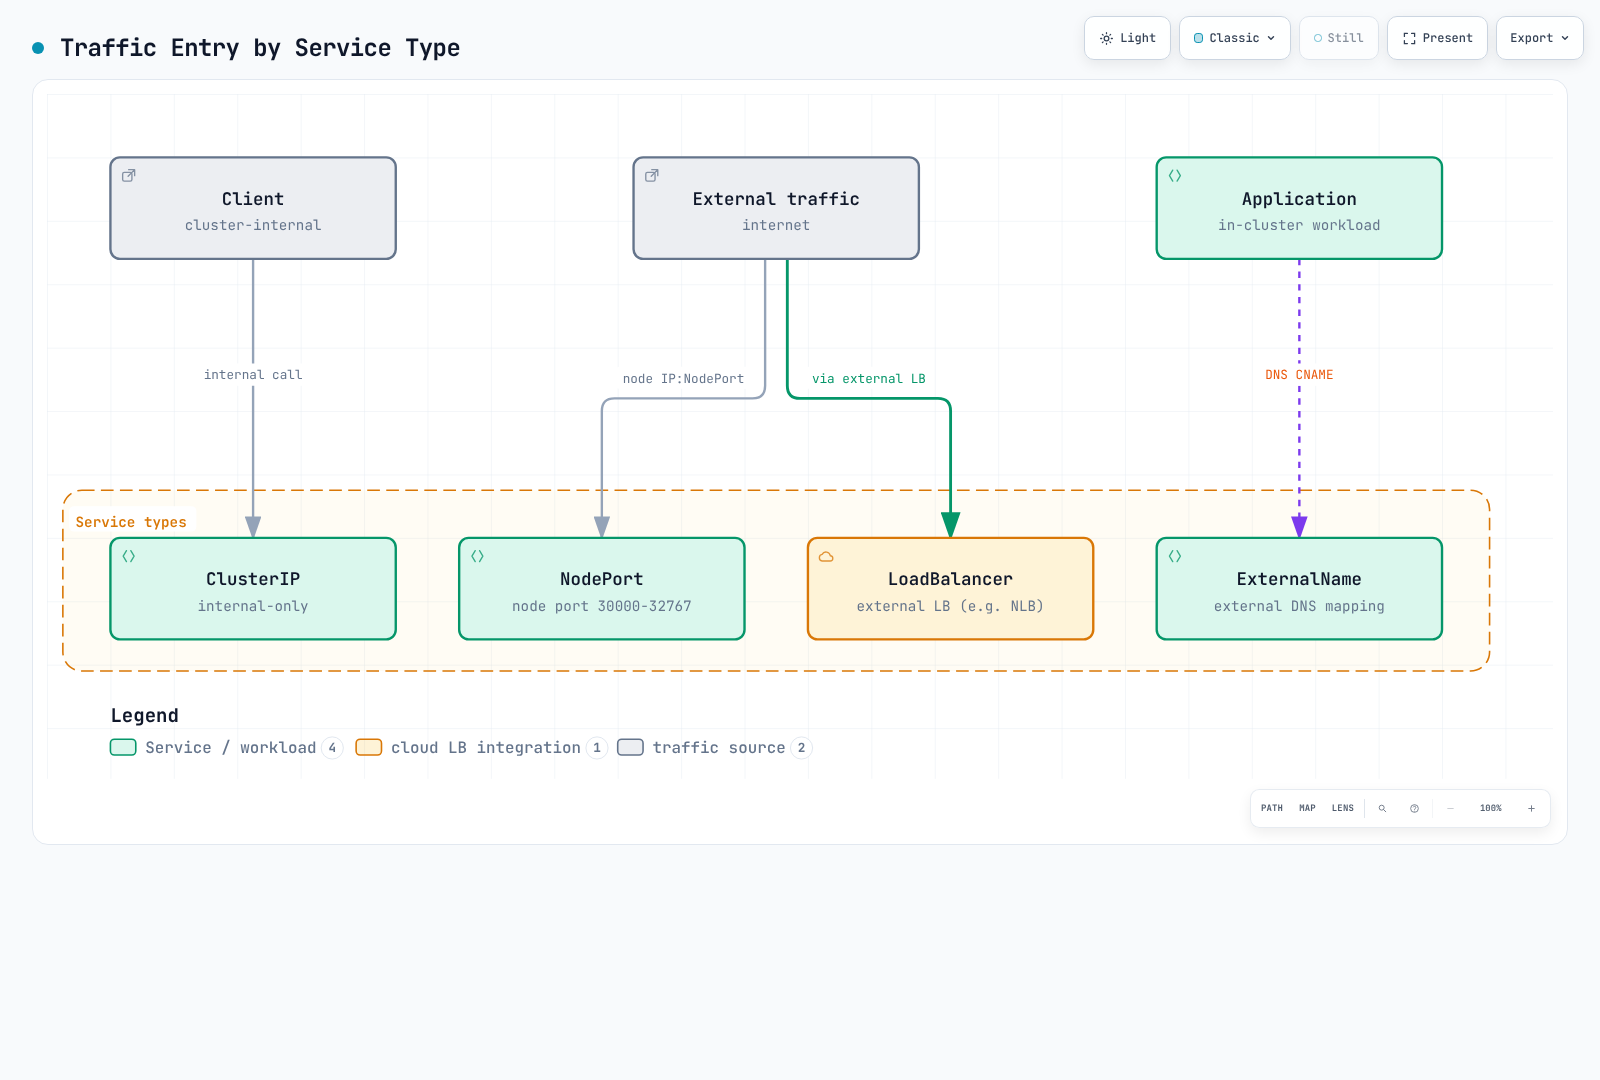
Estos son mecanismos de exposición típicos, no garantías de seguridad. El rango de NodePort y las direcciones de nodo accesibles son configurables; los LoadBalancers pueden ser internos. ExternalName devuelve un alias DNS y no crea un proxy de reenvío.
Características de tipos de Service
Cree Pods app: my-app coincidentes en default, que escuchen en los puertos de destino mostrados. El rango de asignación predeterminado de NodePort es 30000–32767 y puede configurarse. La accesibilidad externa todavía depende de direcciones, rutas y controles de acceso.
El ejemplo de LoadBalancer selecciona explícitamente AWS Load Balancer Controller, con destinos de instancias EC2 y NodePorts asignados. Primero instale/configure ese controlador y sus requisitos previos de IAM/subred. EKS Auto Mode usa un controlador/clase diferente. El puerto 443 solo selecciona aquí un puerto TCP; TLS debe servirse mediante el backend en 8443 o configurarse por separado en el balanceador de carga.
Estas asignaciones de puertos ilustran la API general de Kubernetes Service. AWS documenta actualmente requisitos adicionales de política de red nativa de EKS: el puerto del Service debe coincidir con el puerto del contenedor, y los Pods gestionados por controlador con metadata.ownerReferences ofrecen una aplicación fiable. Adapte los ejemplos a esos requisitos antes de probar esa implementación de política.
apiVersion: v1
kind: Service
metadata:
  name: my-service
  namespace: default
spec:
  type: ClusterIP
  selector:
    app: my-app
  ports:
  - protocol: TCP
    port: 80
    targetPort: 8080
---
apiVersion: v1
kind: Service
metadata:
  name: my-nodeport-service
  namespace: default
spec:
  type: NodePort
  selector:
    app: my-app
  ports:
  - protocol: TCP
    port: 80
    targetPort: 8080
    nodePort: 30080
---
apiVersion: v1
kind: Service
metadata:
  name: my-loadbalancer-service
  annotations:
    service.beta.kubernetes.io/aws-load-balancer-scheme: internet-facing
    service.beta.kubernetes.io/aws-load-balancer-nlb-target-type: instance
  namespace: default
spec:
  type: LoadBalancer
  selector:
    app: my-app
  ports:
  - protocol: TCP
    port: 443
    targetPort: 8443
  loadBalancerClass: service.k8s.aws/nlb
  allocateLoadBalancerNodePorts: true
Networking de Ingress
Un recurso Ingress necesita un controlador y su plano de datos. Este ejemplo HTTP usa AWS LBC con spec.ingressClassName: alb y destinos IP. Los Services referenciados api-v1, api-v2 y web-frontend deben existir en default, exponer el puerto 80 y tener endpoints de Pod listos y enrutables por VPC. Configure HTTPS/certificados por separado cuando sea necesario. Consulte la guía de LBC para conocer sus requisitos previos de instalación y destino.
Ingress define reglas para enrutar tráfico HTTP/HTTPS a Services internos del clúster.
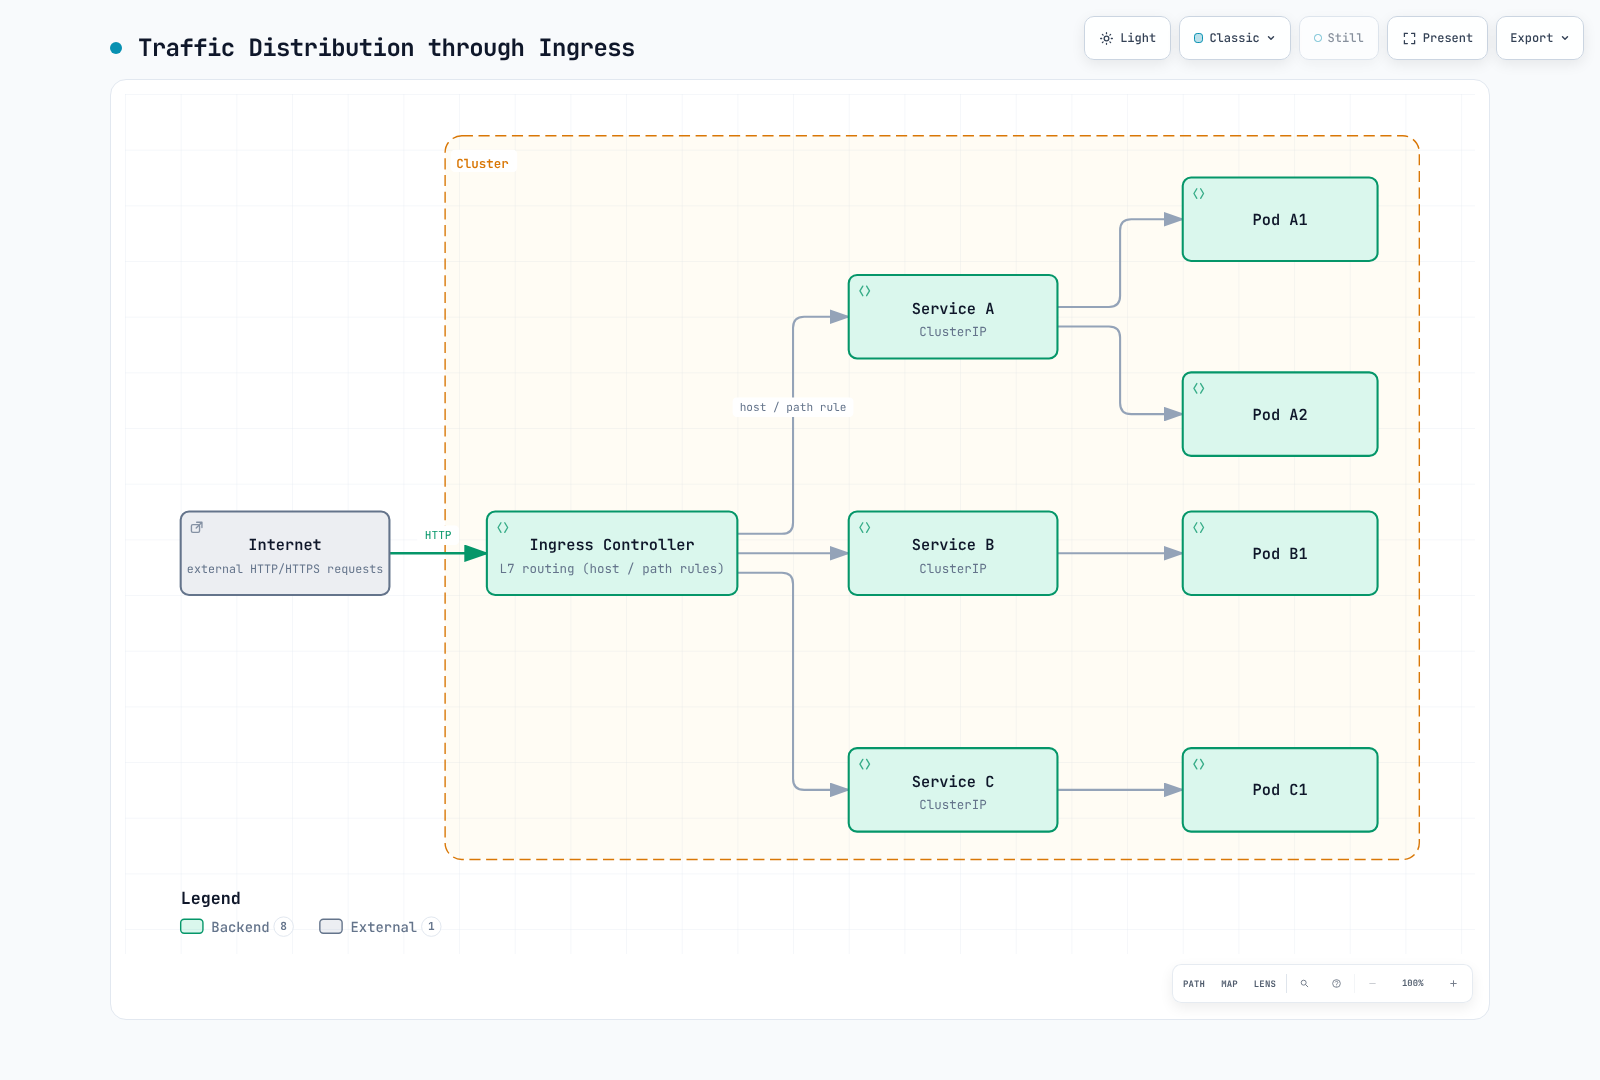
El recuadro representa la función del plano de datos de Ingress. AWS LBC programa ALB; el tráfico de aplicaciones no atraviesa el proceso de reconciliación del controlador. Según el modo de destino, el plano de datos puede alcanzar IP de Pod o NodePorts en lugar de atravesar una IP virtual de Service como un salto adicional literal.
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  name: my-ingress
  annotations:
    alb.ingress.kubernetes.io/scheme: internet-facing
    alb.ingress.kubernetes.io/target-type: ip
  namespace: default
spec:
  rules:
  - host: api.example.com
    http:
      paths:
      - path: /v1
        pathType: Prefix
        backend:
          service:
            name: api-v1
            port:
              number: 80
      - path: /v2
        pathType: Prefix
        backend:
          service:
            name: api-v2
            port:
              number: 80
  - host: web.example.com
    http:
      paths:
      - path: /
        pathType: Prefix
        backend:
          service:
            name: web-frontend
            port:
              number: 80
  ingressClassName: alb
CNI (Container Network Interface)
CNI estandariza la interfaz mediante la cual un runtime configura una red de contenedores. Para Kubernetes actual, kubelet solicita operaciones de sandbox de Pod a través de CRI y el runtime de contenedores administra CNI. Los antiguos indicadores de administración directa de CNI de kubelet se eliminaron en Kubernetes 1.24.
Responsabilidades de runtime y plugin
| Actor | Responsabilidad |
|---|---|
| kubelet | Solicita la creación/eliminación del sandbox mediante la interfaz de runtime de contenedor |
| Runtime de contenedor | Selecciona la configuración de red e invoca la cadena de plugins CNI |
| Plugin CNI | Recibe la configuración, realiza ADD/DEL y otras operaciones compatibles, y devuelve resultados |
| Implementación IPAM | Asigna/libera direcciones; puede ser un plugin delegado o parte de un agente específico del proveedor |
| Agente de nodo opcional | Mantiene rutas, políticas, grupos de IP o estado de datapath específicos del proveedor |
El runtime pasa la configuración al plugin mediante la interfaz CNI; un agente independiente de larga ejecución o un binario IPAM no son obligatorios para cada plugin. Los tipos de interfaz también varían: los pares veth son comunes, pero no son la única implementación.
Comparación de CNI
| Proyecto / ámbito | Networking y políticas | Características y límites que distinguir |
|---|---|---|
| Cilium 1.20.1 | Networking eBPF; Envoy para funciones L7 relevantes; políticas de red de Cilium y Hubble | Dataplane de worker Linux, con requisitos AMD64/Arm64. La disponibilidad de CLI de Windows no es soporte de CNI de Windows. WireGuard/IPsec y Beta ztunnel mTLS tienen ámbitos distintos. |
| Ejemplos de Calico Open Source 3.32.2; 3.33.0 actual | Opciones de enrutamiento/encapsulación; opciones de iptables, nftables y eBPF; niveles de política ordenados y políticas de host/carga de trabajo | Calico 3.33.0 se prueba en Kubernetes 1.35–1.37. Revise sus notas de versión antes de actualizar. Windows tiene límites separados, incluidos ningún dataplane Linux eBPF o WireGuard. La observabilidad de flujos Whisker/Goldmane está disponible como Tech Preview. Consulte la matriz de ediciones para capacidades de pago. |
| Flannel 0.28.9 | Asignación de subred de host y transporte entre nodos; VXLAN, host-gw y otros backends | flanneld por sí mismo no aplica NetworkPolicy; el netpol.enabled opcional del gráfico implementa un controlador de políticas SIGs. WireGuard es un backend documentado; IPsec es experimental. Windows VXLAN tiene configuraciones/límites específicos. |
Ejemplos upstream/Helm de AWS VPC CNI 1.23.0; complemento EKS v1.23.1-eksbuild.1 | Asignación de direcciones VPC y ENI/prefijos EC2; capacidades de políticas de red estándar y Admin de EKS en nodos EC2 Linux compatibles | AWS enumera esta compilación de complemento administrado para Kubernetes 1.31–1.37; verifique la disponibilidad regional y la versión real del clúster. EKS Auto Mode es una implementación de networking administrada con capacidades adicionales de política DNS. Windows, Fargate, networking personalizado, delegación de prefijos y soporte multi-NIC tienen condiciones separadas. |
| Proyecto original Weave Net | Implementación histórica de networking superpuesto | El repositorio original weaveworks/weave está archivado. No lo describa como un valor predeterminado activo y compatible para un clúster nuevo. |
Política, cifrado y observabilidad
- Cilium proporciona política consciente de HTTP/DNS mediante los componentes L7 aplicables, y política de host/de todo el clúster. Su semántica de denegación/permiso no es la API de Tier ordenado de Calico.
- Calico Open Source incluye niveles de política jerárquicos y política de host. La matriz de productos actual asigna política de capa de aplicación, política DNS/FQDN y Cluster Mesh a Cloud/Enterprise; no deben atribuirse silenciosamente a la edición open-source. El cifrado en tránsito documentado de Calico usa WireGuard.
- Amazon EKS proporciona controles Admin/Baseline
ClusterNetworkPolicypara Auto Mode e instalaciones EC2/VPC-CNI compatibles. La función DNS/FQDNApplicationNetworkPolicydescrita por AWS es para Auto Mode. Su nombre no implica una inspección actual de método/cuerpo HTTP. - El controlador de políticas opcional de Flannel tiene sus propios requisitos; seleccionar solo un backend de networking no habilita la aplicación.
- El cifrado de nodo a nodo, la identidad autenticada de carga de trabajo y mTLS de aplicación son controles diferentes. La visibilidad del flujo de red también difiere del tracing de aplicación o la aplicación de proceso/archivo.
Enrutamiento y rendimiento
Calico y Cilium pueden anunciar rutas mediante BGP; eso no proporciona por sí mismo descubrimiento de Service multiclúster, sincronización de políticas ni cifrado. Flannel host-gw usa rutas directas y requiere conectividad adecuada de capa 2. Una superposición añade consideraciones de encapsulación y MTU, pero no puede inferirse una clasificación de rendimiento universal del nombre de CNI.
La antigua cifra de rendimiento de 100/98/95/85/80/75 por ciento no tenía una carga de trabajo reproducible, versiones ni fuente de medición. Use hardware, kernel, tamaños de paquete/solicitud, concurrencia, configuración de cifrado/política, rendimiento, pérdida y latencia de cola comparables. El benchmark de Pod independiente conserva su propio entorno y mediciones históricos.
Guía de selección de CNI
Elija primero el modelo requerido de enrutamiento, política, sistema operativo y soporte; luego pruebe esa combinación.
| Necesidad | Ruta de evaluación |
|---|---|
| Direccionamiento VPC estándar de EKS y políticas de red compatibles | Evalúe las capacidades de AWS VPC CNI/EKS antes de agregar un segundo motor de políticas. |
| Niveles de política ordenados, política de host o BGP de infraestructura | Evalúe la edición/dataplane de Calico pertinente y los requisitos previos de enrutamiento. |
| Política de Cilium, Hubble o características de mesh seleccionadas | Compruebe la compatibilidad de Linux/kernel/plataforma y la guía de mesh de Cilium. Envoy sigue formando parte de las rutas L7 aplicables. |
| Una red pequeña con un conjunto limitado de características | Evalúe el backend y el controlador de políticas opcional de Flannel según los requisitos reales. |
| Aplicación de procesos, syscalls o archivos | Evalúe por separado un componente de seguridad en runtime como Tetragon de la política de red. |
Configuración de complementos administrados de EKS
Lo siguiente es un ejemplo de payload de configuración, no una instrucción para instalar tanto Calico como el motor de políticas VPC CNI en las mismas cargas de trabajo:
{
  "enableNetworkPolicy": "true"
}
La cadena "true" es el tipo documentado para esta configuración. Seleccione una compilación de complemento EKS compatible para la versión de Kubernetes existente e inspeccione el esquema de configuración de esa compilación:
EKS_REGION=ap-northeast-2
KUBERNETES_MINOR=1.35  # Replace with the existing cluster's minor version
aws eks describe-addon-versions --region "$EKS_REGION" --addon-name vpc-cni \
  --kubernetes-version "$KUBERNETES_MINOR"
: "${VPC_CNI_ADDON_VERSION:?Set the compatible eksbuild version selected from metadata}"
aws eks describe-addon-configuration --region "$EKS_REGION" --addon-name vpc-cni \
  --addon-version "$VPC_CNI_ADDON_VERSION"
El número de versión upstream 1.23.0 y una versión EKS eksbuild son identificadores distintos. La tabla actual de complementos de AWS enumera v1.23.1-eksbuild.1 para Kubernetes 1.31–1.37; use describe-addon-versions en la Region de destino para seleccionar una compilación compatible. Fusione los cambios con la configuración prevista del complemento administrado; no seleccione a ciegas latest ni reemplace valores no relacionados. Una migración desde una implementación de política de terceros también necesita la eliminación de su estado de aplicación existente y un plan probado de transición de nodos/cargas de trabajo.
Fundamentos de networking de EKS
Arquitectura de networking predeterminada de EKS
| Ubicación / componente | Responsabilidad |
|---|---|
| VPC administrada por EKS | AWS ejecuta el plano de control de Kubernetes administrado en varias Availability Zones. |
| VPC de clúster del cliente | El networking de workers, las subredes seleccionadas y los ENI entre cuentas administrados por EKS proporcionan las rutas configuradas hacia el plano de control. |
| ALB/NLB en subredes VPC seleccionadas del cliente | Proporciona el punto de entrada de aplicación público o interno elegido; un internet gateway/NAT gateway no sustituye esa configuración de enrutamiento. |
| NAT gateway o endpoints de servicio privados | Proporciona las rutas salientes concretas que requiere el diseño de la carga de trabajo. |
La figura anterior colocaba el plano de control dentro de la VPC del cliente y los balanceadores de carga fuera de ella; ha sido reemplazada por estos límites de propiedad.
DNS y networking por modo de cómputo
| Modo de cómputo | Ubicación de DNS / componente |
|---|---|
| Nodos EC2 estándar | Normalmente usan el Deployment de CoreDNS configurado y los componentes de networking instalados; los reemplazos necesitan su propia configuración compatible. |
| EKS Auto Mode puro | Las funciones de CoreDNS, VPC CNI y kube-proxy se ejecutan como servicios systemd de nodo administrados. Un Deployment/complemento de CoreDNS es innecesario para estos nodos. |
| Auto Mode mezclado con nodos que no son Auto | Mantenga el Deployment de CoreDNS para los nodos que no son Auto; no pueden usar el servicio DNS Auto Mode de otro nodo. |
El primer resolvedor DNS de Auto Mode es local al nodo. El reenvío upstream y la comunicación con el plano de control aún pueden requerir acceso de red; esto no garantiza que cada paquete relacionado con DNS permanezca en el nodo. AWS documenta políticas Admin y DNS para Auto Mode, mientras que la política Admin VPC-CNI de EC2 estándar tiene sus propios requisitos de versión/habilitación.
Cómo funciona VPC CNI
AWS VPC CNI proporciona a los Pods ordinarios direcciones enrutables por VPC mediante el modo IPAM seleccionado. Las direcciones IPv4 secundarias, los prefijos delegados, los ENI de rama y las configuraciones multi-NIC difieren; los Pods de red de host comparten la red del nodo.
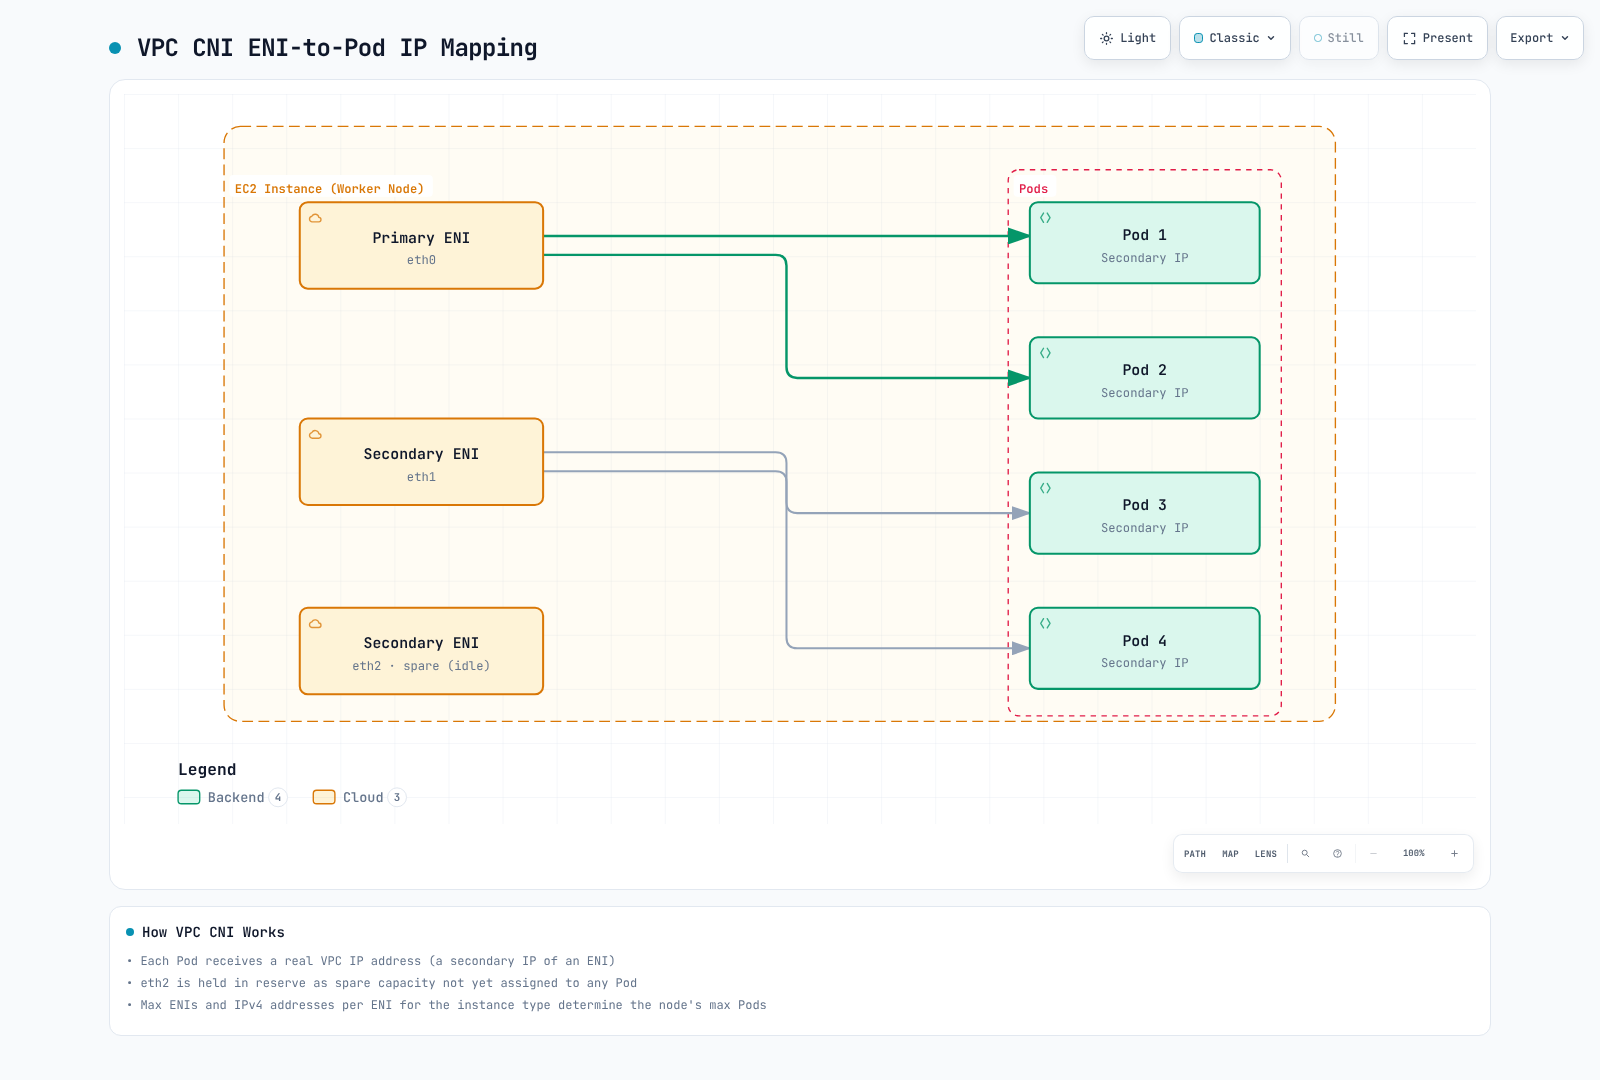
Esto representa solo el modo de IP secundaria. Un ENI cálido es una estrategia de asignación configurable, no un requisito de que cada nodo siempre reserve exactamente uno. La delegación de prefijos, el networking personalizado y los ENI de rama tienen reglas de asignación distintas.
Límites de ENI e IP
| Tipo de instancia | Máx. ENI | Slots IPv4 por ENI | Valor de arranque de IP secundaria heredada |
|---|---|---|---|
| t3.medium | 3 | 6 | 17 |
| t3.large | 3 | 12 | 35 |
| m5.large | 3 | 10 | 29 |
| m5.xlarge | 4 | 15 | 58 |
| m5.2xlarge | 4 | 15 | 58 |
| c5.4xlarge | 8 | 30 | 234 |
Estos valores se verifican contra los límites de instancias de VPC CNI 1.23.0 y la tabla heredada de max-Pods. El cálculo histórico es ENIs × (IPv4 slots per ENI − 1) + 2; no es una recomendación universal actual. La delegación de prefijos, el networking personalizado, los ENI de rama y múltiples tarjetas de red cambian la capacidad de direcciones. La programación de Kubernetes también está limitada por maxPods de kubelet y los recursos. Los grupos de nodos administrados de EKS limitan maxPods a 110 para instancias con menos de 30 vCPU y a 250 de otro modo; el recuento de IP disponibles por sí solo no anula ese límite.
Consideraciones de networking de EKS
Administración de direcciones IP
Para Linux VPC CNI, configure las variables de entorno documentadas mediante el mecanismo de administración de complemento/Helm/DaemonSet seleccionado. Lo siguiente es un fragmento de configuración de complemento EKS. El antiguo ConfigMap amazon-vpc-cni con enable-prefix-delegation no configura Linux IPAMD de esta manera. Conserve los demás valores previstos del complemento cuando aplique un cambio.
{
  "env": {
    "ENABLE_PREFIX_DELEGATION": "true",
    "WARM_PREFIX_TARGET": "1"
  }
}
Como alternativa, ajuste el mínimo total de asignación y el objetivo de IP libres. Cuando se configura MINIMUM_IP_TARGET o WARM_IP_TARGET, tiene prioridad sobre WARM_PREFIX_TARGET; son políticas alternativas en vez de cuatro objetivos aditivos independientes. La asignación todavía se produce en unidades del tamaño de prefijo. El soporte Nitro, espacio /28 contiguo para IPv4 y un límite de Pod kubelet adecuado son requisitos previos separados.
La asignación de prefijos de Windows es una ruta de configuración diferente: AWS documenta enable-windows-prefix-delegation y sus claves de objetivo cálido en el ConfigMap amazon-vpc-cni. No copie sin cambios el procedimiento de variables de entorno de Linux a Windows.
{
  "env": {
    "ENABLE_PREFIX_DELEGATION": "true",
    "MINIMUM_IP_TARGET": "5",
    "WARM_IP_TARGET": "2"
  }
}
Networking personalizado
Estos ejemplos IPv4 requieren ID reales de subred/grupo de seguridad en la AZ y VPC previstas. Habilite el networking personalizado y seleccione el ENIConfig de cada nodo mediante su etiqueta de zona. Una anotación de nodo ENIConfig explícita tiene prioridad sobre esa etiqueta. Los nombres de ejemplo siguientes usan la misma región en ambos idiomas; reemplácelos con las zonas de nodo reales. Instalar objetos ENIConfig por sí solo no activa el networking personalizado.
{
  "env": {
    "AWS_VPC_K8S_CNI_CUSTOM_NETWORK_CFG": "true",
    "ENI_CONFIG_LABEL_DEF": "topology.kubernetes.io/zone"
  }
}apiVersion: crd.k8s.amazonaws.com/v1alpha1
kind: ENIConfig
metadata:
name: ap-northeast-2a
spec:
securityGroups:
- sg-0123456789abcdef0
subnet: subnet-0123456789abcdef0
---
apiVersion: crd.k8s.amazonaws.com/v1alpha1
kind: ENIConfig
metadata:
name: ap-northeast-2b
spec:
securityGroups:
- sg-0123456789abcdef0
subnet: subnet-fedcba9876543210fConceptos avanzados de networking
Los elementos siguientes se mencionan de paso en otra parte de esta descripción general. Los procedimientos completos de configuración y las cifras medidas están en las páginas de análisis profundo vinculadas; esta sección organiza cómo estas piezas difieren por capa y dónde encaja cada una.
L2–L7 y la diferencia entre routers y balanceadores de carga
"Router" y "load balancer" a menudo aparecen en la misma oración, pero responden a preguntas distintas. Un router elige (por lo general) una ruta hacia un único destino; un balanceador de carga elige un destino entre varios candidatos equivalentes usando un algoritmo de distribución.
| Capa | Dispositivo/función | Base de decisión | Correspondencia Kubernetes/AWS |
|---|---|---|---|
| L2 (enlace) | Switch, bridge | Dirección MAC de destino | Pares veth y bridges de Linux creados por el CNI, la NIC virtual que expone un ENI |
| L3 (red) | Router o inserción transparente de appliance | IP de destino para enrutamiento; identidad de flujo para selección de appliance | El router implícito de la VPC, TGW; GWLB encapsula paquetes IP para appliances |
| L4 (transporte) | Balanceador de carga L4 | Identidad de conexión/flujo, comúnmente la 5-tupla | NLB; kube-proxy (iptables, IPVS, nftables); implementaciones de Service eBPF independientes |
| L7 (aplicación) | Balanceador de carga/proxy inverso L7 | Host, ruta, encabezados por solicitud; consciente del protocolo | ALB, implementaciones de Ingress/Gateway API, sidecars de service mesh (Envoy) |
La diferencia clave es la unidad de distribución. Un balanceador de carga L4 normalmente selecciona un destino para una conexión TCP o un flujo UDP rastreado. Un proxy L7 puede seleccionar un destino para cada solicitud de aplicación compatible, incluidas las solicitudes que comparten una conexión. GWLB distribuye flujos IP encapsulados entre appliances de seguridad en lugar de analizar solicitudes de aplicación. La afinidad de flujo depende del timeout, la salud y el comportamiento de failover configurados; no es garantía de que un flujo nunca pueda reasignarse o interrumpirse.
📎 Las definiciones a nivel de protocolo de los conceptos L2/L3 están en Fundamentos de red Parte 1; los tipos de destino ALB/NLB y la configuración real están en AWS Load Balancer Controller.
Conectividad entre cuentas/VPC: TGW, VPC Peering, GWLB, PrivateLink, Lattice
Estas cinco opciones de conectividad difieren en capa y modelo de tráfico. La latencia medida entre uso compartido de TGW RAM, VPC Peering, PrivateLink, TGW Peering y VPC Lattice está en Conectividad VPC entre organizaciones. Esta sección agrega GWLB, que no está en esa tabla de comparación, y replantea las cinco por capa.
| Conectividad | Capa/modelo | Características |
|---|---|---|
| VPC Peering | L3, enrutamiento IP bidireccional | No transitivo; no puede configurarse entre CIDR superpuestos |
| Transit Gateway (TGW) | L3, enrutamiento IP hub-and-spoke | Usa asociaciones y propagación de adjuntos entre una o más tablas de rutas TGW; compartido entre cuentas mediante RAM |
| Gateway Load Balancer (GWLB) | L3, inserción transparente de appliance | Encapsula el paquete original en GENEVE (UDP 6081); un modelo de servicio de endpoint VPC conecta el tráfico del consumidor con la flota de appliances del proveedor |
| PrivateLink | Conectividad de endpoint privado | Un servicio de endpoint respaldado por NLB es un modelo; también existen endpoints de recursos. Los CIDR de consumidor/proveedor pueden superponerse |
| VPC Lattice | Networking de aplicaciones y recursos | Los servicios HTTP/HTTPS admiten enrutamiento L7 y autorización IAM opcional; el paso de TLS y las configuraciones de recursos tienen capacidades diferentes |
GWLB inserta appliances de inspección, como firewalls e IDS/IPS, en una ruta IP a través de un endpoint de Gateway Load Balancer. Su afinidad de flujo predeterminada usa cinco campos; las configuraciones compatibles pueden usar en su lugar dos o tres. Valide las rutas de ida y vuelta, la salud de los appliances, la MTU de encapsulación, las NACL y los grupos de seguridad de las cargas de trabajo/appliances reales. GWLB en sí no tiene un grupo de seguridad como el de ALB, y la afinidad de flujo no sustituye las pruebas de fallos.
Para el diseño de seguridad, consulte protección WAF/origen, NGFW de Palo Alto/Fortinet y rutas y fallos de GWLB/GENEVE. GWLBE tampoco admite SG. Para destinos completamente no saludables, AWS describe la selección de destino por flujo y descartes hasta la recuperación, sin bypass directo del appliance. Revise conjuntamente la afinidad de tupla reducida, cross-zone, NAT y el modo appliance de TGW.
📎 La integración completa de EKS/VPC Lattice (Gateway API Controller, autorización IAM, enrutamiento) está en VPC Lattice.
Cómo se comportan realmente el resolvedor DNS y las tablas de rutas
Resolvedor DNS: AmazonProvidedDNS es Route 53 Resolver. Sus direcciones incluyen la dirección de red IPv4 principal de la VPC más dos (10.0.0.2 para 10.0.0.0/16) y 169.254.169.253; resuelve zonas privadas asociadas y nombres públicos de acuerdo con las reglas de Resolver. CoreDNS normalmente sirve el dominio de clúster Kubernetes configurado, a menudo cluster.local; kube-dns es su nombre de Service, no un namespace ni una zona DNS. El reenvío externo sigue el Corefile y el archivo de resolvedor visible para el Pod DNS. Inspeccione esas configuraciones en vez de suponer que el archivo de resolvedor del nodo se usa sin cambios. En un diseño de endpoint Resolver, los endpoints de entrada aceptan consultas on-premises, mientras que los endpoints de salida y reglas asociadas reenvían consultas VPC seleccionadas al DNS on-premises. El resolvedor local al nodo de Auto Mode no elimina dependencias upstream.
Tablas de rutas: La evaluación de rutas de VPC generalmente usa coincidencia de prefijo más largo. AWS permite reemplazar el destino de una ruta local y agregar rutas de subred más específicas compatibles para enrutamiento de appliance; local no es incondicionalmente la ruta más específica. Para destinos idénticos, las rutas VPC estáticas tienen prioridad sobre las rutas propagadas desde un virtual private gateway. Una ruta VPC dirigida a un TGW es estática; la propagación dentro de un TGW pertenece a sus tablas de rutas independientes. Los destinos no válidos pueden dejar entradas blackhole que descartan tráfico, por lo que debe inspeccionar el estado de ruta además del destino. Una subred sin asociación explícita de tabla de rutas usa la tabla de rutas principal de la VPC.
📎 La prioridad de rutas TGW/Peering y ejemplos de configuración de rutas estáticas están en los hallazgos operativos de Conectividad VPC entre organizaciones.
El plano de datos del kernel: iptables, IPVS, eBPF y filtrado de paquetes
El reenvío de Service de Linux y la aplicación de políticas de red pueden usar mecanismos diferentes. Netfilter proporciona hooks de rutas de paquetes usados por iptables y nftables. Las implementaciones eBPF pueden adjuntarse a hooks XDP, tc o socket y realizar allí la selección de Service. Esto no significa que cada paquete de un clúster con eBPF habilitado evite Netfilter o el seguimiento de conexiones; la ruta depende de CNI, kernel, enrutamiento y configuración de características.
| Implementación | Dónde se sitúa | Características |
|---|---|---|
| iptables | Cadenas de reglas secuenciales en hooks de netfilter | El tiempo de evaluación escala con el número de reglas (O(n)); modo predeterminado de larga trayectoria de kube-proxy |
| IPVS | Balanceador de carga L4 nativo del kernel, una extensión de netfilter | Búsqueda basada en hash (casi O(1)); obsoleto como modo kube-proxy a partir de Kubernetes 1.35 |
| nftables | Marco sucesor de netfilter para iptables | Modo estable de kube-proxy desde 1.33; compruebe primero la compatibilidad kernel/CNI |
| eBPF (p. ej., Cilium) | Hooks XDP, tc y socket configurados | Puede reemplazar el manejo de Service de kube-proxy; es una implementación independiente, con comportamiento Netfilter/conntrack específico de la ruta |
Cambiar implementaciones puede dejar reglas de kernel y conexiones activas. Siga el procedimiento de migración de la distribución/CNI, drene cargas de trabajo según sea necesario y planifique reinicios de nodo cuando la limpieza los requiera. Reemplazar kube-proxy por un CNI basado en eBPF también requiere un orden de transición compatible para que las implementaciones no compitan por el mismo tráfico de Service.
📎 La cronología de la obsolescencia de IPVS y la transición estable a nftables se tratan en Introducción a Kubernetes; el reemplazo de kube-proxy eBPF de Cilium está en Cilium eBPF; el plano de datos eBPF de Calico y su procedimiento de migración están en Calico eBPF.
Networking intensivo en cómputo: ENI, EFA, NVLink y transceptores ópticos
ENI, EFA y NVLink sirven rutas diferentes. Un ENI es una interfaz de red virtual asociada a una instancia EC2 en una Availability Zone; su tráfico IP normal puede llegar a otras AZ y VPC conectadas cuando el enrutamiento y la política lo permiten (consulte VPC CNI). EFA proporciona un dispositivo de omisión de SO usado mediante libfabric por software MPI/NCCL compatible. El tráfico de dispositivos EFA no es enrutable y no puede cruzar límites de VPC/AZ; el tráfico IP normal mediante el dispositivo ENA de una interfaz EFA-with-ENA sigue siendo enrutable. Las interfaces solo EFA no tienen dispositivo ENA ni direccionamiento IP. NVLink conecta GPU dentro de sistemas compatibles, incluidos dominios NVLink a escala de rack compatibles. Mida el hardware seleccionado, las operaciones colectivas y la ubicación en vez de suponer una aceleración fija sobre EFA.
Los transceptores ópticos son un concepto general de networking de centros de datos. Los cables DAC (Direct Attach Copper) de cobre son adecuados para tramos cortos; los módulos ópticos y la fibra admiten otros requisitos de alcance y ancho de banda. QSFP y OSFP describen factores de forma de módulos, no una garantía de medios ópticos. Trate esto como información general: no establece el cableado físico de una carga de trabajo AWS concreta.
📎 La programación consciente de topología NVLink/IMEX y los ejemplos de colocación de GPU Pod están en Infraestructura de IA/ML; la restricción de límite VPC/AZ de EFA y las mediciones están en Conectividad VPC entre organizaciones.
Qué significan los protocolos de próxima generación para Kubernetes: HTTP/3, gRPC, QUIC
La mecánica de protocolo de HTTP/3 (RFC 9114) y su transporte QUIC (RFC 9000) se trata en Fundamentos de red Parte 2 y Parte 3. Aquí cubrimos solo lo que realmente afecta a la distribución de tráfico de Kubernetes.
- gRPC y balanceadores de carga L4: gRPC multiplexa solicitudes sobre conexiones HTTP/2. Un balanceador L4 normalmente mantiene una conexión TCP establecida en su endpoint seleccionado; si ese endpoint es un proxy, puede tomar decisiones de enrutamiento adicionales. Agregar Pods por sí solo no redistribuye las conexiones existentes. La distribución por RPC requiere un proxy L7 compatible o una política del lado del cliente. Un RPC de streaming sigue siendo una llamada; sus mensajes individuales no se equilibran de forma independiente.
- GRPCRoute de Gateway API: Ingress no tiene un recurso específico de gRPC, pero Gateway API estandariza el enrutamiento a nivel de Service/método con
GRPCRoute. El soporte varía según la implementación (cuántas coincidencias de encabezados, políticas de reintento, etc.), por lo que debe consultar la documentación del propio controlador. - Hasta dónde HTTP/3/QUIC realmente llega al clúster: El soporte de HTTP/3 entre un cliente y el edge (una CDN, un balanceador de carga) es una cuestión distinta del soporte de HTTP/3 dentro del clúster o en una conexión backend de Ingress. Muchas implementaciones de Ingress/Gateway aún hablan HTTP/1.1 o HTTP/2 con el backend, y si se admite HTTP/3 de extremo a extremo varía según la implementación y la versión; no generalice, consulte la documentación del controlador realmente en uso.
Subpáginas de networking
Esta sección cubre en detalle los temas siguientes:
Networking de Linux desde el inicio
Si es nuevo en Linux o networking, comience con el curso para principiantes. Sus ocho lecciones conectan la CLI, direccionamiento, DNS, SSH, firewalls, monitoreo y un proyecto final. La ruta siguiente amplía esa base hacia protocolos, el kernel e implementaciones de clúster.
Ruta de networking experto
Después del curso para principiantes, use la ruta de networking experto para conectar proyectos de protocolos, políticas de enrutamiento, EVPN, rendimiento de Linux, diseño de nube y evaluación de automatización. Compruebe primero los criterios de entorno, evidencia y recuperación de cada cuaderno.
Práctica de diagnóstico de red de Linux
Conecte los conceptos de socket y ruta de paquetes del kernel con las observaciones antes de estudiar implementaciones CNI. Use el cuestionario de diagnóstico para comprobar su interpretación.
VPC CNI
Networking de EKS con direcciones VPC para Pods ordinarios y requisitos previos de IPAM/política específicos por modo.
Análisis profundo de Cilium
Solución CNI de alto rendimiento basada en eBPF. Proporciona características avanzadas como L7 Network Policy, Service Mesh y observabilidad (Hubble).
Análisis profundo de Calico
Uno de los CNI más utilizados. Potente Network Policy, soporte BGP y características empresariales. Abarca introducción, arquitectura, modos de networking, análisis profundo de BGP, Network Policy, eBPF, temas avanzados, integración con EKS y guía de operaciones.
VPC Lattice
Servicio de networking de aplicaciones administrado por AWS. Comunicación de servicio a servicio entre VPC y cuentas.
AWS Load Balancer Controller
Integra Kubernetes Services e Ingress con AWS ELB (ALB/NLB).
Gateway API
API de ingress de Kubernetes de próxima generación. Modelo de recursos estandarizado y configuración basada en roles.
Benchmark de red de Pod
RTT de Pod a Pod, latencia y rendimiento HTTP medidos en EKS para el mismo nodo, la misma AZ y entre AZ, además de amplificación de consultas DNS ndots:5.
Solución de problemas de red
Problemas y soluciones comunes
Fallo de comunicación de Pod a Pod
NAMESPACE=default
POD_NAME=iperf-client  # An existing diagnostic Pod with nslookup/curl
SERVICE_NAME=my-service
kubectl -n "$NAMESPACE" get pods -o wide
kubectl -n "$NAMESPACE" exec "$POD_NAME" -- nslookup "$SERVICE_NAME"
kubectl -n "$NAMESPACE" exec "$POD_NAME" -- \
  curl --connect-timeout 3 --max-time 5 -v "http://$SERVICE_NAME:80/"
kubectl -n kube-system logs -l k8s-app=aws-node -c aws-node --tail=100
kubectl -n kube-system logs -l k8s-app=cilium -c cilium-agent --tail=100
Ejecute el diagnóstico desde un Pod existente con las herramientas indicadas. Consulte solo el CNI instalado en el clúster; los servicios del sistema Auto Mode no son esos DaemonSets. El éxito de DNS, la accesibilidad TCP y una respuesta HTTP de aplicación son comprobaciones diferentes. ICMP puede estar bloqueado o requerir privilegios adicionales, por lo que un ping fallido por sí solo no prueba que un Service TCP sea inaccesible.
Service inaccesible
NAMESPACE=default
SERVICE_NAME=my-service
kubectl -n "$NAMESPACE" get service "$SERVICE_NAME" -o yaml
kubectl -n "$NAMESPACE" get endpointslices \
  -l "kubernetes.io/service-name=$SERVICE_NAME" -o yaml
kubectl -n kube-system logs -l k8s-app=kube-proxy --tail=100
Use EndpointSlice para el diagnóstico actual de endpoints. Compruebe los selectores de Service, los puertos de destino, la preparación de endpoints, la familia de direcciones y la política aplicable. Inspeccione los logs de kube-proxy solo si ese componente realmente posee el reenvío de Service; un reemplazo eBPF o Auto Mode necesita su propio diagnóstico.
Depuración de política de red
kubectl get networkpolicies.networking.k8s.io -A
kubectl -n kube-system exec ds/cilium -c cilium-agent -- cilium-dbg policy get
kubectl -n kube-system exec ds/cilium -c cilium-agent -- cilium-dbg endpoint list
# For a Calico installation using its standard CRD datastore:
kubectl get networkpolicies.crd.projectcalico.org -A
kubectl get globalnetworkpolicies.crd.projectcalico.org
Los comandos de Cilium inspeccionan un Agent seleccionado por la referencia DaemonSet; elija el Agent del nodo afectado al rastrear un incidente. Las instalaciones de API nativa de Calico pueden exponer un grupo de API diferente, por lo que debe inspeccionar los recursos servidos por la instalación. Las políticas de extensión de Kubernetes, Calico y AWS son recursos distintos y pueden tener prioridades diferentes.
Pruebas de rendimiento de red
Este ejercicio TCP acotado usa el índice de imagen Netshoot v0.16 fijado por el editor, que contiene imágenes Linux AMD64 y Arm64; su Dockerfile incluye iperf3. Cree estos Pods en un entorno de prueba donde se permita TCP 5201. Es una carga de trabajo ilustrativa, no una comparación medida de CNI.
apiVersion: v1
kind: Pod
metadata:
  name: iperf-server
  namespace: default
  labels:
    app: iperf-server
spec:
  restartPolicy: Never
  automountServiceAccountToken: false
  nodeSelector:
    kubernetes.io/os: linux
  containers:
  - name: netshoot
    image: nicolaka/netshoot:v0.16@sha256:b09d9b21381f47a79b3cbcb30da25266dc17186ea00ae65e99fdc51396f48e70
    command:
    - iperf3
    - -s
    workingDir: /tmp
    resources:
      requests:
        cpu: 100m
        memory: 64Mi
      limits:
        cpu: 500m
        memory: 256Mi
    securityContext:
      runAsNonRoot: true
      runAsUser: 1000
      allowPrivilegeEscalation: false
      capabilities:
        drop:
        - ALL
      seccompProfile:
        type: RuntimeDefault
    ports:
    - containerPort: 5201
      protocol: TCP
---
apiVersion: v1
kind: Pod
metadata:
  name: iperf-client
  namespace: default
  labels:
    app: iperf-client
spec:
  restartPolicy: Never
  automountServiceAccountToken: false
  nodeSelector:
    kubernetes.io/os: linux
  containers:
  - name: netshoot
    image: nicolaka/netshoot:v0.16@sha256:b09d9b21381f47a79b3cbcb30da25266dc17186ea00ae65e99fdc51396f48e70
    command:
    - sleep
    - '3600'
    workingDir: /tmp
    resources:
      requests:
        cpu: 100m
        memory: 64Mi
      limits:
        cpu: 500m
        memory: 256Mi
    securityContext:
      runAsNonRoot: true
      runAsUser: 1000
      allowPrivilegeEscalation: false
      capabilities:
        drop:
        - ALL
      seccompProfile:
type: RuntimeDefaultkubectl -n default wait --for=condition=Ready pod/iperf-server pod/iperf-client --timeout=120s
IPERF_SERVER_IP="$(kubectl -n default get pod iperf-server -o jsonpath='{.status.podIP}')"
test -n "$IPERF_SERVER_IP"
kubectl -n default exec iperf-client -- iperf3 -c "$IPERF_SERVER_IP" -t 10 -b 10MEl cliente duerme durante una hora y el comando limita el tráfico ofrecido a 10 Mbit/s durante diez segundos. Esto prueba la ruta seleccionada, no el rendimiento máximo. Registre la ubicación real de Pod/nodo/AZ, los límites de recursos y la política antes de interpretar los resultados. Elija herramientas específicas de Windows para nodos Windows. Elimine solamente los recursos de prueba que haya creado al finalizar.
Estos Pods de diagnóstico independientes son para pruebas de conectividad. Para las pruebas de aplicación de políticas de red nativas de EKS, use Pods administrados por Deployment/Job y los requisitos documentados de puerto de Service/contenedor.
Prácticas recomendadas
1. Planificación de direcciones IP
- Diseñe bloques CIDR lo bastante grandes
- Separe la red de Pod de la red de Service
- Diseñe subredes pensando en la expansión futura
2. Aplicar políticas de red
Cree el namespace aislado networking-demo antes de usar este ejemplo. Selecciona cada Pod allí y aísla tanto el ingress como el egress bajo la semántica estándar de Kubernetes NetworkPolicy; los flujos DNS y de aplicación requeridos necesitan reglas de permiso explícitas. La aplicación requiere un motor de políticas compatible. Las API adicionales de política de clúster/admin pueden alterar la prioridad, y este manifiesto no es una arquitectura completa de confianza cero.
- Aplique políticas de denegación predeterminada (Zero Trust)
- Permita explícitamente solo el tráfico necesario
- Aísle namespaces
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-all
  namespace: networking-demo
spec:
  podSelector: {}
  policyTypes:
  - Ingress
  - Egress
3. Optimización de rendimiento
- Elija el CNI adecuado (según la carga de trabajo)
- Optimización de MTU
- Ajuste de parámetros del kernel
4. Fortalecimiento de seguridad
- Seleccione cifrado de transporte compatible y verifique qué tráfico cubre.
- Configure identidad de carga de trabajo/aplicación y mTLS cuando sea necesario; manténgalos separados de las listas de permisos basadas en DNS/IP.
- Revise regularmente los cambios de política, certificados y control de acceso.
5. Garantizar la observabilidad
- Recopile métricas de red
- Habilite logs de flujo
- Implemente tracing distribuido
Próximos pasos
Después del curso para principiantes, continúe con la Pila de networking del kernel, luego con la Práctica de diagnóstico de red de Linux y su cuestionario. La ruta de aprendizaje conecta estos fundamentos con contenedores y Services antes de los temas de CNI y AWS que siguen.
- VPC CNI - CNI EKS predeterminado
- Análisis profundo de Cilium - Networking basado en eBPF
- Análisis profundo de Calico - Enrutamiento, política y dataplanes
- VPC Lattice - Networking administrado por AWS
- AWS Load Balancer Controller - Integración de ELB
- Gateway API - Ingress de próxima generación
- Conectividad VPC entre organizaciones - Conexión de VPC entre AWS Organizations (verificado en campo)
- Benchmark de red de Pod - Latencia y rendimiento medidos por límite de nodo/AZ
Referencias
- Modelo de red de Kubernetes
- Kubernetes Services
- Runtime de contenedor y CNI
- Kubernetes NetworkPolicy
- Especificación CNI
- Ediciones de producto Calico
- Lanzamiento de Calico Open Source 3.33.0
- Niveles de política de Calico
- Logs de flujo Whisker de Calico
- Limitaciones de Calico Windows
- Networking y política de Flannel 0.28.9
- Backends de Flannel
- Estado del repositorio original Weave
- AWS VPC CNI 1.23.0
- Últimas versiones del complemento VPC CNI de Amazon EKS
- Configuración de política de red de EKS
- Políticas de red estándar y Admin de EKS
- Delegación de prefijos y maxPods de EKS
- Modelos de implementación de políticas Admin y DNS de EKS
- Networking de EKS Auto Mode
- Requisitos de complementos de EKS
- Arquitectura de plano de control de EKS
- Metadatos de imagen Netshoot v0.16
- Dockerfile de Netshoot v0.16
- Seguridad de runtime Tetragon
- Configuración NLB de AWS LBC 3.5
- Configuración Ingress de AWS LBC 3.5
- Conceptos de Gateway Load Balancer
- Encapsulación GENEVE (RFC 8926)
- Resolvedor DNS de VPC
- Endpoints y reglas de Route 53 Resolver
- Orden de evaluación de tablas de rutas VPC
- Rutas locales y rutas de subred más específicas
- Prioridad de rutas estáticas y propagadas
- Direcciones y comportamiento de AmazonProvidedDNS
- Afinidad de flujo y failover de GWLB
- IP virtuales de Kubernetes Service y modos de kube-proxy
- Nombres de Service CoreDNS y configuración de reenvío
- Endpoints de recursos PrivateLink
- Documentación del proyecto Netfilter/iptables
- EC2 Elastic Fabric Adapter
- Protocolo de transporte QUIC (RFC 9000)
- HTTP/3 (RFC 9114)
- gRPC sobre HTTP/2 y balanceo de carga
- Gateway API GRPCRoute