Análisis detallado de Spark en EKS
Base de revisión: Apache Spark 4.2.0, Kubernetes 1.34 o posterior
Última revisión: 12 de septiembre de 2026
Apache Spark ejecuta cargas de trabajo distribuidas por lotes, SQL, streaming y otros tipos. La compatibilidad nativa con Kubernetes se incorporó en Spark 2.3; la compatibilidad con el modo cliente llegó en la versión 2.4. Spark 4.2.0 especifica Kubernetes 1.34 o posterior como requisito previo. Usa una versión de kubectl compatible con la versión real de EKS, no un mínimo fijo obsoleto.
Spark puede usar la capacidad y el plano de control de Kubernetes que ya operas, sin un master independiente de Spark Standalone ni un YARN ResourceManager. Aun así, debes operar o aprovisionar la capacidad de los nodos, las imágenes, la identidad, la red, el almacenamiento y la observabilidad. YARN ResourceManager y NodeManager son componentes de YARN, no demonios específicos de Spark.
Responsabilidades de ejecución
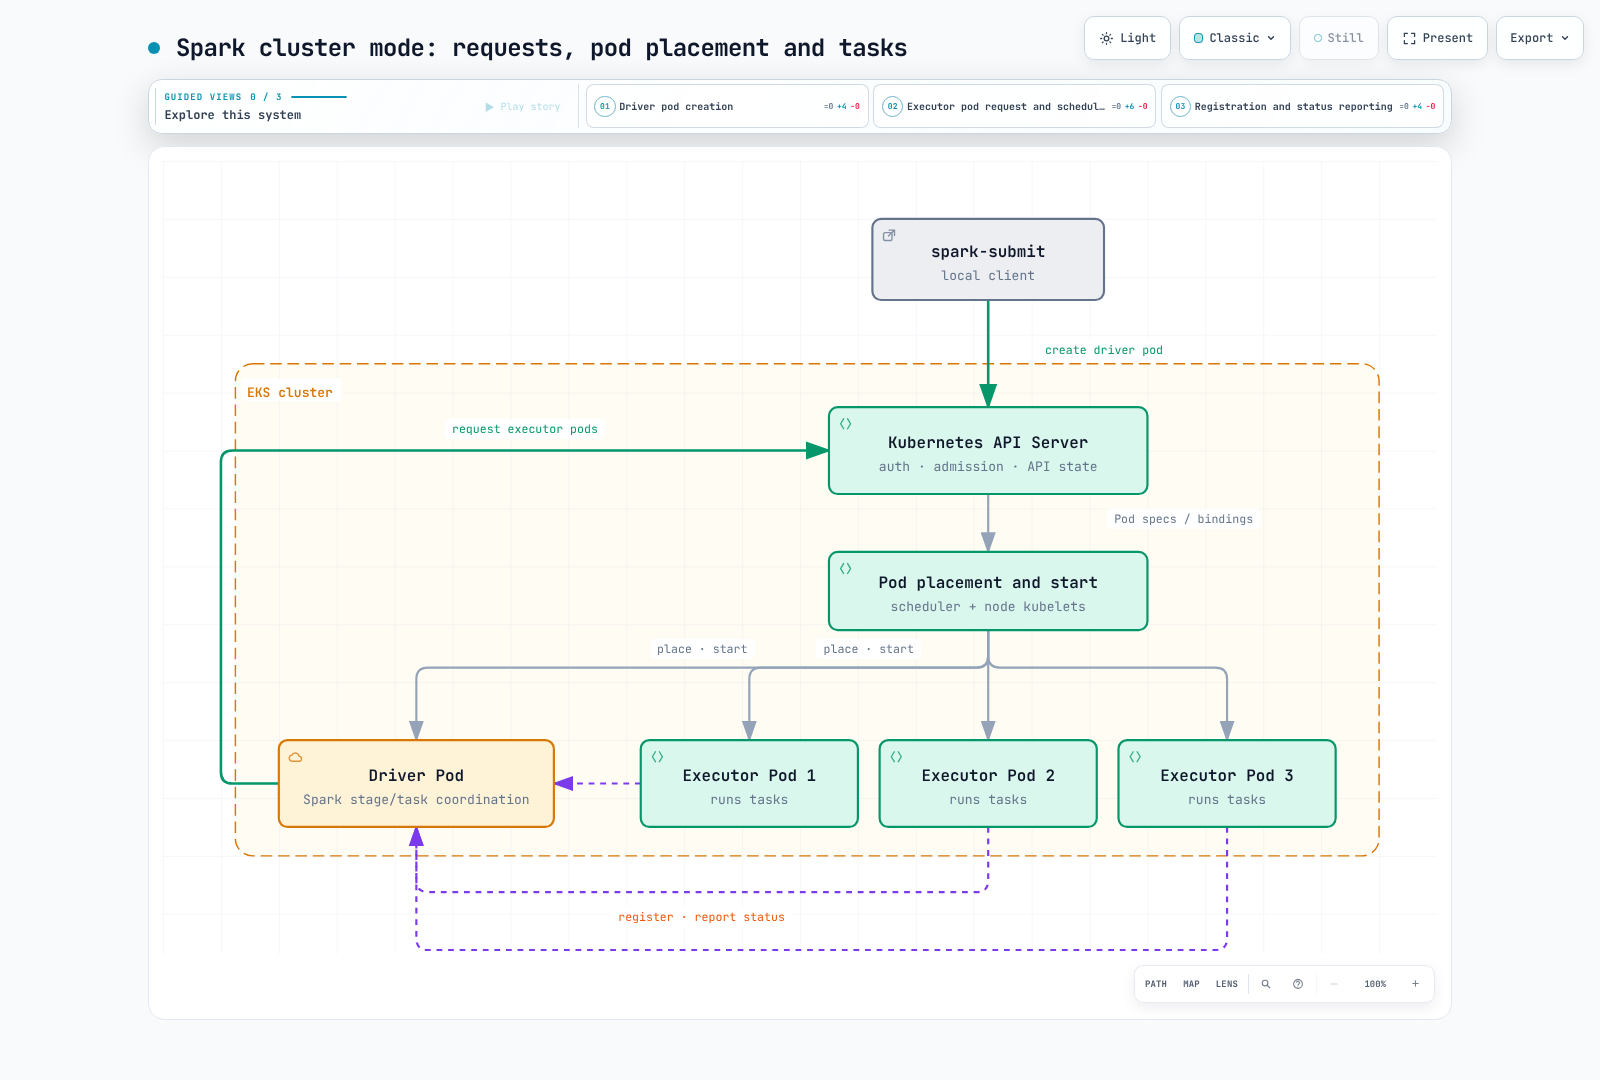
En el modo de implementación en clúster, el cliente que envía el trabajo solicita a la API de Kubernetes que cree el pod del driver. La admisión y la planificación de Kubernetes, junto con los kubelets de los nodos, gestionan la ubicación y el inicio del pod. El driver de Spark solicita pods de executor y coordina las etapas y tareas de Spark; no sustituye al planificador de Kubernetes.
Los executors se registran y se comunican directamente con el driver para el trabajo de Spark. Kubernetes sigue gestionando el ciclo de vida de sus pods. En el modo cliente, el driver se ejecuta junto con la aplicación que envía el trabajo, dentro de un pod o en otro host, y debe ser accesible para los executors. Ambos modos admiten aplicaciones Spark.
Capítulos
- Fundamentos de Spark en Kubernetes: envío en modo clúster o cliente, asignación de recursos, asignación dinámica y condiciones para la retirada ordenada de ejecutores.
- Spark Operator: distingue los operadores de Apache y Kubeflow, sus API, el ciclo de vida de los trabajos, el envío y la supervisión.
- EMR en EKS: clústeres virtuales, envío de trabajos e identidades de ejecución; distingue las funciones del entorno de ejecución administrado de las operaciones de capacidad de EKS.
- Rendimiento y costos: cuellos de botella de shuffle, almacenamiento, CPU y memoria; capacidades de nodo adecuadas, recuperación de Spot y escalado de executors frente al escalado de nodos.
- Prácticas recomendadas y seguridad: identidad de Kubernetes y AWS, acceso a datos, registros e historial de eventos, métricas, política de red y recuperación.
La asignación dinámica de recursos de Spark ajusta los executors dentro de una aplicación. Es distinta de la asignación dinámica de recursos de Kubernetes para dispositivos y del escalado automático de nodos. La retirada ordenada de ejecutores puede reducir el recálculo, pero no garantiza que todos los bloques sobrevivan a una terminación forzada.