Fundamentos de redes, parte 1 — El modelo de capas, capa de enlace y capa de enrutamiento
Última actualización: September 14, 2026
Esta es una serie de cuatro partes
Parte 1: El modelo de capas, capa de enlace y capa de enrutamiento (este documento) · Parte 2: La capa de transporte y TLS · Parte 3: Protocolos de aplicación · Parte 4: El recorrido de una petición y la nube
Una petición del navegador depende de varios protocolos que cooperan entre sí. La secuencia exacta varía según las cachés, la reutilización de conexiones, la versión de IP y la versión de HTTP, así que la resolución de problemas debe examinar más que solo HTTP.
Esta serie recorre 25 protocolos y mecanismos de red, capa por capa, de abajo hacia arriba. La razón para construir desde abajo es simple: toda capa superior se diseña asumiendo que las capas inferiores ya funcionan. Si se lee de arriba hacia abajo, uno tropieza continuamente con la pregunta "pero ¿cómo funciona esa parte?".
Cada entrada sigue la misma estructura: definición en una línea → cómo funciona → dónde duele en la práctica.
0. El mapa de capas en una página
| Capa | Función | Protocolos tratados aquí |
|---|---|---|
| Aplicación | Semántica real del servicio | HTTP/3, WebSocket, WebRTC, gRPC, DNS, DoH, DHCP, MQTT, SSH, SMTP |
| Seguridad | Cifrado y autenticación (se apoya en el transporte) | TLS |
| Transporte | Entrega de datos de extremo a extremo | TCP, UDP, QUIC |
| Internet / Enrutamiento | Elección de rutas entre redes | IPv4, IPv6, ICMP, BGP, OSPF, NAT |
| Enlace | Entrega dentro de un mismo segmento físico | Ethernet, Wi-Fi, VLAN, PPP, ARP |
Algunas entradas se niegan a respetar límites de capa nítidos. TLS queda encajado entre transporte y aplicación, QUIC se apoya en UDP mientras hace el trabajo de una capa de transporte, y ARP tiende un puente entre IP y la capa de enlace. NAT es menos un protocolo que una función. Estas "excepciones" explican la mayor parte de la resolución de problemas del mundo real.
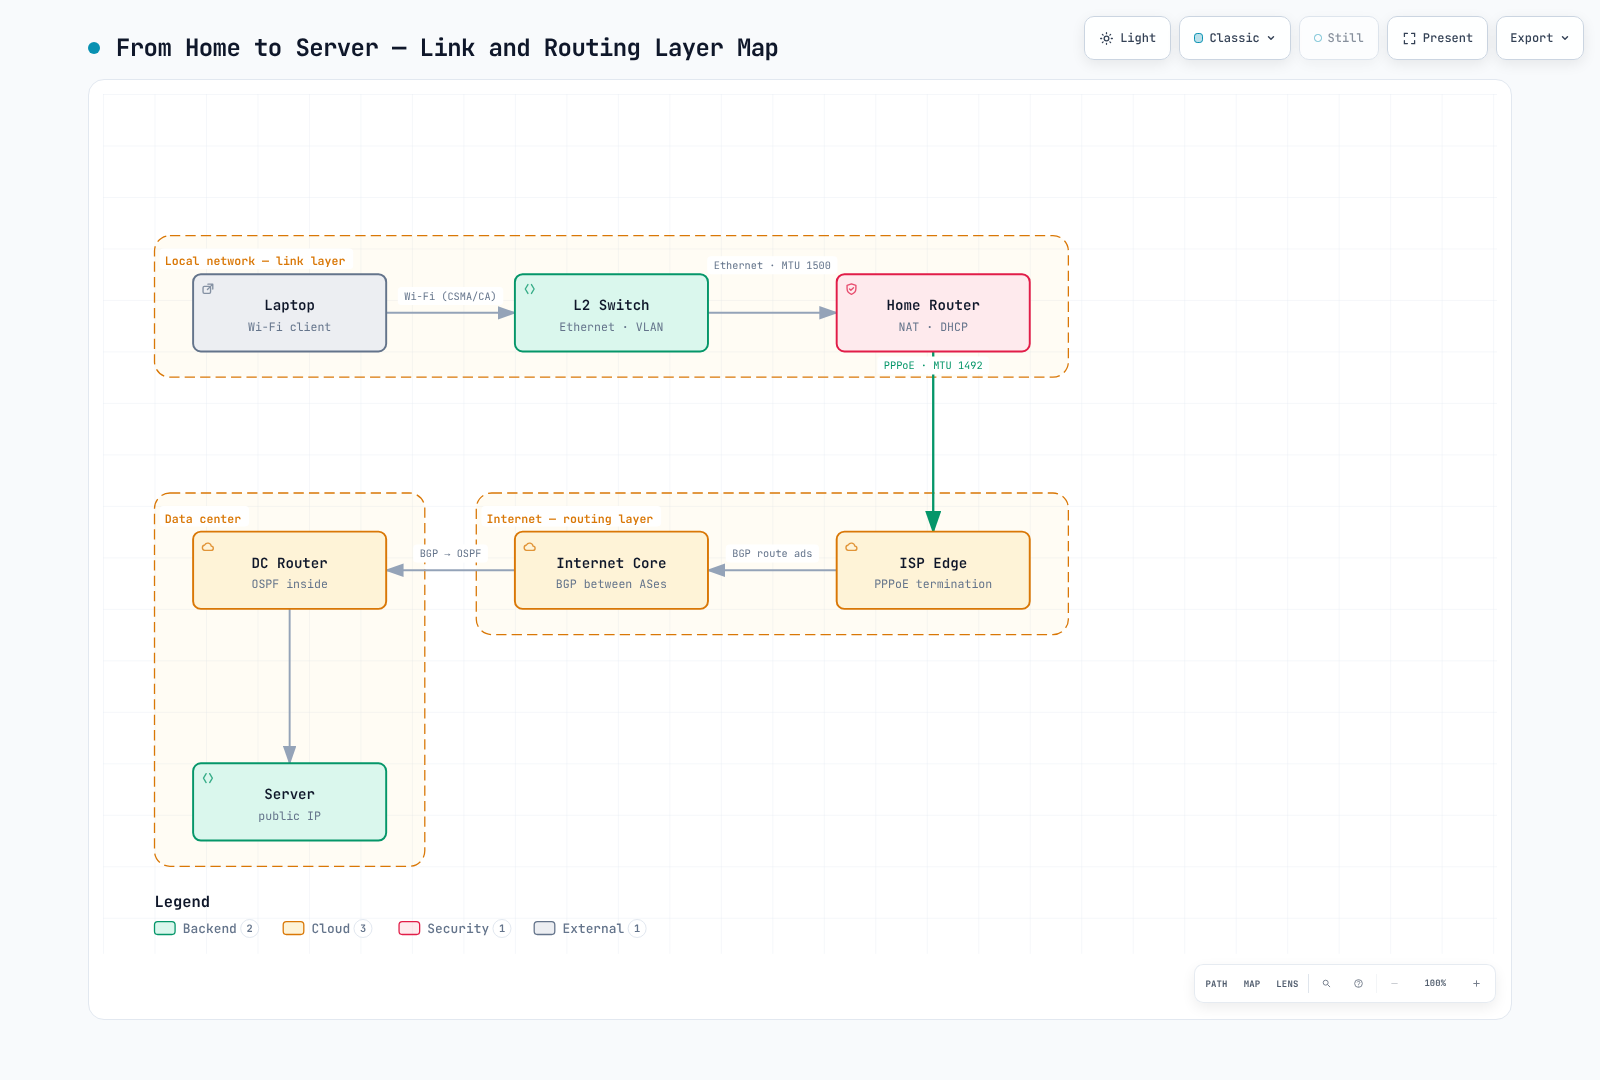
1. Capa de enlace — Mover bits dentro de un segmento
A la capa de enlace le importa exactamente una cosa: cómo entregar bits al dispositivo que está justo al lado. Tanto si el destino final es el rack siguiente como el otro extremo del planeta, esta capa solo es responsable del siguiente salto.
Ethernet
Definición: El estándar de capa de enlace que transporta tramas en redes locales cableadas.
Cómo funciona: Los datos se envuelven en tramas, con las direcciones MAC de destino y de origen al frente. Para unicast conocido, un switch usa su tabla MAC para seleccionar el puerto de destino. Las tramas de broadcast y de unicast desconocido normalmente se inundan dentro de la VLAN; el comportamiento de multicast depende de la configuración. La Ethernet inicial dependía de la detección de colisiones (CSMA/CD), pero en las redes conmutadas modernas full-duplex las colisiones han desaparecido prácticamente.
En la práctica: Para el tráfico IP sobre Ethernet, una MTU de 1500 significa un paquete IP de 1500 bytes dentro de la trama, excluyendo la cabecera Ethernet y el FCS. Las MTU jumbo son específicas del dispositivo o de la ruta; 9001 es un valor admitido en EC2, no un tamaño Ethernet universal. En la nube, superponer una VPN o una red overlay añade cabeceras de encapsulación que reducen la MTU efectiva, y un descubrimiento de MTU fallido puede producir un agujero negro que se manifiesta como "el ping funciona, pero las respuestas grandes se quedan colgadas". Es uno de los modos de fallo que más tarda en diagnosticarse.
MTU frente a MSS: El MSS limita los bytes de datos de TCP, no la trama completa. Con MTU 1500, el cálculo con cabeceras base da 1460 para IPv4 (1500−20−20) o 1440 para IPv6 (1500−40−20). El emisor reduce aún más los datos reales por cada opción IP/TCP que incluya. TCP intercambia el MSS durante el handshake, así que cuando los problemas de MTU se repiten a través de un túnel, el MSS clamping en el router (forzar un MSS de TCP más bajo) es una solución alternativa muy utilizada.
Wi-Fi
Definición: El estándar de capa de enlace que transporta tramas de LAN sobre un segmento inalámbrico (IEEE 802.11).
Cómo funciona: Como el aire es un medio compartido, Wi-Fi es fundamentalmente distinto de Ethernet. Wi-Fi evita depender de la detección de colisiones durante la transmisión y usa CSMA/CA: comprobar que el canal está libre antes de enviar y luego usar ACK/reintento para el tráfico unicast ordinario; el comportamiento de broadcast/multicast difiere. En otras palabras, la retransmisión ya viene incorporada en la capa de enlace.
En la práctica: La retransmisión de la capa de enlace apilada sobre la retransmisión de TCP infla la variación de latencia (jitter). Los problemas de calidad en tiempo real se reportan como "culpa del servidor" cuando el verdadero culpable es el segmento inalámbrico del cliente. El RTT del servidor por sí solo no permite localizar la causa; hay que correlacionarlo con el tiempo de procesamiento de la aplicación y con las métricas de reintentos, señal y colas del cliente y del AP.
VLAN
Definición: Una técnica para segmentar una infraestructura de switching compartida en redes L2 lógicas (IEEE 802.1Q).
Cómo funciona: Una trama etiquetada con 802.1Q lleva una etiqueta VLAN de 4 bytes. Los puertos de acceso pueden transportar tramas sin etiquetar que el switch asigna a una VLAN. Los broadcasts solo llegan a los hosts de la misma VLAN, así que se puede segmentar una red sin tocar el cableado. El tráfico entre VLAN debe pasar por un dispositivo L3 (un router o un switch L3).
En la práctica: Las VLAN proporcionan segmentación lógica L2, no aislamiento físico ni criptográfico. Los controles de enrutamiento y de firewall determinan el tráfico permitido entre segmentos. Las VPC, las subredes y los security groups cumplen funciones distintas en las redes de la nube; no son sustitutos uno a uno de las VLAN.
📎 Para ver cómo EKS estructura su VPC, consulta Fundamentos de redes en EKS.
PPP
Definición: Un protocolo que transporta paquetes sobre un enlace punto a punto que conecta exactamente dos nodos.
Cómo funciona: A diferencia de Ethernet, no se necesita direccionamiento: hay un solo nodo en cada extremo del enlace. En su lugar, PPP proporciona establecimiento del enlace, autenticación opcional y negociación del protocolo superior (LCP/NCP).
En la práctica: Parece una reliquia de la era del acceso telefónico, pero sobrevive como PPPoE en una gran parte de las líneas de internet residenciales. Con payloads Ethernet estándar de 1500 bytes, la habitual cabecera PPPoE de 6 bytes más el campo de protocolo PPP de 2 bytes deja 1492 bytes para IP; si se negocian capas subyacentes mayores se puede preservar 1500. Una reducción no contabilizada a 1492 puede causar los problemas de MTU descritos antes.
ARP
Definición: El protocolo que resuelve una dirección IPv4 de siguiente salto en el mismo enlace a una dirección MAC.
Cómo funciona: La capa IP dice "envía esto a 10.0.1.5", pero Ethernet solo entiende direcciones MAC. Así que el host difunde "¿quién tiene 10.0.1.5?" y el host propietario responde. El resultado se almacena en caché con estados y tiempos de expiración de vecinos específicos del sistema operativo. Para un destino fuera del enlace, el host resuelve la MAC de su gateway en lugar de la MAC del host remoto.
En la práctica: ARP no tiene autenticación. Cualquiera puede responder "esa IP es mía", que es exactamente lo que hace posible el ARP spoofing. La misma propiedad también se usa de forma legítima: en un failover, el nuevo nodo activo difunde un Gratuitous ARP para anunciar a los vecinos la correspondencia entre la VIP y la MAC; los switches también aprenden la ubicación de la MAC de origen a partir de la trama. Cuando una configuración de alta disponibilidad basada en VIP hace failover lentamente, el refresco tardío de la caché es el principal sospechoso.
📎 Para ver cómo Cilium integra el comportamiento de L2 y de enrutamiento con eBPF, consulta Redes con Cilium.
2. Capa de internet y enrutamiento — Cruzar redes
Si la capa de enlace te lleva "a la puerta de al lado", esta capa te lleva "al otro extremo del planeta". La pregunta central es: ¿a dónde debe ir este paquete a continuación?
IPv4
Definición: El protocolo de capa de internet construido sobre direcciones de 32 bits.
Cómo funciona: Todo paquete lleva las IP de origen y de destino; cada router busca la ruta más específica (coincidencia del prefijo más largo) en su tabla de enrutamiento y reenvía al siguiente salto. La entrega es de mejor esfuerzo: sin garantías, sin ordenación. Esas garantías son tarea de la capa superior (TCP).
En la práctica: IPv4 tiene unos 4.300 millones de direcciones posibles, y la escasez hizo que NAT se usara de forma generalizada y convirtió los rangos privados (10.0.0.0/8, 172.16.0.0/12, 192.168.0.0/16) en el estándar de las redes internas. El primer muro con el que chocan las grandes organizaciones durante la migración a la nube es el solapamiento en estos rangos privados: los CIDR solapados entre on-premises y VPC impiden un enrutamiento directo sobre VPN o Direct Connect sin una solución diseñada de renumeración, traducción o proxy. El diseño de direcciones IP es algo que hay que fijar al arrancar el proyecto.
IPv4, CIDR y un ejemplo resuelto de subred
IPv4 tiene cuatro octetos de 8 bits. En notación CIDR, /26 fija los primeros 26 bits como prefijo de red y deja 32 − 26 = 6 bits de host. Las direcciones siguientes son ejemplos de documentación del RFC 5737, no endpoints públicos de prueba.
Para una dirección de interfaz 192.0.2.130/26:
| Paso | Cálculo o resultado |
|---|---|
| Máscara de subred | 255.255.255.192; último octeto 11000000 en binario |
| Direcciones por bloque | 2^6 = 64; los bloques del último octeto empiezan en 0, 64, 128, 192 |
| Dirección de red | 130 AND 192 = 128 (10000010 AND 11000000 = 10000000), por tanto 192.0.2.128/26 |
| Dirección de broadcast | Poner a 1 los seis bits de host: 192.0.2.191 |
| Rango de hosts ordinarios | 192.0.2.129–192.0.2.190: 62 direcciones |
La interfaz posee .130; .128/26 identifica su subred. En una subred de broadcast ordinaria, las porciones de host todo ceros y todo unos identifican las direcciones de red y de broadcast. Un gateway, si está configurado, consume una dirección del rango de hosts; CIDR no exige que sea el primer host.
No apliques la regla de "restar dos" a todos los prefijos. El RFC 3021 permite usar ambas direcciones de un /31 en un enlace punto a punto compatible. Un /32 identifica una sola dirección, a menudo como ruta de host; no implica un par Ethernet directamente conectado. Las reglas de asignación de la nube son aparte: las subredes IPv4 estándar de una VPC de AWS reservan las cuatro primeras direcciones y la última, lo que deja 59 direcciones asignables en un /26, con excepciones como BYOIP. Consulta las reglas de subredes de VPC para el modo de asignación.
Prefijo más largo, siguiente salto y ARP
La búsqueda de ruta se produce antes de la resolución de vecinos. Considera esta tabla de enrutamiento ilustrativa en un host Linux con 192.0.2.130/26 en eth0:
| Prefijo de destino | Siguiente salto / interfaz |
|---|---|
192.0.2.128/26 | Directamente en eth0 (en el enlace) |
198.51.100.0/24 | Vía 192.0.2.129 en eth0 |
198.51.100.128/25 | Vía 192.0.2.190 en eth0 |
0.0.0.0/0 | Por defecto vía 192.0.2.129 en eth0 |
Dentro de la tabla seleccionada, se elige la ruta coincidente con el prefijo más largo (RFC 1812 §5.2.4.3):
- Para
192.0.2.150, la ruta/26está en el enlace: resuelve.150en sí con ARP si falta su entrada de vecino. - Para
198.51.100.140, coinciden/24,/25y/0; gana/25. Resuelve con ARP el gateway192.0.2.190, no el destino remoto. - Para
203.0.113.10, solo coincide/0: se usa el gateway192.0.2.129.
Para un paquete enrutado, el destino Ethernet es la MAC del gateway mientras que el destino IP sigue siendo el host remoto (en ausencia de NAT). Una métrica más baja en la ruta por defecto no gana a un /25 coincidente. Las reglas de política de Linux pueden seleccionar tablas distintas; inspecciona la búsqueda real con ip route get en el namespace de red correspondiente, como se describe en el manual de ip-route(8). El host y un contenedor pueden tener rutas y tablas de vecinos diferentes.
IPv6
Definición: El protocolo de capa de internet de nueva generación con direcciones de 128 bits.
Cómo funciona: Con direcciones de 128 bits, el agotamiento deja de ser un problema. La cabecera base tiene una disposición fija de 40 bytes y no lleva checksum de cabecera; los routers no fragmentan paquetes IPv6. SLAAC permite que los hosts se autoconfiguren direcciones sin DHCP, y ARP se sustituye por NDP (Neighbor Discovery Protocol).
En la práctica: IPv6 no es retrocompatible con IPv4, así que los despliegues reales funcionan en doble pila (dual stack), lo que implica mantener dos conjuntos de reglas de firewall y de políticas de seguridad. La falta de reglas en la ruta IPv6 es una brecha de seguridad habitual. Una dirección IPv6 global no hace por sí sola que una carga de trabajo sea alcanzable desde internet. AWS sigue exigiendo enrutamiento y tráfico permitido por security group y NACL; un egress-only internet gateway puede permitir IPv6 de salida sin conexiones entrantes no solicitadas.
Mecanismos de transición: Hay tres formas prácticas de coexistir con IPv4: doble pila (ejecutar ambos en paralelo, lo más común, a costa de duplicar las políticas), tunelización (envolver paquetes IPv6 en IPv4 para cruzar segmentos solo v4) y NAT64/DNS64 (traducir para que clientes solo-IPv6 puedan llegar a servidores IPv4; los operadores móviles lo usan a gran escala como 464XLAT). Kubernetes también admite Services de doble pila, así que el diseño del CIDR del cluster puede contemplar un rango IPv6 desde el principio.
ICMP
Definición: El protocolo de control que informa de errores y estado de la red.
Cómo funciona: ICMP transporta información de control y puede incluir payloads de Echo o datos citados del paquete original: destino inalcanzable, TTL excedido, fragmentación necesaria, etc. ping usa Echo Request/Reply; traceroute incrementa el TTL (o el Hop Limit de IPv6) un salto a la vez y lee los mensajes Time Exceeded que vuelven.
En la práctica: Bloquear ICMP por completo "por seguridad" es habitual, y es la causa directa del agujero negro de MTU mencionado antes. El PMTUD clásico de IPv4 usa ICMP Type 3 Code 4, mientras que IPv6 usa ICMPv6 Packet Too Big Type 2. Bloquear los mensajes necesarios puede provocar agujeros negros; PLPMTUD, en cambio, puede sondear tamaños de paquete sin depender de ICMP. Conserva el tráfico de error y descubrimiento necesario según la versión de IP y la política.
📎 Para ver cómo se manifiesta este fallo en EKS, consulta Análisis profundo de redes en EKS.
Interpretar la evidencia de ICMP y traceroute
En el reenvío IPv4, un router reduce el TTL del paquete; si expira, el router descarta ese sondeo y normalmente devuelve un ICMP Time Exceeded (Type 11, Code 0). Eso es lo esperado para un sondeo con TTL deliberadamente corto, no una prueba de que los paquetes ordinarios de la aplicación fallen. El error cita parte del paquete original para que el emisor pueda asociar la respuesta con su sondeo (RFC 792).
Mantén separados el sondeo de salida y la respuesta de vuelta. Estos métodos habituales de traceroute pueden recibir todos un ICMP Time Exceeded de routers intermedios:
| Sondeo enviado | Respuesta típica cuando se alcanza el destino |
|---|---|
| UDP a un puerto de destino no usado | ICMP Destination Unreachable, Port Unreachable (IPv4 Type 3, Code 3) |
| ICMP Echo Request | ICMP Echo Reply |
| TCP SYN a un puerto elegido | TCP SYN/ACK si el puerto está escuchando, o RST si está cerrado |
Los valores por defecto y las opciones varían según la implementación; el manual de traceroute(8) de Linux documenta los métodos UDP, ICMP y TCP. Un sondeo TCP prueba el tratamiento de ese puerto, pero ni siquiera un SYN/ACK demuestra que TLS o HTTP funcionen.
Un * significa que no llegó ninguna respuesta coincidente antes de que expirara la espera. El sondeo puede estar filtrado, el router puede suprimir o limitar la tasa de su respuesta, o la respuesta puede perderse en su camino de vuelta. Un salto silencioso con respuestas de saltos posteriores no demuestra pérdida de extremo a extremo. Cada RTT mostrado incluye un camino de vuelta que puede diferir del de ida; el balanceo de carga también puede exponer routers distintos entre sondeos. Compara observaciones repetidas con los resultados del destino y de la aplicación antes de localizar un fallo.
Traceroute explora sobre todo los saltos; los sondeos pequeños que tienen éxito no validan la MTU de la ruta. Un paquete IPv4 mayor con el bit DF puesto puede necesitar aún un Fragmentation Needed (Type 3, Code 4) para descubrir una MTU menor. Distingue ese mensaje de Time Exceeded y de Port Unreachable; y conserva las distinciones de IPv6 y PLPMTUD indicadas antes.
📎 Aplica el razonamiento sobre rutas y sondeos en el laboratorio de enrutamiento e ICMP en Linux y llévalo después a la resolución de problemas en contenedores y Kubernetes.
OSPF
Definición: Un protocolo de enrutamiento de estado de enlace que calcula rutas óptimas dentro de un único sistema autónomo.
Cómo funciona: Cada router inunda su estado de enlace por el área, de modo que los routers de la misma área convergen en una información de estado de enlace coherente y luego cada uno ejecuta el algoritmo de Dijkstra para calcular los caminos más cortos. Los costes de las interfaces se configuran (a menudo derivados del ancho de banda) y las redes se dividen en áreas para escalar.
En la práctica: OSPF es un IGP, para redes internas. La convergencia es rápida y las rutas se encuentran automáticamente, pero cada router mantiene información de estado de enlace de las áreas a las que está conectado, así que a gran escala el diseño de áreas determina el rendimiento.
BGP
Definición: Un protocolo de enrutamiento de vector de rutas que intercambia alcanzabilidad entre sistemas autónomos (AS).
Cómo funciona: El objetivo de BGP difiere del de OSPF: no elige "el camino más rápido", sino "el camino que prefiere la política". Cada AS anuncia los prefijos que puede alcanzar junto con el AS path; los receptores clasifican las rutas por atributos como la longitud del AS_PATH, Local Preference y MED. El enrutamiento de todo internet se apoya en esto.
En la práctica: BGP confía en los anuncios por defecto, y por eso los anuncios de prefijos erróneos pueden causar caídas generalizadas. La validación de origen con RPKI comprueba si el origen del prefijo está autorizado; no valida todo el AS path ni detiene todas las fugas de rutas. Desde la perspectiva de la nube, Direct Connect usa BGP; Site-to-Site VPN puede usar BGP o enrutamiento estático compatible, así que los números de AS, el diseño de los prefijos anunciados y la preferencia de rutas para la redundancia (AS_PATH prepending y compañía) se convierten en decisiones de diseño reales.
📎 Para ver cómo Calico usa BGP dentro de un cluster, consulta Análisis profundo de BGP en Calico.
NAT
Definición: Una función que traduce direcciones IP y, en el caso de NAPT/PAT, puertos de transporte.
Cómo funciona: Un caso común es que muchos hosts privados compartan una dirección pública mediante PAT/NAPT. La traducción también puede ser de privada a privada; no siempre se trata de compartir una dirección de internet pública. Una tabla de traducción guarda las correspondencias por sesión para que los paquetes de vuelta encuentren el camino de regreso al host interno correcto.
En la práctica: NAT es el ejemplo por excelencia de violación de capas: un dispositivo L3 que reescribe puertos L4, y rompe la conectividad de extremo a extremo, la premisa original de internet. Como consecuencia, P2P se vuelve difícil y se hacen necesarias soluciones alternativas como STUN/TURN (véase WebRTC más adelante). En la nube, los problemas prácticos son el agotamiento de puertos del NAT Gateway y los cargos por procesamiento de datos. Para cargas de trabajo con mucho tráfico de salida, los VPC endpoints pueden reducir el procesamiento de NAT para los servicios de AWS compatibles; compara sus cargos por hora y por datos y el camino del tráfico antes de dar por hecho el ahorro.
Siguiente: Parte 2: La capa de transporte y TLS
Referencias de verificación
- https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/network_mtu.html
- https://www.rfc-editor.org/rfc/rfc894
- https://www.rfc-editor.org/rfc/rfc6691
- https://www.rfc-editor.org/rfc/rfc4638
- https://www.rfc-editor.org/rfc/rfc5227
- https://www.rfc-editor.org/rfc/rfc792
- https://www.rfc-editor.org/rfc/rfc8899
- https://www.rfc-editor.org/rfc/rfc2328
- https://www.rfc-editor.org/rfc/rfc6811
- https://docs.kernel.org/networking/bridge.html
- https://docs.aws.amazon.com/vpc/latest/userguide/VPC_Internet_Gateway.html
- https://docs.aws.amazon.com/vpc/latest/userguide/egress-only-internet-gateway.html
- https://docs.aws.amazon.com/vpn/latest/s2svpn/VPNRoutingTypes.html
- https://docs.aws.amazon.com/vpc/latest/userguide/nat-gateway-scenarios.html
- https://docs.aws.amazon.com/vpc/latest/userguide/nat-gateway-pricing.html