Parte 3: Amazon EMR en EKS
Última revisión: 16 de octubre de 2026 · Ejemplo de API:
emr-spark-8.0.0-20260421
Entornos de ejecución y vías de envío
EMR en EKS incorpora un entorno de ejecución de Spark seleccionado por AWS y servicios de envío a una infraestructura de EKS existente. Usted sigue administrando la capacidad, las redes, el almacenamiento y los nodos de EKS. Distinga estas vías:
| Vía | Envío y ciclo de vida | Qué administra usted |
|---|---|---|
| StartJobRun | API de AWS con un ID de clúster virtual de EMR y un rol de ejecución | Estado del trabajo de EMR, permisos y configuración de registros |
| Entorno de ejecución de EMR + Spark Operator | SparkApplication CR enviado al operador de EMR instalado | Helm/CRD, controlador, RBAC de Kubernetes y ciclo de vida del CR |
| Envío directo con spark-submit | Spark envía el trabajo a la API de Kubernetes | Emisor, configuración de Spark, estado y nuevos intentos |
La compatibilidad con Spark Operator desde EMR 6.10.0 no significa que StartJobRun tenga una opción para delegar internamente el trabajo a ese operador. La vía documentada del operador lo instala por separado y utiliza kubectl apply. No suponga que estas aplicaciones CR reciben automáticamente IDs de StartJobRun ni que las administra la API de trabajos de EMR. Puede combinar el entorno de ejecución de EMR con operaciones basadas en CR, pero el envío, la observación y los reintentos dependen de la vía elegida. El gráfico de EMR también es distinto de los gráficos ascendentes actuales de la Parte 2.
Versiones actuales y reproducibilidad
| Versión de EMR en EKS | Entorno de ejecución de Spark |
|---|---|
| emr-7.14.0 | 3.5.8-amzn-0 |
| emr-spark-8.1.0 | 4.1.1-amzn-0; LTS, publicada en septiembre de 2026 |
| emr-spark-8.0.0 | 4.0.2-amzn-0; Spark 4.x con disponibilidad general, publicado en mayo de 2026 |
Spark 4 ya está disponible. El número 8.0.0 identifica una versión del entorno de ejecución de EMR, no Apache Spark 8. Compruebe por separado las versiones y capacidades de otras opciones de implementación de EMR. Un alias -latest sigue las actualizaciones de seguridad; no fija los mismos bytes de imagen. Los sufijos con fecha facilitan la reproducibilidad, pero aun así requieren revisar las actualizaciones. El ejemplo con fecha que aparece a continuación es una base reproducible, no una afirmación de que tenga el parche de seguridad más reciente.
Preparar el entorno
Utilice una versión compatible de EKS, una versión compatible de kubectl y la versión actual de AWS CLI v2, en lugar de seguir una recomendación general obsoleta de Kubernetes 1.30. El auxiliar de CLI de Pod Identity requiere la versión 2.24.0 o posterior. Pida a un administrador que prepare lo siguiente:
- El espacio de nombres
emr-spark, la capacidad de los nodos y las redes, las cuotas y las políticas de admisión. - El rol vinculado al servicio de EMR y el acceso a la API de EKS. Para los nuevos clústeres virtuales, utilice la integración con Access Entry. El procedimiento documentado de CAM muestra API_AND_CONFIG_MAP; compruebe el modo actual y no intente degradar un clúster que solo use la API. Los clústeres virtuales existentes no se migran automáticamente.
- El rol de ejecución
docs-emr-job: acceso de lectura al objeto de script indicado más abajo, y solo los permisos necesarios para los datos, KMS y el grupo y los flujos de registros de CloudWatch. - Un bucket de artefactos de S3 existente y el grupo de registros
/emr-containers/docs-sparkcon una política de retención. Los permisos de quien carga los artefactos y los del trabajo son independientes. - Permisos para que quien invoca pueda iniciar, inspeccionar y cancelar trabajos con los roles de ejecución permitidos. Restrinja los roles mediante
emr-containers:ExecutionRoleArn. Para Pod Identity, limite PassRole al rol seleccionado y apods.eks.amazonaws.com.
Un clúster virtual registra un espacio de nombres de EKS; no crea capacidad de cómputo. Sin embargo, el registro puede crear el rol vinculado al servicio inicial y configurar las entradas o políticas de acceso de CAM. La afirmación «el registro no cambia recursos ni permisos» es demasiado amplia. Para aislar los espacios de nombres también se necesitan controles RBAC, de red y de seguridad de pods.
Rol de ejecución: IRSA o Pod Identity
IRSA requiere el proveedor OIDC de IAM del clúster y una relación de confianza limitada a la audiencia, el espacio de nombres y la identidad de la cuenta de servicio administrada por EMR. update-role-trust-policy modifica esta relación de confianza; no concede permisos sobre los datos ni permisos a quien invoca.
StartJobRun también admite EKS Pod Identity desde EMR 7.3.0. Prepare el agente, los permisos EKS Auth del nodo, la relación de confianza sts:AssumeRole/sts:TagSession para pods.eks.amazonaws.com y las asociaciones de cuentas de servicio de EMR. El auxiliar prepara tres asociaciones: para el emisor, el controlador y el ejecutor. Una anotación de IRSA no sustituye estas asociaciones.
Sustituya los valores del clúster, el rol y el espacio de nombres, y ejecute solo la vía seleccionada. Estos auxiliares modifican la configuración de IAM y EKS.
# Option A: IRSA, after creating the cluster IAM OIDC provider and job role.
aws emr-containers update-role-trust-policy \
  --region "$AWS_REGION" \
  --cluster-name my-eks-cluster --namespace emr-spark --role-name docs-emr-job

# Option B: Pod Identity, after configuring the agent/node permissions and job-role trust.
# Choose the appropriate path; these are not two mandatory consecutive steps.
aws emr-containers create-role-associations \
  --region "$AWS_REGION" \
  --cluster-name my-eks-cluster --namespace emr-spark --role-name docs-emr-job
Registrar un clúster virtual
Guarde el archivo como create-virtual-cluster.json y sustituya los nombres de ejemplo.
{
  "name": "docs-spark-vc",
  "containerProvider": {
    "id": "my-eks-cluster",
    "type": "EKS",
    "info": {
      "eksInfo": {
        "namespace": "emr-spark"
      }
    }
  }
}
La documentación actual del servicio también define schedulerConfiguration con maxConcurrentJobRuns y maxInQueueJobRuns. El modelo de servicio de AWS CLI 2.35.11 utilizado para esta revisión no incluye ese campo, por lo que se omite en este ejemplo base. Compruebe la compatibilidad de CLI/SDK antes de usarlo. Los límites del número de trabajos no sustituyen las cuotas de CPU y memoria ni los límites de ejecutores.
# Replace the cluster/name/namespace in create-virtual-cluster.json first.
: "${AWS_REGION:?Set the region of the EKS cluster}"
aws emr-containers create-virtual-cluster \
  --region "$AWS_REGION" \
  --cli-input-json file://create-virtual-cluster.json \
  --query id --output text
# Copy the returned id into start-job-run.json; verify state before submitting.
: "${EMR_VIRTUAL_CLUSTER_ID:?Set the returned virtual cluster ID}"
aws emr-containers describe-virtual-cluster \
  --region "$AWS_REGION" --id "$EMR_VIRTUAL_CLUSTER_ID" \
  --query 'virtualCluster.{state:state,provider:containerProvider}'
CreateVirtualCluster devuelve id. Úselo como virtualClusterId en StartJobRun y compruebe que el estado sea RUNNING y que corresponda al espacio de nombres previsto.
Enviar un trabajo de prueba
Guárdelo como smoke.py. Comprueba que rows=10 y total=45 sin modificar un conjunto de datos externo.
from pyspark.sql import SparkSession
from pyspark.sql import functions as F

spark = SparkSession.builder.appName("docs-emr-smoke").getOrCreate()
try:
    result = spark.range(10).agg(F.count("*").alias("rows"), F.sum("id").alias("total")).first()
    if result.rows != 10 or result.total != 45:
        raise RuntimeError(f"Unexpected result: {result}")
    print("SMOKE_OK rows=10 total=45")
finally:
    spark.stop()
Guárdelo como start-job-run.json y sustituya virtualClusterId, account, role y bucket. Antes de enviar el trabajo, prepare el acceso de lectura al script y el acceso al grupo de registros.
{
  "name": "docs-spark-smoke",
  "virtualClusterId": "abcd1234efgh5678ijkl9012mnop",
  "executionRoleArn": "arn:aws:iam::111122223333:role/docs-emr-job",
  "releaseLabel": "emr-spark-8.0.0-20260421",
  "jobDriver": {
    "sparkSubmitJobDriver": {
      "entryPoint": "s3://my-existing-artifact-bucket/docs-emr/smoke.py",
      "sparkSubmitParameters": "--conf spark.executor.instances=2 --conf spark.executor.cores=1 --conf spark.executor.memory=1g --conf spark.driver.cores=1 --conf spark.driver.memory=1g"
    }
  },
  "configurationOverrides": {
    "monitoringConfiguration": {
      "cloudWatchMonitoringConfiguration": {
        "logGroupName": "/emr-containers/docs-spark",
        "logStreamNamePrefix": "smoke"
      }
    }
  }
}# Replace the bucket in this command and start-job-run.json with the same existing bucket.
aws s3 cp smoke.py s3://my-existing-artifact-bucket/docs-emr/smoke.py \
--region "$AWS_REGION"
# Keep this token for retries of the same request. Use a new token for a new intended run.
EMR_REQUEST_TOKEN="$(python3 -c 'import uuid; print(uuid.uuid4())')"
aws emr-containers start-job-run \
--region "$AWS_REGION" \
--cli-input-json file://start-job-run.json \
--client-token "$EMR_REQUEST_TOKEN" --query id --output text
: "${EMR_JOB_ID:?Set the returned job ID}"
aws emr-containers describe-job-run \
--region "$AWS_REGION" --virtual-cluster-id "$EMR_VIRTUAL_CLUSTER_ID" \
--id "$EMR_JOB_ID" --query 'jobRun.{state:state,details:stateDetails,reason:failureReason}'Que la respuesta de la API confirme la aceptación no significa que el trabajo haya terminado. Compruebe que el estado final sea COMPLETED y que los registros del controlador contengan SMOKE_OK rows=10 total=45. Un token de solicitud deduplica la solicitud a la API; no garantiza que los efectos externos se produzcan exactamente una vez entre los reintentos de la aplicación. Si se produce un fallo, inspeccione stateDetails, failureReason y los registros del emisor, del controlador y del ejecutor.
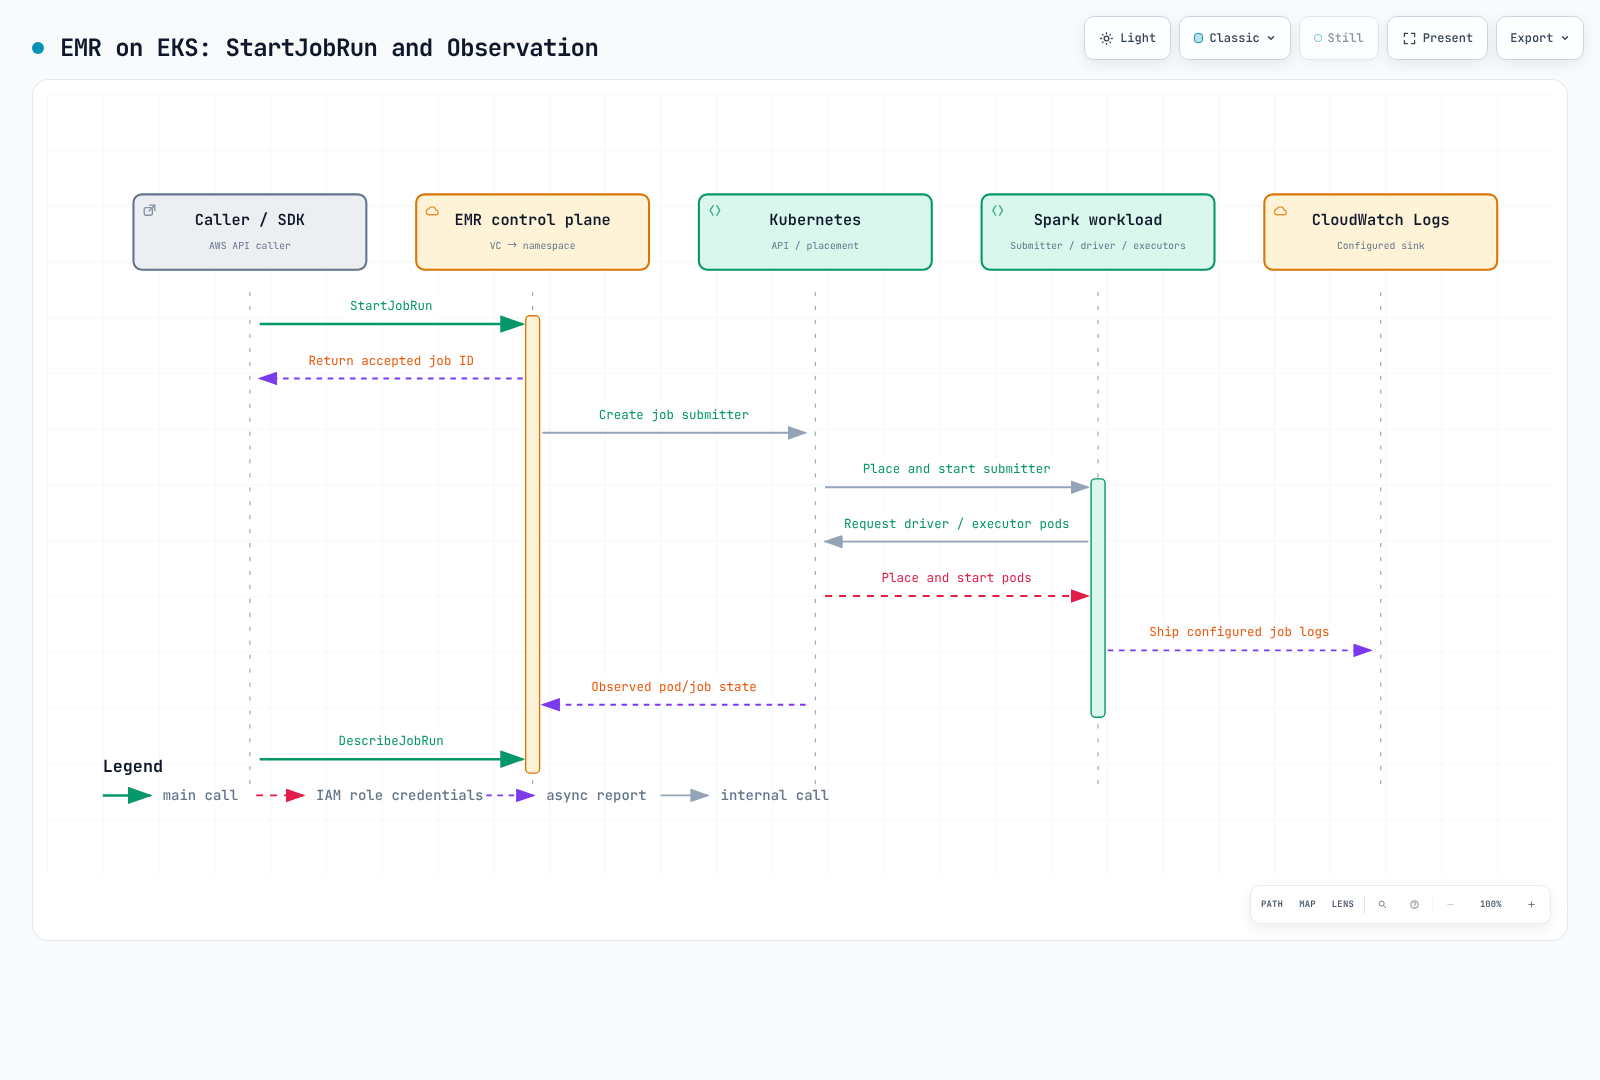
Configuración de pods, observabilidad y desarrollo interactivo
Los pods de EMR se pueden ver con kubectl en su espacio de nombres. Las plantillas de pod admitidas y las rutas de imágenes personalizadas permiten configurarlos; afirmar que «no se puede crear configuración de pods» es incorrecto. No anule arbitrariamente la configuración del espacio de nombres, la cuenta de servicio o el nombre del pod que administra StartJobRun. Siga los campos admitidos para cada versión y método de envío, así como el procedimiento de validación de imágenes personalizadas.
Los registros de CloudWatch requieren monitoringConfiguration y permisos para el rol de ejecución. Distinga las métricas del estado del trabajo de la telemetría completa de los ejecutores de Spark. Step Functions admite la integración de solicitud/respuesta y .sync para StartJobRun, pero requiere una máquina de estados y un rol configurados. Los eventos de trabajo de EventBridge también requieren reglas, destinos y gestión de fallos. Que exista una integración no activa automáticamente toda la recopilación de datos ni la automatización.
EMR Studio se conecta a un punto de enlace interactivo creado con CreateManagedEndpoint. Jupyter Enterprise Gateway administra los ciclos de vida de los kernels y requiere subredes privadas, un controlador ALB, redes y roles. Las celdas del bloc de notas no son simplemente llamadas por lotes normales a StartJobRun. Los usuarios y kernels que comparten un punto de enlace usan su rol de ejecución; revise los límites de acceso y use puntos de enlace separados cuando sea necesario. Los puntos de enlace y los kernels tienen costes; el mero registro del clúster virtual, en cambio, no.
Elección y limpieza
Elija StartJobRun para el ciclo de envío mediante la API de AWS y evalúe un operador adecuado para las operaciones basadas en CR. Compare las versiones ascendentes y los complementos necesarios, la portabilidad, el rendimiento medido y el coste total. EMR no elimina los costes de EKS, cómputo, almacenamiento y registros, ni la responsabilidad por la infraestructura.
Eliminar un clúster virtual no limpia de forma universal los trabajos, los datos y los roles. Inspeccione los trabajos y puntos de enlace activos y limpie por separado los recursos previstos.
# Inspect active work/endpoints before cleanup.
aws emr-containers list-job-runs \
  --region "$AWS_REGION" --virtual-cluster-id "$EMR_VIRTUAL_CLUSTER_ID"
aws emr-containers list-managed-endpoints \
  --region "$AWS_REGION" --virtual-cluster-id "$EMR_VIRTUAL_CLUSTER_ID"
# If this demo job is still active and should stop:
aws emr-containers cancel-job-run \
  --region "$AWS_REGION" --virtual-cluster-id "$EMR_VIRTUAL_CLUSTER_ID" --id "$EMR_JOB_ID"
# After reviewing/cleaning the relevant jobs and any managed endpoints:
aws emr-containers delete-virtual-cluster \
  --region "$AWS_REGION" --id "$EMR_VIRTUAL_CLUSTER_ID"
aws emr-containers describe-virtual-cluster \
  --region "$AWS_REGION" --id "$EMR_VIRTUAL_CLUSTER_ID" --query virtualCluster.state
Observe el estado de eliminación asíncrona; los fallos de permisos pueden producir el estado ARRESTED. Revise por separado el espacio de nombres, el clúster de EKS, los artefactos de S3, el grupo de registros, el rol de IAM y las asociaciones de Pod Identity. Las asociaciones pueden permanecer tras eliminar el espacio de nombres o la cuenta de servicio; quite solo las que ya no se utilicen. No elimine recursos compartidos para esta demostración.
Los ejemplos se comprueban en cuanto a la forma de entrada local de la CLI y la sintaxis. Esto no equivale a una implementación de AWS completada ni a una prueba del entorno de ejecución de EMR. Valide los permisos, las cuotas, las redes y la disponibilidad de la versión en el entorno de destino.
- Etiquetas de versión de EMR en EKS
- Notas de la versión de EMR Spark 8.0.0 en EKS
- Configuración del acceso al clúster de EKS
- Rol de ejecución del trabajo y condición para el rol de ejecución
- Configuración de Pod Identity para StartJobRun
- Clústeres virtuales y límites del planificador
- API StartJobRun
- Instalación de EMR Spark Operator y envío de CR
- Arquitectura del punto de enlace interactivo
- Imágenes personalizadas
- Configuración de registros de CloudWatch