Conectividad entre VPC de distintas organizaciones
Fecha del informe original: September 1, 2026
Revisión del contenido: September 12, 2026
Este capítulo compara cinco patrones para conectar cuentas de distintas AWS Organizations, como un entorno existente y otro entorno de GPU con gobernanza independiente. Las tablas conservan las mediciones comunicadas en el documento anterior. Esta revisión comprueba el comportamiento de AWS y los cálculos; no afirma haber realizado un nuevo despliegue real ni reproducido el benchmark de forma independiente.
Índice
- Por qué conectar distintas organizaciones
- Comparación de las cinco opciones
- Resultados de verificación del informe original
- Mediciones de latencia (M1–M7)
- Hallazgos operativos
- Selección de arquitectura según los requisitos
- Limitaciones y próximas comprobaciones
Por qué conectar distintas organizaciones
La titularidad contractual, las adquisiciones, la gobernanza independiente o los requisitos de aislamiento pueden situar las cargas de GPU y los servicios existentes en Organizations diferentes. La estructura organizativa debe responder a esos requisitos, en lugar de asumir que una segunda Organization mejora automáticamente los descuentos de GPU, las cuotas o el cumplimiento.
Las cuotas de recursos EC2 suelen establecerse por cuenta y región; una cuenta separada puede proporcionar esa separación sin exigir otra Organization. También deben revisarse la agregación de facturación, los descuentos negociados y la duplicación de la gobernanza. Un límite de Organization no sustituye la autorización de aplicaciones, la segmentación de red ni los controles de auditoría.
En EKS, distinga el acceso IP ordinario a canalizaciones de datos o API de inferencia de la comunicación colectiva entre GPU. Un benchmark de solicitud/respuesta con instancias de CPU no establece el rendimiento de NCCL, el throughput ni RDMA. El tráfico de EFA que evita el sistema operativo no puede atravesar VPC ni zonas de disponibilidad; el tráfico IP normal de su interfaz ENA sigue siendo enrutable.
Comparación de las cinco opciones
Las columnas PrivateLink y Lattice describen los patrones probados de servicio de endpoint respaldado por NLB y de servicio HTTP. PrivateLink también dispone de endpoints de recursos y de redes de servicios; Lattice también tiene configuraciones de recursos TCP. No son productos que universalmente «requieran NLB» o sean «solo L7».
| Aspecto | ① Compartición de TGW mediante RAM | ② VPC Peering | ③ Servicio de endpoint PrivateLink | ④ TGW Peering | ⑤ Servicio HTTP de VPC Lattice |
|---|---|---|---|---|---|
| Mecanismo | Compartir un TGW con la cuenta externa | Par de VPC conectado directamente | Endpoint de interfaz del consumidor → NLB/servicio del proveedor | Conectar el TGW de cada propietario | Asociar servicios y VPC cliente con una red de servicios |
| Solapamiento de direcciones | El enrutamiento directo necesita un plan de direcciones sin ambigüedades | No se pueden conectar por peering CIDR solapados | El acceso a servicios puede gestionar CIDR de VPC solapados | El enrutamiento directo necesita un plan de direcciones sin ambigüedades | El acceso a servicios puede gestionar CIDR de VPC solapados |
| Modelo de conexión | Enrutamiento IP bidireccional cuando está permitido | Enrutamiento IP bidireccional cuando está permitido | El consumidor inicia; las respuestas pueden volver por la conexión | Enrutamiento IP bidireccional cuando está permitido | Los clientes inician solicitudes a servicios publicados; el acceso inverso necesita configuración propia |
| Configuración de rutas | Rutas VPC más tablas y asociaciones TGW | Rutas en ambos lados; VPC Peering no es transitivo | Permisos de endpoint/servicio y controles de red, en lugar de tránsito VPC general | Rutas estáticas explícitas hacia el peer más rutas VPC | Asociaciones y políticas de servicio/red, en lugar de tránsito VPC general |
| Control | El propietario del TGW gestiona sus tablas; los consumidores conservan los controles de sus VPC | Cada propietario de VPC | El proveedor controla permisos y destinos del servicio; el consumidor controla sus endpoints | Cada propietario de TGW, con rutas coordinadas | Propietarios de red/servicio y controles de la red cliente |
| Tiempo de aprovisionamiento del informe original | TGW ~3 min más aceptación | Menos de 1 min | Endpoint ~3 min | ~7 min | ~5 min |
Los tiempos de aprovisionamiento son observaciones del informe original, no SLA ni estimaciones de entrega de extremo a extremo. La fila de rutas describe la topología de dos TGW de este capítulo; no afirma que exista tránsito sin restricciones por cadenas arbitrarias de peers. NAT y el rediseño de direcciones son otras formas de abordar el solapamiento y requieren su propio diseño.
Resultados de verificación del informe original
El informe original afirma que se establecieron los cinco patrones y se intercambió tráfico entre dos Organizations. La documentación de AWS admite desplegar estos patrones entre cuentas; pertenecer a la misma Organization no es un requisito inherente. Sin embargo, las restricciones IAM/SCP/de compartición pueden impedir la configuración, y las rutas, los grupos de seguridad, las NACL, DNS y la autorización de servicios determinan si el tráfico funciona. Los ID de cuenta y la aceptación por sí solos no bastan.
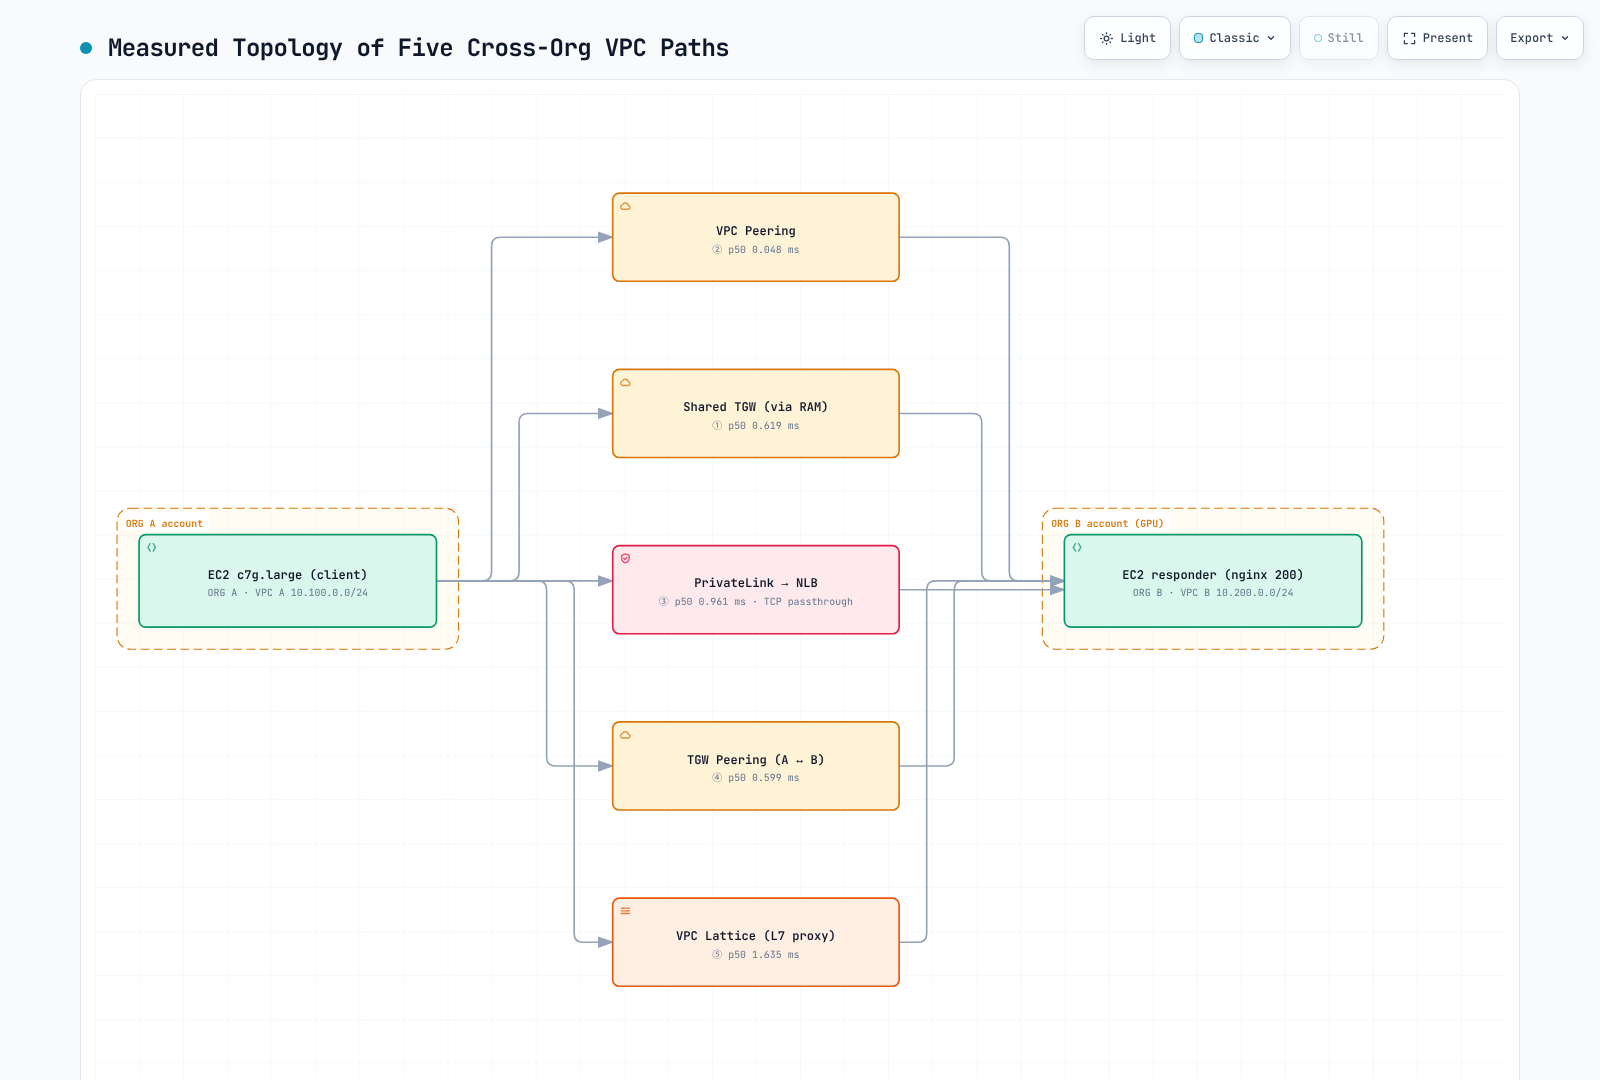
La figura conserva las observaciones originales. El valor de Lattice es HTTP KA, mientras que los demás valores mostrados son TCP_RR; no constituyen una misma métrica directamente comparable. La etiqueta «GPU» identifica el entorno propuesto, no un benchmark de GPU.
Mediciones de latencia (M1–M7)
Configuración comunicada: ap-northeast-2, ZoneId apne2-az1 coincidente entre cuentas, c7g.large y un único servidor EC2 de respuesta con nginx que devuelve un HTTP 200 fijo. El informe describe tres ENI con subredes y rutas de retorno por trayectoria, cinco rondas intercaladas en turnos rotativos, 1,500 muestras TCP_RR con conexiones persistentes por ruta, 100 muestras ICMP por ruta y 275 muestras HTTP keep-alive por ruta.
La descripción de nginx identifica al servidor de respuesta HTTP; la página no identifica la implementación TCP_RR ni los tamaños de los mensajes. Aquí no se enlazan muestras brutas, versiones de software/kernel, límites de los intervalos de medición ni la configuración de políticas de rutas de retorno de Linux. Las conexiones persistentes buscan reducir los efectos de establecer conexiones repetidamente, pero sus intervalos de medición no pueden comprobarse de forma independiente a partir de estas tablas.
Todos los valores de latencia siguientes están en milisegundos; TTL es un campo de paquete independiente. TCP_RR e ICMP son medidas de ida y vuelta de solicitud/respuesta. HTTP KA incluye procesamiento de aplicación. Las dos campañas de medición siguientes deben interpretarse por separado.
| ID | Ruta | ICMP p50 | TCP_RR p50 | RR p99 | RR sd | HTTP KA p50 | TTL |
|---|---|---|---|---|---|---|---|
| M1 | Misma VPC → EC2 (referencia) | 0.121 | 0.049 | 0.062 | 0.007 | 0.087 | 127 |
| M2 | ② VPC Peering → EC2 | 0.125 | 0.048 | 0.057 | 0.011 | 0.080 | 127 |
| M3 | ① TGW compartido (RAM) → EC2 | 0.535 | 0.619 | 0.695 | 0.141 | 0.686 | 126 |
| M4 | ④ TGW Peering (dos TGW) → EC2 | 0.912 | 0.599 | 0.855 | 0.133 | 0.488 | 125 |
| M5 | ③ PrivateLink → NLB → EC2 | No medido | 0.961 | 1.084 | 0.035 | 0.711 | — |
| M6 | ⑤ VPC Lattice → EC2 destino | No medido | No medido para este servicio HTTP | — | — | 1.635 | — |
| M7 | ② Peering → NLB → EC2 (aislamiento del salto NLB) | No medido | 0.841 | 0.909 | 0.119 | 0.883 | — |
Diferencias entre las medianas comunicadas
Estas son diferencias entre medianas de rutas, no costes aislados de saltos unidireccionales ni mediciones de un componente ENI/proxy individual.
| Comparación de rutas observadas | Diferencia | Δ TCP_RR p50 | Δ ICMP p50 | Δ HTTP KA p50 |
|---|---|---|---|---|
| Peering frente a referencia dentro de la misma VPC | M2 − M1 | -0.001 | +0.004 | -0.007 |
| Ruta TGW compartida frente a peering | M3 − M2 | +0.571 | +0.410 | +0.606 |
| Ruta de dos TGW frente a peering | M4 − M2 | +0.551 | +0.787 | +0.408 |
| Peering con NLB frente a peering directo | M7 − M2 | +0.793 | — | +0.803 |
| PrivateLink/NLB frente a peering/NLB | M5 − M7 | +0.120 | — | -0.172 |
| Servicio HTTP Lattice frente a HTTP por peering directo | M6 − M2 | — | — | +1.555 |
- M2 está cerca de la referencia dentro de la misma VPC, pero las tablas no establecen equivalencia estadística ni sobrecarga cero.
- La mediana TCP_RR de la ruta de dos TGW es inferior a la de la ruta con un único TGW compartido. Por tanto, los datos no respaldan un valor universal de «0.4–0.6 ms por salto TGW» ni una fórmula lineal de coste por salto.
- M5−M7 es +0.120 ms para TCP_RR, pero −0.172 ms para HTTP KA. No puede etiquetarse como el coste puro de la ENI de PrivateLink.
- La comparación de Lattice es HTTP +1.555 ms, no TCP_RR. Describe esta prueba de servicio HTTP, no todos los modos de Lattice.
- TTL no revela el número de saltos de la ruta sin conocer el TTL inicial y el comportamiento de red pertinente.
Campaña independiente con NLB delante de los servicios
El informe original también colocó NLB en cada ruta L3. Es una comparación útil para ese patrón de exposición de servicios, no un requisito de todo despliegue productivo de Peering/TGW.
| Configuración | TCP_RR p50 | HTTP KA p50 |
|---|---|---|
| ② Peering → NLB → EC2 | 0.622 | 0.648 |
| ③ PrivateLink → NLB → EC2 | 0.658 | 0.845 |
| ① TGW compartido → NLB → EC2 | 1.273 | 1.257 |
| ④ TGW Peering → NLB → EC2 | 1.425 | 1.279 |
| ⑤ Servicio HTTP Lattice (sin NLB separado en esta prueba) | — | 1.680 |
En esta campaña, PrivateLink/NLB menos Peering/NLB es +0.036 ms TCP_RR y +0.197 ms HTTP KA. Las medianas TCP_RR del TGW compartido y de los TGW conectados por peering son, respectivamente, 1.93× y 2.17× la mediana de PrivateLink; las proporciones HTTP son 1.49× y 1.51×. Son proporciones de latencia, no multiplicadores de throughput ni pruebas de equivalencia de las rutas.
La mediana HTTP de Lattice supera las medianas HTTP del TGW compartido/NLB y de los TGW conectados por peering/NLB en +0.423 ms y +0.401 ms. No combine esta campaña con M1–M7 para deducir el coste de un componente: incluso las medianas de Peering/NLB difieren entre ejecuciones.
El informe original también describe una prueba piloto descartada con una instancia de rendimiento ampliable mediante ráfagas, NLB→ALB y conexiones curl nuevas, cuyo p95 rondaba 7 ms, y aumentos del primer flujo de 0.6–1.6 ms. Siguen siendo observaciones atribuidas sin muestras brutas enlazadas, no garantías de AWS. Mida por separado el establecimiento de conexiones y el comportamiento estable de la aplicación real.
Hallazgos operativos
- Compartición externa de RAM: deben permitirse los principales externos y la cuenta ajena a la Organization debe aceptar la invitación. El valor predeterminado de
allowExternalPrincipalsen la APICreateResourceSharees true; establecer explícitamente--allow-external-principalsdocumenta la intención, pero omitir ese flag literal de CLI no es una causa universal de fallo. Verifique la configuración efectiva de compartición y los permisos. - Aceptación de attachments VPC de TGW compartido: con
AutoAcceptSharedAttachmentsdeshabilitado, que es el valor predeterminado, el propietario del TGW debe aceptar el attachment compartido. Habilitarlo cambia ese flujo de trabajo. La aceptación de la compartición RAM y la del attachment TGW son pasos distintos. Los consumidores no pueden modificar las tablas de rutas TGW del propietario, pero siguen controlando sus rutas VPC y sus ajustes de seguridad. - Aceptación de TGW Peering: el propietario del TGW receptor acepta la solicitud pendiente en la región del receptor, incluso si el peering es de la misma cuenta. Utilice el
TransitGatewayAttachmentIdde esa solicitud; no lo confunda con un ID de TGW o de attachment VPC. Una respuestaNotFoundno establece una regla que obligue a usar ID diferentes en los dos lados. El retraso de visibilidad de unos dos minutos del informe original es una observación, no una garantía de espera fija. - Rutas de peering: el peering directo entre TGW utiliza rutas estáticas configuradas explícitamente, no propagación BGP a través del attachment de peering. Configure las tablas TGW y VPC pertinentes en ambas direcciones. La automatización puede gestionar esas rutas estáticas.
- Prioridad de rutas: primero se aplica la coincidencia de prefijo más largo. Una ruta estática prevalece sobre una propagada para el mismo prefijo de destino; una estática menos específica no anula una propagada más específica.
- Grupos de seguridad de los destinos Lattice: para la ruta de servicio documentada mediante asociación VPC, utilice las listas de prefijos gestionadas de la región y familia IP (
com.amazonaws.REGION.vpc-latticeycom.amazonaws.REGION.ipv6.vpc-lattice) en los puertos reales del destino y de comprobación de estado. El ejemplo original169.254.171.0/24no es una definición universal de la lista; las listas gestionadas pueden incluir direcciones locales de enlace o públicas no enrutables. Las rutas de endpoints y gateways de recursos tienen controles propios. También debe configurarse la autenticación IAM del servicio; asociar una VPC no la habilita por sí solo. - Responsabilidad de la limpieza: el informe original describe dependencias de red gestionadas por GuardDuty, asociaciones de políticas IAM y recursos Lattice restantes que afectaron a la retirada. Inspeccione los ID reales de las dependencias y el servicio propietario antes de actuar. No deshabilite controles de seguridad gestionados ni elimine recursos ajenos solo para forzar la eliminación de una VPC o un rol.
Selección de arquitectura según los requisitos
| Requisito | Patrón candidato | Comprobaciones importantes |
|---|---|---|
| Cada Organization debe conservar su autoridad sobre rutas TGW | ④ TGW Peering | Coordinación de rutas estáticas, plan de direcciones, throughput, disponibilidad, inspección y cargos de transferencia |
| Se desea exponer un conjunto pequeño de endpoints de inferencia/servicios | ③ Servicio de endpoint PrivateLink | Protocolo/modelo admitido, aceptación del endpoint, autenticación de aplicación, DNS, coste y payload/concurrencia reales |
| Acceso a servicios entre CIDR solapados | ③ PrivateLink o ⑤ Lattice | Alcance de servicio/recurso; evaluar NAT/rediseño de direcciones si se necesita enrutamiento IP más amplio |
| Otra cuenta puede usar un hub controlado centralmente | ① Compartición de TGW mediante RAM | Política de compartición externa, ajustes de aceptación y modelo de control TGW del propietario |
| Un número pequeño de pares VPC directos | ② VPC Peering | CIDR sin solapamiento, mantenimiento de rutas por pares, cuotas y cargos de transferencia |
| Se requieren identidad, descubrimiento y gobernanza gestionados de servicios HTTP | ⑤ VPC Lattice | Políticas IAM explícitas, solicitudes firmadas, conectividad de servicios y mediciones de cargas |
Un híbrido de TGW Peering y PrivateLink puede encajar con una gobernanza de red independiente y una exposición limitada de API. Las tablas de latencia publicadas no establecen que sea óptimo para la mayoría de los entornos GPU. Elija según la conectividad y los controles necesarios y mida después la carga real.
Limitaciones y próximas comprobaciones
El informe original excluye mediciones de rutas de inspección Network Firewall, latencia entre regiones y throughput/concurrencia. Comunica comprobaciones funcionales de solapamiento sin publicar resultados de latencia para ese caso. Esta página tampoco establece resultados de comunicación colectiva entre GPU, EFA/RDMA, tamaños de payload representativos, estimaciones de incertidumbre ni artefactos completos de reproducción.
Conserve las cifras comunicadas como contexto histórico. Antes del despliegue, valide las políticas de las cuentas destino y el modelo de conexión admitido, las rutas bidireccionales o el acceso a servicios necesarios, el comportamiento ante fallos y el presupuesto de latencia/throughput de la aplicación. Esta revisión no realizó aprovisionamiento AWS ni benchmarks reales.
Referencias
- Documento técnico sobre redes multi-VPC escalables
- Compartición de TGW entre cuentas
- Una o varias Organizations
- API RAM CreateResourceShare
- Opciones de aceptación de TGW
- Aceptación de TGW Peering
- Enrutamiento y orden de evaluación TGW
- Tipos de endpoint PrivateLink
- NAT privado y redes solapadas
- Grupos de seguridad Lattice
- Cuotas EC2 por cuenta y región
- Limitaciones de EFA
- Guía VPC Lattice
- Cuestionario entre organizaciones