Parte 1: Arquitectura de Ray
Línea base de revisión: Ray 2.58.0 · 2026-09-12
Configuración del entorno de laboratorio
El ejemplo local se verificó con Python 3.12, ray==2.58.0 y numpy==2.2.6. Sus comprobaciones de task, actor y ObjectRef no requieren GPU, modelo entrenado ni Kubernetes. Verifica por separado las dependencias adicionales pertinentes al habilitar funciones como el dashboard.
El ejemplo configura explícitamente dos CPU lógicas y un object store de 80 MiB, y luego cierra Ray. La configuración de recursos de Ray no son límites del sistema operativo para el CPU/RAM total; los procesos de control y worker requieren memoria adicional.
¿Qué es Ray?
Ray Core proporciona funciones remotas (tasks), instancias remotas con estado (actors), ObjectRefs y object stores por nodo. Train, Tune y Serve se basan en esa base. Compartir Core no elimina sus propios controllers, reintentos, checkpoints ni lógica de comunicación del framework.
Primitivas principales
Tasks
Después de aplicar @ray.remote, envía mediante f.remote(...). Llamarlo como un f(...) ordinario es incorrecto. Un ejemplo de retorno único produce un ObjectRef, que puede leerse con ray.get().
Llamar a una task sin estado no garantiza una función pura sin efectos secundarios. Las mutaciones de archivos/base de datos necesitan una estrategia de idempotencia para los reintentos. Los workers pueden reutilizarse; una caché global del módulo que sobrevive de forma incidental es distinta de la gestión explícita del estado.
Ray rastrea dependencias. Pasar un ObjectRef ascendente como argumento de nivel superior a otra task crea una dependencia de que ese valor esté listo. Las tasks no son necesariamente independientes entre sí.
Actors
Actor.remote() crea un handle para una instancia remota; handle.method.remote() envía un método a esta. Los contadores, conexiones o modelos en la memoria de esa instancia pueden reutilizarse entre llamadas.
Esto no es almacenamiento durable automático. En 2.58.0, max_restarts tiene como valor predeterminado 0. Configurar reinicios vuelve a ejecutar el constructor; no restaura automáticamente el estado de la aplicación. Diseña los checkpoints y la recuperación por separado, y distingue la concurrencia/ordenación síncrona, async y mediante threads de los actors.
Object Store
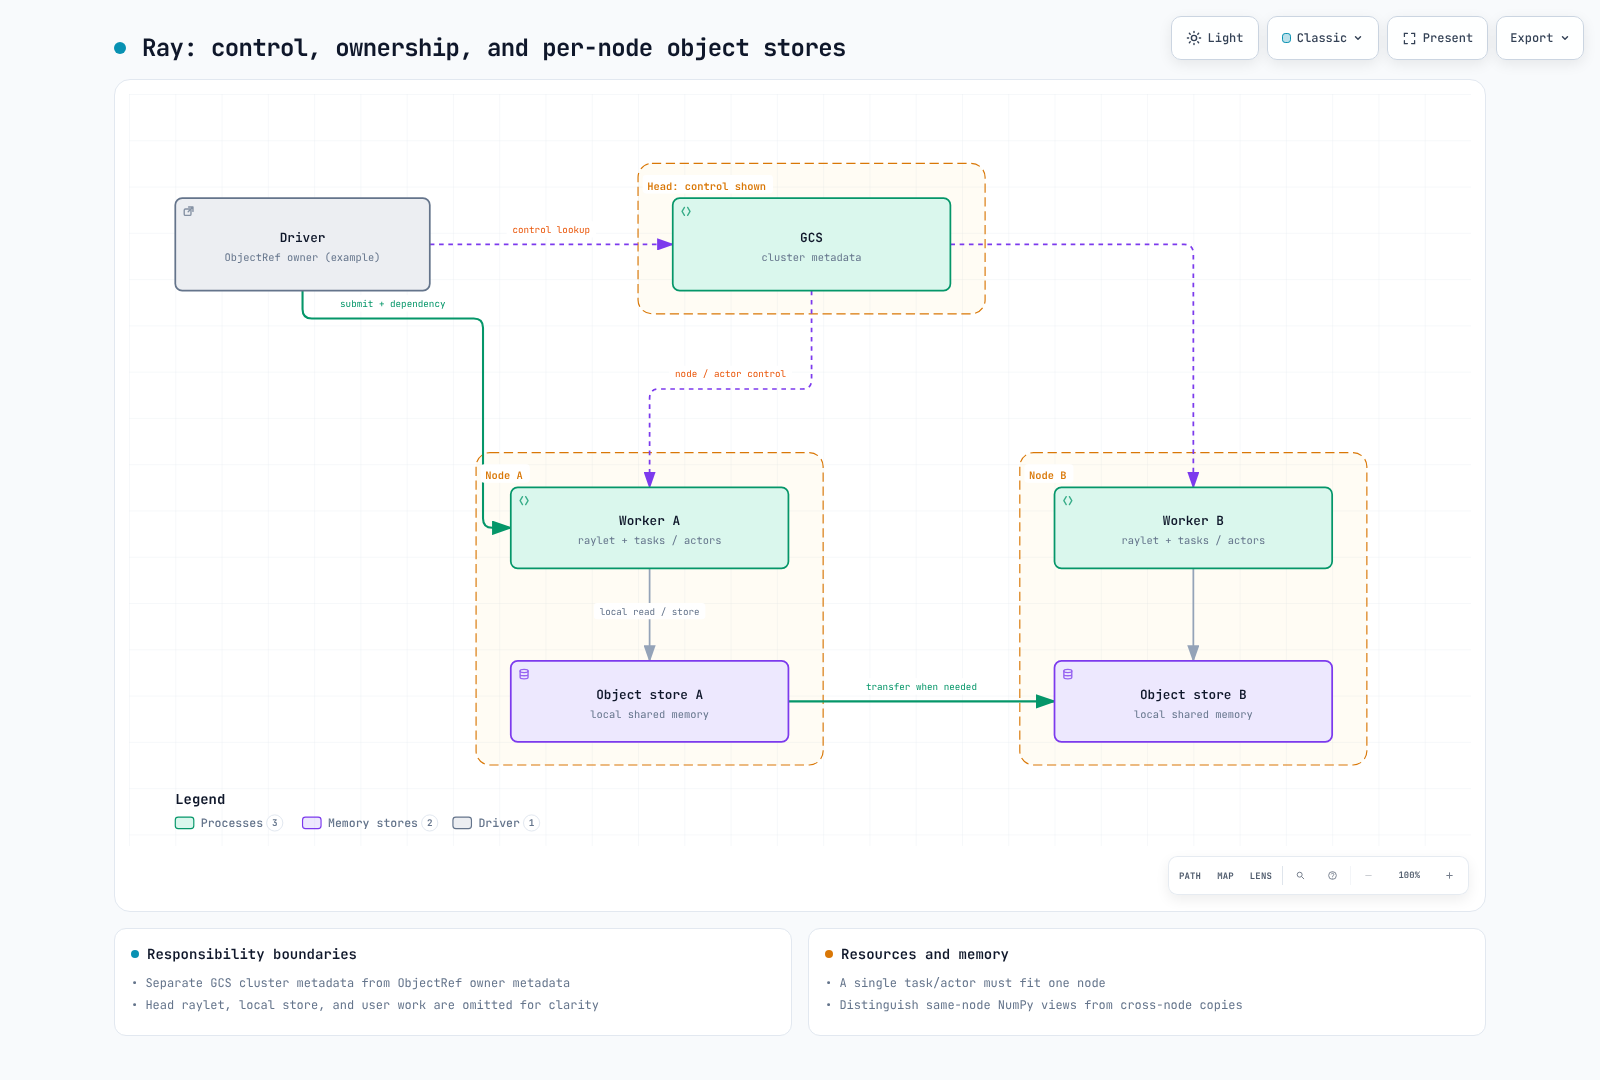
Los valores remotos son inmutables y pueden almacenarse o replicarse en object stores locales de cada nodo. Las referencias a un valor no hacen que todos los nodos compartan una región de memoria física. El acceso entre nodos puede implicar costes de transporte y serialización.
Los arrays de NumPy en el mismo nodo pueden leerse mediante vistas de memoria compartida de solo lectura. Cópialos antes de modificarlos. Esto no implica comportamiento de copia cero para todos los objetos de Python, transferencias entre nodos ni tensores de GPU/pesos de modelos. Los valores pequeños y grandes también pueden usar rutas de transferencia diferentes.
Ejemplo local pequeño
Esto comprueba el comportamiento de la API, no el rendimiento de entrenamiento ni un benchmark.
import ray
import numpy as np

try:
    ray.init(address="local", num_cpus=2, include_dashboard=False,
             object_store_memory=80 * 1024 * 1024)

    @ray.remote(num_cpus=1)
    def twice(value):
        return value * 2

    first = twice.remote(2)
    second = twice.remote(first)  # ObjectRef dependency
    assert ray.get(second, timeout=15) == 8

    @ray.remote(num_cpus=1)
    class Counter:
        def __init__(self):
            self.value = 0
        def increment(self):
            self.value += 1
            return self.value

    counter = Counter.remote()
    assert ray.get([counter.increment.remote(),
                    counter.increment.remote()], timeout=15) == [1, 2]
    ref = ray.put(np.arange(256_000, dtype=np.int64))
    array = ray.get(ref, timeout=15)
    assert not array.flags.writeable
finally:
    ray.shutdown()
Un ejercicio pequeño de un único nodo no demuestra la recuperación ante fallos multinodo, el uso compartido de memoria de GPU ni el rendimiento de red.
Arquitectura de clúster: Head Node y Worker Nodes
El head ejecuta componentes de control del clúster, incluido el Global Control Service (GCS). Los raylets, procesos worker y object stores locales participan en la ejecución y el movimiento de datos en el head y los workers. Un head puede anunciar cero CPU lógicas para restringir la colocación de tasks de usuario; no necesita aportar los mismos recursos de cómputo que un worker.
El driver ejecuta la aplicación de nivel superior. No tiene que ejecutarse en el head; la colocación depende del método de envío. Un autoscaler también es un componente de despliegue configurado, no una promesa de que cada ray.init() local aprovisione automáticamente más workers.
El GCS administra metadatos del clúster como actors, nodos y placement groups. No lo describas como el propietario centralizado de todos los metadatos de objetos. El proceso que crea el ObjectRef original es el propietario del objeto y puede diferir del worker que calcula el valor.
Colocación de recursos
Ray considera el estado del clúster al seleccionar candidatos, pero cada task/actor debe caber en un nodo factible. Dos nodos con un CPU libre cada uno no ejecutan conjuntamente una única task de dos CPU. La factibilidad, disponibilidad, localidad de datos y restricciones de colocación/etiqueta/afinidad son importantes.
Los recursos lógicos de CPU/GPU guían la admisión y la programación. num_cpus=1 no fuerza a cada thread del sistema operativo en el proceso a ejecutarse en un núcleo físico. Configura por separado los requests/limits del contenedor y los recuentos de threads de las bibliotecas.
Recuperación ante fallos y bibliotecas de nivel superior
El GCS está en memoria de forma predeterminada; la recuperación después de un fallo del head requiere una configuración adicional de backend durable. La documentación de 2.58.0 distingue Redis externo compatible de RocksDB integrado alpha. Recuperar los metadatos del GCS no restaura el estado de la aplicación de cada actor ni el valor de cada objeto.
La recuperación de objetos depende de la propiedad, el lineage y la elegibilidad para reintento/reconstrucción. No equipares los valores de ray.put() con las salidas de tasks recomputables, ni el object spilling con una copia de seguridad a largo plazo.
Train, Tune y Serve reutilizan Core mientras añaden políticas como checkpoints de entrenamiento, programación de trials y controllers de serving. Los colectivos del framework y otras comunicaciones de entrenamiento no pueden describirse todos como tráfico a través de una única ruta de object store.
Por qué esto es importante en Kubernetes
KubeRay reconcilia CRs como RayCluster, RayJob y RayService en Pods de Ray y recursos relacionados. La programación de tasks/actors de Ray, la colocación de Pods de Kubernetes y el aprovisionamiento real de EC2 mediante herramientas como Karpenter son capas independientes. KubeRay no es un dispatcher que selecciona automáticamente Train, Tune o Serve para una aplicación.