Parte 4: Ajuste del rendimiento y los costes
Referencia de revisión: 12 de septiembre de 2026 · Spark ascendente 4.2.0 · Karpenter 1.14
Alcance y medición
Este capítulo usa la ruta directa de spark-submit de la Parte 1. Spark 4.2 requiere Kubernetes 1.34 o posterior; compruebe también la compatibilidad de EKS, kubectl y Karpenter. Los operadores de la Parte 2 y EMR de la Parte 3 usan rutas distintas para enviar trabajos y personalizar pods. No copie todos los ajustes entre estas opciones sin revisarlos. Los valores siguientes son puntos de partida modestos, no valores óptimos de rendimiento medidos.
metrics-server no es necesario para que Karpenter aprovisione nodos a causa de pods pendientes. Karpenter usa las solicitudes de los pods y las restricciones de programación. metrics-server ayuda a observar el uso y a consumidores como kubectl top/HPA; no proporciona datos sobre la cola de tareas de Spark ni aprovisiona EC2 directamente.
Mida el tiempo de etapas y tareas, el spill, la espera de fetch de shuffle, el sesgo, el GC y las pérdidas de ejecutores en la interfaz de Spark y en los registros de eventos, junto con los límites de CPU, memoria, disco y red de los nodos. Confirme el cuello de botella antes de suponer que la serie R o NVMe siempre será más rápida. Revise AQE, el particionado, la estrategia de join y el formato de los datos; cambie un factor a la vez.
1. Elegir nodos y almacenamiento de instancia
Los ejemplos antiguos con R5d/R5ad/R5dn son solo algunas de las opciones disponibles. Compare las familias M/C/R/I según las necesidades de CPU, memoria, disco y red, la capacidad actual de la zona de disponibilidad y el coste total. La serie R no siempre es la mejor para shuffle y la serie C no es inadecuada por definición para Spark.
Graviton es una opción válida para evaluar Spark. Puede que ya exista una imagen probada compatible con varias arquitecturas; no siempre es necesario crear una imagen propia. Compruebe la compatibilidad arm64 de JNI, códecs, BLAS, paquetes de Python y complementos personalizados. El ejemplo siguiente selecciona amd64 para mantener una ruta coherente, sin afirmar que sea más rápida.
Nitro/NVMe no permite saber si un disco es almacenamiento de instancia. EBS también se expone como NVMe en Nitro. Que un disco no esté montado no significa necesariamente que esté vacío ni que sea seguro formatearlo. Se eliminó el bucle antiguo que formateaba dispositivos NVMe sin montar porque podía identificar mal dispositivos EBS o raíz.
2. Almacenamiento temporal administrado en AL2023
Antes de este laboratorio, pida a un administrador que prepare dos EC2NodeClass:
spark-general: una configuración general de nodos revisada para los controladores.spark-nvme: una nueva clase específica para ejecutores, con una AMI AL2023 fijada que coincida con la versión y arquitectura de Kubernetes, y los ajustes adecuados de IAM, subredes y grupos de seguridad.
Incluya este campo en la configuración completa de spark-nvme. Es un fragmento, no un recurso independiente que se aplique con kubectl. Cambiar un NodeClass existente puede provocar deriva y sustitución de nodos; no improvise el formateo de discos en nodos en ejecución.
spec:
  instanceStorePolicy: RAID0
En AL2023, Karpenter configura RAID0 para el almacenamiento de instancia mediante NodeConfig y lo usa para el almacenamiento efímero de kubelet/containerd, incluida la capacidad asignable al nodo. Así se evita fijar /dev/nvme1n1 o exigir hostPath. Para otras familias de AMI o procesos de arranque personalizados, siga el procedimiento documentado.
El almacenamiento de instancia es espacio temporal y volátil, que se puede perder al detener, terminar o sufrir un fallo. RAID0 no es replicación ni copia de seguridad. Aunque no haya un cargo de volumen EBS separado, el precio de las instancias, la capacidad inactiva y los recálculos siguen teniendo un coste. EBS con el tamaño adecuado también es una opción; tenga en cuenta los límites de rendimiento tanto del volumen como de la instancia. No suponga que todos los nodos de EKS tienen un volumen raíz de 20 GB ni el mismo sistema de archivos subyacente.
3. Colocar controladores en On-Demand y ejecutores en Spot
On-Demand reduce la exposición del controlador a la reclamación de instancias Spot, pero no a fallos, mantenimiento ni deriva o caducidad de Karpenter. El estado de SparkContext/coordinación del controlador importa tanto en modo clúster como en modo cliente. Diseñe por separado los reintentos del trabajo y la recuperación de datos.
Guarde lo siguiente como nodepools.yaml, haciendo referencia a los dos NodeClass preparados. Los ejecutores necesitan capacidad de almacenamiento de instancia. Esta configuración usa exclusivamente Spot: si no hay capacidad Spot suficiente, los pods pueden quedar en estado Pending, sin conmutación automática a On-Demand. Si hace falta, diseñe una política de reserva explícita y límites de coste.
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: spark-driver
spec:
  template:
    metadata:
      labels:
        workload-pool: spark-driver
    spec:
      requirements:
      - key: kubernetes.io/arch
        operator: In
        values:
        - amd64
      - key: kubernetes.io/os
        operator: In
        values:
        - linux
      - key: karpenter.sh/capacity-type
        operator: In
        values:
        - on-demand
      - key: karpenter.k8s.aws/instance-category
        operator: In
        values:
        - m
        - r
      - key: karpenter.k8s.aws/instance-generation
        operator: Gt
        values:
        - '5'
      taints:
      - key: spark-role
        value: driver
        effect: NoSchedule
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: spark-general
  limits:
    cpu: '64'
    memory: 512Gi
  disruption:
    consolidationPolicy: WhenEmpty
    consolidateAfter: 120s
---
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: spark-executor
spec:
  template:
    metadata:
      labels:
        workload-pool: spark-executor
    spec:
      requirements:
      - key: kubernetes.io/arch
        operator: In
        values:
        - amd64
      - key: kubernetes.io/os
        operator: In
        values:
        - linux
      - key: karpenter.sh/capacity-type
        operator: In
        values:
        - spot
      - key: karpenter.k8s.aws/instance-category
        operator: In
        values:
        - m
        - r
        - i
      - key: karpenter.k8s.aws/instance-generation
        operator: Gt
        values:
        - '5'
      - key: karpenter.k8s.aws/instance-local-nvme
        operator: Gt
        values:
        - '0'
      taints:
      - key: spark-role
        value: executor
        effect: NoSchedule
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: spark-nvme
  limits:
    cpu: '256'
    memory: 2048Gi
  disruption:
    consolidationPolicy: WhenEmpty
    consolidateAfter: 120s
Las etiquetas y los selectores del pool eligen un destino; las tolerancias permiten usar sus taints. Una tolerancia no fuerza la ubicación y otros pods también pueden tenerla. NoSchedule no expulsa los pods que ya están en ejecución. Los límites de NodePool son salvaguardas de capacidad con coherencia eventual, que pueden rebasarse brevemente durante el escalado simultáneo; no son límites exactos de gasto.
Guárdelo como driver-template.yaml. Es una plantilla de pod de Spark, completada por Spark, no una implementación de pod independiente.
apiVersion: v1
kind: Pod
spec:
  securityContext:
    runAsNonRoot: true
    runAsUser: 185
    fsGroup: 185
  tolerations:
  - key: spark-role
    operator: Equal
    value: driver
    effect: NoSchedule
  containers:
  - name: spark-kubernetes-driver
    securityContext:
      allowPrivilegeEscalation: false
      capabilities:
        drop:
        - ALL
      seccompProfile:
        type: RuntimeDefault
    resources:
      requests:
        ephemeral-storage: 2Gi
      limits:
        ephemeral-storage: 4Gi
Guárdelo como executor-template.yaml.
apiVersion: v1
kind: Pod
spec:
  securityContext:
    runAsNonRoot: true
    runAsUser: 185
    fsGroup: 185
  tolerations:
  - key: spark-role
    operator: Equal
    value: executor
    effect: NoSchedule
  containers:
  - name: spark-kubernetes-executor
    securityContext:
      allowPrivilegeEscalation: false
      capabilities:
        drop:
        - ALL
      seccompProfile:
        type: RuntimeDefault
    resources:
      requests:
        ephemeral-storage: 10Gi
      limits:
        ephemeral-storage: 20Gi
    volumeMounts:
    - name: spark-local-dir-scratch
      mountPath: /var/data/spark-local
  automountServiceAccountToken: false
  volumes:
  - name: spark-local-dir-scratch
    emptyDir:
      sizeLimit: 16Gi
Este emptyDir usa el sistema de archivos de kubelet preparado y respaldado por NVMe; otra configuración de nodo podría respaldarlo de otra manera. El nombre del volumen debe empezar por spark-local-dir-, incluido el guion final y un sufijo. El nombre antiguo spark-local-dir no se reconoce y puede provocar que se monte otro emptyDir en la misma ruta.
Establecer solo spark.local.dir puede hacer que Spark en Kubernetes cree allí un emptyDir; no se requiere hostPath. Los montajes temporales reconocidos rellenan SPARK_LOCAL_DIRS. sizeLimit no reserva capacidad: el disco del nodo podría agotarse antes. Observe conjuntamente las solicitudes y límites, los registros, las capas de escritura y la presión del disco.
tmpfs consume RAM y requiere asignar presupuesto de memoria.
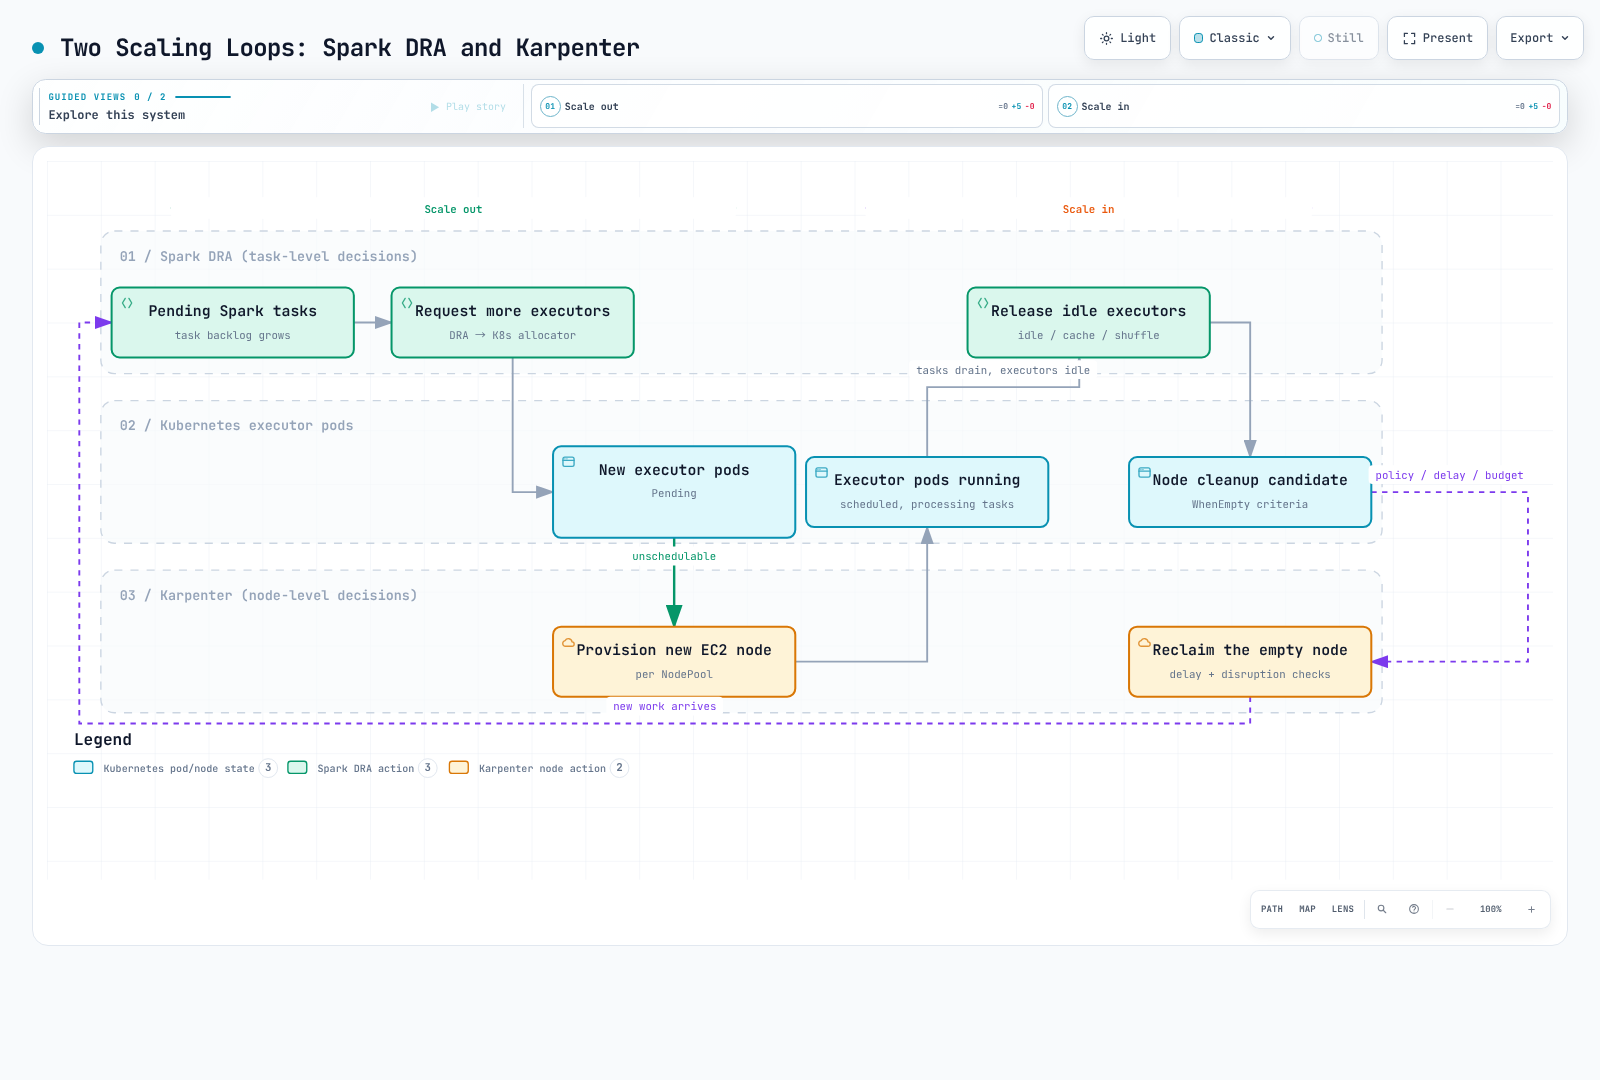
4. Dos ciclos de escalado y terminación
Guárdelo como performance.properties, reutilizando el espacio de nombres y el RBAC de la Parte 1.
spark.kubernetes.namespace=spark-jobs
spark.kubernetes.container.image=spark:4.2.0-scala2.13-java21-ubuntu
spark.kubernetes.authenticate.driver.serviceAccountName=spark-driver
spark.kubernetes.authenticate.executor.serviceAccountName=spark-executor
spark.kubernetes.driver.podTemplateFile=driver-template.yaml
spark.kubernetes.executor.podTemplateFile=executor-template.yaml
spark.kubernetes.driver.node.selector.workload-pool=spark-driver
spark.kubernetes.executor.node.selector.workload-pool=spark-executor
spark.kubernetes.driver.node.selector.karpenter.sh/capacity-type=on-demand
spark.kubernetes.executor.node.selector.karpenter.sh/capacity-type=spot
spark.driver.cores=1
spark.driver.memory=1g
spark.kubernetes.driver.limit.cores=1
spark.executor.cores=2
spark.executor.memory=4g
spark.kubernetes.executor.limit.cores=2
spark.executor.instances=2
spark.dynamicAllocation.enabled=true
spark.dynamicAllocation.shuffleTracking.enabled=true
spark.dynamicAllocation.minExecutors=1
spark.dynamicAllocation.initialExecutors=2
spark.dynamicAllocation.maxExecutors=10
spark.dynamicAllocation.executorIdleTimeout=60s
spark.kubernetes.allocation.batch.size=5
spark.kubernetes.allocation.batch.delay=1s
spark.decommission.enabled=true
spark.storage.decommission.enabled=true
spark.kubernetes.executor.terminationGracePeriodSeconds=120s# Prerequisite: Part 1's spark-jobs namespace and driver/executor RBAC.
# All template/property files below must be present in the submitter's working directory.
K8S_API_SERVER="$(kubectl config view --minify -o jsonpath='{.clusters[0].cluster.server}')"
: "${K8S_API_SERVER:?Select the intended Kubernetes context first}"
spark-submit \
--master "k8s://${K8S_API_SERVER}" --deploy-mode cluster \
--name spark-performance-smoke \
--properties-file performance.properties \
--class org.apache.spark.examples.SparkPi \
local:///opt/spark/examples/jars/spark-examples.jar 10Spark DRA ajusta el número de ejecutores según la cola de tareas y el estado de inactividad, caché y shuffle. spark.kubernetes.allocation.batch.size y batch.delay controlan la tasa de creación de pods del asignador de Kubernetes; no son exclusivos de DRA. Karpenter aporta capacidad a partir de las solicitudes y restricciones de pods que no se pueden programar. Las descargas de imágenes, la falta de IP, cuotas o capacidad en una zona y las discrepancias de taints también pueden retrasar los pods.
WhenEmpty con 120s es una política inicial de consolidación conservadora para pods Spark que suelen estar en ejecución. La definición de vacío de Karpenter puede incluir pods restantes sin coste de interrupción, como DaemonSets. Antes de considerar vacío un nodo que solo tenga ejecutores, inspeccione también las otras cargas de trabajo normales.
consolidateAfter > executorIdleTimeout no garantiza que DRA libere primero los ejecutores. Los temporizadores empiezan con eventos distintos, y los datos en caché o el seguimiento de shuffle pueden mantener los ejecutores activos durante más tiempo. La deriva, la caducidad y las interrupciones de Spot son independientes de la consolidación. Los PDB, do-not-disrupt y los presupuestos de interrupción no impiden que se reclame una instancia Spot.
Límites reales de la retirada
Normalmente, los avisos de detención o terminación de Spot llegan con dos minutos de antelación, según el mejor esfuerzo. La hibernación comienza de inmediato, sin ese aviso de dos minutos. La gestión de Spot de Karpenter requiere una conexión de EventBridge a SQS, una cola de interrupciones y permisos. Las opciones de Spark por sí solas no reciben avisos de interrupción de AWS.
Como se verificó en la Parte 1, la opción de retirada de Spark 4.2 inserta el preStop /opt/decom.sh de la imagen oficial. Compruebe el script real, la señal, el periodo de gracia del pod y la ruta de drenaje del nodo. spark.kubernetes.executor.terminationGracePeriodSeconds=120s solicita un periodo de gracia; no garantiza el tiempo de vida restante en la nube ni que se complete la migración de bloques. Sobrescribir los hooks del ciclo de vida puede cambiar ese comportamiento.
La migración depende de la capacidad de los pares, la red y el tiempo. La reserva de shuffle requiere una configuración explícita de spark.storage.decommission.fallbackStorage.path, además de un sistema de archivos operativo y sus permisos. Un almacenamiento remoto arbitrario o History Server no proporcionan una reserva automática. La recuperación de la caché RDD y la de shuffle también son distintas. Los recálculos, las pérdidas repetidas, los límites de reintento de fetch/tareas o los datos de origen ilegibles pueden hacer fallar el trabajo; no se garantiza que la pérdida de un ejecutor sea inocua.
5. Validar los recursos y el coste
| Ajuste | Efecto en Kubernetes |
|---|---|
| Memoria del controlador/ejecutor | Heap más la sobrecarga u otra memoria aplicable en la solicitud y el límite |
| Cores del controlador/ejecutor | Solicitud de CPU predeterminada y concurrencia específica del rol de Spark; no establecen un límite de CPU automáticamente |
| spark.kubernetes.*.request.cores | Solicitud explícita de CPU, distinta del número de ranuras de tareas |
| spark.kubernetes.*.limit.cores | Límite explícito de CPU |
| Almacenamiento efímero de la plantilla | Presupuesto de almacenamiento temporal para archivos temporales y registros; el almacenamiento subyacente depende de la configuración del nodo |
Un ejecutor JVM con heap de 4g y la sobrecarga predeterminada del 10 % añade 409 MiB tras la conversión a entero, con un total de 4505 MiB. Calcule por separado PySpark, la memoria fuera del heap y los ajustes explícitos de sobrecarga; 4g no es toda la memoria del pod. No es necesario que el controlador siempre sea mayor que el ejecutor, y los ejecutores más pequeños no son mejores en todos los casos.
Compare el coste por trabajo completado correctamente y el tiempo p95 de finalización, incluidos los reintentos, la capacidad inactiva, el almacenamiento, la red y los registros, en lugar de fijarse solo en el precio por hora de la instancia. El comportamiento del entorno de ejecución de EMR, como la preasignación de ejecutores, puede diferir del de Spark ascendente; inspeccione la configuración de la versión seleccionada.
Los ejemplos se comprobaron con los CRD y la construcción de pasos funcionales nativos de Spark. Esto no equivale a aprovisionar EC2, inicializar discos, probar interrupciones de Spot ni ejecutar un benchmark de rendimiento con un gran volumen de shuffle.
- Comportamiento de Karpenter para instanceStorePolicy y AMI
- Gestión de interrupciones y disrupciones de Karpenter
- Programación de Karpenter
- Implementación de la configuración de almacenamiento de instancia en EKS AL2023
- Configuración de Kubernetes de Spark 4.2
- Implementación de la función de directorio local de Spark
- Configuración de Spark 4.2
- Limitaciones de los avisos de interrupción de Spot
- Guía de rendimiento y almacenamiento específica de EMR