Parte 2: Implementación con Helm y elección del ejecutor
Base de revisión: chart 1.22.0 / Airflow 3.3.1 / KEDA 2.20 Último parche upstream comprobado: Airflow 3.3.2; los ejemplos del chart siguen usando 3.3.1 · 12 de octubre de 2026
1. Identidad del chart y valores predeterminados reales
Esta guía usa el chart oficial del repositorio de Apache Airflow. Al registrar el alias de repositorio apache-airflow, el nombre del chart de Helm es apache-airflow/airflow. No mezcle valores de charts independientes, como airflow-helm/charts; no son los únicos charts que existen.
El chart 1.22.0 usa Airflow 3.2.2 y CeleryExecutor de forma predeterminada, no KubernetesExecutor. Los ejemplos alinean explícitamente la etiqueta de la imagen y airflowVersion con 3.3.1 y seleccionan un ejecutor. Los campos de versión que no coinciden o las sustituciones de digest pueden hacer que la configuración generada por el chart no concuerde con la imagen real.
Use Helm 3.19.0 o una versión posterior. El registro de cambios de la versión especifica este mínimo, aunque en el README incluido todavía aparece una declaración anterior de Helm 3.0+. La lista de versiones de Kubernetes probadas con Airflow 3.3.1 es 1.30–1.35. El README del chart 1.16.0 especificaba 1.29+, por lo que no introdujo un requisito de 1.30+. No dé por sentado que Chart.yaml impone todos los mínimos documentados: durante la revisión se renderizaron plantillas para 1.29, lo cual no demuestra que esa versión sea compatible.
2. Preparar conexiones y Secrets
Este laboratorio da por supuestos permisos en el namespace, una base de datos PostgreSQL externa preparada y la red/capacidad de EKS. Prepare el esquema y el usuario de la base de datos, los privilegios de migración, el URI de conexión/TLS probado y las políticas de copia de seguridad/retención. KEDA solo se necesita para el perfil de escalado de Celery.
Los valores de abajo hacen referencia a Secrets en lugar de incluir contraseñas. Guarde el URI de la base de datos en una sola línea dentro de un archivo protegido y codifique con URI los caracteres reservados en las contraseñas y otros campos. Use TLS verificado para RDS u otras bases de datos remotas. Cualquier ruta de sslrootcert debe ser legible por el cliente real de la base de datos. KEDA también es un cliente de base de datos: la configuración de CA, DNS, red y acceso solo para Airflow es insuficiente. El chart no copia automáticamente los archivos CA a KEDA.
Esta es una secuencia para una instalación nueva. No sobrescribe Secrets existentes. No vuelva a generar las claves Fernet/API/JWT durante las actualizaciones habituales; gestione las copias de seguridad y la rotación por separado.
set -euo pipefail
# Fresh installation only. Keep existing Fernet/API/JWT keys during an ordinary upgrade.
# AIRFLOW_DB_URI_FILE contains the tested, single-line PostgreSQL URI; do not commit it.
: "${AIRFLOW_DB_URI_FILE:?Set the path to your protected database connection file}"
kubectl create namespace airflow --dry-run=client -o yaml | kubectl apply -f -
kubectl -n airflow create secret generic airflow-metadata \
  --from-file="connection=$AIRFLOW_DB_URI_FILE"

umask 077
AIRFLOW_SECRET_TMP_DIR="$(mktemp -d)"
trap 'rm -rf "$AIRFLOW_SECRET_TMP_DIR"' EXIT
python3 - "$AIRFLOW_SECRET_TMP_DIR" <<'PY'
import base64
from pathlib import Path
import secrets
import sys
folder = Path(sys.argv[1])
(folder / "fernet-key").write_text(base64.urlsafe_b64encode(secrets.token_bytes(32)).decode())
(folder / "api-secret-key").write_text(secrets.token_urlsafe(48))
(folder / "jwt-secret").write_text(secrets.token_urlsafe(48))
PY
kubectl -n airflow create secret generic airflow-fernet \
  --from-file="fernet-key=$AIRFLOW_SECRET_TMP_DIR/fernet-key"
kubectl -n airflow create secret generic airflow-api-secret \
  --from-file="api-secret-key=$AIRFLOW_SECRET_TMP_DIR/api-secret-key"
kubectl -n airflow create secret generic airflow-jwt \
  --from-file="jwt-secret=$AIRFLOW_SECRET_TMP_DIR/jwt-secret"
Si se establece metadataSecretName, metadataConnection no es la fuente autoritativa de la conexión. Deshabilitar únicamente PostgreSQL incluido en el chart no configura una base de datos externa. Para un URI de PostgreSQL compartido por Airflow y KEDA, verifique que el esquema sea compatible con ambos, como postgresql://; es posible que los esquemas +driver específicos de SQLAlchemy no funcionen en KEDA.
3. Instalación explícita de KubernetesExecutor
Guárdelo como kubernetes-values.yaml. Este laboratorio deshabilita la persistencia del triggerer; los registros locales temporales no son un historial duradero. La Parte 3 prepara la entrega de DAG y la Parte 5 trata los registros/almacenamiento remotos. Verifique el acceso a los registros posteriores a las tareas antes de usarlo en producción.
airflowVersion: 3.3.1
defaultAirflowTag: 3.3.1
executor: KubernetesExecutor
postgresql:
  enabled: false
redis:
  enabled: false
data:
  metadataSecretName: airflow-metadata
  metadataConnection:
    protocol: postgresql
fernetKeySecretName: airflow-fernet
apiSecretKeySecretName: airflow-api-secret
jwtSecretName: airflow-jwt
createUserJob:
  enabled: false
triggerer:
  persistence:
    enabled: false
config:
  core:
auth_manager: airflow.providers.fab.auth_manager.fab_auth_manager.FabAuthManagerhelm repo add apache-airflow https://airflow.apache.org
helm repo update apache-airflow
helm install airflow apache-airflow/airflow \
--namespace airflow --version 1.22.0 \
--values kubernetes-values.yaml --wait --timeout 10m
kubectl -n airflow get deployments,statefulsets,pods,jobs
helm list -n airflowQue --wait termine correctamente o que los pods estén Running no demuestra que se ejecuten los DAG. Verifique que los trabajos de migración se hayan completado correctamente y que los componentes de larga duración estén Ready; después, use el DAG de prueba de la Parte 3 para comprobar el inicio de los workers, la comunicación con Execution API, los resultados y los registros.
Usuario inicial
createUserJob está habilitado de forma predeterminada y puede crear admin/admin, por lo que este perfil lo deshabilita. Los valores actuales están en createUserJob.defaultUser; webserver.defaultUser es una ruta de compatibilidad. En lugar de guardar una contraseña en values.yaml o Helm --set, use este comando interactivo para el administrador de autenticación FAB seleccionado. Otros administradores de autenticación o SSO requieren sus propios procedimientos de gestión de usuarios.
# FAB auth manager, as selected in these values. Password is prompted twice.
kubectl -n airflow exec -it deployment/airflow-api-server -c api-server -- \
  airflow users create --username airflow-admin --role Admin \
  --email admin@example.com --firstname Airflow --lastname Admin
kubectl -n airflow port-forward --address 127.0.0.1 service/airflow-api-server 8080:8080
Con el port-forward en ejecución, consulte la interfaz de usuario en el puerto local 8080. El acceso de producción requiere una ruta adecuada de autenticación/autorización/TLS; este comando no crea un endpoint público. Los Secrets de API y task-JWT tienen funciones distintas y necesitan una gestión estable durante su ciclo de vida. Perder o sustituir sin cuidado una clave Fernet puede hacer que las conexiones/variables cifradas existentes no se puedan leer.
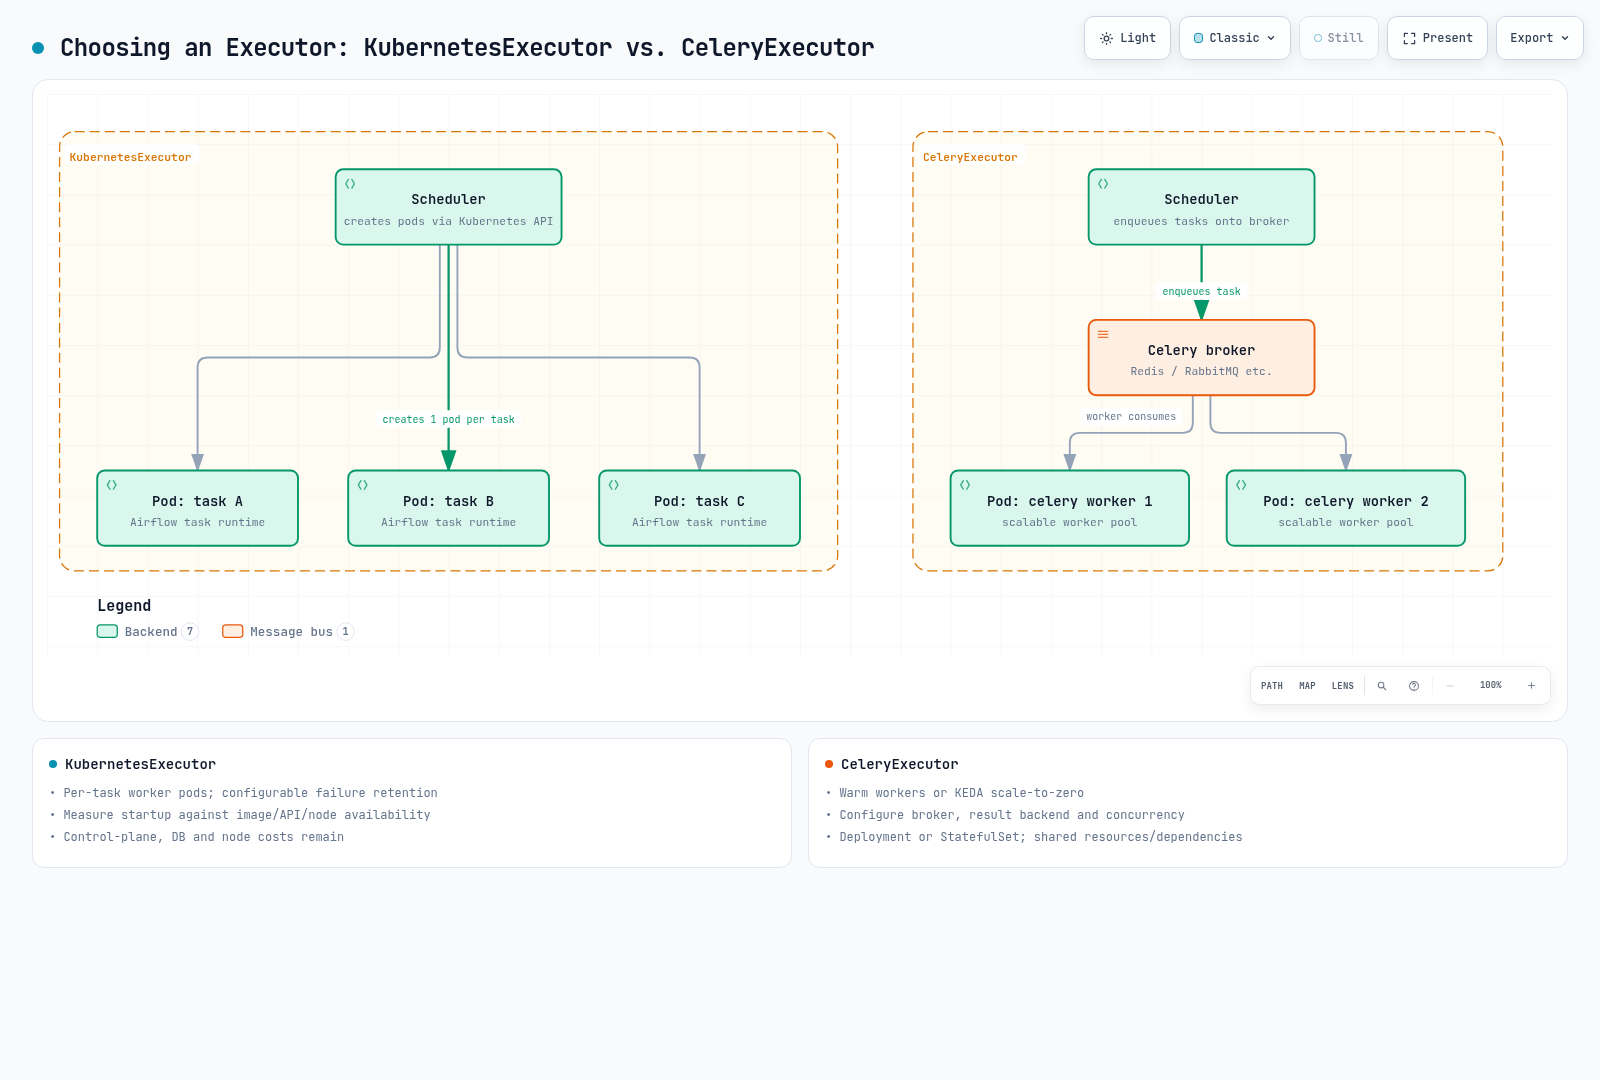
4. Elegir ejecutores según la carga de trabajo y las operaciones
| Aspecto | KubernetesExecutor | CeleryExecutor |
|---|---|---|
| Unidad de worker | Un Pod por instancia de tarea | Un pool que consume trabajo del broker |
| Inicio | Mida la caché de imágenes, la latencia de API/scheduler y la disponibilidad de nodos | La capacidad disponible puede reducir el tiempo de inicio; escalar hasta cero vuelve a introducir arranques en frío |
| Costo en reposo | Se mantienen los costos del plano de control, la base de datos, los nodos y los registros | Se mantienen los costos del broker, la base de datos y los nodos, incluso sin workers |
| Recursos/aislamiento | Dependen de la especificación del Pod, las cuotas, las cuentas de servicio, la red y los nodos | Las tareas simultáneas comparten los recursos y las dependencias de los workers |
| Requisitos adicionales | Entorno de ejecución/imagen de tareas, entrega de DAG y permisos de la API de Kubernetes | Broker, backend de resultados, ciclo de vida de los workers, colas y concurrencia |
No dé por supuesto un tiempo de inicio fijo de 1–2 minutos ni una superioridad universal con grandes volúmenes. La imagen de worker de KubernetesExecutor necesita un entorno de ejecución de tareas y dependencias de DAG compatibles con Airflow; no puede ser una imagen arbitraria de GPU/CLI. KubernetesPodOperator inicia un Pod secundario independiente con una imagen de carga de trabajo y es una ruta diferente. La retención/eliminación de pods con errores también depende de la configuración del provider.
Se pueden usar ejecutores simultáneos, pero la operación mixta no es obligatoria en la mayoría de las implementaciones. Compare la simplicidad de un solo ejecutor con los beneficios medidos y las políticas adicionales que requiere su carga de trabajo real.
5. Escalar los workers de Celery
Prepare primero el broker externo y el backend de resultados. Estos Secrets solo se necesitan para el perfil de Celery; valide el protocolo, TLS y los permisos frente a los servicios reales. Un backend de resultados de base de datos SQLAlchemy de Celery usa un URI como db+postgresql://, así que no copie sin más el URI de conexión de metadatos.
# Use protected URI files for the chosen external broker and result backend.
: "${AIRFLOW_BROKER_URI_FILE:?Set the protected broker URI file}"
: "${AIRFLOW_RESULT_URI_FILE:?Set the protected Celery result-backend URI file}"
kubectl -n airflow create secret generic airflow-broker \
  --from-file="connection=$AIRFLOW_BROKER_URI_FILE"
kubectl -n airflow create secret generic airflow-result-backend \
  --from-file="connection=$AIRFLOW_RESULT_URI_FILE"
Guárdelo como celery-values.yaml, un perfil completo independiente. Seleccione este archivo en el comando de instalación para una implementación nueva. Cambiar una implementación activa requiere un plan de drenaje, migración y recuperación.
airflowVersion: 3.3.1
defaultAirflowTag: 3.3.1
executor: CeleryExecutor
postgresql:
  enabled: false
redis:
  enabled: false
data:
  metadataSecretName: airflow-metadata
  metadataConnection:
    protocol: postgresql
  brokerUrlSecretName: airflow-broker
  resultBackendSecretName: airflow-result-backend
fernetKeySecretName: airflow-fernet
apiSecretKeySecretName: airflow-api-secret
jwtSecretName: airflow-jwt
createUserJob:
  enabled: false
triggerer:
  persistence:
    enabled: false
config:
  core:
    auth_manager: airflow.providers.fab.auth_manager.fab_auth_manager.FabAuthManager
  celery:
    worker_concurrency: 4
workers:
  celery:
    persistence:
      enabled: false
    keda:
      enabled: true
      minReplicaCount: 0
      maxReplicaCount: 20
      pollingInterval: 10
      cooldownPeriod: 300
      advanced:
        horizontalPodAutoscalerConfig:
          behavior:
            scaleDown:
              stabilizationWindowSeconds: 300
Concurrencia=4 y maxReplicaCount=20 son límites de ejemplo, no garantías de rendimiento ni de costos. Ajuste conjuntamente los recursos de los workers, la memoria de las tareas, la carga de la base de datos/broker y los límites de los nodos. Con persistence=false, este perfil tiene como objetivo un Deployment; persistence=true puede producir un StatefulSet, que KEDA también admite.
Los valores predeterminados reales del chart son pollingInterval=5s y cooldownPeriod=30s. El ejemplo elige explícitamente 10s/300s. El cooldown controla el escalado a cero; distíngalo del sondeo/estabilización de HPA por encima de cero. El sondeo real de la base de datos también depende de la actividad de KEDA, las solicitudes de HPA y el almacenamiento en caché de métricas, no de un intervalo universal exacto de 10 segundos.
Este perfil genera la siguiente consulta de PostgreSQL:
SELECT ceil(COUNT(*)::decimal / 4) FROM task_instance WHERE (state='running' OR state='queued') AND queue IN ('default')worker_concurrency no es una columna de la base de datos: el chart inserta el número 4. Cuenta el trabajo en ejecución/en cola de esta cola de workers y calcula la cantidad de réplicas necesarias. Un resultado de consulta de 25 sigue limitado por maxReplicaCount=20, por lo que puede quedar una cola pendiente. No interprete los errores de consulta o autenticación como si no hubiera trabajo; inspeccione el estado de ScaledObject/HPA.
Ejecutores mixtos y alias
Al combinar ejecutores, excluya el trabajo que Celery no ejecutará. La consulta predeterminada del chart excluye el literal KubernetesExecutor, pero un alias almacenado, como k8s, todavía puede contabilizarse. TaskInstance conserva el valor de task.executor.
Este ejemplo de sustitución de consulta supone el uso de CeleryExecutor predeterminado junto con KubernetesExecutor. Actualice los filtros al cambiar las colas, los alias o los nombres completos de clase, según los valores almacenados reales. En esta configuración, NULL representa el ejecutor Celery predeterminado.
executor: CeleryExecutor,KubernetesExecutor
workers:
  celery:
    keda:
      query: >-
        SELECT ceil(COUNT(*)::decimal / {{ .Values.config.celery.worker_concurrency }})
        FROM task_instance
        WHERE state IN ('running', 'queued')
        AND queue = 'default'
        AND (executor IS NULL OR executor = 'CeleryExecutor')
Combine este fragmento con el perfil completo de Celery e inspeccione el SQL renderizado y el destino antes de cambiar una implementación. Los Pods de tareas de KubernetesExecutor no forman un pool de réplicas que se escale de la misma manera. La capacidad de nodos de Karpenter/Cluster Autoscaler, el paralelismo/pools/concurrencia de DAG de Airflow y el rendimiento de API siguen siendo límites independientes. Esto no significa que KEDA solo admita Deployments o que no pueda usarse en otros lugares de un entorno de KubernetesExecutor.
6. Validación y ciclo de vida de los recursos
kubectl -n airflow rollout status deployment/airflow-api-server --timeout=180s
kubectl -n airflow rollout status deployment/airflow-scheduler --timeout=180s
kubectl -n airflow rollout status deployment/airflow-dag-processor --timeout=180s
kubectl -n airflow get jobs
kubectl -n airflow logs deployment/airflow-scheduler -c scheduler --tail=100
kubectl -n airflow logs deployment/airflow-dag-processor -c dag-processor --tail=100
# Celery/KEDA profile only:
kubectl -n airflow get scaledobjects,hpa
kubectl -n airflow describe scaledobject airflow-worker
kubectl -n airflow get deployments,statefulsets -l component=worker
Una visita correcta a la interfaz de usuario o un Deployment en buen estado no valida conjuntamente las migraciones, la entrega de DAG, la ejecución de tareas, los registros remotos y el escalado a cero. Envíe trabajo conocido, inspeccione la cantidad de workers, los resultados y los registros; después, pruebe el retorno al estado inactivo y la recuperación.
Este perfil no usa PostgreSQL incluido en el chart. El chart usa de forma predeterminada una imagen antigua de PostgreSQL bitnamilegacy; una instalación predeterminada no es una referencia para producción. Eliminar un Pod de base de datos con Helm uninstall no necesariamente elimina de inmediato los datos de PVC/PV. Inspeccione por separado la retención de PVC, la política de recuperación de StorageClass y la eliminación/copias de seguridad de bases de datos externas, en lugar de eliminar indiscriminadamente el namespace, los Secrets y la base de datos.
La revisión comprueba la estructura de recursos del chart/KEDA, los manifiestos públicos de imágenes y 24 casos SQL en un motor PostgreSQL real. No ejecuta una conexión a EKS/base de datos, una carga de trabajo de contenedor, la creación de usuarios ni el escalado del controlador de KEDA.