Parte 4: Katib — Ajuste de hiperparámetros y AutoML
Versiones compatibles: Katib 0.19.0, Kubeflow Community Distribution 26.03.1 Última actualización: September 12, 2026
Configuración del entorno de laboratorio
Use los controladores de Katib 0.19.0, el administrador/almacenamiento de DB, las imágenes de Suggestion requeridas y los permisos del namespace para crear Experiments. Distinga el acceso a Profile de plataforma completa de una instalación independiente. La capacidad de GPU es opcional; Karpenter es un aprovisionador.
Qué es Katib
Katib admite optimización de hiperparámetros (HPO) y búsqueda de arquitectura neuronal (NAS). Un Experiment define el objetivo/espacio de búsqueda/algoritmo/plantilla de Trial; Suggestion y su servicio de algoritmo proponen candidatos; un Trial administra la ejecución de un candidato. La forma en que los resultados previos influyen en las sugerencias depende del algoritmo.
Estos son objetos de recursos personalizados definidos por CRDs, no definiciones de CRD nuevas instaladas para cada ejecución. El controlador de Trial crea el recurso de trabajo configurado; el controlador de ese trabajo y Kubernetes gestionan la creación de Pods y la ubicación de nodos. Los trialResources predeterminados de 0.19.0 incluyen TrainJob.v1alpha1.trainer.kubeflow.org, Kubernetes Job y tipos de trabajos de entrenamiento heredados. Haga coincidir la API/runtime de Trainer real, los permisos, las condiciones de éxito/error y los Pods/contenedores de destino del recopilador; la compatibilidad no es automática.
Inspeccione el estado con kubectl get experiments.kubeflow.org y kubectl get trials.kubeflow.org. Estos son distintos de la API Experiment de KFP con nombre similar.
Algoritmos de búsqueda
Los nombres de los algoritmos deben coincidir con las entradas KatibConfig instaladas y las imágenes de Suggestion. La configuración predeterminada de 0.19.0 incluye:
| Nombre | Estrategia y restricciones |
|---|---|
random | Muestreo del espacio/distribuciones configurados; no necesariamente uniforme para cada parámetro |
grid | Combinaciones finitas; los objetivos, errores o límites de Trial pueden impedir una ejecución exhaustiva |
bayesianoptimization, tpe, multivariate-tpe | Diferentes estrategias de candidatos basadas en modelos; no se garantizan menos Trials ni un óptimo |
hyperband | Presupuestos de recursos y reducción sucesiva; el código de entrenamiento debe respetar el parámetro de presupuesto |
cmaes, sobol | Evolución por adaptación de covarianza y muestreo de baja discrepancia, respectivamente; no son el mismo algoritmo |
pbt | Entrenamiento basado en población con requisitos para compartir checkpoints; distinto de CMA-ES |
enas, darts | Algoritmos de búsqueda de arquitectura con sus propias plantillas/dependencias |
La guía de PBT requiere un volumen RWX y resumePolicy: FromVolume. Cambiar el nombre de un algoritmo no hace que un código de entrenamiento arbitrario sea compatible.
Anatomía de un Experiment
| Campo | Significado |
|---|---|
objective | Nombre de la métrica, maximizar/minimizar y objetivo opcional |
parameters | Espacios double/int/discrete/categorical, rangos/listas/distribuciones |
algorithm | Algoritmo y configuración de Suggestion instalados |
trialTemplate | Sustitución de trialParameters y especificación de trabajo, selección de contenedor/Pod principal, condiciones de éxito/error |
parallelTrialCount | Trials procesados simultáneamente, no la cantidad de Pods/GPU/EC2 |
maxTrialCount | Criterio de detención por conteo de completados, no conteo de entrenamientos exitosos ni límite inmutable de costo durante la vida útil |
maxFailedTrialCount | Umbral de errores que incluye Trials con error y métricas no disponibles |
metricsCollectorSpec / earlyStopping | Informe de métricas y configuración independiente de detención temprana |
El logro del objetivo, el límite de conteo de completados o las sugerencias agotadas pueden finalizar correctamente; los umbrales de error o los errores de Suggestion pueden hacer fallar el Experiment. El estado de finalización cuenta Trials exitosos, fallidos, eliminados, detenidos tempranamente y con métricas no disponibles. La política de reanudación y los cambios de especificación también afectan al ciclo de vida, así que no trate maxTrialCount como un límite inmutable de creación o gasto durante la vida útil.
Succeeded es un resultado del bucle de control, no una certificación de calidad del modelo. status.currentOptimalTrial describe la mejor observación recopilada; la ausencia de métricas puede no dejar ningún modelo mejor utilizable.
Detención temprana y la implementación medianstop de 0.19.0
La detención temprana puede terminar un Trial en curso. La guía oficial requiere recopiladores StdOut/File y registros con marcas de tiempo. No suponga compatibilidad equivalente para cada recopilador o bucle de entrenamiento arbitrario. Los valores predeterminados son min_trials_required=3 y start_step=4.
Distinga la regla documentada de la implementación de esta versión. La guía oficial describe una mediana de los promedios acumulados de Trials completados. Sin embargo, en v0.19.0, get_median_value almacena el promedio de cada Trial exitoso sobre sus primeras observaciones start_step y devuelve la media aritmética de esos promedios almacenados. Ejecutar la función sin cambios localmente con [1, 2, 100] produjo aproximadamente 34.333, no la mediana estadística 2. El nombre del algoritmo no garantiza un cálculo de mediana en esta versión.
La asignación de presupuesto de Hyperband y el servicio de detención temprana son rutas de configuración/ejecución independientes. Valide el riesgo de descartar candidatos prometedores y los efectos del formato de métricas, la frecuencia de informe y los parámetros de presupuesto.
Cómo se ejecuta un Experiment, de principio a fin
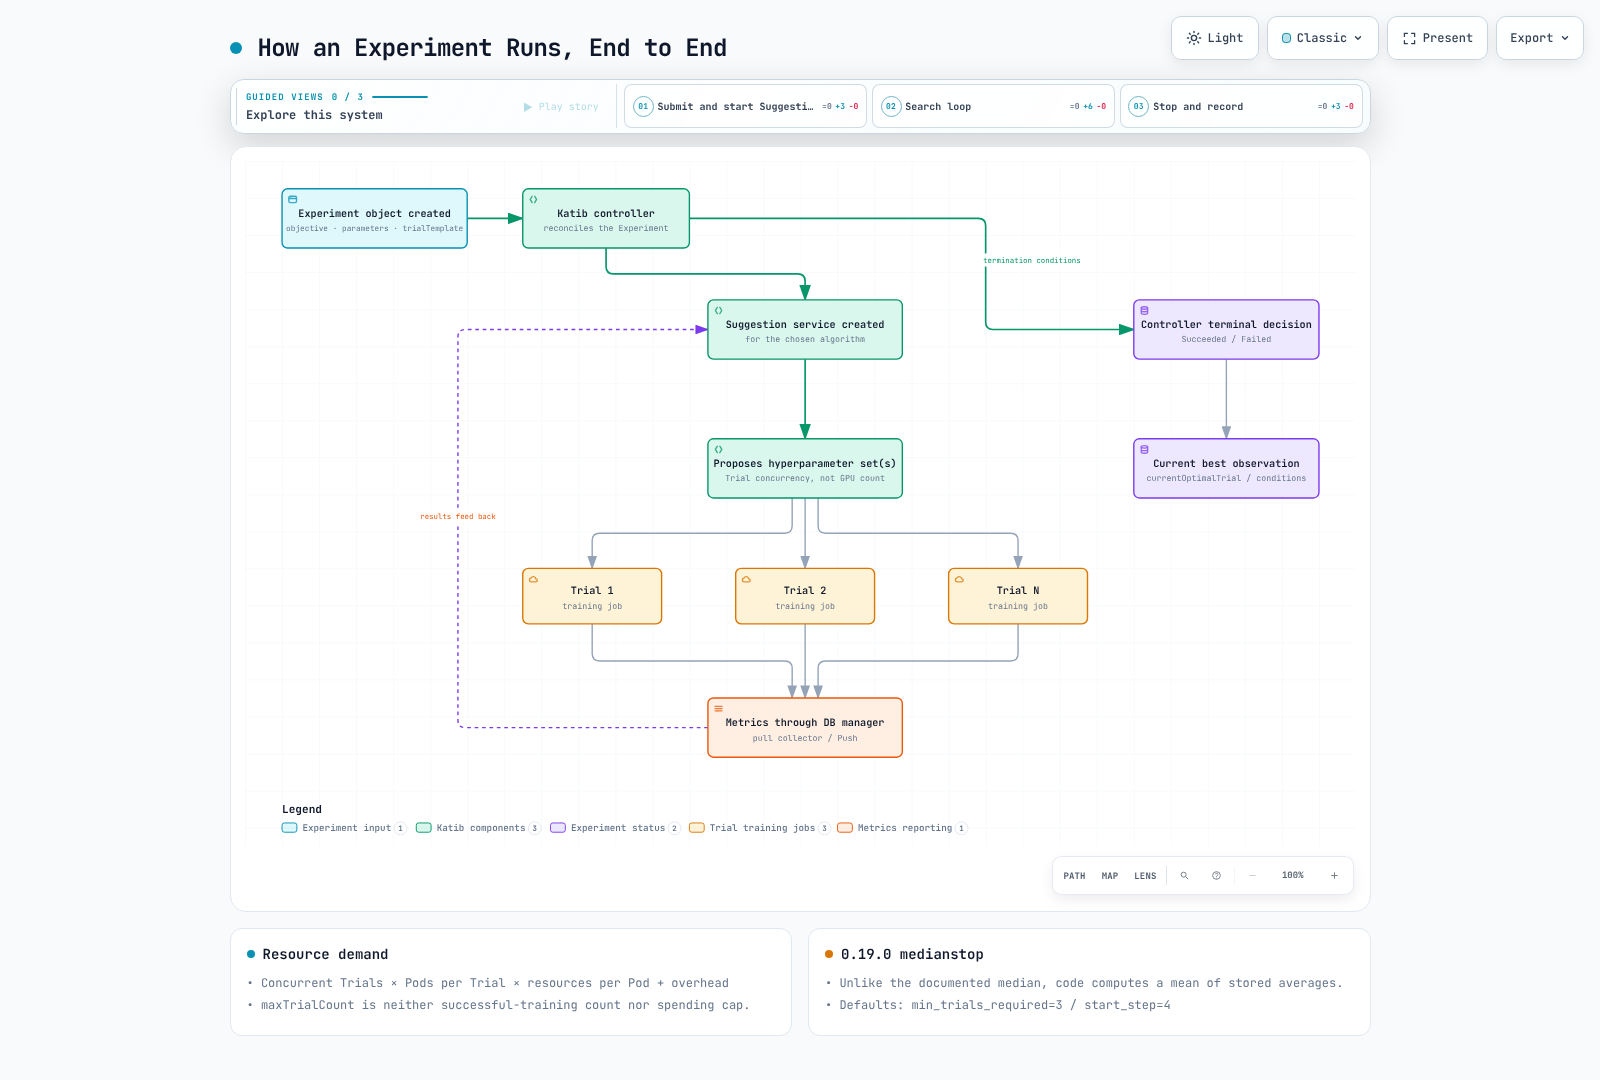
El controlador de Experiment solicita candidatos mediante recursos Suggestion y crea objetos Trial. Los controladores de Trial y de trabajos de entrenamiento impulsan la ejecución, mientras que las métricas se informan mediante el administrador de DB. Los algoritmos consumen los resultados según su implementación. Inspeccione las condiciones de finalización y los trabajos secundarios restantes; los hiperparámetros óptimos no constituyen por sí mismos un artefacto de modelo desplegable.
Recopilación de métricas
| Modo | Configuración y restricciones |
|---|---|
StdOut | Modo de extracción predeterminado; extrae métricas del formato de registro del contenedor principal |
File | TEXT o JSON delimitado por líneas; configure la ruta y los filtros |
TensorFlowEvent | Directorio de archivos de eventos, incluidos escritores compatibles con TensorBoard |
Custom | Implementación de recopilador proporcionada por el usuario; el scraping HTTP arbitrario no es una opción predeterminada integrada |
Push | El código de entrenamiento llama a SDK report_metrics() para el administrador de DB; no siempre se requiere un sidecar de recopilador |
La inyección de extracción necesita la etiqueta de namespace katib.kubeflow.org/metrics-collector-injection: enabled, un webhook funcional y una selección correcta del Pod/contenedor de destino. El entrenamiento distribuido necesita una política explícita de rango de informe. Valide los nombres de métricas, el formato numérico, las marcas de tiempo, la conectividad y las políticas. Un trabajo de entrenamiento exitoso no garantiza que se hayan recopilado métricas.
Capacidad y costo en EKS
La demanda es aproximadamente Trials simultáneos × Pods por Trial × recursos por Pod, más la sobrecarga de recopilador/Suggestion/base de datos. Si cada Trial tiene dos Pods que solicitan cuatro GPU cada uno, parallelTrialCount 8 puede solicitar 64 GPU, no ocho.
Para los Pods Pending, inspeccione los eventos, las restricciones de programación, las cuotas, la capacidad de NodePool/EC2, los controladores y el estado de bootstrap. Karpenter no siempre puede proporcionar capacidad, y una mayor concurrencia no garantiza un tiempo total de ejecución más corto. La detención temprana puede liberar recursos de Pod mientras continúan los cargos de EC2 por nodos retenidos.
Configure conjuntamente los criterios de total de Trials, la concurrencia, los reintentos de trabajos/el tamaño distribuido, los plazos y la retención de datos. Verifique la recopilación de métricas y la finalización con una pequeña carga de trabajo de CPU antes de aumentar la escala de GPU.
Validación y fuentes
Se inspeccionaron la configuración de v0.19.0, las rutas de controlador/API, recopilador y el código fuente de medianstop. La función medianstop sin cambios se ejecutó localmente con historial precargado de Trials exitosos y llamadas de red bloqueadas. No se ejecutó ningún Experiment ni carga de trabajo de GPU.
- KatibConfig predeterminado de 0.19.0
- Decisiones de estado de Experiment
- implementación de medianstop
- Guía del recopilador de métricas
- Guía de detención temprana
Próximos pasos
Continúe con las API y los runtimes de entrenamiento distribuido en Parte 5: Trainer.
Cuestionario
Para poner a prueba lo aprendido en este capítulo, pruebe el Cuestionario del tema.