Gestión del tráfico de Linkerd
Última actualización: 11 de septiembre de 2026 · Linkerd edge-26.9.1 · Gateway API 1.5.1 · Flagger 1.45.0
El enrutamiento actual de Linkerd utiliza recursos de Gateway API y anotaciones compatibles. Los ServiceProfiles siguen siendo una interfaz de compatibilidad, mientras que TrafficSplit/linkerd-smi está obsoleto. Estas vías no son intercambiables: un ServiceProfile existente tiene prioridad sobre los HTTPRoutes de salida del mismo Service e impide que surta efecto la configuración más reciente de reintentos, tiempos de espera y acumulación de fallos.
Los ejemplos siguientes son ejercicios independientes para cargas de trabajo de aplicaciones existentes y probadas. Presuponen los requisitos previos de instalación, la incorporación adecuada de los namespaces, puertos de Service/contenedor declarados y endpoints listos. En esta revisión no se ejecutó ninguna instalación de clúster, cambio de tráfico ni prueba con carga de producción.
Arquitectura de gestión del tráfico
| Vía de políticas | Función prevista | Límite importante |
|---|---|---|
| HTTPRoute con un Service como padre | Enrutamiento y fiabilidad de salida desde clientes de la malla | El cliente debe pertenecer a la malla y poder inspeccionar HTTP |
| HTTPRoute con un Server como padre | Coincidencia para la autorización de entrada | Vinculación y función de política diferentes |
| ServiceProfile | Métricas, reintentos y tiempos de espera de rutas de la interfaz anterior | Anula la vía de políticas más reciente para el mismo Service |
| TrafficSplit | Enrutamiento ponderado SMI heredado | Requiere su extensión y sus CRDs obsoletos |
Las políticas basadas en Services dependen del descubrimiento de Services. Las rutas directas a IP de Pod o sin IP de clúster, los clientes ajenos a la malla y el TLS opaco originado por la aplicación no reciben automáticamente el mismo comportamiento de L7. Trate la identidad, la autorización y el enrutamiento como controles independientes.
Enrutamiento actual con HTTPRoute
Services y enrutamiento ponderado
Para este ejercicio, prepare Deployments estables y canary etiquetados con app:web y version:stable/canary, que escuchen en 8080 y tengan comprobaciones de disponibilidad adecuadas para la carga de trabajo. El namespace siguiente incorpora los Pods aptos de nueva creación; no despliega esas aplicaciones:
apiVersion: v1
kind: Namespace
metadata:
  name: route-demo
  annotations:
    linkerd.io/inject: enabled
---
apiVersion: v1
kind: Service
metadata:
  name: web
  namespace: route-demo
spec:
  selector:
    app: web
    version: stable
  ports:
  - name: http
    port: 80
    targetPort: 8080
    appProtocol: http
---
apiVersion: v1
kind: Service
metadata:
  name: web-stable
  namespace: route-demo
spec:
  selector:
    app: web
    version: stable
  ports:
  - name: http
    port: 80
    targetPort: 8080
    appProtocol: http
---
apiVersion: v1
kind: Service
metadata:
  name: web-canary
  namespace: route-demo
spec:
  selector:
    app: web
    version: canary
  ports:
  - name: http
    port: 80
    targetPort: 8080
    appProtocol: http
El Service de entrada selecciona Pods estables para el enrutamiento predeterminado de Kubernetes. Su selector sí se utiliza: el tráfico ajeno a la malla o no sujeto a la política sigue necesitando un backend elegido deliberadamente. El HTTPRoute dirige el tráfico apto de los clientes de la malla hacia los Services de backend:
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: web-route
  namespace: route-demo
spec:
  parentRefs:
  - group: ''
    kind: Service
    name: web
    port: 80
  rules:
  - backendRefs:
    - name: web-stable
      port: 80
      weight: 90
    - name: web-canary
      port: 80
      weight: 10
group:"" es el grupo de API principal canónico para las referencias a Services. Linkerd conserva un alias core heredado en algunas vías, pero los recursos portables de Gateway API deben usar el grupo vacío. El 80 referenciado es el puerto del Service, no el 8080 del contenedor.
Los pesos son valores relativos no negativos con un total positivo utilizable. 90/10 y 9/1 expresan la misma proporción; la suma no tiene que ser 100. Son una configuración de enrutamiento, no una garantía de recuentos exactos de solicitudes a corto plazo, conexiones iguales ni recuentos de réplicas correspondientes.
kubectl -n route-demo get httproute web-route -o yaml
kubectl -n route-demo get endpointslices.discovery.k8s.io \
  -l kubernetes.io/service-name=web-stable -o yaml
linkerd diagnostics policy -n route-demo svc/web 80 -o json
linkerd viz stat deploy/client -n route-demo --to svc/web
linkerd viz stat pods -n route-demo
Inspeccione las condiciones Accepted/ResolvedRefs de la ruta, la política real del controlador y el tráfico real de los clientes. Una vista de la política del controlador no demuestra que todos los proxies ya la hayan aplicado.
Cabeceras y rutas
Lo siguiente es una sustitución alternativa de web-route, que añade una cabecera de cohorte canary antes de la regla predeterminada ponderada:
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: web-route
  namespace: route-demo
spec:
  parentRefs:
  - group: ''
    kind: Service
    name: web
    port: 80
  rules:
  - matches:
    - headers:
      - name: x-release-track
        type: Exact
        value: canary
    backendRefs:
    - name: web-canary
      port: 80
  - backendRefs:
    - name: web-stable
      port: 80
      weight: 90
    - name: web-canary
      port: 80
      weight: 10
Los valores de las cabeceras no son identidades autenticadas. Un cliente no confiable puede establecer x-release-track o x-debug; utilice una autorización independiente para los backends privilegiados o de depuración. La coincidencia exacta con Cookie:beta=true solo coincide con ese valor completo de cabecera, no con cualquier aparición de una cookie entre otros pares de cookies. Normalice una señal de cohorte autorizada o implemente un análisis deliberado de cookies, en lugar de atribuir una semántica general de cookies a una coincidencia exacta de cabecera.
Un ejemplo de enrutamiento por ruta para Services preparados por separado:
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: frontend-paths
  namespace: route-demo
spec:
  parentRefs:
  - group: ''
    kind: Service
    name: frontend
    port: 80
  rules:
  - matches:
    - path:
        type: PathPrefix
        value: /api
    backendRefs:
    - name: api-service
      port: 80
  - matches:
    - path:
        type: PathPrefix
        value: /static
    backendRefs:
    - name: static-service
      port: 80
  - backendRefs:
    - name: web-stable
      port: 80
Las coincidencias dentro de una entrada se combinan con AND; las entradas o reglas alternativas y las rutas en competencia siguen la precedencia de Gateway API. No suponga que el orden en el archivo por sí solo resuelve los conflictos entre distintos objetos HTTPRoute.
Reintentos y tiempos de espera
Los reintentos son un comportamiento de salida que se activa explícitamente, no una garantía automática de recuperación de las solicitudes fallidas. Úselos solo cuando repetir la operación real sea seguro. Un reinicio de conexión, error o tiempo de espera agotado puede dejar desconocido el resultado de una escritura en el servidor; la idempotencia de la aplicación y los reintentos del cliente requieren controles independientes.
Para un Service api existente en retry-demo, este par configura reintentos solo para GET /api/read y sus rutas descendientes, con una alternativa de reenvío para las demás solicitudes:
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: api-read
  namespace: retry-demo
  annotations:
    retry.linkerd.io/http: gateway-error
    retry.linkerd.io/limit: '2'
    retry.linkerd.io/timeout: 400ms
    timeout.linkerd.io/request: 2s
spec:
  parentRefs:
  - group: ''
    kind: Service
    name: api
    port: 80
  rules:
  - matches:
    - method: GET
      path:
        type: PathPrefix
        value: /api/read
    backendRefs:
    - name: api
      port: 80
---
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: api-default
  namespace: retry-demo
spec:
  parentRefs:
  - group: ''
    kind: Service
    name: api
    port: 80
  rules:
  - matches:
    - path:
        type: PathPrefix
        value: /
    backendRefs:
    - name: api
      port: 80
Este ejemplo requiere que no haya anotaciones de reintento en el Service padre, que no haya un ServiceProfile en conflicto y que no estén habilitadas modificaciones de políticas por solicitud provenientes de fuentes no confiables. De lo contrario, la alternativa puede heredar una política de reintentos. Inspeccione la política efectiva y mida las solicitudes de escritura por separado; reenviar una escritura no demuestra que todas las capas hayan deshabilitado los reintentos.
Las anotaciones configuran como máximo dos reintentos (hasta tres intentos), un tiempo de espera de reintento de 400ms y uno de 2s para la solicitud completa. El plazo de la solicitud incluye el presupuesto de intentos y puede terminar la operación antes de que se efectúen todos los reintentos. En la referencia actual, las solicitudes con cuerpos mayores de 64KiB no se reintentan.
No use retry.linkerd.io/limit:"0" como interruptor de desactivación en edge-26.9.1. Consulte el analizador de la versión publicada. Ese analizador filtra el cero y lo convierte en un valor no especificado; si hay condiciones de reintento, recurre a un reintento. Una cadena vacía de condiciones de reintento HTTP tampoco es una política compatible para impedir reintentos. Mantenga los valores predeterminados de los Services con métodos mixtos libres de configuración de reintentos y adjunte políticas de activación explícita solo a las rutas de lectura previstas.
Las anotaciones de reintento de la ruta anulan en conjunto la configuración de reintentos del Service, y las anotaciones de tiempo de espera de la ruta anulan de forma similar las del Service. Los ServiceProfiles tienen prioridad sobre estas anotaciones. Linkerd puede respetar opcionalmente las cabeceras l5d-* por solicitud cuando se habilita explícitamente; no acepte modificaciones de políticas de clientes no confiables ni trate esas cabeceras como autenticación.
Alcance del plazo
| Configuración | Alcance |
|---|---|
| timeout.linkerd.io/request | Flujo completo de solicitud/respuesta |
| timeout.linkerd.io/response | Duración de la respuesta del backend en curso |
| timeout.linkerd.io/idle | Inactividad del flujo |
| retry.linkerd.io/timeout | Tiempo de espera de un intento reintentable, sujeto a la política y al límite de reintentos |
| Tiempo de espera de ruta de ServiceProfile | Espera total de la ruta heredada, incluidos los reintentos |
Los tiempos de espera ordinarios de solicitud, respuesta e inactividad no son el tiempo de espera de reintento. Un tiempo de espera agotado no demuestra la cancelación del trabajo de negocio. Una vez iniciado el envío de las cabeceras o el cuerpo de la respuesta, un fallo puede terminar o reiniciar un flujo en vez de generar una nueva respuesta de error HTTP.
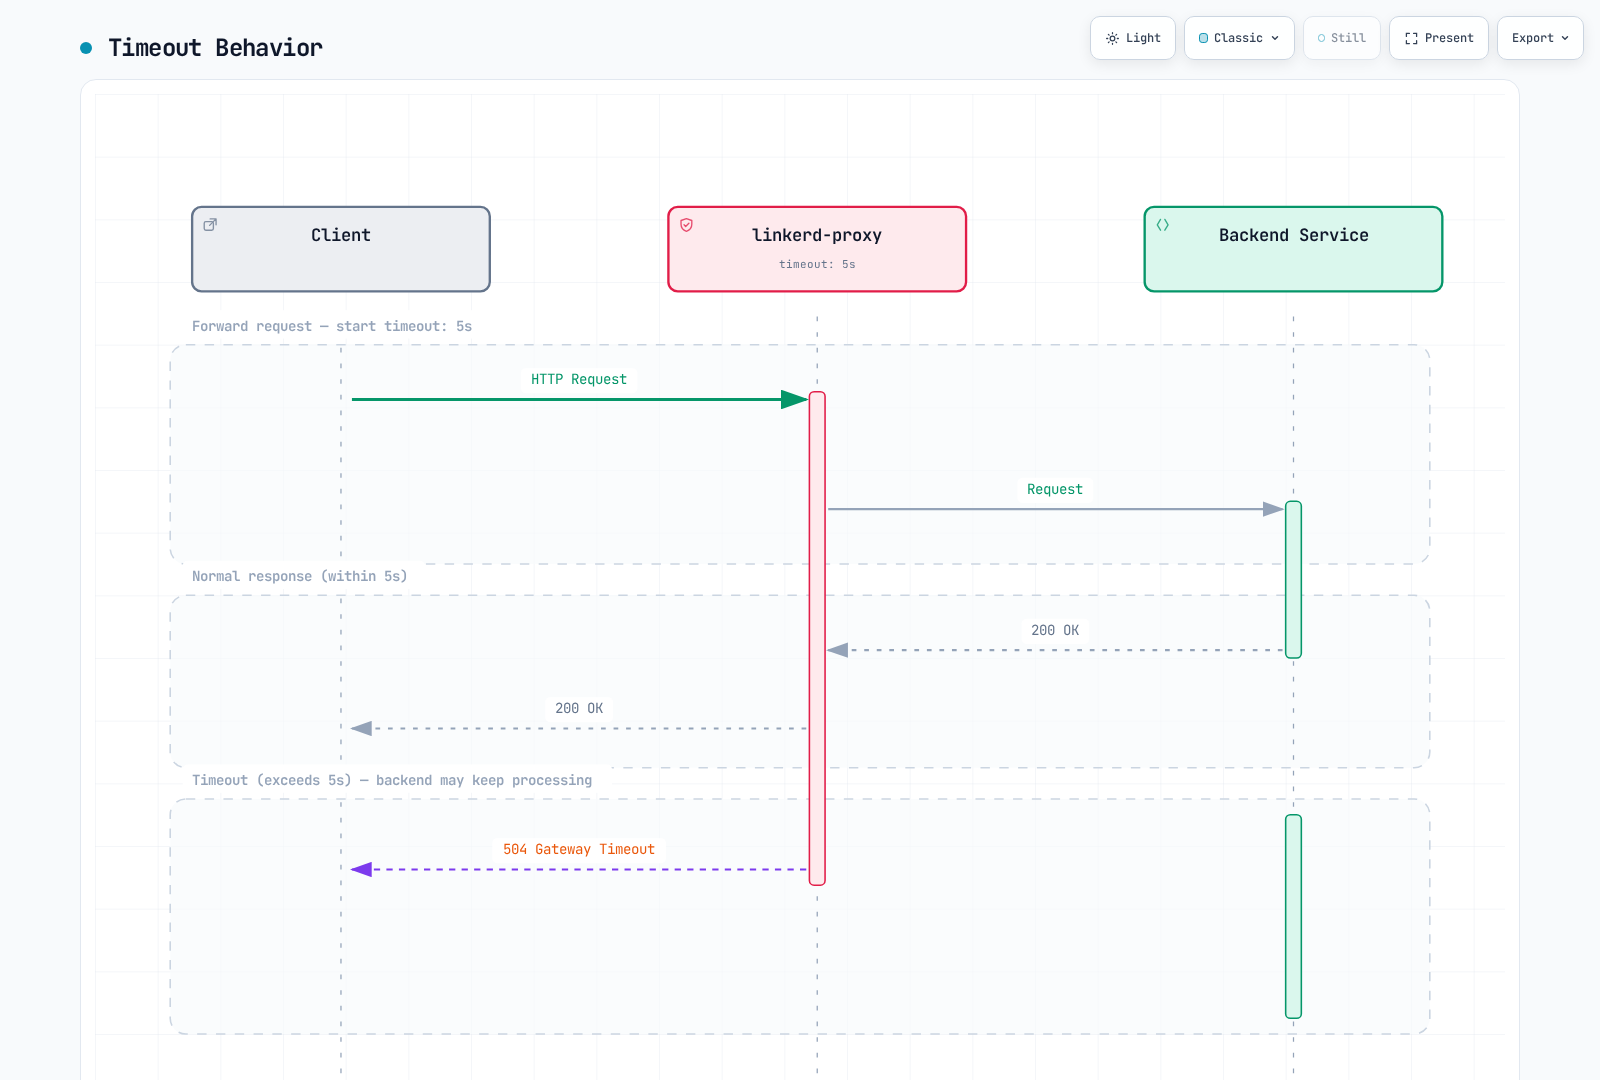
No prescriba valores de 5/60/600 segundos basándose únicamente en etiquetas como «síncrono», «asíncrono» o «carga de archivos». Parta del plazo de extremo a extremo de la aplicación, del comportamiento de procesamiento o transmisión esperado y de la semántica de cancelación del cliente y el servidor. Omitir un tiempo de espera de una política no elimina otros límites de la aplicación, el transporte, el proxy o el balanceador de carga.
ServiceProfiles: configuración de compatibilidad admitida
Los ServiceProfiles siguen siendo compatibles, pero la configuración de Gateway API los ha sustituido para el desarrollo de nuevas funciones. Este ejercicio independiente de profile-demo ilustra una coincidencia válida de rutas heredadas y la exclusión explícita de reintentos para escrituras:
apiVersion: linkerd.io/v1alpha2
kind: ServiceProfile
metadata:
  name: api.profile-demo.svc.cluster.local
  namespace: profile-demo
spec:
  routes:
  - name: read-users
    condition:
      all:
      - method: GET
      - pathRegex: ^/api/users(/.*)?$
    isRetryable: true
    timeout: 5s
  - name: write-api
    condition:
      all:
      - any:
        - method: POST
        - method: PUT
        - method: PATCH
        - method: DELETE
      - pathRegex: ^/api/.*$
    isRetryable: false
    timeout: 10s
  - name: health
    condition:
      all:
      - method: GET
      - pathRegex: ^/(health|ready|live)$
    isRetryable: false
    timeout: 1s
  - name: stream
    condition:
      all:
      - method: GET
      - pathRegex: ^/stream$
    isRetryable: false
  retryBudget:
    retryRatio: 0.2
    minRetriesPerSecond: 10
    ttl: 10s
method es un método HTTP exacto, no una expresión regular. POST|PUT|DELETE no es una unión de métodos. Use condiciones any/all explícitas o rutas independientes, incluido PATCH cuando corresponda. La selección de rutas y la clasificación de respuestas deben ajustarse a la aplicación; un indicador retryable configurado es una afirmación de seguridad del operador, no una prueba automática de idempotencia.
isRetryable:false deshabilita este mecanismo de ServiceProfile para la ruta coincidente. No impide que un SDK, un cliente u otro intermediario reintente. La ruta de transmisión omite un tiempo de espera del perfil; eso significa que este campo no impone un tiempo de espera, no que la operación de extremo a extremo sea ilimitada.
Presupuesto de reintentos
retryRatio:0.2 aporta una asignación proporcional de reintentos. minRetriesPerSecond:10 añade una asignación independiente, por lo que esto no es un límite estricto del 20% con poco tráfico. ttl es la ventana retrospectiva o de retención para calcular el presupuesto, no un temporizador de reinicio periódico. Los reintentos reales también dependen de la elegibilidad de la ruta, la clasificación de respuestas, el almacenamiento en búfer, los plazos y los endpoints disponibles.
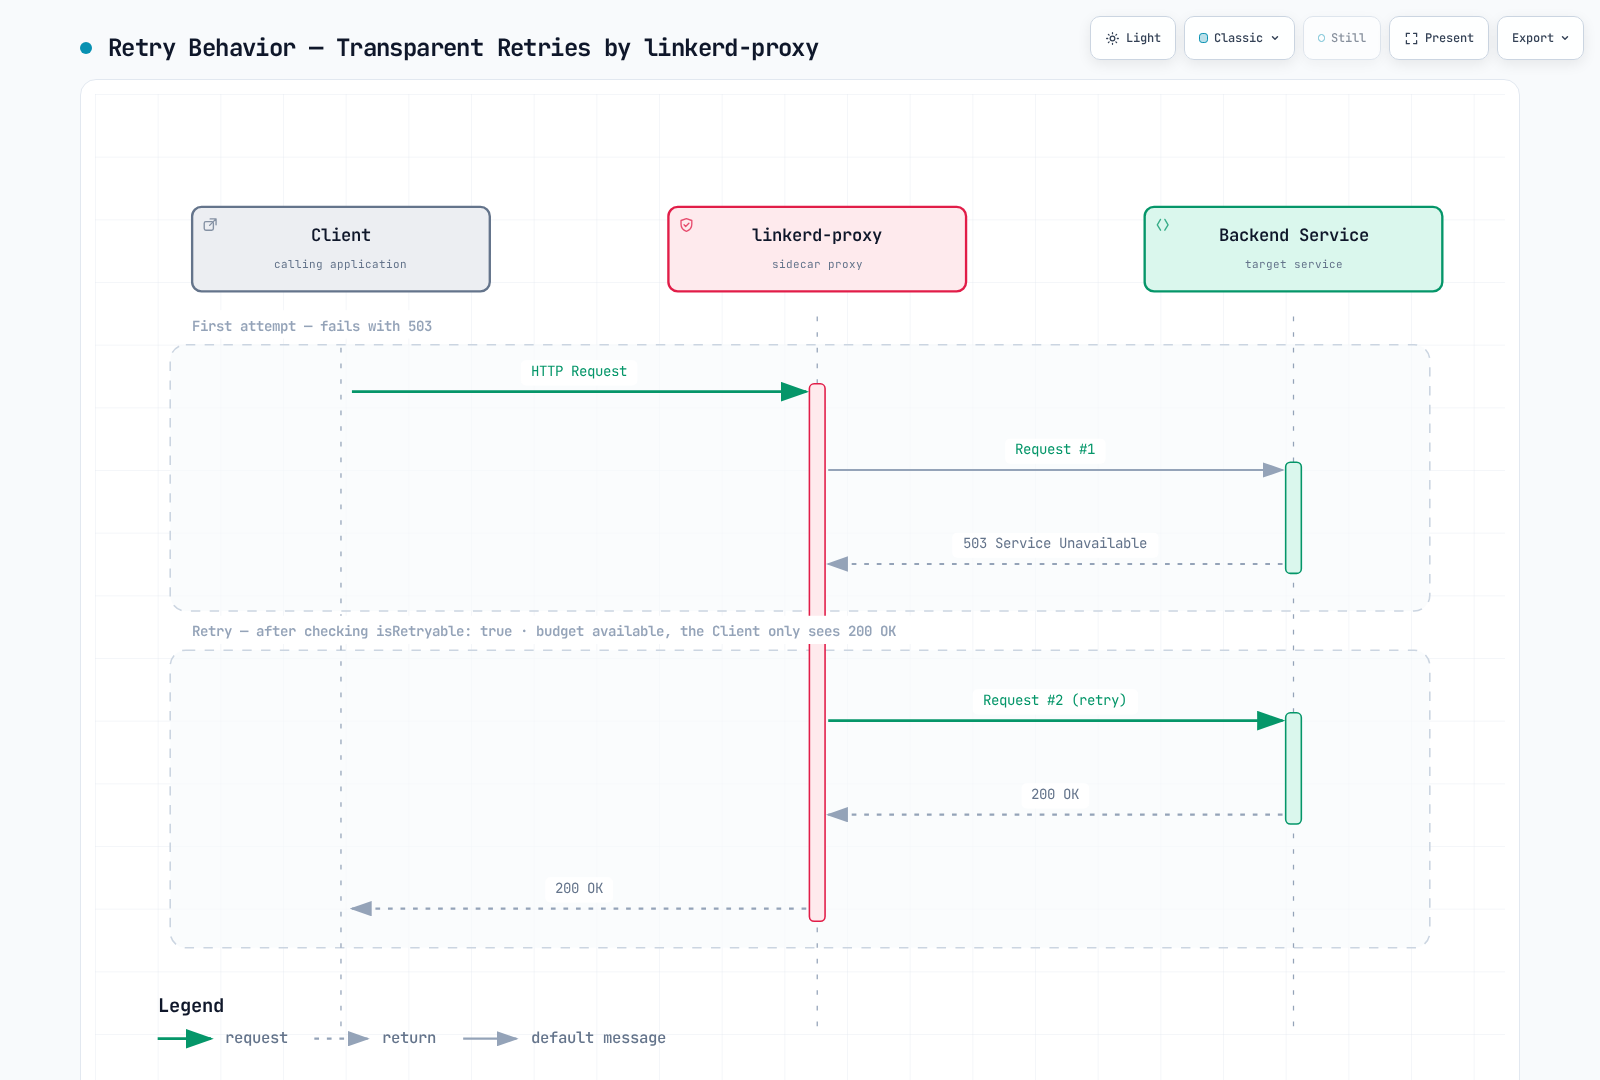
Observe por separado los intentos fallidos sin procesar, las entregas adicionales al servidor de destino y los resultados finales. La imagen es un ejemplo de reintento exitoso, no una promesa de ocultar todos los fallos.
Generación y observación de perfiles
# SERVICE is the short Service name; the CLI adds the namespace/domain.
linkerd profile -n profile-demo --open-api swagger.yaml api > api-openapi-profile.yaml
linkerd profile -n profile-demo --proto service.proto api > api-proto-profile.yaml
# Requires actual Viz tap traffic; the final Service argument is mandatory.
linkerd viz profile -n profile-demo api --tap deploy/api --tap-duration 60s \
  > api-observed-profile.yaml
# For offline generation with default assumptions, use --ignore-cluster.
La CLI nativa requiere un nombre corto de Service; el argumento original con nombre completo se rechaza. El comando tap también requiere su argumento final de Service. La salida de OpenAPI/protobuf/tap necesita revisión: el tráfico observado no es un inventario completo de rutas, y las rutas generadas pueden crear métricas de alta cardinalidad. La generación no demuestra que sea seguro reintentar todas las operaciones.
linkerd viz routes service/api -n profile-demo -o wide
linkerd viz routes deploy/client -n profile-demo --to svc/api -o wide
linkerd viz stat deploy/client -n profile-demo --to svc/api
viz routes es la vista de rutas orientada a ServiceProfile. Use la salida wide/JSON de la versión real y las métricas documentadas; la antigua fila inventada [RETRIES] y un campo de nivel superior .success_rate supuesto no son una interfaz fiable para la automatización.
Balanceo de carga y acumulación de fallos
Linkerd utiliza un comportamiento EWMA que tiene en cuenta la latencia para las solicitudes HTTP; TCP se balancea por conexión. Esto favorece a los candidatos sanos y rápidos, pero no implica que cada solicitud seleccione de forma determinista la puntuación mostrada globalmente más baja. Las estadísticas por Pod y de origen a Service miden agregaciones diferentes.
Activación explícita del disyuntor
La acumulación actual de fallos HTTP está deshabilitada salvo que se configure en el Service. Es incompatible con un ServiceProfile para ese Service. Para cargas de trabajo api preparadas en un namespace circuit-demo independiente:
apiVersion: v1
kind: Service
metadata:
  name: api
  namespace: circuit-demo
  annotations:
    balancer.linkerd.io/failure-accrual: consecutive
    balancer.linkerd.io/failure-accrual-consecutive-max-failures: '7'
    balancer.linkerd.io/failure-accrual-consecutive-min-penalty: 1s
    balancer.linkerd.io/failure-accrual-consecutive-max-penalty: 1m
spec:
  selector:
    app: api
  ports:
  - name: http
    port: 80
    targetPort: 8080
    appProtocol: http
El umbral predeterminado de la política consecutive es 7, no cinco fallos de conexión automáticos. Hace seguimiento de los fallos de respuesta HTTP/gRPC compatibles; no es una afirmación genérica sobre todos los errores de conexión TCP. La versión seleccionada también documenta una política unified con tratamiento de la tasa de éxito y la limitación de solicitudes; revise sus parámetros independientes antes de usarla.
| Estado | Significado |
|---|---|
| Disponible | El balanceador de carga puede seleccionar el endpoint |
| No disponible | Las solicitudes ordinarias se dirigen a otro lugar cuando es posible |
| En prueba | Se permite que una solicitud real de la aplicación compruebe la recuperación tras la espera de retroceso |
El estado de prueba no genera periódicamente sondas de salud de Kubernetes. Sin tráfico apto de la aplicación, una comprobación /ready exitosa por sí sola no restablece el endpoint. La espera de retroceso incluye los tiempos configurados y variación aleatoria. Si fallan todos los endpoints utilizables, las solicitudes pueden seguir fallando o puede seleccionarse otro backend configurado.
linkerd diagnostics policy -n circuit-demo svc/api 80 -o json
linkerd viz stat pods -n circuit-demo
linkerd viz stat deploy/client -n circuit-demo --to svc/api
Inspeccione la política real y los resultados, no solo la disponibilidad de los Pods o el éxito agregado. La métrica outbound_http_balancer_endpoints distingue los recuentos de endpoints ready/pending; pending no es exclusivamente un diagnóstico de acumulación de fallos.
TrafficSplit y SMI heredados
TrafficSplit y linkerd-smi están obsoletos y requieren su extensión y sus CRDs independientes. Una instalación ordinaria actual de Linkerd no proporciona ese flujo de trabajo por el mero hecho de aplicar un YAML de TrafficSplit. Prefiera el enrutamiento compatible de Gateway API para trabajos nuevos y planifique la migración de una instalación SMI existente.
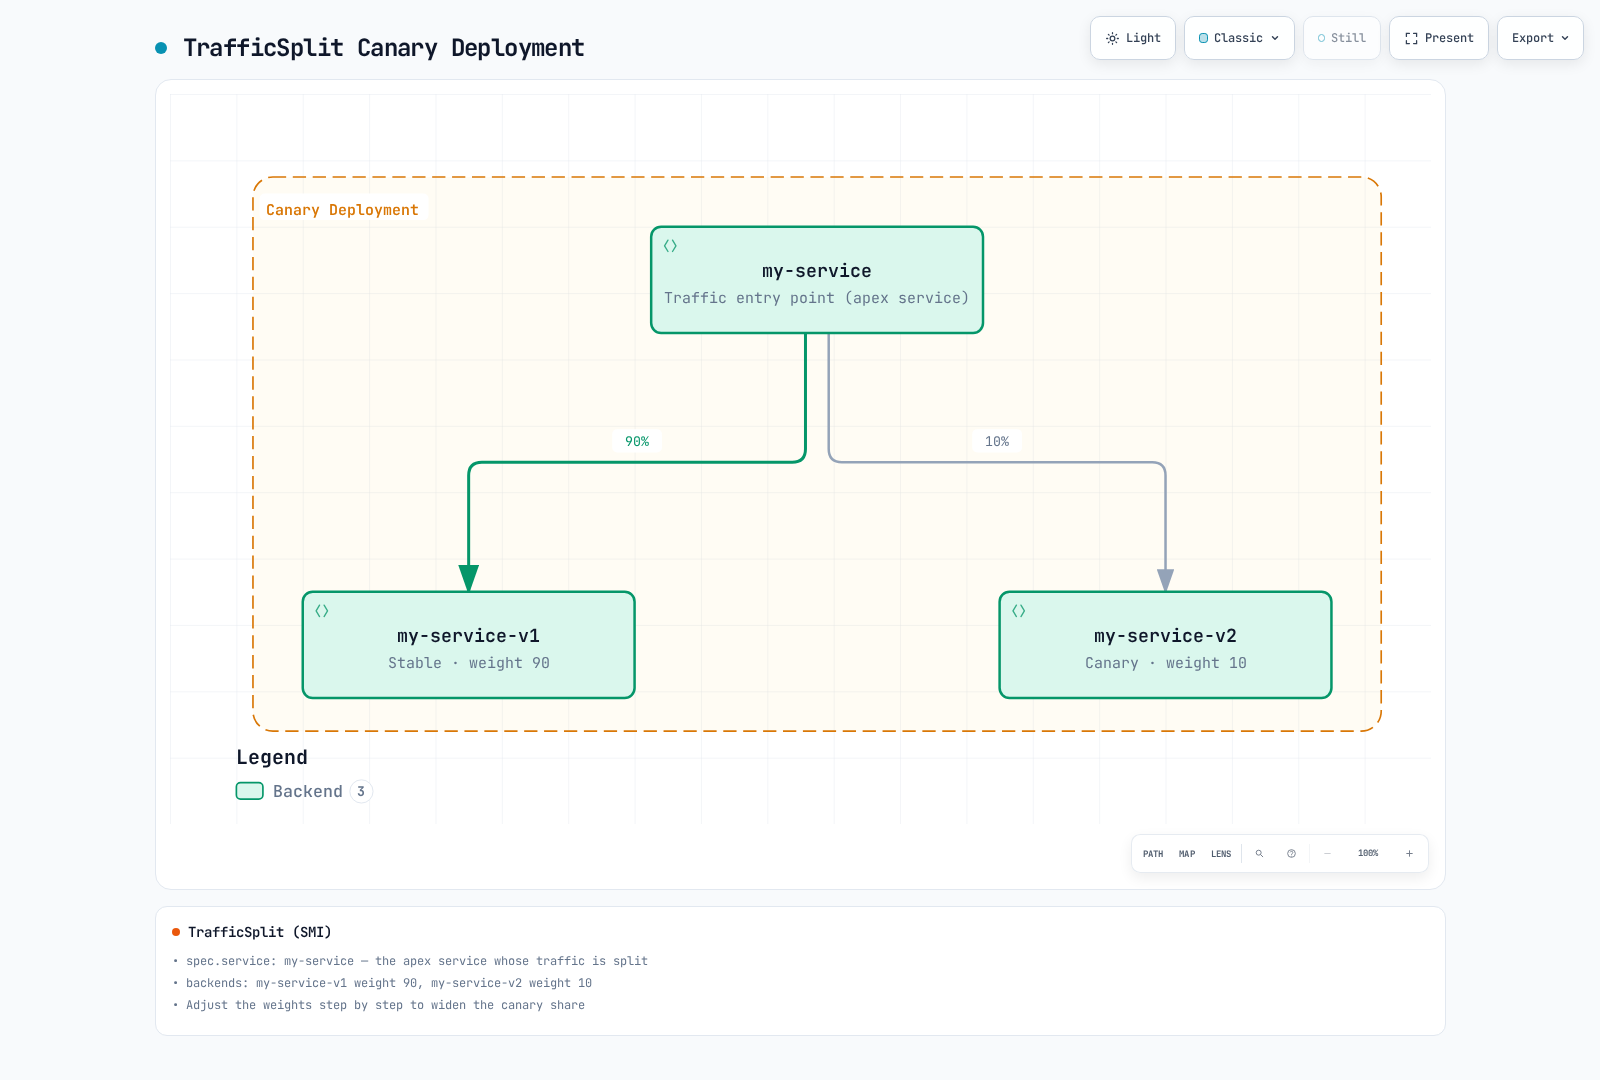
El campo service del recurso heredado nombra un Service de entrada, y los backends contienen pesos relativos. Esto resulta útil para reconocer una configuración existente, pero los ejemplos activos anteriores usan HTTPRoute. Los selectores de Service siguen siendo importantes para el tráfico ajeno a la malla o alternativo; un selector del Service de entrada no debe exponer accidentalmente Pods canary a clientes fuera de la política de tráfico.
Para los cambios manuales progresivos, revise cada etapa configurada —como 99/1, 90/10 y 50/50— frente a pruebas reales de tráfico, errores y latencia. No aplique varios recursos con el mismo nombre en un archivo suponiendo que ejecutan un despliegue temporizado; prevalece el último estado aplicado.
Reversión manual explícita
Solo para el ejemplo route-demo gestionado manualmente, guarde lo siguiente como web-stable-only.yaml para definir el estado que utiliza únicamente la versión estable:
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: web-route
  namespace: route-demo
spec:
  parentRefs:
  - group: ''
    kind: Service
    name: web
    port: 80
  rules:
  - backendRefs:
    - name: web-stable
      port: 80
      weight: 100
    - name: web-canary
      port: 80
weight: 0# Review the target context and this manually owned route before applying.
kubectl apply -f web-stable-only.yaml
kubectl -n route-demo get httproute web-route -o yamlVerifique la aceptación del controlador, los endpoints estables listos y los resultados reales de los clientes después del cambio. El antiguo bucle de shell imprimía «Revirtiendo» y después solo salía del bucle; nunca restauraba los pesos. También carecía de un tratamiento fiable de la falta de datos y los errores. Use un controlador de entrega real para la automatización y no sobrescriba manualmente una ruta gestionada por Flagger al margen de ese controlador.
Entrega progresiva con Flagger
Versión del controlador y responsabilidad de gestión
Este esquema utiliza Flagger/chart 1.45.0, la instalación seleccionada de Linkerd/Gateway API y un Prometheus de Linkerd Viz existente. La factoría publicada sigue asociando meshProvider:linkerd al enrutador SMI. Use gatewayapi:v1 para el enrutador HTTPRoute actual; una cadena de proveedor sin versión o no relacionada no es equivalente.
Guarde como flagger-values.yaml:
image:
  tag: 1.45.0
meshProvider: gatewayapi:v1
metricsServer: http://prometheus.linkerd-viz.svc.cluster.local:9090
crd:
  create: true
prometheus:
  install: false
podAnnotations:
  linkerd.io/inject: enabled
linkerdAuthPolicy:
  create: true
namespace: linkerd-vizhelm repo add flagger https://flagger.app
helm repo update flagger
helm template flagger flagger/flagger --version 1.45.0 \
-n flagger-system -f flagger-values.yaml > flagger-rendered.yaml
# Review existing CRD ownership, RBAC, injection and Prometheus access first.
helm upgrade --install flagger flagger/flagger --version 1.45.0 \
-n flagger-system --create-namespace -f flagger-values.yaml \
--wait --timeout 10mEl chart crea los CRDs de Flagger solo cuando se solicita. Revise la responsabilidad de gestión existente antes de habilitar crd.create. El Pod del controlador pertenece a la malla, y la autorización de Linkerd apunta al Server prometheus-admin existente de Viz con el ServiceAccount del controlador. Los despliegues externos de Prometheus necesitan su propio diseño de recopilación de métricas, identidad/autenticación y autorización.
Esquema de aplicación y análisis
Prepare un Deployment web existente en progressive-demo, con un puerto HTTP 8080 declarado, comprobaciones de disponibilidad operativas, imágenes probadas y capacidad suficiente. Aplicar un Canary delega en Flagger el ciclo de vida del despliegue y los Services: crea un Deployment primario y Services de entrada, primario y canary, y puede reducir el destino original a cero entre análisis. Esto difiere de los Deployments estables y canary gestionados manualmente antes.
El cliente debe pertenecer a la malla para utilizar un HTTPRoute con un Service como padre. Use tráfico controlado hacia el Service de entrada para validar el enrutamiento. La carga directa al Service canary es útil para probar esa versión, pero elude la decisión ponderada del Service de entrada.
apiVersion: v1
kind: Namespace
metadata:
  name: progressive-demo
  annotations:
    linkerd.io/inject: enabled
---
apiVersion: flagger.app/v1beta1
kind: Canary
metadata:
  name: web
  namespace: progressive-demo
spec:
  provider: gatewayapi:v1
  targetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: web
  progressDeadlineSeconds: 600
  service:
    port: 80
    targetPort: 8080
    gatewayRefs:
    - group: ''
      kind: Service
      name: web
      namespace: progressive-demo
      port: 80
  analysis:
    interval: 30s
    threshold: 5
    maxWeight: 50
    stepWeight: 10
    metrics:
    - name: linkerd-completed-responses
      templateRef:
        name: completed-responses
        namespace: progressive-demo
      thresholdRange:
        min: 20
      interval: 1m
    - name: linkerd-http-availability
      templateRef:
        name: http-availability
        namespace: progressive-demo
      thresholdRange:
        min: 99
        max: 100
      interval: 1m
    - name: linkerd-ttfb-p99-ms
      templateRef:
        name: ttfb-p99-ms
        namespace: progressive-demo
      thresholdRange:
        min: 0
        max: 500
      interval: 1m
gatewayRefs apunta deliberadamente a un Service, y el enrutador v1 del controlador conserva esa referencia al padre. Ningún ServiceProfile debe prevalecer sobre estas rutas generadas. No otorgue a otro controlador ni a un bucle manual la gestión del mismo HTTPRoute.
threshold:5 es el umbral de comprobaciones fallidas, maxWeight:50 es el techo de tráfico canary durante el análisis y stepWeight:10 es el incremento en puntos porcentuales. No significan cinco comprobaciones exitosas obligatorias ni 50 fallos permitidos. La reversión se produce mediante reconciliación tras alcanzar el umbral registrado de fallos u otra condición de fallo; no es una garantía instantánea.
Plantillas explícitas de métricas de Linkerd
Cree estos MetricTemplates antes de habilitar el análisis del Canary. Sus nombres de métricas personalizados evitan los observadores integrados request-success-rate/request-duration específicos del proveedor, que no son intercambiables con esta configuración del enrutador de Gateway API.
apiVersion: flagger.app/v1beta1
kind: MetricTemplate
metadata:
  name: completed-responses
  namespace: progressive-demo
spec:
  provider:
    type: prometheus
    address: http://prometheus.linkerd-viz.svc.cluster.local:9090
  query: sum(increase(response_total{namespace="{{ namespace }}",deployment="{{ target }}",direction="inbound"}[{{
    interval }}]))
---
apiVersion: flagger.app/v1beta1
kind: MetricTemplate
metadata:
  name: http-availability
  namespace: progressive-demo
spec:
  provider:
    type: prometheus
    address: http://prometheus.linkerd-viz.svc.cluster.local:9090
  query: |-
    (100 * (sum(rate(response_total{namespace="{{ namespace }}",deployment="{{ target }}",direction="inbound",classification="success"}[{{ interval }}])) or vector(0)) / sum(rate(response_total{namespace="{{ namespace }}",deployment="{{ target }}",direction="inbound"}[{{ interval }}])))
    and on() (sum(rate(response_total{namespace="{{ namespace }}",deployment="{{ target }}",direction="inbound"}[{{ interval }}])) > 0)
---
apiVersion: flagger.app/v1beta1
kind: MetricTemplate
metadata:
  name: ttfb-p99-ms
  namespace: progressive-demo
spec:
  provider:
    type: prometheus
    address: http://prometheus.linkerd-viz.svc.cluster.local:9090
  query: |-
    histogram_quantile(0.99,
      sum by (le) (rate(response_latency_ms_bucket{namespace="{{ namespace }}",deployment="{{ target }}",direction="inbound"}[{{ interval }}]))
    )
Las consultas suponen que la configuración de recopilación de Viz proporciona etiquetas namespace/deployment y seleccionan deliberadamente las respuestas de entrada completadas del Deployment de destino. Confirme esas etiquetas y series en el Prometheus real. Un backend compartido o federado necesita el alcance de clúster y la deduplicación adecuados; de lo contrario, podrían combinarse cargas de trabajo con nombres similares.
Las comprobaciones tienen objetivos diferentes:
- completed-responses exige al menos 20 respuestas completadas en la ventana retrospectiva. increase es una estimación extrapolada del contador, no un recuento exacto de un registro de auditoría. El contador incluye observaciones finalizadas o con errores; no cuenta operaciones de negocio exitosas ni solicitudes únicas de usuarios.
- http-availability devuelve 0 para una ventana en la que todo falla, aunque no exista ninguna serie de éxitos. Requiere un total positivo, por lo que el tráfico ausente o inactivo no se considera un estado sano al 100%.
- ttfb-p99-ms utiliza response_latency_ms, el histograma de tiempo hasta el primer byte de Linkerd, en milisegundos. No es la duración completa de la respuesta. El proxy publicado registra la latencia en el primer fragmento disponible del cuerpo de la respuesta, con una alternativa cuando se descarta el cuerpo; generalmente no espera a que termine todo el flujo. La clasificación y el recuento finales de respuestas son independientes, por lo que las muestras del histograma y del contador de respuestas no tienen por qué aparecer juntas.
Cada consulta se agrega a un único resultado. El proveedor de Prometheus publicado rechaza resultados vacíos y NaN; los límites inferior y superior explícitos de disponibilidad y latencia también impiden que valores infinitos superen esas comprobaciones. Estos ejemplos no prometen identificar todo tipo de telemetría ausente u obsoleta mediante una sola consulta: verifique por separado la actualidad de los datos, la salud de la recopilación, las etiquetas del destino y la ventana de muestreo.
Tráfico, hooks y observación
Un tráfico sostenido y representativo es un requisito previo para un análisis significativo. El ejemplo no instala un generador de carga ni una aplicación. Los webhooks opcionales de aceptación previa al despliegue y de pruebas de carga durante el despliegue requieren un endpoint privado compatible desplegado por separado, una política de autenticación y red definida, ejecución limitada y semántica de prueba. No pegue una URL de webhook para un Service que nunca se haya creado.
kubectl -n progressive-demo get canary web
kubectl -n progressive-demo describe canary web
kubectl -n progressive-demo get httproute web -o yaml
kubectl -n progressive-demo get deployments,services
kubectl -n flagger-system logs deployment/flagger --tail=200
kubectl -n progressive-demo get events \
  --field-selector involvedObject.kind=Canary
Compruebe los Services web-primary/web-canary generados, el HTTPRoute de entrada, los endpoints activos, los eventos del controlador y los valores reales de las métricas. Una prueba directa al canary que muestra un estado sano no demuestra que el tráfico de entrada siga la distribución prevista.
La reversión cambia el enrutamiento posterior y el estado del despliegue; no puede deshacer escrituras ya confirmadas ni demostrar que las solicitudes en curso se hayan detenido. Defina por separado los procedimientos de recuperación de los datos de la aplicación y de los efectos secundarios.
Lista de comprobación operativa
- Mantenga explícita la responsabilidad del enrutamiento: HTTPRoute manual, Flagger o un controlador SMI heredado.
- Compruebe la precedencia de ServiceProfile antes de diagnosticar anotaciones de HTTPRoute que parezcan ignoradas.
- Mantenga los reintentos como una opción explícita para operaciones cuya repetición se haya verificado como segura, con plazos y pruebas de los intentos adicionales.
- Verifique tanto la política aceptada por el controlador como los resultados observados desde clientes de la malla.
- Supervise conjuntamente la disponibilidad de los endpoints, la latencia, los fallos sin procesar, los resultados finales y la disponibilidad de la telemetría.
- Trate la capacidad, la generación de carga, las imágenes de la aplicación y el comportamiento de reversión como requisitos previos específicos del entorno, no como garantías probadas en producción por este documento.
Referencias
- Referencia de HTTPRoute de Linkerd
- Reintentos y tiempos de espera
- ServiceProfiles
- Disyuntores
- Balanceo de carga
- División del tráfico y obsolescencia de SMI
- Métricas del proxy
- Implementación publicada del momento de registro de las métricas de respuesta
- Enrutador de Gateway API de Flagger 1.45.0
- Selección de proveedor de Flagger 1.45.0
- Evaluación de métricas de Flagger 1.45.0
- Cuestionario de gestión del tráfico