パート4: 性能とコストの調整
レビュー基準: 2026年9月12日 · upstream Spark 4.2.0 · Karpenter 1.14
範囲と測定
この章では、パート1の spark-submit 直接実行経路を使います。Spark 4.2には Kubernetes 1.34以降が必要です。EKS、kubectl、Karpenter の互換性も確認してください。パート2の Operator とパート3の EMR では、送信経路と Pod カスタマイズの方法が異なります。すべての設定をそのまま流用せず、レビューしてください。以下の値は小さく始めるための例であり、性能が最適になると測定された値ではありません。
Karpenter が Pending Pod を配置するために metrics-server は不要です。 Karpenter は Pod request と scheduling 制約を使います。metrics-server は使用状況の観測や、kubectl top/HPA のような利用元に役立ちますが、Spark task backlog を提供したり、EC2 を直接起動したりしません。
Spark UI/event log の stage/task 時間、spill、shuffle fetch wait、skew、GC、executor 喪失を、node の CPU、memory、disk、network 上限とあわせて測定します。ボトルネックを確認する前から、R-series や NVMe が常に速いと決めつけないでください。AQE、partitioning、join 戦略、data format を確認し、一度に1つの要素を変更してください。
1. Node と instance storage を選ぶ
以前の R5d/R5ad/R5dn の例は、利用可能な選択肢の一部に過ぎません。CPU、memory、disk、network の要求、現在の AZ capacity、総コストに応じて M/C/R/I family を比較します。R-series が shuffle に常に最適とは限らず、C-series が Spark に不向きというわけでもありません。
Graviton も Spark の評価対象として有効です。すでに multi-architecture 対応の検証済み image が利用できる場合があり、独自 image の build が常に必要なわけではありません。JNI、codec、BLAS、Python wheel、custom plugin の arm64 対応を確認します。以下の例は一貫した経路を示すため amd64 を選びますが、amd64 のほうが速いと主張するものではありません。
Nitro/NVMe だけでは disk が instance store かどうか判別できません。 Nitro 上では EBS も NVMe として公開されます。Mount されていない disk が空、または format して安全とは限りません。未 mount の NVMe device を format する古い loop は EBS/root device を誤認する可能性があり、削除しました。
2. AL2023 上で scratch storage を管理する
この lab の前に、管理者が次の2つの EC2NodeClass を準備します。
spark-general: Driver 用の、レビュー済み一般 node 設定。spark-nvme: Executor 専用の新しい class。Kubernetes release/architecture に合った固定済み AL2023 AMIと、適切な IAM/subnet/security-group 設定を含めます。
以下の field を完全な spark-nvme 設定に追加します。これは単独で kubectl apply する resource ではなく、fragment です。既存 NodeClass を変更すると drift と node 置換が発生する場合があります。稼働中の node で disk format を即興で実行しないでください。
spec:
  instanceStorePolicy: RAID0
AL2023 では、Karpenter が NodeConfig 経由で instance store の RAID0 を構成し、kubelet/containerd の ephemeral storage に使用します。Node allocatable capacity にも反映されます。これにより /dev/nvme1n1 に固定したり hostPath を要求したりせずに済みます。別の AMI family や独自 bootstrap では公式の手順に従ってください。
Instance store は一時的な scratch であり、stop、termination、failure で失われる可能性があります。RAID0 は replication や backup ではありません。EBS volume に別途料金は発生しませんが、instance 料金、idle capacity、再計算にはコストがかかります。適切なサイズの EBS も選択肢です。Volume と instance の throughput 上限を両方確認してください。すべての EKS node に20GBの root volume がある、または同じ backing filesystem を使うと考えないでください。
3. Driver は On-Demand、executor は Spot に配置する
On-Demand にすると driver が Spot 回収にさらされにくくなりますが、failure、maintenance、Karpenter の drift/expiration は防げません。Cluster mode と client mode のどちらでも driver の SparkContext/調整状態は重要です。Job の再実行と data recovery は別途設計してください。
2つの NodeClass を参照する nodepools.yaml として、次を保存します。Executor には instance-store capacity が必要です。この設定では Spot のみを使うため、Spot capacity が足りないと Pod は Pending のままで、自動的な On-Demand fallback はありません。必要に応じて明示的な fallback policy とコスト上限を設計してください。
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: spark-driver
spec:
  template:
    metadata:
      labels:
        workload-pool: spark-driver
    spec:
      requirements:
      - key: kubernetes.io/arch
        operator: In
        values:
        - amd64
      - key: kubernetes.io/os
        operator: In
        values:
        - linux
      - key: karpenter.sh/capacity-type
        operator: In
        values:
        - on-demand
      - key: karpenter.k8s.aws/instance-category
        operator: In
        values:
        - m
        - r
      - key: karpenter.k8s.aws/instance-generation
        operator: Gt
        values:
        - '5'
      taints:
      - key: spark-role
        value: driver
        effect: NoSchedule
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: spark-general
  limits:
    cpu: '64'
    memory: 512Gi
  disruption:
    consolidationPolicy: WhenEmpty
    consolidateAfter: 120s
---
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: spark-executor
spec:
  template:
    metadata:
      labels:
        workload-pool: spark-executor
    spec:
      requirements:
      - key: kubernetes.io/arch
        operator: In
        values:
        - amd64
      - key: kubernetes.io/os
        operator: In
        values:
        - linux
      - key: karpenter.sh/capacity-type
        operator: In
        values:
        - spot
      - key: karpenter.k8s.aws/instance-category
        operator: In
        values:
        - m
        - r
        - i
      - key: karpenter.k8s.aws/instance-generation
        operator: Gt
        values:
        - '5'
      - key: karpenter.k8s.aws/instance-local-nvme
        operator: Gt
        values:
        - '0'
      taints:
      - key: spark-role
        value: executor
        effect: NoSchedule
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: spark-nvme
  limits:
    cpu: '256'
    memory: 2048Gi
  disruption:
    consolidationPolicy: WhenEmpty
    consolidateAfter: 120s
Pool の label/selector は配置先を選び、toleration はその taint の許容を示します。Toleration は配置を強制するものではなく、ほかの Pod が同じ toleration を持つ場合もあります。NoSchedule は稼働中 Pod を退避させません。NodePool limit は最終的に整合する capacity guardrail です。並行 scale-out で一時的に超過する場合があり、厳密な支出上限ではありません。
driver-template.yaml として保存します。これは Spark が補完するSpark Pod template であり、単独の Pod deployment ではありません。
apiVersion: v1
kind: Pod
spec:
  securityContext:
    runAsNonRoot: true
    runAsUser: 185
    fsGroup: 185
  tolerations:
  - key: spark-role
    operator: Equal
    value: driver
    effect: NoSchedule
  containers:
  - name: spark-kubernetes-driver
    securityContext:
      allowPrivilegeEscalation: false
      capabilities:
        drop:
        - ALL
      seccompProfile:
        type: RuntimeDefault
    resources:
      requests:
        ephemeral-storage: 2Gi
      limits:
        ephemeral-storage: 4Gi
executor-template.yaml として保存します。
apiVersion: v1
kind: Pod
spec:
  securityContext:
    runAsNonRoot: true
    runAsUser: 185
    fsGroup: 185
  tolerations:
  - key: spark-role
    operator: Equal
    value: executor
    effect: NoSchedule
  containers:
  - name: spark-kubernetes-executor
    securityContext:
      allowPrivilegeEscalation: false
      capabilities:
        drop:
        - ALL
      seccompProfile:
        type: RuntimeDefault
    resources:
      requests:
        ephemeral-storage: 10Gi
      limits:
        ephemeral-storage: 20Gi
    volumeMounts:
    - name: spark-local-dir-scratch
      mountPath: /var/data/spark-local
  automountServiceAccountToken: false
  volumes:
  - name: spark-local-dir-scratch
    emptyDir:
      sizeLimit: 16Gi
この emptyDir は、準備した NVMe-backed kubelet filesystem を使います。別の node 設定では backing が異なる場合があります。Volume 名は末尾の hyphen と suffix を含めて spark-local-dir- で始まる必要があります。以前の名前 spark-local-dir は認識されず、同じ path に追加の emptyDir mount が作られる場合があります。
spark.local.dir だけを設定しても Kubernetes Spark がその場所に emptyDir を作成できるため、hostPath は不要です。認識された scratch mount は SPARK_LOCAL_DIRS に反映されます。sizeLimit は capacity の予約ではありません。先に node disk が枯渇する可能性があります。Request/limit、log、writable layer、disk pressure をあわせて観測してください。tmpfs は RAM を消費するため、memory budget に含める必要があります。
4. 2つの scaling loop と終了処理
パート1と同じ namespace/RBAC を再利用し、performance.properties として保存します。
spark.kubernetes.namespace=spark-jobs
spark.kubernetes.container.image=spark:4.2.0-scala2.13-java21-ubuntu
spark.kubernetes.authenticate.driver.serviceAccountName=spark-driver
spark.kubernetes.authenticate.executor.serviceAccountName=spark-executor
spark.kubernetes.driver.podTemplateFile=driver-template.yaml
spark.kubernetes.executor.podTemplateFile=executor-template.yaml
spark.kubernetes.driver.node.selector.workload-pool=spark-driver
spark.kubernetes.executor.node.selector.workload-pool=spark-executor
spark.kubernetes.driver.node.selector.karpenter.sh/capacity-type=on-demand
spark.kubernetes.executor.node.selector.karpenter.sh/capacity-type=spot
spark.driver.cores=1
spark.driver.memory=1g
spark.kubernetes.driver.limit.cores=1
spark.executor.cores=2
spark.executor.memory=4g
spark.kubernetes.executor.limit.cores=2
spark.executor.instances=2
spark.dynamicAllocation.enabled=true
spark.dynamicAllocation.shuffleTracking.enabled=true
spark.dynamicAllocation.minExecutors=1
spark.dynamicAllocation.initialExecutors=2
spark.dynamicAllocation.maxExecutors=10
spark.dynamicAllocation.executorIdleTimeout=60s
spark.kubernetes.allocation.batch.size=5
spark.kubernetes.allocation.batch.delay=1s
spark.decommission.enabled=true
spark.storage.decommission.enabled=true
spark.kubernetes.executor.terminationGracePeriodSeconds=120s# Prerequisite: Part 1's spark-jobs namespace and driver/executor RBAC.
# All template/property files below must be present in the submitter's working directory.
K8S_API_SERVER="$(kubectl config view --minify -o jsonpath='{.clusters[0].cluster.server}')"
: "${K8S_API_SERVER:?Select the intended Kubernetes context first}"
spark-submit \
--master "k8s://${K8S_API_SERVER}" --deploy-mode cluster \
--name spark-performance-smoke \
--properties-file performance.properties \
--class org.apache.spark.examples.SparkPi \
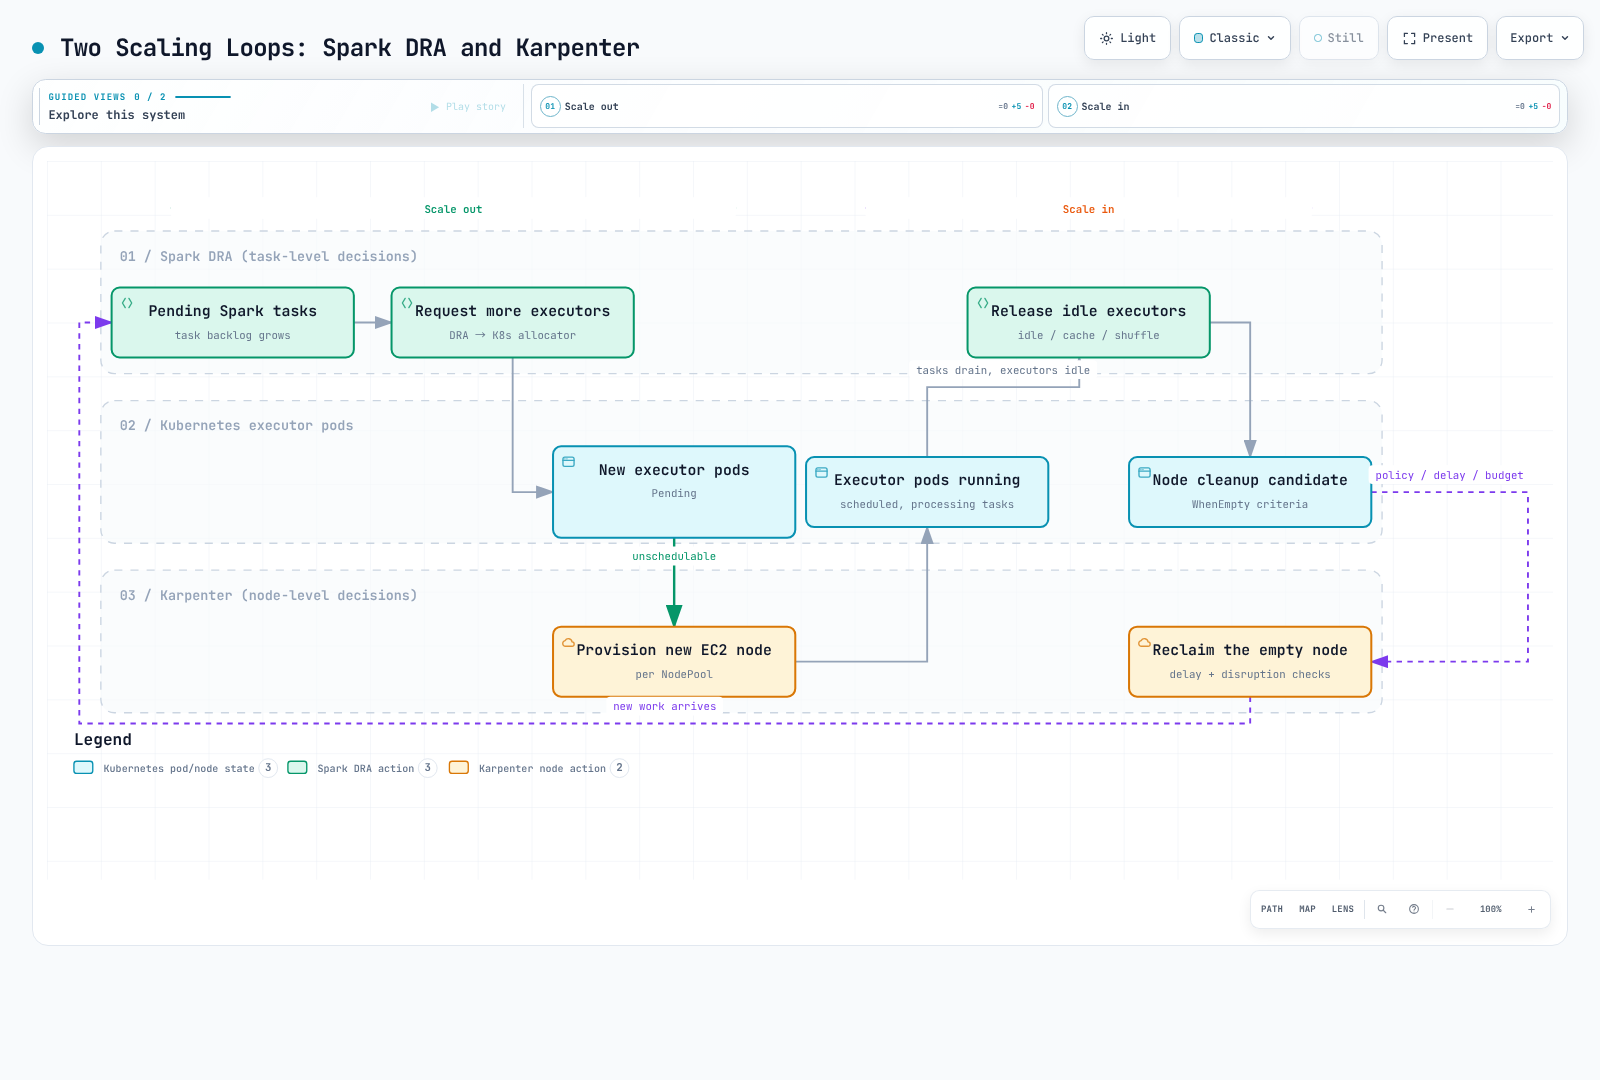
local:///opt/spark/examples/jars/spark-examples.jar 10Spark DRA は task backlog と idle/cache/shuffle 状態に基づいて executor 数を調整します。spark.kubernetes.allocation.batch.size と batch.delay は Kubernetes allocator の Pod 作成 rate を制御し、DRA 専用の設定ではありません。Karpenter はスケジュール不能な Pod の request と制約に応じて capacity を提供します。Image pull、IP/quota/AZ の不足、taint の不一致も Pod 遅延の原因です。
通常稼働する Spark Pod に対し、WhenEmpty と120秒を使うのは控えめな consolidation の初期設定です。Karpenter が empty と判定する状態には、DaemonSet のような disruption cost のない残存 Pod が含まれることがあります。Executor だけの node を empty と判断する前に、ほかの通常 workload も確認してください。
consolidateAfter > executorIdleTimeout としても、DRA が先に executor を解放する保証はありません。各 timer は異なる event から始まり、cached data/shuffle tracking により executor が長く保持されることもあります。Drift、expiration、Spot interruption は consolidation とは別の事象です。PDB、do-not-disrupt、disruption budget で Spot 回収を防ぐことはできません。
Decommission の実際の制限
Spot instance の stop/terminate 通知は通常2分前に届きますが、best effort です。Hibernation は2分間の通知なしで直ちに開始します。Karpenter の Spot 対応には EventBridge から SQS への接続、interruption queue、permission の設定が必要です。Spark flag だけでは AWS interruption 通知を受け取りません。
パート1で確認したように、Spark 4.2 の decommission flag は公式 image の /opt/decom.sh preStop を挿入します。実際の script、signal、Pod grace、node drain 経路を調べてください。spark.kubernetes.executor.terminationGracePeriodSeconds=120s は grace を要求しますが、残りの cloud instance lifetime や block 移行完了を保証しません。Lifecycle hook の上書きで挙動が変わることがあります。
移行には peer capacity、network、時間が必要です。Shuffle fallback には、正常に動作する filesystem/permission と、明示的に設定した spark.storage.decommission.fallbackStorage.path が必要です。任意の remote storage や History Server が自動的に fallback になるわけではありません。RDD cache と shuffle の recovery も異なります。再計算、繰り返しの喪失、fetch/task retry 上限、読めない source data により job が失敗することがあります。Executor の喪失が無害とは限りません。
5. Resource と cost を検証する
| 設定 | Kubernetes への影響 |
|---|---|
| Driver/executor memory | Heap と該当する overhead/その他の memory を request/limit に加える |
| Driver/executor cores | 既定の CPU request と Spark の役割ごとの concurrency。CPU limit は自動設定しない |
spark.kubernetes.*.request.cores | Explicit な CPU request。Task slot 数とは別 |
spark.kubernetes.*.limit.cores | Explicit な CPU limit |
| Template の ephemeral-storage | Scratch/log の一時 storage budget。Backing storage は node 設定による |
Heap 4g、既定の10% overhead を使う JVM executor では、整数変換後に409 MiB が加わり、合計は4505 MiBです。PySpark、off-heap、明示的な overhead 設定は別途考慮してください。4g は Pod 全体の memory ではありません。Driver が常に executor より大きい必要はなく、小さい executor が一律に優れるわけでもありません。
Instance の時間単価だけでなく、retry、idle capacity、storage/network、log を含む成功 job あたりの cost と p95 完了時間を比較してください。Executor preallocation など EMR runtime 固有の挙動は upstream と異なる場合があります。選択した release の設定を確認してください。
例は CRD と native Spark feature-step の構築方法に照らして検証しています。これは EC2 の provision、disk initialization、Spot interruption test、大規模 shuffle 性能 benchmark を実施したものではありません。