可観測性
対応バージョン: Istio 1.31 最終更新: September 11, 2026
Istioプロキシは観測通信のテレメトリーを生成します。メトリクス収集、アクセスログ、トレースprovider、保存の設定が必要です。スパンをつなぐにはアプリが受信/送信要求間でコンテキストを伝播します。内部スパンや例外にはアプリ計装/ログが必要です。
目次
可観測性概要
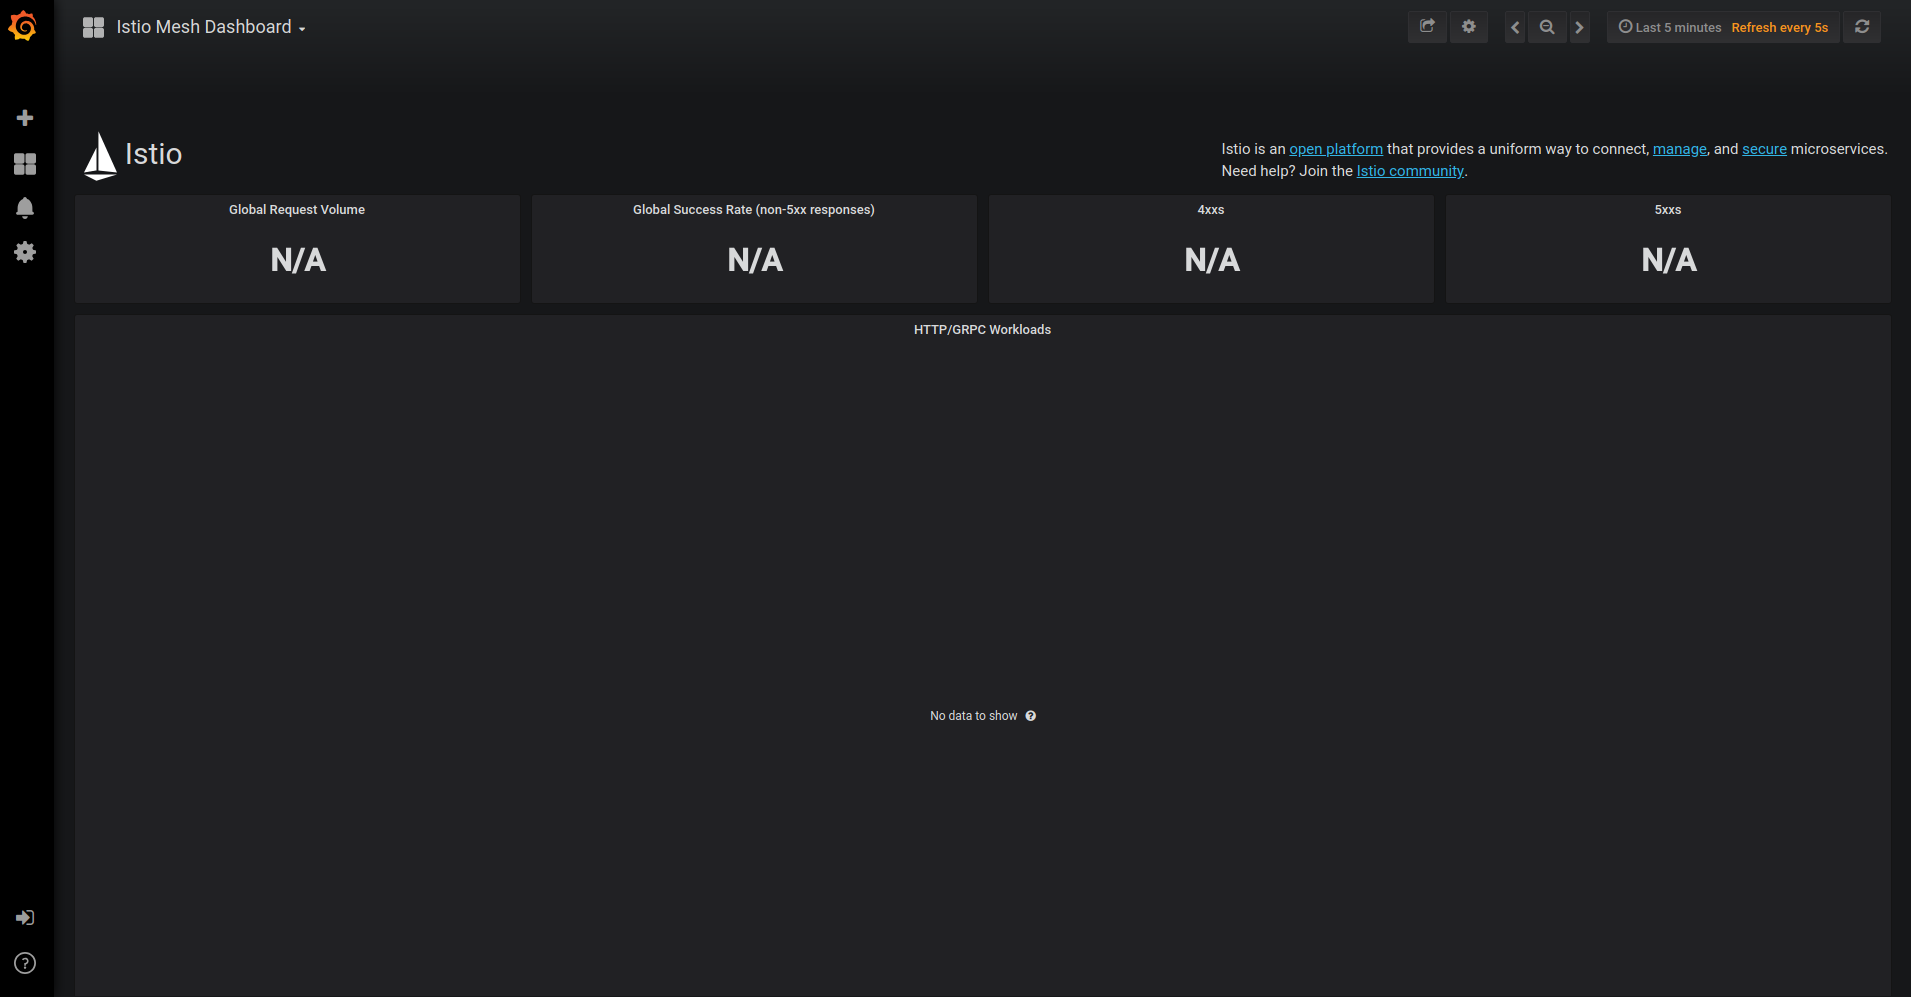
サイドカーとwaypointはアプリコードにプロキシ計装を加えずHTTPメトリクス、スパン、アクセスログを報告できます。Ambient ztunnelはL4を提供し、HTTP観測にはwaypointが必要です。CPU、メモリ、ホストのパケットメトリクスはIstio要求メトリクスでなくKubernetes/ノードエクスポーター由来です。画像は設定済みdashboardで、Istioと自動導入されるコンポーネントではありません。
可観測性の3本柱
可観測性の3要素
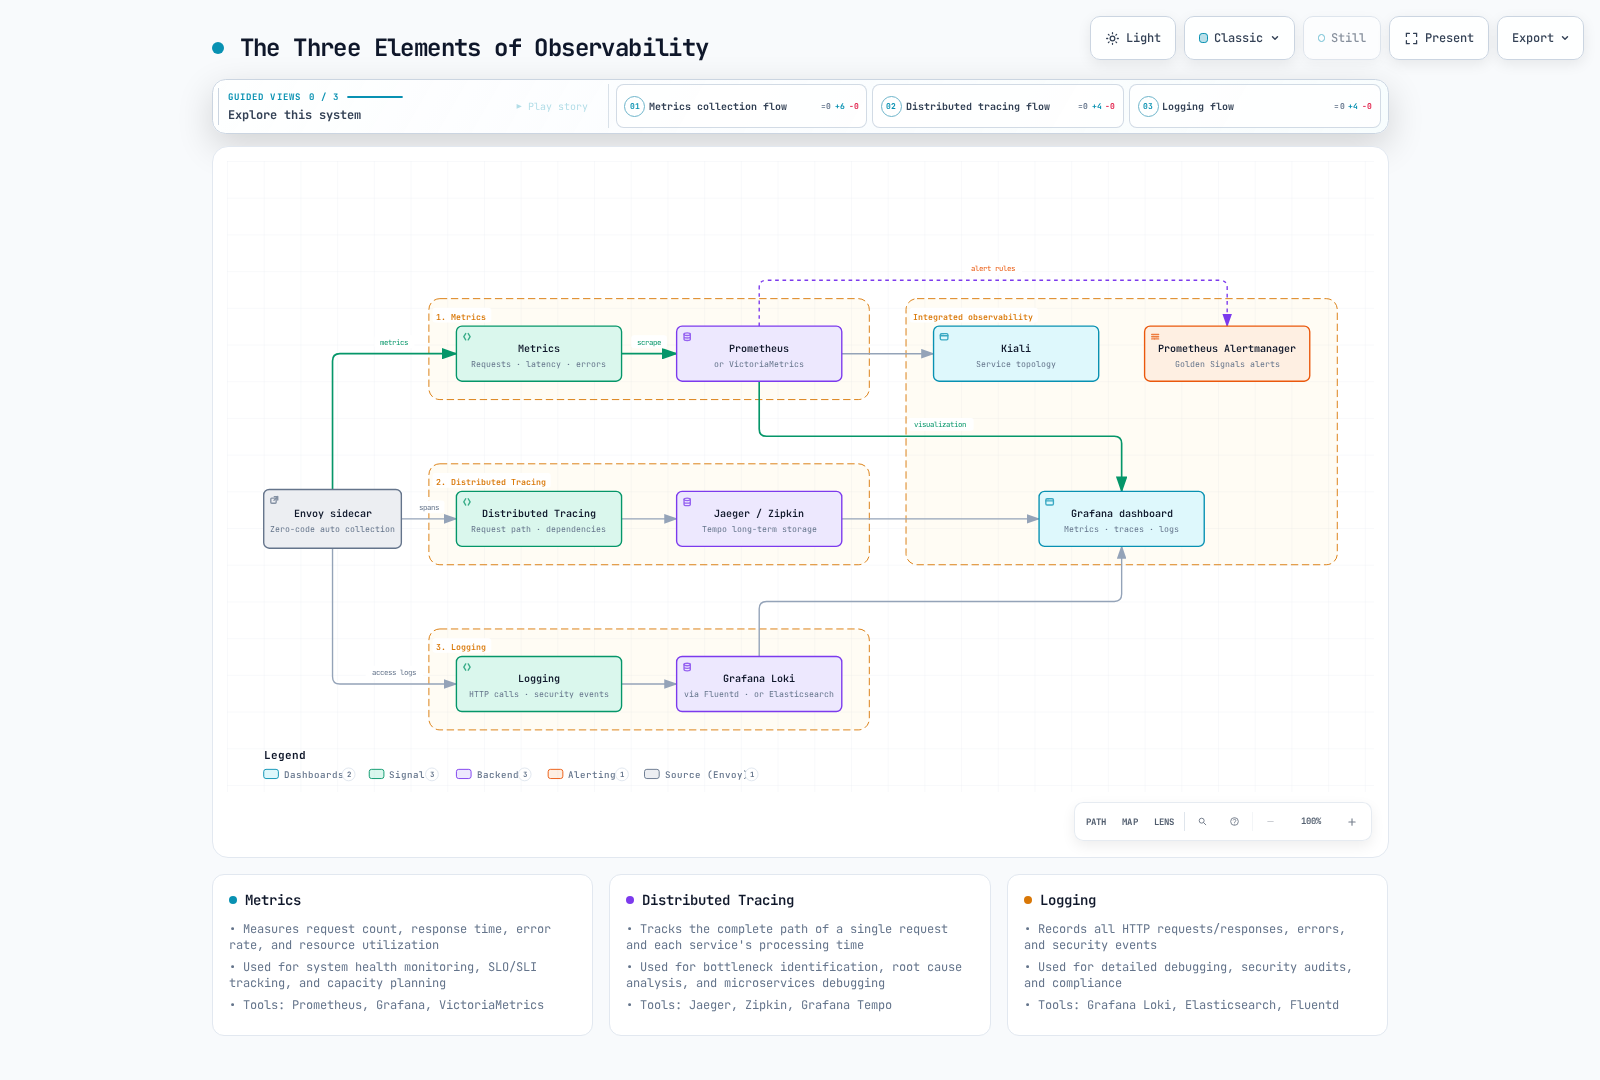
1. メトリクス
何を測定するか
- 要求数、応答時間、エラー率
- リソース使用率(CPU、メモリ)
- ネットワーク通信(バイト、パケット)
いつ使うか
- システム健全性監視
- SLO/SLI追跡
- 容量計画
主なツール: Prometheus、Grafana、VictoriaMetrics
2. 分散トレーシング
何を追跡するか
- 単一要求の全経路
- 各サービスの処理時間
- サービス依存関係
いつ使うか
- 性能ボトルネック特定
- 障害根本原因分析
- マイクロサービスのデバッグ
主なツール: Jaeger、Zipkin、Grafana Tempo
3. ログ記録
何を記録するか
- 設定したHTTPアクセスメタデータ(全要求/応答本文ではない)
- プロキシエラー。アプリ例外にはアプリログが必要
- セキュリティイベント
いつ使うか
- 詳細デバッグ
- セキュリティ監査
- コンプライアンス要件
主なツール: Grafana Loki、Elasticsearch、Fluentd
可観測性アーキテクチャ
全体構成
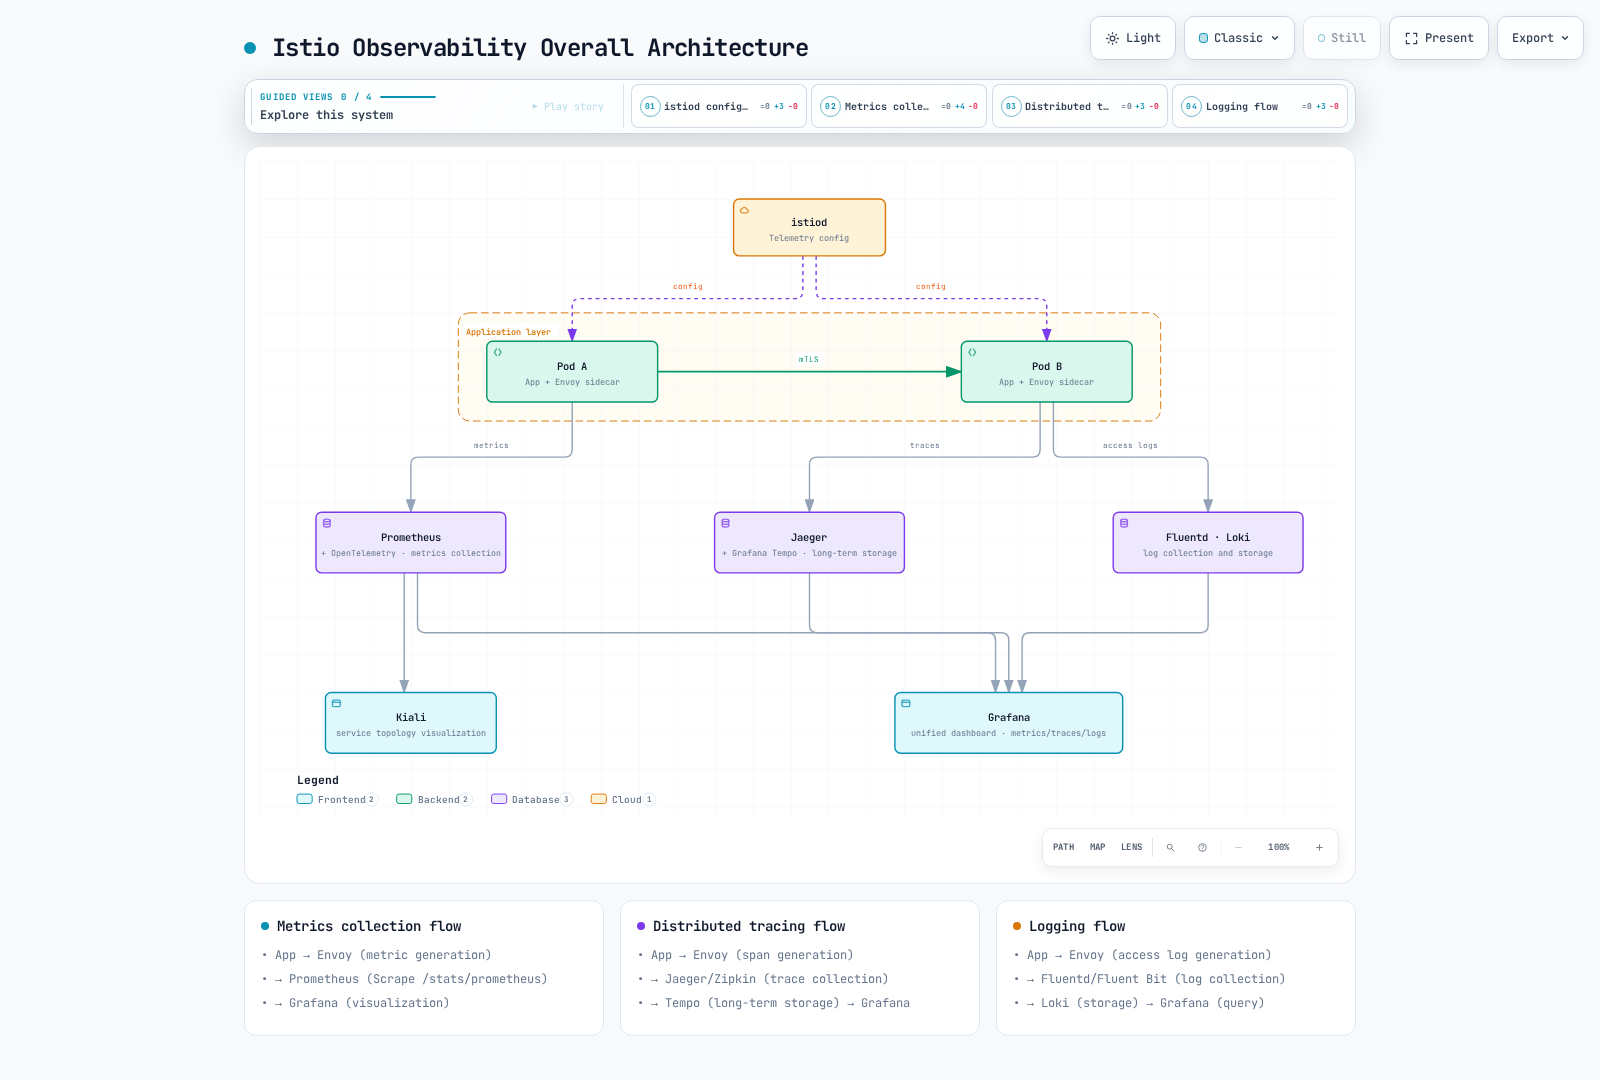
データフロー
1. メトリクス収集フロー:
App → Envoy (metric generation)
    → Prometheus (Scrape /stats/prometheus)
    → Grafana (visualization)
2. 分散トレースフロー:
App propagates context → Envoy generates spans
    → configured collector/protocol (for example OpenTelemetry/OTLP)
    → one chosen backend: Jaeger, Zipkin or Tempo
    → backend UI or configured Grafana datasource
3. ログフロー:
App → Envoy (Access Log generation)
    → Fluentd/Fluent Bit (log collection)
    → Loki (log storage)
    → Grafana (log query and visualization)
ゴールデンシグナル
Google SRE原則に従う主要シグナルです。HTTPクエリは同じホップのsource/destination二重計上を避けてreporter="destination"を選びます。測るのはサービスホップで、一意なユーザートランザクションではありません。destination reporterのない外部/Gateway通信は別分析し、gRPCアプリ失敗にはgrpc_response_statusも必要です。下のレイテンシーはミリ秒です。
1. レイテンシー
# P50 latency
histogram_quantile(0.50,
  sum(rate(istio_request_duration_milliseconds_bucket{reporter="destination"}[5m])) by (le)
)

# P95 latency
histogram_quantile(0.95,
  sum(rate(istio_request_duration_milliseconds_bucket{reporter="destination"}[5m])) by (le)
)

# P99 latency
histogram_quantile(0.99,
  sum(rate(istio_request_duration_milliseconds_bucket{reporter="destination"}[5m])) by (le)
)
2. トラフィック
# Requests per second (RPS)
sum(rate(istio_requests_total{reporter="destination"}[5m]))

# Traffic by service
sum(rate(istio_requests_total{reporter="destination"}[5m])) by (destination_service)
3. エラー
# Error rate (%)
sum(rate(istio_requests_total{reporter="destination",response_code=~"5.."}[5m]))
/
sum(rate(istio_requests_total{reporter="destination"}[5m]))
* 100

# 4xx vs 5xx errors
sum(rate(istio_requests_total{reporter="destination",response_code=~"4.."}[5m])) by (response_code)
sum(rate(istio_requests_total{reporter="destination",response_code=~"5.."}[5m])) by (response_code)
4. 飽和
# CPU consumption in cores (not percent), one series per application container.
sum by (namespace, pod, container) (
  rate(container_cpu_usage_seconds_total{container!="",container!="POD"}[5m])
)

# Memory working set / configured limit (%); containers without limits omitted.
100 * max by (namespace, pod, container) (
  container_memory_working_set_bytes{container!="",container!="POD"}
)
/ on (namespace, pod, container)
(max by (namespace, pod, container) (
  kube_pod_container_resource_limits{resource="memory",unit="byte"}
) > 0)
kubelet/cAdvisorとkube-state-metrics収集が必要で、Istioメトリクスではありません。重複対象を避け、マルチクラスター集約にはclusterラベルを含めます。limitに対する使用量は容量信号の1つにすぎず、スロットリング、キュー待ち、保留処理も確認します。
可観測性のベストプラクティス
1. 標準メトリクスの利用
推奨:
- Istio標準メトリクスを優先
- カスタムメトリクスは必要時だけ追加
- カーディナリティを考慮してラベルを最小化
避けるもの:
- 過剰なカスタムメトリクス
- 高カーディナリティラベル(user_id、request_idなど)
2. トレースサンプリング
本番に適したサンプリング率を設定します。
下のアドレスにOTLP collector Serviceが存在し、選択backendへ出力する必要があります。providerを既存導入設定へマージしてからTelemetry APIで設定します。
# istioctl install -f input, not kubectl apply
apiVersion: install.istio.io/v1alpha1
kind: IstioOperator
spec:
  meshConfig:
    enableTracing: true
    extensionProviders:
    - name: otel
      opentelemetry:
        service: otel-collector.observability.svc.cluster.local
port: 4317apiVersion: telemetry.istio.io/v1
kind: Telemetry
metadata:
name: mesh-tracing
namespace: istio-system
spec:
tracing:
- providers:
- name: otel
randomSamplingPercentage: 1.01.0は100%でなく 1% です。通信量、調査ニーズ、collector/backend容量で選びます。100%は小規模テストに適する場合があり、本番の低率は検証が必要です。コンテキスト伝播も必要です。同じ名前空間に第2のセレクターなしTelemetryを加えず、両例を使うならトレース/アクセスログを1つにマージします。
3. アクセスログ最適化
以下はフィールドでなく要求を絞ります。フィールド選択/機密情報のマスキングはproviderで設定します。このHTTPフィルターは成功要求を省くため、完全アクセス監査には使えません。
apiVersion: telemetry.istio.io/v1
kind: Telemetry
metadata:
  name: mesh-default
  namespace: istio-system
spec:
  accessLogging:
  - providers:
    - name: envoy
    filter:
      expression: response.code >= 400  # Record only errors
4. メトリクス保持方針
運用、保存費用、実保持要件に合わせる期間例です(規制上のデフォルトではありません)。
- リアルタイムメトリクス: 1-7日(高解像度)
- 長期メトリクス: 30-90日(ダウンサンプリング)
- トレース: 7-30日
- ログ: 実保持方針で定義。30–365日は例のみ
PrometheusローカルTSDBは古いデータを自動ダウンサンプリングしません。必要なら対応する長期backendを明示設定します。
5. アラート設定
下のしきい値は例です。ノイズ削減にはサービスSLOと、最小通信量を伴う持続したエラーバジェット消費を優先します。
重大アラート(即時対応):
- エラー率>5%
- P99遅延>しきい値
- サービス停止
警告アラート(監視):
- エラー率>1%
- P95遅延増加
- リソース使用率>80%
詳細文書
可観測性の各分野の詳細ガイド:
1. メトリクス
メトリクスガイド で学ぶ内容:
- Istio標準メトリクス
- Prometheus統合
- OpenTelemetry統合
- カスタムメトリクス追加
- メトリクス最適化
主なトピック:
istio_requests_total: 総要求数istio_request_duration_milliseconds: 要求遅延istio_request_bytes/istio_response_bytes: 要求/応答サイズヒストグラム- サーキットブレーカーメトリクス
- Telemetry APIカスタマイズ
2. 分散トレーシング
分散トレースガイド で学ぶ内容:
- Jaeger統合
- Zipkin統合
- トレースサンプリング
- コンテキスト伝播
- 性能分析
主なトピック:
- Trace Context伝播(W3C Trace Context)
- スパン作成と管理
- Backend選択(Jaeger、Zipkin、Tempo)
- サンプリング戦略
- トレース分析
3. ログ記録
ログガイド で学ぶ内容:
- アクセスログ設定
- 形式カスタマイズ
- Grafana Loki統合
- ログフィルター
- ログ集約
主なトピック:
- Envoyアクセスログ形式
- JSON構造化ログ
- ログレベル設定
- ログ収集(Fluentd、Fluent Bit)
- ログクエリ(LogQL)
4. ダッシュボード
ダッシュボードガイド で学ぶ内容:
- Grafanaダッシュボード
- Kialiサービスグラフ
- カスタムダッシュボード作成
- アラートルール設定
主なトピック:
- Istio標準ダッシュボード
- サービスメッシュダッシュボード
- ワークロードダッシュボード
- Kiali通信可視化
- SLOダッシュボード
次のステップ
参考資料
公式ドキュメント
関連プロジェクト
標準と仕様
クイズ
この章の知識を確認するには、Istio可観測性クイズに挑戦してください。