パート3: 状態、チェックポイント、ストリーミングパターン
最終更新日: 2026年9月12日。Operator 1.15.0。Kafkaの例はFlink 2.2.1、Icebergの例は別のFlink 2.1.3構成を使用。
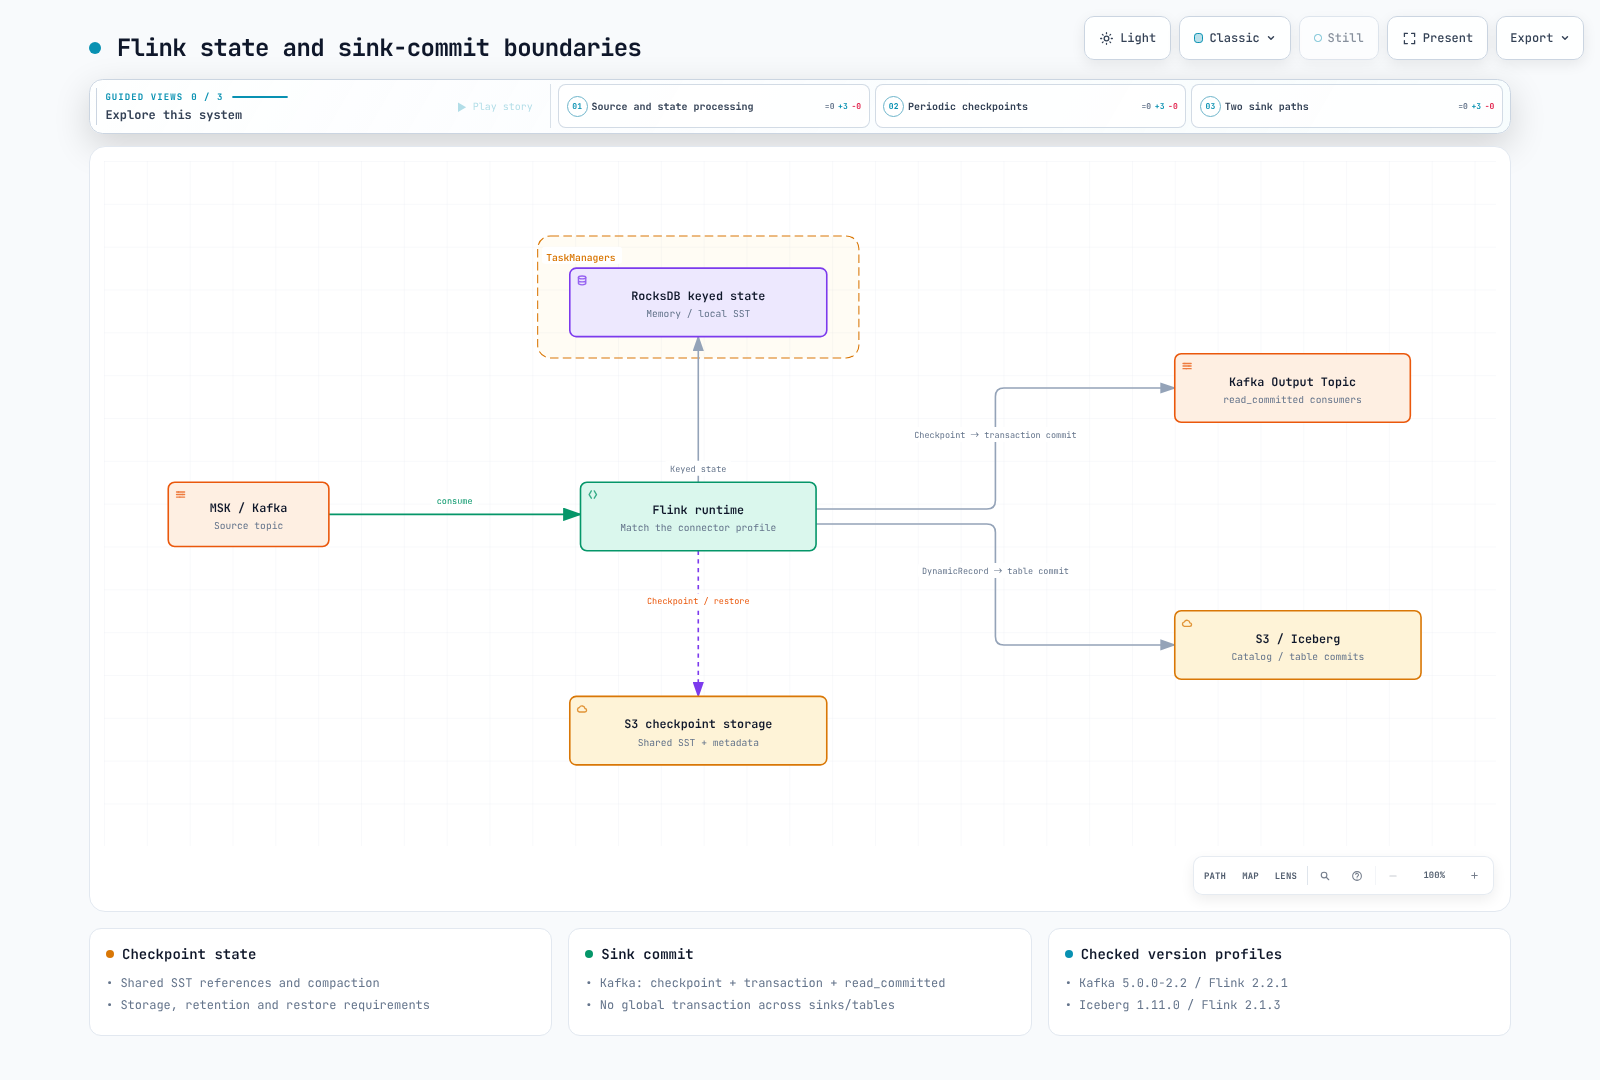
状態とは、集計、結合、重複排除などで処理結果を保持するデータです。すべてのウィンドウが入力レコードをすべて保持するわけではありません。増分SUM/COUNT集計ではアキュムレーターを保持できます。ステートレス処理でも、ソースの再生、acknowledgement、外部書き込みの失敗によって出力を失ったり重複させたりすることがあります。内部状態、再生可能なソース、sinkのcommit保証をまとめて検証してください。
1. まず互換性のある組み合わせを固定する
| 例 | Flink | 追加依存関係 |
|---|---|---|
| Kafka sink/SQL | 2.2.1/Java 17 | flink-connector-kafka 5.0.0-2.2、connector-base、必要なSQL/runtime/formatモジュール |
| Dynamic Iceberg sink | 2.1.3/Java 17 | iceberg-flink-runtime-2.1 1.11.0 |
Iceberg 1.11.0の公式配布では、Flink 2.1、2.0、1.20向けのruntime JARが示されています。Flink 2.2.1上の2.1 JARを、検証済みの組み合わせとして提示してはいません。以下のJavaヘルパーはそれぞれの組み合わせに対してコンパイルしますが、実行にはソース、セキュリティ、カタログ、ストレージの設定が必要です。
2. State backendとcheckpointストレージは異なる
| Backend | 特性 | 調べる制約 |
|---|---|---|
| HashMap | Keyed stateをJVMヒープオブジェクトとして保持 | ワークロードに応じてヒープ、GC、シリアライズのコストを測定する |
| EmbeddedRocksDB | シリアライズしたkeyed stateをローカルRocksDBに保持。ネイティブメモリ/キャッシュとディスクを使う | ディスクだけでなくmanaged/native memory、I/O、CPUも必要 |
| ForSt | リモートファイルシステムのSSTとローカルキャッシュを使う分離型state | 2.2ではexperimental。非同期state APIとsnapshot制約を確認する |
RocksDBだからslotごとに必ず1インスタンスになる、または全operator state/ユーザーオブジェクトがoff-heapになる、という意味ではありません。Keyed operatorごとにbackendを持つことがあり、1 slot内のインスタンスがmanaged-memory予算/キャッシュを共有する場合があります。Operator state、timer、buffer、ユーザーオブジェクトもメモリを使います。
RocksDBを必須にする任意のMBしきい値を設けないでください。stateの形、シリアライズ、GC/I/O、checkpoint/restore時間を比較します。ForStもincremental snapshotに対応するため、増分処理はRocksDBだけの機能ではありません。このラボではRocksDBを使います。
増分checkpointで削減されるもの
RocksDBのcheckpointは、新しいSSTファイルとメタデータを保存し、再利用できる共有SSTを参照します。論理的なkeyの変更を直接diffするわけではありません。論理変更が小さくても、compactionで大きなファイルが書き換わることがあります。
restoreには選択したcheckpointから参照されるすべてのファイルが必要であり、過去のcheckpointをすべて順番に再生する必要はありません。Full checkpointが必ず単一ファイルになるわけでもありません。Native SST restoreでは正規のkey/value状態からRocksDBを再構築せずに済む場合がありますが、転送量、ファイル数、ネットワーク、I/Oによって復旧が速くも遅くもなります。アクティブなcheckpointが参照している共有S3ファイルを、独自判断で期限切れにしないでください。
3. S3 stateを保持するための実際の前提条件
パート2のOperator、データ処理namespace、chartが作成したRole/flinkを使います。バケット/prefixとIAMロールを準備し、以下の例の値を置き換えます。読み取り/書き込み/一覧表示、cleanup/削除、multipart、必要なKMS権限をパスごとに検証してください。ServiceAccountのannotationだけではIAMロールは作られず、OIDC信頼も設定されません。
apiVersion: v1
kind: ServiceAccount
metadata:
  name: flink-state
  namespace: data-processing
  annotations:
    eks.amazonaws.com/role-arn: arn:aws:iam::123456789012:role/flink-state-checkpoints
---
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: flink-state
  namespace: data-processing
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: Role
  name: flink
subjects:
- kind: ServiceAccount
  name: flink-state
  namespace: data-processing
このFlinkDeploymentはIRSAを使い、JM/TMの両方でS3 pluginを有効にし、ローカルRocksDBファイルにはemptyDirを使います。Pod/nodeを失った後に復旧可能なstateはS3にあります。fsGroupはこのイメージのflink UID/GID 9999に合わせています。
重要なバージョン制約があります。確認対象の2.2.1 S3 Hadoop pluginには、Hadoop 3.3.4とAWS SDK for Java 1.12.779が含まれています。SDK 1.xは2025年12月31日にサポート終了となりました。この例ではartifactが実際に含むv1 credential classを使っており、SDK v2構成として検証したものではありません。本番利用では、上流filesystemの対応状況/セキュリティと、互換性のあるruntime/connectorの代替案を評価してください。SDK世代をまたいでJARやprovider class名を個別に置き換えないでください。
apiVersion: flink.apache.org/v1beta1
kind: FlinkDeployment
metadata:
  name: flink-state-demo
  namespace: data-processing
spec:
  image: flink:2.2.1-java17
  flinkVersion: v2_2
  mode: native
  flinkConfiguration:
    taskmanager.numberOfTaskSlots: '2'
    state.backend.type: rocksdb
    state.backend.rocksdb.localdir: /opt/flink/state
    execution.checkpointing.storage: filesystem
    execution.checkpointing.dir: s3://replace-with-your-bucket/flink-state-demo/checkpoints
    execution.checkpointing.savepoint-dir: s3://replace-with-your-bucket/flink-state-demo/savepoints
    execution.checkpointing.interval: 2 s
    execution.checkpointing.mode: EXACTLY_ONCE
    execution.checkpointing.timeout: 10 min
    execution.checkpointing.min-pause: 30 s
    execution.checkpointing.incremental: 'true'
    execution.checkpointing.num-retained: '3'
    execution.checkpointing.externalized-checkpoint-retention: RETAIN_ON_CANCELLATION
    high-availability.type: org.apache.flink.kubernetes.highavailability.KubernetesHaServicesFactory
    high-availability.storageDir: s3://replace-with-your-bucket/flink-state-demo/ha
    fs.s3a.aws.credentials.provider: com.amazonaws.auth.WebIdentityTokenCredentialsProvider
  serviceAccount: flink-state
  jobManager:
    resource:
      memory: 2048m
      cpu: 1
  taskManager:
    resource:
      memory: 2048m
      cpu: 1
  job:
    jarURI: local:///opt/flink/examples/streaming/StateMachineExample.jar
    parallelism: 2
    upgradeMode: last-state
    state: running
    args:
    - --backend
    - rocksdb
    - --checkpoint-dir
    - s3://replace-with-your-bucket/flink-state-demo/checkpoints
    - --incremental-checkpoints
    - 'true'
  podTemplate:
    spec:
      securityContext:
        fsGroup: 9999
      containers:
      - name: flink-main-container
        env:
        - name: ENABLE_BUILT_IN_PLUGINS
          value: flink-s3-fs-hadoop-2.2.1.jar
        volumeMounts:
        - name: rocksdb-local
          mountPath: /opt/flink/state
      volumes:
      - name: rocksdb-local
emptyDir: {}StateMachineExampleは、コード内でcheckpoint間隔を2秒に明示設定しています。例の設定もそれに一致します。min-pauseは30秒で、checkpointの所要時間もあるため、実際のsnapshotが常に2秒ごとに作られるわけではありません。アプリケーションコードで60秒の設定値を上書きする場合があります。実効runtime設定を確認してください。
Pod Identityを使う場合は、IRSA設定の代わりにServiceAccount association、Agent、ネットワークを準備してください。このv1 artifactでは、com.amazonaws.auth.DefaultAWSCredentialsProviderChainなどのcontainer credential経路を検証します。バージョン1.12.779は、文書化されたPod Identityの最低バージョン1.12.746を満たしますが、サポート終了済みSDKである点は変わりません。環境変数/IRSA/その他の認証情報ソースが優先されないかも調べます。
デプロイ後は、Completed checkpoint、S3メタデータ/データファイル、再起動/restore、アプリケーションの結果を検証してください。単にRunning状態を見るだけでは不十分です。emptyDirは永続バックアップではありません。このレビューでは実際のAWSデプロイや障害復旧を実行していません。
4. Checkpointとsavepointのライフサイクル
| 項目 | Checkpoint | Savepoint |
|---|---|---|
| 主な用途 | 障害復旧用のstate/ソース位置 | 明示的なrestore、アップグレード、分岐の起点 |
| 起動方法 | 周期実行または明示的な要求 | ユーザー/Operator要求。自動化で定期作成することもできる |
| 保持 | 個数、外部化した場合の保持、job終了ポリシー | ユーザー/Operatorのポリシーとrestore所有者 |
| 形式/保存場所 | JobManagerまたはファイルシステムストレージなど | canonical/native形式とアクセス可能なストレージ |
Savepointが自動的に永久保存されるわけではなく、checkpointが必ずS3にあるわけでもありません。Canonical形式はbackend間の可搬性を目指し、native形式はbackend固有です。state schema、UID、serializer、最大並列度、バージョン互換性を検証してください。
CLAIM/NO_CLAIM restoreモードはsnapshotの所有権と削除責任に影響します。NO_CLAIM restore後の最初のRocksDB checkpointは、独立性を確立するためfullになる場合があります。復旧が依存しているsnapshotを削除しないでください。Operatorのlast-stateは、アクセス可能なHAメタデータまたは最後のcheckpoint/savepointを利用できます。必ず単一の最新checkpointファイルを指すとは限りません。
一意なCRで新しいsavepointを要求する
generateNameは作成時に新しい名前を割り当てます。これにより、完了済みリソースを再利用して古いsnapshotを新しい成功と誤認することを防ぎます。
apiVersion: flink.apache.org/v1beta1
kind: FlinkStateSnapshot
metadata:
  generateName: flink-state-before-upgrade-
  namespace: data-processing
spec:
  jobReference:
    kind: FlinkDeployment
    name: flink-state-demo
  savepoint:
    formatType: CANONICAL
disposeOnDelete: falsekubectl create -f savepoint.yaml
kubectl get flinkstatesnapshots -n data-processing --watch新しいCRのstatus.state=COMPLETEDとstatus.pathを調べます。FAILEDまたはABANDONEDの場合は、error/job状態を調査します。disposeOnDelete=falseはこの例の保持方法であり、既定のtrueやOperatorのcleanupポリシーとは異なります。保持ファイルを誰が削除するか記録してください。
5. Kafkaのexactly-onceにはcheckpoint、transaction、consumerが必要
KafkaSinkのEXACTLY_ONCEは、checkpoint完了と連携してKafka transactionをcommitします。再生可能なソース、復旧可能なstate、正しいsink設定が必要です。下流consumerではread_committedを使います。すべてのsubtask、partition、ほかのsink systemをまたぐ単一のグローバルatomic transactionを作るものではありません。Kafka transactionは複数topic/partitionにまたがることができますが、複数sink subtaskの個別transactionがFlink checkpoint全体を1つのtransactionにするわけではありません。
このヘルパーはKafka connector 5.0.0-2.2とFlink 2.2.1でコンパイルします。呼び出し元が入力ストリーム、実際のbootstrap server、TLS/SASL producer設定、timeoutを渡し、アプリケーションを実行します。Kafkaクラスターをインストールする手順ではありません。
import java.util.Properties;
import org.apache.flink.api.common.serialization.SimpleStringSchema;
import org.apache.flink.connector.base.DeliveryGuarantee;
import org.apache.flink.connector.kafka.sink.KafkaRecordSerializationSchema;
import org.apache.flink.connector.kafka.sink.KafkaSink;
import org.apache.flink.streaming.api.datastream.DataStream;

public final class KafkaExample {
    private KafkaExample() {}

    public static void attach(
            DataStream<String> input,
            String bootstrapServers,
            String transactionalIdPrefix,
            int transactionTimeoutMs,
            Properties securityProperties) {
        if (transactionTimeoutMs <= 0 || transactionalIdPrefix.isBlank()) {
            throw new IllegalArgumentException("Positive timeout and a unique stable prefix are required");
        }
        Properties producer = new Properties();
        producer.putAll(securityProperties);
        producer.setProperty("transaction.timeout.ms", Integer.toString(transactionTimeoutMs));
        input.getExecutionEnvironment().enableCheckpointing(60_000);

        KafkaSink<String> sink = KafkaSink.<String>builder()
                .setBootstrapServers(bootstrapServers)
                .setKafkaProducerConfig(producer)
                .setRecordSerializer(KafkaRecordSerializationSchema.<String>builder()
                        .setTopic("orders-enriched")
                        .setValueSerializationSchema(new SimpleStringSchema())
                        .build())
                .setDeliveryGuarantee(DeliveryGuarantee.EXACTLY_ONCE)
                .setTransactionalIdPrefix(transactionalIdPrefix)
                .build();
        input.sinkTo(sink).name("orders-enriched").uid("orders-enriched-sink");
    }
}transactionalIdPrefixは、同じKafkaクラスター上で独立して同時実行するsink/job間で一意にし、再起動後も安定させてください。変更すると以前のtransactionがabortされずに残り、timeoutまでread_committedの進行を妨げる場合があります。blue/green実行間で無条件に共有すると、fencing/競合の危険があります。
5.0.0のbuilderでは、transaction timeoutの既定値は1時間です。brokerで許可された最大値に合わせ、最悪時のcheckpoint/再起動/復旧に十分な時間を設けてください。transaction期限切れ後に、設定ラベルだけでexactly-once保証を復元することはできません。
checkpoint間隔を60秒にしても、追加レイテンシが最大60秒になるわけではありません。待ち時間、checkpoint所要時間、commit、障害/再試行、consumer lagが影響します。短い間隔はcommit/メタデータ負荷を増やします。既定のINCREMENTING命名では新しいIDを作ります。任意のPOOLINGではIDを再利用し、Kafka 3以降、追加のtopic読み取り権限、文書化された移行手順が必要です。どの設定でもtransaction IDが無期限に増えるわけではありません。
6. Dynamic Iceberg sink: 実際のAPIと別のruntime
このヘルパーはIceberg 1.11.0/Flink 2.1.3を対象にします。入力RowDataのフィールドはtarget_table STRING、id BIGINT、value STRINGで、insert-onlyです。呼び出し元がカタログ、warehouse、認証を設定したCatalogLoaderを渡します。宛先table名は信頼できる/許可された値だけに制限してください。
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.table.data.GenericRowData;
import org.apache.flink.table.data.RowData;
import org.apache.iceberg.DistributionMode;
import org.apache.iceberg.PartitionSpec;
import org.apache.iceberg.Schema;
import org.apache.iceberg.catalog.TableIdentifier;
import org.apache.iceberg.flink.CatalogLoader;
import org.apache.iceberg.flink.sink.dynamic.DynamicIcebergSink;
import org.apache.iceberg.flink.sink.dynamic.DynamicRecord;
import org.apache.iceberg.types.Types;

public final class IcebergExample {
    private IcebergExample() {}
    private static final Schema PAYLOAD_SCHEMA = new Schema(
            Types.NestedField.required(1, "id", Types.LongType.get()),
            Types.NestedField.optional(2, "value", Types.StringType.get()));

    // Insert-only input RowData: target_table STRING, id BIGINT, value STRING.
    // The caller supplies an authenticated, authorized CatalogLoader.
    public static void attach(DataStream<RowData> input, CatalogLoader catalogLoader) {
        input.getExecutionEnvironment().enableCheckpointing(60_000);
        DynamicIcebergSink.forInput(input)
                .generator((row, out) -> {
                    TableIdentifier target = TableIdentifier.of("docs", row.getString(0).toString());
                    GenericRowData payload = GenericRowData.of(
                            row.getLong(1), row.isNullAt(2) ? null : row.getString(2));
                    out.collect(new DynamicRecord(
                            target, "main", PAYLOAD_SCHEMA, payload,
                            PartitionSpec.unpartitioned(), DistributionMode.HASH, 2));
                })
                .catalogLoader(catalogLoader)
                .uidPrefix("docs-dynamic-iceberg")
                .writeParallelism(2)
                .append();
    }
}実際のAPIはforInput → generator → catalogLoader → appendです。Generatorは1レコードを返すのではなく、Collectorに0件以上のレコードを出力します。以前のforRecords/withTableIdentifierSelector/withSchemaEvolutionEnabledの例は、このリリースには存在しません。
各DynamicRecordには宛先、schema、RowData、partition仕様を指定します。schema evolutionは対応する変更と設定に従います。任意のrename/型変更を自動的に解決するわけではありません。CDCのupdate/deleteにはRowKind、equality field、upsert、table formatの検証が必要です。このinsert-onlyヘルパーを完全なCDC processorとして使わないでください。複数tableへのcommitとKafka/Icebergへの同時出力は、グローバルなatomic commitではありません。
シンプルな取り込みには、MSK → Firehose → S3 Tables/IcebergまたはMSK Connect sinkを検討できます。対応source/ネットワーク、認証、catalog/table format、行操作/key、buffering、障害対応を確認してください。例えばFirehose IcebergにはV2/Parquet/MORの要件が記載されています。マネージドインフラでも、設定、schema、配信セマンティクスの検証は必要です。
7. SQL、time attribute、遅延データ
SQL/Table APIは関係変換/集計を表現し、DataStreamは独自state、timer、operatorロジックを公開します。SQLにも高度な機能があります。DataStreamでもcheckpoint barrier/backpressureを任意に回避できるわけではありません。2.xの公開APIとconnector/format JARを確認してください。Kafka/Iceberg/JDBCがすべて常に同梱されるわけではなく、過去のScala APIがすべて引き続きサポートされるとは限りません。
次の計画例にはtable定義とwatermarkが含まれています。実行前に、broker/セキュリティ設定とJSON field/時刻表現を実際のsourceに合わせてください。
-- Schema/planning example. Supply real broker/authentication settings before execution.
CREATE TEMPORARY TABLE orders (
  customer_id STRING,
  amount DECIMAL(12,2),
  event_time TIMESTAMP(3),
  WATERMARK FOR event_time AS event_time - INTERVAL '5' SECOND
) WITH (
  'connector' = 'kafka',
  'topic' = 'orders',
  'properties.bootstrap.servers' = 'kafka.example.invalid:9093',
  'properties.group.id' = 'docs-orders',
  'scan.startup.mode' = 'earliest-offset',
  'format' = 'json'
);

SELECT window_start, window_end, customer_id, SUM(amount) AS total_amount
FROM TABLE(TUMBLE(TABLE orders, DESCRIPTOR(event_time), INTERVAL '1' MINUTE))
GROUP BY window_start, window_end, customer_id;
Flink 2.2.1 plannerはこのqueryを受け入れますが、watermark/time attributeのない通常のTIMESTAMP列は拒否します。これはplanningの検証であり、Kafkaからの読み込みや実行済みwindow結果のテストではありません。
Watermarkはevent-timeの進行を推定するもので、古いイベントが到着しない保証ではありません。すべてのレコードにevent timestampが自動で含まれるわけではありません。timestamp抽出、watermark strategy、入力のidle状態を設定してください。遅い/idleな入力で進行が止まる一方、入力再開後に遅延データが発生する場合があります。
- Tumbling: 固定サイズで重複しないwindow。
- Sliding: 固定サイズとslide間隔を使い、slideが小さいほど重複が増える。
- Session: 壁時計上のidle timerだけでなく、event-timeの間隔とwatermarkの進行で決まる。
DataStreamでallowedLateness>0にすると、保持されたwindow stateが遅延レコードを受け入れ、更新結果を出力できます。cleanup後の遅延レコードは破棄するか、明示的に設定したlate-data side outputへ送ります。allowedLatenessだけではside outputは作られません。このDataStreamオプションの挙動をSQL windowに一般化しないでください。
検証範囲
2つのruntime固有Java helperはrelease 17をtargetとしてコンパイルしました。確認項目には、有効/watermark欠落SQLのplanning、S3 plugin archive内のv1 credential class、CRD/YAML構造、公開済みソースを含みます。ローカルJavaツールはCorretto 21を使いました。Java 17クラスター実行、AWS/Kafka/Iceberg接続、CDC、障害復旧テストは実施していません。
参考資料
- Flink 2.2のstate backend
- Checkpoint設定
- Savepointと所有権
- S3 filesystem plugin
- S3 pluginの依存関係
- 同梱のStateMachineExample
- Operator snapshot
- Kafka connector 5.0.0 sink
- Kafka transactionの命名
- Icebergのrelease/runtime対応表
- Iceberg 1.11 DynamicIcebergSink
- Windowと遅延データ
- Watermarkとidle状態
- EKS Pod Identity SDK要件
- AWS SDK for Java 1.xのサポート状況
- Firehose Icebergの前提条件